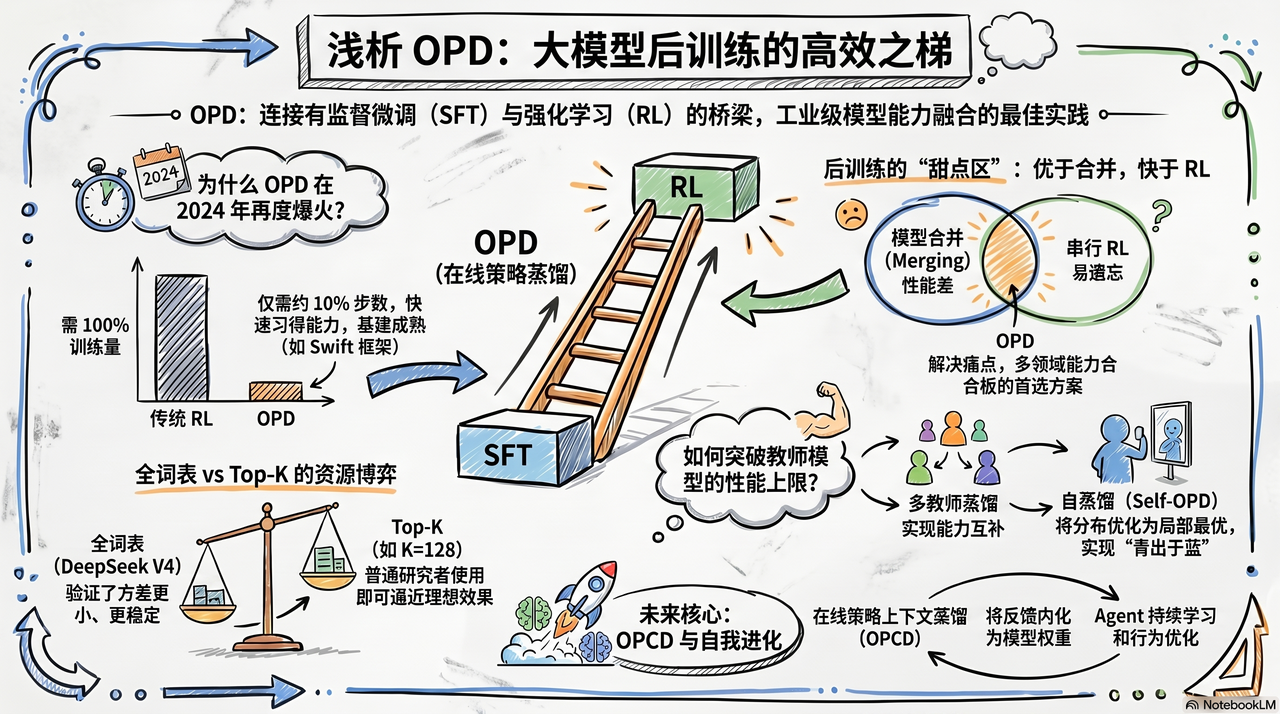
精选文章 实录精选|On-Policy Distillation专题:与RL 的本质区别、全词表监督、跨模型/黑盒蒸馏、Self-OPD... 过去一年,OPD 强势改写大模型后训练格局,消融蒸馏与强化学习的技术壁垒,驱动模型从静态对齐迈向自主进化,一众关乎 AI 自我迭代的前沿疑问应运而生。 在 5 月 30 日,#青稞AMA 第 3 期:On-Policy Distillation(OPD) 专题中,青稞社区邀请到了当前 OPD 方向最
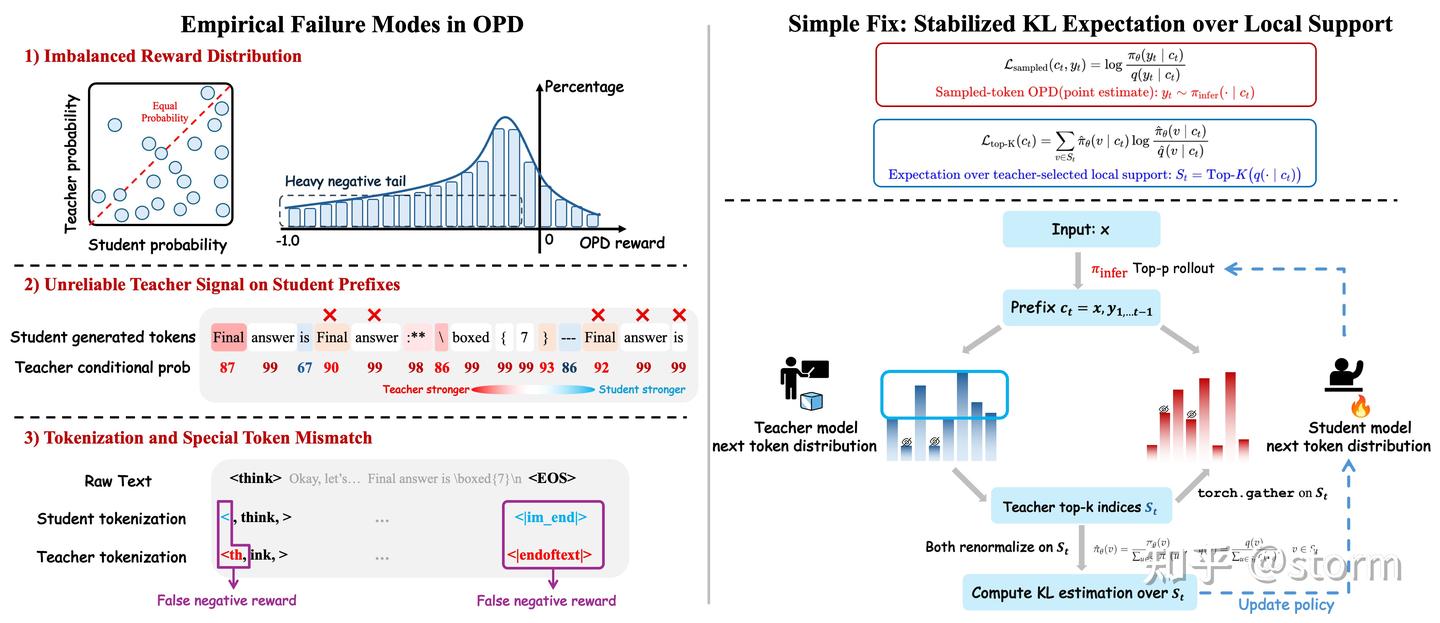
精选文章 重探 On-Policy Distillation(OPD):三类典型失败以及修复路径 作者:storm 原文:https://zhuanlan.zhihu.com/p/2025536259628569667 英文博客:http://yuqianfu.notion.site/revisiting-opd 论文链接:https://huggingface.co/papers/2603.2
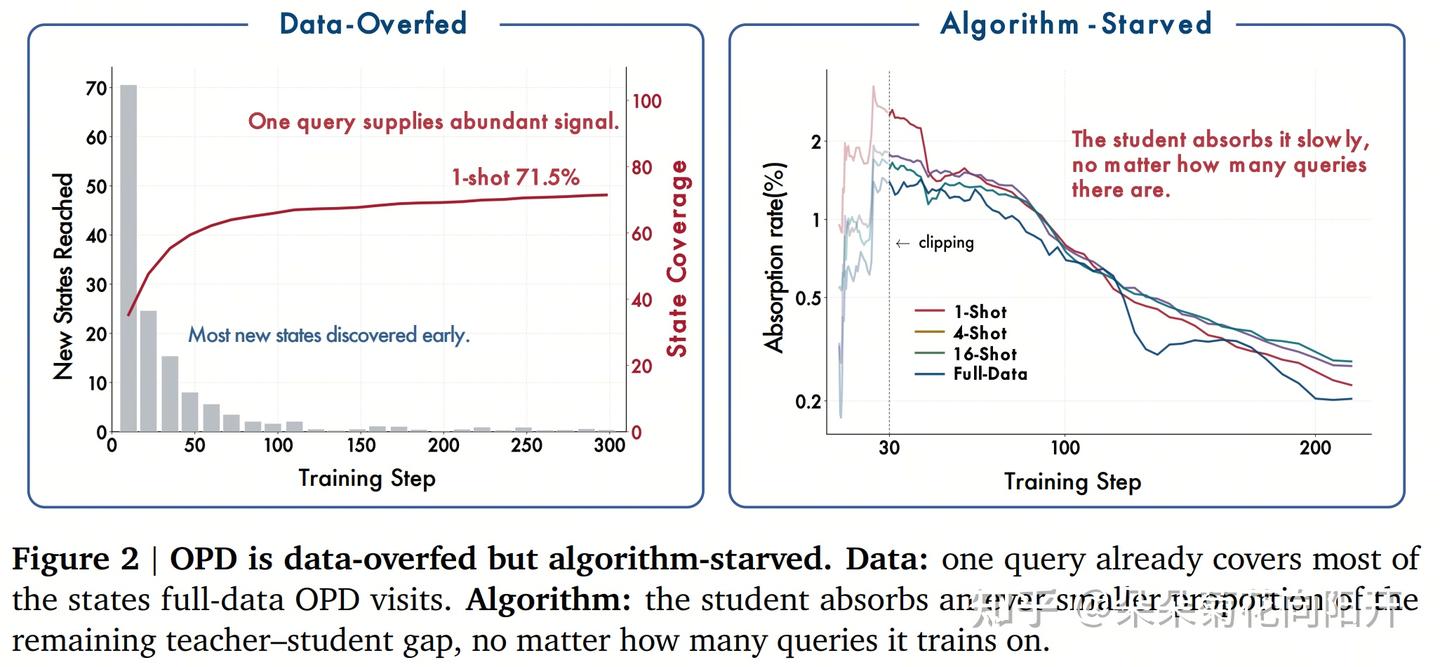
精选文章 Rethinking OPD II: 为什么 OPD 在一条样本上训练,也能接近全量数据的效果? 作者:朵朵菊花向阳开 原文:https://zhuanlan.zhihu.com/p/2079700159114507443 青稞社区为科研人员提供成果宣传支持,如有优秀研究成果分享推广,欢迎投稿联系:aiFreeCode 我们很高兴发布 Rethinking OPD 系列工作的第二篇,从数据视角看
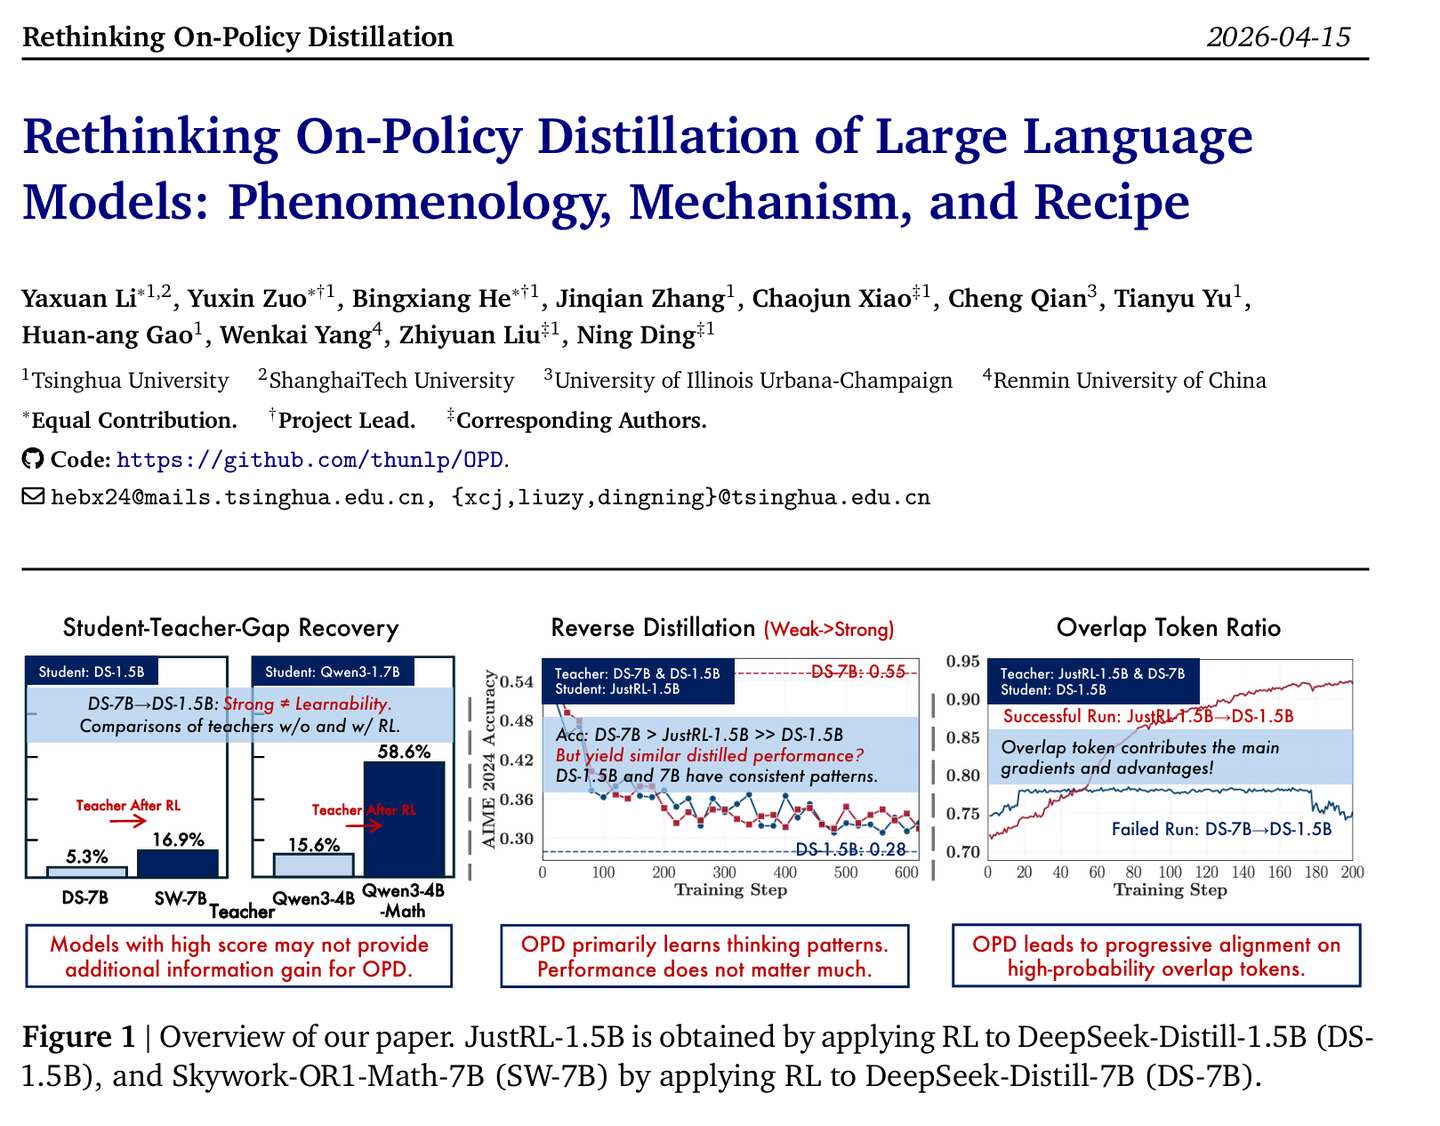
青稞Talk 直播预告!周四晚8点,一起Rethinking On-Policy Distillation On-policy distillation 正在成为大模型 post-training 的标配。Qwen3、MiMo、GLM-5、DeepSeek-V4——2025 年以来几乎所有头部模型都在用它:学生模型生成自己的 rollout,教师模型在每一个 token 位置上提供分布监督,密集、精准、高
青稞Talk 直播预告!模型的“什么经验值得被看见”?一起聊聊 LOPD:不再手动设计 OPSD 特权信息 学术社区是否已经对层出不穷的 On-Policy Self-Distillation (OPSD) 特权信息变体感到审美疲劳? 当 answer、trajectory、reflection、skill 被不断设计得更精巧,LOPD 反过来追问一个更根本的问题:我们为何仍要替模型规定“什么经验值得被看
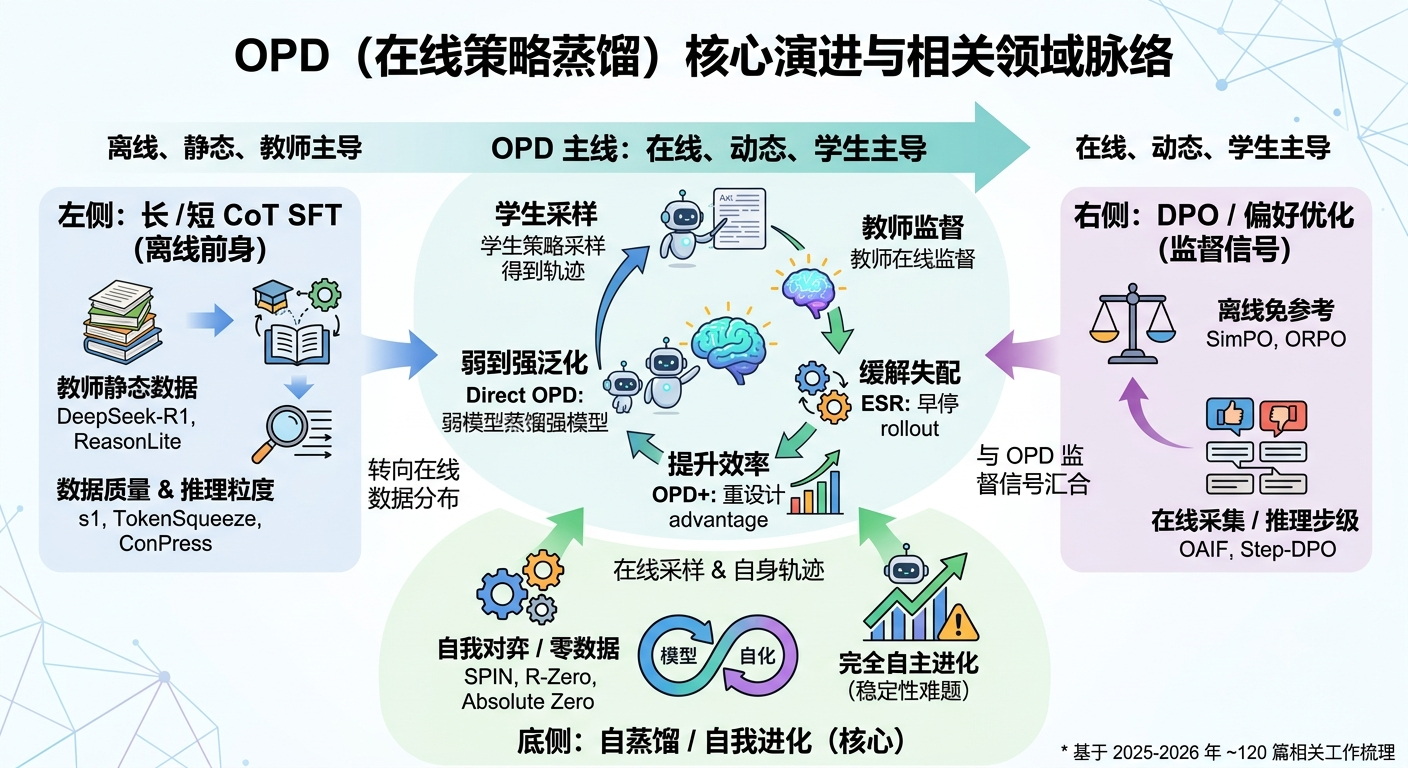
精选文章 从长/短 CoT SFT、到自蒸馏,再到偏好优化!厘清 OPD 的核心技术演变 作者:zklink https://zhuanlan.zhihu.com/p/2067242658939065932 2026 年以来,以 On-Policy Distillation(在线策略蒸馏,OPD)命名的工作在推理模型后训练领域密集出现,成为继长思维链(Long CoT)蒸馏之后又一个快速
青稞Talk 直播预告!没有外部专家监督时,如何让 OPD 策略学会自我持续进化?聊聊在线自进化后训练框架 DRIFT 强化学习之后,大语言模型还能如何持续进化? 在没有人类专家监督的情况下,大模型到底该怎么练才能不崩溃、不效率低下? 来自贝壳、清华、巴黎高师的研究团队最新带来一篇名为《DRIFT: Difficulty Routing Self-DIstillation with Rhythm-Gated Expl
精选文章 突破OPD教师天花板!淘天 × 华科大提出MAD-OPD:让小模型学会"老师们争出来的答案" 论文:MAD-OPD: Breaking the Ceiling in On-Policy Distillation via Multi-Agent Debate 链接:https://arxiv.org/abs/2605.01347 代码:https://github.com/chiefovoav
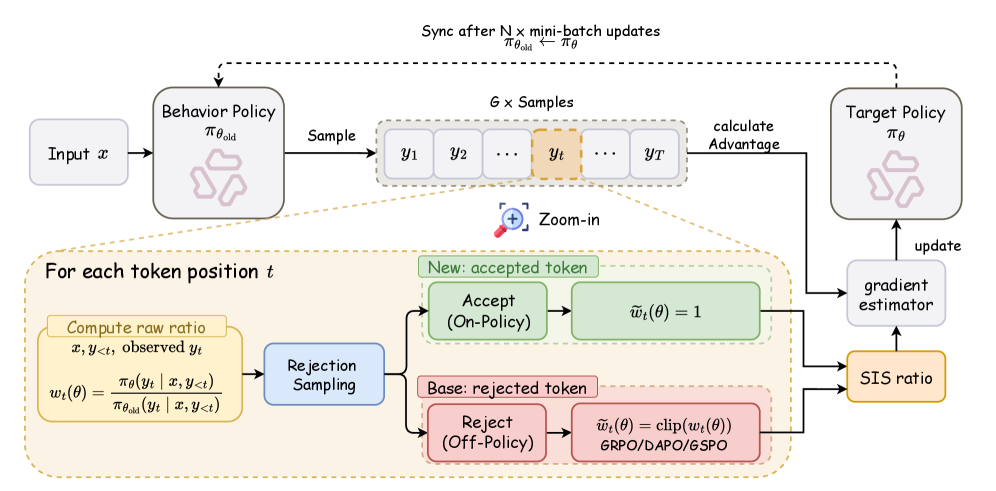
精选文章 人大 & 京东|关于 RL中 Off-Policy 修正,我们可能一直在走弯路 做 LLM RL 后训练,最干净的做法本该是on-policy:拿当前策略 \pi_\theta现采一批数据,算梯度,更新,再采下一批。policy gradient的理论就建立在"数据来自当前策略"这个前提上,只要严格on-policy,梯度就是无偏的,训练也最稳。 问题是,严格 on-polic
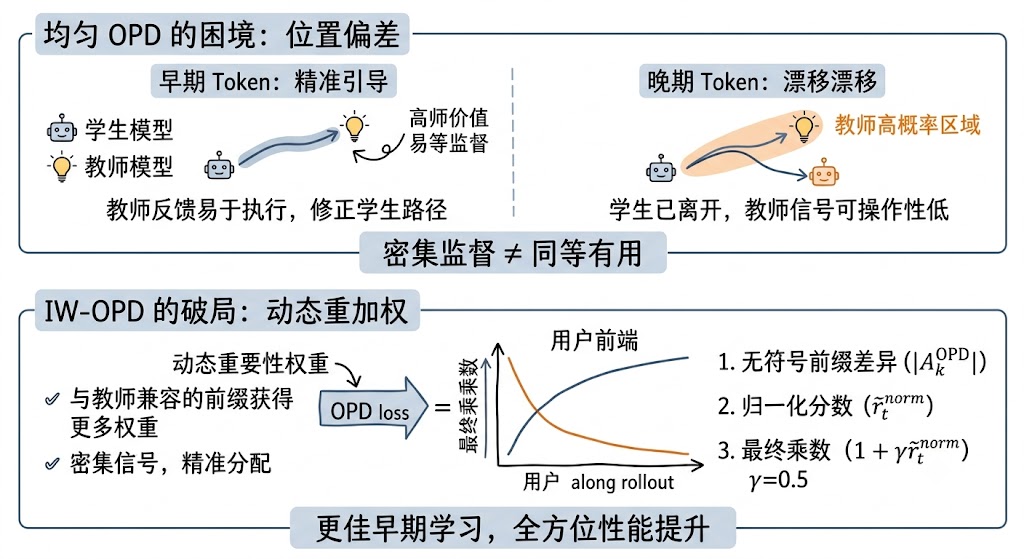
精选文章 OPD 的 token 加权真的合理吗?也许早期 token 才是关键,均匀加权全错了! 原文链接:https://yannx1e.github.io/IW-OPD/ 论文作者:Yan Xie, Sijie Zhu, Tiansheng Wen, Bo Chen, Yifei Wan 摘要 在线蒸馏(On-Policy Distillation, OPD)之所以受到关注,是因为它结合了两
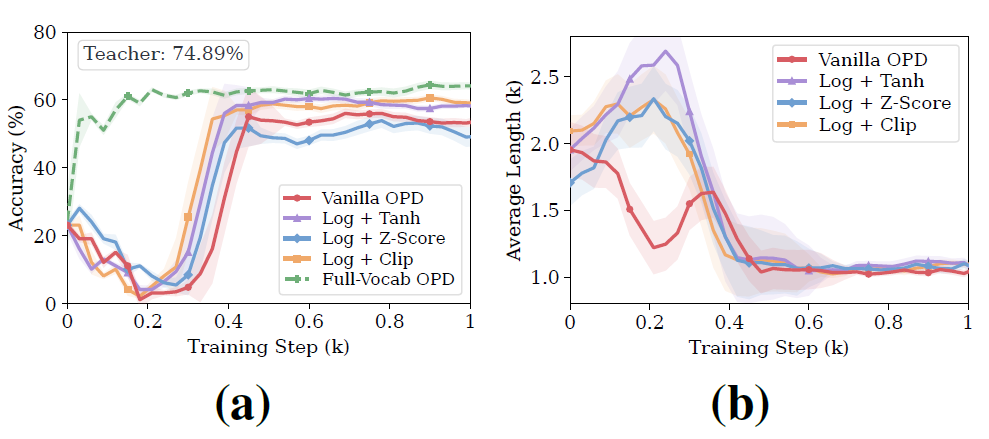
精选文章 就从来没人质疑过 OPD 的 reward 设计吗?我们发现了 log 本身就是问题,也许就不该用! 📄 arXiv:https://arxiv.org/abs/2606.17199 作者机构:东方理工、香港理工大学、上海交通大学、University of Waterloo` On-Policy Distillation(OPD)正在成为大模型后训练的标准组件。和传统 SFT 只在 teach
精选文章 xOPD 演进|梳理近期 OPD 的改进工作:哪些是同一个问题换说法、哪些是动了不同的模块 作者:banana 原文:https://zhuanlan.zhihu.com/p/2039735648421163598 OPD相关的论文这几个月每周冒出好几篇,剧本和当年xPO(DPO 之后)、xGRPO(GRPO 之后)几乎一样,大家围着它做排列组合。本文试图对近期这一波工作进行初步梳理——哪
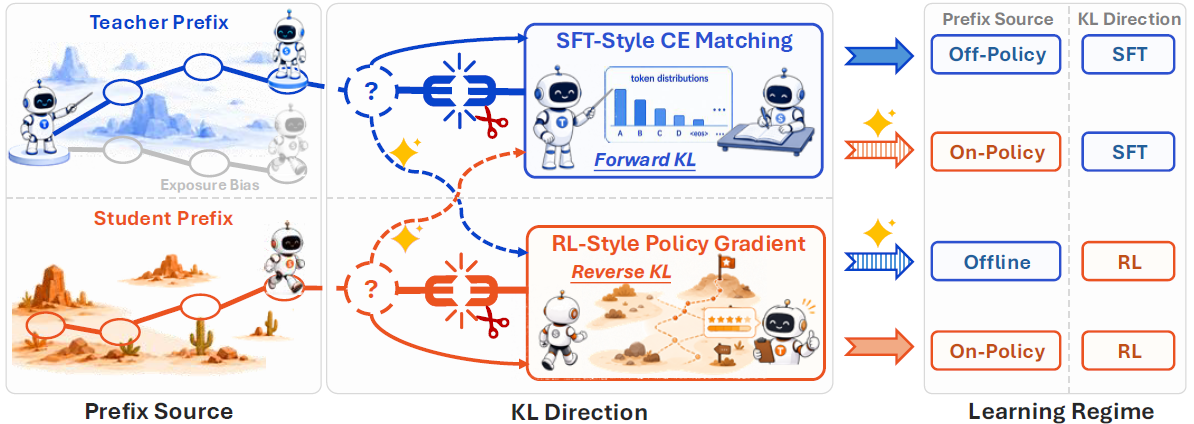
精选文章 🤔什么?SFT、DAgger、离线 RL 和 OPD,竟然是同一张 2×2 表格上的四个格子! 蒸馏 + RL 已经是 reasoning 模型后训练的标配:DeepSeek-R1、s1、OpenThinker 走的是“off-policy 蒸馏再 RL”,Qwen3、MiMo、GLM-5 则把 on-policy distillation(OPD)直接编进了后训练管线。 但有一个问题很少有人
青稞AMA 直播预告|从 MiniLLM 开始,为什么 OPD 正在成为推理模型时代的“基础设施”? 过去一年里,OPD 几乎成为后训练领域最火热的话题之一。 越来越多工作开始发现: 学生模型并不只是“模仿教师” On-policy 数据可能比静态 SFT 数据
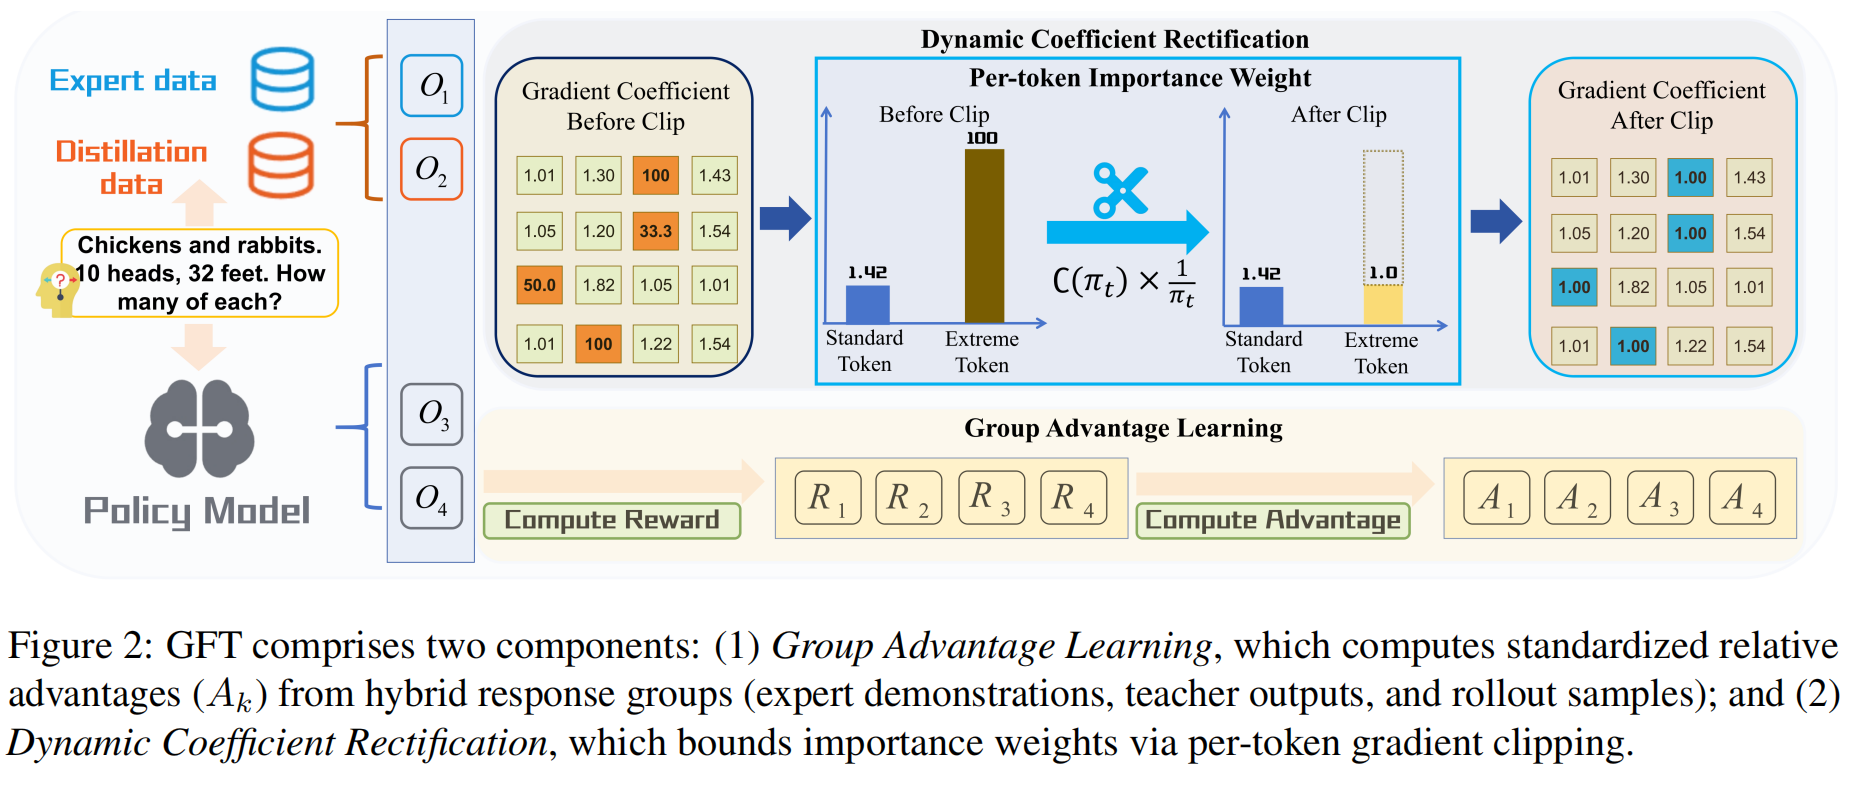
精选文章 ACL 2026 Findings | 浙大提出 GFT:On-Policy SFT 视角下的奖励微调 🧪 Title: GFT: From Imitation to Reward Fine-Tuning with Unbiased Group Advantages and Dynamic Coefficient Rectification 🎉 Venue: ACL 2026 Findings 📝 P
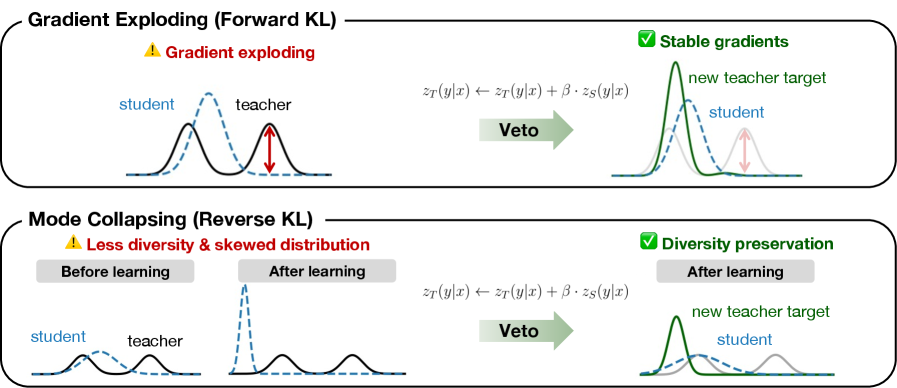
青稞Talk 重探 On-Policy Distillation(OPD):三类典型失败以及修复路径 在最近的大模型后训练中,On-Policy Distillation已经成为默认选项之一。 但研究者们在分析训练日志、实验曲线和对比不同 OPD 方法实现时,反复碰到同一个问题:理论上很自然的 sampled-token OPD,实际运行起来并不稳定,甚至会把模型往一些局部上“看起来合理”、整体上却
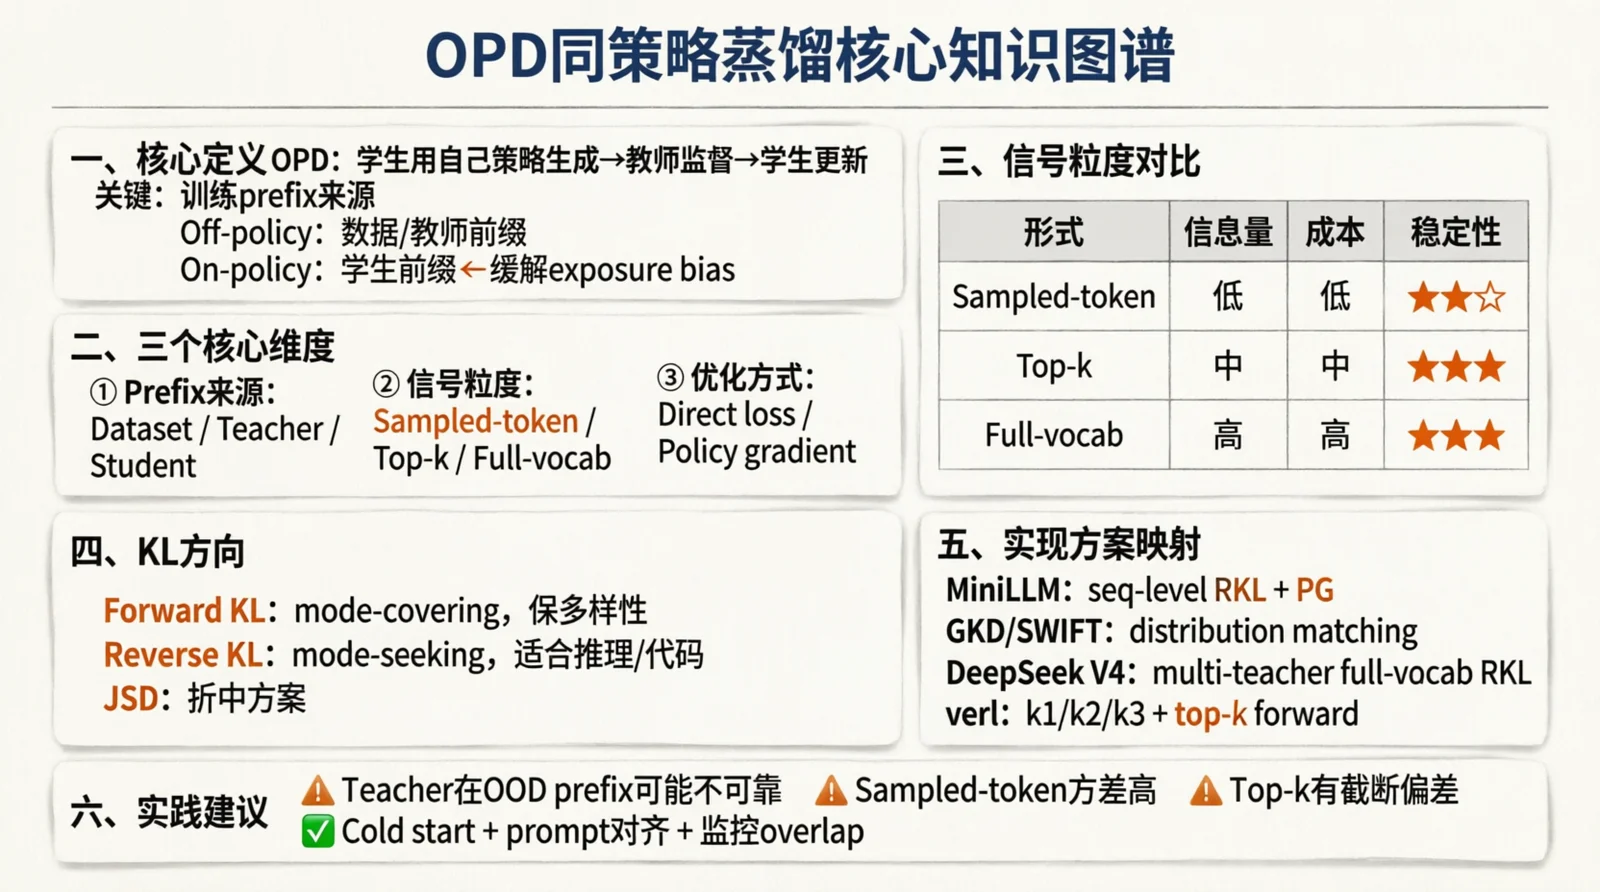
精选文章 OPD深度解析:从数学推导到DeepSeek V4、SWIFT与verl实践 作者:banana https://zhuanlan.zhihu.com/p/2033212181823608430 这篇文章要回答的问题:OPD 到底在优化什么?训练 prefix 从哪里来,以及在每个 prefix 上你比较的是一个 sampled token、一个 top-k 局部分布,还是整
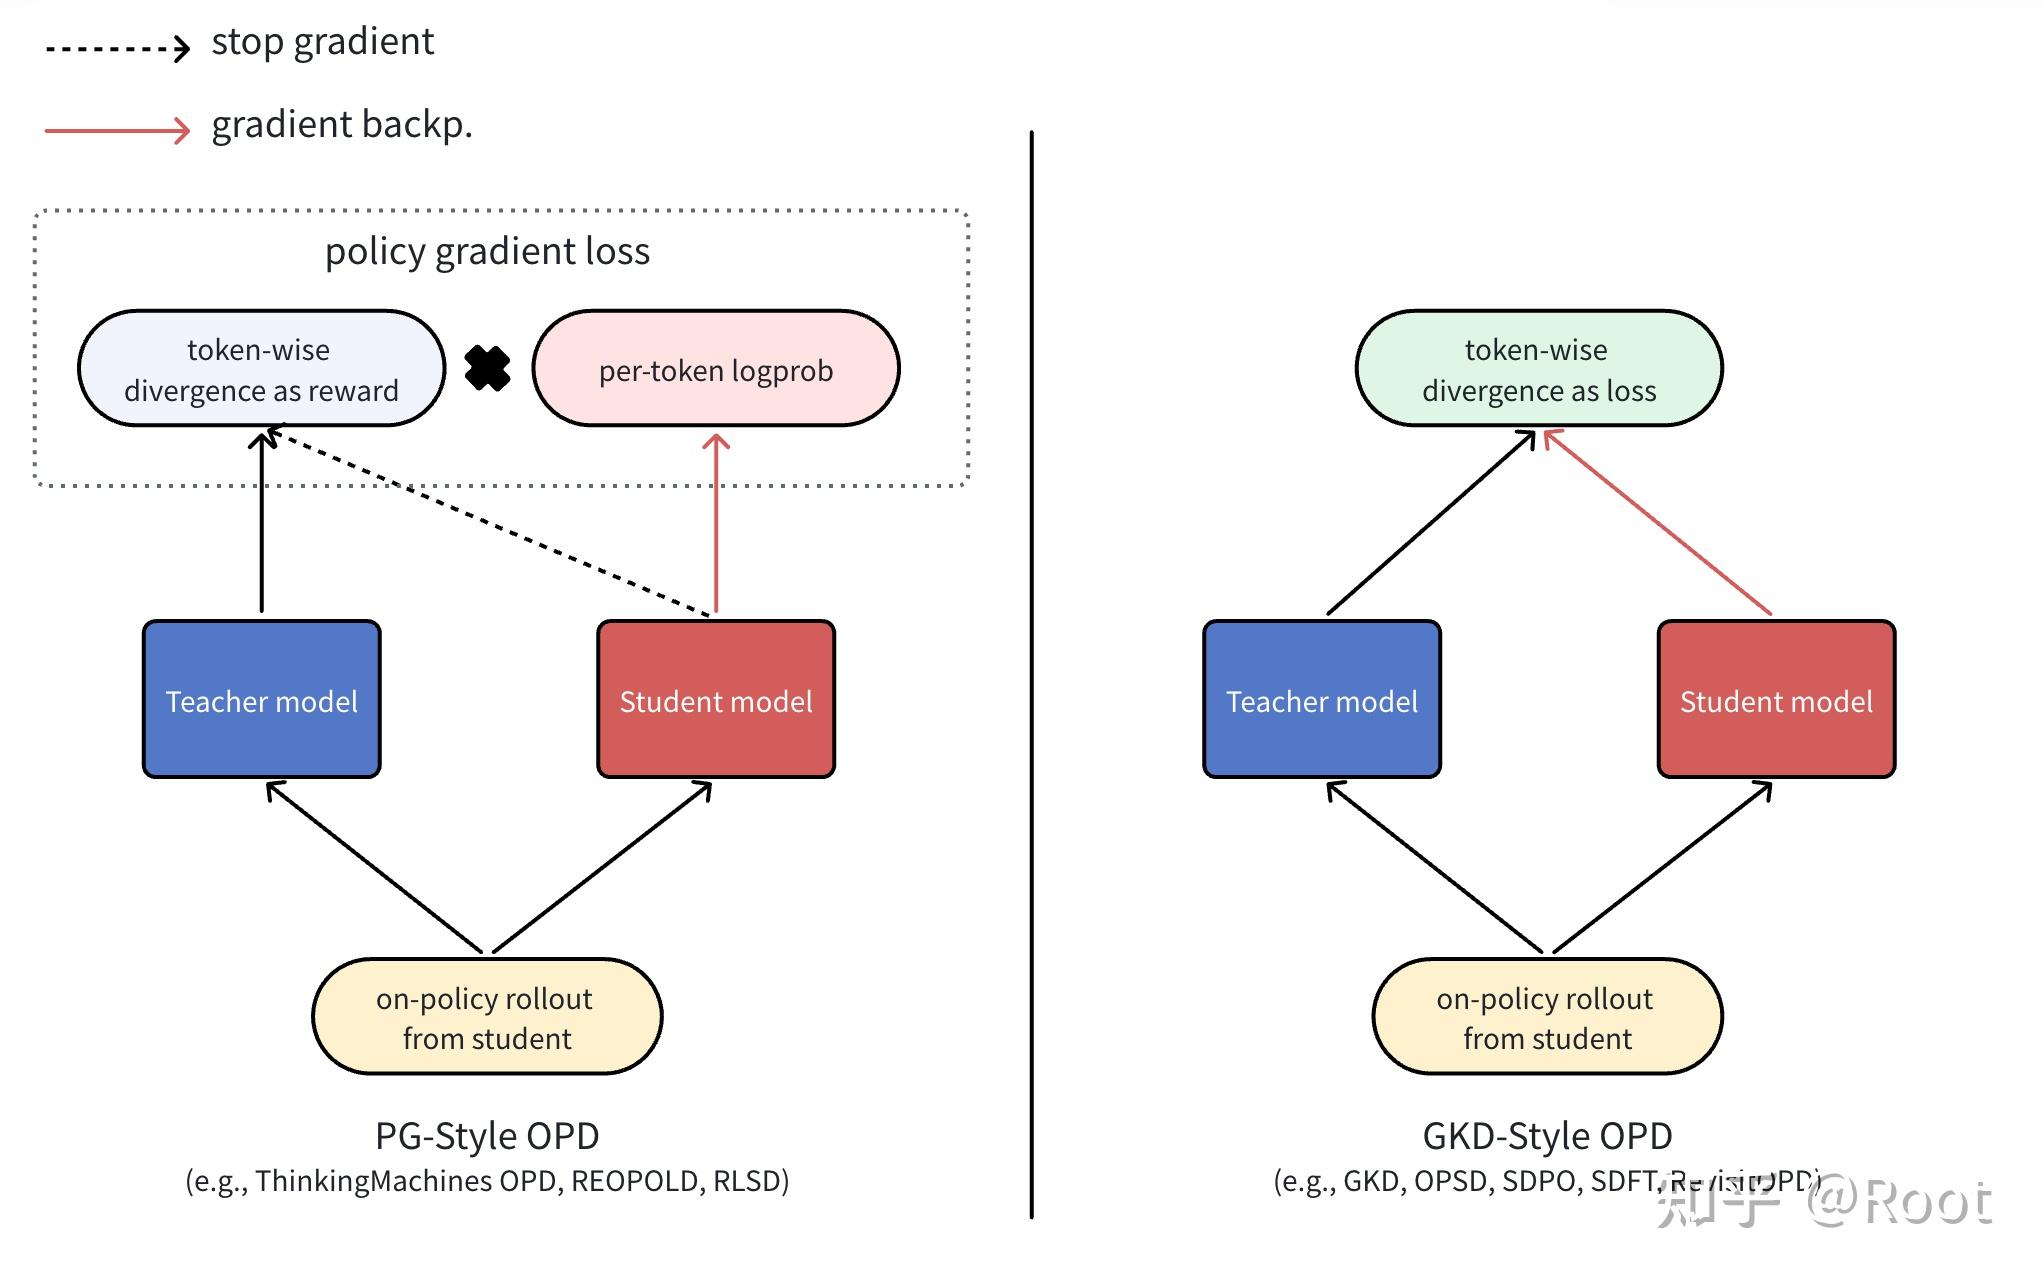
精选文章 从OPD与反向KL的关系到OPD的两种形态以及路线之争 作者:Root 原文:https://zhuanlan.zhihu.com/p/2027548813129267030 前言 On-policy distillation最近在LLM后训练领域非常火,我也一直有在关注OPD/OPSD相关论文的进展。之前,我一直认为这波OPD热潮涌现的一系列方法都可以
精选文章 Rethinking On-Policy Distillation of Large Language Models: 现象、机制与配方 作者:恰似故人归 https://zhuanlan.zhihu.com/p/2023482883415835093 这两年大家谈 LLM post-training,常见的叙事是两条线: 一条是 outcome reward 的 RL 一条是 teacher 提供 dense signal 的 kn
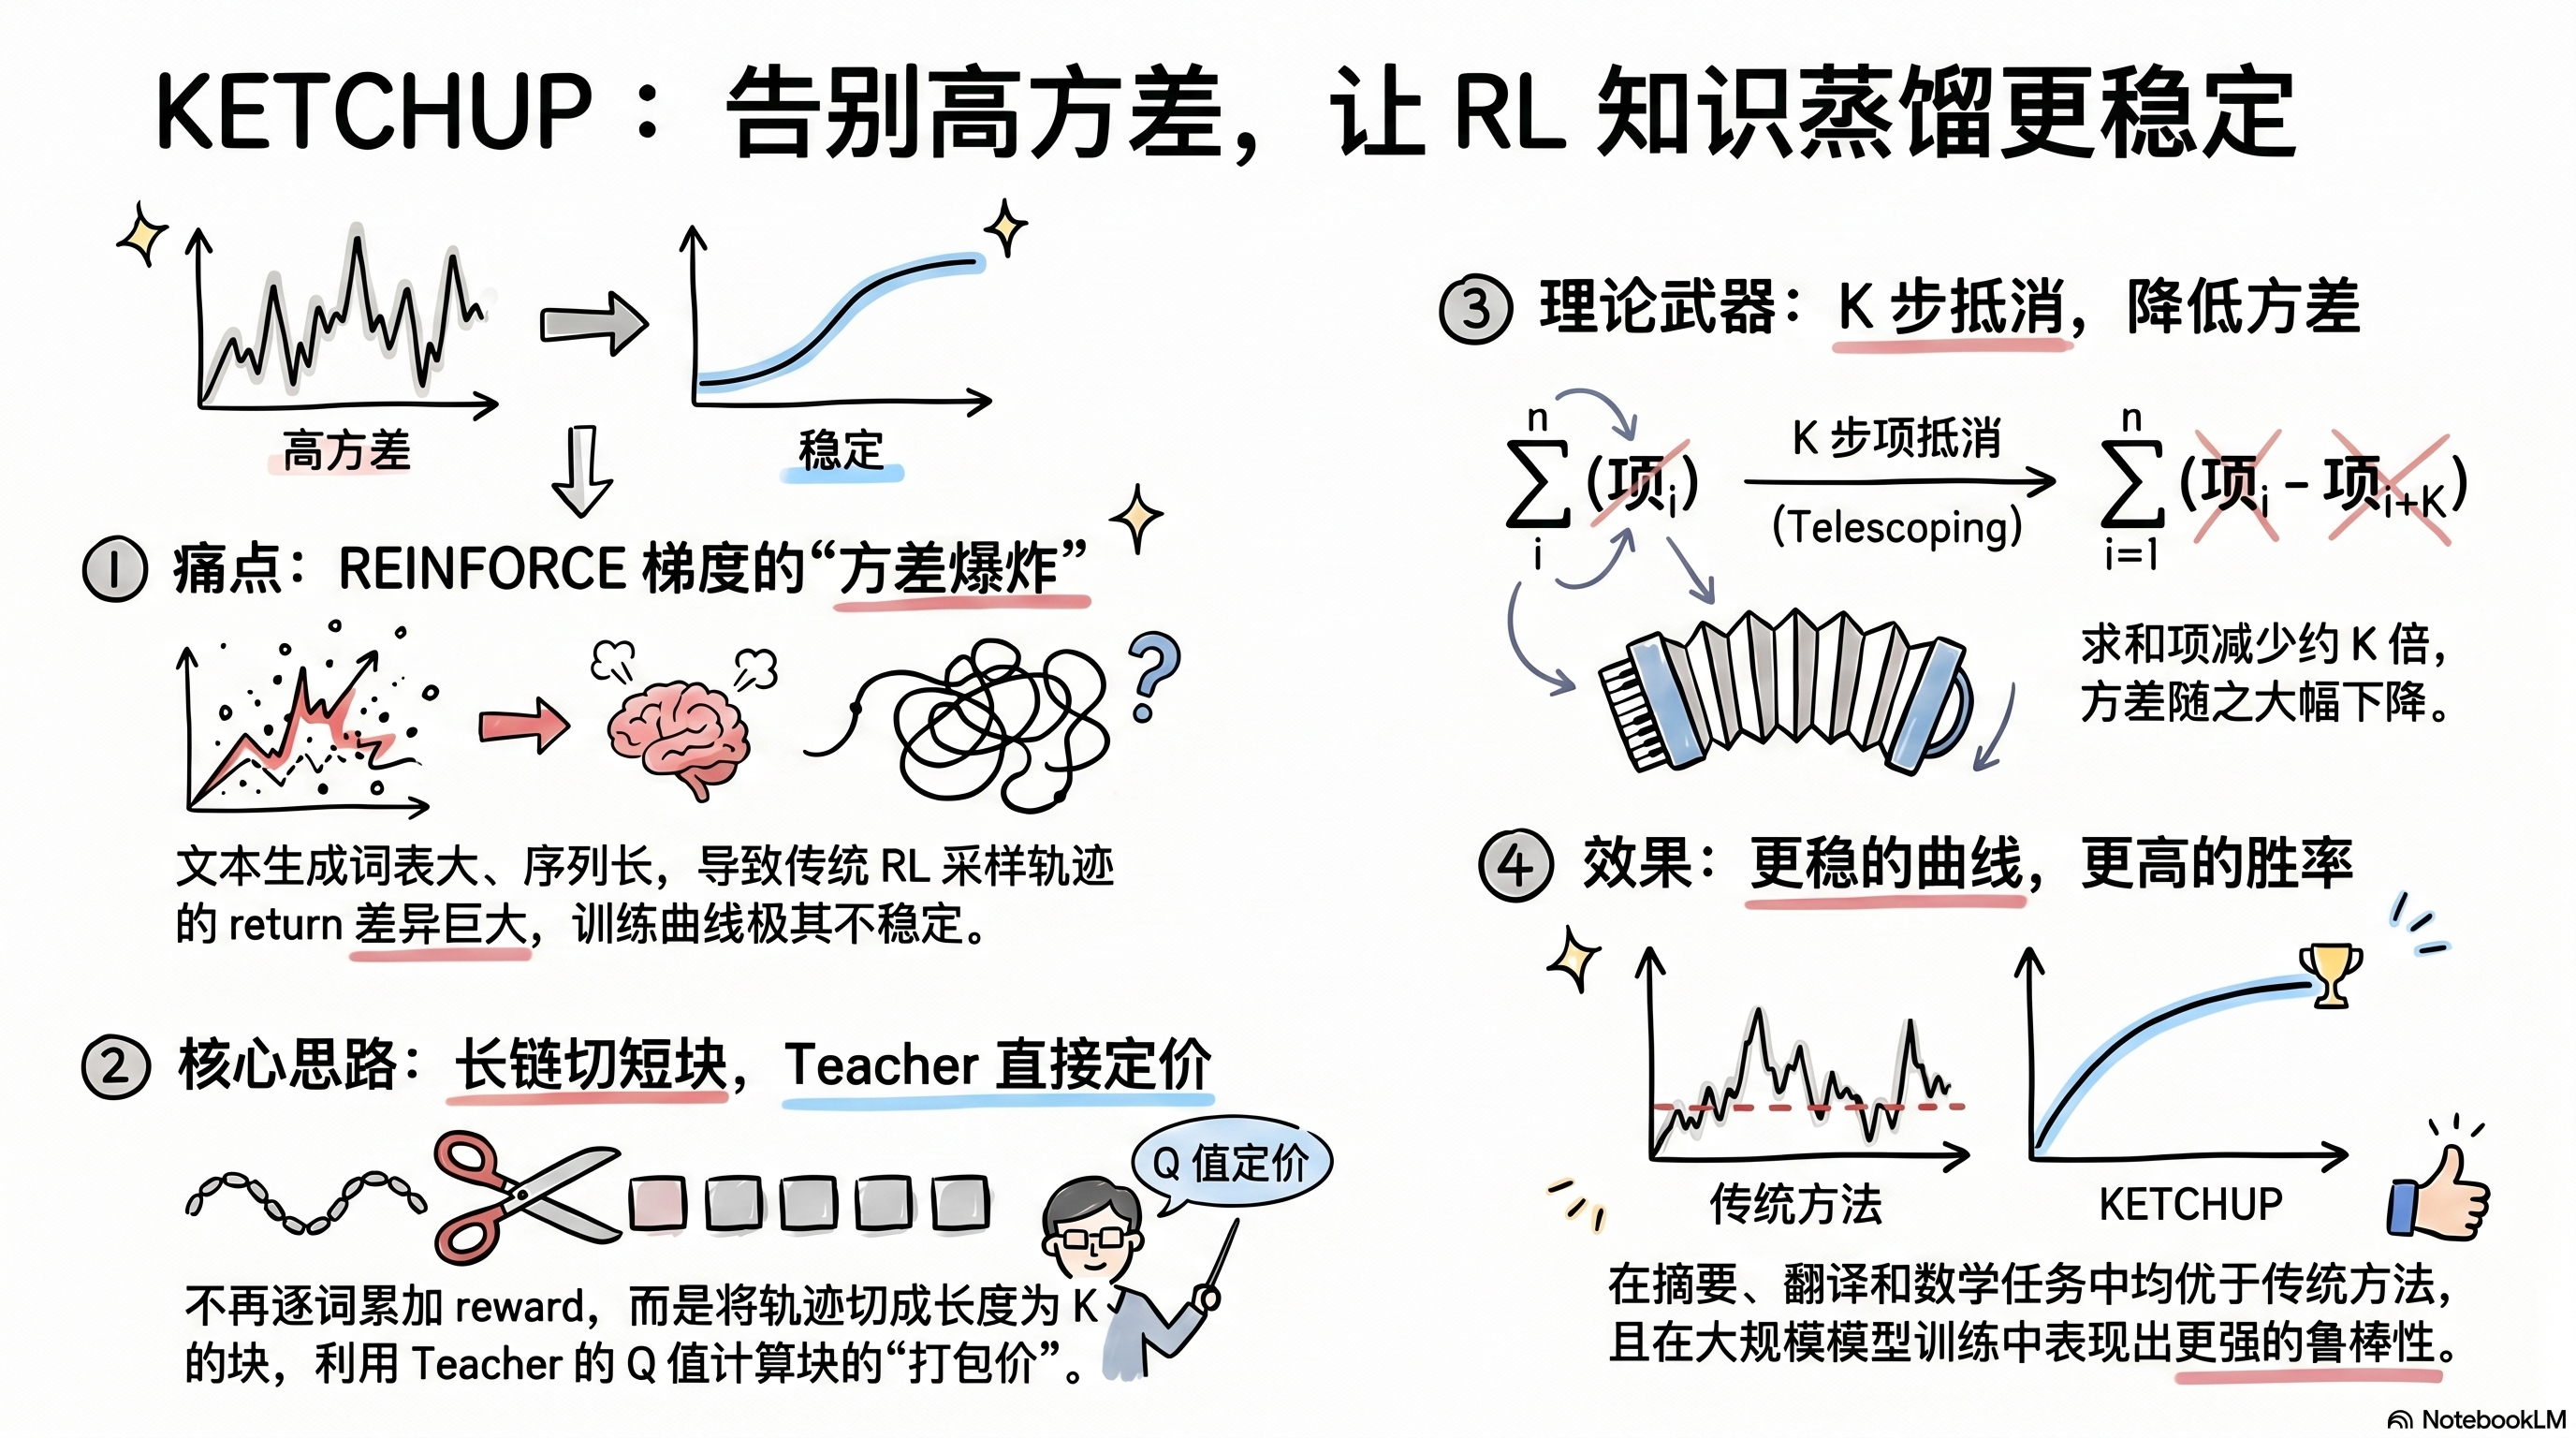
精选文章 用强化学习做知识蒸馏,方差太大怎么办? 作者:Frankdark https://zhuanlan.zhihu.com/p/2026908932694647597 最近在做 RL-based knowledge distillation 的过程中,我们被一个老生常谈的问题折磨了很久:REINFORCE 的梯度方差太大,训练极其不稳定。 最
精选文章 On-Policy Distillation 三大流派:一个方法解决两道难题 痛点与破局 RL 训练过的人都知道那种感觉——跑了三天 GRPO,token 消耗是 SFT 的十几倍,最后一看提升,几乎为零。 问题出在哪?Reward 信号太稀疏,credit assignment 做不到 token 级,rollout 全错时梯度直接归零。 但 SFT 也有自己的软肋:推理时