On-policy distillation 正在成为大模型 post-training 的标配。Qwen3、MiMo、GLM-5、DeepSeek-V4——2025 年以来几乎所有头部模型都在用它:学生模型生成自己的 rollout,教师模型在每一个 token 位置上提供分布监督,密集、精准、高效。
清华团队在 Rethinking OPD 系列工作中,聚焦 OPD mechanism,希望回答这样两个问题:
(1)OPD 什么时候能高效地 work?

Rethinking On-Policy Distillation of Large Language Models:Phenomenology, Mechanism, and Recipe
https://arxiv.org/abs/2604.13016
https://github.com/Thinking-Space/Rethinking-OPD
(2)为什么 OPD 在一条样本上,也能在几百步的训练中持续稳定提升,接近全量数据的效果?

Rethinking On-Policy Distillation of Large Language Models II: One Training Example
https://arxiv.org/abs/2609.04172
https://github.com/Thinking-Space/One-Shot-OPD
首先,更强的教师不一定是更好的老师。我们发现 OPD 能不能启动,取决于师生之间的 thinking pattern 是否一致,而不是教师的 benchmark 分数有多高。Strong ≠ Learnable。
其次,OPD 是"数据撑死"但"算法饿死"的:
- 从数据角度看,一条样本已经覆盖了全量数据 OPD 所访问状态空间的大部分;
- 从算法角度看,每一步更新能消除的剩余 teacher-student gap 的比例不依赖于数据量。
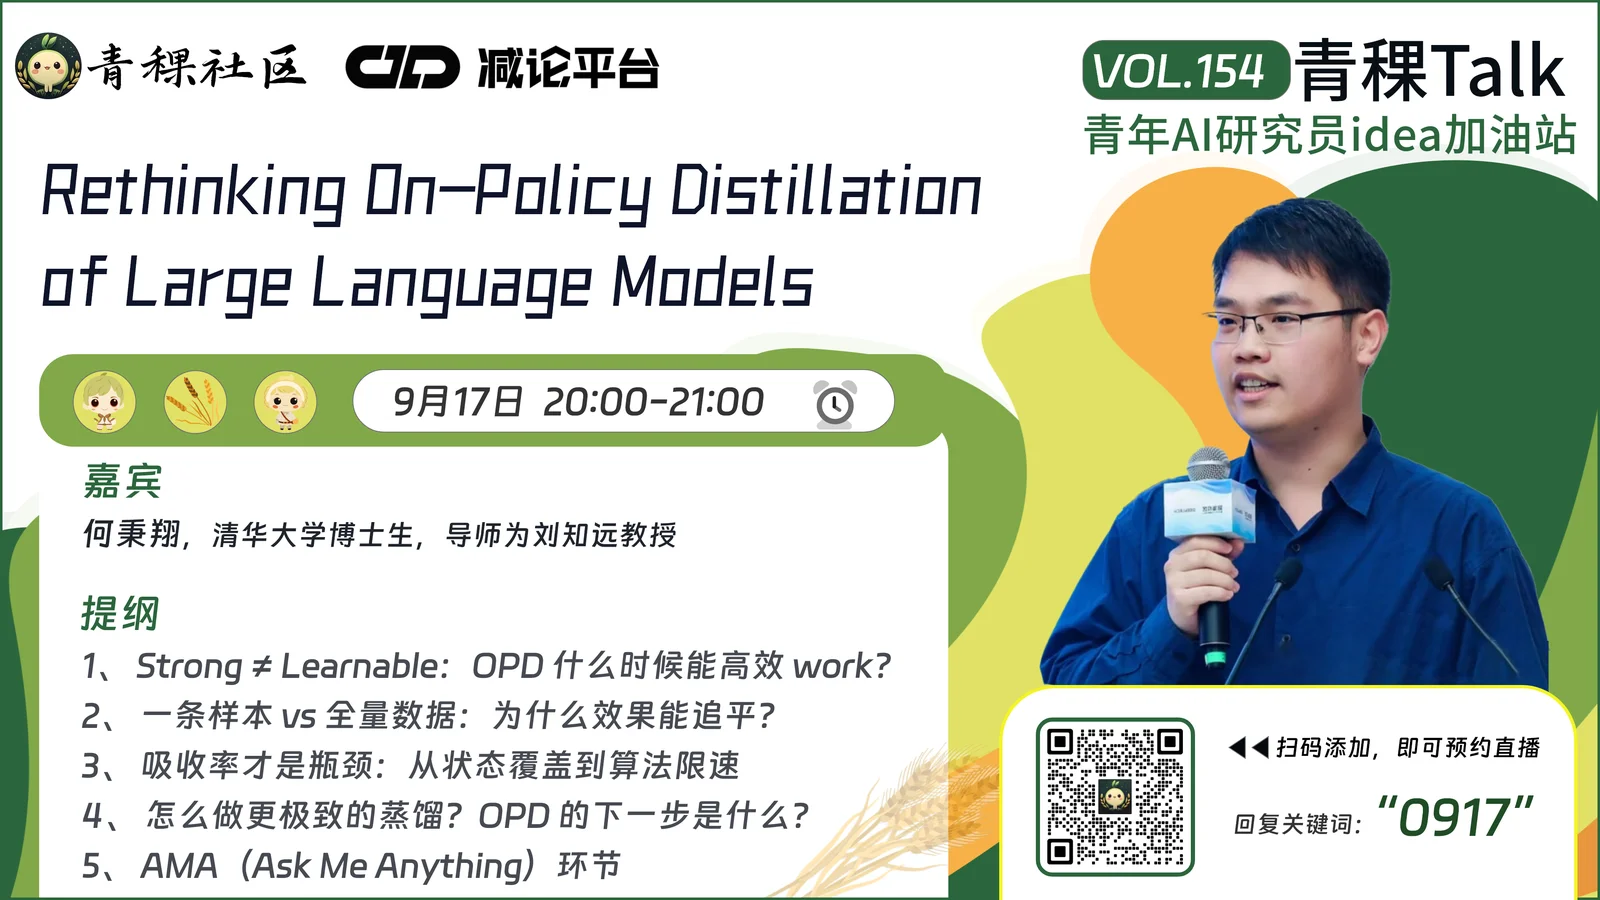
9月17日(周四)晚8:00,青稞Talk 第154期,青稞社区邀请到清华大学博士生何秉翔,和大家一起《Rethinking On-Policy Distillation of Large Language Models》。
青稞介绍
何秉翔,清华大学计算机系 2024 级博士生,导师为刘知远教授。主要研究方向为大模型强化学习和自进化。其代表工作包括 JustRL、Unsupervised RLVR、Rethinking OPD,曾在 ACL、ICLR、NeurIPS 等人工智能国际顶级会议发表多篇论文,谷歌学术累计被引 2700 余次。曾获青源 InnoVibe 2026 最受瞩目学术新星、入选中国电子学会-腾讯博士生科研激励计划。
主题提纲
Rethinking On-Policy Distillation of Large Language Models
1、Strong ≠ Learnable:OPD 什么时候能高效 work?
2、一条样本 vs 全量数据:为什么效果能追平?
3、吸收率才是瓶颈:从状态覆盖到算法限速
4、怎么做更极致的蒸馏?OPD 的下一步是什么?
5、AMA(Ask Me Anything)环节
直播时间
9月17日(周四)20:00 - 21:00=