作者:朵朵菊花向阳开
原文:https://zhuanlan.zhihu.com/p/2079700159114507443
青稞社区为科研人员提供成果宣传支持,如有优秀研究成果分享推广,欢迎投稿联系:aiFreeCode
我们很高兴发布 Rethinking OPD 系列工作的第二篇,从数据视角看 OPD。自从 Rethinking OPD I 发布后,我们继续探索 OPD 的 mechanism,这次我们问了一个更极端的问题:为什么 OPD 在一条样本上,也能在几百步的训练中持续稳定提升,接近全量数据的效果?
Rethinking On-Policy Distillation of Large Language Models: 现象、机制与配方
我们的回答是:OPD 是 "数据撑死" 但 "算法饿死"。
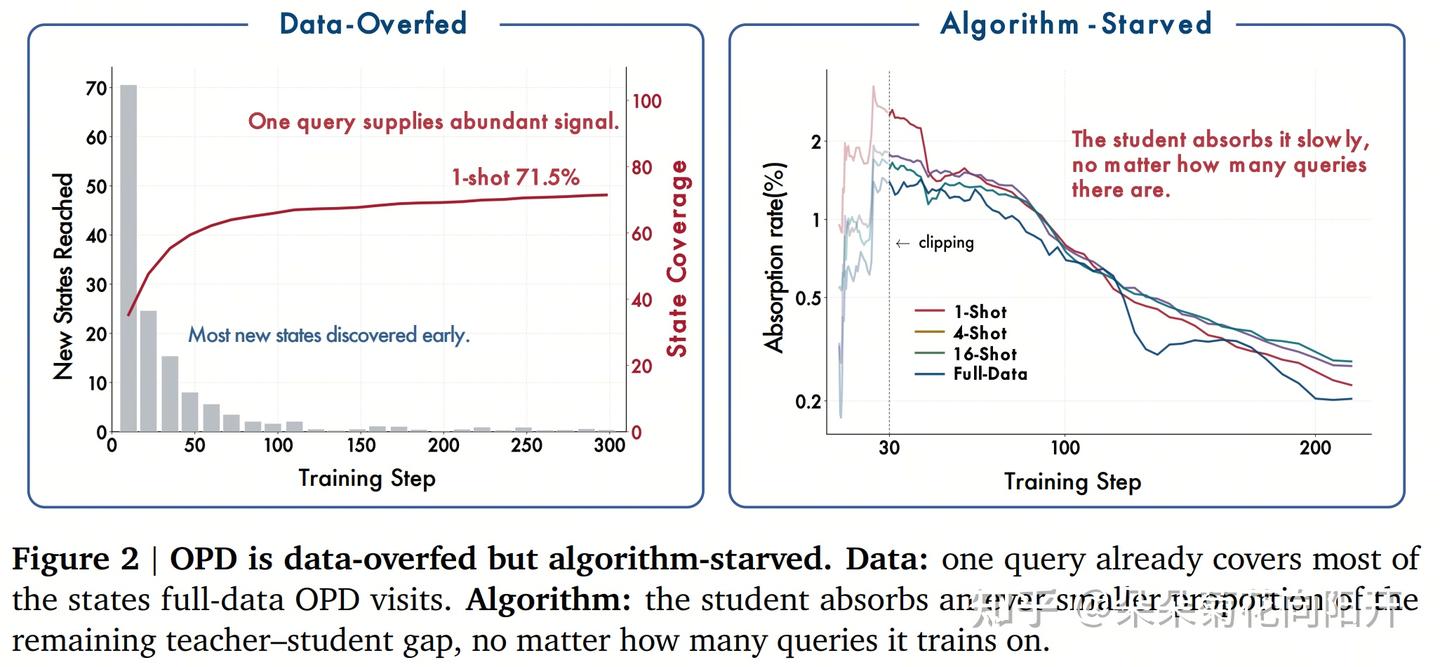
从 data 角度看,OPD 训的不是问题,而是 student 在 on-policy rollout 过程中访问到的 state。一条 query 配上每步 N 条 rollout,就能产生大量带 teacher 监督的 states。
我们定义了 state coverage:一条 query 已经覆盖了 full-data OPD 所访问 state space 的 71.5%,16 条语义多样的 query 覆盖率达到 98.9%,追平 full-data。
从 algorithm 角度看,真正限制训练效率的似乎不是数据供给,而是吸收率(absorption rate):每一步更新能消除的剩余 teacher-student gap 的比例在持续下降。这个下降速度在 1 条、4 条、16 条、甚至全部 17k 条 query 上几乎一样。
这个结论在 MOPD 上也成立:每个领域 16 条语义多样的 query,就能匹配 full-data MOPD。
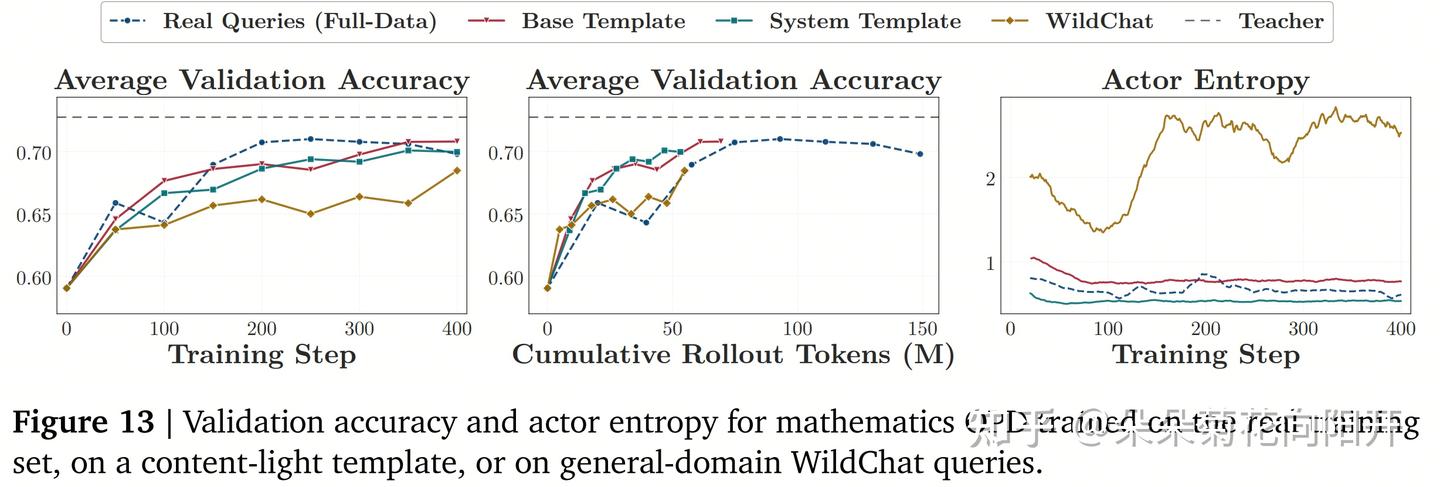
更极端地,我们试了空模板(只保留 <think>)和完全 off-domain 的 WildChat 对话数据(只有 0.17% 和数学相关),两者都能接近 math 的 real-data 基线,虽然只用了后者三分之一到一半的 rollout tokens。
这并说明 input 的作用不只有提供题目,它更像是一个 state generator,只要能把 student 的 reasoning 启动起来,放到有 teacher 监督价值的状态区域就行。
📝 Paper: https://huggingface.co/papers/2609.04172
💻 Code: https://github.com/Thinking-Space/One-Shot-OPD
X Thread: https://x.com/HBX_hbx/status/2095716853196747175
这个问题是从哪来的
问“数据能减到多少”这件事,之前就有不少工作做过。在 RLVR 上,one-shot RLVR 已经把这个实验做过一遍:一道题,模型能持续涨一千多步;在 OPD 上,TML 的 blog 也做过一条样本的 OPD。
RLVR 的信号定义在轨迹末尾,所以它的训练输入需要是一道能被验证的题,而且难度得卡在“有的 rollout 对、有的 rollout 错”的位置上,否则一组 rollout 全对或全错,GRPO 的 advantage 就是零。
OPD 的信号定义在每一个访问到的位置上,跟这条轨迹最后对不对可以没有关系。
这个差别意味着,“减数据”这件事在 OPD 上很可能是另一个故事。值得一提的是,已经有一批工作从算法侧观测过 OPD 的训练动态,包括对更新几何的分析、对“哪些 token 是可学的”的刻画、以及对失败模式的归因。
这些工作解释了 OPD 为什么有效,我们做的是它们留下的另一半:数据在这里面起了什么作用,以及数据和算法怎么互相牵制。
One-Shot Phenomenon:一道题,喂了几百步
把训练集换成一道题,其余全部不动,然后跑几百步。然后我们在 4 个 task domain (math / coding / instruction following / agentic tool use) 和 3 个 model family 上跑 one-shot OPD。
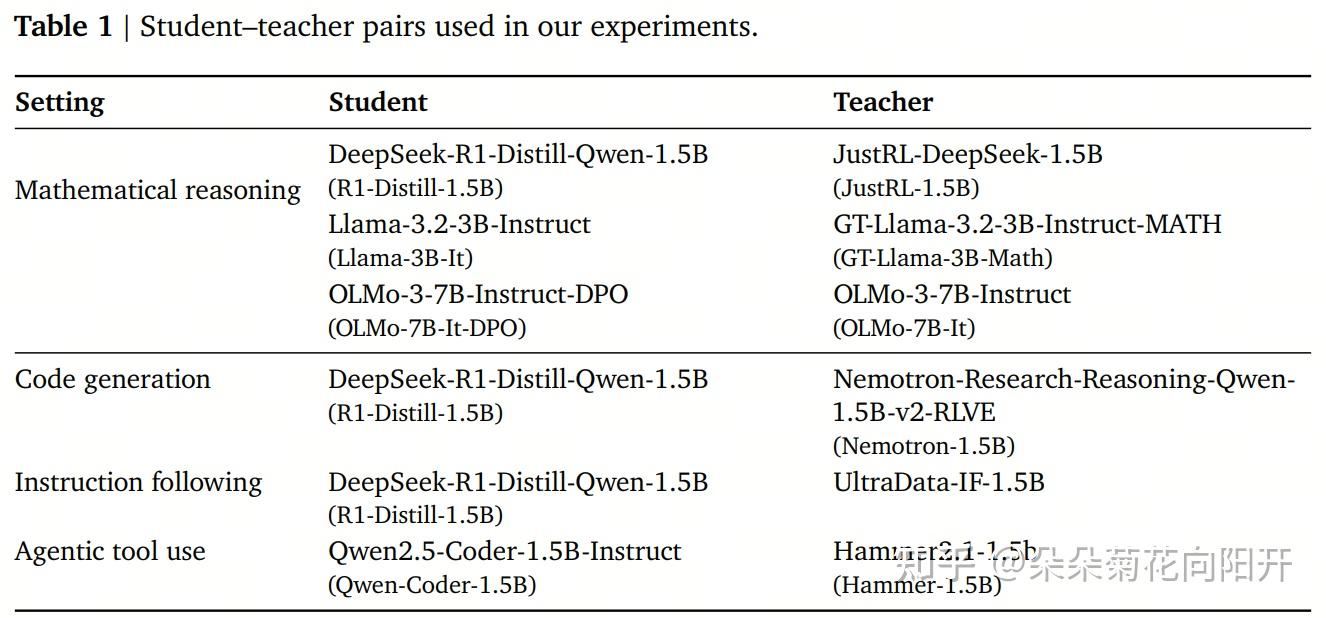
学生和 teacher 都在同一家族里配对,数学上是 R1-Distill-1.5B 配 JustRL-1.5B,代码上配 Nemotron-1.5B,指令跟随上配我们自己训的一个 UltraData-IF-1.5B,工具调用上是 Qwen-Coder-1.5B 配 Hammer-1.5B。
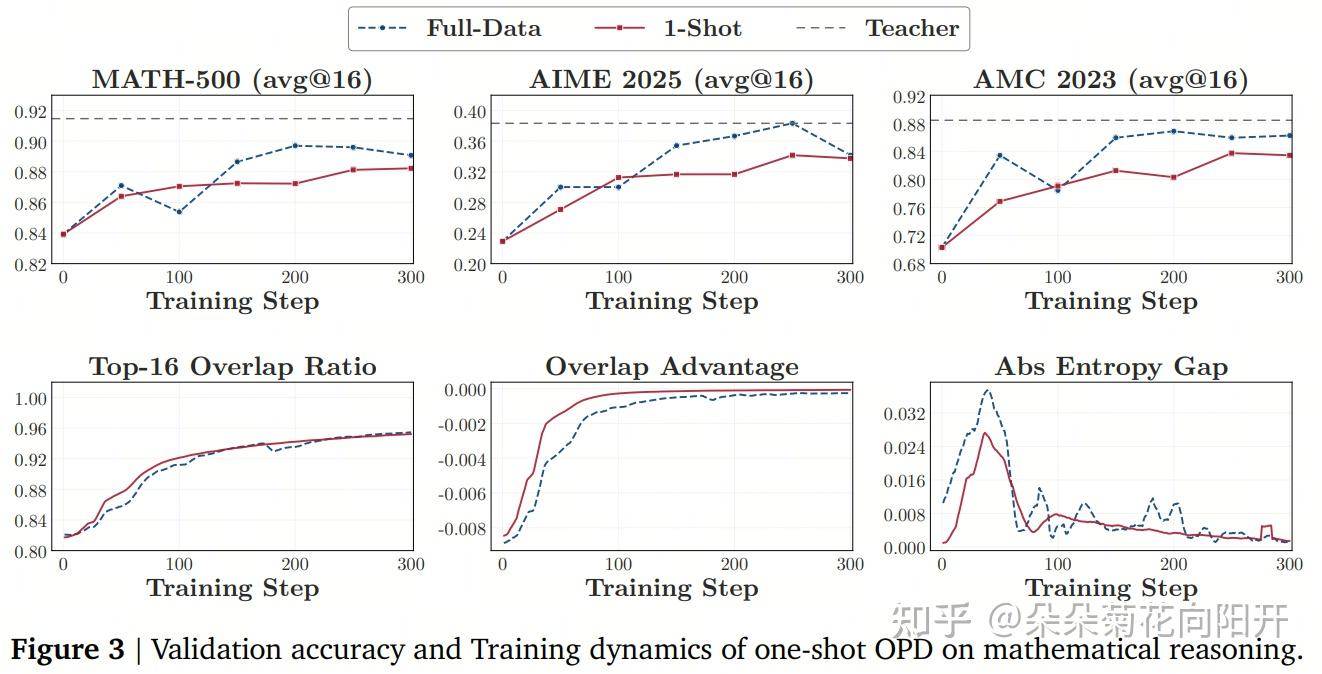
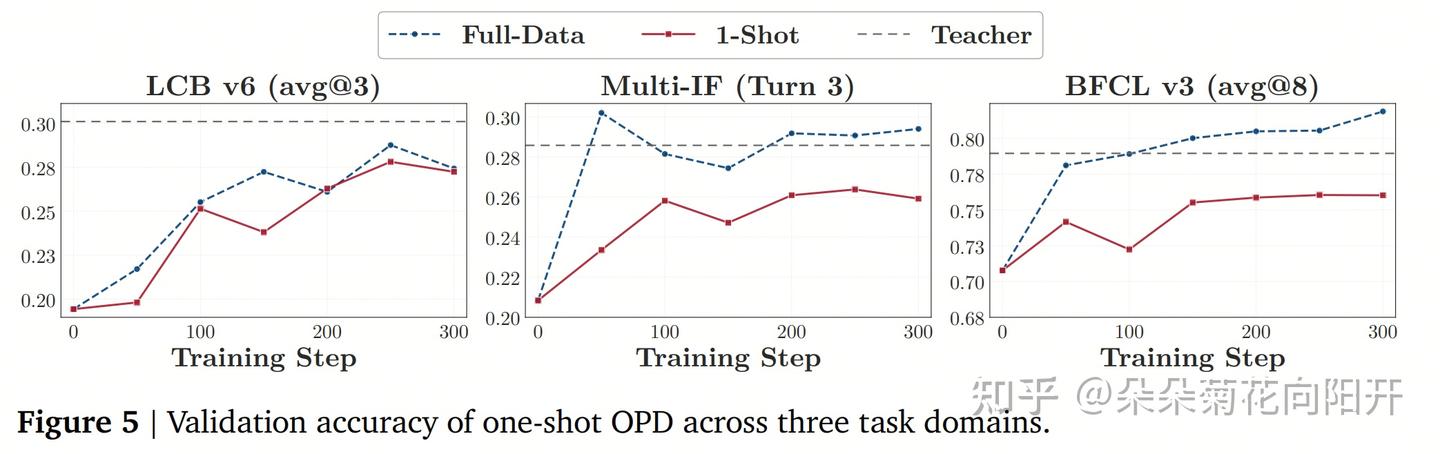
结果是一道题就足以稳定地把学生往 teacher 那边推。 数学上单题训练到 step 300 达到 68.5,全量数据是 69.8,恢复了师生差距的 69%、全量增益的 87%(下图)。
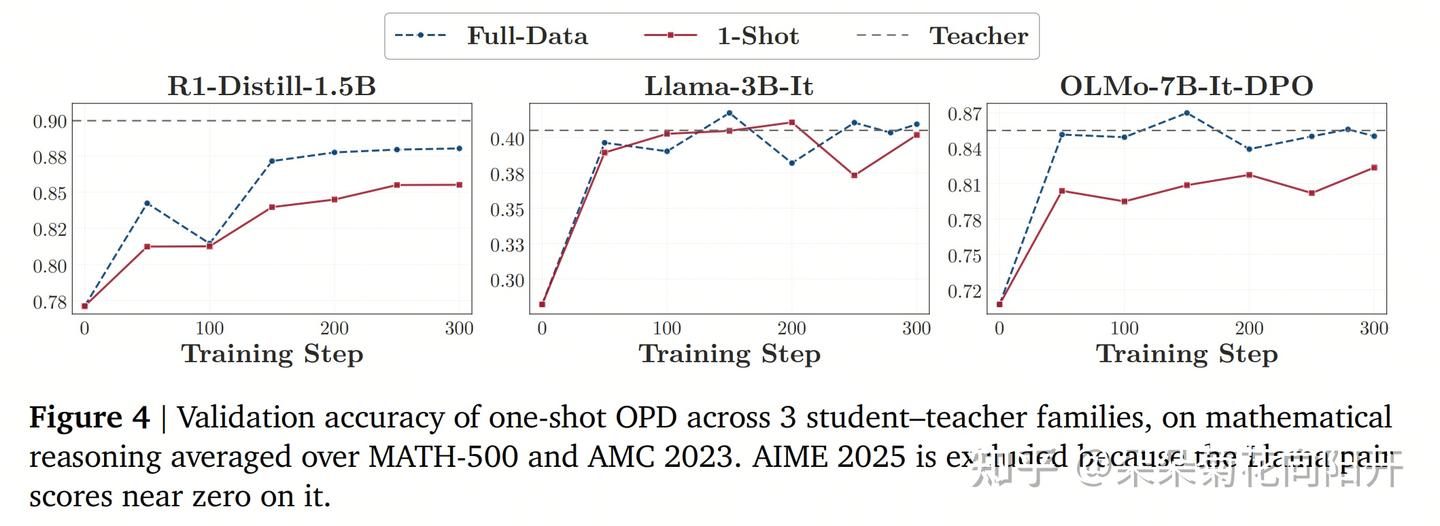
换到别的家族,三对师生的平均分分别从 77.1、28.2、70.8 涨到 85.5、40.2、82.4。
换到别的域,代码、指令跟随、工具调用分别恢复了师生差距的 73%、66% 和 64%。
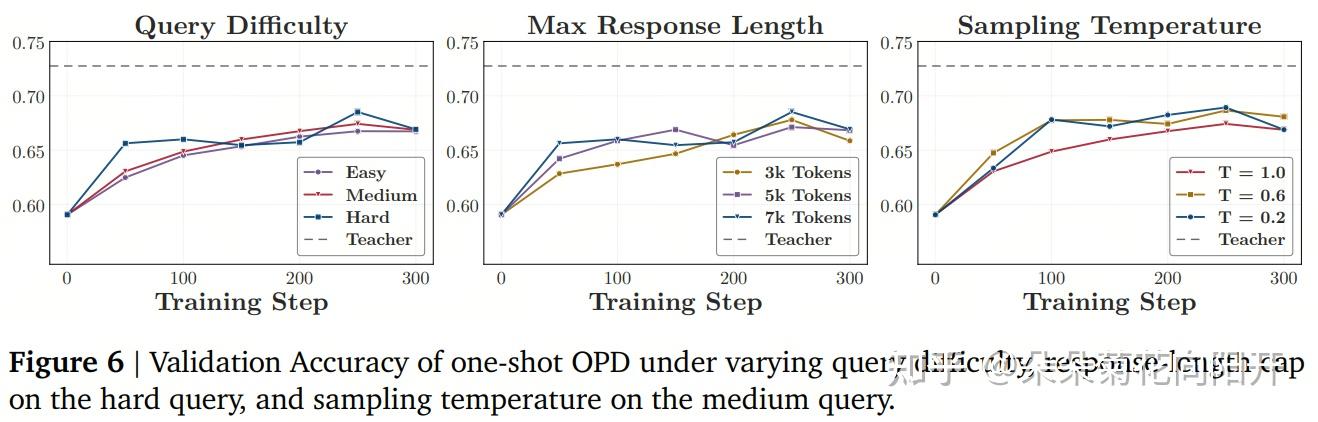
此外,这个效果对训练题本身的性质似乎不太敏感。难度从 8/8 (Easy) 换到 0/8 (Hard),三条曲线的终点几乎重合;把响应长度上限从 7k 砍到 3k,采样温度从 1.0 降到 0.2,结论不变。
那道 0/8 的难题在 300 步里一次都没被做对过,训练准确率全程是 0,模型也在涨。这一点也是 OPD 和 RLVR 很不同的一个地方,因为在 RLVR 里,一道永远做不对的题似乎不太能给出 advantage?
但是,一道题能让模型走得很远,但走不到全量数据能到的地方。那么,一道题到底给了模型什么,让它能走这么远?下一步我们把视角切到“状态”上,去看看一道题的 rollout 究竟覆盖了多大一块地方。
Data Perspective:一道题就摸到了 71.5% 的状态空间
在 OPD 中,一道 query x 和一条采样出来的响应 y ,在每个 token 位置 i 上都产生一个状态 s_i = (x, y_{<i}) ,每个状态都配着 teacher 给的一个目标分布。每步 64 条 rollout,即使只有一道题,一步下来也是几万个带监督的状态。
所以“题目数量”这个计数方式,可能严重低估了 OPD 实际拿到的监督量。 为了把“覆盖了多大一块”量化出来,我们定义了一个叫 state coverage 的指标:
- 表示:每个状态用 teacher 在这个状态最后一个 token 上的最后一层隐向量来表示
- 参考空间:把全量 OPD 整个 run 访问过的状态汇成一个池子,每条 rollout 上均匀取 8 个位置。这个池子留出一部分不参与聚类,单独作为一个设定来测,叫 full data (held-out)。
- 聚类:PCA 之后用 K-means 切成 K=200 个簇,每个状态归到最近的那个簇。
一个设定的状态覆盖率,就是它的 rollout 碰到的簇占这 200 个簇的比例。它记录的是“碰到过哪些簇”,不是“碰了多少次”,而且参考空间是全量 run 定义出来的,所以 100% 是全量 OPD 能达到的水平,不是构造上的上限。
题目数量只告诉我们喂进去了多少,不告诉我们这些题把模型带到了哪里,而后者才是 teacher 真正能施加影响的地方。结果是一道题就摸到了全量状态空间的大部分,而且大半在最初的那几十步里就摸完了。 到 step 300 是 71.5%,到 step 100 已经是 65.9%,之后 200 步只再涨 5.6 个百分点。重复从同一道题采样,确实还在不断发现新的簇,但速度衰减得非常快。
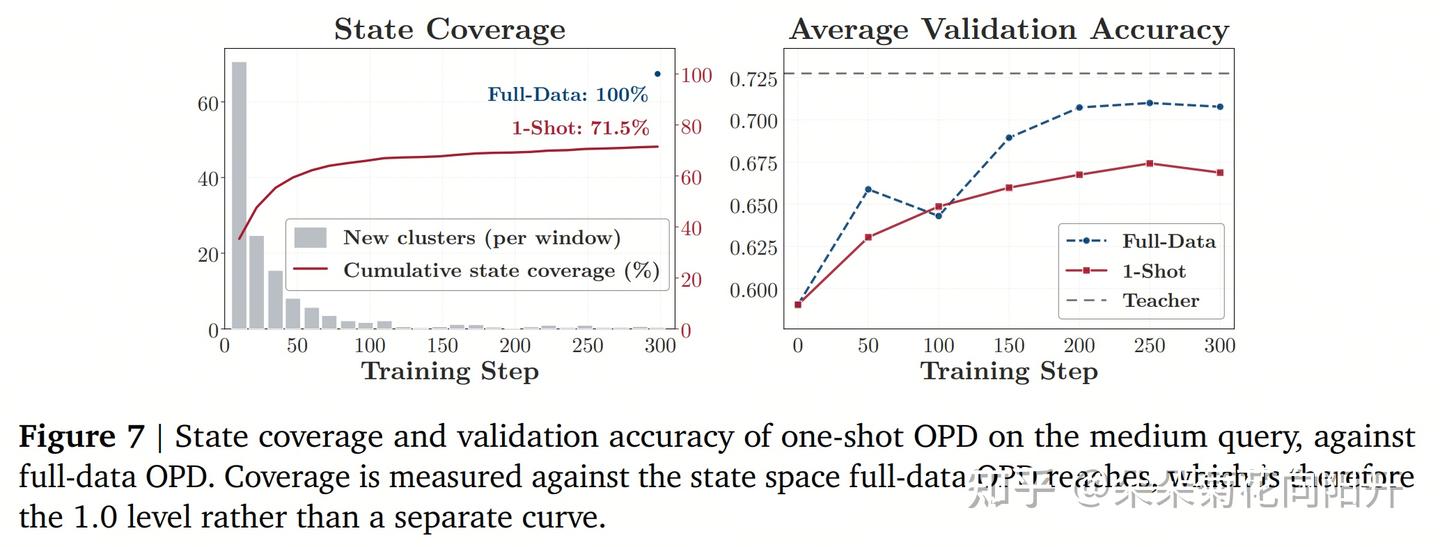
不过,这只是相关性:一个训练得好的 run 也可能只是顺带多走了些地方,而多走的那些地方什么活都没干。所以我们直接去消融状态数量本身,从两个方向各做一次控制:
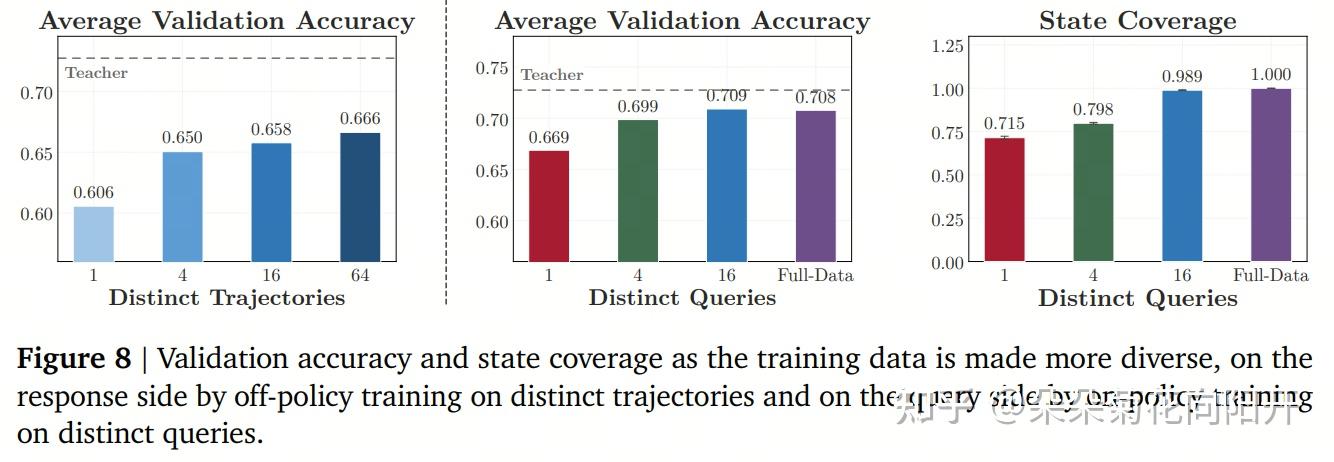
(1)在回复侧,我们一次性从初始学生那里采 64 条轨迹然后冻住,只保留其中 1、4、16、64 条反复用;
(2)在题目侧,我们用 BGE-M3 把 DAPO-Math-17k 聚类,每个语义簇取一个代表,搭出 4 题和 16 题两个 setting。
结果发现:
(1)回复侧,验证准确率随不同轨迹条数单调上升,而这些轨迹唯一多带来的东西就是状态;
(2)题目侧,状态覆盖率从一道题的 71.5% 涨到 16 道题的 98.9%,验证准确率同步涨到和全量持平。
在附录中,我们进一步探究,同样是 16 道题,从 16 个语义簇里各取一道,比从同一个簇里取 16 道在覆盖率和准确率上都更高,后者的覆盖率在 100 步内就平在 76.8% 附近不动了。
所以,一道题多值多少钱,取决于它能不能带模型走到前面的题没走到的地方。到这里数据侧的问题算是回答了:一道题之所以能“改善这么多”,是因为它供给的监督本来就接近全量。但还有另一半没答——如果监督这么早就给足了,为什么模型要花几百步才吃完?
Algorithm Perspective:吸收率跟喂多少题关系不大
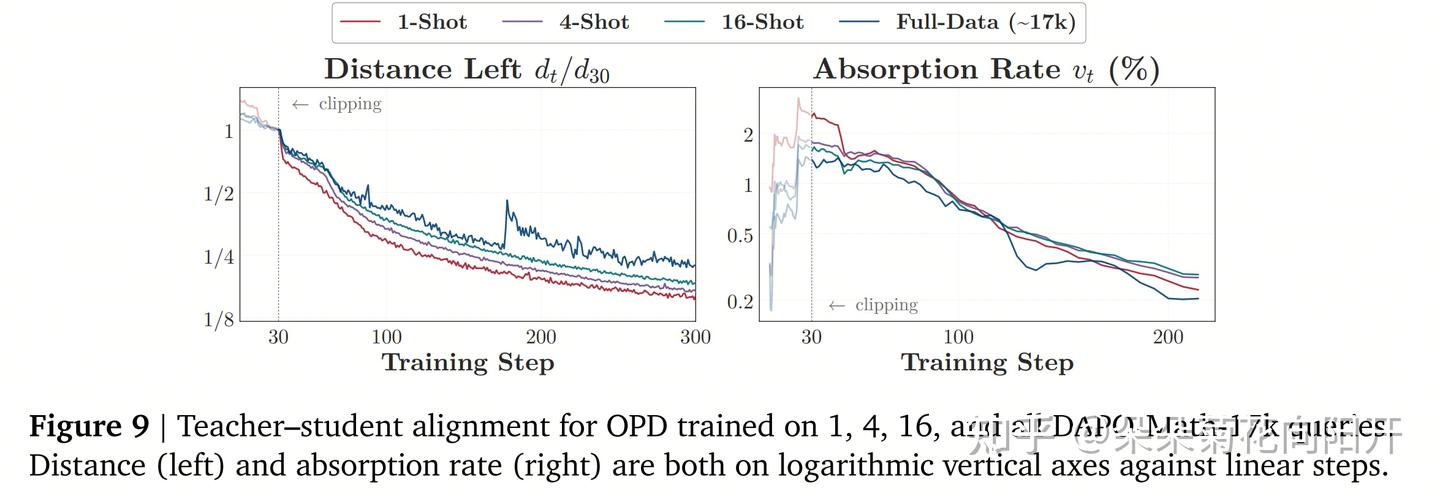
我们用两个量来描述“吃到哪了”和“吃得多快”。距离 d_t 是学生在它访问到的位置上,和 teacher 的 per-token log 概率差的平均绝对值,取绝对值是为了不让正负抵消,这样 d_t 只有在两个分布真的一致时才趋近于零。吸收率 v_t = (d_t - d_{t+1})/d_t,就是一次更新吃掉了剩余距离的百分比。
第一个观察是:学生一直在进步,但越来越慢。 距离在整个 run 里都在下降,模型从没卡住;下降的是吸收率——在对数的距离轴上,恒定的吸收率会画成一条直线,而实际的四条曲线都在往平里弯。每次更新吃掉的比例都比上一次少,这可能能解释为什么一个 run 需要几百步而不是几十步。
第二个观察是:这条下滑曲线跟训练集大小几乎没关系。 1 题、4 题、16 题、全量 17k 题,四个 run 到 step 300 各自吃掉了自己 step-30 距离的 78% 到 84%,而且在训练过程中减速的倍数也接近。一道题既不会让对齐变慢,也不会让它变快:这个节奏看起来是 OPD 这个算法的性质而不是训练集的性质。
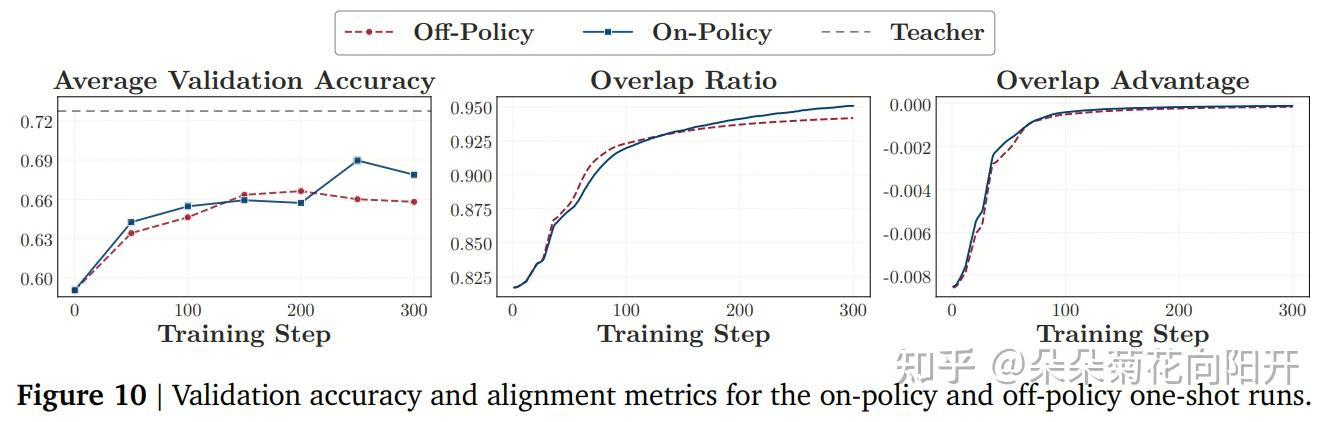
有一种解释是:on-policy 训练一直在产生新状态,run 之所以这么长,是因为新状态的供给一直没断。我们尝试让一个 run 全程复用初始学生采出来的那 64 条固定轨迹,训练状态从头到尾不变。
结果是它照样稳稳涨了约 200 步才停下来,对齐指标也是同样慢的节奏。所以把新状态的供给掐掉,run 并没有变短——一个固定的状态集,本身就够让 OPD 跑上几百步。
两侧合起来就是那句话:OPD 拿到的监督,比它的算法能吸收的多。一道题供给的那部分监督,其实很大一块到最后都没被用上。但是说实话对业界而言,可能这件事不重要,如果有大量的数据,直接流式全部注入进去能让上限更高似乎更重要。
Multi-Teacher OPD:每个域 16 道题,好像也足够了
上面的结论如果只在单域单 teacher 上成立,实用价值有限。现在前沿的后训练流程里更常见的是多 teacher OPD(MOPD):一个学生同时训多个域,每道题路由到它自己域的 teacher。我们在数学、代码、指令跟随三个域上做了同样的阶梯。
结论是同样的:每个域只要十几道语义上互不相同的题,就能打平全量 MOPD。 Step 300 上,学生从 43.5 起步,一题每域是 50.1,16 题每域是 52.9,全量是 52.8——16 题恢复了全量 MOPD 增益的 101%。分域看也不是被某一个域带起来的:数学 93%、代码 136%、指令跟随 109%。
作为参照,三个单域全量 OPD 分开跑合起来是 53.8,比全量 MOPD 高 1.0 分,说明对于这三个域,合到一个 run 里训本身代价不大。
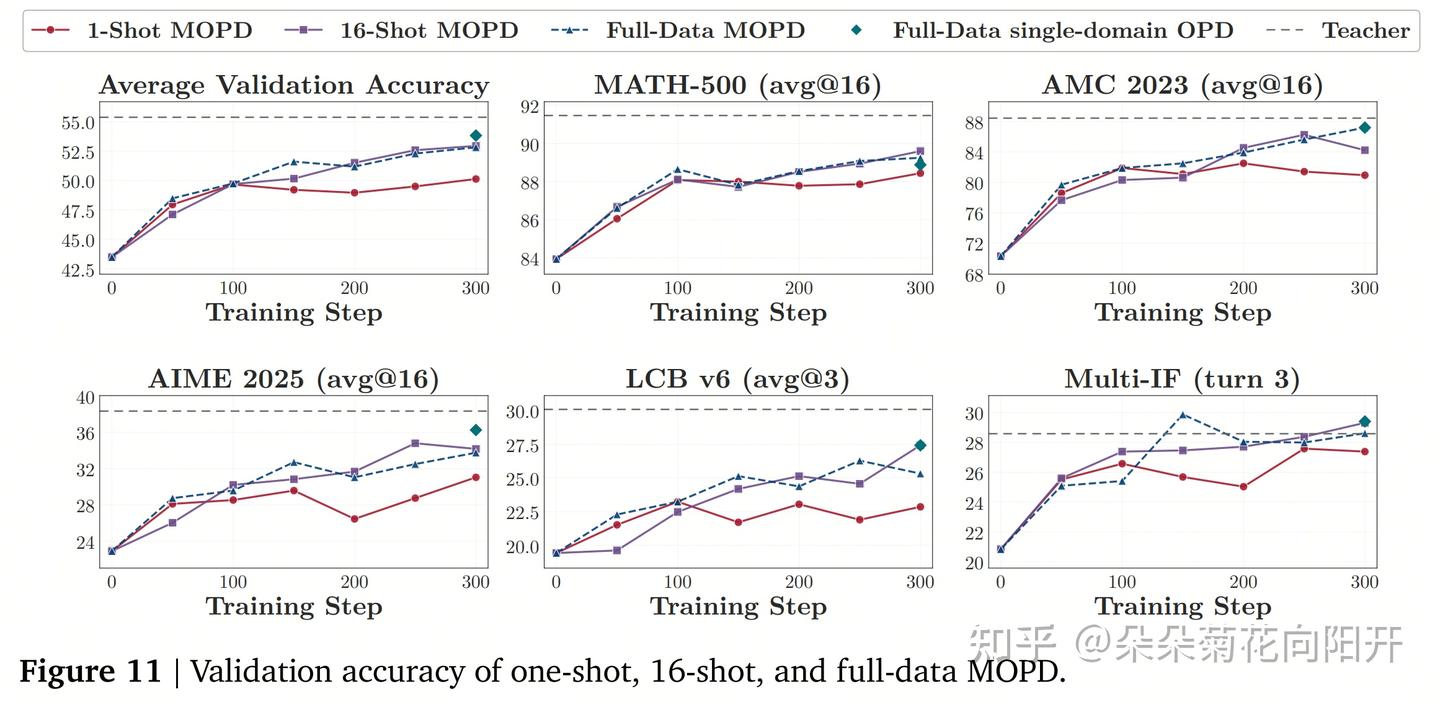
因为 16 题和全量用的是同样的 rollout 和优化预算,所以在这个设定下,把每个域的题目集扩到 16 道以上,平均分上不再有额外收益。需要说明的是,我们的 MOPD 只跑了三个域、每域一个 teacher,teacher 数量继续加上去之后这个结论能延伸多远,我们没有测过。
Discussion:连“不成题的题”也能训
如果一道题真的是通过“它把模型带到哪些状态”起作用的,那顺着推下去会得到一个相当激进的预测:输入里的任务内容也许不是必需的,只要它还能让学生生成出 teacher 有话可说的轨迹。我们把这个预测做成了三级压力测试。
第一级是一个空模板:用户轮是空的,末尾直接跟一个 <think>,不说任何任务、不带任何领域。
第二级是系统模板,在空模板上加一行 domain-specific prompt,点了名但仍然没有题。
第三级是 WildChat——19 万多条真实用户对话,以英文的闲聊、创作、角色扮演、改写为主;看了下,可能只有 0.17% 与数学相关、2.63% 与代码相关。
实验结果:三种条件都能带来一定提升,甚至有的贴近真实数据的 baseline 走,而且只花了它 1/3 到 1/2 的 rollout token。
最后我们把 OPD 和 RLVR 放在同一道题上做了一次受控对比。同样是每步 64 条 query 的 batch,RLVR 每题采 8 条 rollout 按结果打分,OPD 每题采 1 条、逐 token 对着 teacher 打分。跑满 1000 步,OPD 在验证集上的涨幅是 RLVR 的两倍多,同时缩小了自己与 teacher 差距的 72%,按 rollout token 对齐之后结论也不变。
可能的解释是,RLVR 的信号会随着模型学会这道题而枯竭,因为一组八条几乎总是一致,一致的组在 GRPO 下没有 advantage,剩下的更新只是在锐化策略,熵随之塌掉;OPD 的信号定义在每个访问位置上,题目做对之后它还能继续从局部的师生差里学,虽然这个差也在慢慢变小。
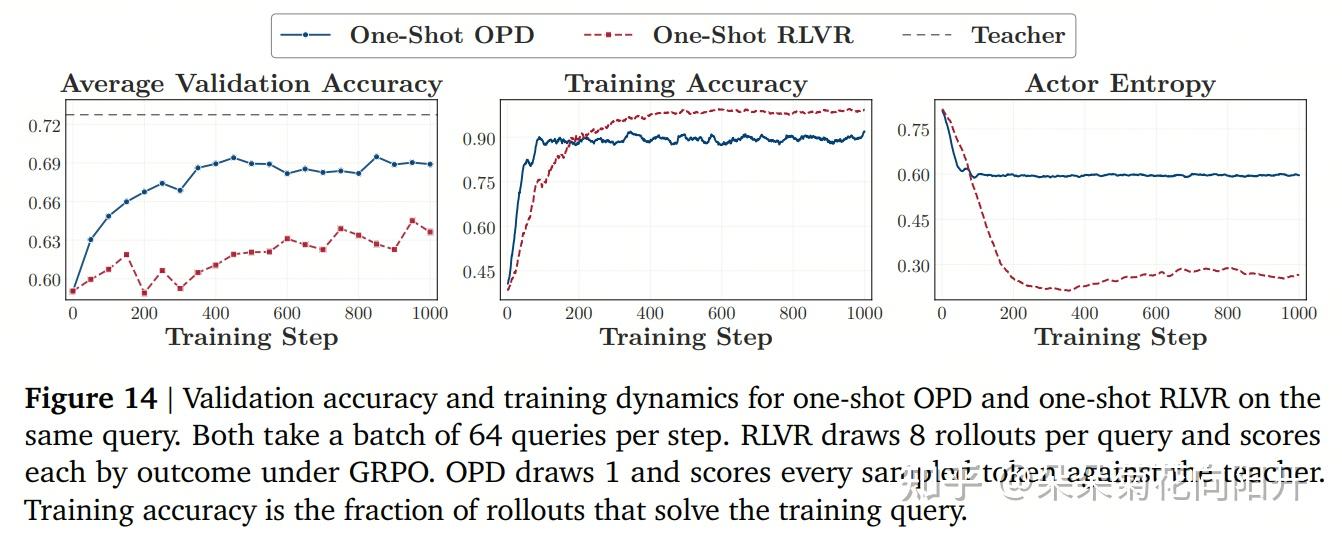
但是两者的天花板也是反过来的:RLVR 不被任何 teacher 的分布拴住,而 OPD 是被训练去匹配一个分布的。所以这不是“OPD 比 RLVR 好”,而是两件事各自受限于不同的东西。RLVR 受限于它的数据能提供多少结果上的差异,OPD 受限于它自己吸收 dense 监督的速度。
最后
再简单补充一下这篇工作的边界和后续方向。首先,
1、 State coverage 是 semantic-level proxy
我们用它来衡量数据效率,但它本身有一些弱点——它是相对于 full-data rollout 构建的 reference space 来定义的,所以报告的是“query set 能达到 reference space 的多少”,而不是“它独立覆盖了什么”。
另外每个 cluster 权重相同,不管它实际被访问得多频繁、teacher 监督还有多少价值。
2、 吸收率为什么会下降,我们还没完全搞懂
这个工作描述了现象(下降速度与数据量无关),但“为什么会这样”是一个更底层的问题——是优化几何?是 KL 约束?还是参数更新本身的特性?这个留待后续。
3、 MOPD 的结论需要在更多教师、更多领域下验证
我们只跑了三个领域、每个领域一个 teacher,16 条 query 能 match full-data,但加更多 teacher 之后这个数字会怎么变,还不清楚。
再说后续,我们觉得三个方向可能可以看:
1、 用 state coverage 选数据
既然 key 不再是“收多少题”,而是“诱导哪些 state regions”,那如果能直接从 query 本身估计 state coverage(而不需要先跑一遍 full-data),就能做数据筛选了。
2、 让训练更 step-efficient
既然瓶颈在吸收率,那有没有办法打破它?比如在一个 trust region 内重复利用同一批 states 做多个 epoch,或者给“teacher 信号还很大”的 token 加权,让吸收更快一点。
3、 场景扩展
更多 teacher 和 domain、更大模型、更长的 context——这些地方 training data 收集成本最高,如果 state coverage 视角能继续 hold,价值也最大。
这篇工作更多是“提出问题,给出一个视角”,而不是“给答案”。我们觉得 state 这个视角比 OPD 本身要宽,它可能也适用于其他 on-policy 训练范式。欢迎讨论和批评,也期待看到后续的工作把这个方向继续往前推。