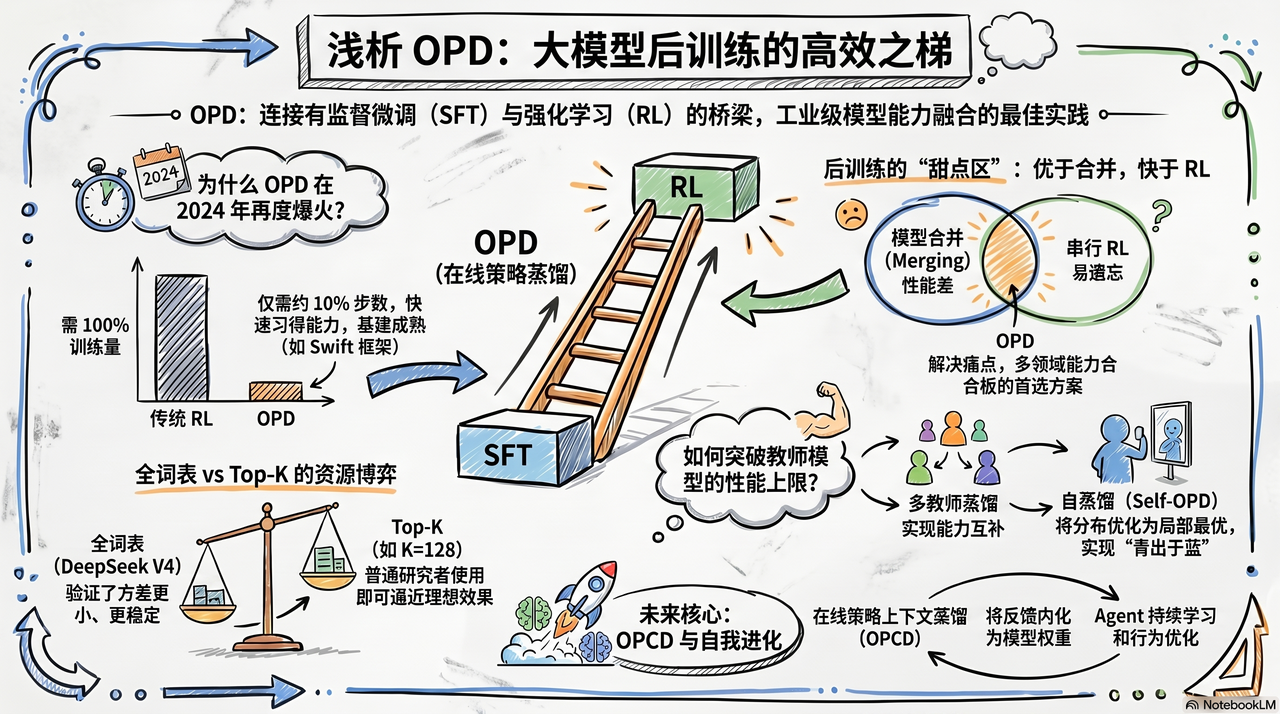
精选文章 实录精选|On-Policy Distillation专题:与RL 的本质区别、全词表监督、跨模型/黑盒蒸馏、Self-OPD... 过去一年,OPD 强势改写大模型后训练格局,消融蒸馏与强化学习的技术壁垒,驱动模型从静态对齐迈向自主进化,一众关乎 AI 自我迭代的前沿疑问应运而生。 在 5 月 30 日,#青稞AMA 第 3 期:On-Policy Distillation(OPD) 专题中,青稞社区邀请到了当前 OPD 方向最
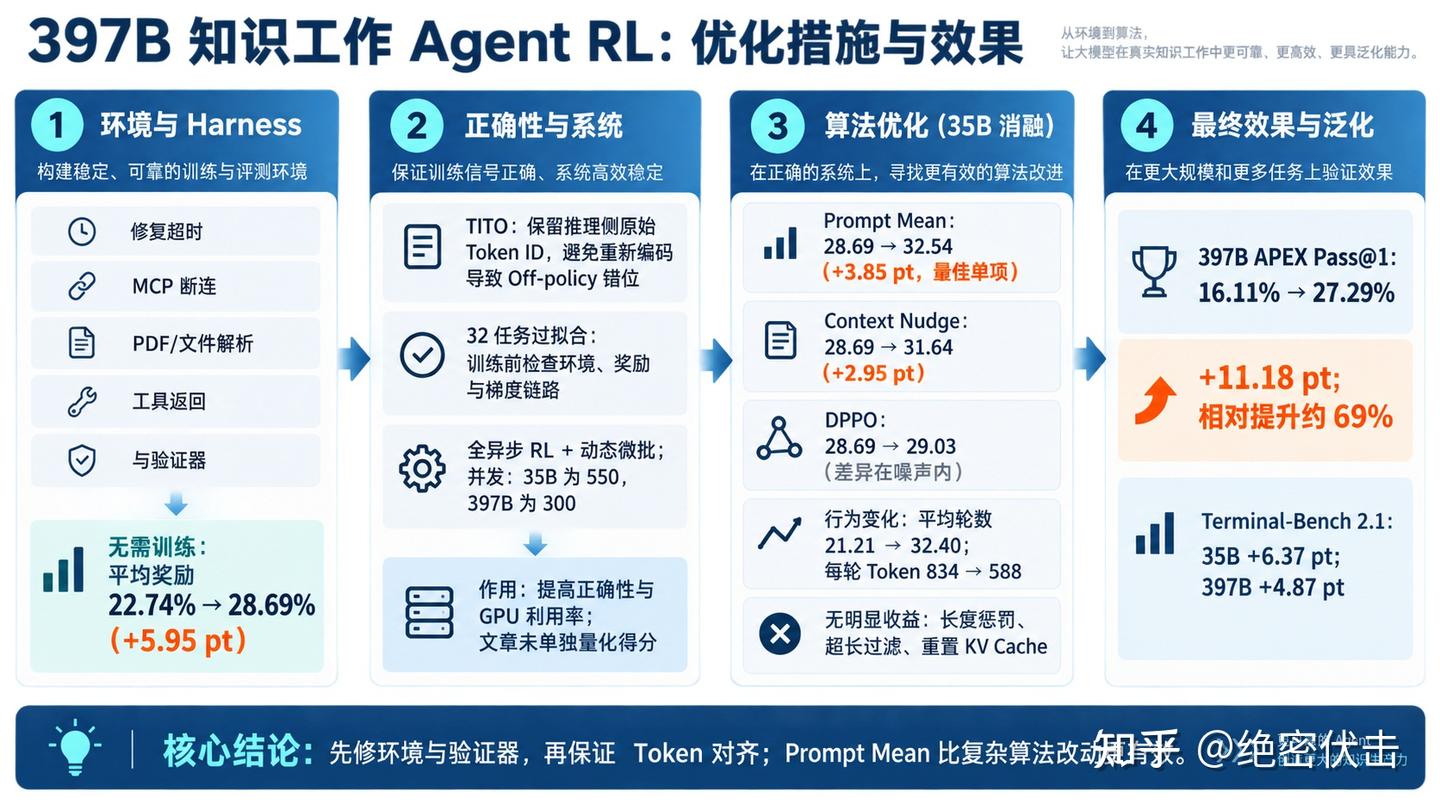
精选文章 LoRA 一作、OpenAI o1 核心成员的新工作:首次公开 397B 模型的 Agent RL 训练配方 LoRA 第一作者、OpenAI o1 核心成员 Edward Hu 近期加入 Mercor,担任 Head of AI Modeling。他加入后的首批公开成果之一,便是与 SkyRL 团队联合发布的一套面向复杂知识工作 Agent 的强化学习方案。 这项工作并未止步于公布最终结果,而是系统公开了
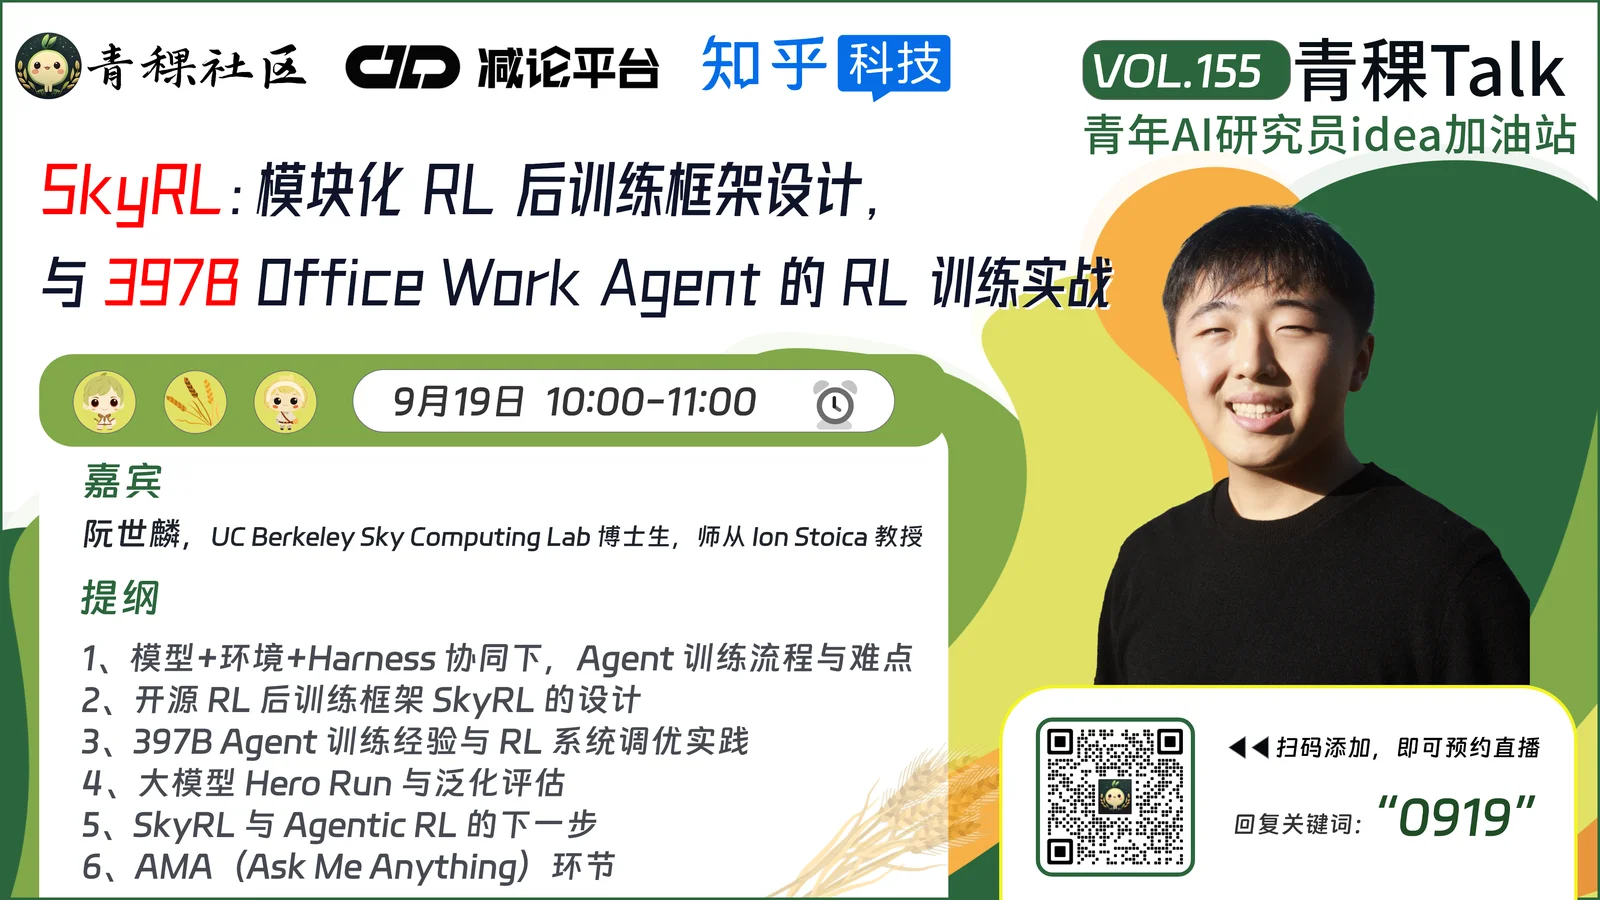
青稞Talk 周六上午10点!聊聊 RL 后训练框架 SkyRL,以及 397B Agent 的 RL 训练实战 当 Agent 训练从「只训模型」走向「模型 + 环境 + Harness」的协同,有了 RL 数据、也有了 RL 框架之后,接下来该做什么?这大概是一些刚开始做 Agentic RL 的企业团队会遇到的问题。 9月19日(周六)上午10:00,青稞Talk 第155期,青稞社区邀请到 SkyRL
精选文章 干货!大模型后训练的“剂量”学,什么剂量才能让 Qwen3.8-27B 想得少、不掉能力,还能用 XH 档? 先放最终后训练完成的模型地址: https://modelscope.cn/models/Merkyor/Qwen3.8-27B-EfficientThink-K3-Opus5-Grok4.6-GPT5.6Sol-SFT-SimPO-DFlash2 这件事一开始看起来挺简单。Qwen 3.8 27
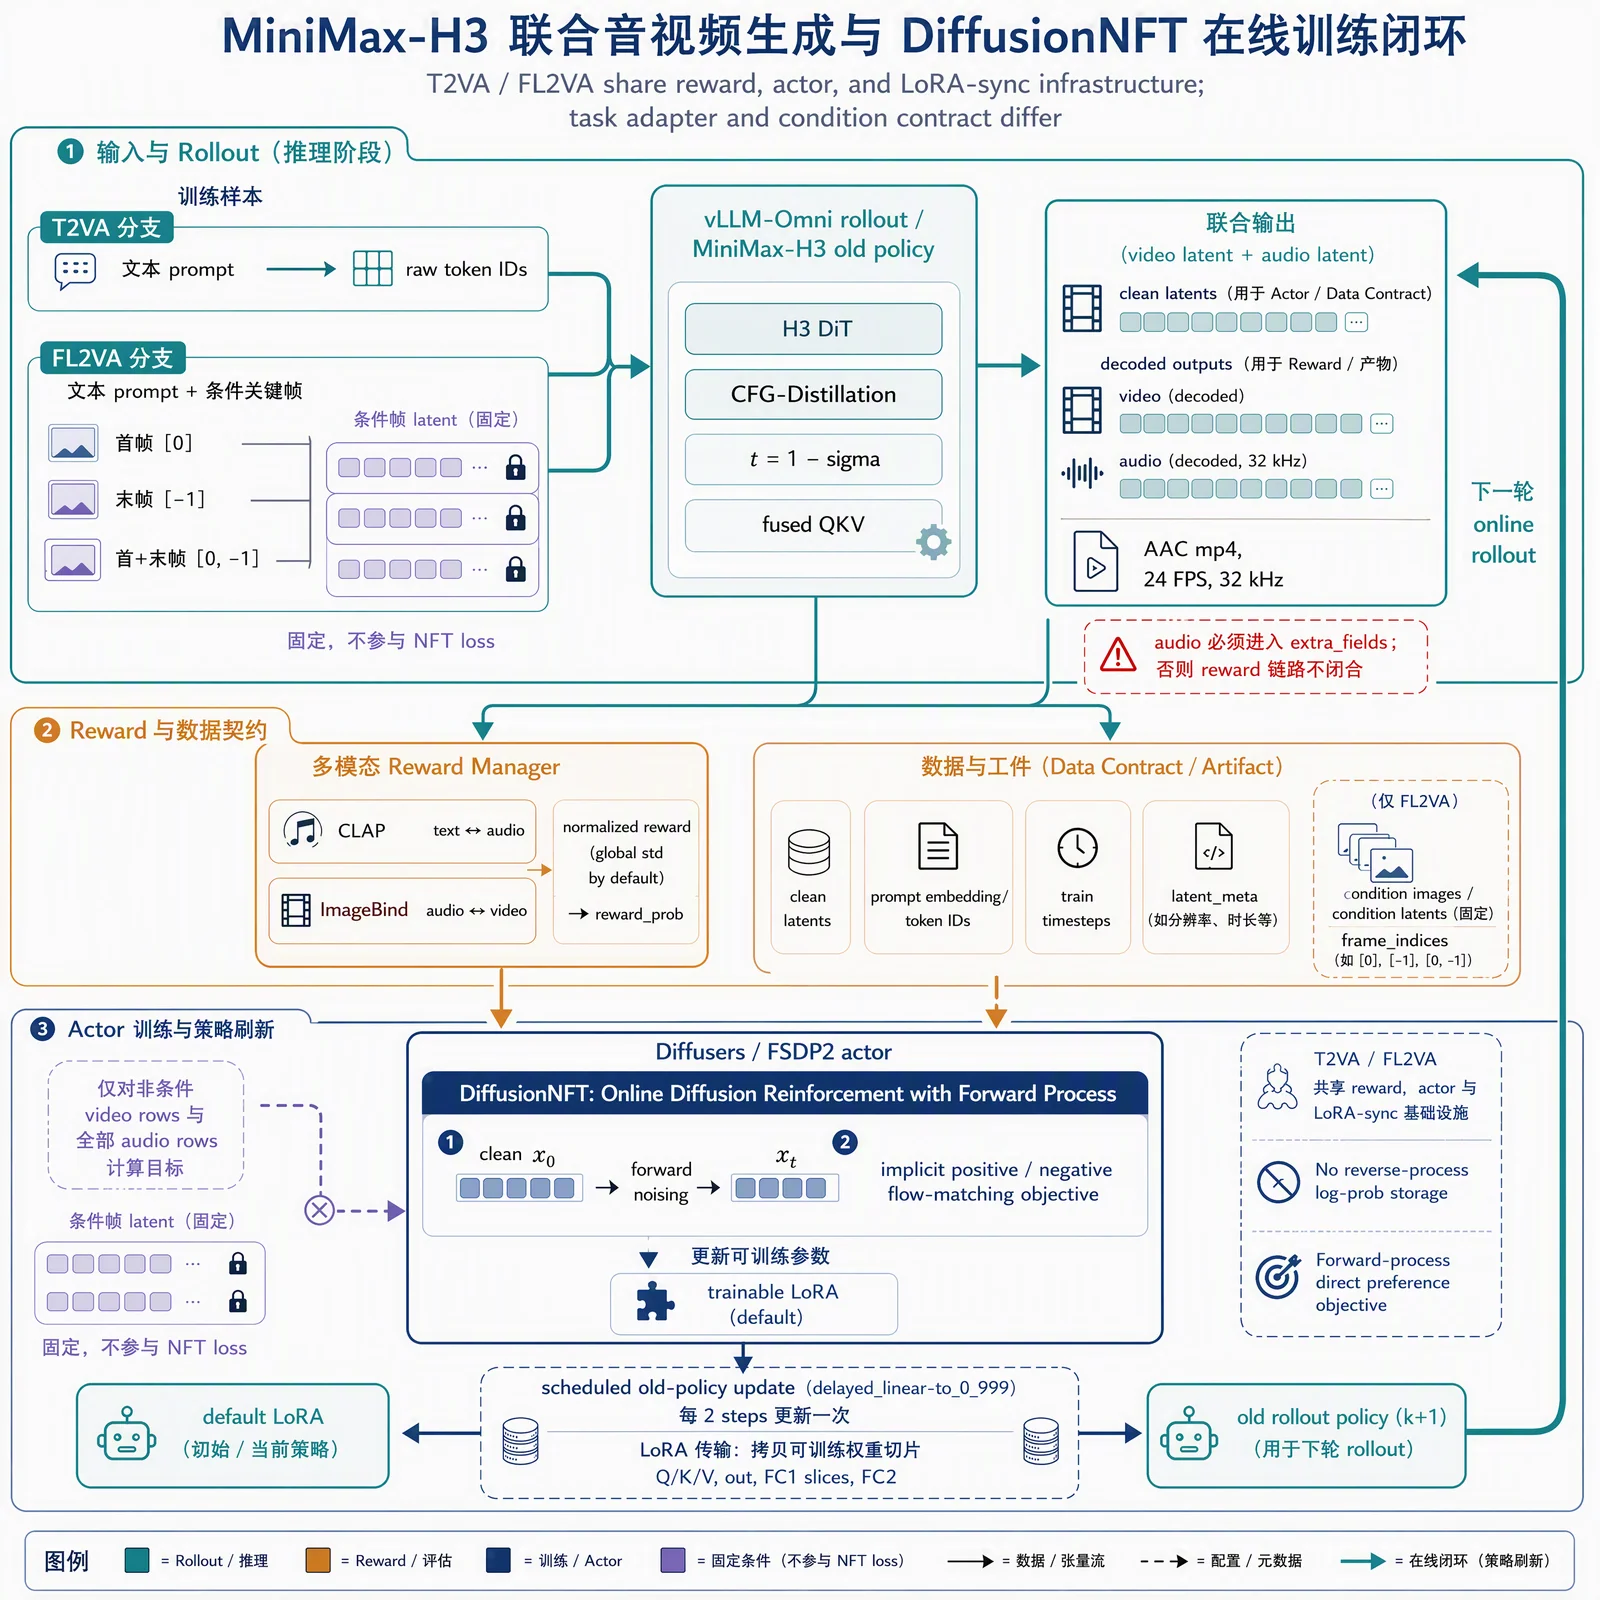
精选文章 MiniMax-H3 音视频生成 RL 后训练:基于 VeRL-Omni 的开源实践 引言 MiniMax-H3 是当前开源社区中最受关注的音视频生成模型之一。它是一个通用的多模态生成模型,接收文本、图像、视频、音频等多种输入,直接输出带原生立体声音轨的视频,支持最长 15 秒、最高 2K 分辨率、24 FPS、32 kHz 立体声。 在 Artificial Analysis 的
精选文章 大模型对齐中的古德哈特定律:为什么你的 Reward Model 总是被 “Hack”? 作者:蔡恒毅 https://zhuanlan.zhihu.com/p/2058574573143078204 做过 LLM 后训练的人,大概都见过这样一条曲线:强化学习跑着跑着,模型在奖励模型上的得分一路走高,训练日志里一片祥和;可当你真的翻开模型生成的文本,却发现它开始变得冗长、爱堆排版、甚至在
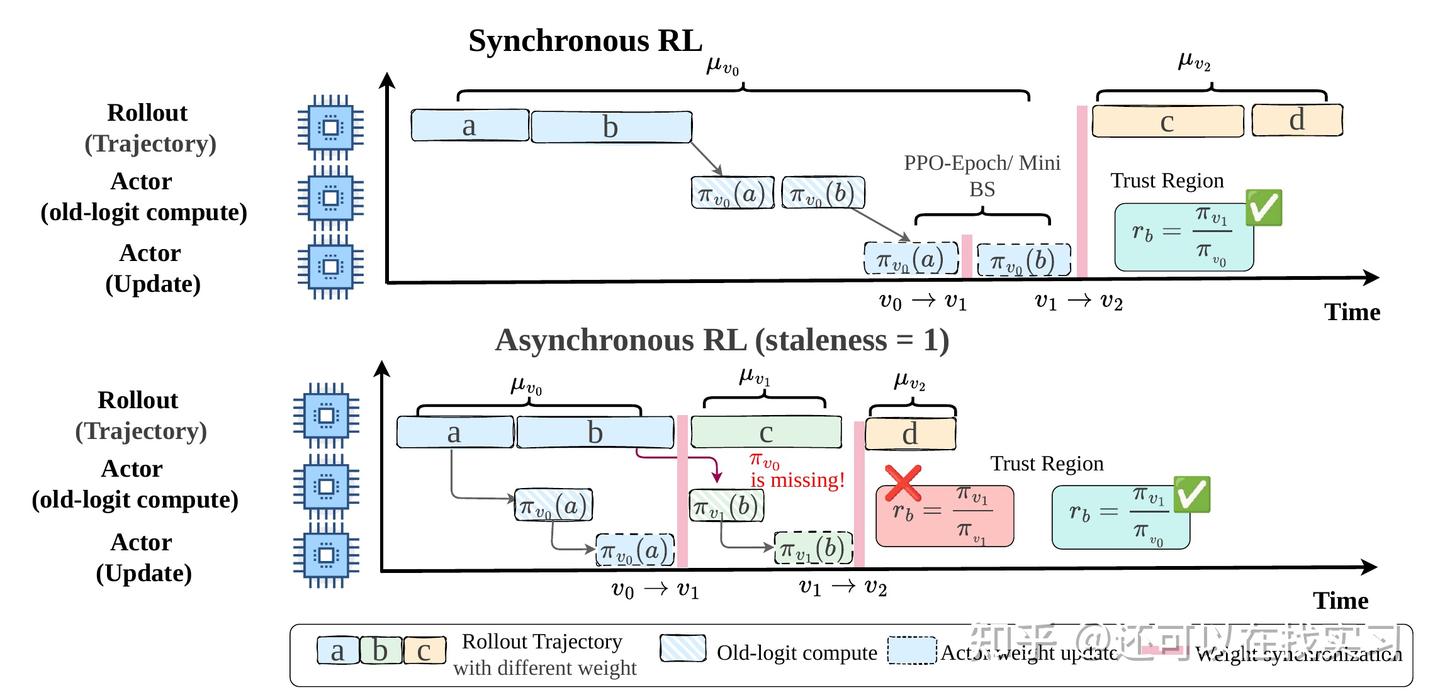
精选文章 当异步 Agentic RL 遇到“旧策略失忆”:重新理解 Off-Policy Correction 作者:还可以在找实习 https://zhuanlan.zhihu.com/p/2038002855374753895 欢迎关注我们关于异步 Agentic RL 的最新工作。本文聚焦一个在大规模 LLM 强化学习系统中非常基础、但经常被忽略的问题:当 rollout 和 training 异步解耦
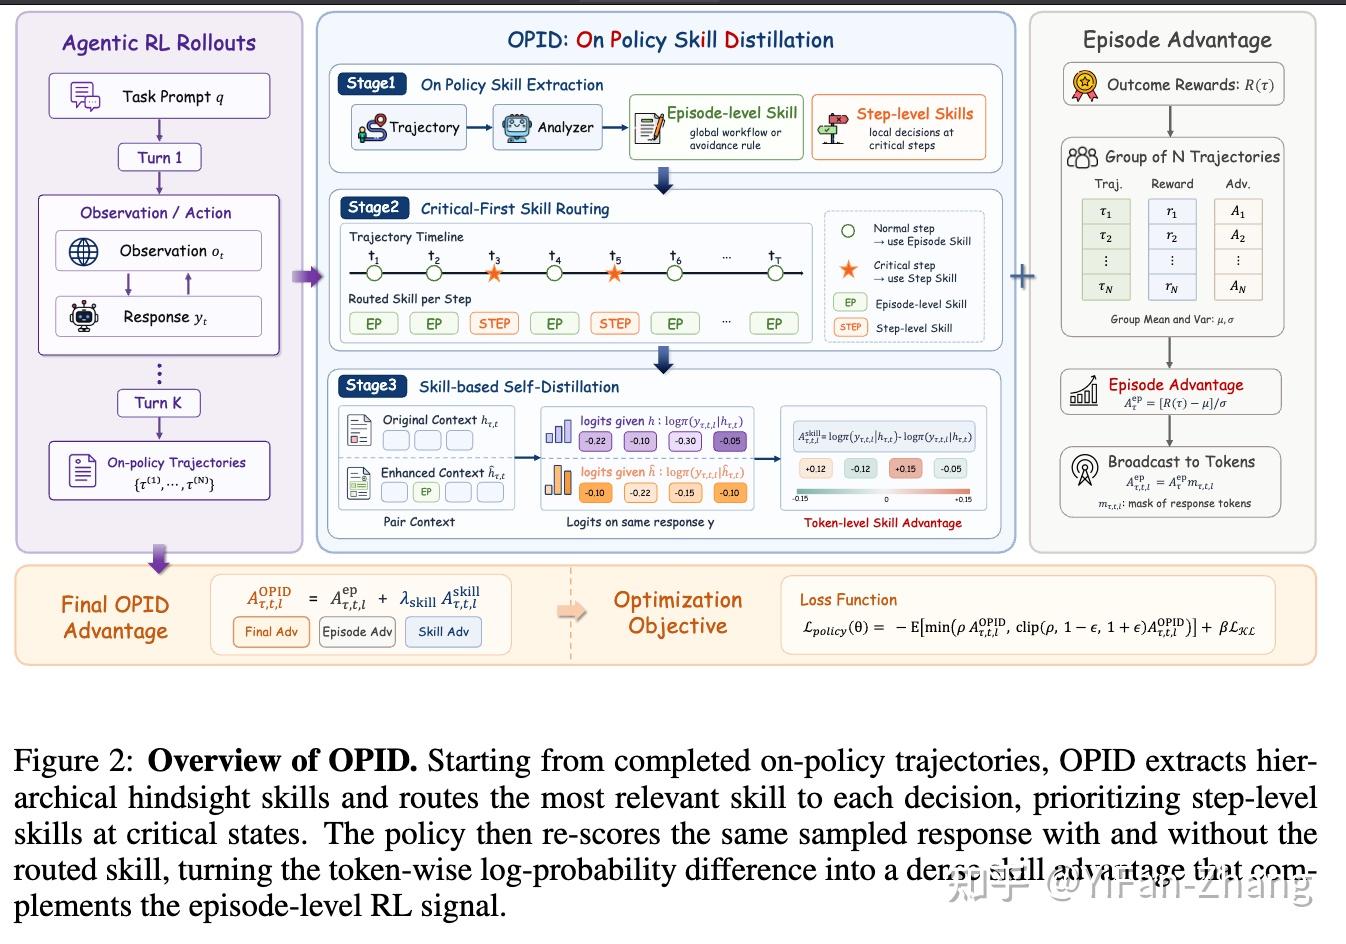
精选文章 从 GLM/Qwen 看: Agentic RL 最新进展 作者:YiFan-Zhang https://zhuanlan.zhihu.com/p/2054605815588435332 GLM 5.2: From Grpo to PPO 引入了 slime 这套训练与推理基础设施,同时在长链路任务里改用了更适合 compaction 的 PPO 训练方式,
青稞Talk 直播预告!聊聊 VeRL-Omni:基于VeRL及vLLM-Omni构建的面向多模态生成模型的开源 RL 后训练框架 随着文生图/视频及全模态模型快速落地,基于人类偏好与可验证信号的 RL 后训练已成为提升生成质量的关键手段。但与纯文本 LLM 不同,多模态生成 RL 在采样 rollout、reward 计算与分布式训练上的 I/O 与算力特征差异显著,亟需专门框架支撑。 VeRL-Omni 基于 VeRL及vL
青稞Talk 直播预告!一起聊聊腾讯混元最新开源的 UniRL:面向统一多模态模型的分布式 RL 后训练框架 目前多模态领域 RL 仍然缺少生成理解统一的 Infra。图像 / 视频的生成、理解,Prompt-Enhancer (PE),以及 HunyuanImage-3.0、Bagel 等 unified multimodal models,通常都需要各自维护 rollout、reward、advanta
青稞Talk ZEDA:将 Post-Trained MoE 迁移为高效动态 MoE MoE 通过稀疏激活在扩大参数容量的同时控制计算量;Dynamic MoE 可以动态调整专家激活数量,让简单 token 使用更少计算,从而进一步提升推理效率。 6 月 9 日(周二)晚 8 点,青稞 Talk 第 130 期,清华大学博士生吕兴泰,将直播分享《ZEDA:将 Post-Trained
青稞AMA 直播预告|从 MiniLLM 开始,为什么 OPD 正在成为推理模型时代的“基础设施”? 过去一年里,OPD 几乎成为后训练领域最火热的话题之一。 越来越多工作开始发现: 学生模型并不只是“模仿教师” On-policy 数据可能比静态 SFT 数据
青稞Talk 重探 On-Policy Distillation(OPD):三类典型失败以及修复路径 在最近的大模型后训练中,On-Policy Distillation已经成为默认选项之一。 但研究者们在分析训练日志、实验曲线和对比不同 OPD 方法实现时,反复碰到同一个问题:理论上很自然的 sampled-token OPD,实际运行起来并不稳定,甚至会把模型往一些局部上“看起来合理”、整体上却
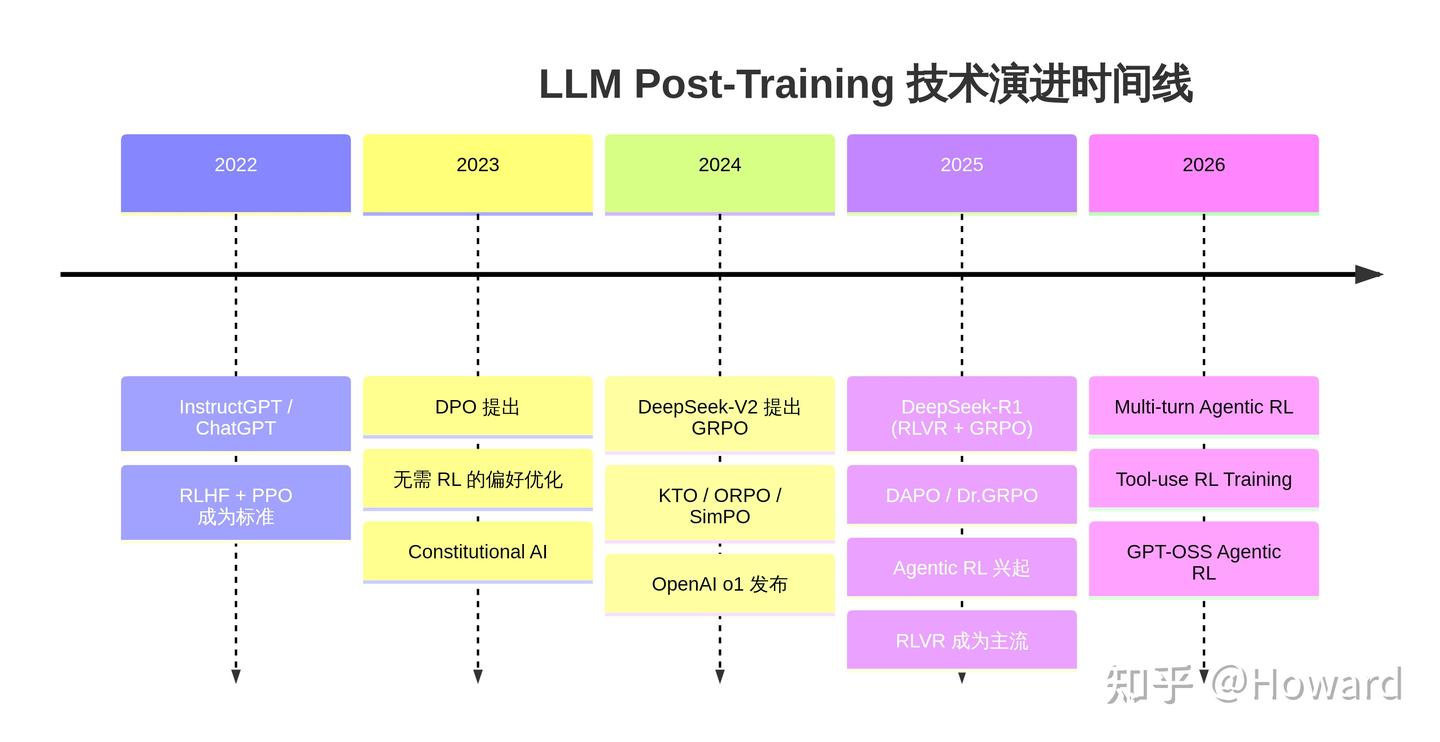
精选文章 LLM Post-Training 全景指南:从 RLHF 到 GRPO 再到 Agentic RL 作者:Haohe,Meta FAIR 研究科学家 https://zhuanlan.zhihu.com/p/2012909606771400823 1. 引言:什么是 Post-Training? 大语言模型(LLM)的训练通常分为两个大阶段:预训练(Pre-training) 和 后训练(Post
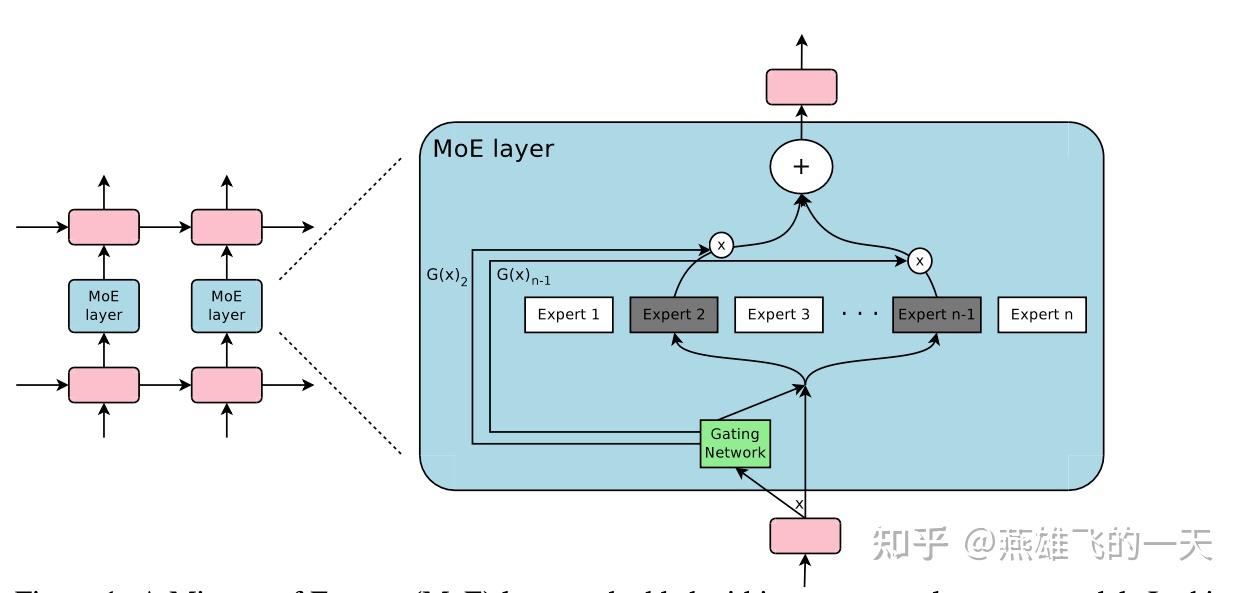
精选文章 MOE 架构如何做 SFT 和 RL?聊聊 post-training 难点与经验 作者:燕雄飞的一天 https://zhuanlan.zhihu.com/p/2018018879109091590 无论是开源还是顶尖商业模型,moe架构已经成为绝对主流,区别于dense模型,在sft和rl阶段有什么独特的训练难点或者挑战,对于这些挑战如何缓解。期望从基础原理入手,看如何训练mo
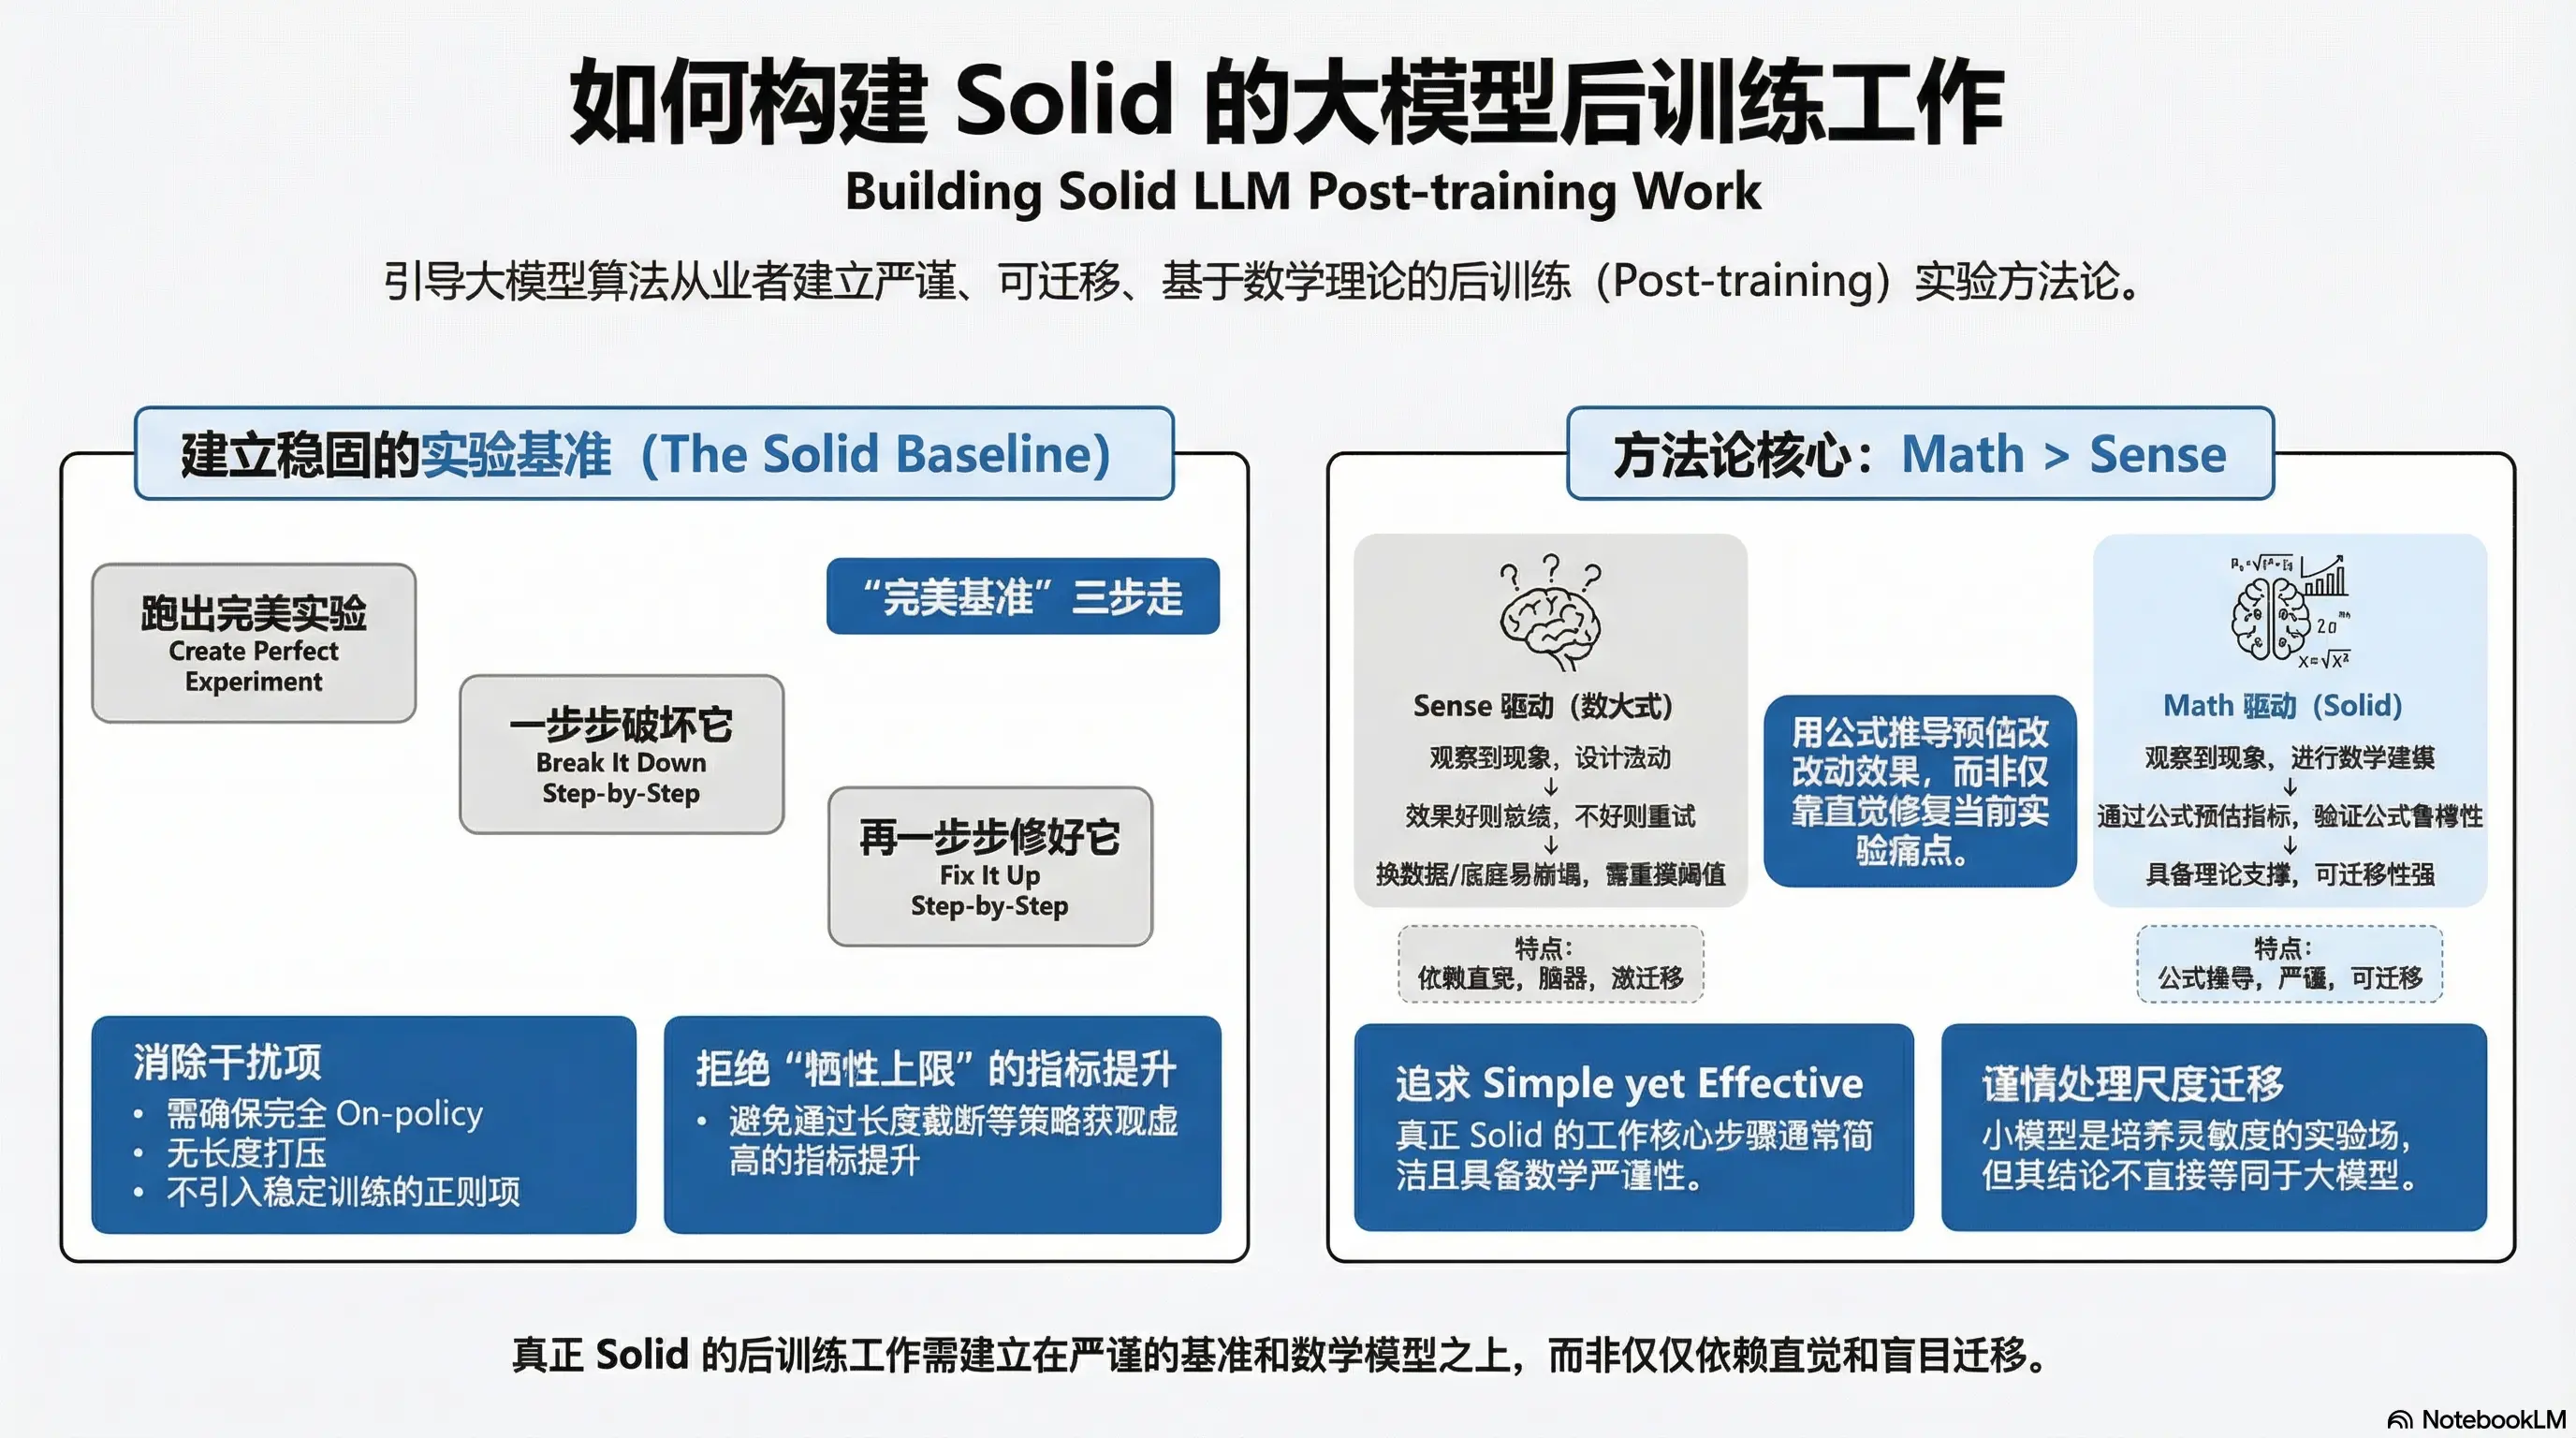
精选文章 少用 sense 挑战 math!如何把 post train 做好,后训练方法论 作者:ybq https://zhuanlan.zhihu.com/p/1995265459285694156 LLM 论文千千万,有用的工作却没几篇。这篇文章,我想简单讨论下到底该如何把后训练工作做的 solid。文章并没什么技术细节,大家随便看看。 敲定正确的 Baseline 有太多论文工作不