LoRA 第一作者、OpenAI o1 核心成员 Edward Hu 近期加入 Mercor,担任 Head of AI Modeling。他加入后的首批公开成果之一,便是与 SkyRL 团队联合发布的一套面向复杂知识工作 Agent 的强化学习方案。
这项工作并未止步于公布最终结果,而是系统公开了整套训练流程:从任务环境搭建、Agent Harness 优化、Token 对齐和分布式系统调优,到小规模过拟合验证、35B 模型算法消融,再到397B模型的正式训练。
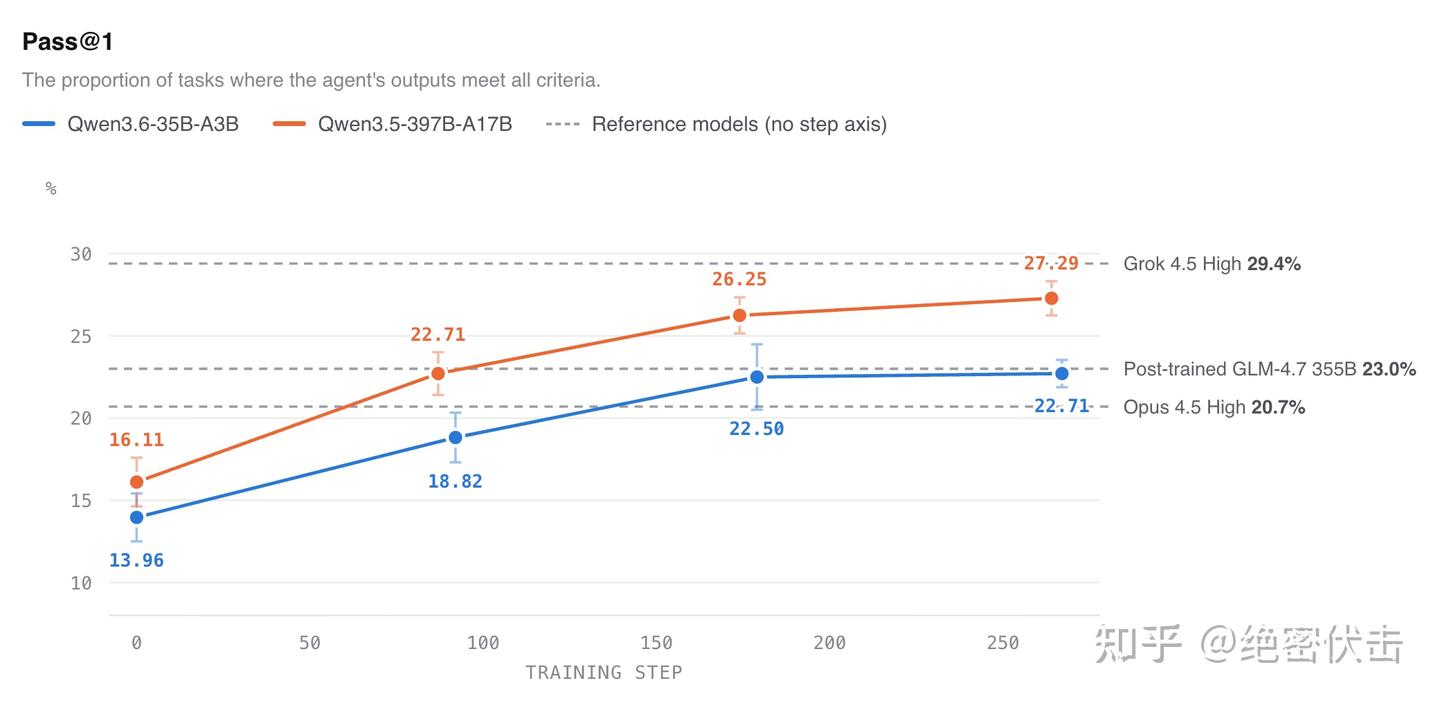
最终,Qwen3.5-397B-A17B 在 APEX-Agents 上的 Pass@1 从16.11%提升至27.29%,相对提升约70%;经过强化学习后,规模更小的Qwen3.6-35B-A3B也在该基准上超过了Claude Opus 4.5。
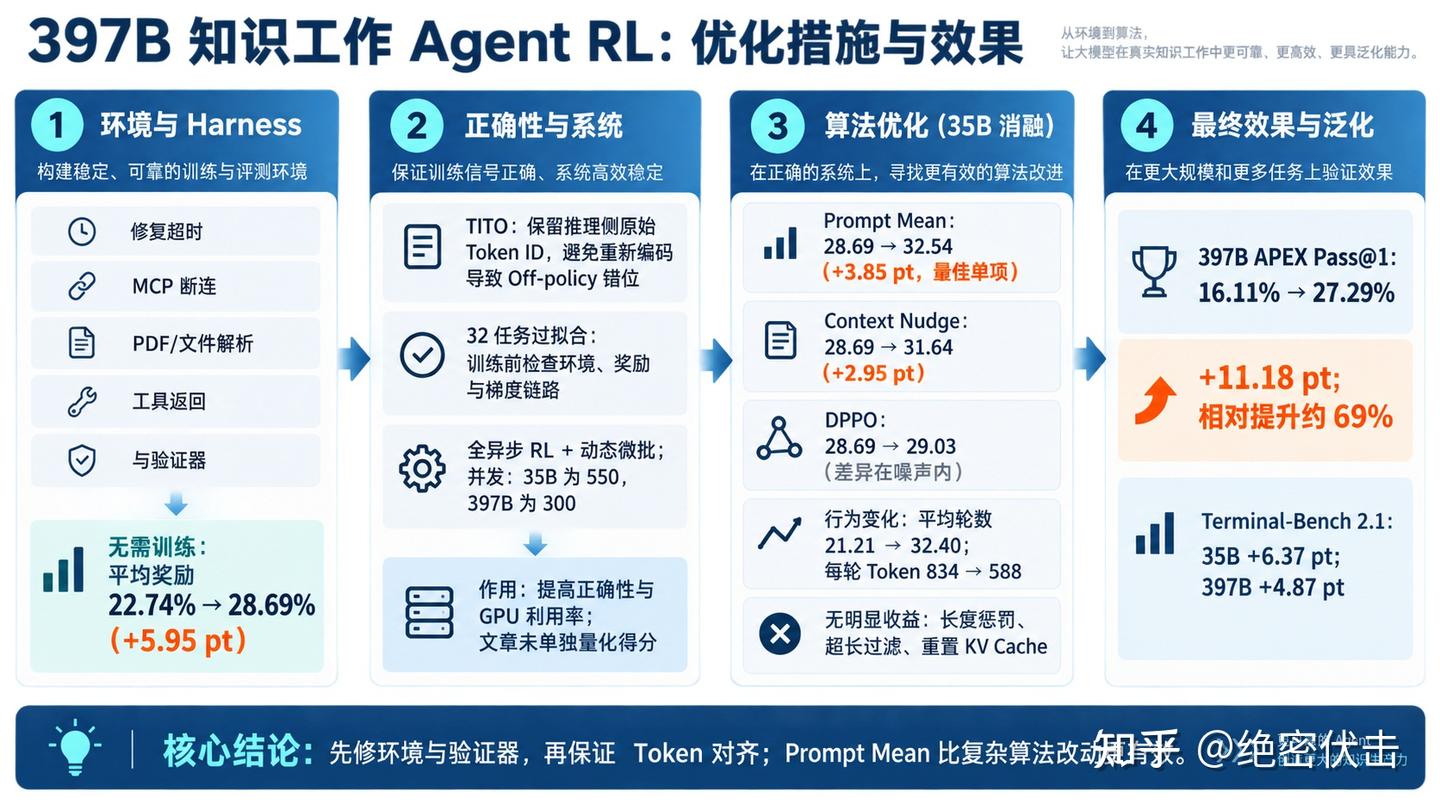
下图概括了这项工作的主要优化:
- 优化 Agent Harness:构建稳定、可靠的训练与评测环境,仅靠 Harness 优化便将平均奖励从22.74%提升至28.69%,提高5.95个百分点;
- 保证训练正确性与系统效率:通过 TITO 确保推理与训练使用完全一致的 Token 序列,并采用全异步 RL 提高长轨迹训练的资源利用率;
- 改进训练算法:引入 Prompt Mean,避免超长轨迹主导梯度;加入 Context Nudge,减少上下文耗尽造成的无效轨迹,并结合 DPPO 改善 Agent 的多轮工具调用行为。
比最终分数更值得关注的是,文章传达了一个非常明确的判断:
对复杂知识工作Agent而言,RL算法只是整个训练系统的一部分。环境、Harness、Verifier、Token对齐、KV Cache和异步调度,同样可能决定一次训练能否成功。
一、Background:APEX-Agents 与训练设置
1.1 APEX-Agents 测试什么?
APEX-Agents 是一个面向真实知识工作的长程 Agent 基准,共包含480个公开测试任务,覆盖三个专业领域:
- Corporate Law:公司法务;
- Management Consulting:管理咨询;
- Investment Banking:投资银行。
它不是一个只有 Prompt 和标准答案的传统 Benchmark。
每个任务都存在于一个模拟企业环境中。环境里可能有几十份 PDF、Excel、PowerPoint、邮件和聊天记录。Agent 需要通过 MCP 工具或者代码执行进入环境,搜索信息、处理文件并完成最终交付物。
因此,一个任务可能需要经历:
理解需求
→ 搜索邮件和聊天记录
→ 阅读多个PDF
→ 分析Excel数据
→ 调用代码工具
→ 创建或修改文件
→ 检查最终结果
→ 提交回答
为了进行强化学习,Mercor 另外准备了 1,928 个专家创建的训练任务,分布在 112 个模拟企业环境中。
训练任务与公开的 480 个评测任务具有相同结构,但具体 Prompt 和企业环境不重合,以降低数据污染风险。
1.2 使用了哪些模型?
团队选择了两个 MoE 模型:
| 模型 | 总参数量 | 每个Token激活参数 | 主要作用 |
|---|---|---|---|
| Qwen3.6-35B-A3B | 35B | 3B | 系统调试和算法消融 |
| Qwen3.5-397B-A17B | 397B | 17B | 最终大规模训练 |
这里的 397B 是模型总参数量。由于它采用 MoE 架构,每个 Token 实际激活约 17B 参数。
团队没有先进行 SFT Warm-up,而是直接对基础模型开展 RL。这样做并不是为了证明“SFT不重要”,而是因为他们希望集中研究整条流程里最困难、最容易失败的 RL 部分。
1.3 不同领域的提升情况
两种模型经过训练后,在法律、咨询和投行三个领域都取得了提升,但受益最大的领域有所不同:
- 35B模型在公司法务领域提升最大;
- 397B模型在管理咨询领域提升最大;
- 两个模型在投行业务上也获得了明显提升。
这说明强化学习带来的提升并不是由单一领域贡献的,而是覆盖了多种复杂知识工作。
二、Harness 环境优化
作者把正式训练前的第一项工作拆成三个部分:
1、 明确哪些组件在哪里运行;
2、 提高环境和 Harness 的稳定性;
3、 实现精确的 Token-in-Token-out。
其核心逻辑是:如果环境本身不稳定,模型产生的失败轨迹就无法代表模型能力,更不能用于强化学习。
2.1 哪些组件在哪里运行?
整套系统主要由 SkyRL、Harbor、Ray、vLLM、Megatron 和 Modal 组成。
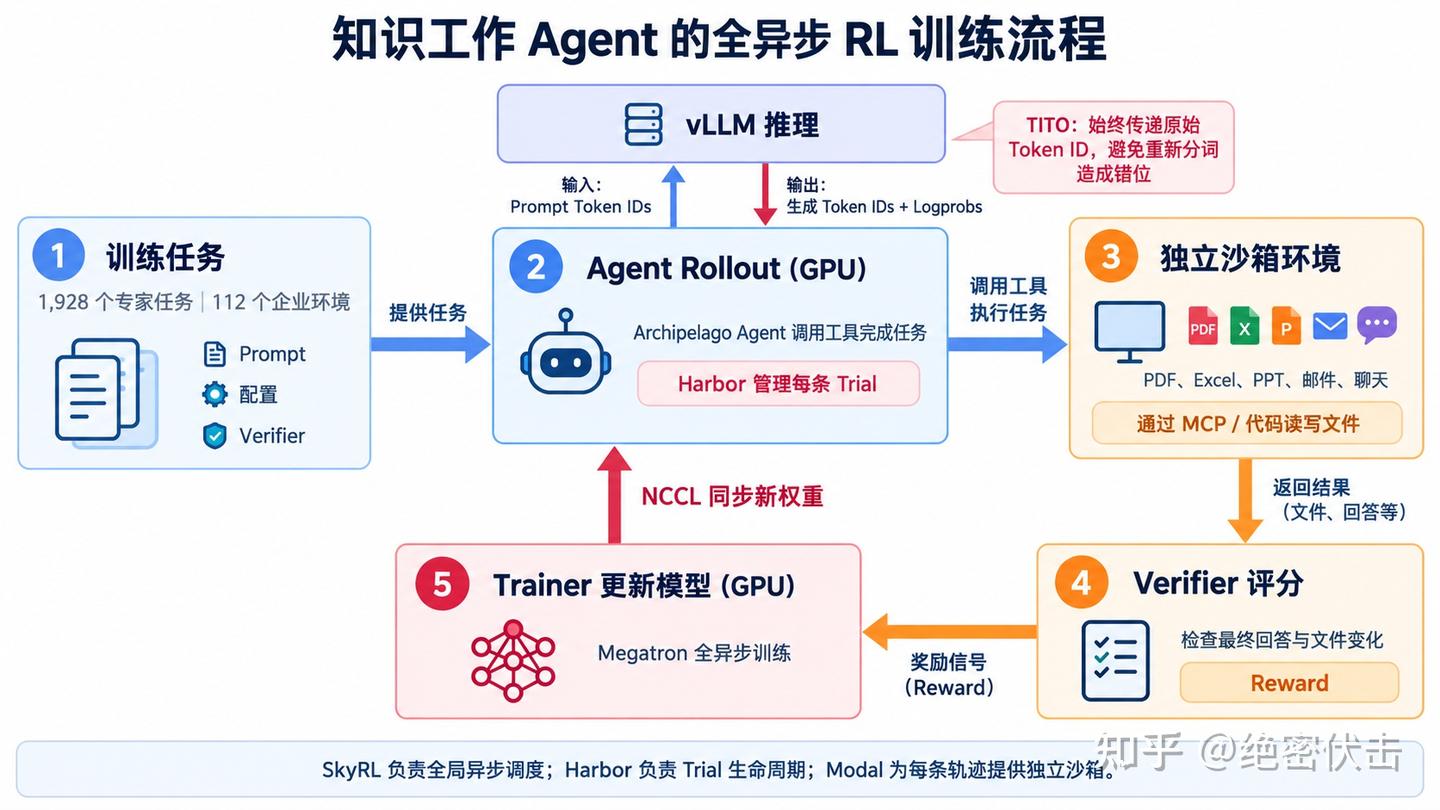
从左到右可以分成三个部分。
训练数据
每个任务以 Harbor Task Directory 的形式保存,包括:
instruction.md:任务要求;task.toml:任务配置;archipelago.json:Agent配置;ecr_image:对应的企业环境镜像;tests/:Verifier和评分逻辑。
每次 Trial 消费一个独立任务目录。
GPU集群
GPU集群由 Ray 调度,包括:
- Megatron Training Nodes:负责更新模型参数;
- vLLM Inference Nodes:负责生成 rollout;
- SkyRL:负责全异步训练循环;
- Harbor Trial:管理每条轨迹的生命周期;
- ArchipelagoAgent:实际执行多轮 MCP 工具调用;
- NCCL:将更新后的权重同步到推理节点。
一次 Trial 的完整流程为:
启动环境
→ Agent运行
→ Verifier评分
→ 返回Reward
→ 销毁环境
独立沙箱
每个 Trial 都会从 AWS ECR 拉取对应的 Docker 镜像,并启动一个独立的 Modal Sandbox。
沙箱中运行:
- PDF MCP;
- Excel MCP;
- PowerPoint MCP;
- Email MCP;
- Chat MCP;
- 搜索和代码执行工具;
- 任务对应的文件系统;
- 最终结果 Verifier。
也就是说,每条轨迹不是简单生成一段文本,而是让模型进入一个独立的模拟企业环境中工作。
2.2 提高环境基础设施的稳定性
长程 Agent 任务可能运行几十分钟,生成几万乃至十几万 Token。
如果模型已经完成大量阅读和工具调用,却因为最后一次 MCP 断连、沙箱销毁超时或者 Judge API 限流而得到零分,不仅会浪费推理资源,还会污染训练信号。
因此,团队在正式 RL 前做了大量环境治理。
给所有外部操作设置Timeout
包括:
- 文件下载;
- MCP调用;
- 容器启动;
- 容器销毁;
- LLM Judge请求。
在数百条轨迹并发运行时,任何一个没有超时的外部操作,最终都有可能永久挂起。
处理LLM Judge限流
普通评测产生的 Judge 请求不多,但强化学习可能同时运行数百条 rollout。
团队使用:
- 多个 API Key 轮询;
- 失败重试;
- 指数退避;
避免 Judge API 成为整体吞吐瓶颈。
每个Agent Loop使用独立进程
早期系统让数百个 Agent Loop 共享同一个 Python 进程,结果出现大量 MCP 连接断开。
后来,他们将每条 Agent 轨迹放入独立的 Ray Task,使其拥有独立进程和 MCP Client,显著提高了环境稳定性。
区分“任务失败”和“系统错误”
系统需要明确判断:
- 是模型真正做错了,因此应该得到低奖励;
- 还是 MCP、沙箱或外部服务失败,应该重新运行。
如果把所有系统错误都当作模型失败,训练器就会把错误的零奖励写入参数。
作者的建议是:在开始 RL 前,先按照正式训练时的并发规模,对完整训练集执行一次评测,将非模型错误率尽可能压到接近零,而不是依赖训练阶段的错误屏蔽。
2.3 优化Agent Harness
基础设施稳定之后,下一步是分析 Agent Harness 本身。
团队先让未经训练的模型运行完整训练集,然后逐条检查失败轨迹,判断失败来自:
- 模型能力不足;
- 工具设计不合理;
- Harness行为异常;
- 环境缺少必要依赖;
- Verifier判断错误。
他们发现了几个典型问题。
沙箱缺少Python包
模型会花费多个回合尝试不同方案,才能发现某个包并未安装;或者被迫使用更难操作的 MCP 工具。
这部分 Token 并没有用于解决任务,而是在探索环境限制。
PowerPoint工具错误返回None
工具实际上已经成功执行,但返回结果始终是None。模型无法判断操作是否完成,可能不断重复调用或者放弃正确路径。
PDF工具破坏二维布局
原有 PDF MCP 会把二维页面转成一维文本。在处理多栏文档和复杂表格时,不同列的内容会被错误拼接。
团队因此提示模型:遇到复杂PDF时优先使用Python的pdfplumber。
其他 Harness 改进
他们还加入了几个实用机制:
- 工具调用格式解析失败时,让模型重新生成,而不是立即终止轨迹;
- 截断过长的工具返回,避免一次调用耗尽上下文;
- 当上下文剩余不多时,提醒模型开始收尾;
- 修复文件生成与文件比较逻辑。
这些改动的效果非常明显。
在没有进行任何参数训练的情况下,Qwen3.6-35B-A3B的平均奖励从:
提高了5.95个百分点。
作者认为,这个提升幅度大约相当于在旧Harness上完成一个Epoch的训练。
换句话说:
在Agent RL中,修好Harness本身,就可能比修改一次RL算法更有效。
2.4 TITO:Token-in-Token-out
完成环境治理后,还需要确保推理端和训练端使用的是完全相同的 Token。
问题并不是“Tokenizer不固定”,而是:
虽然Tokenizer对相同文本的编码是确定的,但不同Token序列可能解码成同一段文本。
假设词表中包含:
0: <
1: search
2: <search
3: >
推理时,模型实际采样的是:
[0, 1, 3]
解码后得到:
<search>
Harness如果只保留文本,再交给训练器重新编码,可能得到:
[2, 3]
虽然两组Token显示为相同文本,但RL中的动作已经不同。
推理侧真实轨迹是:
训练器却以为模型执行的是:
这会破坏 PPO、GRPO、DPPO 等算法所依赖的状态—动作—概率对应关系,使训练在不知不觉中变成 Off-policy。
为什么多轮Agent更加严重?
多轮Agent会反复经历:
模型输出工具调用
→ Decode成文本
→ 执行工具
→ 拼接工具结果
→ 整段历史重新Tokenize
→ 模型继续生成
如果每轮都通过文本重建上下文,那么第 NN 轮真实输出的Token,可能与第 N+1N+1 轮输入历史中的Token不同。
团队最终让 Agent 直接通过/completions接口处理原始 Token ID,并保存:
- 输入Token ID;
- 输出Token ID;
- Rollout Logprob;
- Loss Mask;
- Reward。
这样,训练器使用的动作才与推理引擎实际采样的动作完全一致。
三:RL Systems Tuning
完成环境和Token正确性检查后,第二步才是调优RL系统。
长程Agent任务中,不同轨迹的完成时间差异很大。简单任务可能很快结束,复杂任务可能生成 100K Token 以上。
如果使用严格同步训练,整个Batch必须等待最慢的轨迹完成,大量GPU时间会浪费在等待上。
因此,团队采用Fully Async RL:
- Rollout 节点持续生成轨迹;
- 完成的轨迹立即进入缓冲区;
- Trainer 持续从缓冲区取数据;
- 训练不等待同一批所有轨迹结束;
- 更新后的权重通过 NCCL 同步到 vLLM 推理节点。
3.1 优化Megatron配置
团队首先用独立脚本扫描Megatron配置,包括:
- TP (Tensor Parallelism);
- EP (Expert Parallelism);
- PP (Pipeline Parallelism);
- CP (Context Parallelism);
- CPU Offloading;
- Micro-batch Size。
他们使用动态微批处理,根据每条序列的 Token 数量动态组成 Micro-batch。对于长度差异极大的 Agent 轨迹,这对训练吞吐非常重要。
3.3 分配 Rollout 与 Training 资源
基本原则是:
先固定训练GPU数量,再增加足够的推理 GPU,直到 Trainer 不再等待轨迹生成。
原博客给出的节点比例为:
- 35B:12个推理节点、4个训练节点;
- 397B:12个推理节点、8个训练节点。
3.4 设置 Rollout 并发数
并发上限由系统和算法两个条件共同决定。
系统上限:KV Cache
可以粗略表示为:
由于单条 Agent 轨迹可能达到数万乃至十几万 Token,每条轨迹都会占用大量 KV Cache。
模型越大、轨迹越长,可同时运行的 Agent 就越少。
算法上限:轨迹陈旧程度
Fully Async RL中,生成轨迹时使用的 Policy 可能落后于当前训练 Policy。
文章给出的算法并发上限为:
使用实际配置:
也就是说,理论上最多可以容纳 1,024 条尚未消费的轨迹。超过这个数量后,部分轨迹会因为过旧而无法被Trainer 接受。
但两次实验真正受到的限制都是 KV Cache:
- 35B 最大并发:550;
- 397B 最大并发:300。
3.5 检查训练—推理概率偏差
参数确定后,团队运行了少量训练 Step,比较 vLLM 推理端与 Megatron 训练端对相同 Token 计算的 Logprob。
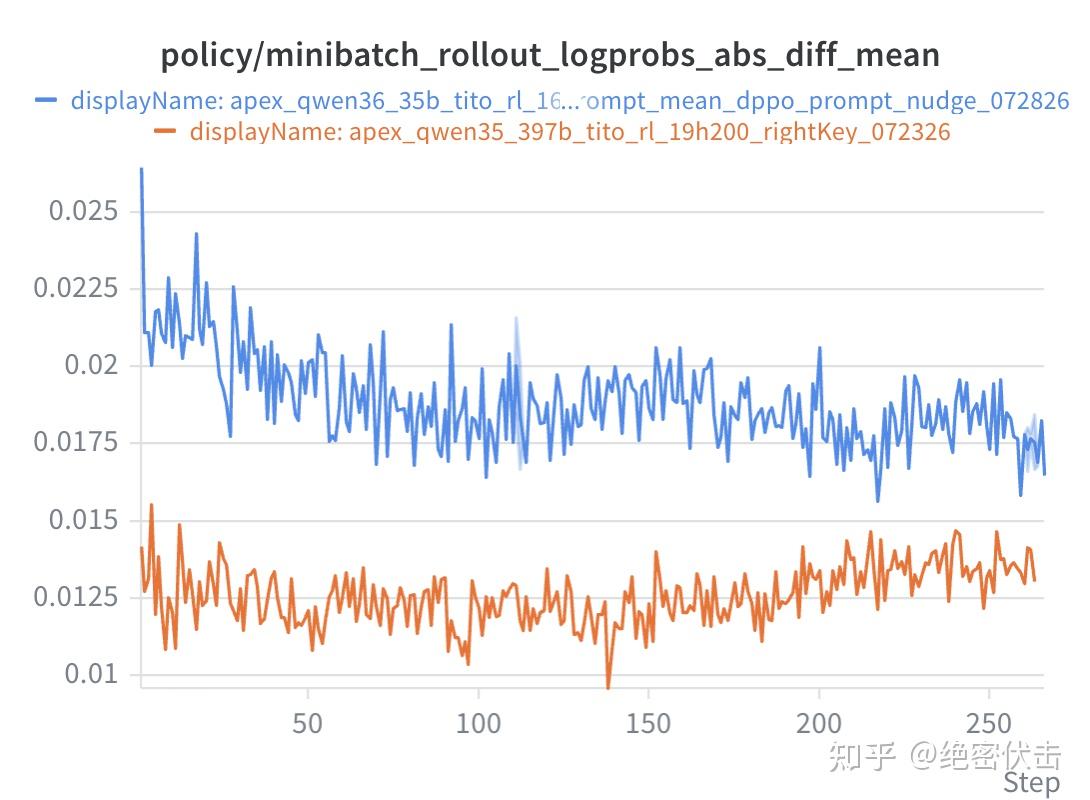
作者认为,平均 Logprob 差异低于0.03,通常说明系统比较健康。
这个检查还帮助他们发现了 vLLM CPU Offloading、GDN 模型和 In-flight 权重更新组合下的正确性问题。
两次正式训练中,即使没有使用 Rollout Router Replay,Logprob 差异仍然维持在较小范围。
四、Overfitting Run
即使环境和系统已经通过检查,团队依然没有马上启动完整训练,而是先进行了一个小规模过拟合实验。
具体配置为:
- 从训练集中选出 32 个任务;
- 每个任务在离线评测中必须存在非零奖励方差;
- Batch Size 为 32;
- 每个 Prompt 采样 8 条轨迹;
- 采用同步训练;
- 每一个 Step 相当于完整训练一个 Epoch。
选择“具有奖励方差”的任务非常重要。
如果模型对一个任务的所有采样结果都是零分,那么 GRPO 一类组内相对优化方法很难获得有效信号。团队优先选择模型偶尔能够成功的任务,以验证整个训练链路是否具备学习能力。
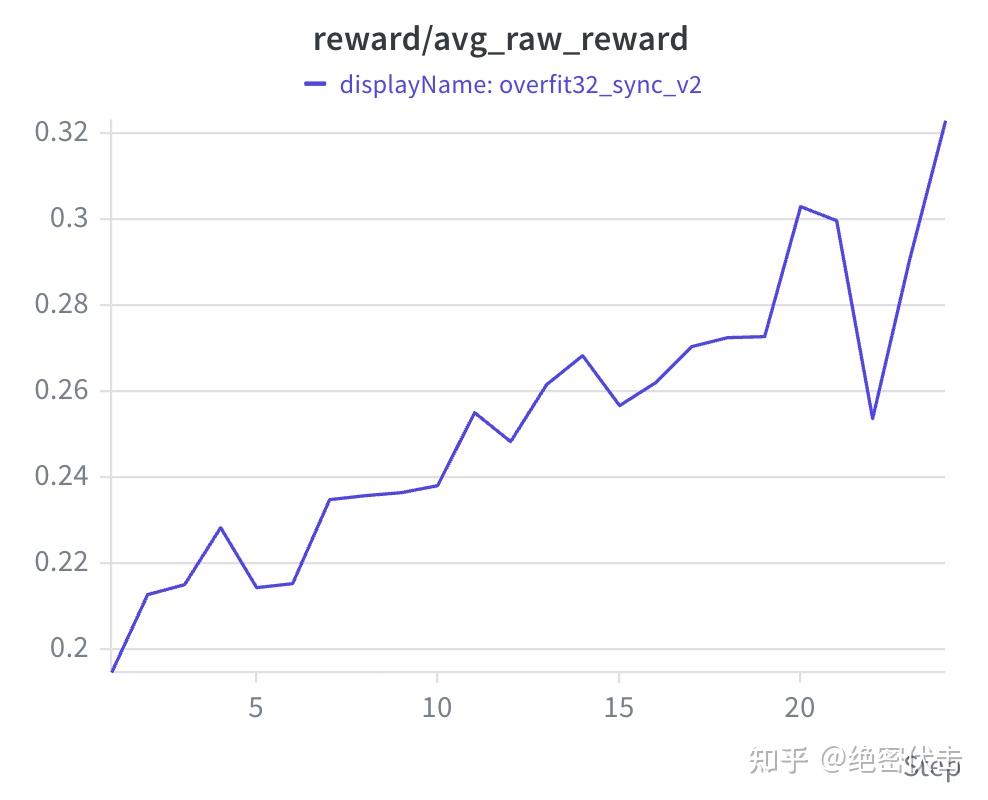
平均奖励整体从约 0.19 上升到 0.32,说明系统已经能够产生明确的学习信号。
过拟合实验发现了什么问题?
团队发现,通过“比较 Rollout 前后文件差异”进行评分的任务,明显比只检查最终文本回答的任务更难过拟合。
继续排查后,他们发现问题不在模型,而在文件评分系统:
- 文件内容提取不完整;
- 原始 Diff 工具不能准确识别变化;
- 正确修改也可能被判定为失败。
更换第三方文件 Diff 工具后,这些任务才开始出现清晰的学习信号。
因此,小规模过拟合在 Agent RL 中相当于一次端到端单元测试:
- 检查任务是否可学习;
- 检查 Reward 是否正确;
- 检查 Verifier 是否可靠;
- 检查 Token 是否对齐;
- 检查梯度能否真正改善模型。
如果连 32 个任务都无法过拟合,直接进行 397B 训练基本等于浪费 GPU。
五、Algorithm Ablations on the 35B
完成前三步去风险之后,团队才开始真正比较 RL 算法。
为了控制成本,他们先在 Qwen3.6-35B-A3B 上进行消融,然后将较优配置迁移到 397B 模型。
每组实验都取第一个 Epoch 的 Checkpoint,并在 480 个 Hold-out 任务上评测 3 次。
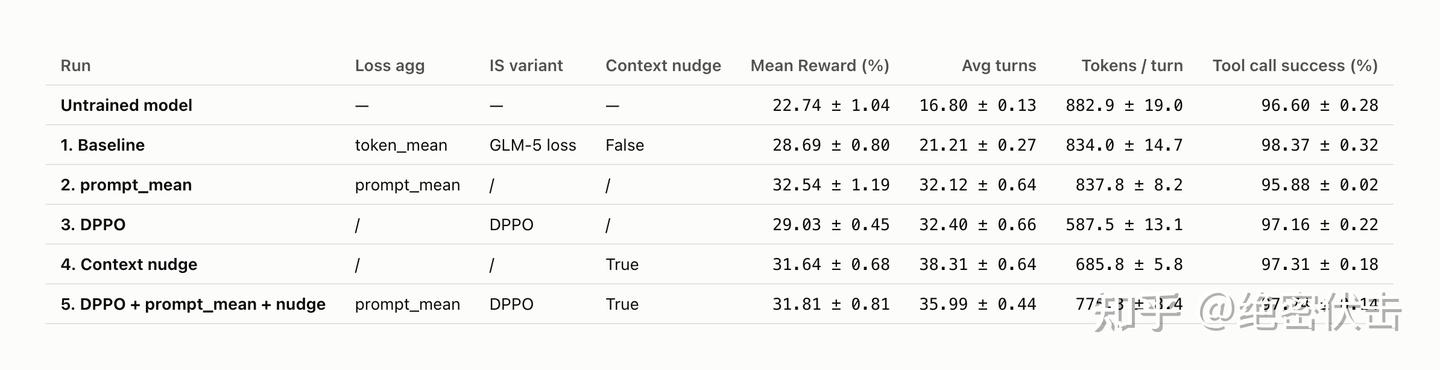
需要注意,消融实验的绝对分数低于文章开头的最终成绩,因为团队在完成这些实验后,又进一步优化了Harness。
不过所有消融实验都使用同一版本Harness,所以横向比较仍然有效。
5.1 Token Aggregation:Prompt Mean 提升 3.9 个点
团队比较了三种 Policy Loss 聚合方法。
Token Mean
将整个 Batch 中的所有 Token 放在一起平均:
这是很多开源 RL 框架的默认方式。
但文章中的轨迹长度从 2K 到 128K Token 不等,因此长轨迹会获得远高于短轨迹的梯度权重。
一条 128K Token 轨迹对更新的影响,可能是一条 2K Token 轨迹的几十倍。
这会使训练目标从“平等优化不同任务”变成“重点优化输出最长的任务”。
Sequence Mean
先对每条序列内部取平均,再对所有序列平均:
这样每条序列权重相同,但同一个 Prompt 如果包含多条序列,其总体影响仍可能更大。
Prompt Mean
先在同一个 Prompt 对应的 Rollout Group 内部聚合,再对不同 Prompt 求平均。
这样,每个任务获得相同的总体权重,不再由轨迹长度决定梯度贡献。
这一项改动让平均奖励从:
提高了 3.85 个百分点,是文章中效果最好的单项算法改动。
5.2 DPPO 与 GLM-5 Loss
Fully Async RL 同时存在两类偏差:
- vLLM 与 Megatron 之间的 Train-inference mismatch;
- Rollout Policy 与当前训练 Policy 之间的 Staleness。
传统 TIS 通常需要用训练模型额外前向一次,以获得 Trainer Logprob。对于 100K Token 轨迹,这次额外 Forward 的代价非常大。
DPPO 和 GLM-5 Loss 都直接使用 Rollout Logprob,因此可以避免这次额外前向。
两者的主要区别是:
- DPPO:当训练与推理 Logprob 偏离过大时,屏蔽对应 Token;
- GLM-5 Loss:截断 Importance Ratio,控制过大的 Off-policy 更新。
从奖励看:
DPPO 相对于 GLM-5 Loss 只提高了约 0.34 个百分点,明显处于评测噪声范围内,不能认为它显著更优。
但 DPPO 明显改变了 Agent 的行为:
- 平均轮数从 21.21 增加到 32.40;
- 每轮 Assistant Token 从 834 降低到 587.5;
- 模型倾向于进行更多、更短的交互。
也就是说,模型的行为从“一次输出很长”转向:
短思考
→ 调工具
→ 看结果
→ 再思考
→ 再调工具
作者最终选择 DPPO,主要是因为这种行为模式看起来更适合复杂 Agent 工作,而不是因为它在 Reward 上取得了显著优势。
5.3 Context Nudge
当 Agent 消耗掉 80% 的上下文预算时,Harness 会插入提示,要求模型尽快完成任务。
这个提醒只在训练阶段使用,评测阶段不会添加。
它将平均奖励从:
28.69→31.64 28.69\rightarrow31.64
提高了 2.95 个百分点。
原因是一些轨迹会不断阅读和调用工具,直到上下文耗尽。模型没有生成最终回答,整条轨迹就会得到零分。
Context Nudge 减少了这类被截断的轨迹,使每个 Batch 包含更多有效奖励信号。
它还有一个附加作用:训练上下文为 160K,评测上下文为 256K。使用相对比例而不是固定 Token 数触发提醒,可以在一定程度上吸收训练和评测的上下文差异。
5.4 哪些方法没有帮助?
团队还测试了:
- Overlong Filtering;
- Adaptive Length Penalty;
- 重置KV Cache。
这些方法均没有显著收益。
Overlong Filtering 会从 Loss 中屏蔽超长轨迹,但结果反而下降约 1.5 个百分点。
Adaptive Length Penalty 分别惩罚模型生成 Token 和环境返回 Token,在多个系数下均为中性或负面。
可能的原因包括:
- 训练和评测上下文长度差距不大;
- 只训练一个 Epoch,长度约束的长期价值尚未体现;
- 长轨迹并不一定代表无效探索,部分复杂任务本身就需要大量操作。
5.5 为什么不能只看 Reward?
作者提醒,480 个任务的单次评测仍然有较大噪声,不同运行之间可能波动 1 至 3 个百分点。
因此:
- 约 1 个点以内的差距应该视为持平;
- 每组结果都应该多次评测;
- 不仅要看最终 Reward,还要观察 Agent 行为。
他们重点关注:
- 平均工具调用轮数;
- 每轮 Assistant Token 数;
- 工具调用成功率;
- 代码执行比例;
- 上下文耗尽比例。
综合分数与行为后,团队选择:
DPPO + Prompt Mean + Context Nudge
作为 397B 正式训练配置。
六:The 397B Hero Run
完成 35B 消融后,团队将以下配置用于 397B 模型:
- DPPO;
- Prompt Mean;
- Context Nudge;
- 不使用长度惩罚;
- 不使用 Curriculum Learning。
作者认为,从 35B 扩展到 397B,算法层面没有出现本质变化。真正增加的工作量主要来自系统侧:
- 更多训练 GPU;
- 更复杂的并行策略;
- 更低的 Rollout 并发;
- 更大的 KV Cache 压力;
- 更高的权重同步成本。
6.1 Pass@1曲线
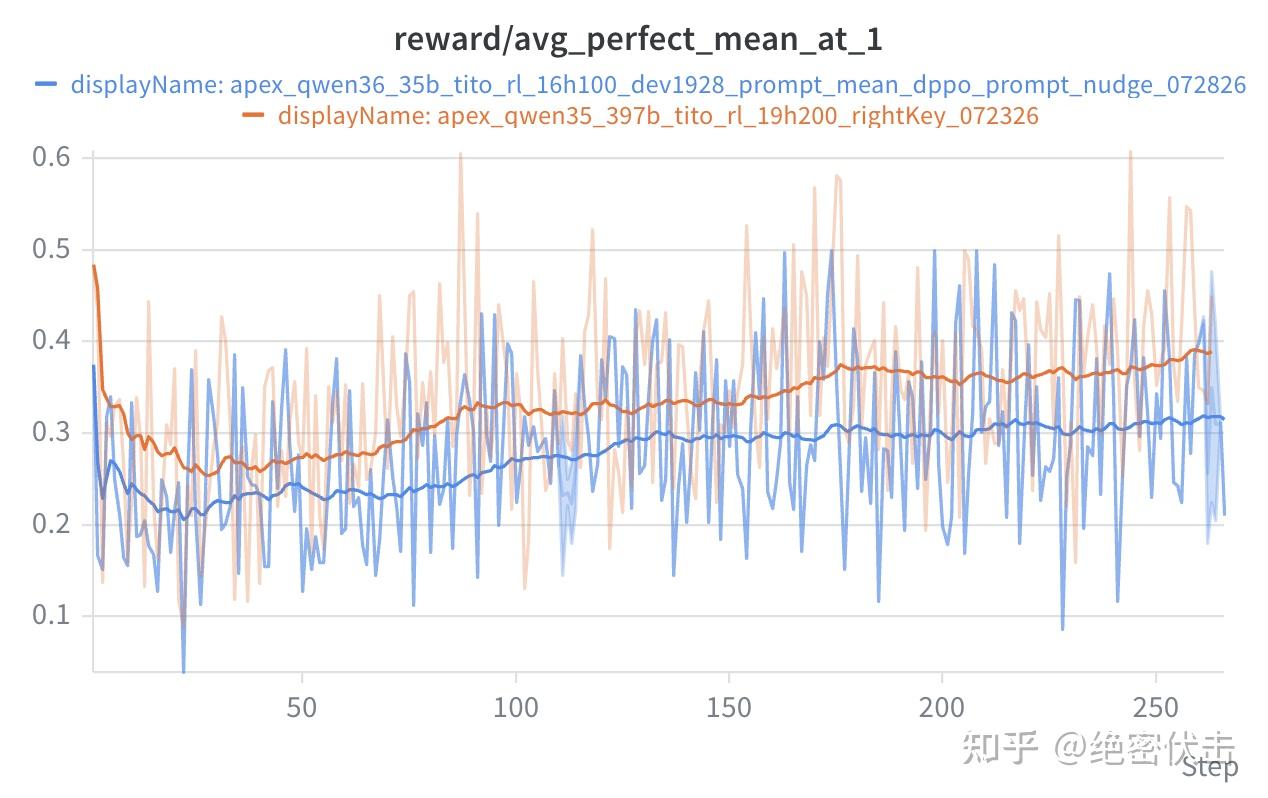
两种模型在训练初期都出现了 Pass@1 下降。
作者认为,这主要来自 Fully Async RL 的动态偏差:简单任务通常更快完成,因此训练缓冲区早期会被简单任务占据,导致前期数据分布不均衡。随着更多长任务完成,指标才逐渐恢复并持续上升。
最终:
- 35B 模型的 Pass@1 达到 22.71%;
- 397B 模型的 Pass@1 达到 27.29%。
6.2 Pass@16曲线
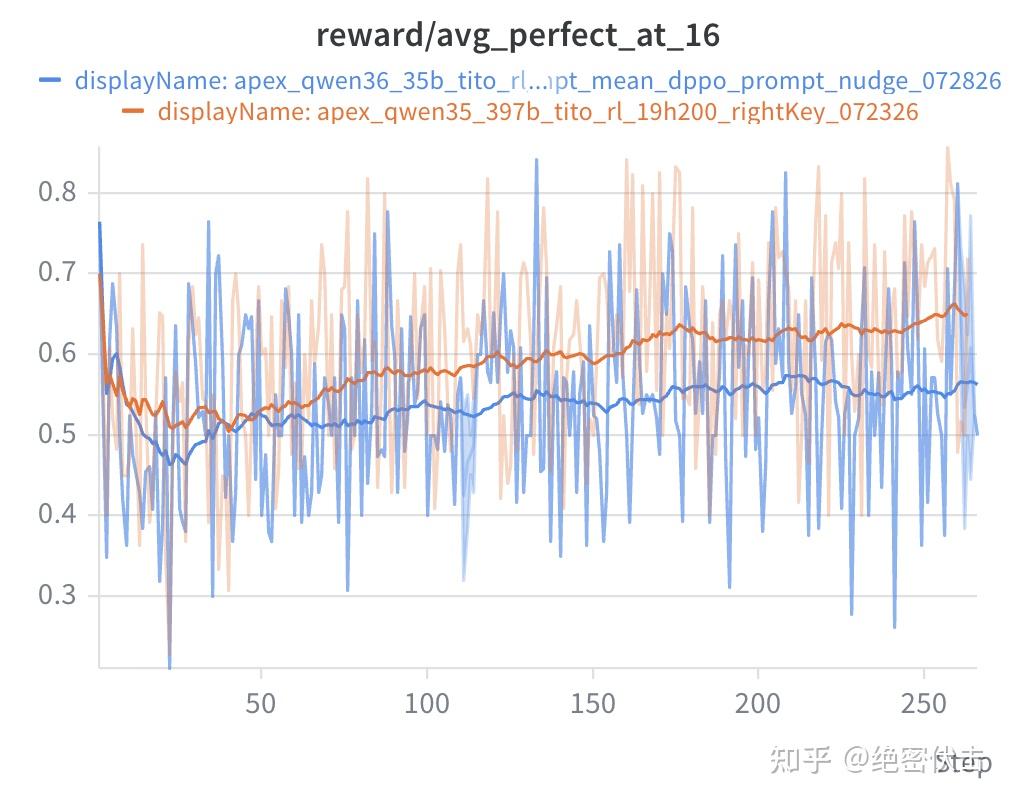
Pass@16 表示对同一任务采样 16 次时,至少有一次完全通过的比例。
从平滑曲线看:
- 35B 最终大约达到 0.56;
- 397B 最终大约达到 0.65。
Pass@16 继续上升,说明模型并非只是在固定任务上收缩成单一行为,而是仍保留了一定探索成功的空间。
6.3 Policy Entropy 曲线
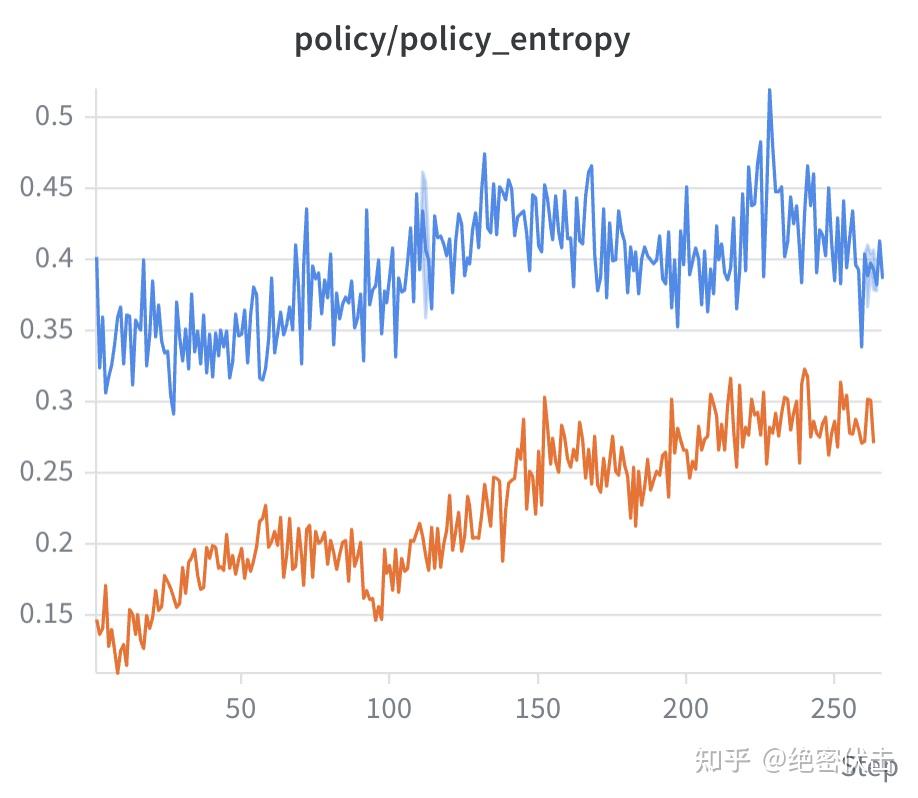
两个模型的Policy Entropy都没有持续坍缩,反而总体呈现上升趋势。
397B 模型的 Entropy 始终低于 35B,说明其策略分布更集中;35B 模型保持了更高的动作不确定性和探索性。
仅凭 Entropy 无法判断策略好坏,但结合 Pass@1 和 Pass@16 曲线,可以看出训练并没有造成明显的策略坍缩。
七、Evaluation and Generalization
Agent RL 经常会遇到一个问题:训练收益可能并不是模型获得了通用能力,而是学会适应某套 Harness。
为了测试这一点,团队进行了两级迁移实验。
7.1 更换 Harness: 从Archipelago 迁移到OpenCode
训练时使用的 Archipelago 基于 MCP 工具。
评测时,团队完全移除 MCP Server,换成代码型 OpenCode,只提供:
bash
glob
read
grep
write
edit
todowrite
评测任务仍然是同一组 480 个 APEX-Agents 任务。
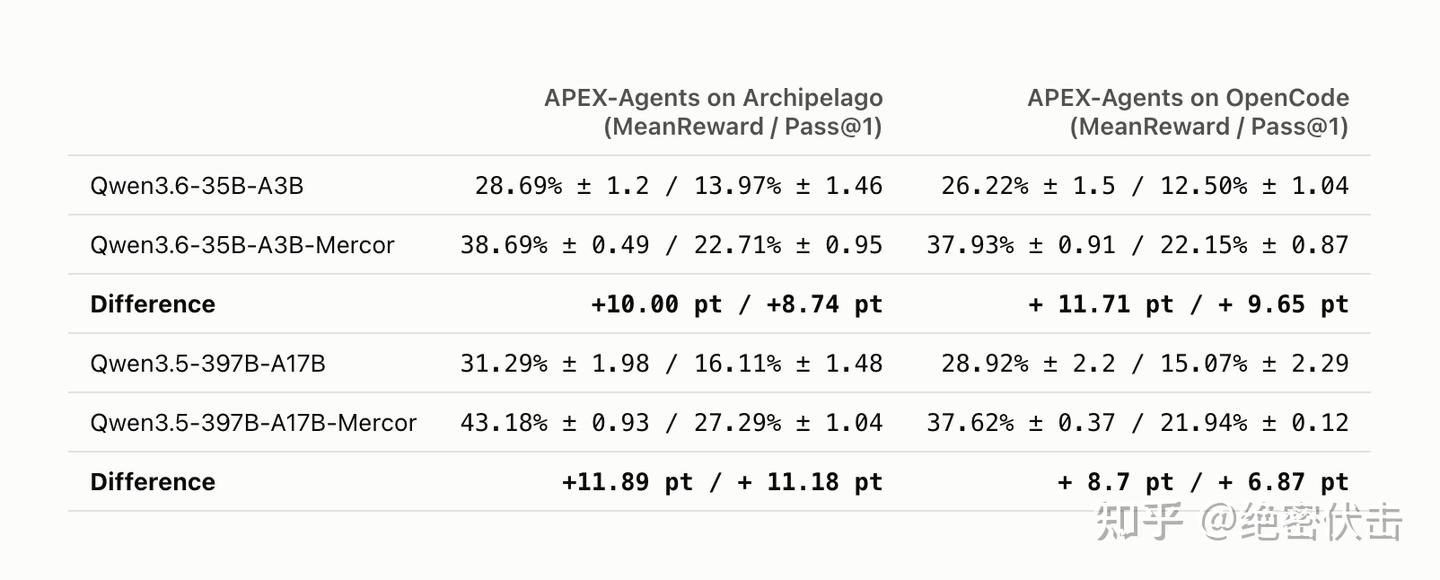
在训练 Harness Archipelago 上:
- 35B Mean Reward提升10.00点,Pass@1提升8.74点;
- 397B Mean Reward提升11.89点,Pass@1提升11.18点。
换成 OpenCode 后:
- 35B Mean Reward提升11.71点,Pass@1提升9.65点;
- 397B Mean Reward提升8.70点,Pass@1提升6.87点。
因此,大部分 RL 收益都能够迁移到不同 Harness。
不过,35B 模型的迁移效果明显好于 397B。
7.2 为什么35B的跨Harness迁移更好?
团队进一步分析了两种模型使用代码工具的比例。
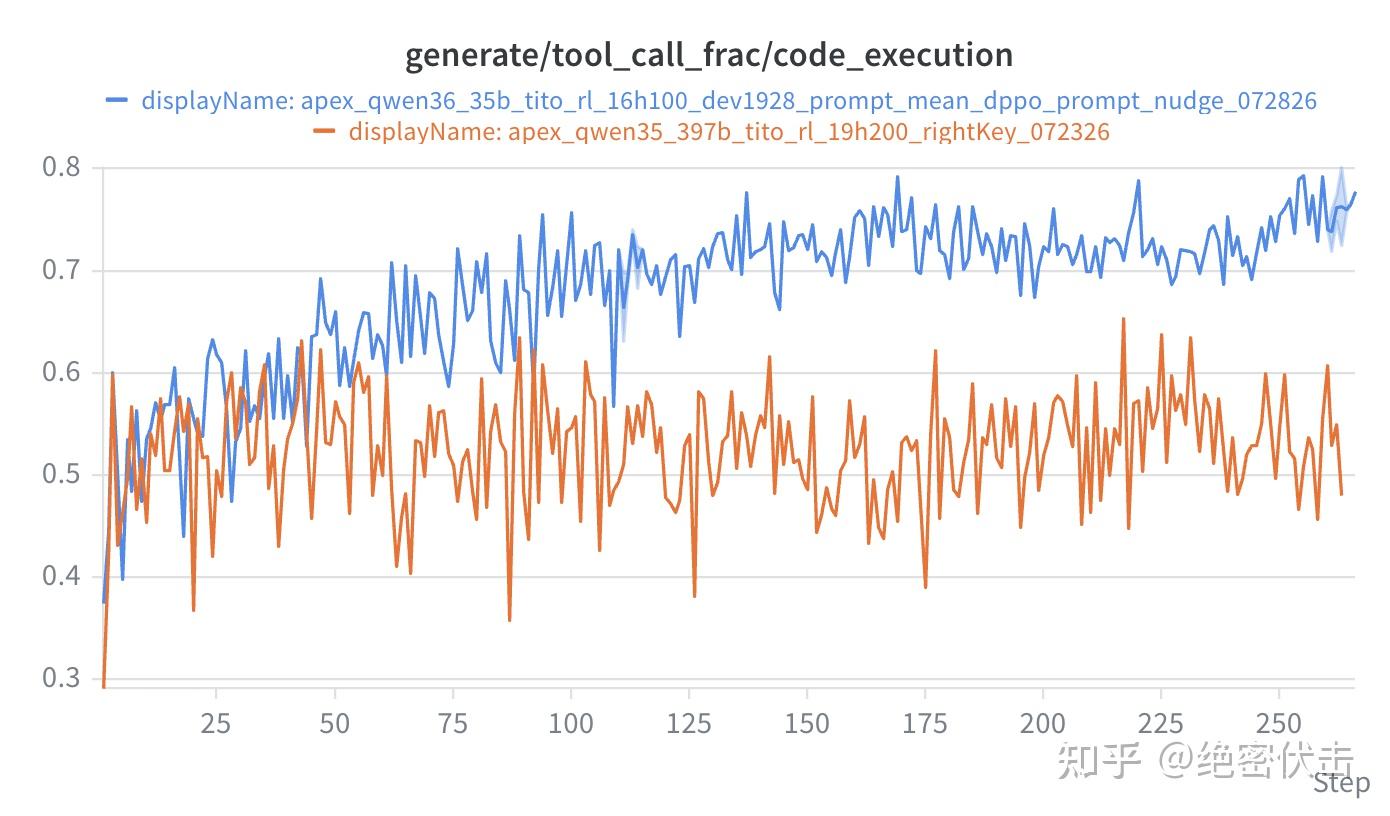
训练过程中:
- 35B 模型的代码执行比例从约 0.5 持续上升到 0.75 以上;
- 397B 模型的代码执行比例长期维持在 0.5 左右。
也就是说,35B 逐渐学会了依赖代码执行,而 397B 仍然更偏好 MCP 工具。
OpenCode 恰好是代码型 Harness,因此 35B 迁移得更好。
作者推测,这可能与Qwen3.6-35B-A3B在基础训练阶段接受过更强的Agentic Post-training有关。
这个结果说明:
Agent是否能够跨Harness泛化,不仅取决于模型规模,还取决于训练过程中形成了怎样的工具偏好。
7.3 同时更换任务和 Harness:Terminal-Bench 2.1
接下来,团队同时更换了评测任务和Harness:
- 数据集换成Terminal-Bench 2.1;
- Harness换成Terminus;
- 每个任务最多1,000步;
- 沙箱最长运行3小时;
- 每组实验执行3次。
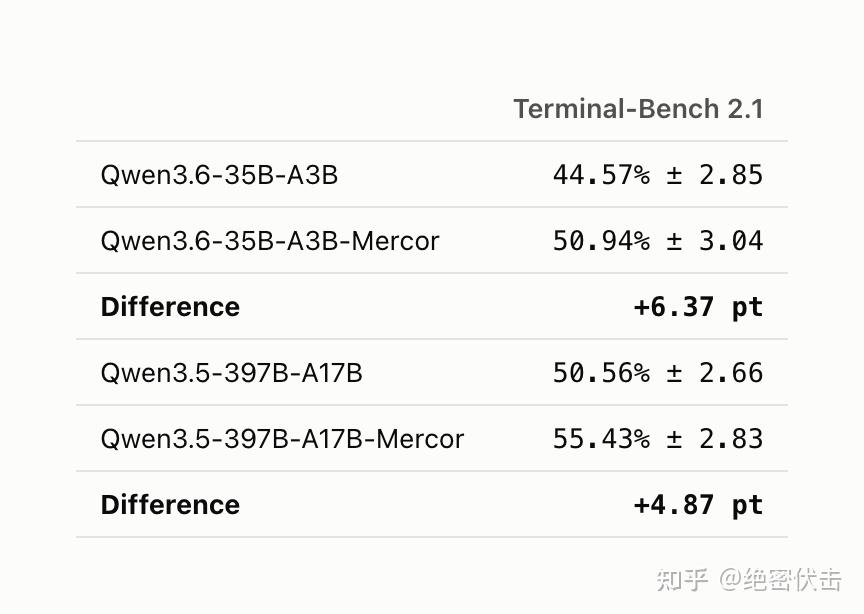
结果为:
| 模型 | 训练前 | 训练后 | 提升 |
|---|---|---|---|
| Qwen3.6-35B-A3B | 44.57% | 50.94% | +6.37 |
| Qwen3.5-397B-A17B | 50.56% | 55.43% | +4.87 |
这说明模型学到的不只是 APEX-Agents 的任务模式,也不只是 Archipelago 的工具格式,而是获得了一定的通用长程 Agent 能力。
35B 模型依然取得了更大的迁移收益,与其更强的代码执行偏好相吻合。
7.4 是否损害了原有推理能力?
团队还在HLE和GPQA上进行了测试。
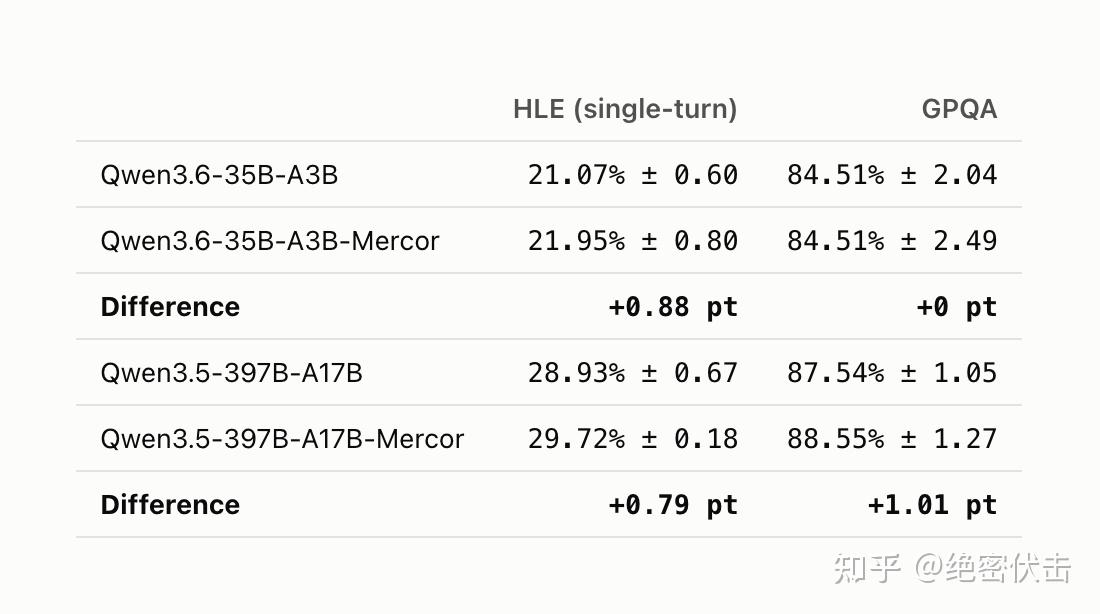
结果显示:
- 35B:HLE提升0.88点,GPQA没有变化;
- 397B:HLE提升0.79点,GPQA提升1.01点。
但这些差异都在误差范围内。
因此,正确的解读不是“ Agent RL 提高了通用推理能力”,而是:
没有观察到显著的非Agent推理能力退化。
这说明专业知识工作 RL 至少没有明显破坏模型原有的知识和推理能力。
文章最后总结了两个最重要的判断。
1. 算法的影响可能没有数据大
团队测试了多种算法和训练技巧。
效果最好的单项改动是 Prompt Mean,提升约 3.9 个百分点;Context Nudge 提升约 3.0 个百分点;DPPO 相对于 GLM-5 Loss 的奖励提升则不显著。
但完整 Post-training 使两个模型都提高了约 10 至 12 个百分点。
与此同时,仅仅修复 Harness,就让未训练模型提高了 5.95 个百分点。
这意味着,决定知识工作 Agent 表现的因素远不只是 Policy Loss,还包括:
- 任务是否来自真实专业工作;
- 环境能否准确还原任务;
- 工具是否可靠;
- Verifier 能否正确判断结果;
- Reward 是否稳定;
- 失败轨迹究竟来自模型还是系统;
- 数据是否覆盖真正的能力缺口。
Coding Agent 之所以较早通过 RL 取得明显进展,很大程度上是因为代码天然具备可执行、可验证的奖励。
但咨询、金融和法律任务没有天然的单元测试。真正困难的是把专业工作转化成:
环境
+ 任务
+ 工具
+ 轨迹
+ 可验证结果
+ 可靠 Reward
从这个角度看,高质量专业数据不仅是“收集更多 Prompt”,而是在构造可供强化学习交互和验证的完整世界。
2. RL 收益没有完全锁死在 Harness 中
经过训练的模型在更换 Agent Harness 后仍然保留了大部分收益,并且能够迁移到T erminal-Bench 2.1。
因此,经过 Post-training 的开放模型并不一定是“焊死”在某套 Agent Scaffold 上的专用组件,也可能成为可复用的能力资产。
不过,397B 模型在 OpenCode 上的收益明显缩小,也说明 Harness 依赖并未完全消失。
总结
这篇文章表面上讲的是“如何训练一个 397B 参数的知识工作 Agent”,但真正有价值的是它给出了一套大规模Agent RL 的实施顺序:
第一步:把环境和 Harness 修好
不要让 MCP 断连、PDF 解析、工具返回、沙箱超时和文件 Diff 污染训练信号。
第二步:保证 Token 完全对齐
使用 TITO 保存推理侧实际采样的 Token ID,避免 Decode 后重新 Tokenize 导致隐蔽的 Off-policy 错位。
第三步:调优异步训练系统
合理配置 Megatron 并行策略、动态 Micro-batch、Rollout 与 Training 资源比例、KV Cache 和最大并发。
第四步:先证明少量任务可以过拟合
如果 32 个任务都学不会,不要直接启动昂贵的 397B 训练。
第五步:在小模型上完成算法消融
Prompt Mean 是最有效的单项改动;DPPO 主要改变 Agent 行为;Context Nudge 可以显著减少无效轨迹。
第六步:再启动大模型正式训练
最终,397B 模型的 APEX-Agents Pass@1 从16.11%提高到27.29%,绝对提升11.18个百分点,相对提升约69%。
第七步:必须检查跨 Harness 与跨任务泛化
只有离开训练 Harness 仍然有效,才能说明模型获得了可复用的 Agent 能力。
整项工作最值得记住的结论是:
Agent RL并不是选定 GRPO、PPO 或者 DPPO 以后就可以开始训练。真正的大规模 Agent RL,是模型、数据、工具、环境、Verifier、分布式推理和训练系统共同组成的工程。
在这些环节中,任何一个部分出现偏差,都可能让几十万 Token 的轨迹变成错误信号。
因此,Mercor 与 SkyRL 给出的最重要经验不是某个新公式,而是一套务实的优先级:
先修环境,再保证 Token 正确;先证明可以过拟合,再比较算法;最后,才值得把 397B 模型放进训练集群。
作者:绝密伏击
https://zhuanlan.zhihu.com/p/2082860762947703480