工具调用、长链推理和环境交互,让 Agent 的每条 rollout 都有自己的节奏:有的很快完成,有的需要多轮交互。训练算法也需要适应这种不规则性,让独立完成的轨迹能够持续进入学习过程。
我们推出 FlashREINFORCE,一个面向 Agentic LLM 的 critic-free、single-rollout、one-pass 异步强化学习方法。
据我们所知,这是首个面向 LLM、公开报告并开源 6,000+ 次稳定训练更新的 critic-free、single-rollout 异步 RL 工作。
方法围绕三个组件展开:
- One-Batch REINFORCE:从独立 prompt 的轨迹中构造正负反馈。
- Sequence Trust Region:在 token IS 之外,筛选整条轨迹的策略漂移。
- Sample-Mean Optimization:平衡轨迹贡献,限制长失败轨迹的额外影响。
实验覆盖长 CoT 数学推理、Python 工具调用和 ALFWorld,并扩展到了 Qwen3-30B-A3B MoE。
1. 为什么是 single-rollout asynchronous RL?
对于长链推理和工具任务,采样预算不仅决定生成多少条轨迹,也决定模型能接触多少个不同的问题。
以一次收集 128 条 rollout 为例:如果每个 prompt 采样 4 次,这批数据覆盖 32 个 prompt;如果每个 prompt 只采样 1 次,则可以覆盖 128 个 prompt。
Single rollout 把更多采样预算用于不同问题,也让学习过程不再依赖同一个 prompt 的 sibling rollouts 凑齐。
这与异步训练自然契合。Rollout workers 各自完成推理和交互,将完成的轨迹提交给 learner;learner 收集下一批可用轨迹后进行更新。
真正需要解决的是:如何让这样的更新持续有效?
一方面,每个 prompt 只有一条轨迹,需要在独立样本之间构造学习反馈。失败轨迹也应贡献信号,但长失败轨迹不应仅因 token 更多,就主导负更新。
另一方面,异步数据可能由不同的策略快照生成。Learner 持续变化,因此需要处理行为策略与当前策略之间的差异。
FlashREINFORCE 将这两个问题连接起来:有效的正负反馈、合适的轨迹权重,以及与异步漂移相匹配的筛选粒度。
2. One-Batch REINFORCE:一批独立轨迹,构造正负反馈
FlashREINFORCE 将不同 prompt 的已完成轨迹组成一个 batch,直接使用 batch 平均奖励作为 baseline:
这里,R_i 是第 i 条轨迹的奖励,A_i 是用于更新的 advantage。
以二元奖励为例,假设一个 batch 的平均奖励为 0.4:
- 成功轨迹得到 1-0.4=0.6 的正反馈;
- 失败轨迹得到 0-0.4=-0.4 的负反馈。
这个例子说明了 batch centering 的作用:让成功和失败都能参与学习,而不需要为每个 prompt 额外生成一组轨迹,也不需要训练或预训练 critic。
在数据使用方式上,每个 batch 都由此前未用于更新的完成轨迹构成。Learner 对它执行一次完整更新,随后丢弃。下一次更新使用下一批轨迹,避免在同一批已采集数据上连续更新时进一步累积策略偏移。
这就是 One-Batch REINFORCE:跨独立 prompt 构造 signed feedback,并采用一次使用、一次更新的训练方式。
3. Sequence Trust Region:动作概率校正之外,再看整条轨迹
3.1 Token IS 校正了什么?
异步训练中,生成轨迹的 behavior policy 与当前 learner policy 可能不同。
FlashREINFORCE 保存生成时的 behavior log-probability,并使用 token importance sampling:
其中,\mu_i 是生成该轨迹的行为策略,\pi_\theta 是当前策略,h_{i,t} 是已经存储的历史。
这里有一个对设计很重要的区别:
Token IS 校正的是给定历史下的动作分布;历史本身仍然由 behavior policy 生成。
长轨迹包含许多这样的历史。论文从 local off-policy surrogate 出发,分析误差如何随累计策略漂移变化,由此引出 sequence-level admission:将整条轨迹作为筛选单位。
3.2 用 KL proxy 决定轨迹是否参与更新
实现中,我们利用已保存的行为概率,计算采样动作对应的 Bernoulli KL proxy。
记
则
它把词表分成“当前采样动作”和“其余动作”两部分,因此只需要生成时保存的动作概率,无需保存完整 behavior logits。
接着,在轨迹内部取平均:
当平均漂移超过阈值时,这条轨迹的全部 loss contribution 都会被移除。
Token IS 负责局部动作校正,Sequence Trust Region 负责完整轨迹的 admission。 两者分别作用于不同粒度。
选择 divergence-based screening 也有直观理由:ratio 表达相对概率变化,KL 则同时考虑变化发生时的概率尺度。这与 DPPO 对 divergence-based trust 的讨论一致。
阈值可以设置得相对宽松,让常规 IS 校正继续发挥作用,把筛选集中在漂移较大的轨迹上。论文中的 Qwen2.5-Math 对照也显示,较宽松的阈值能够保持稳定训练并取得更好的后期均分。
4. Sample-Mean Optimization:让轨迹长度不再额外放大负反馈
失败轨迹的终局奖励通常是粗粒度的。一段推理可能大部分步骤都有效,但最后的答案错误,使整条轨迹获得负 advantage。
因此,负反馈需要保留,它的权重也需要控制。
如果直接把一个 batch 的所有 token loss 放在一起求平均,长轨迹自然会占据更大的权重。
设第 ii 条轨迹内部的平均 token loss 为
两种 reduction 的区别是:
这里的 token loss 已包含 advantage、IS 权重和 sequence mask。
举一个简化例子:两条失败轨迹分别长 1,000 和 4,000 个 token,且平均 token loss 相同。Token mean 会给第二条轨迹四倍的显式权重;sample mean 则给两条轨迹相同的显式权重。
Sample-Mean Optimization 先在轨迹内部平均,再跨轨迹平均,消除这部分长度加权。
这样,失败轨迹仍提供负反馈,同时长失败轨迹不会仅仅因为更长,就额外放大对参数更新的影响。论文附录 C 进一步分析了粗粒度负反馈的动机,正文的 sample-mean/token-mean 对照直接检验轨迹加权方式。
5. 三个组件如何组成一次更新?
整个流程可以概括为五步:
1、 收集下一批已完成、尚未用于更新的独立轨迹。
2、 使用 batch 平均奖励,计算每条轨迹的 signed advantage。
3、 根据已保存的 behavior probability 和当前 learner probability,计算 token IS 与 sequence KL proxy。
4、 对通过 sequence admission 的轨迹,先平均其内部 token loss,再跨轨迹平均。
5、 执行一次完整更新,然后丢弃这批数据。
对应的 loss 为:
更新时,advantage 和 sequence mask 保持固定;IS 权重在这一 loss 实现中使用 stop-gradient。
三个组件在同一个更新中承担清晰的角色:
| 组件 | 处理的问题 | 在更新中的作用 |
|---|---|---|
| One-Batch REINFORCE | 单 rollout 的学习反馈 | 跨独立 prompt 构造 signed advantage |
| Sequence Trust Region | 异步数据的策略漂移 | 决定整条轨迹是否参与更新 |
| Sample-Mean Optimization | 长轨迹的额外权重 | 先按轨迹归一化,再跨轨迹平均 |
这套更新不需要 critic、ratio clipping 或 reference-model forward pass。
6. 实验:稳定性、采样效率,以及 30B MoE 扩展
下文的训练步数指策略更新次数;各基准的平均分对任务赋予相同权重。
6.1 长 CoT:lag 4 下稳定训练至 6,000 次更新
我们在 DeepSeek-R1-Distill-Qwen-1.5B 上进行异步长 CoT 数学训练,每次更新使用 128 条轨迹,policy lag 约为 4。
图中展示前 6,000 次累计更新:AIME24/25 mean avg@32 从 21.7 提升到这一范围内最后一次评测的 33.7;同时,response length 逐步下降,token entropy 逐渐趋于平稳。
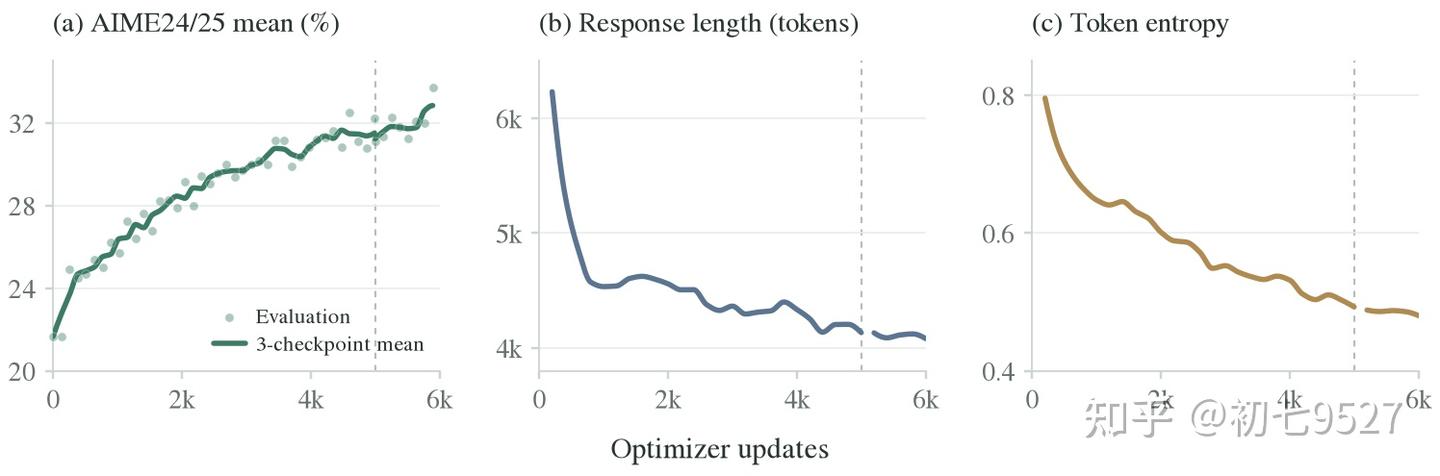
图 1:R1 长 CoT 训练。左图圆点为实际评测,曲线为分段的三检查点移动平均;中、右图为每 200 次更新的窗口均值。虚线标记从第 5,000 步 checkpoint 开始的续训。
这组实验展示了单 rollout、无 critic 的更新方案在长 CoT 异步训练中的持续稳定性。
6.2 数学推理:一半 rollout,取得更高均分
在 Qwen2.5-Math-1.5B 上,我们比较 MATH-500、AMC23、Minerva、AIME25 和 OlympiadBench 五项基准:
| 方法 | Rollout 数 | 五项基准均分 |
|---|---|---|
| C-RF + NTF,论文引用的公开结果 | 512k | 35.3 |
| GRPO,论文引用的公开结果 | 512k | 36.3 |
| FlashREINFORCE | 256k | 38.0 |
FlashREINFORCE 在第 2,000 次更新的 checkpoint 达到 38.0,比已报告的 GRPO 基线高 1.7 个百分点,使用的 rollout 数减少一半。
这一结果体现了单 rollout 方案在采样预算下的竞争力。
6.3 30B MoE:更高 policy lag 下的工具学习
我们进一步将方法应用于 Qwen3-30B-A3B 的 Python 工具任务。
在相同的 102.4k rollout 预算、800 次更新处:
| 方法 | Policy lag | AMC23 / Minerva / AIME25 均分 |
|---|---|---|
| GRPO | 约 1 | 60.3 |
| FlashREINFORCE | 约 8 | 67.1 |
FlashREINFORCE 的三项评测均分领先 6.8 个百分点。
扩展稳定性实验中,带 routing replay 的 R3 配置训练至 1,450 次策略更新,在第 1,000–1,450 次更新期间维持 63.7–66.8 的三项均分,最终为 66.4。
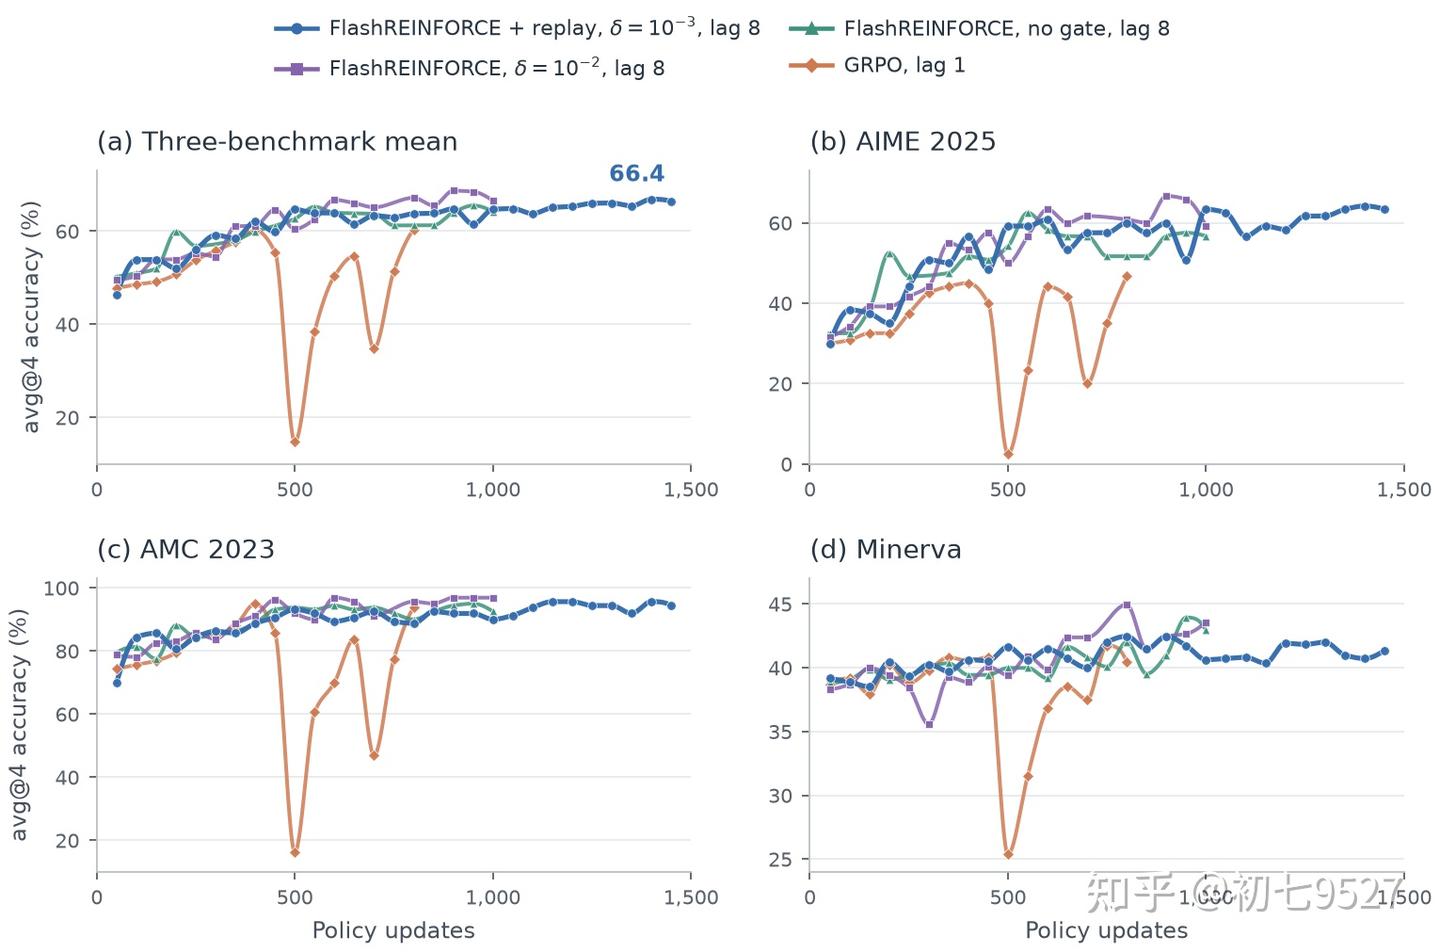
图 2:30B MoE 工具训练。FlashREINFORCE 的 policy lag 约为 8,GRPO 约为 1;标记为实际 avg@4 评测,曲线为保形插值。R3 展示至第 1,450 次策略更新。
从 1.5B 长 CoT 到 30B MoE 工具任务,这些结果提供了不同模型和异步程度下的稳定性证据。
6.4 工具使用与交互任务
在 Qwen2.5-7B-Instruct 的 Python 工具实验中,第 600 次更新时:
- FlashREINFORCE 的三项评测均分为 37.0,GRPO 为 30.3;
- FlashREINFORCE 保持每条轨迹平均 3.25 次工具调用,对应 GRPO 为 0.00。
更高的答案准确率与持续的工具使用同时出现。
在 ALFWorld 中,同一基础模型取得 98.3% seen / 96.5% unseen 成功率,覆盖了交互式决策任务。
7. 消融如何支撑这些设计?
论文通过不同对照,分别检验反馈、轨迹加权和 admission 粒度。
保留 signed feedback。 在 Qwen2.5-7B-Instruct 工具任务中,保留 batch-centered 正负反馈的三项均分为 36.2,positive-only 对照为 9.8;前者也保持了工具调用。这支持让失败轨迹继续贡献学习信号。
按轨迹平均 loss。 从第 900 步 checkpoint 继续约 150 次更新后,sample mean 的训练奖励为 0.477、截断率为 17.2%;token mean 对应为 0.403 和 45.3%。这组对照支持通过轨迹归一化控制长度加权。
按完整轨迹进行 admission。 在 Qwen2.5-Math 的同一 KL proxy、同一阈值对照中,sequence-level 方案保持稳定,而 token-local 方案出现奖励下降和熵上升。该结果与论文关于完整轨迹贡献的设计动机一致。
这些实验分别回答了三个问题:失败轨迹是否应参与学习、轨迹长度如何影响更新、以及漂移筛选应作用于哪个粒度。
8. 开源与交流
FlashREINFORCE 提供了一条面向异步 Agent RL 的简洁路径:每个 prompt 一条 rollout,以 batch 构造反馈,以 sequence 筛选漂移,以 sample 平衡贡献。
我们希望这项工作能帮助研究者探索长链推理、工具交互和更灵活的异步训练流程。
📄 论文:FlashREINFORCE: Critic-Free Single Rollout Asynchronous RL for Agentic Language Models
🔗 链接:https://www.researchgate.net/publication/414274571_FLASHREINFORCE_CRITIC-FREE_SINGLE-ROLLOUT_ASYNCHRONOUS_RL_FOR_AGENTIC_LANGUAGE_MODELS
💻 代码:https://github.com/NVIDIA-NeMo/labs-molt
欢迎阅读论文、体验代码,也欢迎交流异步 RL、单 rollout 训练和 Agent 学习中的经验。
作者:初七
原文链接:9527https://zhuanlan.zhihu.com/p/2082798684144771194