
让模型继续变强,眼下最缺的往往不是想法,而是反馈:代码修复要跑测试,化学反应要上实验台,免疫研究要做湿实验。每一次执行都是真实成本。
反馈一贵,问题就从“怎么改”变成“先试哪个”。同一个 coder 给出四个候选补丁,同一轮里只执行其中一个;同一批反应条件,实验台只给 40 次机会。选错一次,机会就少一次。
麻烦还在于,这类系统很难“一轮比一轮好”——而这种靠经验持续变强的能力,研究里叫递归自我改进(recursive self-improvement,RSI)。
策略一更新,它提出的候选变了,候选背后的经验分布也跟着变;世界模型是在旧分布上训练的,预测可靠性可能悄悄失效。
反过来,世界模型一改,候选排序、想象轨迹与训练信号又全变。把单个部件做得更好,并不保证两者装在一起更好。
RSI-Anything 要处理的正是这个问题。它由 PhAI Labs、香港中文大学等团队提出,建立在团队前作 JEPA-Anything 之上:预测决定哪个候选值得花掉一次反馈,反馈再决定策略与世界模型各自要不要更新。

一轮循环大致六步:策略提出候选 → 世界模型预测后果 → 排序并选择 → 执行拿回反馈 → 更新策略或工作流 → 决定保留哪一对。
选择这一步,排序分数是预测效用,启用不确定性估计时再减去一项惩罚;反馈只来自真正被执行的那几个候选。也正因为覆盖面有限,另一个判断要格外小心:世界模型现在还可靠吗?
答案是三态,reliable、unreliable、insufficient。关键在第三态——覆盖不够时,必须判“证据不足”,而不是“看起来还行”。选择偏差由此被写进协议本身,而不是留到事后解释。
更新之后还有一道门,管“留下什么”。组件门分别检查策略的任务效用与世界模型的预测质量;配对门再检查装配后的整体——在新策略提出的候选上,世界模型的预测还准不准。
组件不过只回退该组件,配对不过则整对回退。被保留的那一版策略-模型对,决定下一轮的候选池与经验分布。“递归”的分量就落在这里:不是多跑几轮,而是更新被保留下来,并真的改变了后续的交互与学习。

代码修复是最干净的一组对照:coder 固定为 ReasonFlux-Coder-7B,200 道 CodeContests 题、3 个随机种子,每轮提四个候选、最多三轮反馈。
隐藏测试全通过率从容量匹配静态验证器的 26.3%,到预测引导选择的 29.2%,再到世界模型自适应后的 31.2%;而每任务的在线测试调用稳定在 3.71–3.72 次。增益不是靠多花测试换来的:预测器本身也更准,候选排序准确率从 66.5% 升到 72.8%,五类 Brier 分数从 0.488 降到 0.358。
同一套机制在别的任务上也成立。GUI 上,MiniWoB++ 的 click-checkboxes 三档保留版本成功率 51% → 79% → 99%,每回合平均动作数从 5.30 降到 3.21,重复点击从 237 次归零。
实验室规划里,同一次自我改进过程产出的五个连续 4B 策略版本,在 LabHorizon F200 Level-2 上从 21.80% 升到 46.01%,终版 0.4601 超过由 35B Actor 加 Gemini 3.1 Pro 组成的参考系统(0.4532),也高于 GPT-5.5、Gemini 3.1 Pro 直接提示的结果。
反应优化把机制搬上实验台:两个 Suzuki–Miyaura 筛选各自与贝叶斯优化对照,同等预算下,40 次流动 LC–MS 屏的最佳观测产率 96.15%、贝叶斯优化 82.16%,另一组 GC 屏在 20 次实验时是 93.0% 对 87.5%。
这套机制的底座 JEPA-Anything 本身也值得一看:它用正交预测分解(OPF)把潜在预测目标拆成互补因子,每个因子走专属预测通路,再合成完整状态,同一套建模骨架覆盖视觉、生物、临床轨迹、控制、分子动力学、物理场与天气七个领域。
在 Interventional Pong 上,单干预预测误差降低 34.8%;四个分子体系的 100 步 rollout 误差在对比方法中最低;一个由因子提名的生物学干预,在细胞共培养、类器官、肿瘤碎片与小鼠上拿到了实验支持。
论文:RSI-Anything: Unlocking Recursive Self-Improvement with World Models
链接:https://arxiv.org/abs/2610.13912
代码:https://github.com/Gen-Verse/RSI-Anything
数据:https://huggingface.co/datasets/Gen-Verse/RSI-Anything

底座:JEPA-Anything: Learning Predictive Models across Different Worlds
链接:https://arxiv.org/abs/2609.20800
代码:https://github.com/Gen-Verse/JEPA-Anything
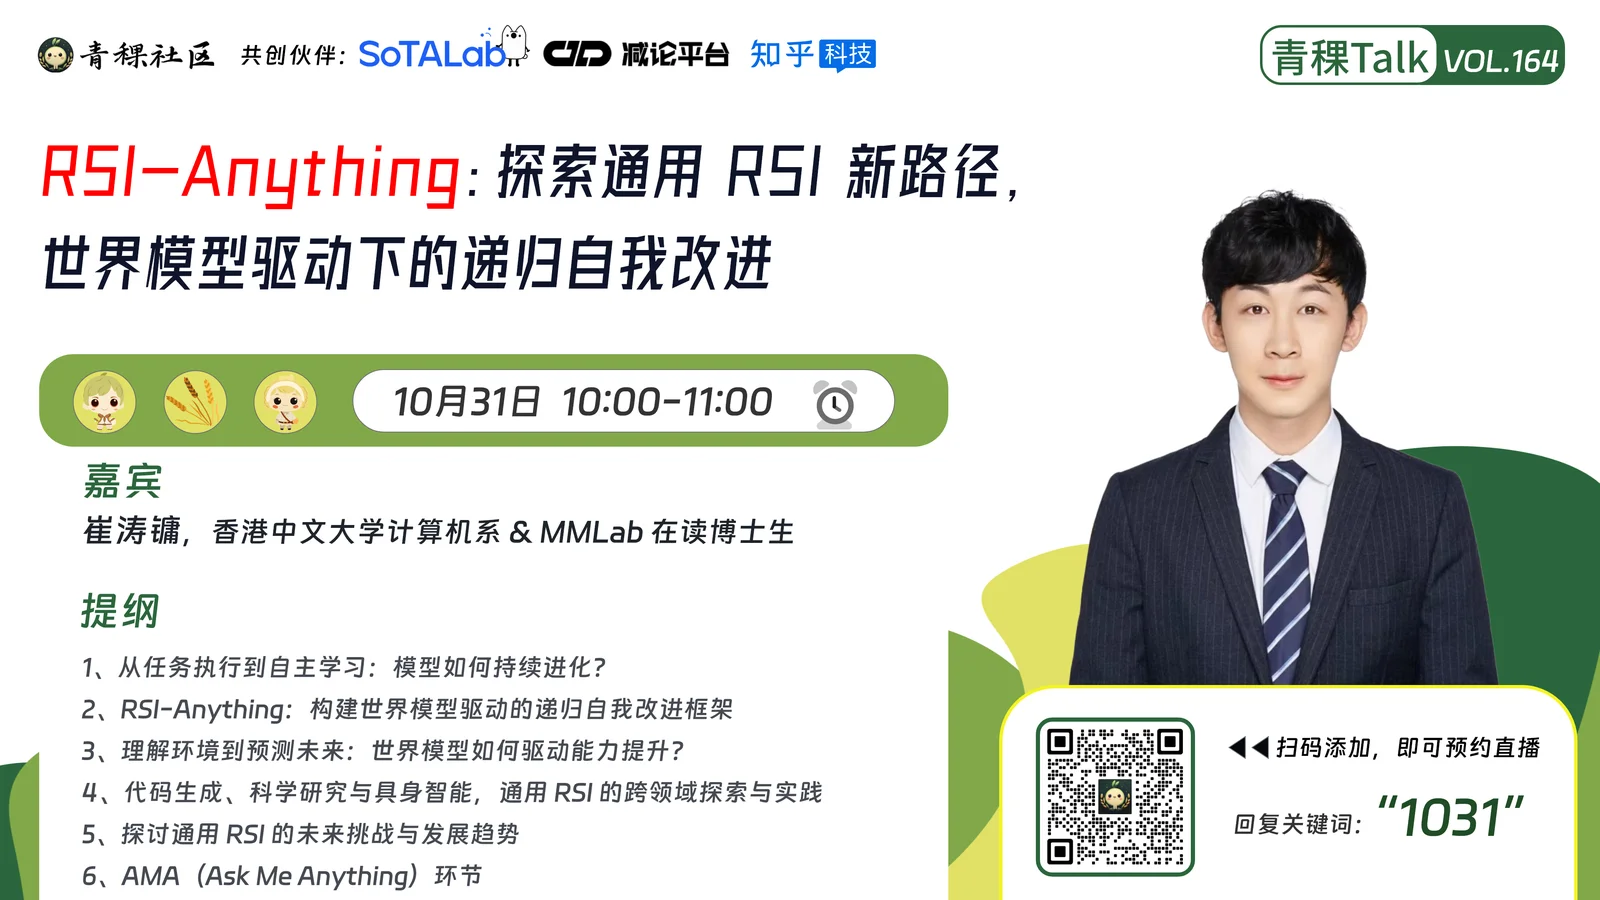
10月31日(周六)上午10点,青稞Talk 第163期,青稞社区邀请到 RSI-Anything 第一作者、香港中文大学计算机系 & MMLab 博士生崔涛镛,分享《RSI-Anything:探索通用 RSI 新路径,世界模型驱动下的递归自我改进》。
嘉宾介绍
崔涛镛,香港中文大学计算机系 & MMLab 在读博士生,曾在微软研究院和上海人工智能实验室开展研究。研究聚焦 AI for Science、物理世界建模与递归自我改进,以第一作者或共同第一作者在 Nature Machine Intelligence、Nature Communications 等 Nature 子刊发表论文多篇,曾获世界人工智能大会青年优秀论文奖等国内外奖项。近期作为第一作者与团队共同发布 JEPA-Anything 和 RSI-Anything,并参与 Gen-Verse 开源社区建设。
分享内容
RSI-Anything:探索通用 RSI 新路径,世界模型驱动下的递归自我改进
1、从任务执行到自主学习:模型如何持续进化?
2、RSI-Anything:构建世界模型驱动的递归自我改进框架
3、理解环境到预测未来:世界模型如何驱动能力提升?
4、代码生成、科学研究与具身智能,通用RSI的跨领域探索与实践
5、探讨通用RSI的未来挑战与发展趋势
6、AMA (Ask Me Anything)环节
直播时间
10月31日(周六)10:00 - 11:00
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册