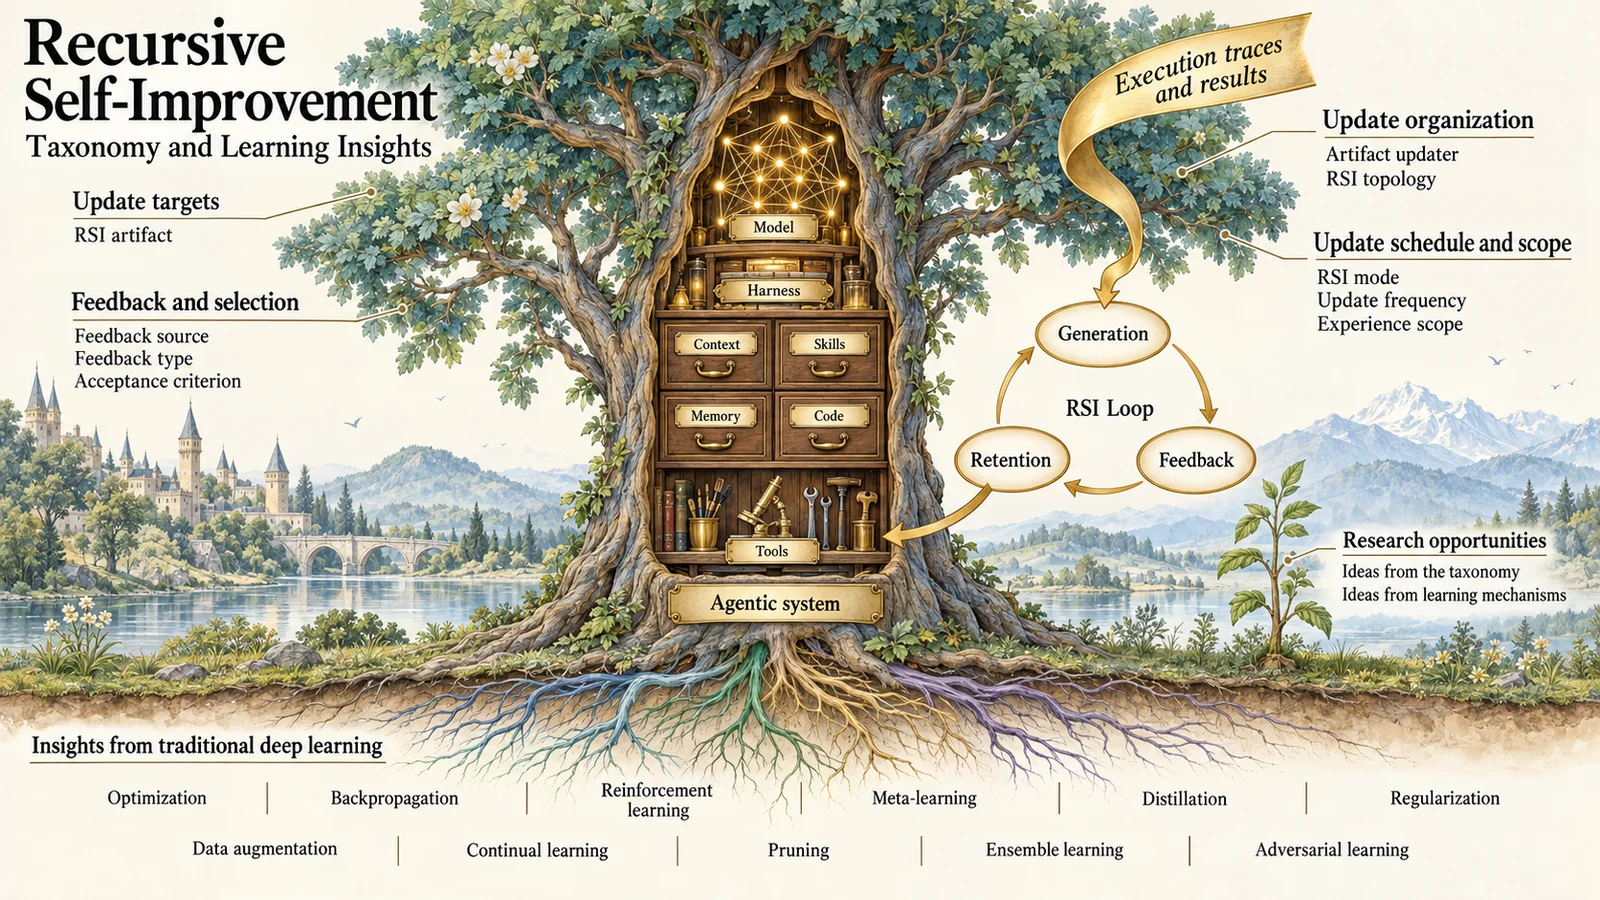
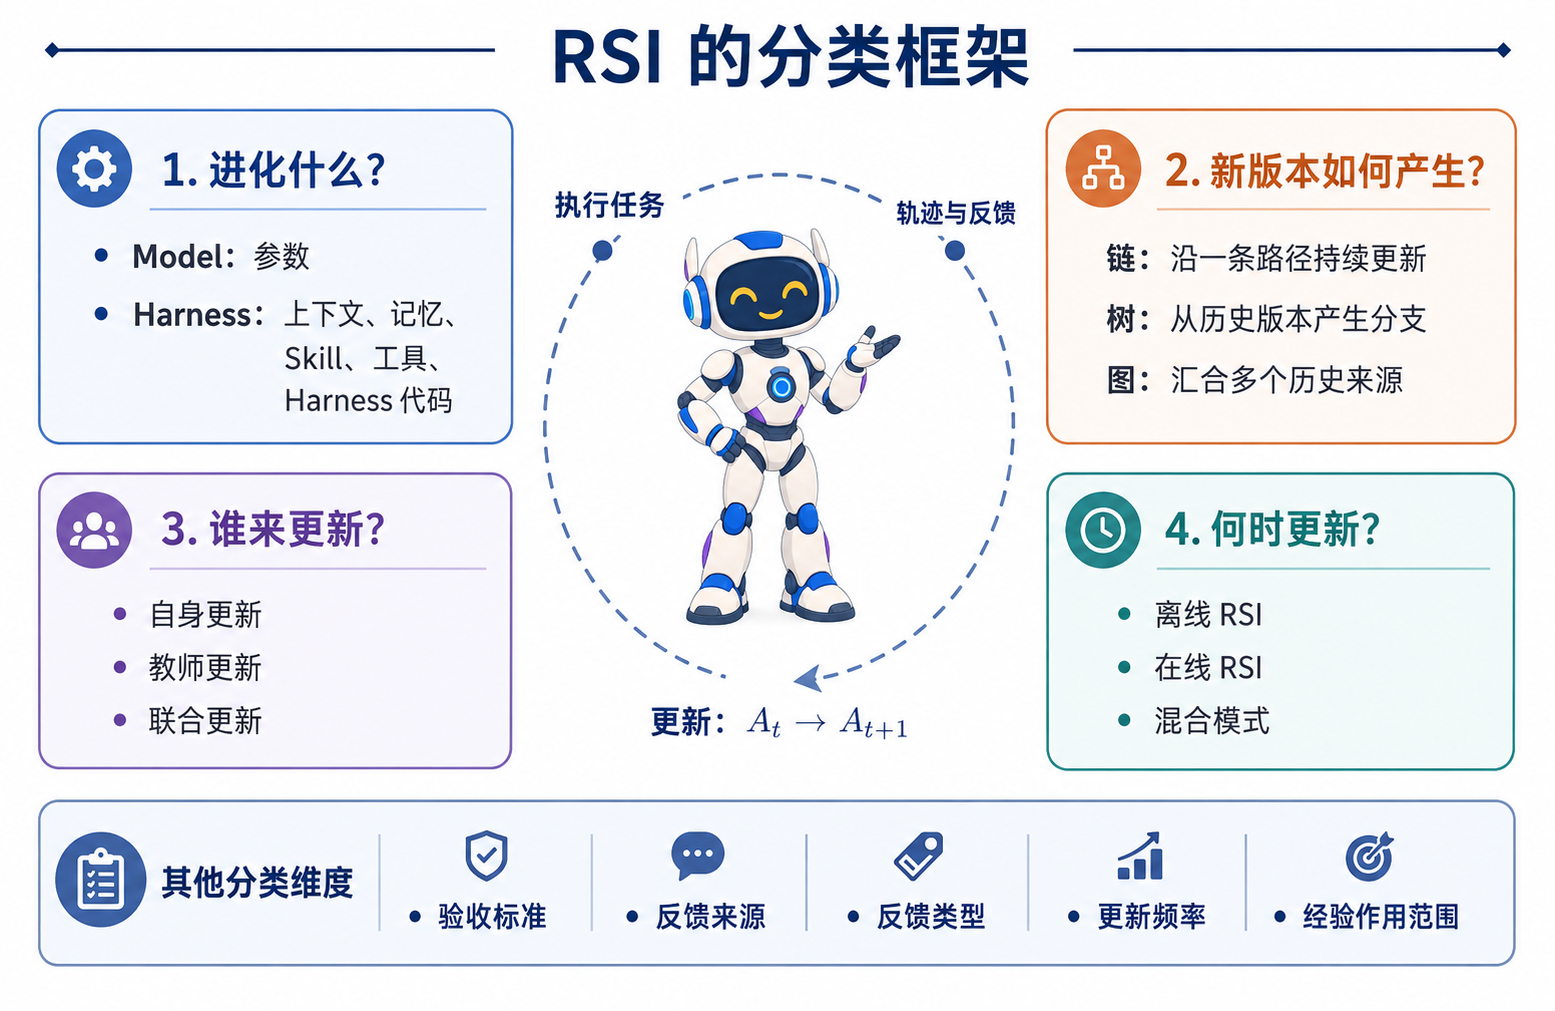
精选文章 RSI,正在重走深度学习的老路 作者:南冥有一鱼 https://zhuanlan.zhihu.com/p/2093754106439545815 过去一段时间,RSI(Recursive Self-Improvement)正在从一个遥远的设想变成现实。市面上出现了一大批可以动手实验的论文和方法。这些论文有的修改自己的 Skill
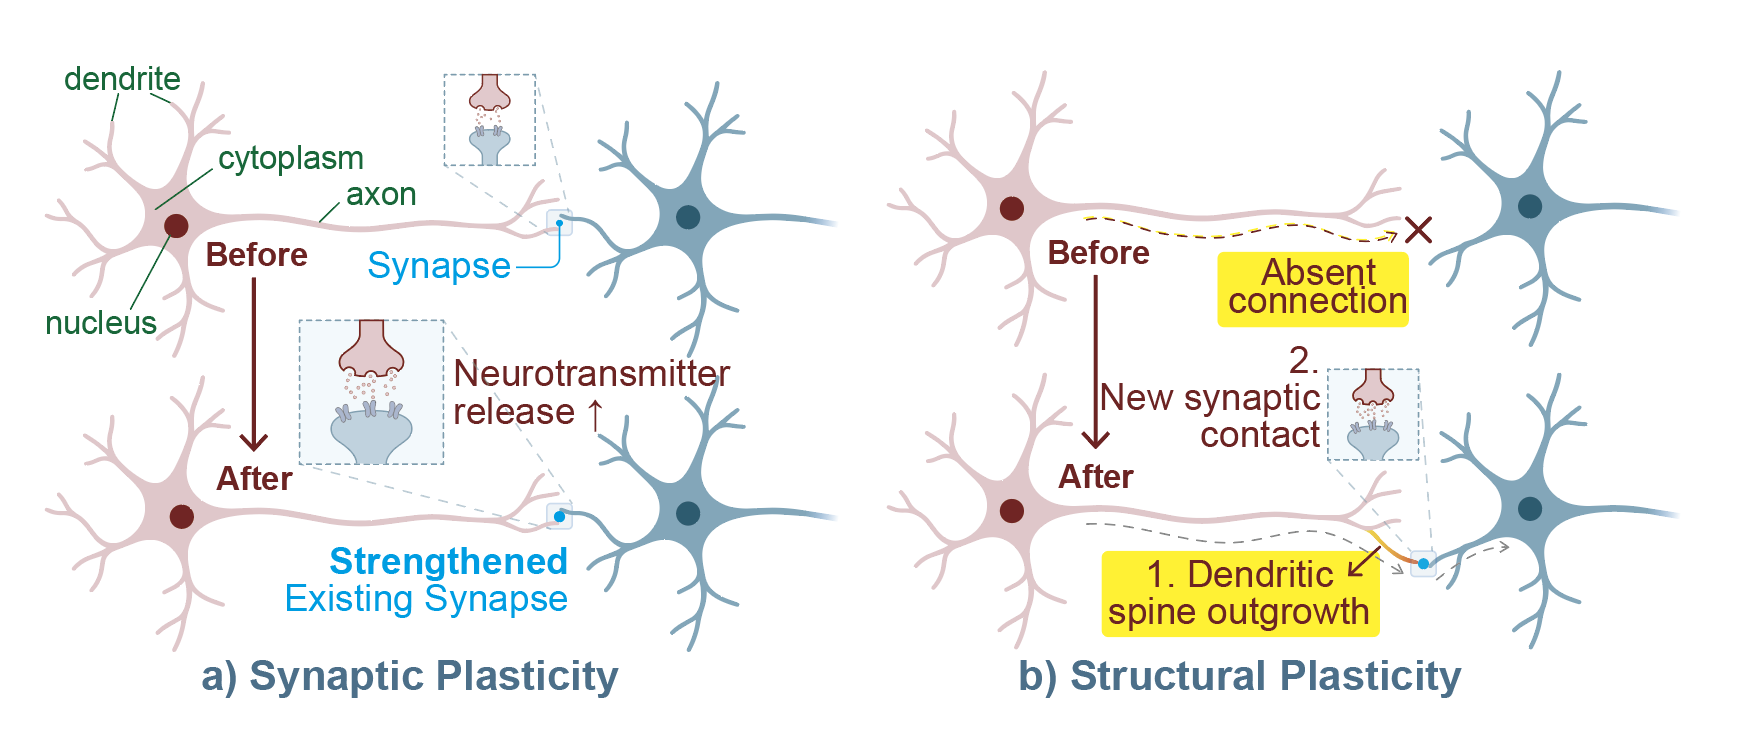
精选文章 把经验真正沉淀为长期参数记忆!浙大& Seed 提出 Cortex,探索 Agent 持续自我进化 一次成功操作、一段纠错反馈,能否成为智能体下一次进步的起点?Cortex 将经验带来的帮助沉淀为长期参数记忆,在学习新内容的同时尽量保留已有能力,为智能体的持续自我改进提供可积累的基础。 一个智能体(Agent)接到任务后,会查阅文档、调用工具、尝试不同方案。在解决问题的过程中,它可能借助文档用对了
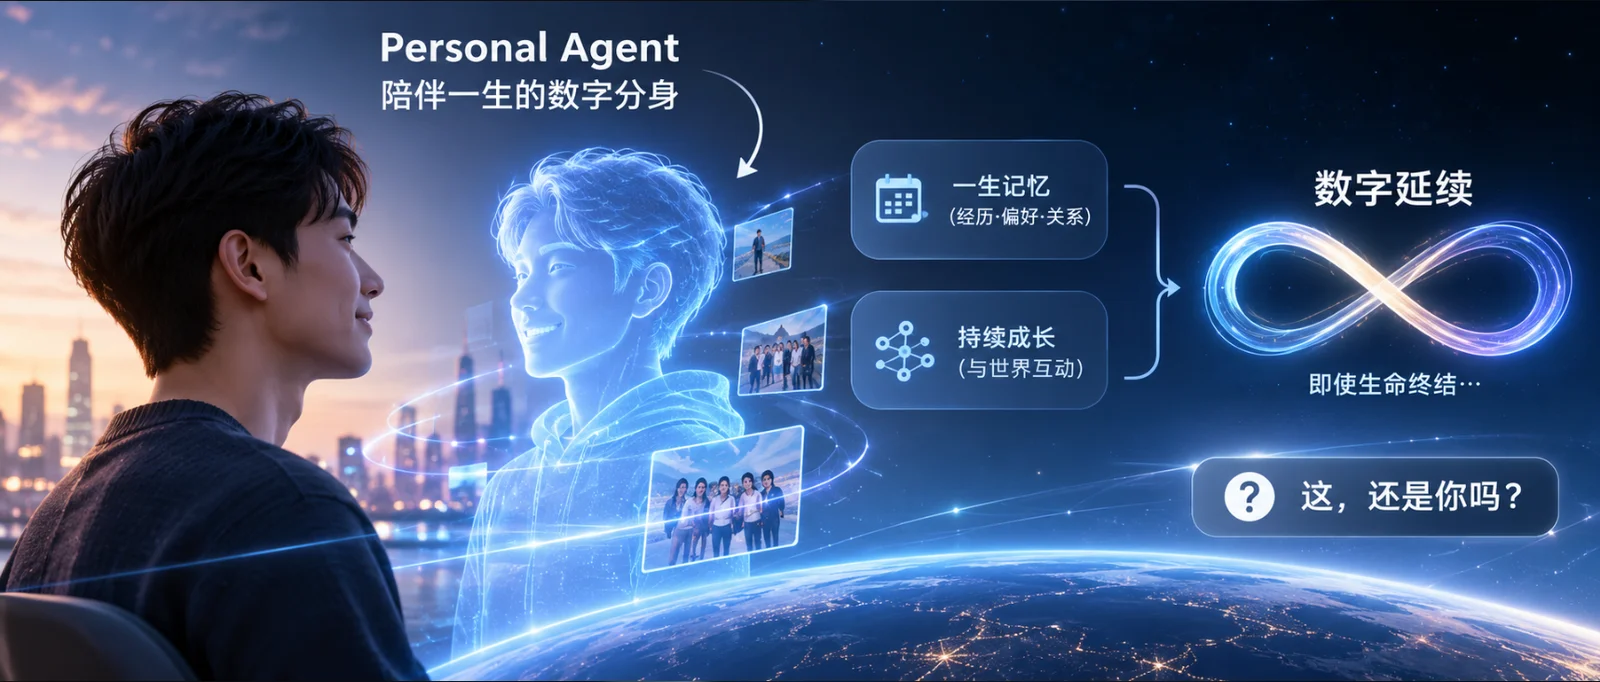
精选文章 DeepMate 创始人王鸿儒:Personal Agent,可能是人类实现「永生」的版本答案! Personal Agent,可能是人类实现「永生」的版本答案 一个有点可怕的想法:也许未来人类的死亡,不再意味着一个人的彻底消失。 最近在做 DeepMate,一个围绕人与 Personal Agent 的记忆、身份和社交关系构建的 AI 产品。 在思考 Agent 的长期记忆机制时,突然意识到一
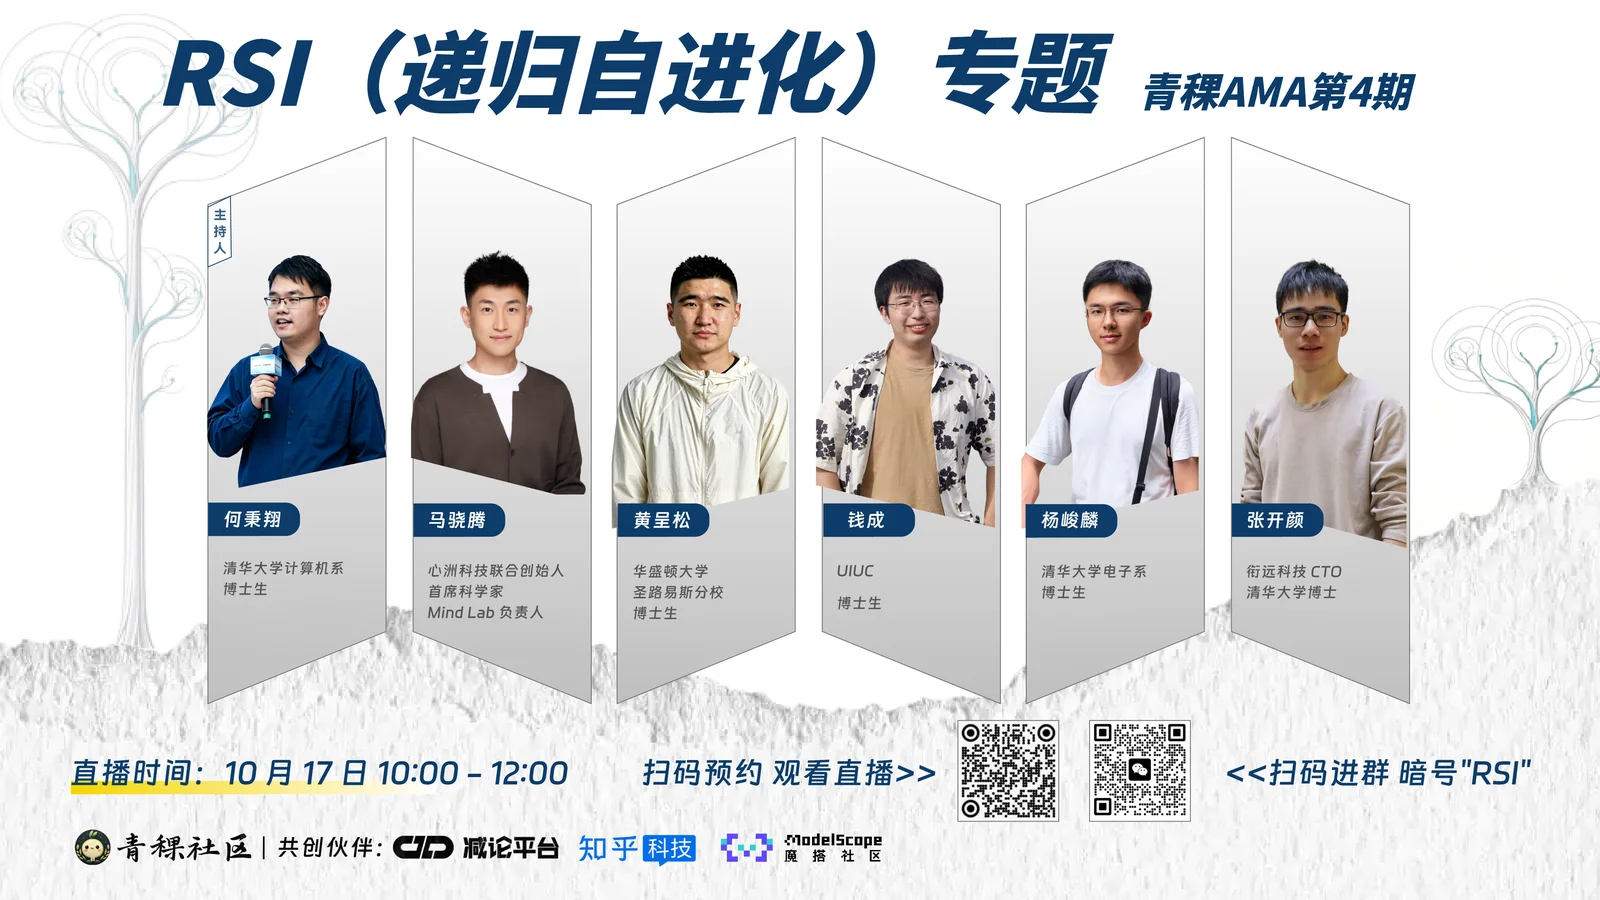
青稞AMA RSI 专题实录!RSI 的定义、技术路线、瓶颈、Benchmark、未来形态,以及人又会扮演什么样的角色 AI 能否改进自己的推理、训练方法和 Agent 系统? 当模型能够生成改进方案、构建实验环境、验证结果,并将有效改进带入下一轮迭代,我们距离真正的 RSI(递归自进化)还有多远? RSI 正在成为 AI 研究中的一个重要议题,但它并不是一个边界清晰、人人理解一致的概念。 Self-Evolutio
精选文章 Robotics RSI大时代,我们应该做什么 转眼间已经距离Astra横空出世过去了好几个月了,这段时间也出了非常多的RSI、Harness系统刷爆了仿真,特别是之前被誉为珠峰的Robodojo,平均一周榜首换两三个,还基本上都是Agentic系统。 在这个狂欢下,我们不禁注意到,仍然有若干问题是agent无法解决的,以及一些是即使到GPT7、
青稞Talk 直播预告!从 JEPA-Anything 到 RSI-Anything:探索通用 RSI 新路径,世界模型驱动下的递归自我改进 让模型继续变强,眼下最缺的往往不是想法,而是反馈:代码修复要跑测试,化学反应要上实验台,免疫研究要做湿实验。每一次执行都是真实成本。 反馈一贵,问题就从“怎么改”变成“先试哪个”。同一个 coder 给出四个候选补丁,同一轮里只执行其中一个;同一批反应条件,实验台只给 40 次机会。选错一次,机会就
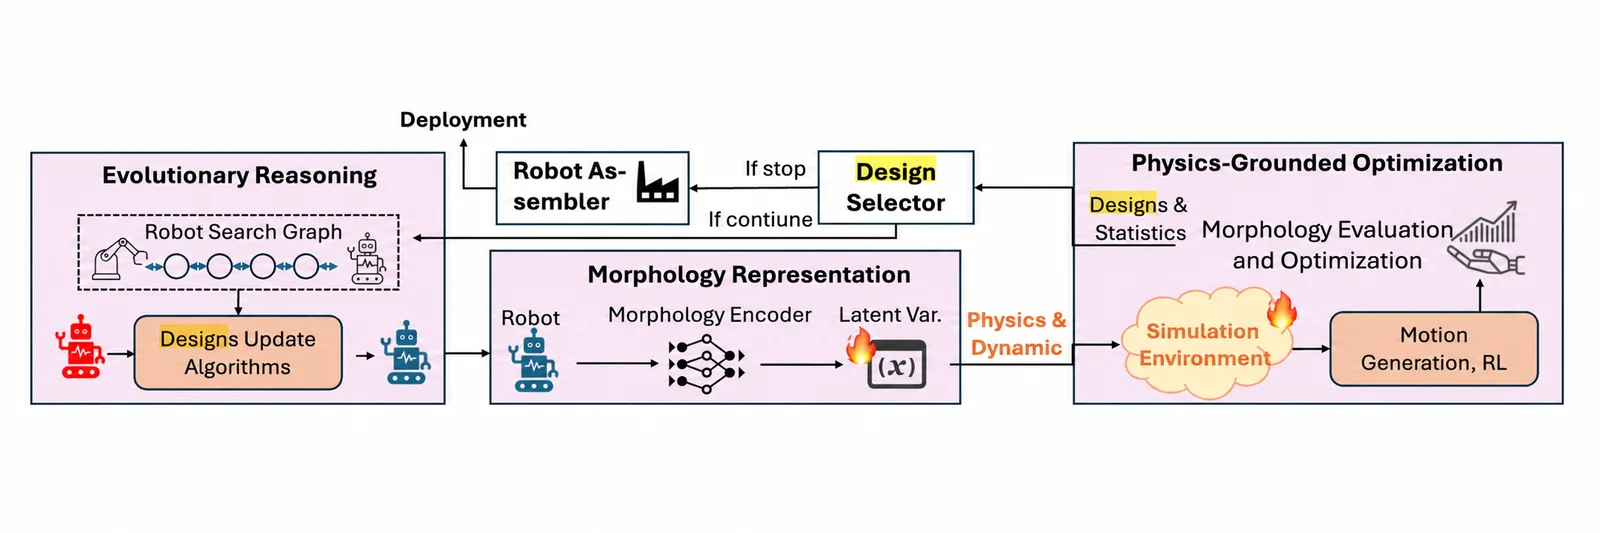
精选文章 别只升级“大脑”!NeurIPS 2026 论文呼吁:机器人的身体也该进化 作者:岳博,在香港中文大学(深圳)在读博士 青稞社区为科研人员提供成果宣传支持,如有优秀研究成果分享推广,欢迎投稿联系:aiFreeCode 谈到具身智能,我们很容易想到更强的视觉语言模型、更多的机器人数据,以及更好的控制策略。但有一个问题往往被放在了训练之外:如果机器人的身体本身不适合任务,再聪明
青稞Talk 直播预告!从 Code-as-Policies 到 EmbodiedRSI,聊聊具身智能体的自主学习与自我进化 近年来,机器人学习主要依赖模仿学习:用大量专家示范数据训练策略。但换个任务、变个环境,往往就要重新采集数据、重新训练——成本高,扩展性也差。 更麻烦的是,机器人基础模型在物体位置或任务指令变化时,性能会明显下降;想要进一步改进,又需要大量遥操作数据做后训练。 那么问题来了:能不能让具身智能体像人一样
精选文章 NeurIPS 2026 高分论文!清华提出 SAFLOW,构建面向在线强化学习的自伴随生成式策略 清华大学车辆学院与人工智能学院团队提出最新研究成果《Self-Adjoint Flow Policy Optimization》,构建了面向在线强化学习的自伴随生成式策略 SAFLOW。论文已被 NeurIPS 2026 接收。OpenReview 评审评分为 5 / 5 / 5 / 4(6 分制)
青稞AMA 直播预告!当 AI 开始改进 AI,我们离真正的 RSI 还有多远?|青稞 AMA:RSI 专题 AI 能改进自己的推理、训练方法和 Agent 系统吗? 当模型能够生成改进方案、构建实验环境、验证结果,并将有效改进带入下一轮迭代,我们距离真正的递归自我改进(Recursive Self-Improvement,RSI)还有多远? RSI 正在成为 AI 研究中的一个重要议题,但它并不是一个边界
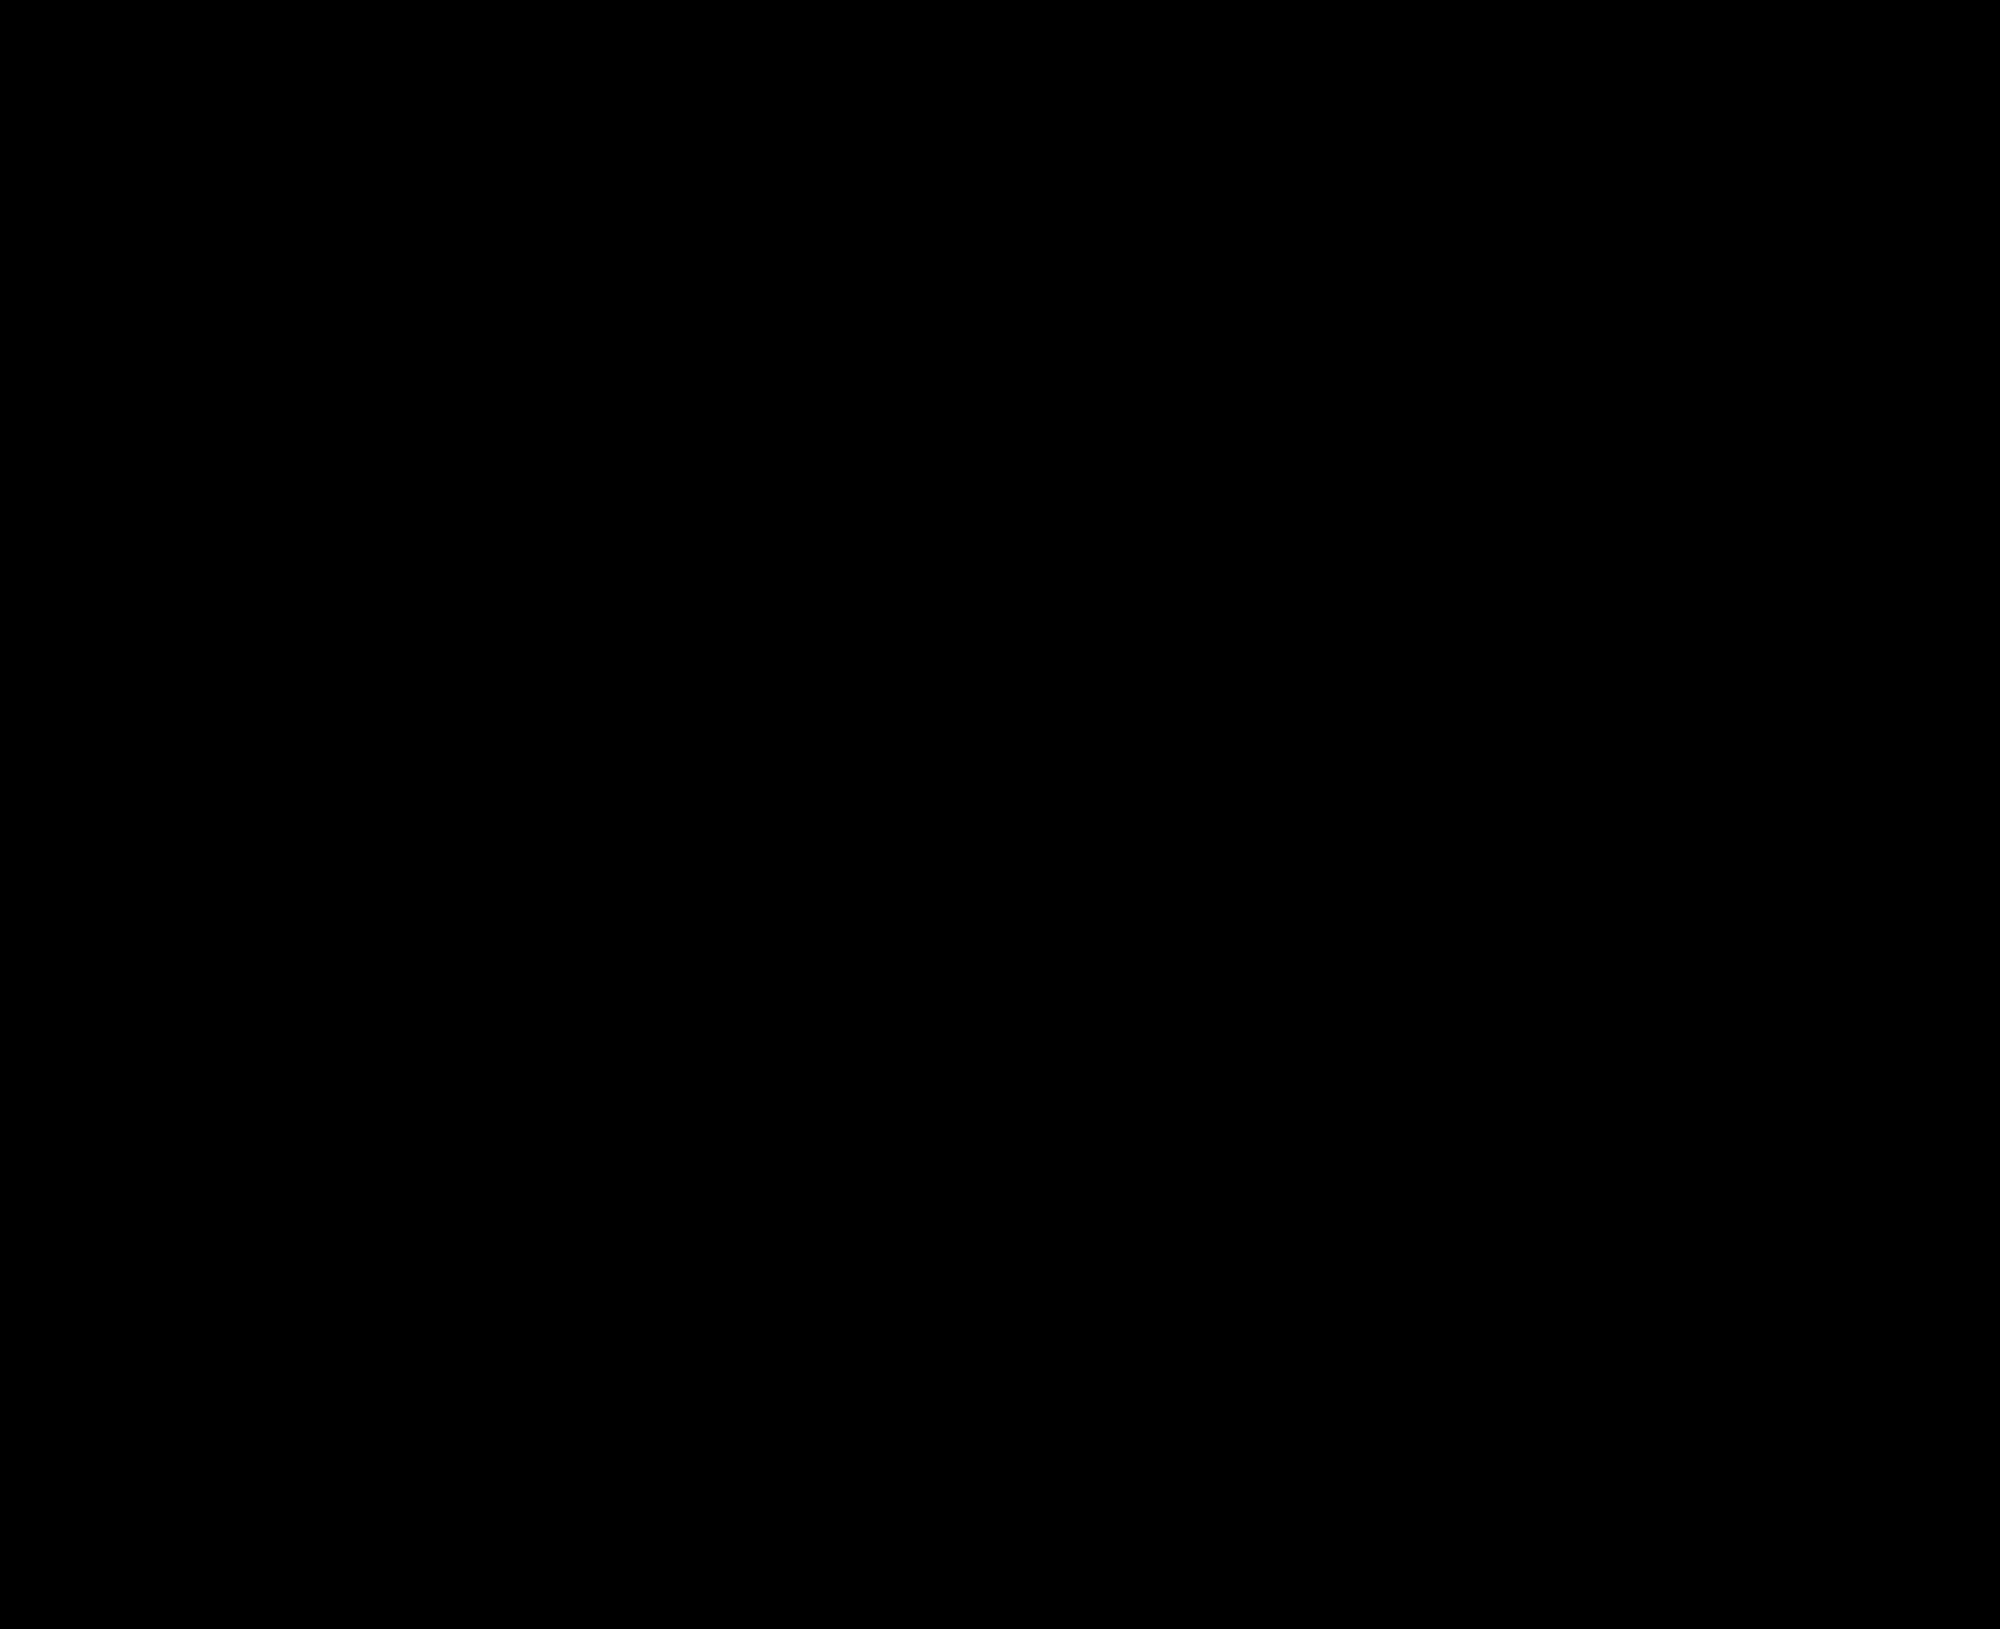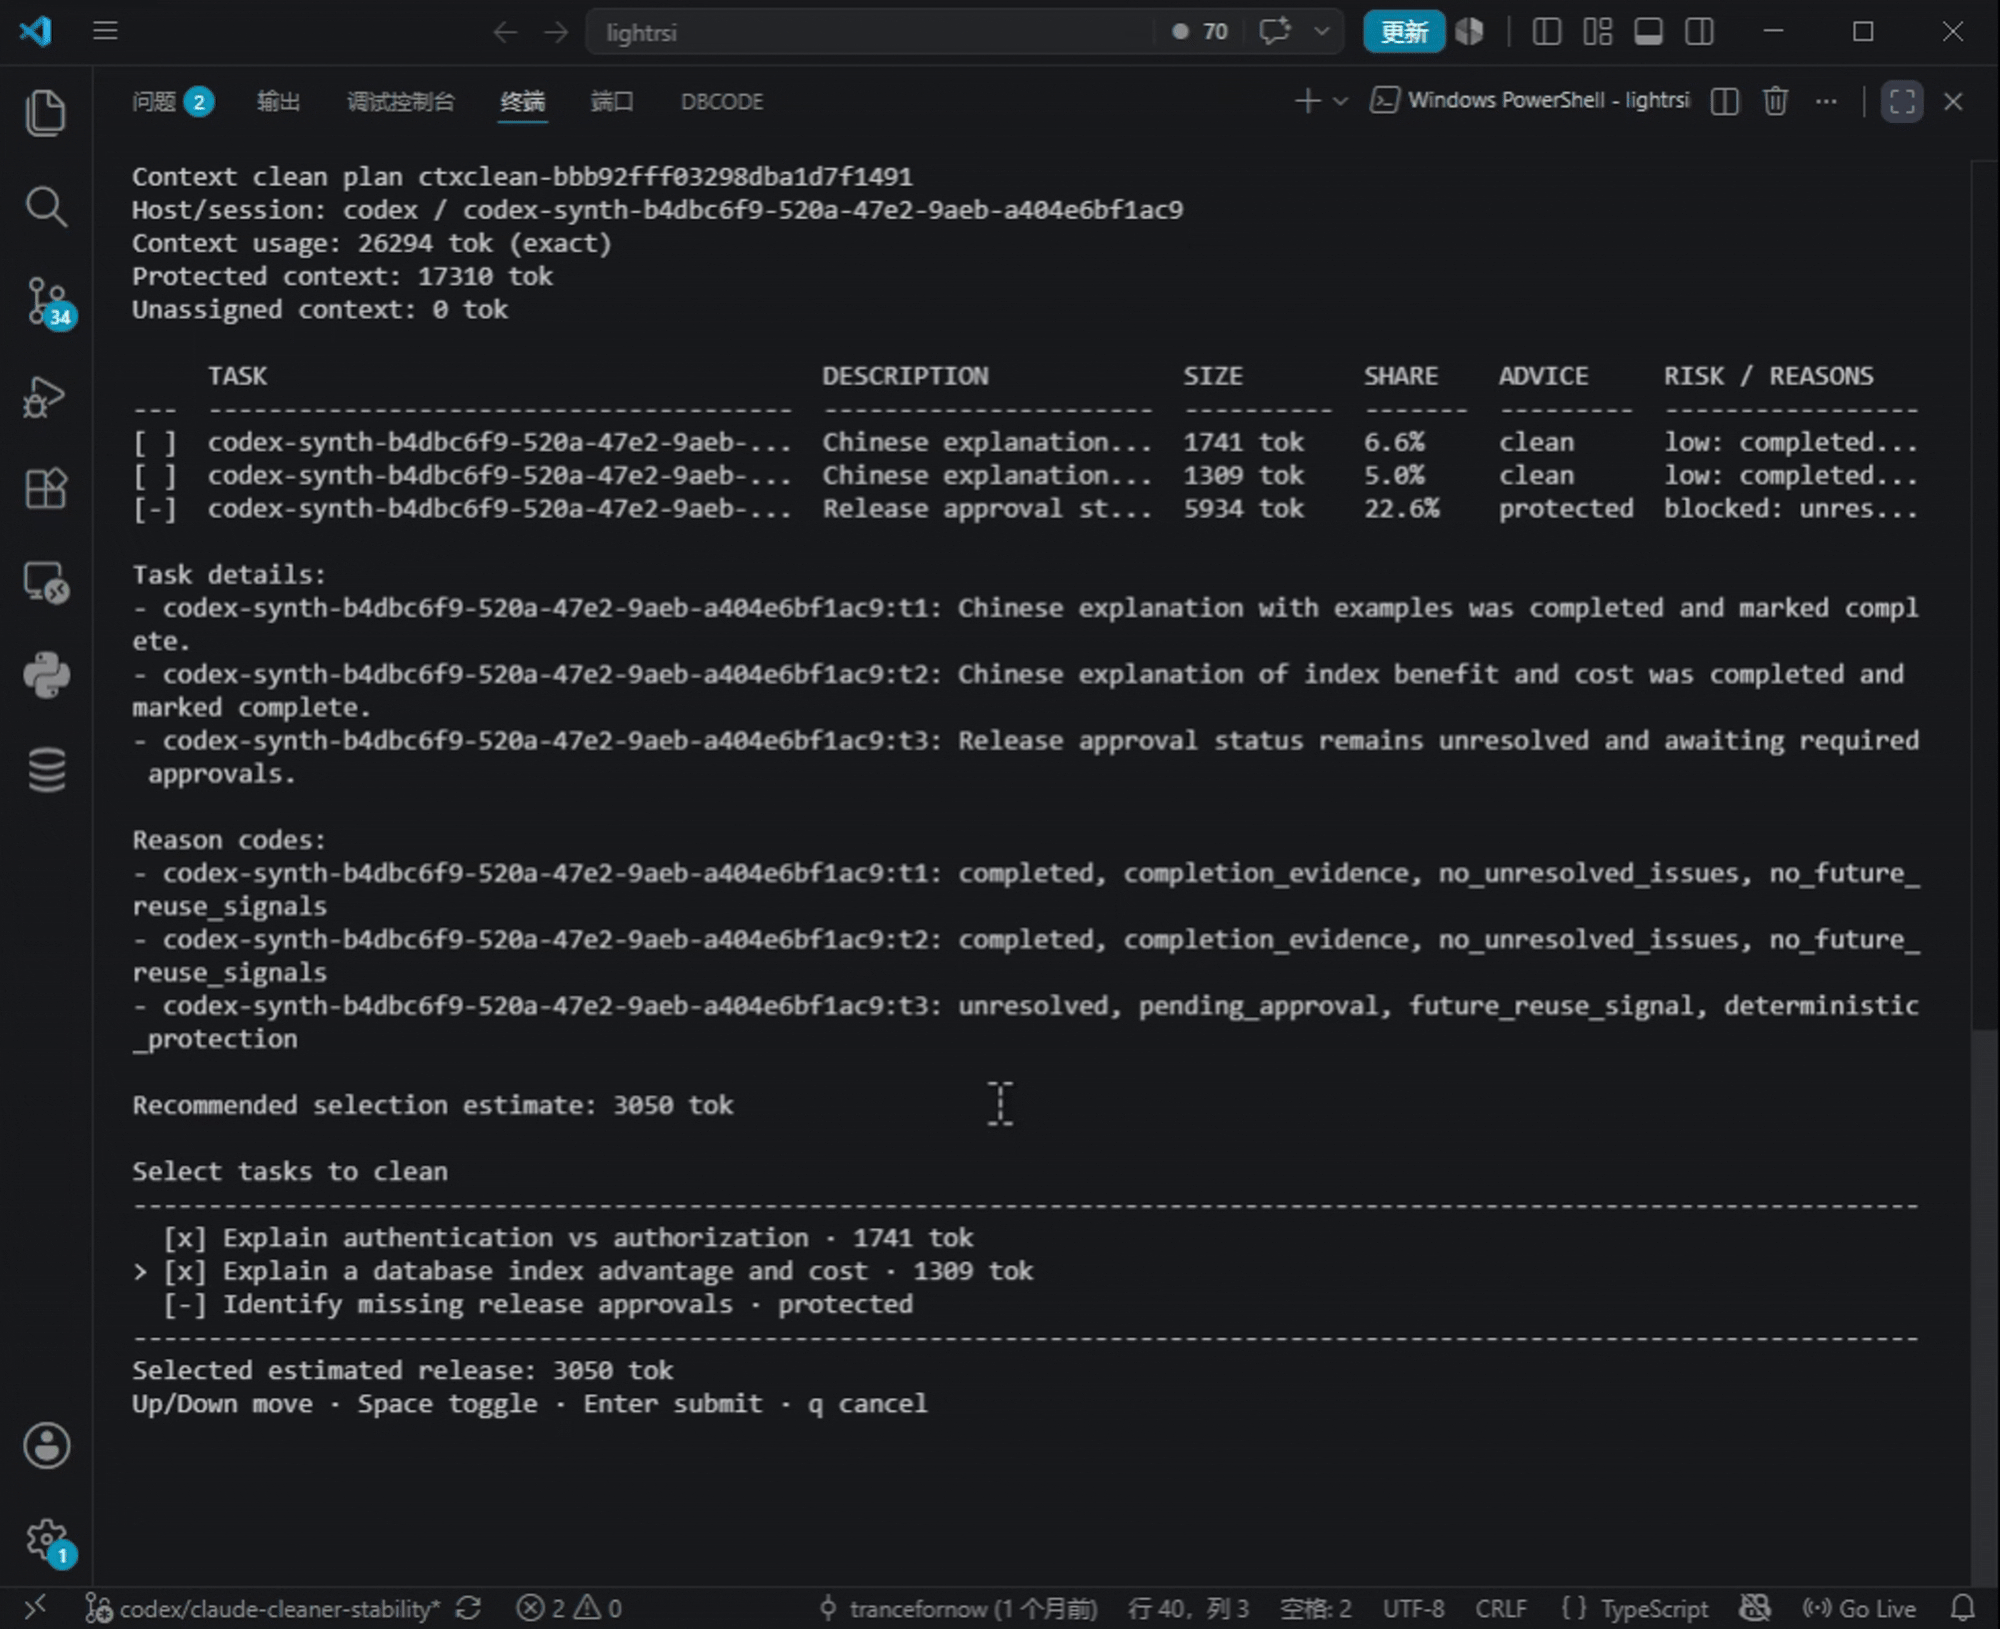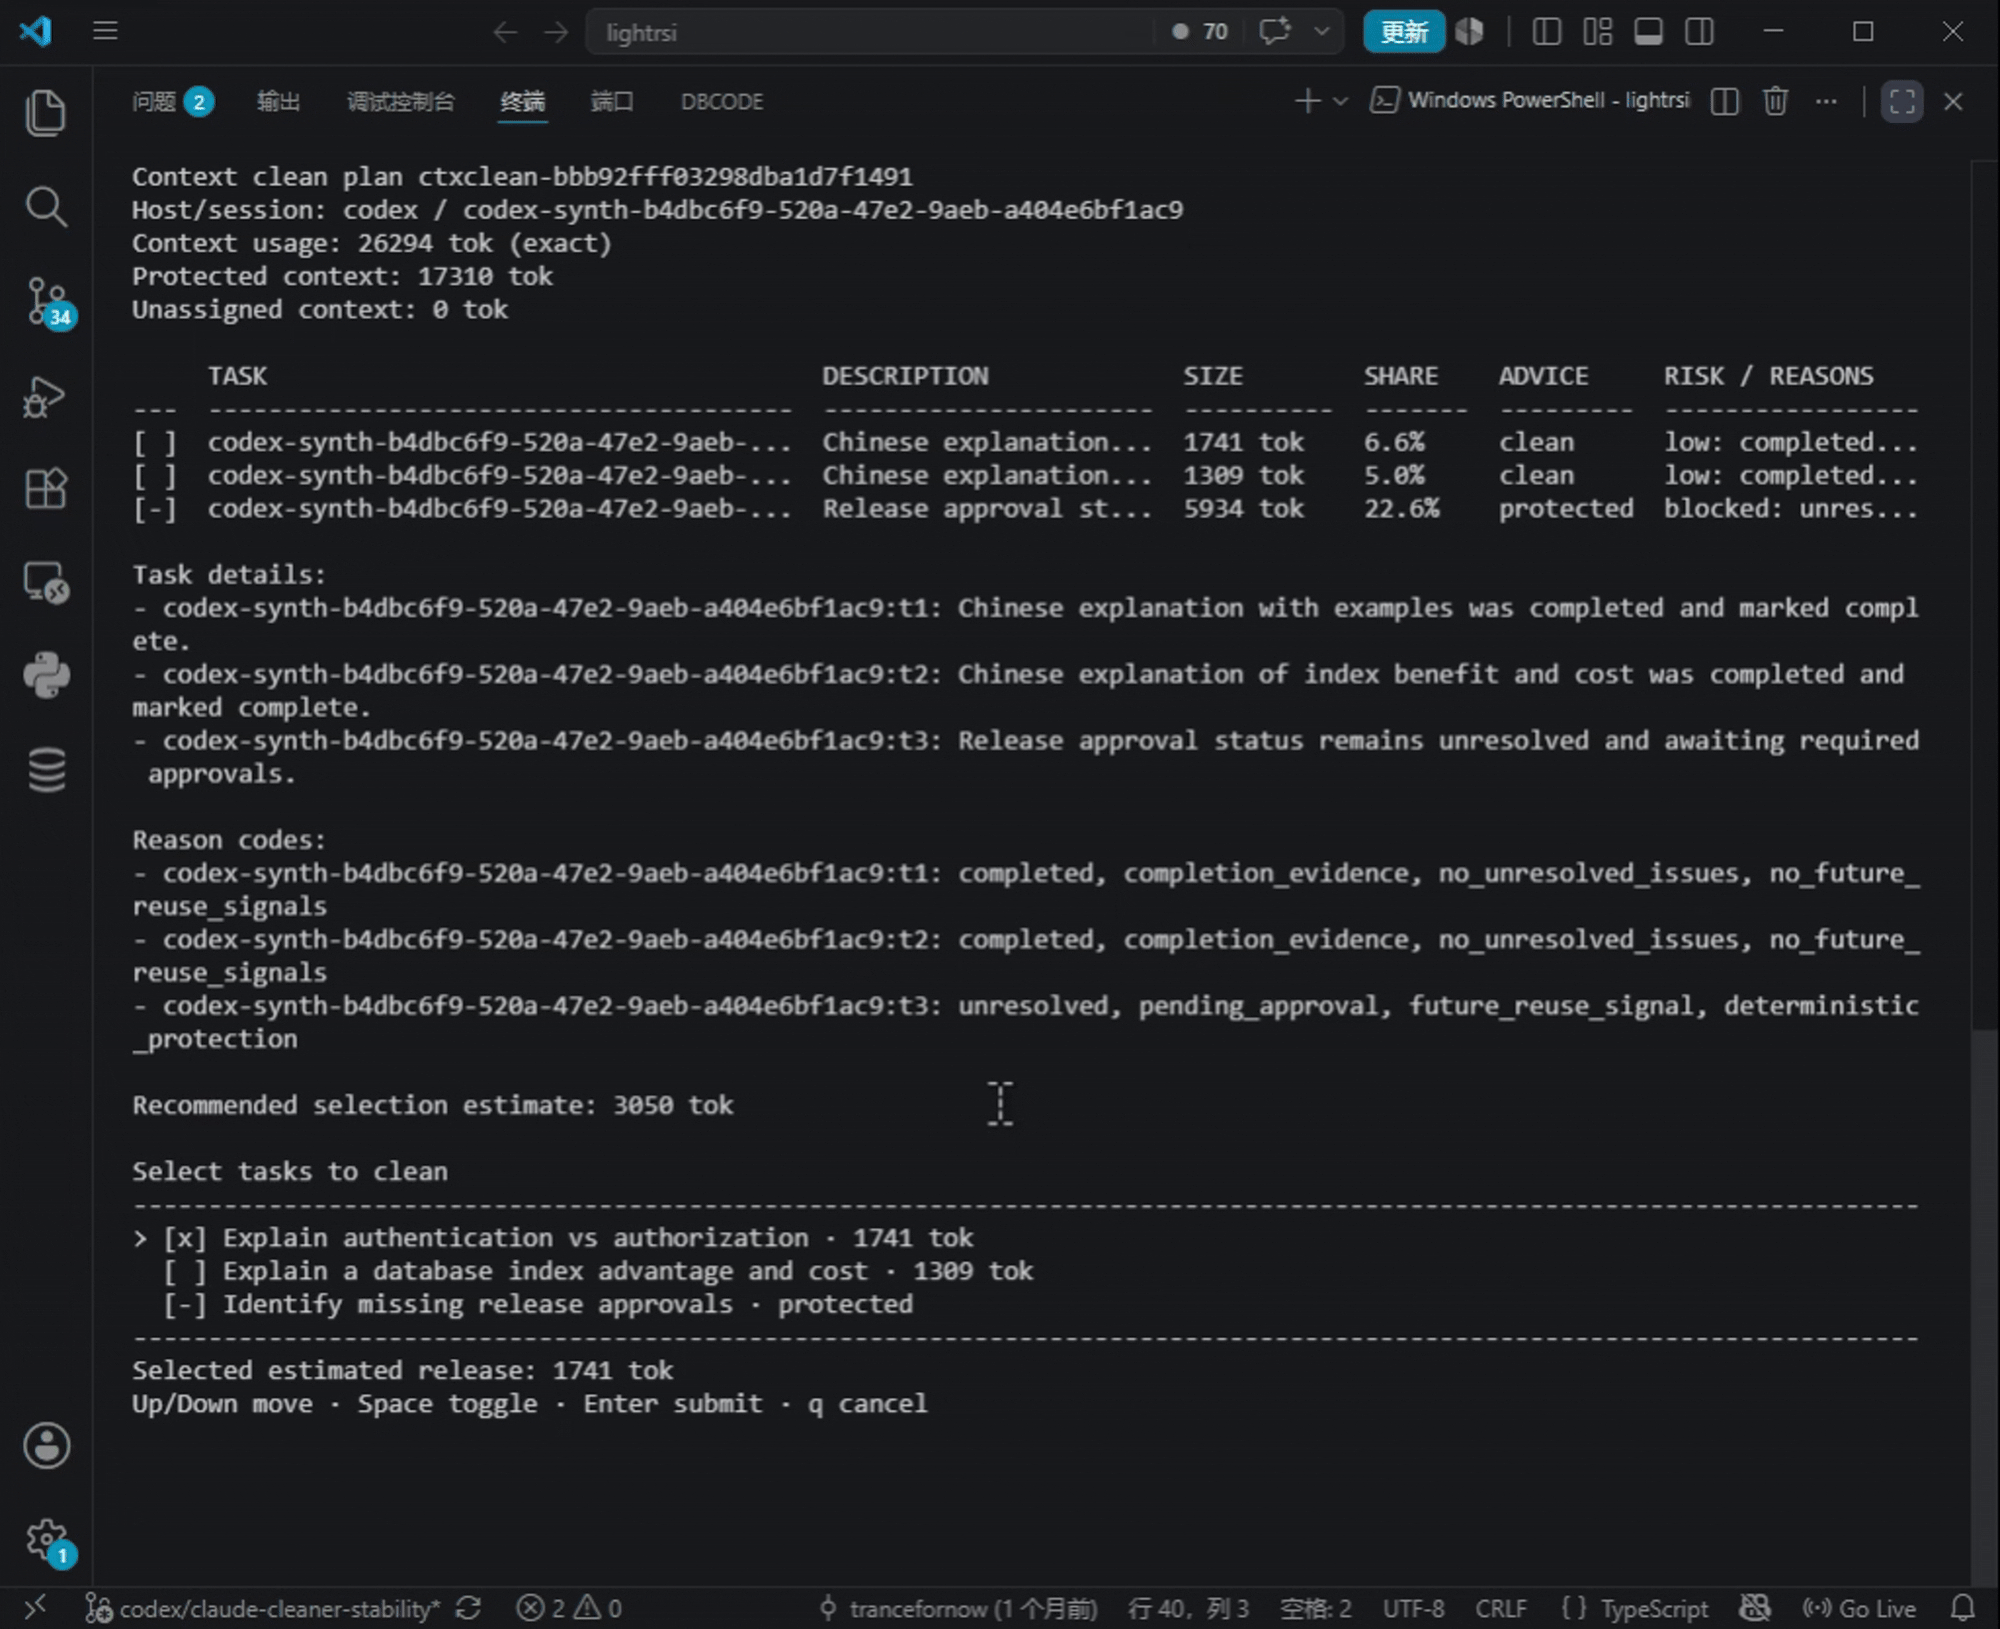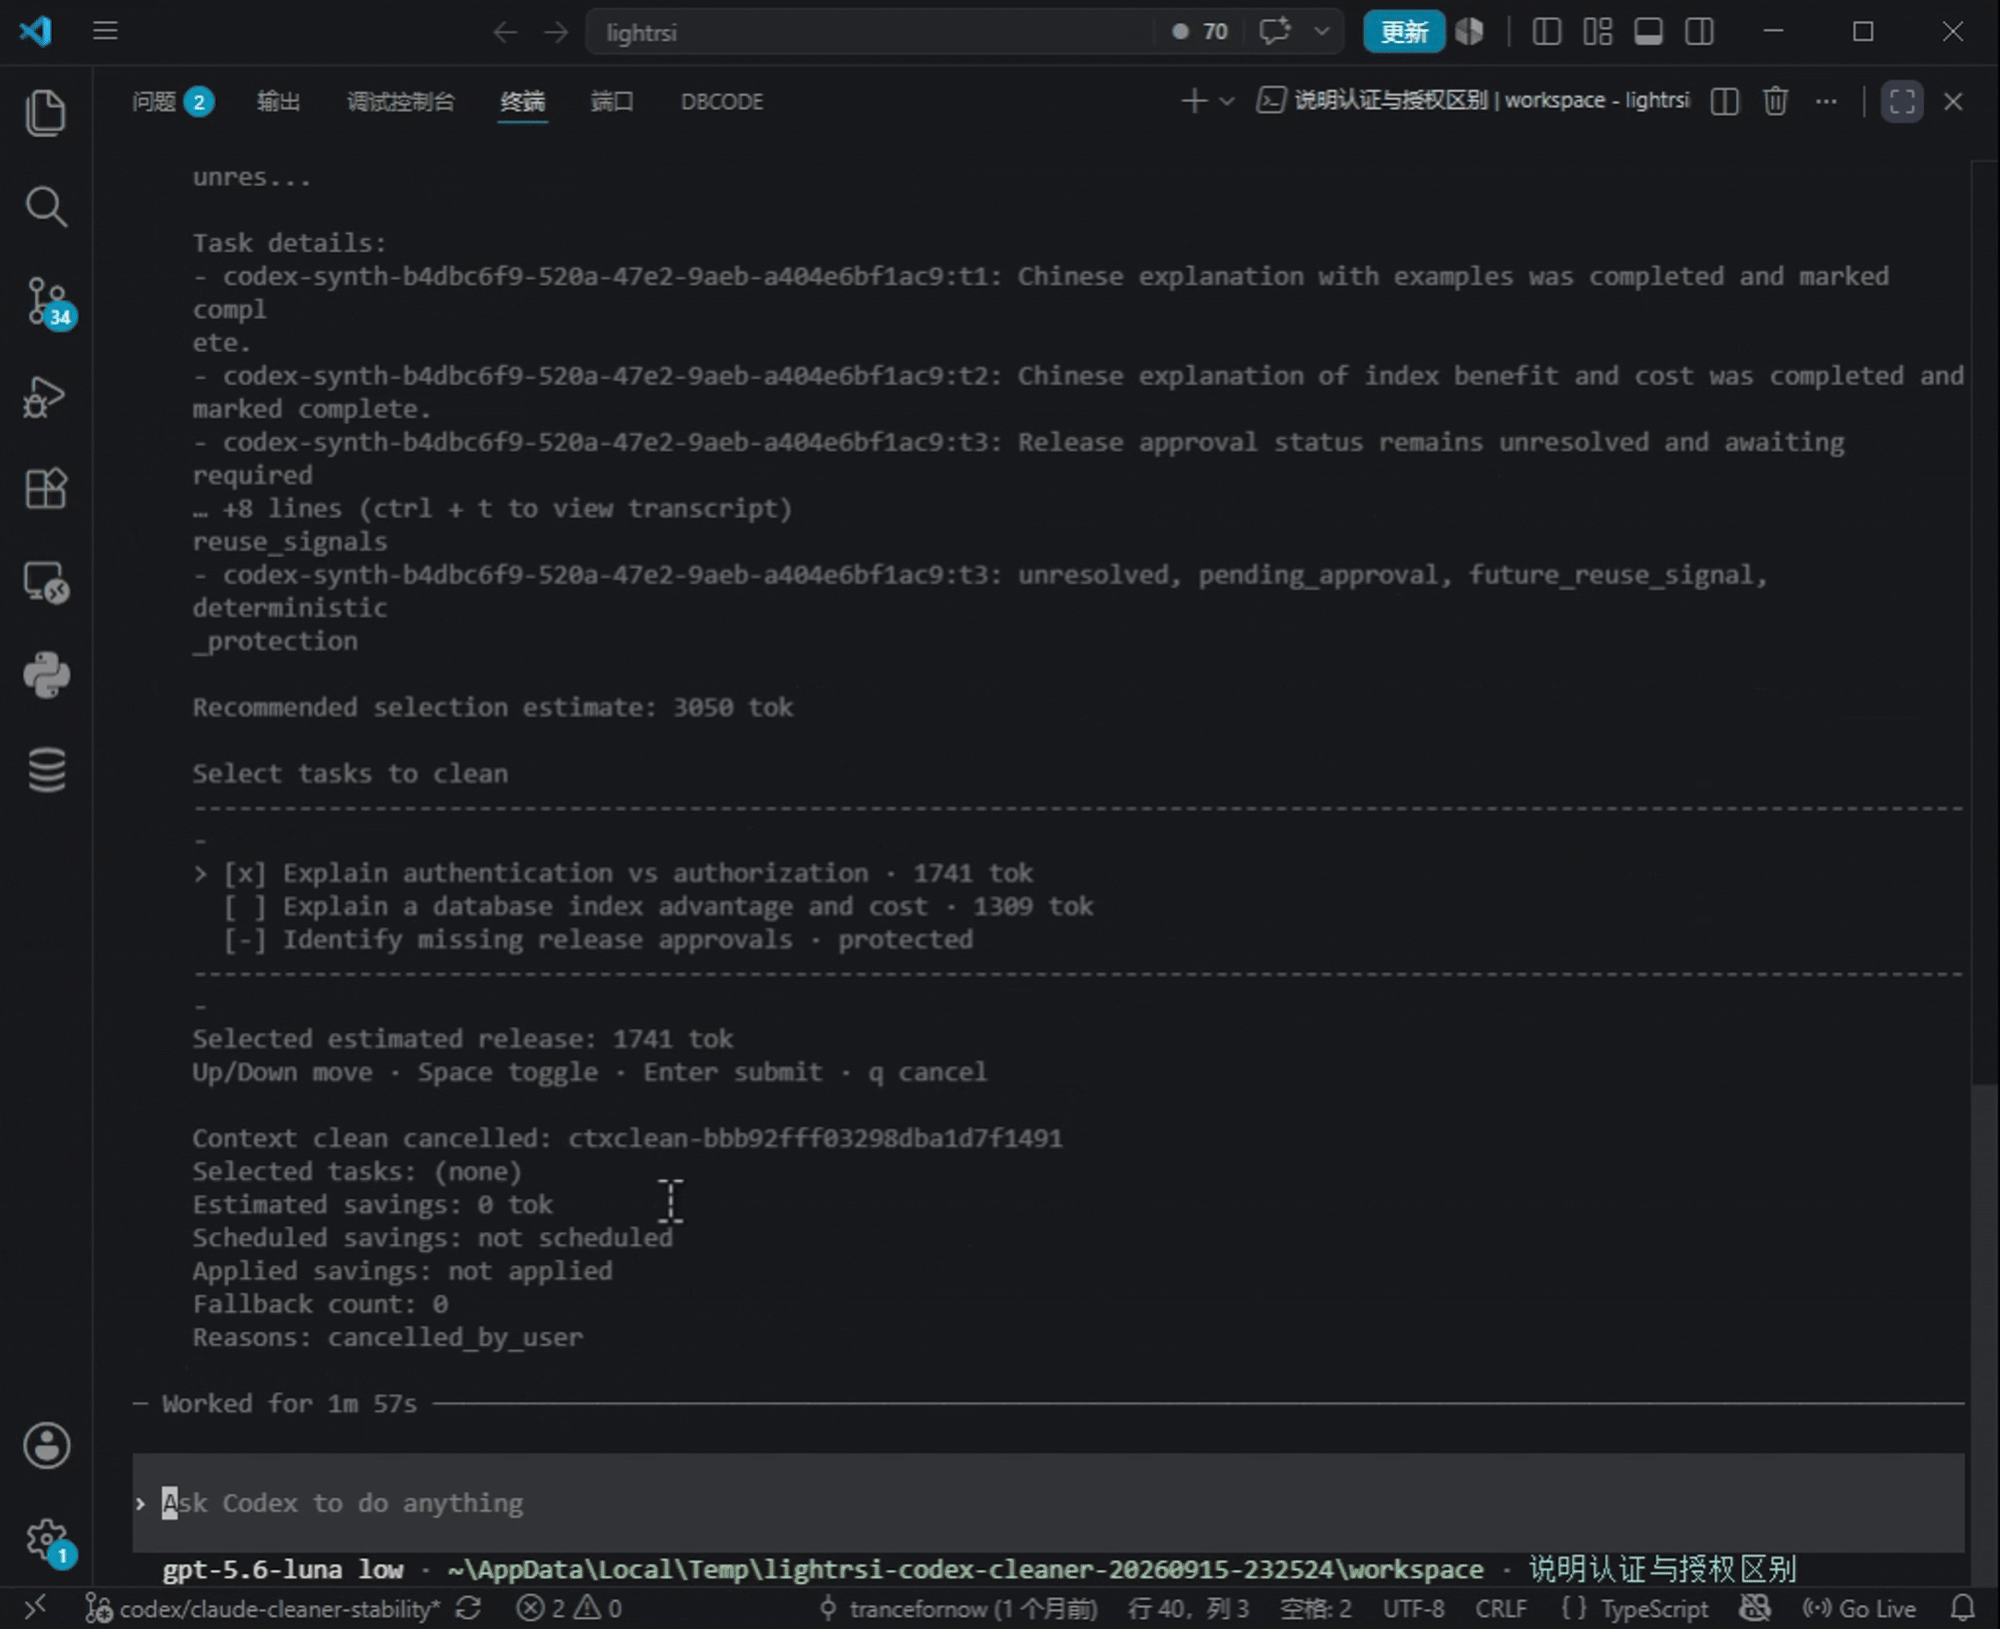
精选文章 让 Agent 长会话更省、更好管!浙大最新推出 LightRSI 探索低成本自进化 用 Agent 写代码,一个任务通常不止一次问答。它要读文件、调用工具、修改代码、跑测试,再根据结果继续行动。 在同一个会话里做得越久,积累的历史就越多。之前读过的文件、重复的测试日志、已经结束的任务,都可能继续跟在后面的请求里。当前只想改一个小功能,却要带上越来越多的旧信息。 这段时间,我们围绕这
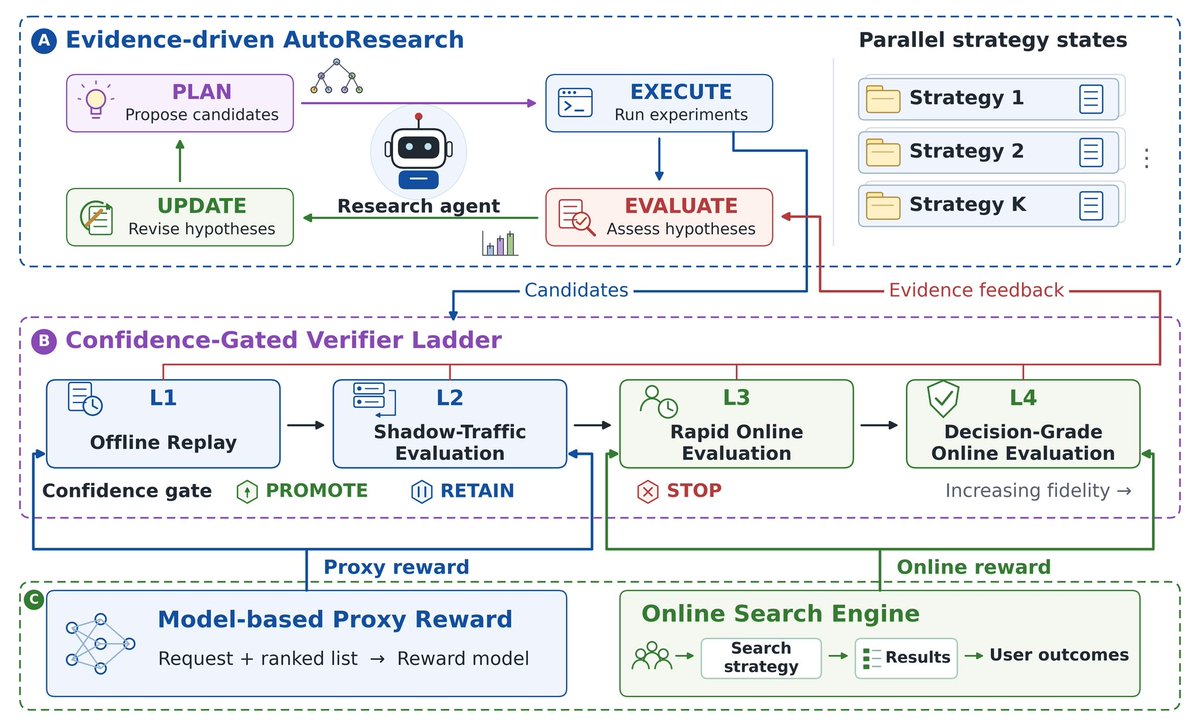
精选文章 字节最新提出 PEAR:面向工业级搜推在线系统的 RSI 框架 工业搜索长期围绕同一条技术主线演进:让结果「找得更全、排得更准、转化更高」。查询理解不断深入,召回覆盖持续扩大,排序目标日益精细,生成式搜索与大模型也在持续拓展系统的能力边界。 但随着系统日趋复杂,真正制约迭代效率的已不只是能否设计出更强的模型,而是:如何在持续变化的真实流量中,稳定地找到并验证可信
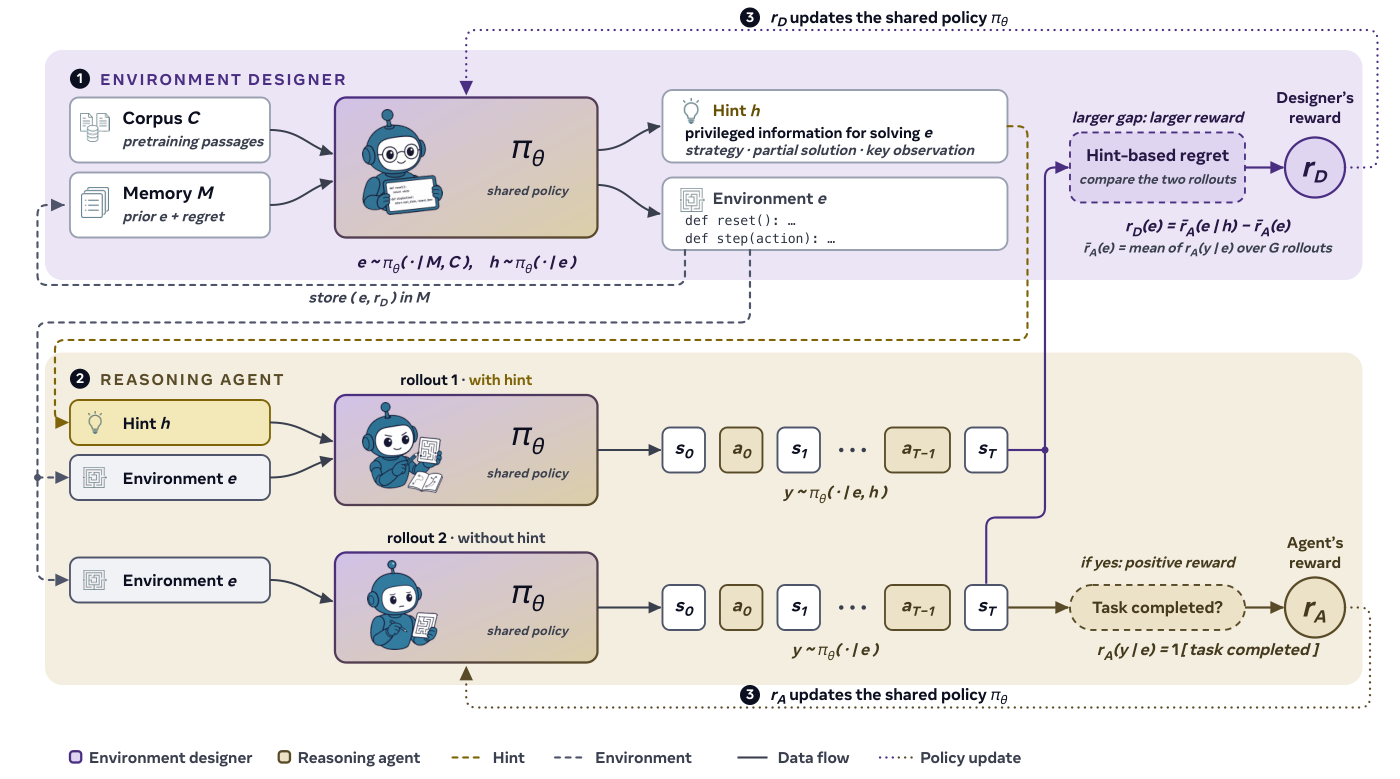
青稞Talk 直播预告!聊聊自我改进、递归自我改进(RSI),以及与自博弈的关系 大模型的强化学习后训练依赖人工整理的题目和固定的训练环境。模型变强之后,现有环境的难度和多样性跟不上,训练收益逐渐减少。 SPIRAL(ICLR 2026):与不断变强的自己对弈 论文:SPIRAL: Self-Play on Zero-Sum Games Incentivizes Reasonin
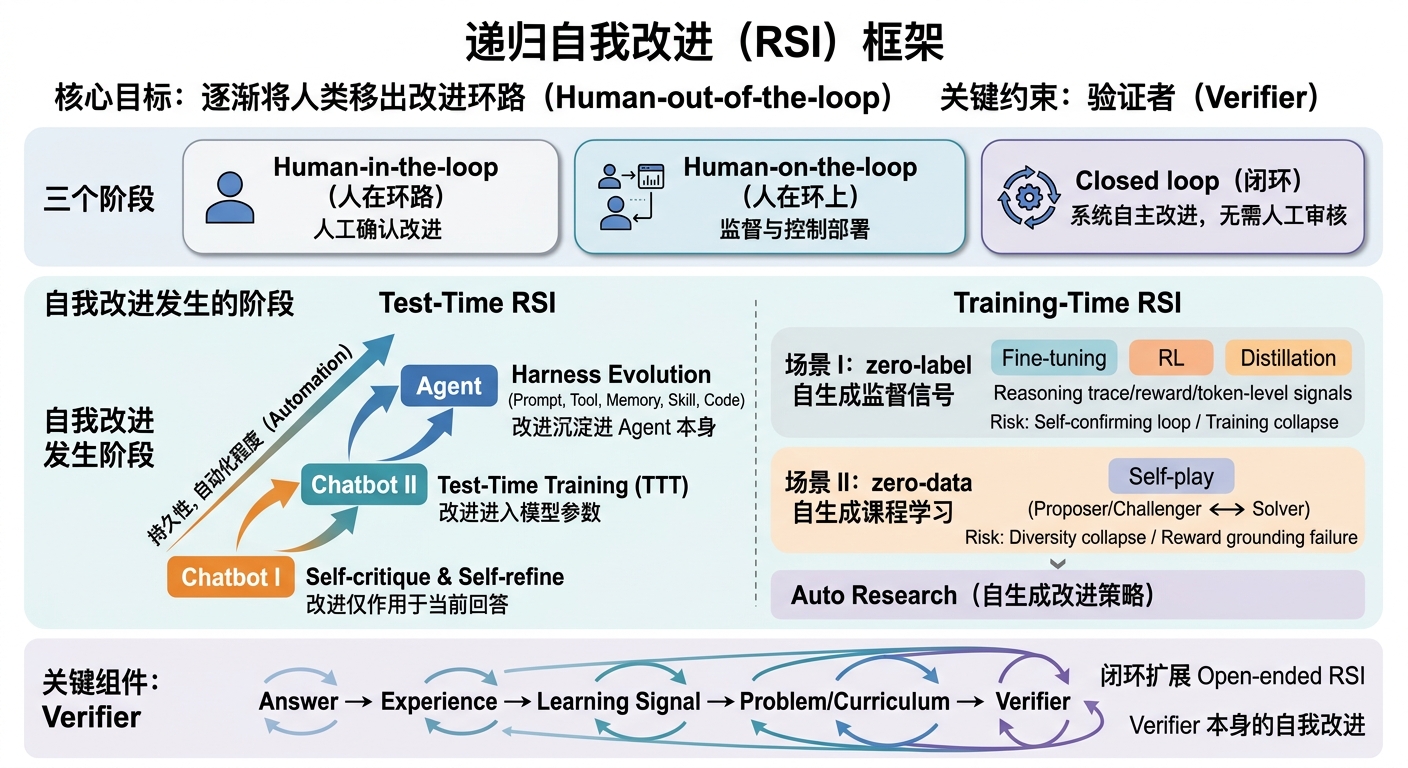
精选文章 万字长文带你读懂 RSI(自进化,Self-Evolving) 原文:https://prism-shadow.github.io/awesome-rsi/#blog/understanding-rsi RSI(Recursive Self-Improvement)这个概念最近热度很高。与之相近的表述还有自进化、Self-Evolving、Self-Improv
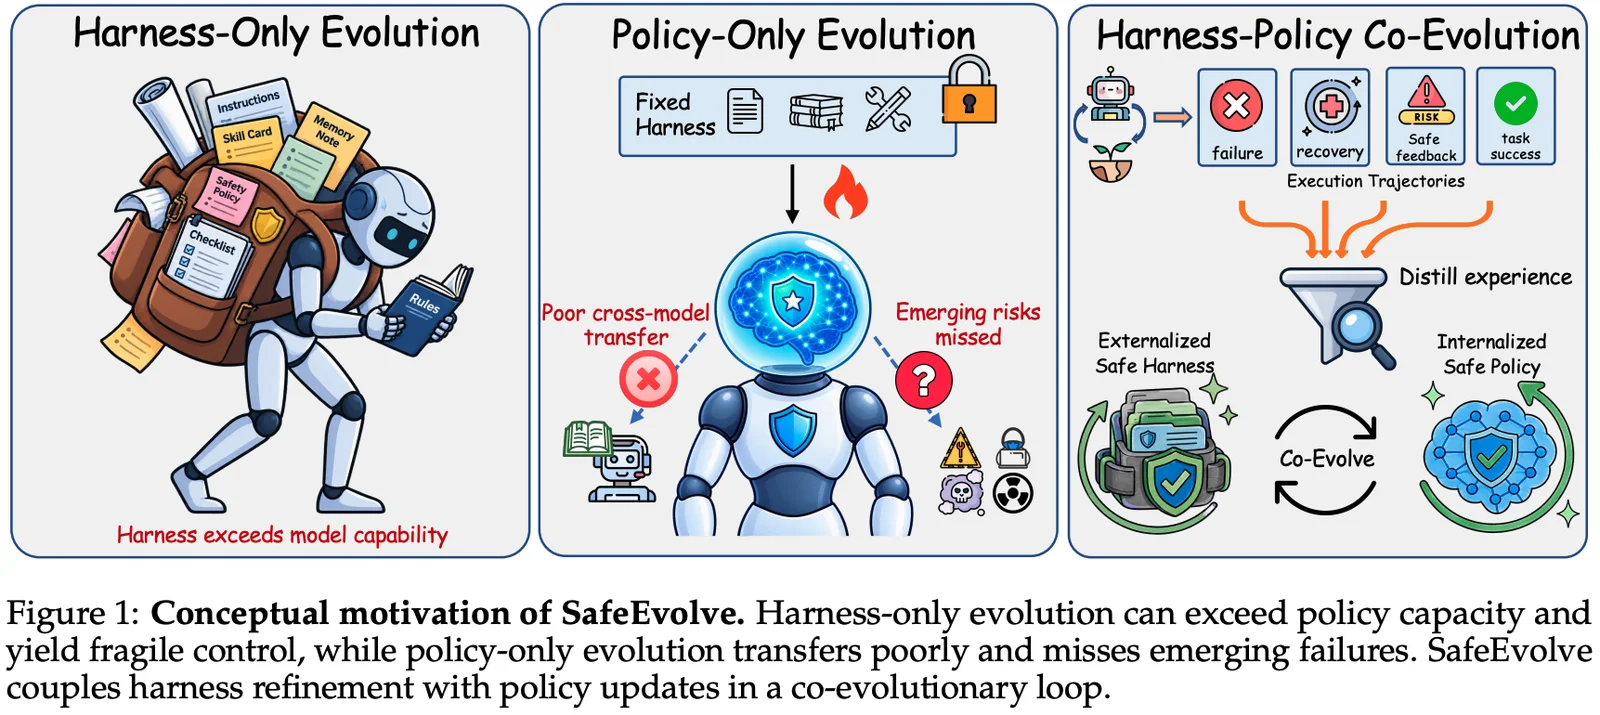
精选文章 Agent 安全也能自进化?SafeEvolve 让 Harness 与 Policy 从安全经验中共同进化 随着大模型Agent逐渐具备自主规划、工具调用、网页访问和多步任务执行能力,Agent安全正在面临新的挑战。 过去,安全对齐往往主要关注模型最终输出是否有害,例如是否拒绝危险请求、是否生成不当内容。但对于能够与外部环境持续交互的Agent而言,风险可能发生在最终回答之前,也可能隐藏在中间决策、工具调
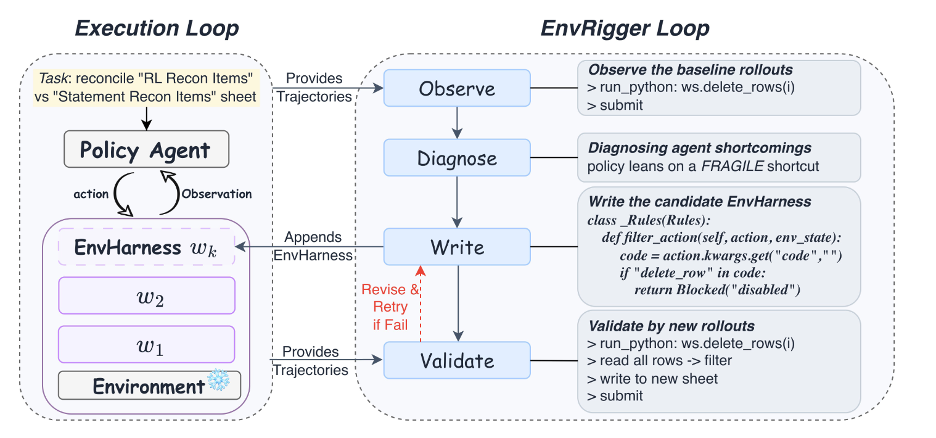
青稞Talk 直播预告!聊聊 EnvHarness,Agent 和环境如何“左脚踩右脚”实现自进化 当前 Agent 训练面临两难: 传统环境静态僵化,Agent 易过拟合; 完全合成环境又易产生逻辑幻觉。 而 Agent 本质上是一个不断与环境(Environment)进行交互的主体:感知反馈、做出决策、影响环境。在自进化 Agent 的主流范式中,往往高度依赖 Agent 在环境中的单向探索来
青稞Talk 直播预告!从 Harness 看 AI4AI 如何实现 我们能否在不更新任何模型参数的情况下,把强模型的能力迁移给弱模型? 我们通常认为,更强的 AI 能力需要通过蒸馏,OPD等各种方式训练更弱的模型,但在 Harness 的热潮下,一个更本质的问题值得探索:如果完全不改模型参数,强模型能不能在 test time 直接帮弱模型“搭好思考方式”? Har
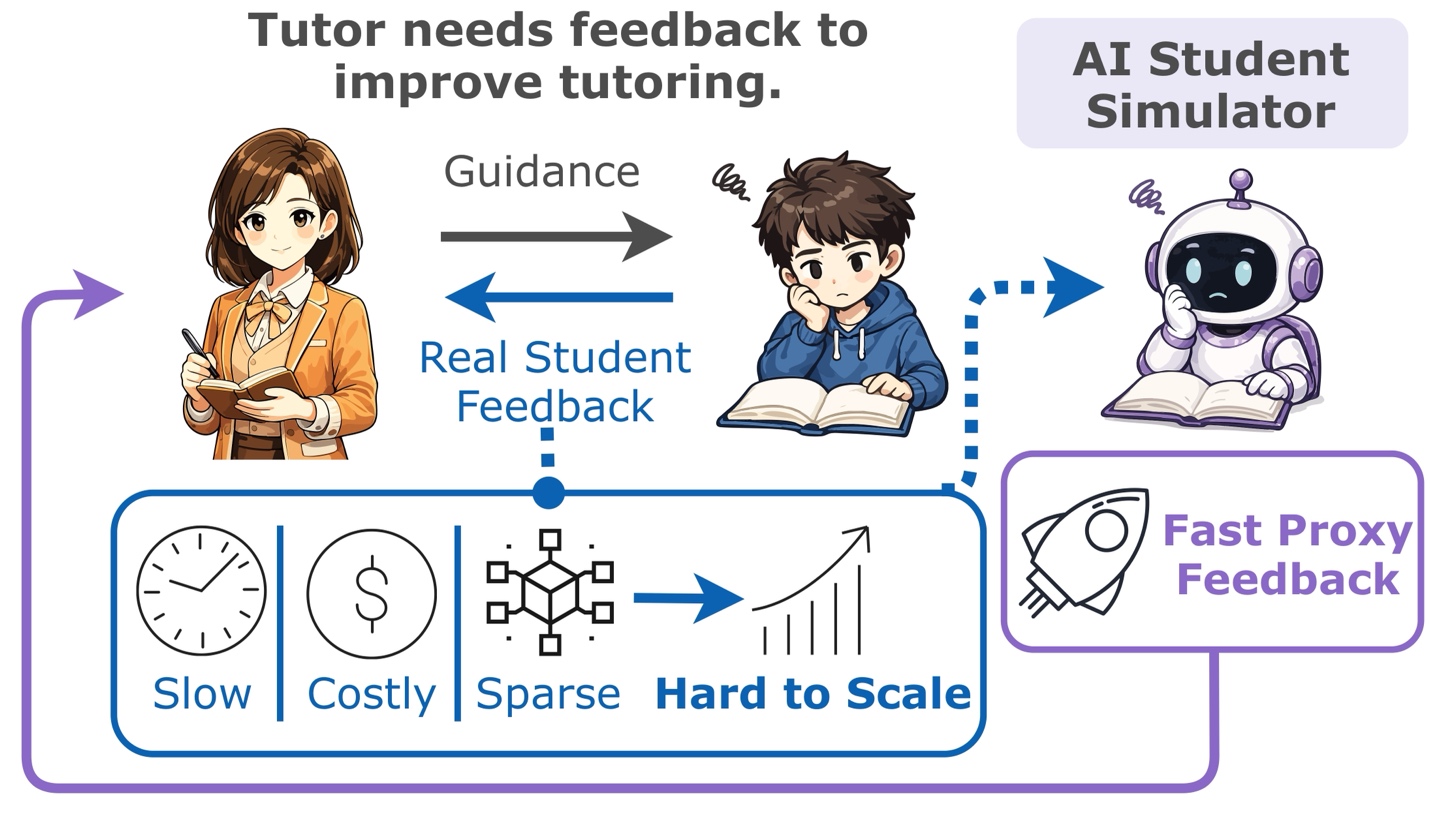
精选文章 微软最新提出面向 AI tutor 训练的学生模拟器 StudentSim:从真实学习记录构造 feedback model 论文标题:StudentSim: Training LLM-based Student Simulators 论文链接:https://arxiv.org/abs/2609.01591 Huggingface Paper 主页:https://huggingface.co/papers/2609.0
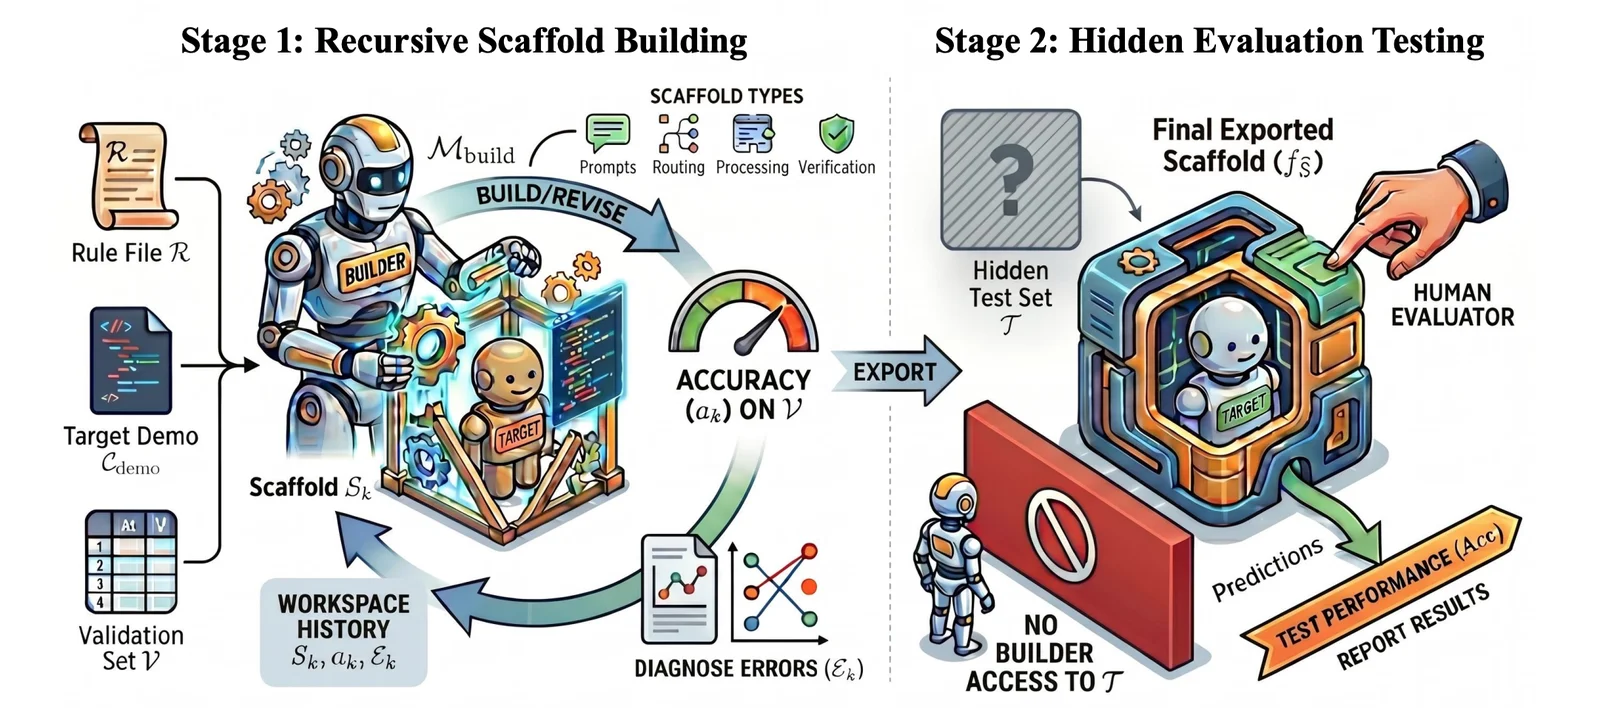
精选文章 当 Harness 也能被 AI 自动设计:AI4AI 正在重写小模型变强的方式 今年,AI 的竞争正在悄悄换一个方向:决定一个 AI 系统能力的,开始不只是模型本身,还有模型外面的那套“工作方式”。 过去,我们想让一个模型变强,通常意味着继续训练它:更多数据、更好的反馈、更大的计算量,本质上都是在改变模型内部的参数。但 Agent 时代正在让另一条路线变得越来越重要:模型可以完
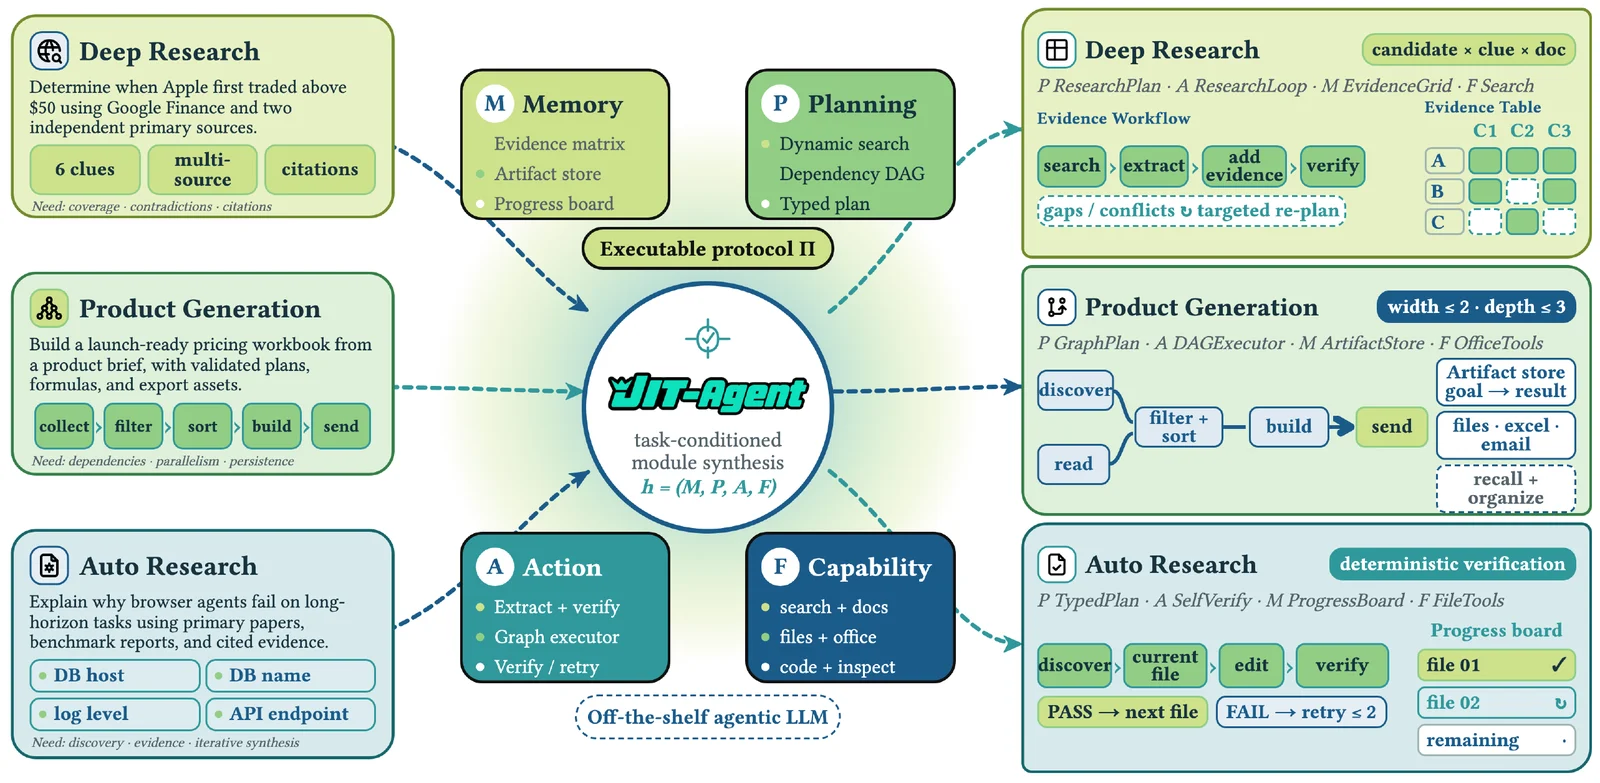
精选文章 Harness基模JIT-27B,为每个任务写一套“Claude Code” Harness基模JIT-27B,为每个任务写一套“Claude Code” Agent benchmark 通常把模型视为能力的主要来源,但同一模型只要更换记忆组织、规划协议、工具暴露方式或错误恢复流程,最终表现就可能跨越一个明显的档位。 这样的差异来自 Agent Harness:它定义模型在什
精选文章 关于 RSI 的一些思考:Test-Time 沉淀与 Training-Time 演化的架构终局 近期最火的一个词,当属 RSI,全名为 Recursive Self-Improvement。简单来说,就是让 LLM / Agent 不仅完成任务,还能利用自己产生的经验、数据、反馈甚至代码,迭代地改进自己。 实际上类似的术语非常多:self-evolve、self-play、self-refin
青稞Talk 直播预告!模型的“什么经验值得被看见”?一起聊聊 LOPD:不再手动设计 OPSD 特权信息 学术社区是否已经对层出不穷的 On-Policy Self-Distillation (OPSD) 特权信息变体感到审美疲劳? 当 answer、trajectory、reflection、skill 被不断设计得更精巧,LOPD 反过来追问一个更根本的问题:我们为何仍要替模型规定“什么经验值得被看
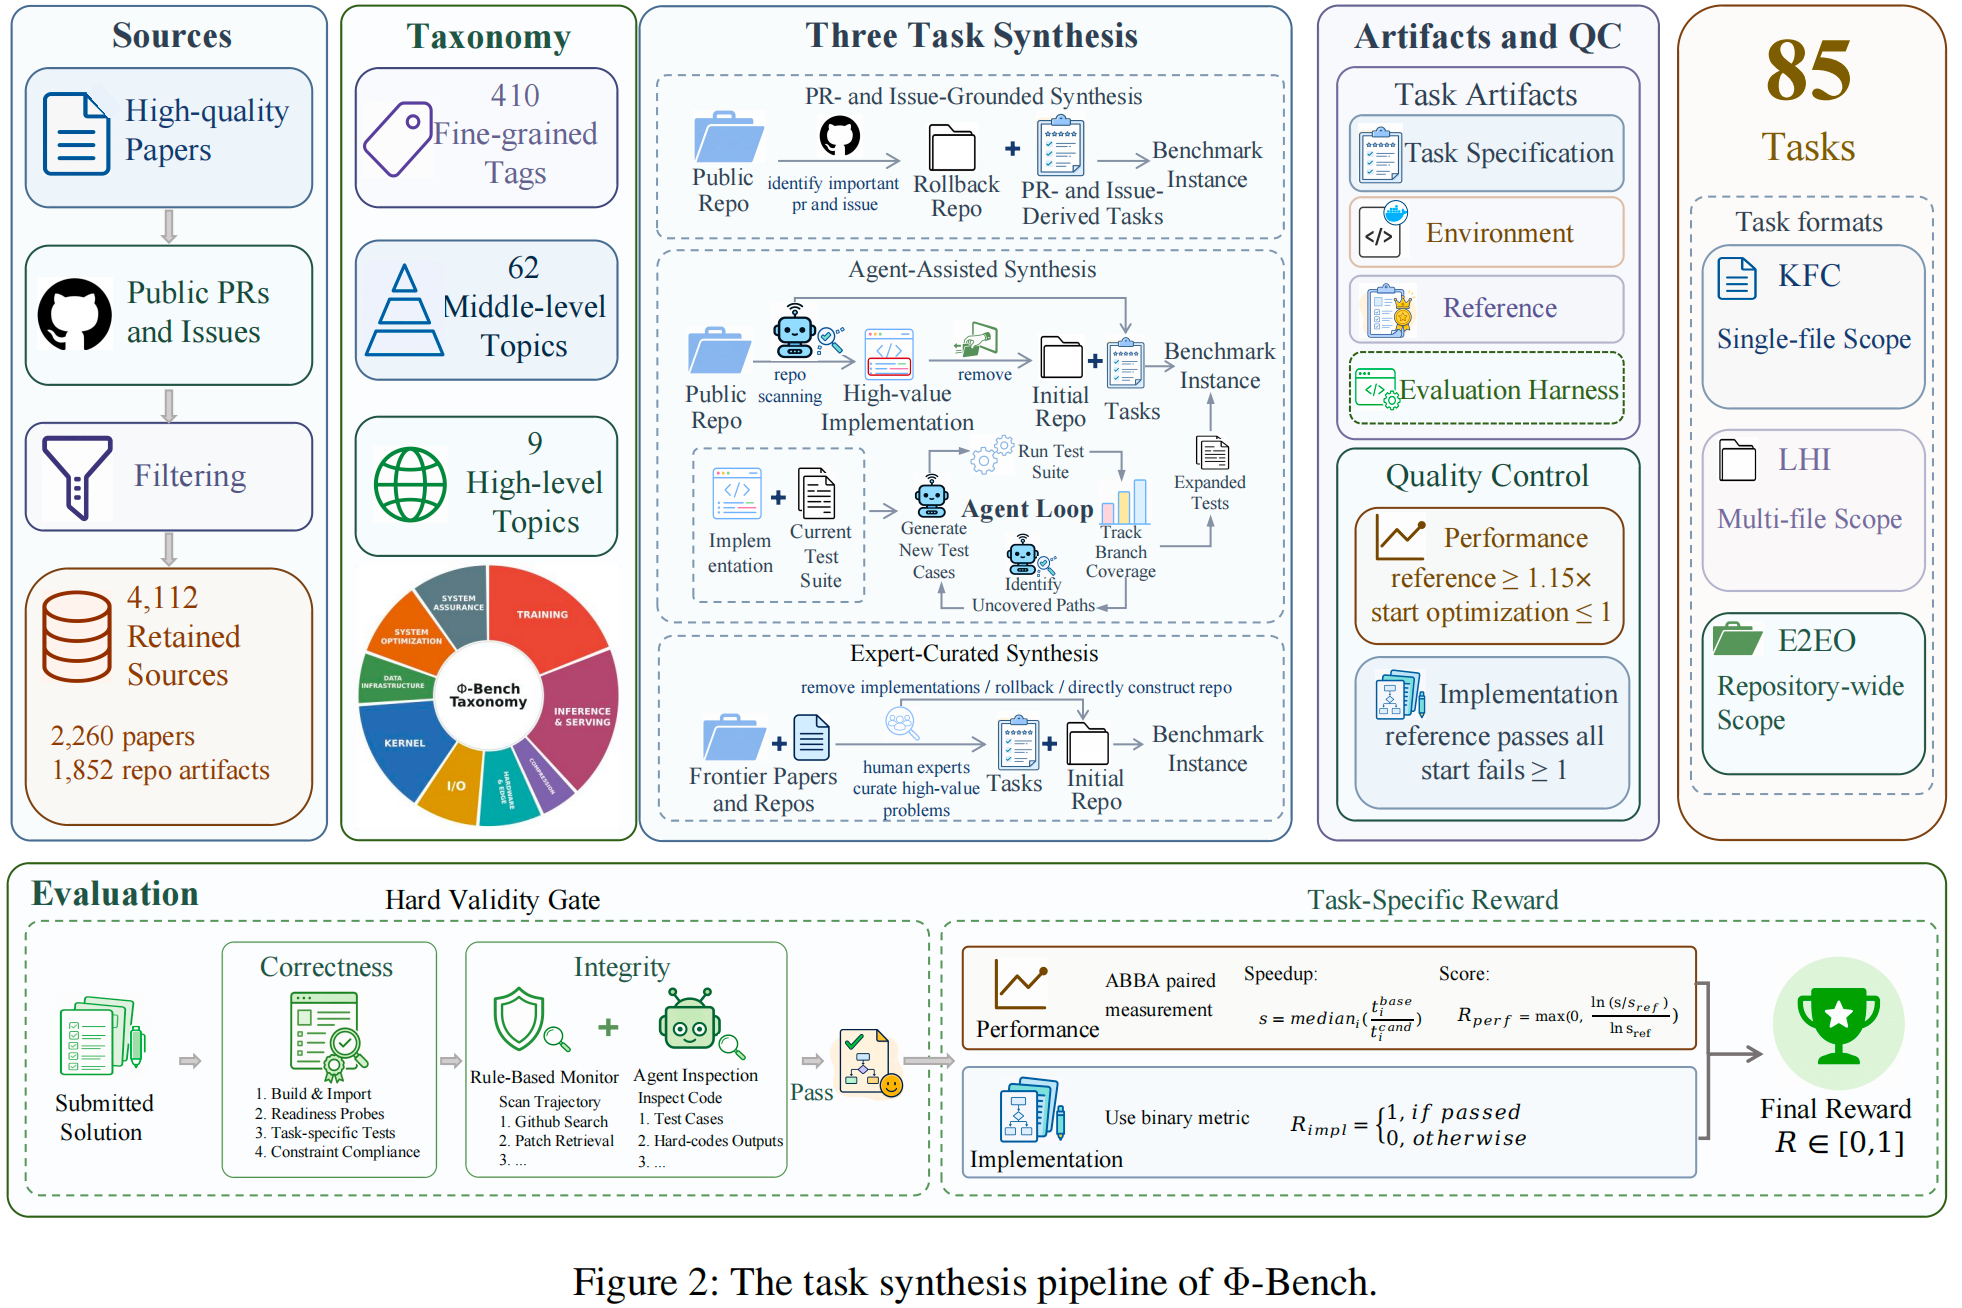
精选文章 Infra 也能自进化?Φ-Bench 深度评测:大模型距离“AI 工程师”还有多远? 过去几年,大语言模型(LLM)的能力快速提升。从写代码、完成复杂推理,到辅助科研和软件开发,模型正在逐渐成为越来越强大的工程助手。 但一个更深层的问题正在出现:如果模型能够帮助人类构建软件,大模型是否也能够反过来优化支撑自身运行的基础设施? 换句话说:Can Large Language Model
精选文章 自进化也能“左脚踩右脚”?Google提出 EnvHarness:环境自进化,倒逼 Agent 疯狂进化! Agent绝大部分时候都运行在环境当中,那么在agent进化的过程中,有没有办法让环境也进化呢。 论文:EnvHarness: Awakening Static Worlds for Agent Learning 链接:https://arxiv.org/abs/2608.19880 主页:http
青稞Talk AI for AI 的前世今生: 从进化、自进化与元进化,迈向递归自我改进(RSI) 导语:当代码智能体(Code Agents)与测试床工程(Harness Engineering)飞速发展,AI 不再仅仅是被动接受指令的工具。AI for AI (AI4AI) 正在经历一场深刻的范式演变,其核心目标已明确指向人工智能领域的终极愿景之一——递归自我改进(Recursive Self
精选文章 Kimi K3、Qwen3.8-Max 官方评测都在用!伯克利硬核测试揭穿 AI 自进化假象 TL;DR Auto-Research 系统正在快速发展,但当前多数成功案例建立在一个重要前提上:候选方案可以被廉价、快速、明确地验证。只要评分足够便宜,扩大采样与搜索就能持续提高找到好答案的概率。 真实机器学习研究并不总具备这个条件。完整训练昂贵,反馈存在延迟,单次实验只能提供部分证据。系统不仅要