
大模型的强化学习后训练依赖人工整理的题目和固定的训练环境。模型变强之后,现有环境的难度和多样性跟不上,训练收益逐渐减少。
SPIRAL(ICLR 2026):与不断变强的自己对弈

论文:SPIRAL: Self-Play on Zero-Sum Games Incentivizes Reasoning via Multi-Agent Multi-Turn Reinforcement Learning
链接:https://arxiv.org/abs/2506.24119
SPIRAL 让模型在多轮零和博弈中,与持续变强的自己对抗——不需要任何人工标注,就能自动生成难度递增的“无限课程”。为了支撑这种在线、多轮、多智能体的训练,团队提出了 RAE(role-conditioned advantage estimation)来稳定训练过程。
效果如何?只用 Kuhn Poker 一个游戏训练 Qwen3-4B-Base,数学提升 8.6%、通用推理提升 8.4%,超过用 25,000 条专家游戏轨迹做 SFT。论文进一步分析,这种迁移来自三种认知模式:系统分解、期望值计算、逐例分析。
SPICE(Meta FAIR):让真实语料成为无穷题库

论文:SPICE: Self-Play In Corpus Environments Improves Reasoning
链接:https://arxiv.org/abs/2510.24684
SPICE 让同一个模型分饰两角:Challenger 从大规模语料中挖掘文档、生成多样化的推理题,Reasoner 负责解题。与无 grounding 的自博弈不同,真实语料提供了近乎无穷的外部信号,使生成的任务始终停在模型的能力前沿,收益也更持久。
在多个模型家族上,SPICE 让数学提升 8.9%、通用推理提升 9.8%。
SPADE:把环境本身也交给自博弈

论文:SPADE: Self-Play in Adaptive Synthetic Executable Environments
链接:https://arxiv.org/abs/2608.19197
SPADE 更进一步:同一个模型分别担任环境设计者和求解者,设计者以可执行代码的形式编写带 reset/step 接口的训练环境,求解者在其中训练。
设计者的奖励取自求解者在有提示和无提示两种情况下的表现差距,这一信号使生成的环境难度贴近求解者当前的能力边界,同时避免生成无法完成的任务。
实验中,30B 规模的模型在八个数学、科学、代码和推理评测集上平均比最强的固定环境基线高 5.3 分,在工具调用评测 BFCL v4 多轮和 ACEBench-Agent 上分别提高 5.7 分和 13.9 分。
从对手(SPIRAL)到题库(SPICE)再到环境(SPADE),被自博弈接管的范围越来越大。但这是否意味着模型已经在“递归自我改进”?自我改进与递归自我改进的边界又在哪里?
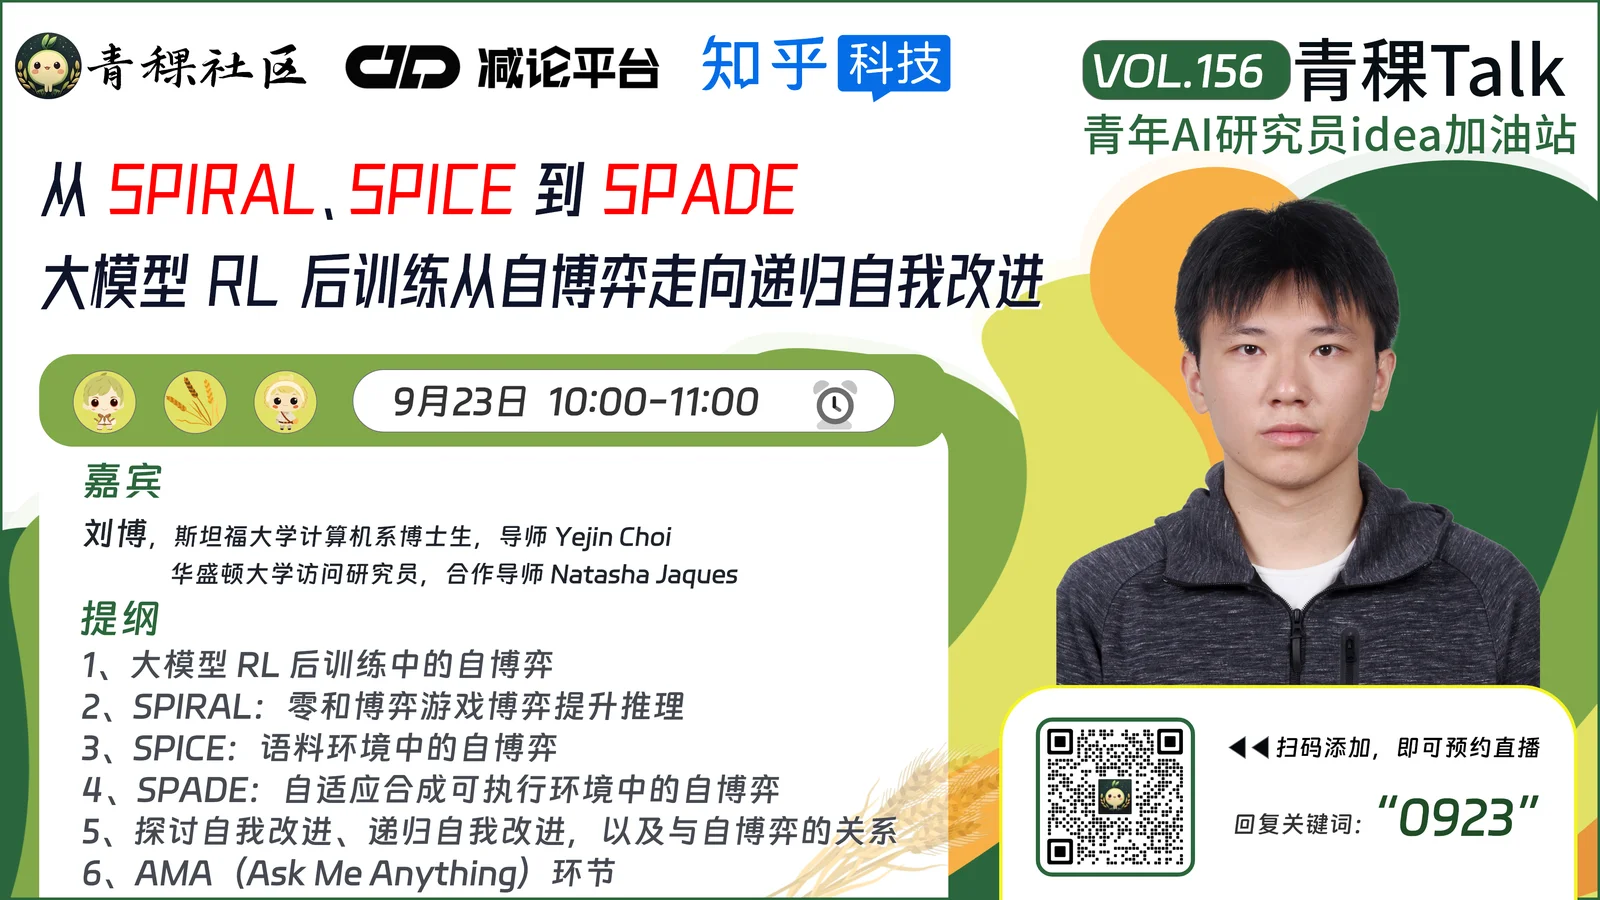
9月23日(周三)上午10:00,青稞Talk 第156期,青稞社区邀请到斯坦福大学博士生刘博,分享 SPIRAL、SPICE 和 SPADE 这三篇成果,同时也将探讨:自我改进在何种条件下才称得上是递归自我改进、自博弈与递归自我改进又有什么样的关系?
青稞介绍
刘博,斯坦福大学计算机系博士生,导师 Yejin Choi;华盛顿大学访问研究员,合作导师 Natasha Jaques。研究方向为强化学习、推理与机器学习系统,研究重点目前是大语言模型的自博弈与自我改进。此前在 Meta FAIR 任研究科学家实习生,与 Jason Weston 合作研究大模型的可扩展自博弈自我改进;曾在 DeepSeek 参与 DeepSeek-LLM、DeepSeek-V2、DeepSeek-VL、DeepSeek-Prover、DeepSeek-Prover-V1.5 等基础模型工作。本科毕业于北京大学,获智能科学与技术理学学士和经济学学士学位。
代表工作:SPIRAL(ICLR 2026)、SPICE(Meta FAIR)、SPADE。另参与 Agent Learning via Early Experience(ICML 2026)、DreamGym(ICLR 2026)、Vision-Zero(ICLR 2026)、Natural Language Reinforcement Learning 等。个人主页:https://benjamin-eecs.github.io/
主题提纲
从 SPIRAL、SPICE 到 SPADE:大模型 RL 后训练从自博弈走向递归自我改进
1、大模型 RL 后训练中的自博弈
2、SPIRAL:零和博弈游戏博弈提升推理
3、SPICE:语料环境中的自博弈
4、SPADE:自适应合成可执行环境中的自博弈
5、探讨自我改进,什么是递归自我改进,以及与自博弈的关系
6、AMA(Ask Me Anything)环节
直播时间
9月23日(周三)10:00 - 11:00