核心技巧: 通过离散一致性蒸馏做 warmup、确定初步结构、逐步引入连续一致性蒸馏和分布蒸馏;音视频采用不同 shift、量化策略。
引言
文生视频正在从只有画面走向音视频联合生成。电影片段、游戏 CG 和短视频里的声音需要跟随画面中的动作发生,不仅需要语义对齐,节奏和时间也要同步。文本到视频音频联合生成(Text-to-Video-Audio Generation,T2VA)因此开始直接在同一个生成过程中建模画面与声音。
LTX-2 是这一方向中具有代表性的开源模型。它使用联合 Transformer 处理视频与音频,让两个模态在生成过程中持续交换信息。模型总参数量为 19B,其中视频部分约 14B,音频部分约 5B。
联合建模带来了更直接的音画交互,也显著增加了推理开销:教师模型需要完成 40 步扩散或流采样,在 512×768 分辨率下生成 121 帧音视频平均耗时 50.52 秒;分辨率提高到 1024×1792 后,生成器耗时达到 318.74 秒。
这类大模型的成本来自两个地方。长采样轨迹要求模型反复执行前向计算,高分辨率音视频 token 又让每一次前向都很重。只减少采样步数,单步计算仍然昂贵;只优化算子,40 步采样带来的重复计算依然存在。
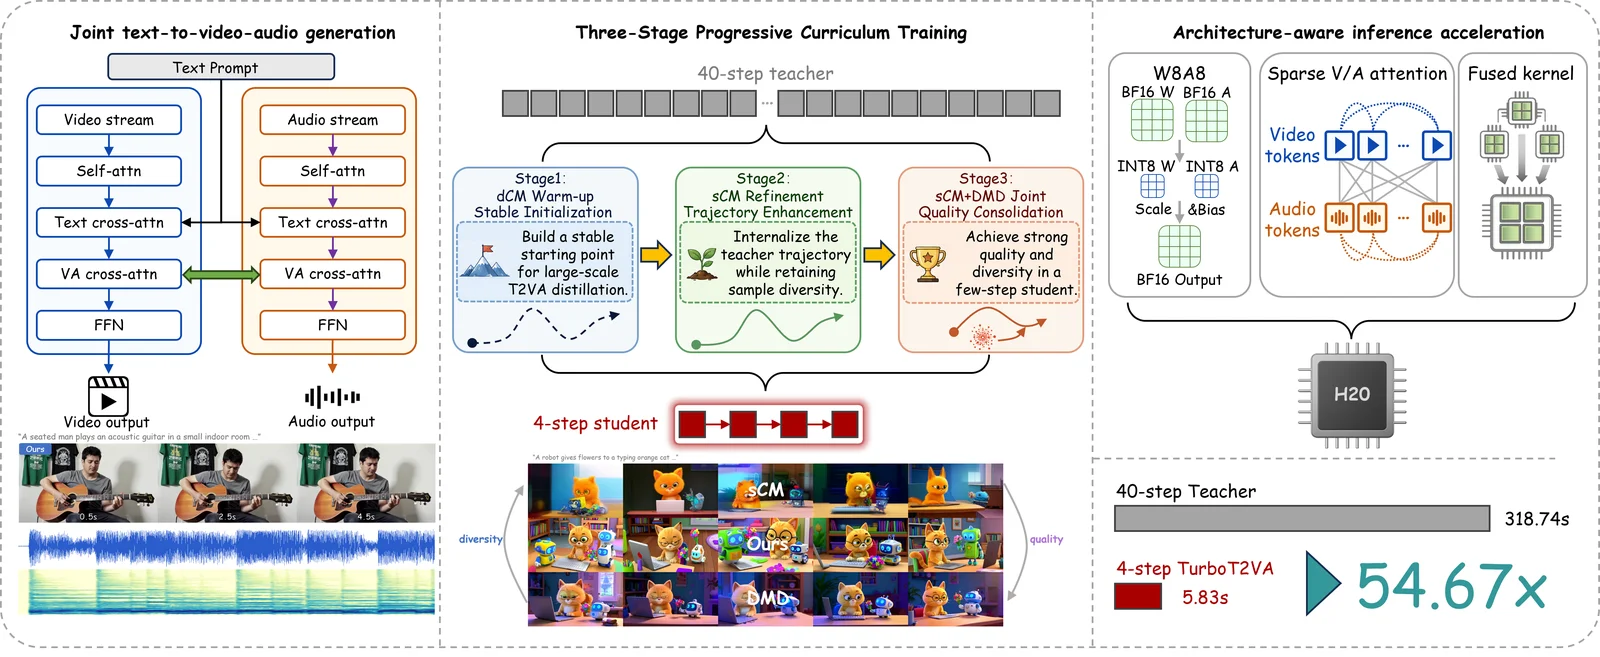
TurboT2VA 从这两个层面同时处理问题。训练端将 40 步教师蒸馏为 4 步学生:先用离散一致性蒸馏(dCM)完成 warmup,再切换到连续一致性蒸馏(sCM)学习教师轨迹,等学生形成稳定的联合生成结构后加入分布匹配蒸馏(DMD)。推理端则根据视频和音频的计算特点,采用不同的 shift 设置,并叠加 W8A8 量化、稀疏自注意力、文本填充压缩与融合算子。
最终,在单张 NVIDIA H20、1024×1792 分辨率、121 帧的测试设置下,TurboT2VA 将生成器耗时从 318.74 秒降至 5.83 秒,实现 54.67 倍生成器加速。本文重点拆解其中的联合训练方法:为什么 SCM 需要与 DMD 结合,为什么 DMD 要到最后一个阶段再加入,以及音视频模态差异如何落实到 shift、损失归一化和量化策略中。
论文:TurboT2VA: Fast Large-Scale Text-to-Video-Audio Generation via Score-Regularized Consistency Distillation
链接:https://arxiv.org/abs/2608.24674
代码与演示:https://github.com/thu-ml/TurboDiffusion/tree/main/turbot2va
一、核心技巧:先确定生成结构,再逐步引入联合目标
1.1 用离散一致性蒸馏 warmup,再过渡到 sCM+DMD
连续时间一致性模型(sCM,下文的 SCM 均指 sCM)需要估计教师生成轨迹的局部方向。模型扩大到 19B,并且同时处理视频与音频后,这一步对数值稳定性的要求更高。TurboT2VA 因此采用分阶段训练,让学生先获得基本的去噪能力。
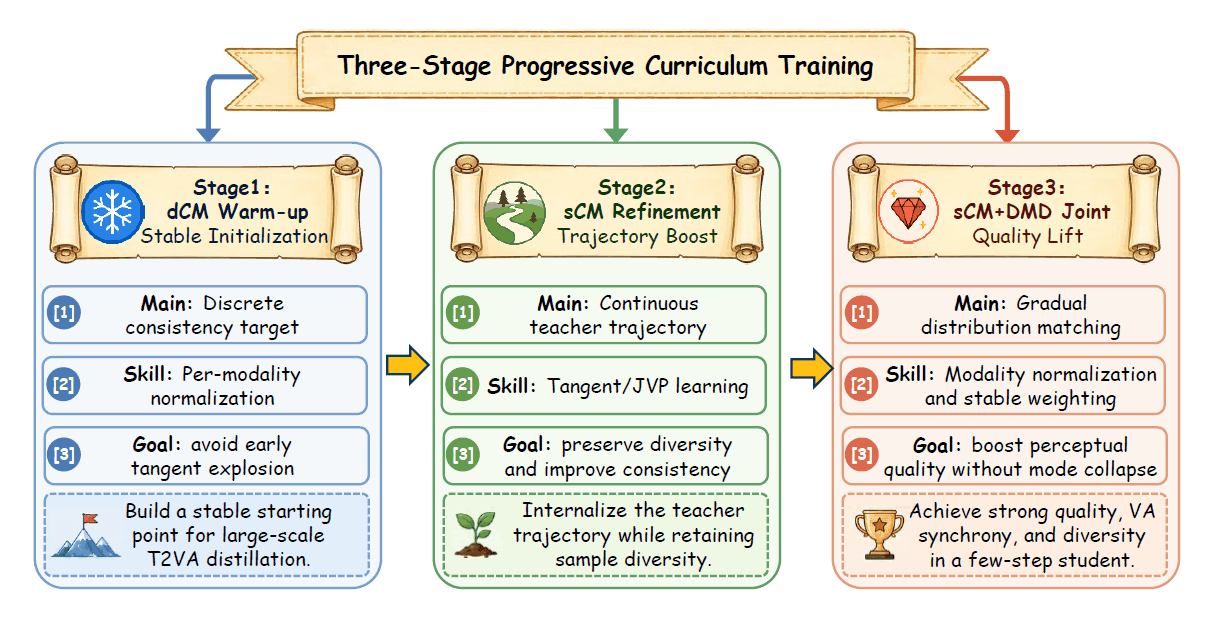
第一阶段使用离散一致性蒸馏(dCM)。学生在离散噪声水平之间学习一致的预测,先确定粗粒度的联合去噪结构,包括基本去噪能力与稳定的时间步条件响应。dCM 不需要连续时间的轨迹切线估计,适合作为大模型蒸馏的 warmup。
第二阶段从这个初始化继续训练,引入 sCM。学生进一步学习教师的连续生成轨迹,让不同噪声水平下的预测保持一致。对于音视频任务,这一阶段需要同时保留画面中的运动演变、声音事件的发展,以及两者的时间对应关系。
第三阶段保留 sCM,并加入分布匹配蒸馏(DMD)。此时学生已经具备较稳定的生成轨迹,DMD 再推动生成结果向教师分布靠近,改善最终样本的感知质量;持续参与训练的 sCM 则约束轨迹结构,保留不同随机种子带来的变化。
训练顺序是 dCM warmup → sCM refinement → sCM+DMD 联合优化。 三个阶段沿用同一个学生模型,变化的是训练目标及其引入时机。这里的“确定初步结构”,指建立联合去噪与生成轨迹的先验,模型仍使用原有 LTX-2 架构。
1.2 音视频采用不同的时间步 shift
音频与视频的隐变量维度、时间分辨率和学习节奏不同。训练中为两个模态分别设置时间步 shift,可以调整各自在噪声水平上的分配,使音视频的去噪调度与各自特征相适应。
实现时,需要区分共享的基础时间变量与各模态经过 shift 后的有效时间。两个模态仍属于同一条配对样本,共享文本条件,通过联合 Transformer 交换信息;模态各自的噪声构造和时间条件则需要与对应的调度保持一致。
这里的 shift 指扩散时间或噪声调度的偏移。CFG guidance scale 控制文本条件引导的强度,是另一项参数。调试音视频联合蒸馏时,应分别核对这两类设置,避免把引导强度的差异误当成时间调度的差异。
1.3 量化策略:按算子和注意力路径分别处理
四步蒸馏减少了模型调用次数,单次调用仍要执行 19B 模型的计算。TurboT2VA 将推理优化叠加在蒸馏后的学生上,无需为这套推理栈重新训练学生模型。
在线性层上,方法采用 W8A8:权重按输出通道做静态 INT8 量化,激活按行做动态 INT8 量化。矩阵乘法使用 INT32 累加,在完整累加结束后统一应用缩放与偏置,减少分块计算中重复缩放的开销。不同音视频分支的矩阵形状并不相同,无法满足优化算子要求的分支回退到原生 BF16 计算。
在注意力上,视频和音频的自注意力使用 SageSLA。H20 路径将 Query、Key 量化为 INT8,Value 聚合使用 FP8;高分辨率配置的 Key 块保留比例为 0.3。对于较短的音频序列,运行时保证至少保留一个 Key 块。双向音视频交叉注意力和文本交叉注意力继续采用密集计算,保留完整的跨模态交互与文本条件路径。
此外,归一化、调制、门控残差更新和旋转位置编码等操作通过算子融合减少中间读写。单样本推理还会根据共享文本掩码,去掉音视频条件嵌入中的填充位置,减少文本交叉注意力的冗余计算。
二、为什么要把 SCM 与 DMD 结合起来?
2.1 一致性蒸馏保留轨迹,分布蒸馏改善样本质量
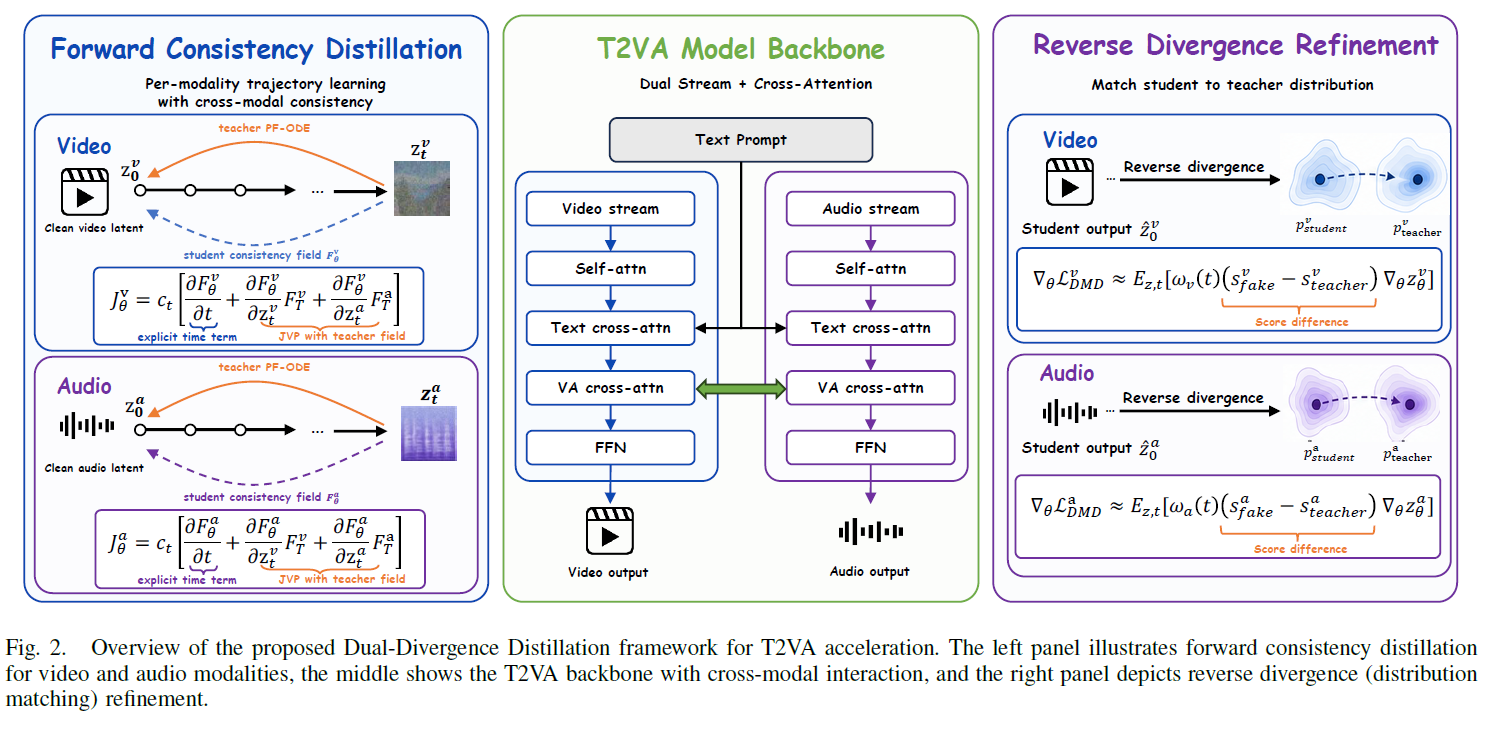
一致性蒸馏约束的是不同噪声水平下的预测关系。学生沿教师的生成轨迹学习,因而能够用很少的采样步数得到结果。dCM 在离散时间点之间建立这种关系,sCM 则在连续时间上学习轨迹的一致性,需要通过雅可比向量积(JVP)估计局部变化方向。
对音视频联合生成来说,轨迹学习影响整段内容的演变:物体怎样运动,声音怎样出现,动作与声音在什么时刻对应。保留这些变化,有助于学生继承教师的时间结构和样本多样性。
DMD 关注学生生成分布与教师分布之间的差异。它利用 score 层面的差异提供更新方向,推动学生生成更接近教师分布的样本。已有的 DMD、DMD2 工作展示了这一路线在少步生成中的感知质量优势,但分布匹配也可能偏向有限的高概率模式,使不同随机种子的结果越来越相似。
因此,两种目标可以分工:sCM 保留生成轨迹及其覆盖范围,DMD 改善最终输出的感知质量。已有 rCM 工作采用了 score 正则化与连续一致性结合的思路,TurboT2VA 将这类联合蒸馏扩展到大参数量级的音视频生成,并进一步设计训练顺序与模态平衡机制。相关方法脉络见论文相关工作部分。
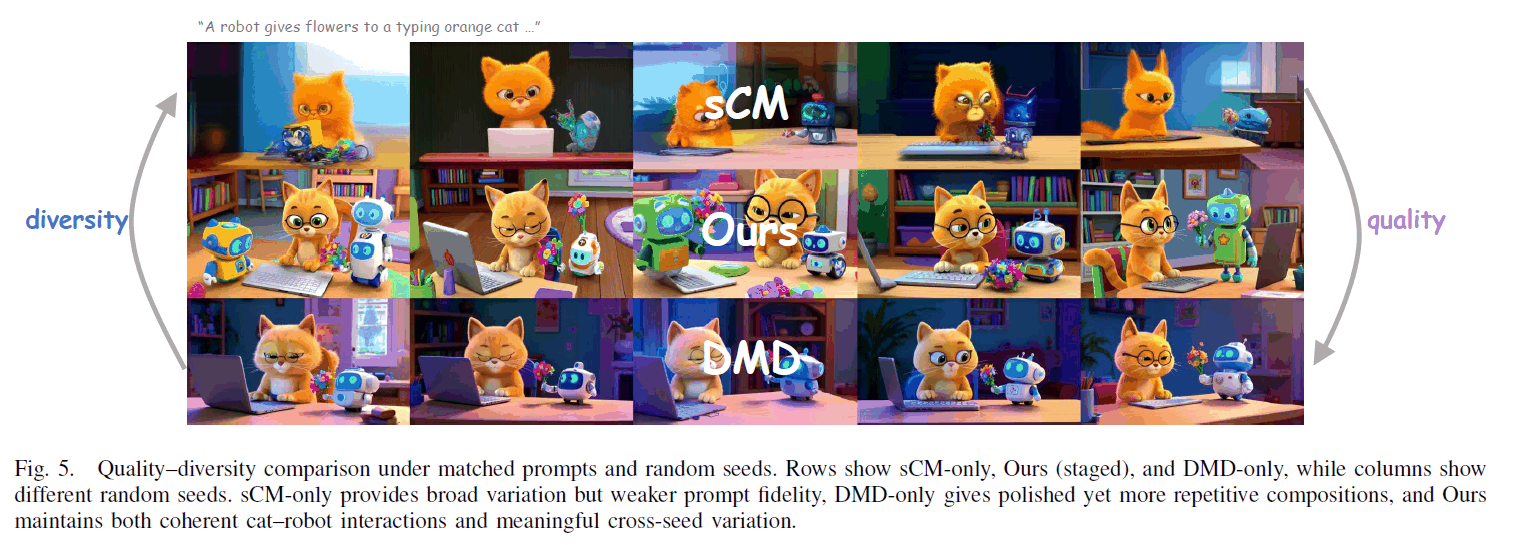
图中各列对应不同随机种子。sCM 的构图变化较大,但部分结果对提示词的表达较弱;DMD 的画面更规整,构图也更重复。分阶段联合训练保留了猫与机器人之间的互动,同时留下可见的跨种子变化。
2.2 为什么不从第一步就同时训练 SCM 与 DMD?
论文比较了直接联合训练与分阶段训练。直接使用 sCM+DMD 可以收敛,也能生成合理结果;分阶段方案进入联合训练阶段后,在相同训练步数下取得了更高的 Javis Score。
作者对这一现象的解释是:过早加入分布匹配时,学生尚未学到覆盖足够广的生成轨迹,就开始受到较强的分布级约束,可能削弱从教师轨迹中继承的多样性。先做 dCM warmup 和 sCM refinement,可以给后续 DMD 提供更稳定、覆盖更充分的起点。
在 T2VA 中,这种覆盖范围还包括运动轨迹、声音事件、节奏和音画对应方式。逐步引入目标,让轨迹学习先建立这些关系,再由分布匹配改善最终输出。
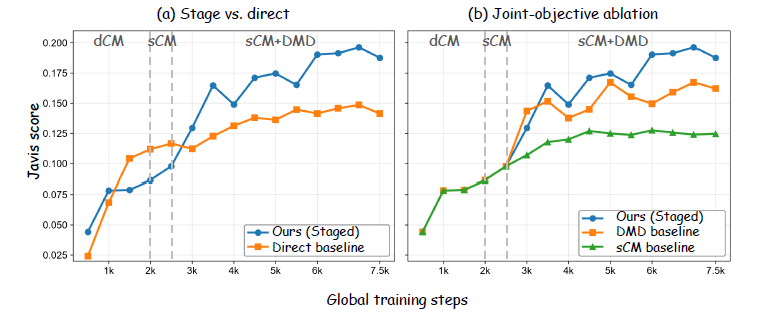
左图比较分阶段训练与直接联合训练;右图比较联合目标与单独使用 sCM、DMD 的结果。两张图纵轴均为 Javis Score,反映音视频对齐表现。样本多样性则需要结合不同随机种子的生成结果与独立的多样性评估判断。
三、联合训练如何处理音视频差异?
3.1 配对输入,联合前向传播
TurboT2VA 在配对的视频与音频隐变量上进行蒸馏。同一条样本的两个模态共享文本条件,分别采样噪声,一起进入联合 Transformer;学生通过一次前向传播输出视频和音频预测。
损失按模态分别计算,梯度通过同一个跨模态计算图回传。视频分支能够利用音频 token,音频分支也能够利用视频 token。计算 sCM 所需的 JVP 时,局部方向同样经过跨模态模型,使轨迹学习包含音视频之间的相互影响。
3.2 两种目标采用不同的归一化方式
视频与音频的隐变量规模不同,直接相加损失容易让某一模态主导优化。TurboT2VA 分别处理两种目标的更新尺度。
sCM 对每个模态的方向向量做 L2 归一化,再组合模态损失,以减轻视频与音频之间的尺度差异。DMD 则使用学生样本与教师预测之间的残差尺度归一化,让分布匹配信号相对于各模态自身的误差大小进行调整。
DMD 的监督作用于同一学生生成的配对音视频样本。两个目标使用相同批次、文本条件和配对隐变量,在联合训练时分别约束轨迹与输出分布。归一化后的损失还通过模态权重和目标权重控制相对强度。
3.3 训练配置与阶段衔接
主实验使用 10 万条文本、视频、音频配对样本,在 8 张 H20 上训练,分辨率为 512×768,长度为 121 帧,训练约耗时 21 小时。
论文给出的主模型训练安排为:2,000 步 dCM warmup、500 步 sCM refinement,以及 4,500 步 sCM+DMD 联合优化,总计 7,000 步。联合阶段的 sCM 与 DMD 权重相同。消融曲线则统一展示到 7,500 步,用于比较不同优化路径。具体配置见论文实验设置。
四、实验结果:四步生成与推理栈分别带来多少加速?
4.1 标准分辨率:50.52 秒降到 2.51 秒
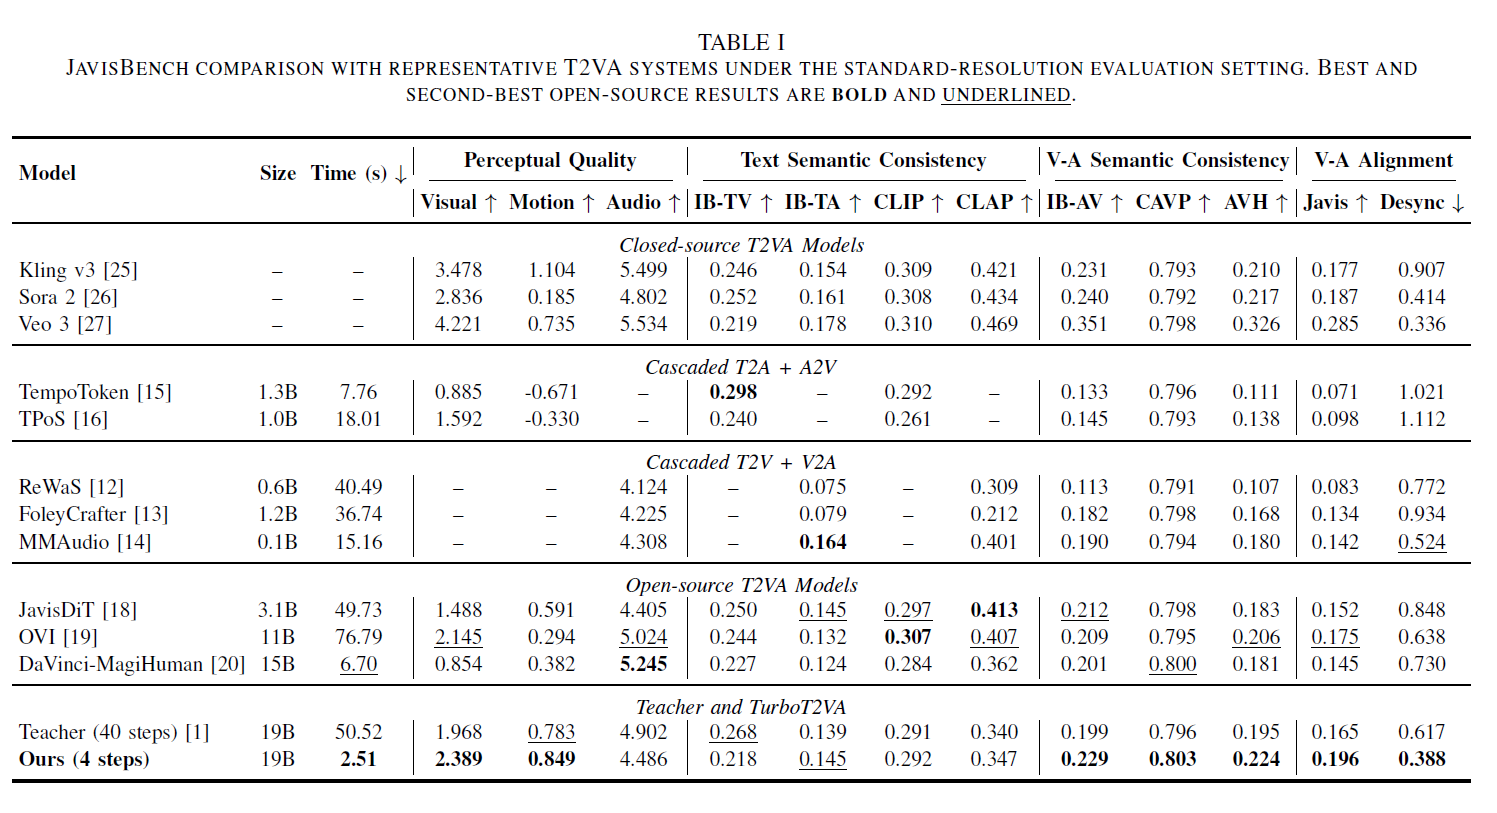
在 512×768、121 帧的标准评测设置下,40 步教师的生成器耗时为 50.52 秒,4 步学生为 2.51 秒,对应约 20.1 倍加速。
JavisBench 结果中,学生的 Visual 指标由教师的 1.968 提升至 2.389,Motion 由 0.783 提升至 0.849。音画对齐方面,Javis Score 从 0.165 提升至 0.196,Desync 从 0.617 降至 0.388,其中 Desync 越低越好。这些结果展示了四步学生在画面、运动和音画对齐上的表现。
论文还使用 VBench 和 TTA-Bench 分别评估视频与音频保真度,并用 ImageBind 比较同一提示词下不同随机种子生成样本的嵌入距离。综合这些评测,纯 sCM 更偏向保留多样性,纯 DMD 更偏向感知质量,分阶段联合方案在两者之间取得了更好的平衡。
4.2 高分辨率:完整推理栈达到 54.67 倍生成器加速
高分辨率测试采用单张 NVIDIA H20,输出为 1024×1792、121 帧。官方仓库给出了逐项叠加优化的耗时:
- 40 步教师、密集注意力:318.74 秒。
- 教师加入 W8A8 与 FastNorm:233.34 秒。
- 在此基础上切换到 4 步学生:12.16 秒。
- 继续加入 SageSLA 和文本填充压缩:5.83 秒。
最终配置相对教师达到 54.67 倍加速。作为参照,同分辨率下未叠加这些推理优化的纯 4 步学生耗时为 16.50 秒,完整推理栈在此基础上进一步带来约 2.83 倍加速。各阶段沿用此前已启用的优化,详见官方推理耗时记录。
以上高分辨率数字统计生成器耗时,不包含模型加载、音视频解码、封装和磁盘读写。54.67 倍对应这一测试口径下的生成器加速。