AgentArk 是一个面向多模态智能体的开放环境框架。核心思路是利用 Coding Agent 持续扩展 task,并让同一批环境同时支持 Agentic RL 训练与评测。
AgentArk:https://github.com/P90-RushB/AgentArk
AgentArk Hub:https://p90-rushb.github.io/agentark-hub
AgentArk Bench:https://www.kaggle.com/benchmarks/xunyiljg/agentark-bench
目前,AgentArk 已经开发了 200+ 个 task environments(受限于奥特曼不给开第三个codex 20x),覆盖 2D、3D、物理交互、多视角、时间估计、GUI、图表、3D 建模以及 ARC-AGI-3-like 等不同方向;2026 年的目标是扩展到 1K+。
RL 侧目前已经支持 ms-swift 与 verl,可以直接在这些多模态交互环境上进行 GRPO 等 Agentic RL 训练。
如果用一句不太严谨、但足够直观的话概括我希望它最终变成什么:
我希望 AgentArk 能成为“大模型的 Steam”。
这里的重点不是维护一套固定题目,而是让环境持续增长:新的 task 可以不断被开发、验证并加入 Task Store,模型既可以进入这些环境中做评测,也可以直接用于 RL。
GPT-6 Astra 把 AgentArk Bench 推到了 80.46
这次写这篇文章,一个直接的契机是 GPT-6 Astra。
这两天托管AgentArk Bench的kaggle评测平台开放了Astra。在当前公开的 14 个 task、6 个模型上,GPT-6 Astra 的综合得分达到 80.46。
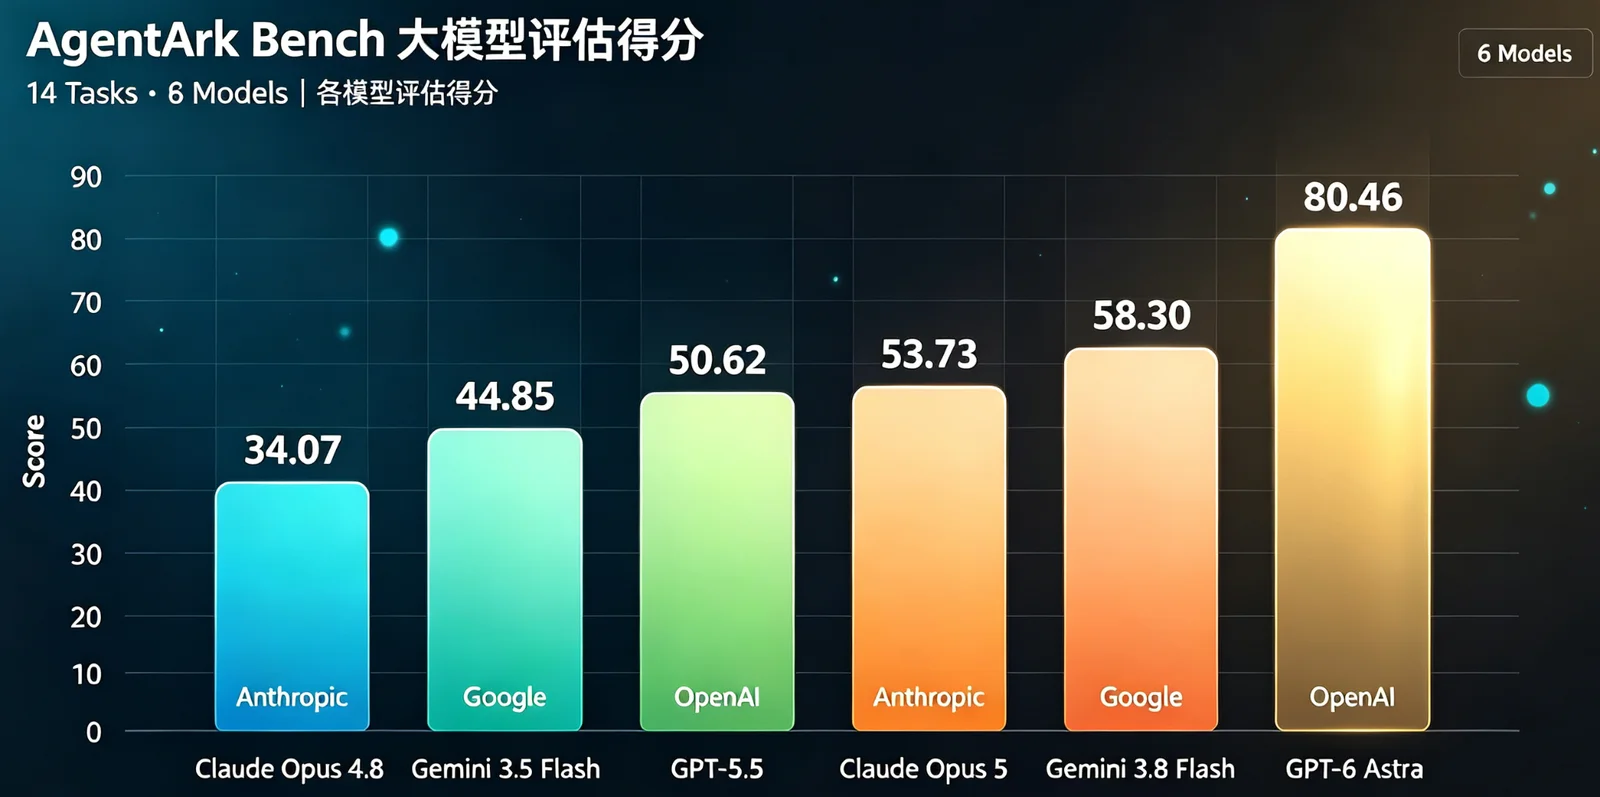
Astra与与此前模型拉开了非常明显的差距,把AgentArk Bench也刷爆了,像arc-agi-3一样,爆了!(暂时的,毕竟可扩展哈哈)
对于AgentArk被刷爆,我很开心。因为刚开源不久,此前在做 benchmark 和 task validation 时,我一直存在一个疑问:为什么很多 task 上不同模型都做不好?
当所有模型都低分时,很难完全排除另一种可能:
到底是模型能力还不够,还是 environment 本身设计得有问题?
尤其 AgentArk 的 task 完全由 Coding Agent 自动化开发,这个问题更值得警惕。
而这一次,在同一套 environment 和 interaction protocol 下,更强的模型能够把总体成绩明显推高。它当然不能证明每一个 task 都已经完美,但至少给出了一个很重要的信号:过去大量的失败,并不只是因为任务本身不可解;随着模型能力提升,原本存在的 capability headroom 确实可以被打开。
这也是我现在更愿意继续把 AgentArk 往“更难、更陌生、更依赖 in-context learning”的方向扩展的原因。
GPT-6 Astra 这次在 ARC-AGI-3 上的表现也提供了一个很有意思的参照。ARC-AGI-3 和 AgentArk 并不是同一种 benchmark,但两者关注的能力存在明显交集:
把模型放进一个陌生环境,通过 observation、action 和 feedback,在 context 内逐渐理解环境规律。
也就是 in-context learning inside environments。
ARC-AGI-3 更集中于陌生的抽象交互环境;AgentArk 则更侧重广义的 multimodal Agent。除了几十个 ARC-AGI-3-like task,AgentArk 里还有普通 2D / 3D、物理交互、空间推理、多视角、时间估计、GUI、图表、3D 建模等不同任务类型。
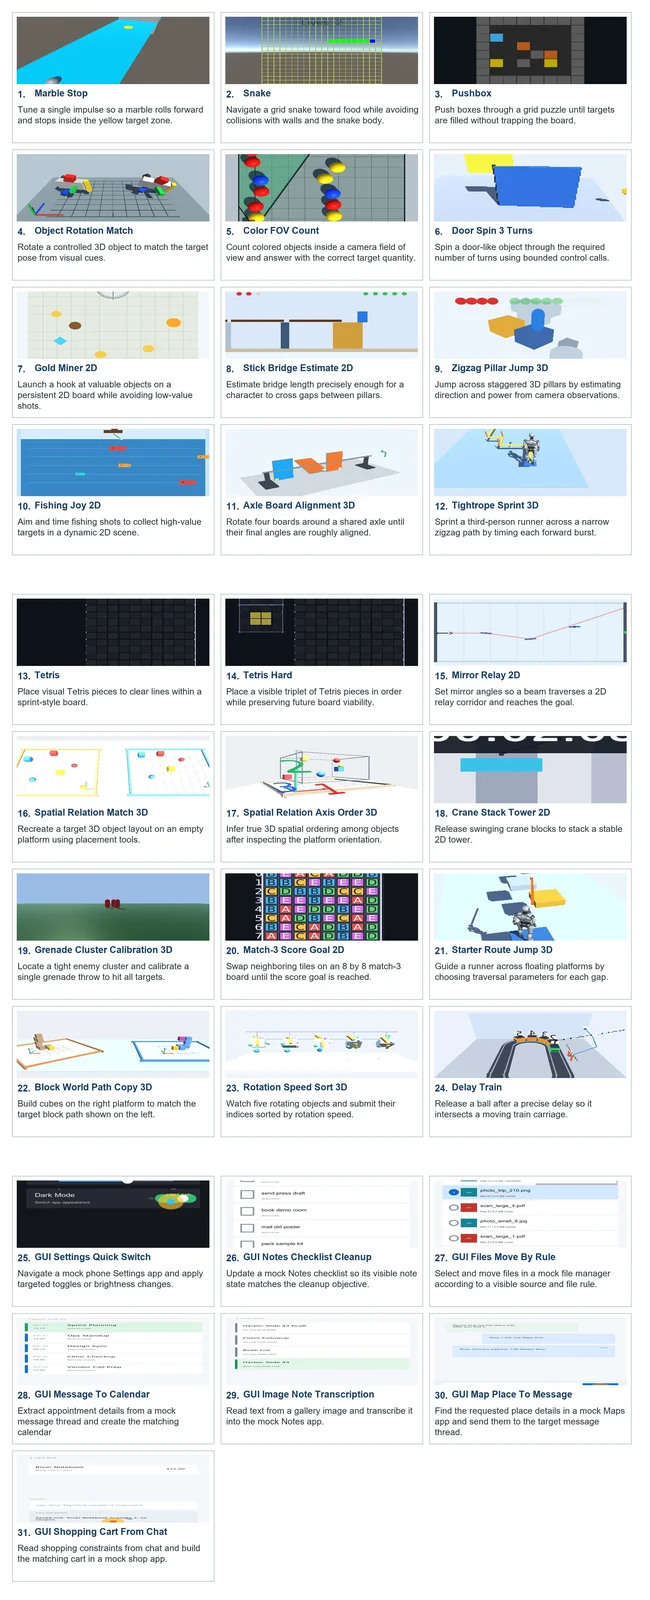
从这个角度看,AgentArk 想解决的问题其实很直接:
如果我们希望模型真正进入陌生环境中观察、试错、学习和改进,那么足够丰富的多模态交互环境从哪里来?
一、多模态 Agent 真正缺的是 Environment
如果把范围放宽到所有 Agent 环境,那么“环境稀缺”并不准确。
例如 Coding Agent 已经拥有大量成熟的 sandbox、repository、compiler、interpreter 和 unit test。这些结构化基础设施天然适合构成大规模、可验证的训练与评测环境。
我这里真正想强调的是:
足够多样、可交互、可验证,并且能同时用于 Evaluation 和 RL 的 multimodal environments,仍然非常稀缺。
多模态环境的难点在于,模型看到的是画面,执行的 action 需要真实改变环境,而环境随后还必须自动给出 reward,并支持 reset、randomization、replay,以及并行运行。
现有相关工作当然有。
多模的一部分子方向已经很适合扩展。例如 GUI task 的交互范式相对固定;Web / WebDev 又天然拥有 DOM、HTML、CSS、JavaScript 这样的结构化状态,因此既容易构造视觉 observation,也容易自动验证。
还有另一类工作更侧重环境接口、部署和共享,例如 OpenEnv,以及 Prime Intellect 的 Environments Hub。它们对 Agent 生态很重要,但更关注如何让已有 environment 更容易被标准化、运行和分发。
我觉得这里需要区分两个问题:
怎样让 environment 更容易被接入和共享?
以及:
大量新的 multimodal environment 本身从哪里来?
AgentArk 更想解决的是后一个问题。
二、AgentArk 的思路:用 Coding Agent 去扩展 Multimodal Agent
AgentArk 的基本路线很直接:
利用已经非常强的 Coding Agent,自动开发用于评测和训练下一代 Multimodal Agent 的环境。
哪怕在半年前,这件事都很难成立。因为一个真正可用于 Agent 的 environment,不只是“写一个小游戏”,还包括场景、任务目标、Observation、Action API、Reward、Randomization、Reset、Termination、异常处理、可解性检查与 Replay;task本身也不是一次性完成的,既然要修正,那coding agent也要有一定的多模能力!
但今天,Coding Agent 的软件工程能力已经明显跨过了一个门槛,那么一个自然的问题就是:
能否把 Coding Agent 的能力,转化为构造训练环境的能力?
AgentArk 正是在做这件事。
三、Task Mod:环境持续增加,而无需不断修改 Runtime
AgentArk 底层维护一个通用 Runtime,而新的任务环境则以独立 Task Mod 的形式加载。
每个 Mod 可以自行定义:
Task Instruction
Observation
Action
Reward / Scoring
Termination
Scene Logic
Runtime 本身不需要知道当前加载的是 3D 空间推理、物理控制、GUI、ARC-like puzzle 还是图表操作,它只负责提供统一的执行和交互能力。
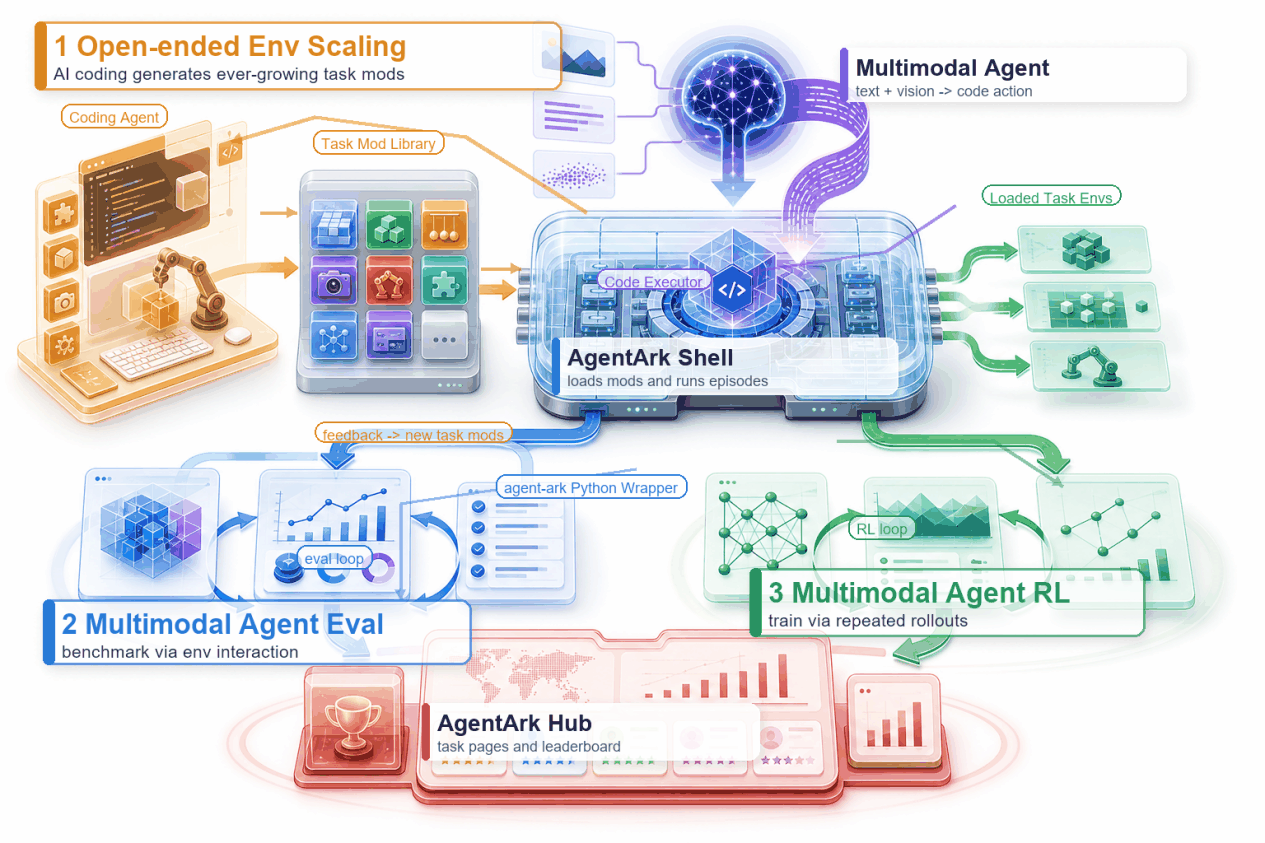
因此,AgentArk Bench 只是 AgentArk 的一种公开评测方式。更准确地说,Benchmark 是从持续增长的 Task Store 中抽出一部分环境,用统一配置进行公开评测。
四、为什么这种路线有机会稳定扩展:判别容易,决策难
如果 Coding Agent 只是不断生成“看起来像任务”的场景,那么无论 1000 个还是 10000 个,意义都不大。
真正关键的问题是:
Reward 从哪里来?
而这正是游戏引擎式环境的一项重要优势。
我经常用一句话概括这种结构:
判别容易,决策难。
假设一个 3D task 要求模型根据画面判断两个物体谁离 camera 更近。
对 Multimodal Agent 来说,它拿到的是 RGB observation,需要理解深度、透视、遮挡和空间关系。
但对 Environment 来说,它内部直接知道:
Camera.position
ObjectA.position
ObjectB.position
答案几乎可以直接计算。
再比如一个物理 task:模型需要控制力度和方向,把物体投到目标区域。
Agent 只能根据画面和历史尝试估计距离、角度、速度、重力、摩擦和碰撞;Environment 内部却拥有真实的 position、velocity、collision、rigidbody state 和 target bounds。
对 Agent 来说,这是一个困难的 perception + reasoning + control 问题;对 verifier 来说,可能只需要判断:
success = target.Contains(object.position)
这里存在一个非常适合 RL 的信息结构:
Agent 只能根据有限的 multimodal observation 做决策,而 Environment 可以使用 privileged structured state 做验证。
因此 reward 不需要依赖另一个昂贵的 VLM 去“判断模型是不是大概做对了”,引擎本身就知道 ground truth。
我认为,这是 AgentArk 能够持续扩展 task,同时仍然保持可训练性的一个核心杠杆。
五、环境生产不只是 Coding,更是 Verification
环境代码能运行,并不代表它就是一个好的 Agent task。
一个程序可以完全没有 bug,但仍然可能出现:
- 目标在视觉上不可观察
- reward 存在 shortcut
- 某些随机 seed 下任务无解
- 反馈不足,Agent 无法从失败中学习
- replay 无法稳定复现
因此,AgentArk 的环境生产不是一次性的 “prompt → code”,而是一个带验证的工作流。
在当前工作流中,Coordinator 负责调度,Designer 负责将 capability gap 转换为 task specification,Builder 负责实现环境,Reviewer 负责检查视觉可观察性、任务可解性、可重放性等关键属性。
在 Reviewer 之后,我又加入了 Black-box Agent Playtest:让 Agent 以黑盒方式真正试玩 task,从模型侧暴露任务设计问题,例如反馈不足、任务说明存在歧义、交互逻辑不合理,或者“从开发者视角看起来可解,但实际 Agent 很难获得完成任务所需的信息”。试玩agent就像玩家,玩家不需要一定厉害,但能知道task是否合理。
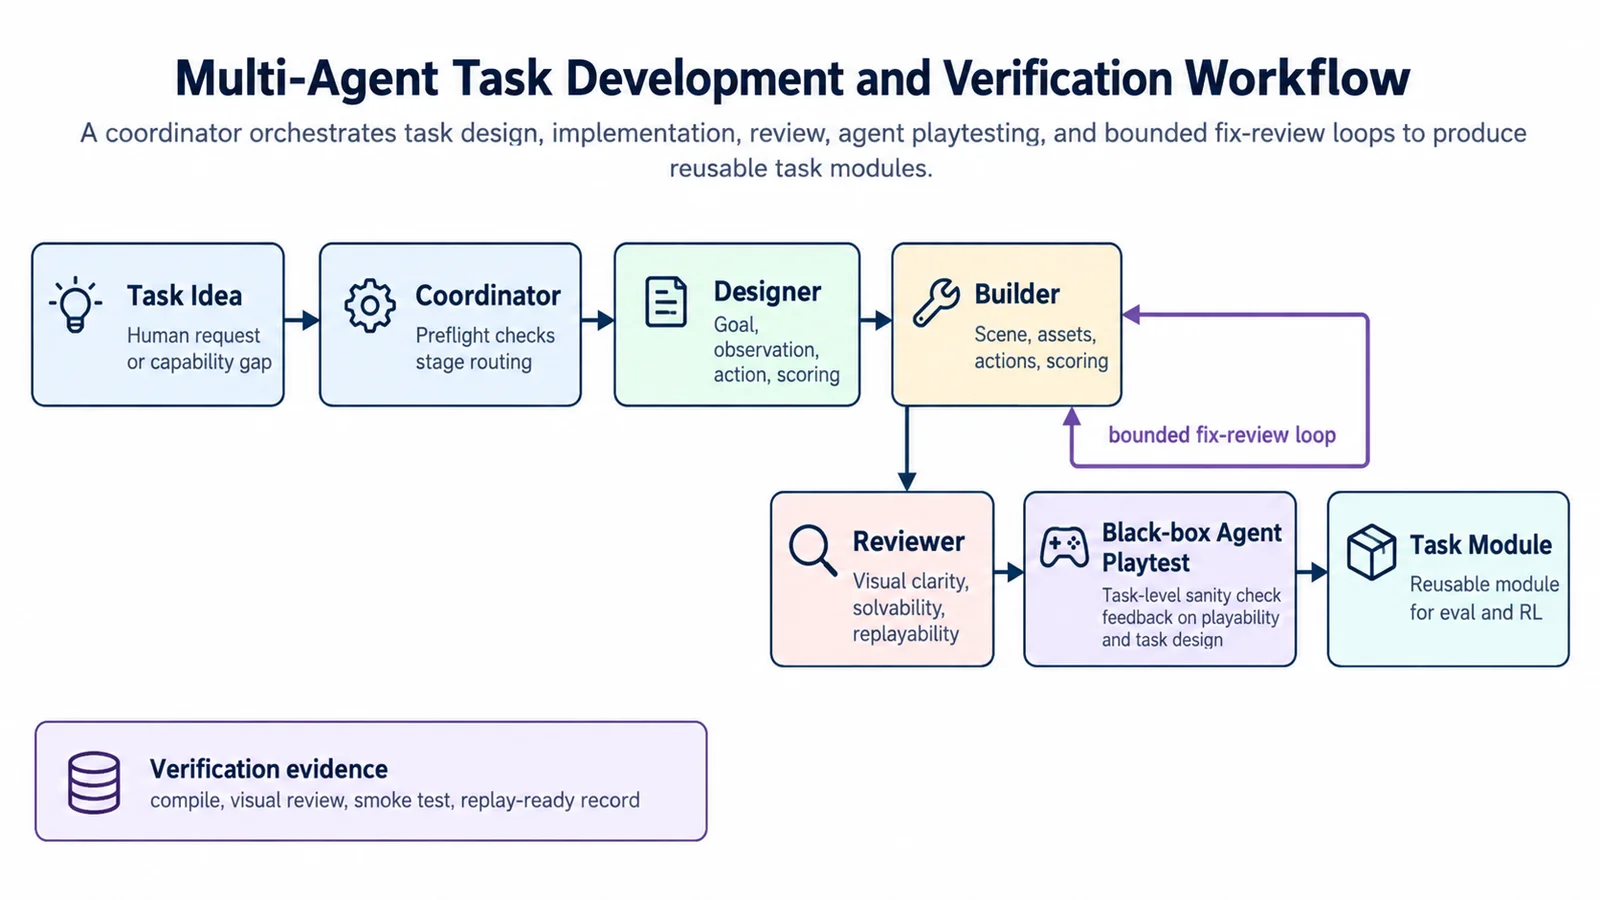
这里最重要的一点是:
Code correctness 不等于 Task correctness。
对于 AgentArk 来说,task 开发实际上比“让 Coding Agent 写一个 Unity 环境”复杂得多。一个可用于评测和 RL 的 task,至少需要确保任务可解、能够稳定 reset、能够重放、reward 可验证,并且模型确实能够通过给定 observation 获取完成任务所需要的信息。
这些都属于 Coding Agent 开发工作流本身。本文不展开具体实现细节,但如果未来希望把 task 扩展到 1K、10K 甚至更多,那么需要 scale 的不只是 Coding,也必须包括 Environment Verification。
六、AgentArk 和 World Model:生成“世界”与生成“任务环境”并不是一回事
另一条很重要的路线当然是 World Model。
今天的视频世界模型已经可以生成越来越真实、甚至能够实时交互的世界。我非常看好这个方向,但如果从 Agent Evaluation / RL 的视角看,我觉得需要区分两件事:
World Generation
和
Task Environment Generation
World Model 擅长生成场景、视觉变化和动态过程,模型甚至可以在其中移动和探索。
但一个可用于 RL 的 environment 还需要:
Goal
Action Semantics
Reward
Termination
Verification
Persistent State
也就是说,除了“世界长什么样”,还要回答:
这个世界里要做什么?做对了以后怎么知道?
因此,一个能够探索的世界,并不天然等于一个能够用于训练 Agent 的 task environment。两个月前真实的例子:roblox开发的world model,可让玩家进入实时游玩。但玩家进去后一脸懵逼:“我能移动,然后呢?玩啥啊???”
AgentArk 的出发点刚好相反:先确定要评测或训练什么能力,再围绕这个目标构建 Scene、Observation、Action 和 Reward。因此,Coding Agent 生产的环境天然是 task-centric 的。
我并不认为这两条路线互斥。更可能的未来反而是:
World Model / 3D Generation 提供无限的视觉与世界多样性;Task Engine 提供 Goal、Logic、Action 和 Verifiable Reward。
这也是 AgentArk 后续希望进一步结合的方向。
七、为什么不是传统 Gym:LLM Agent 需要 LLM-native Environment
AgentArk 仍然遵循最基本的 RL loop:
reset → observation → action → reward + next observation
但与传统gym有大量必须不同的地方,这里着重讲 Observation 和 Action。
传统 Gym 环境通常会预先定义固定的:
observation_space = Box(...)
action_space = Discrete(...)
这非常适合针对具体环境训练的 policy network。
但 Foundation Model based Agent 的目标不太一样。我们更关心的是:
模型第一次进入一个陌生 environment 时,能不能依靠当前 context 现场理解它?
因此,AgentArk 的 Observation 可以是图像、多图、视频帧、文本、task instruction、previous action、score、error message,以及前几次 attempt 的历史。
一次失败也不一定意味着这段 rollout 完全失去价值。对于很多需要校准、规则发现或物理推理的 task,之前的失败本身就是下一次 decision 的 evidence。
这也是为什么 AgentArk 的很多 task 本质上都依赖 in-context learning。
Code as Action:Action 也不应该只是几个固定整数
对于 LLM / VLM Agent,固定的:
0 = left
1 = right
2 = jump
往往会浪费大模型已经具备的一项重要能力:写代码。
因此,AgentArk 的 Action 本质上采用 Code as Action。
简单任务可以暴露 function:
Move(...)
Rotate(...)
Launch(...)
Click(...)
TypeText(...)
模型通过 structured tool call 调用。
更复杂的 task 也可以直接允许模型提交完整代码,让一次 action 表达一个更长的 control program。
当然,Code as Action 也带来了新的问题:JSON 可能非法、参数可能越界、代码可能编译失败,或者执行时出现 exception。
AgentArk 会在不同阶段捕获这些错误:
- Schema / format error
- Compilation error
- Runtime exception
而关键设计是:
这些错误本身也会成为 next observation。
模型可以看到 compiler diagnostics 或 runtime exception,并在下一步主动修复。
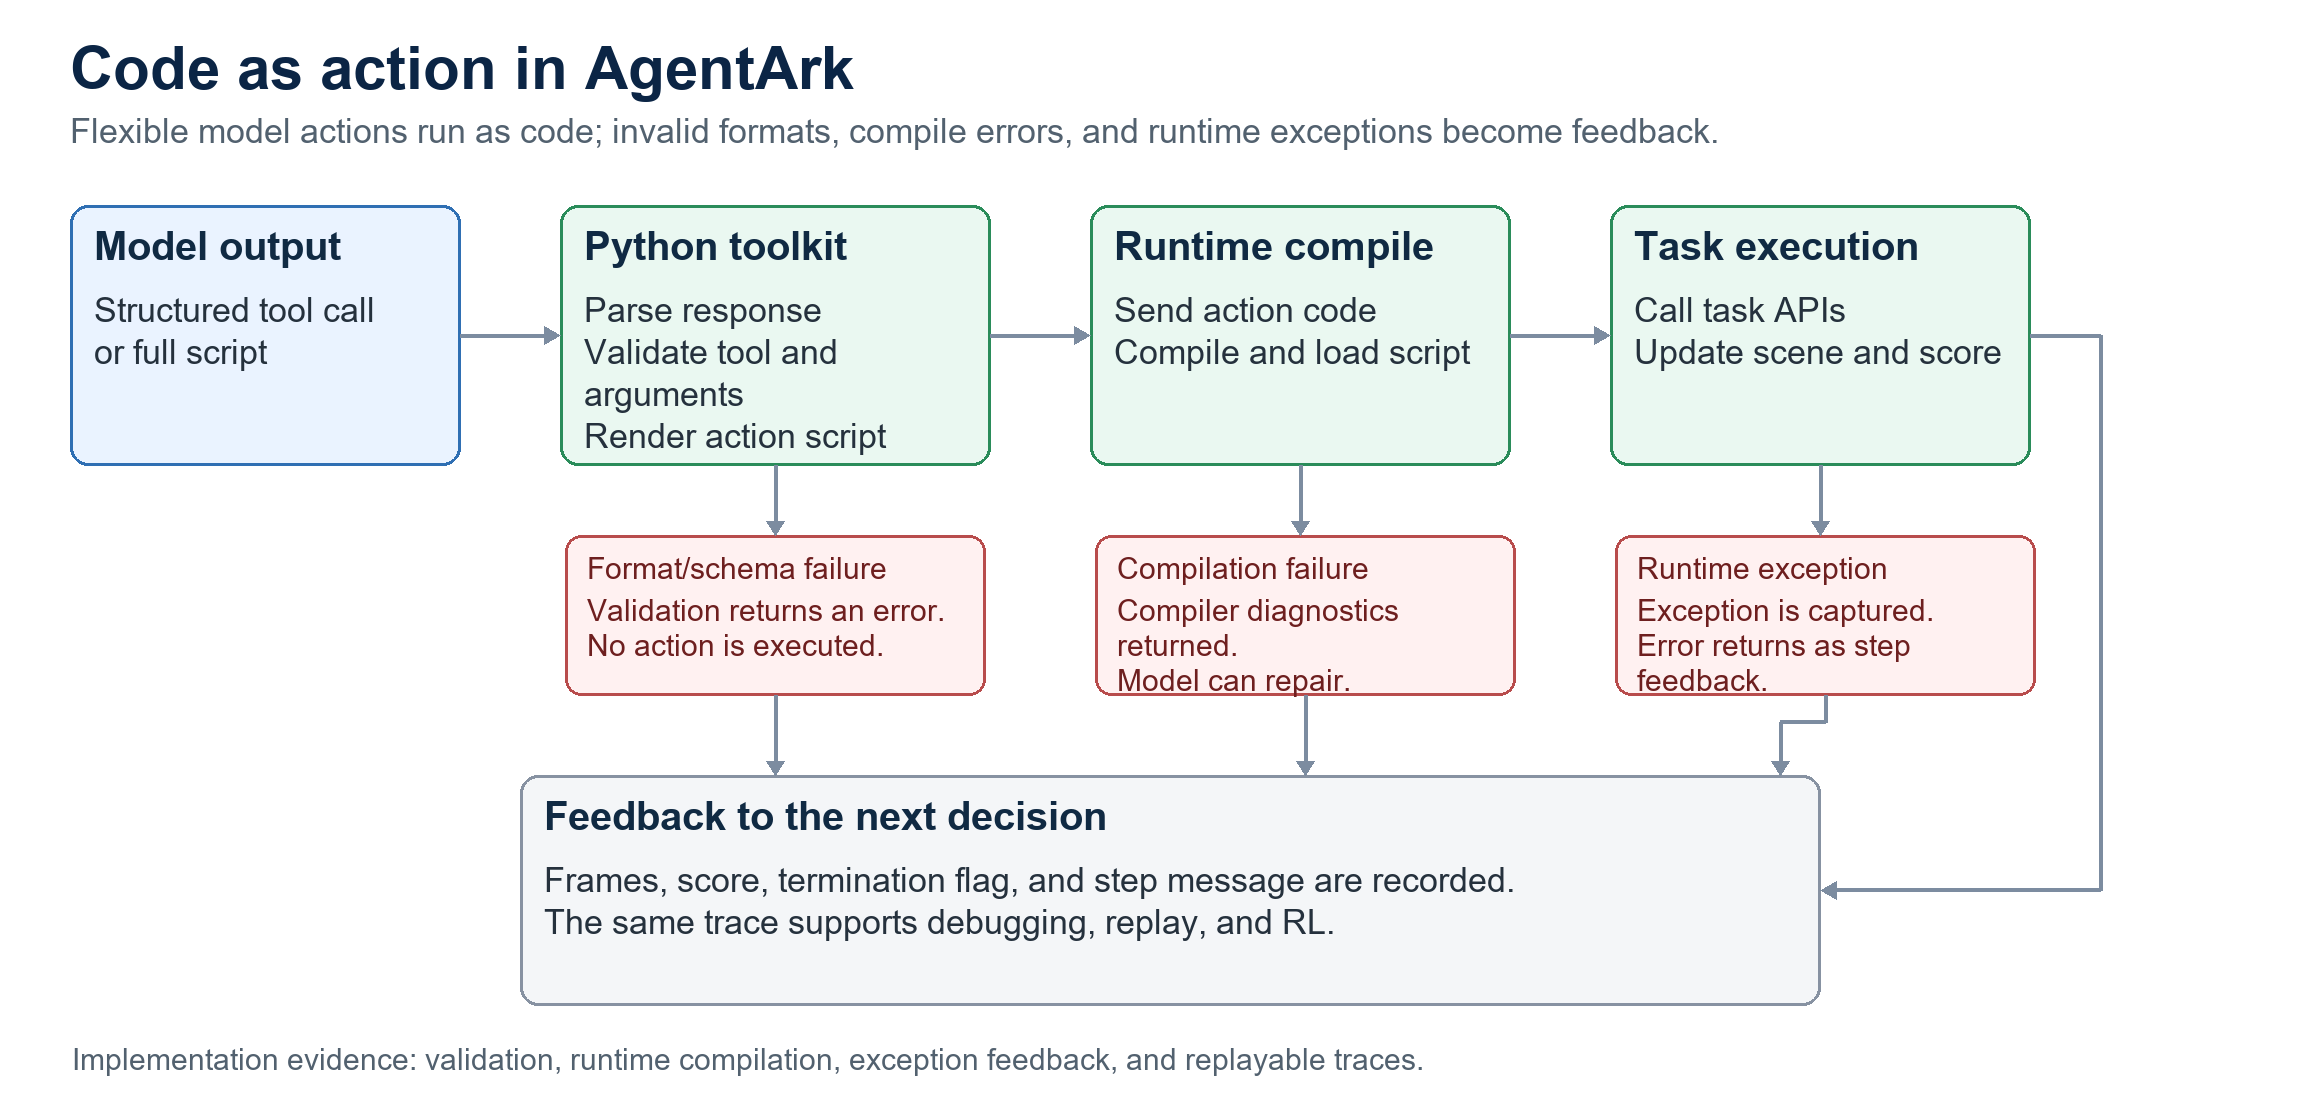
在我看来,这比要求 LLM 模拟一个传统 policy network,更接近真正的 LLM-native Environment Interface。
八、同一套环境,同时用于 Eval 和 RL
AgentArk Bench 只是 AgentArk 的一种使用方式。
整个系统围绕同一批 Task Mods,同时支持:
Coding Agent
    ↓
Task Mods
    ↓
AgentArk Runtime
   ↙        ↘
Evaluation   RL
   ↓          ↓
Replay/Hub  ms-swift / verl
其中:
- Repo 提供 Runtime、Python tooling、评测、Replay 和 RL 接口
- AgentArk Hub 更像不断增长的 Task Store,展示 Task、Tag、Media、模型结果和 artifacts
- Kaggle Bench 提供公开 Evaluation 入口
RL 侧目前已经支持 ms-swift 与 verl 的 Agentic RL / GRPO 集成。
Environment Server 负责管理 Task、Seed、Runtime Worker、Pre-warm、Sandbox 与 Worker recycle;Trainer 则通过 HTTP 与环境池交互,不需要直接管理 Unity process。
对于 GRPO 这类 group-based RL,同组样本还可以使用相同的 Task、Random Seed 和 Initial Condition,使组内 reward 差异尽量来自 policy 本身,而不是 environment 随机性。
这也是 AgentArk 从设计之初就很重视的一点:
一个 task 被生产出来以后,希望 Evaluation 和 RL 可以直接复用,而不是再写两套环境。
九、长期目标:Model–Environment Co-evolution
AgentArk 今年的目标是 1K+ task environments。
但 1000 不是终点。
如果整个流程永远只是:
Human 提出新任务方向
↓
Coding Agent 实现任务
那么系统最终仍然强依赖 human task designer。
我更感兴趣的是下一步:
Model Evaluation / RL
        ↓
Failure Traces
        ↓
Capability Gap
        ↓
自动提出新 Task
        ↓
Coding Agent 实现 Environment
        ↓
Verification
        ↓
加入 Curriculum
        ↓
继续 RL
也就是 Model–Environment Co-evolution。
今天,Coding Agent 已经在软件工程上非常强,可以先利用它来生产环境,补齐 Multimodal Agent 的能力缺口。
未来,Multimodal Agent 进一步增强后,它又可以从自己的 failure trace 中发现新的弱点,提出下一代 task,再进入新的 RL 循环。
Agent 找到自己的弱点 → 为自己出题 → 训练 → 再寻找新的弱点。
这才是我认为 AgentArk 最值得长期探索的方向。
结语:给大模型一个不断增长的“Steam”
相比“一个新的 multimodal benchmark”,我更愿意这样定义 AgentArk:
一个用 Coding Agent 持续生产多模态交互环境,并统一用于 Evaluation 和 Reinforcement Learning 的开放框架。
它现在还很早:刚开源两个月,已经开发 200+ task,今年的阶段性目标是 1K+。
但 task 数量本身不是最终目标。
真正重要的是,环境能不能持续扩展到新的能力域,并且在模型进步以后继续产生新的 challenge。
GPT-6 Astra 这次把 AgentArk Bench 推到了 80.46,对我来说并不意味着“现有 benchmark 快做完了”。
反而让我更关心下一个问题:
GPT-6 已经解决了这些,那么下一批它还解决不了的 Environment 在哪里?
找到它们,做成环境,让模型进去失败,再通过 RL 让它学会,然后继续寻找下一批。
这就是我目前对 AgentArk 最期待的方向。
希望有一天,大模型进入 AgentArk,就像我们打开 Steam 一样:里面永远有它还没玩过、也还没学会的新东西。