近日,由中国科学院信息工程所、小米 MiLM Plus、南开大学、宾汉姆顿大学合作完成的研究成果《UniTranslator: A Unified Multi-modal Framework for End-to-end In-Image Machine Translation》被 ECCV 2026 接收。
题目:UniTranslator: A Unified Multi-modal Framework for End-to-end In-Image Machine Translation
作者: Jiahao Lyu, Pei Fu, Zhenhang Li, Shaojie Zhang, Jiahui Yang, Yu Zhou, Can Ma, Zhenbo Luo, Jian Luan
单位:中国科学院信息工程所、小米 MiLM Plus、南开大学、宾汉姆顿大学
论文链接:https:/doi.org/10.48550/arXiv.2606.24333
代码链接:https:/github.com/SeerRay-Lab/Unitranslator
模型链接:https:/huggingface.co/SeerRay-Lab/Unitranslator
论文聚焦图内机器翻译(In-Image Machine Translation,IIMT)这一任务,首次系统性揭示统一多模态模型在该任务上的两大结构性瓶颈——理解-生成冲突与空间位置错位,并提出统一框架 UniTranslator,在多个基准上全面刷新 SOTA。
图内机器翻译:既要“译得准”,又要“放得对”
图内机器翻译(IIMT)的目标是:将图像中的场景文字翻译为目标语言,并把译文重新写回原始区域,同时保持整体视觉外观、版式与背景一致。它是多语言视觉沟通的基础能力,广泛应用于旅行辅助、增强现实、跨境电商等场景。
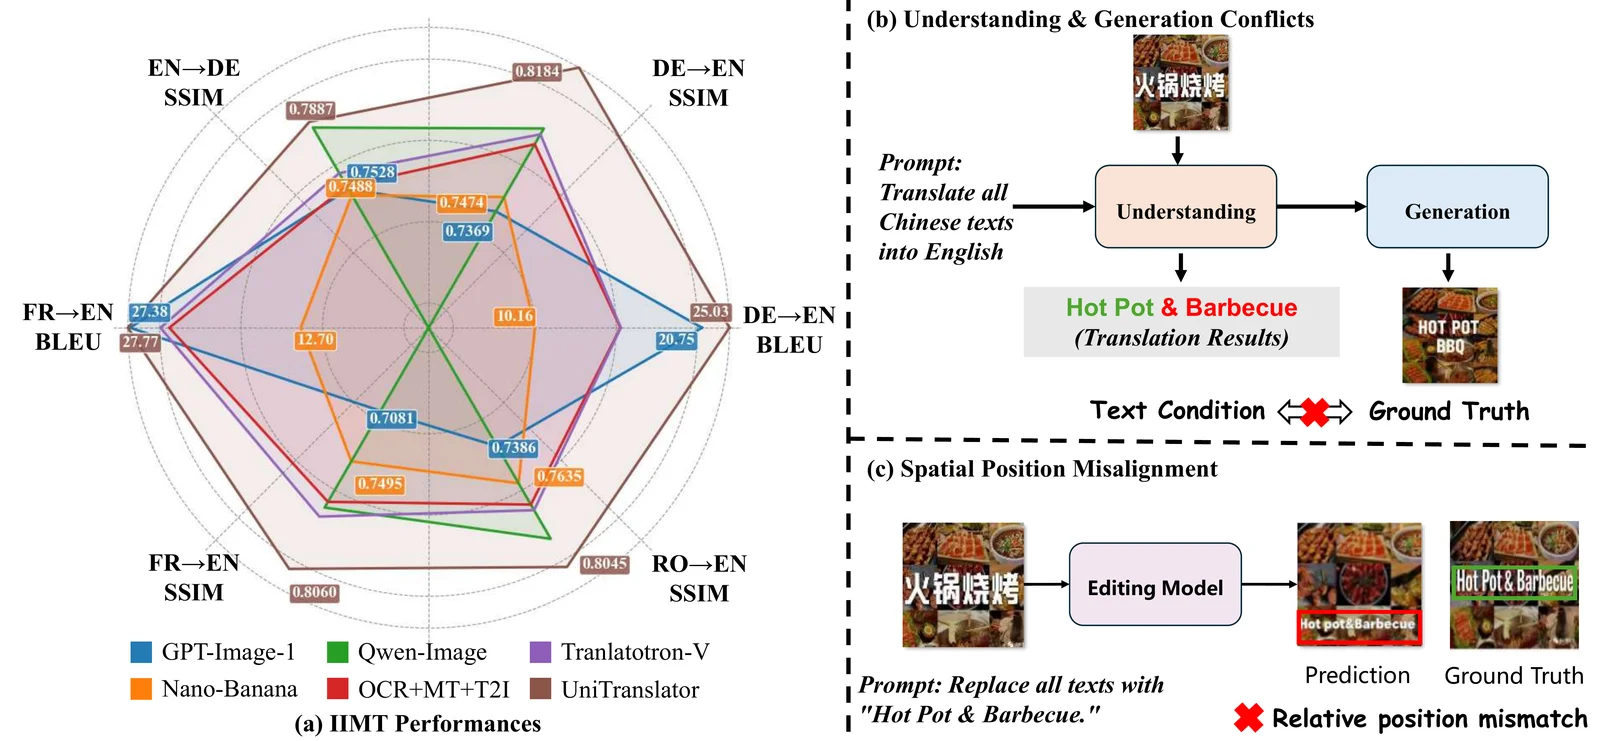
现有系统大多沿用级联式 OCR–机器翻译–文字编辑流水线,虽高效但易跨阶段累积误差。近期统一多模态模型(UMM)将视觉理解与图像生成整合进单一预训练框架,为 IIMT 提供了新范式。然而,直接把这类模型迁移到 IIMT 仍面临两大核心障碍:
- 理解-生成冲突(Understanding-Generation Conflict)。 同一源文本可以有多种合法译法,理解分支预测出的译文可能语义正确,却与标注图像中的文字不同,导致两个分支收到相互矛盾的训练信号。
- 空间位置错位(Spatial Position Misalignment)。 扩散模型天然偏好全局一致性,易改动原始背景纹理、破坏文字区域的刚性空间布局,即便译文内容正确,也常被放到错误的位置或排布。
核心方法:UGAM + SMD 双管齐下
UniTranslator 将翻译理解与视觉文字编辑紧耦合在单一框架内,通过两个专用模块分别对症化解上述瓶颈。
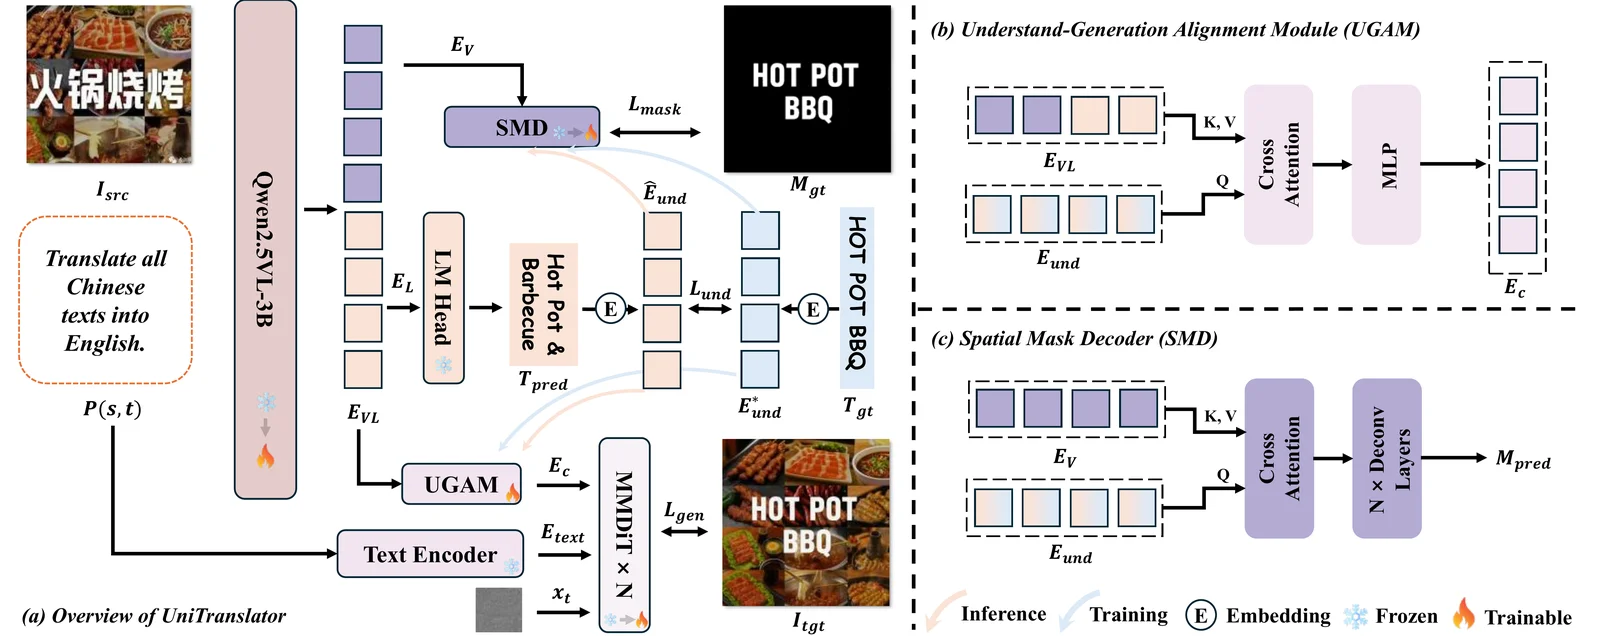
- 理解-生成对齐模块(UGAM)。 以理解表征为 Query、多模态表征为 Key/Value,经交叉注意力与 MLP 生成对齐的条件嵌入特征。这个模块能够更好地告诉生成分支语义翻译如何对齐到视觉空间,在表征层面缓解语义-像素监督的冲突。
- 空间掩码解码器(SMD)。 以视觉表征为 Key/Value、理解表征为 Query,通过交叉注意力注入翻译语义后解码出目标文字区域掩码,并用 BCE + Dice 损失进行像素级监督,显著提升空间定位、几何对齐与版式可控性。
- 两阶段训练。 Stage 1 冻结主干,仅训练 UGAM,建立稳定的理解-生成接口;Stage 2 联合微调 Qwen2.5-VL 的 LoRA、UGAM、SMD 与 MMDiT 投影层,完成更准确的翻译文字生成。
实验:多基准全面领先
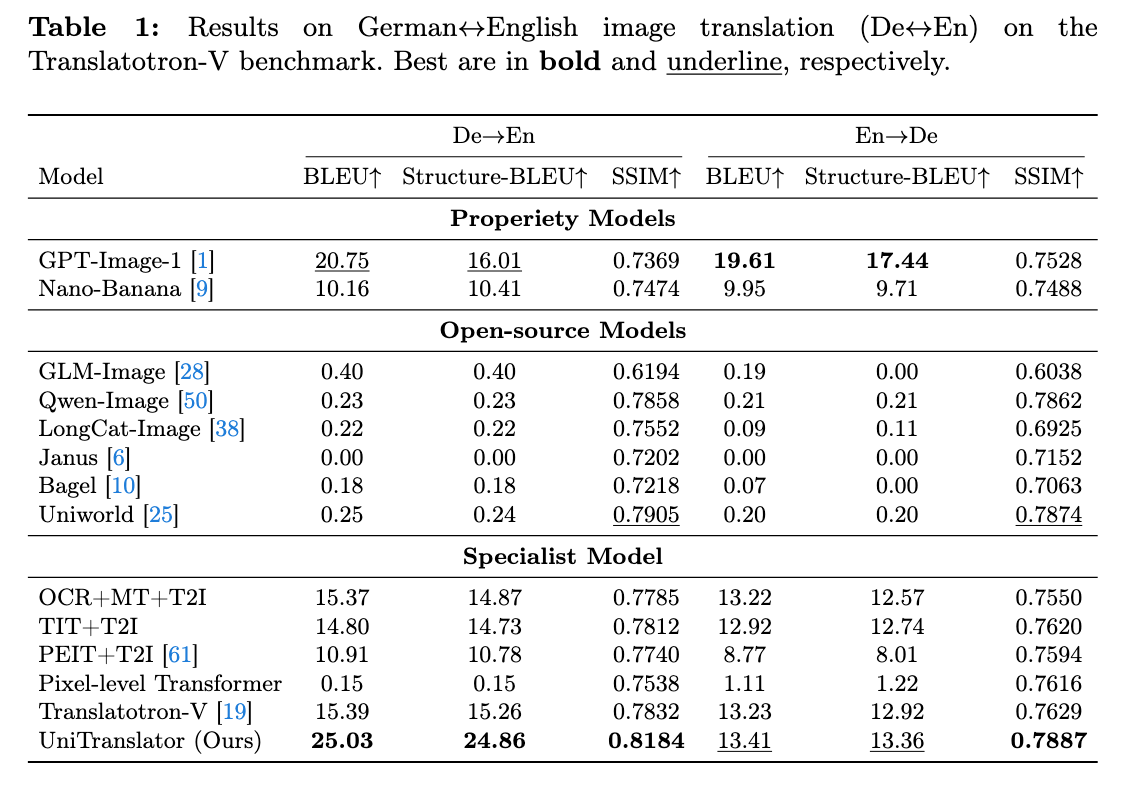
Translatotron-V(ision)。 在 De↔En、Fr→En、Ro→En 四个子任务上,开源统一多模态模型零样本表现普遍很差,而 UniTranslator 全面取得最优。在 De→En 上 BLEU 达 25.03、SSIM 达 0.8184,大幅领先 GPT-Image-1、Translatotron-V 等。
IIMT30k(真实场景)。 在真实照片背景的实例级基准上,UniTranslator 在 De→En 与 En→De 的翻译质量(BLEU/COMET)与视觉质量(FID)上均取得最优,FID 优势尤为明显,说明其更适应杂乱背景与复杂纹理的真实编辑场景。
PRIM(多语种)。 在覆盖 5 个翻译方向的大规模多语种基准上,UniTranslator 在端到端模型中取得最佳平均性能,BLEU/COMET 最强、FID 最低。
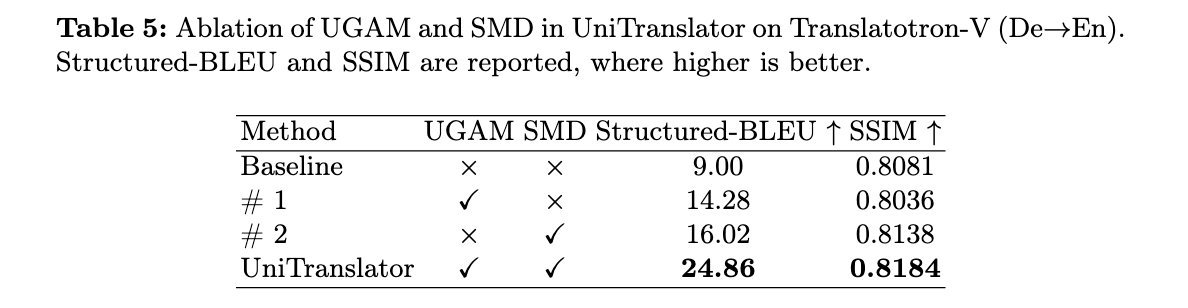
模块消融。 UGAM 主要提升翻译质量,SMD 同时改善结构感知翻译与图像保真度,二者结合带来大幅增益,验证了“语义一致性 + 空间精度”的互补性。
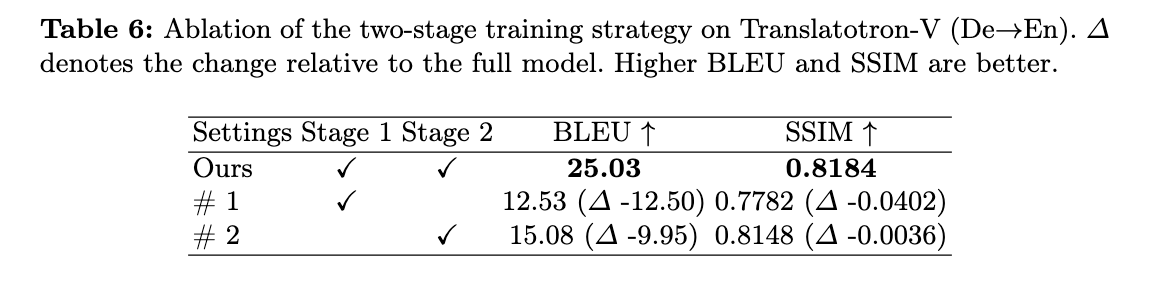
训练策略消融。 仅 Stage 1 或仅 Stage 2 都远逊于完整两阶段训练,证明 Stage 1 建立跨模态条件桥梁、Stage 2 完成端到端适配,缺一不可。
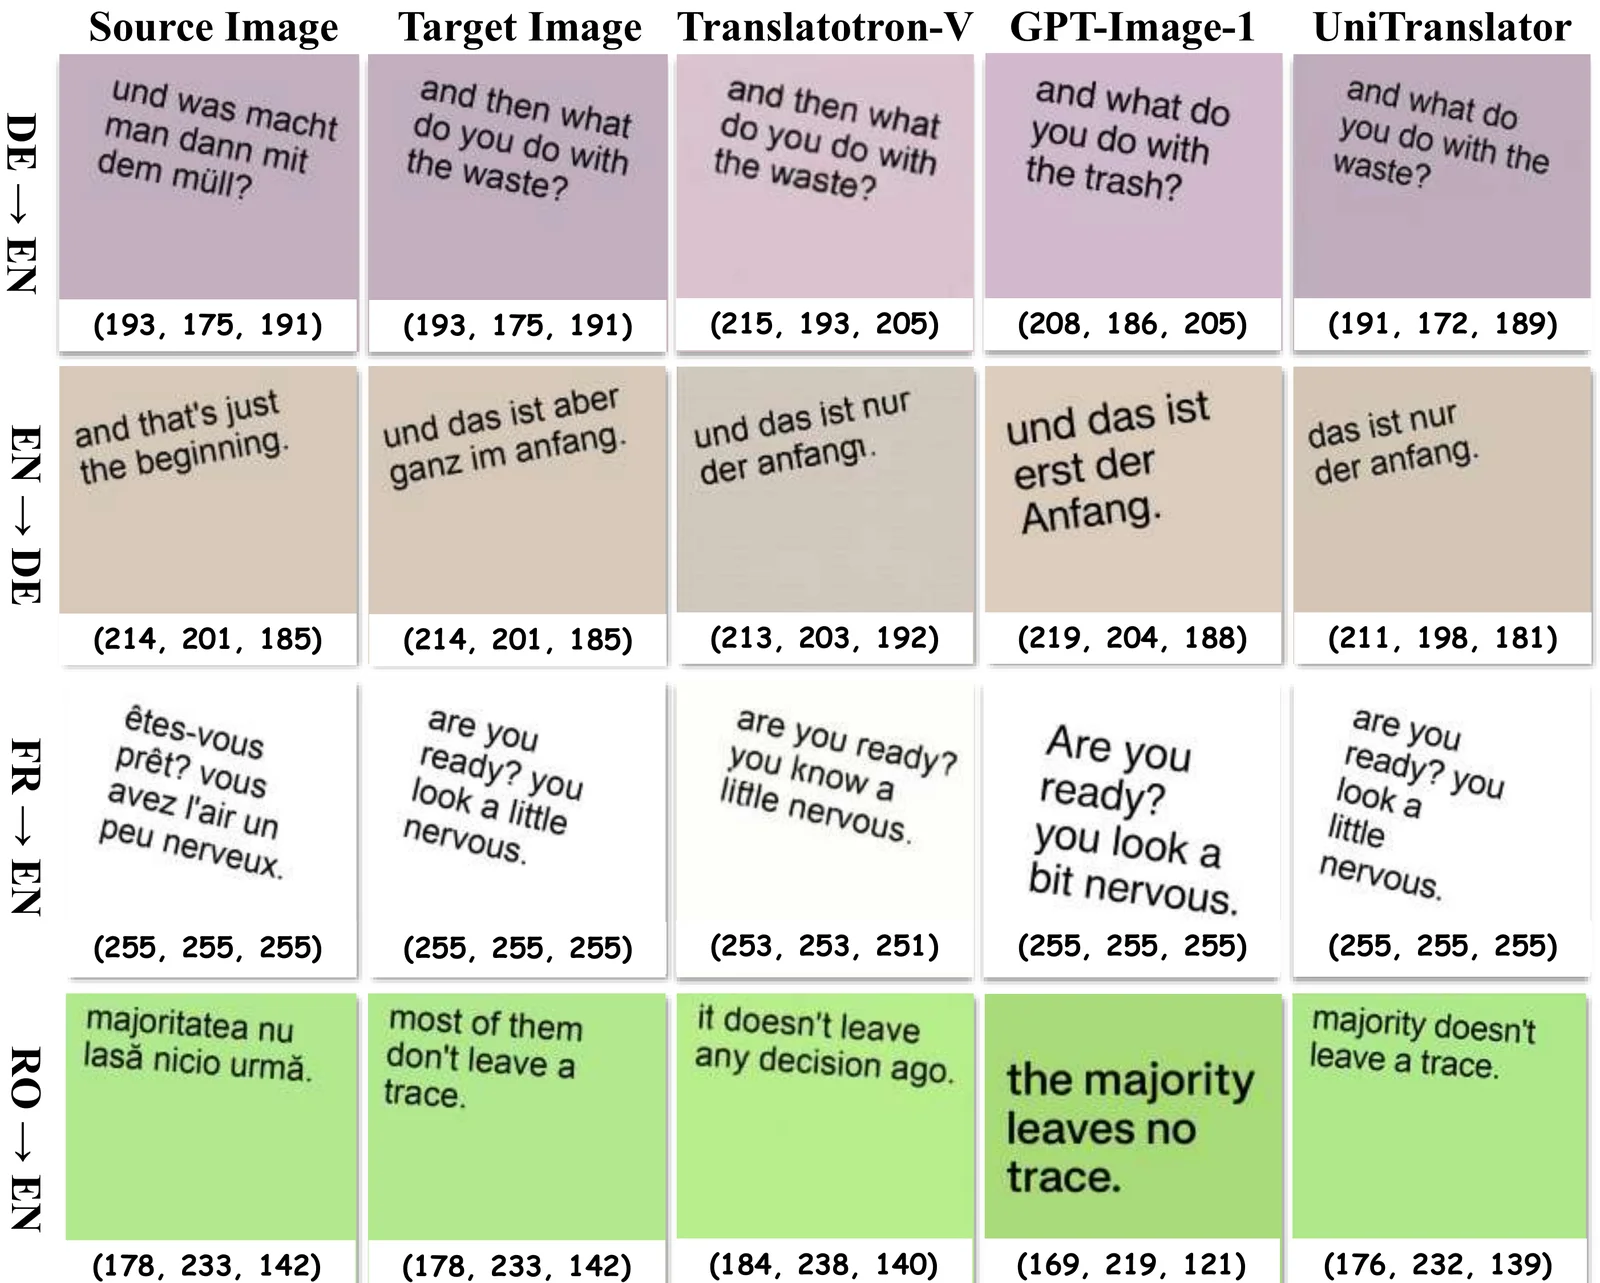
定性可视化。 在 Translatotron-V 的四个子任务上,UniTranslator 在翻译正确性、版式保持与源图忠实渲染之间取得了出色平衡:相比 Translatotron-V 更一致地保留背景色与整体外观;相比 GPT-Image-1,则在空间一致性上更优,译文更准确地对齐原始位置与布局。
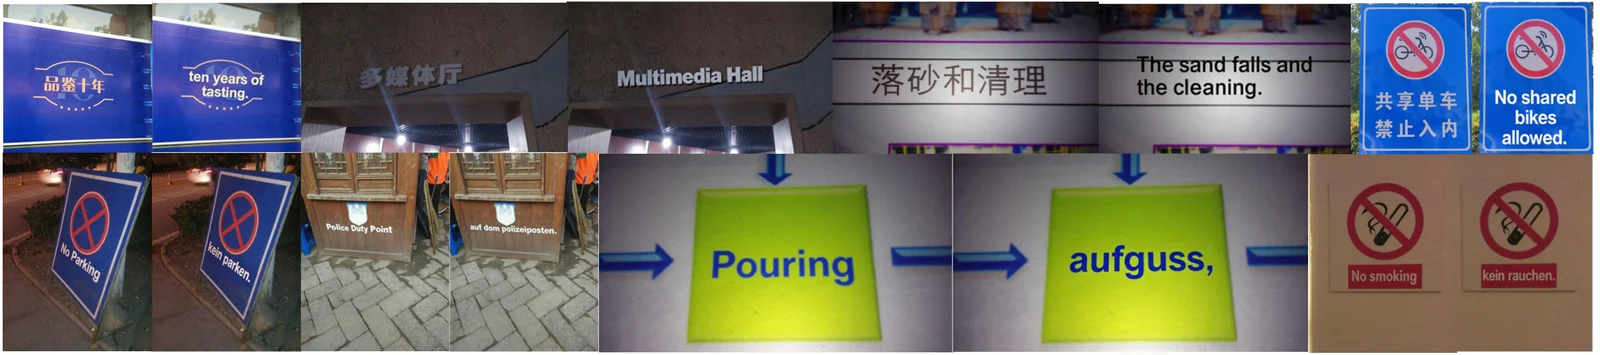
这一优势同样迁移到 AnyTrans 数据集上的零样本推理,在中译英、英译德方向都保持了稳健表现。
关键发现:理解与生成的“双向互增益”
论文最有价值的洞察在于:翻译理解与图像生成并非简单的主辅关系,而是相互强化的闭环。
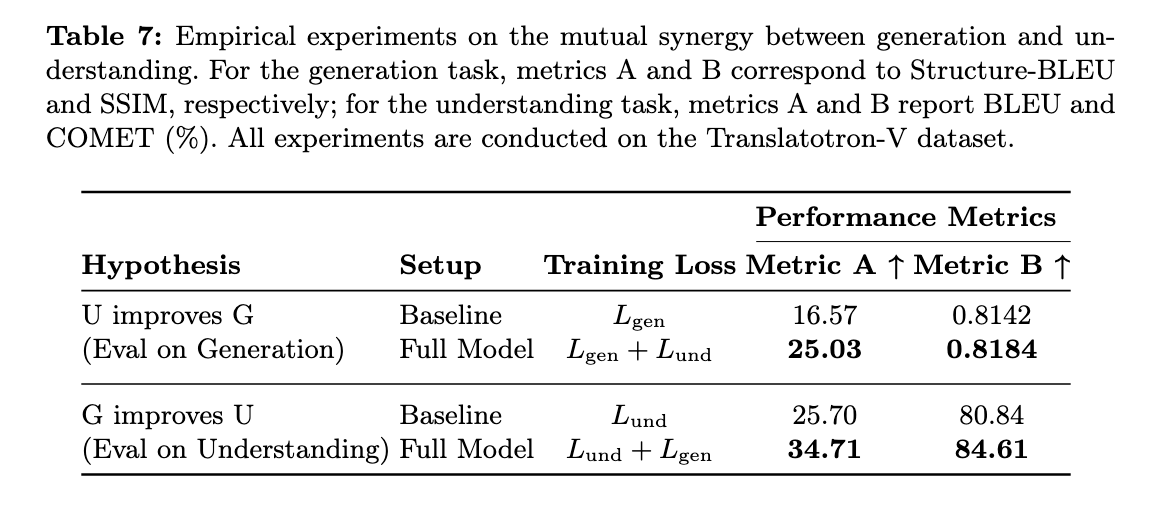
- 理解促进生成(U→G)。 加入理解损失后,Structure-BLEU 与 SSIM 一致提升,说明语言侧监督为文字渲染提供了更强的语义条件。
- 生成促进理解(G→U)。 联合生成损失后,BLEU 与 COMET 双双提升,说明生成目标通过鼓励视觉接地的表征,反过来增强了翻译理解能力。
- 这一发现有力支撑了核心设计理念:IIMT 应被建模为统一的“理解-生成”问题,而非级联的流水线。
价值与展望
UniTranslator 从表征对齐与空间监督两个层面,系统性化解了统一多模态模型在图内机器翻译中的理解-生成冲突与空间错位问题,并揭示了理解与生成之间的双向互增益效应。它在多语言方向与复杂真实场景下都展现出强泛化能力,为图像内机器翻译任务提供了新范式。