前言
作者:周星星(星仔)
原文:https://zhuanlan.zhihu.com/p/2095863677282996988
大家好,我是星仔。这篇我们聊 OPD(On-Policy Distillation)。
2025 年 10 月,Thinking Machines Lab 在同名博客里展示了它降低后训练成本的潜力。更早的 Qwen3 报告:从同一个 Qwen3-8B 起点出发,OPD 用约十分之一的追加 GPU 小时,取得了比 RL 更高的数学、代码等评测分数。DeepSeek-V4 和 MiMo-V2-Flash 把OPD用于专家合版:先把各领域教师练强,再将能力蒸进同一个学生。
相对于传统 SFT 蒸馏,OPD 缓解了训推不一致。 SFT 蒸馏让学生接着教师答案往下写,使用时却要接着自己的输出。OPD 让学生自己生成,再由教师提供指导,训练时就能处理自己实际会遇到的情况。相对于只按最终结果打分的 RLVR,白盒 OPD 提供了更稠密的监督。
比如,学生先写一段代码;训练时,教师根据题目和各位置之前的代码,给出下一 token 的概率分布,学生据此更新参数。这里的“白盒”,就是能拿到教师的 token 概率。这些信号也可以接入 RL 更新。在教师指导有效时,OPD 有机会用较少的训练更新改善任务表现,因此也值得在持续学习中尝试。
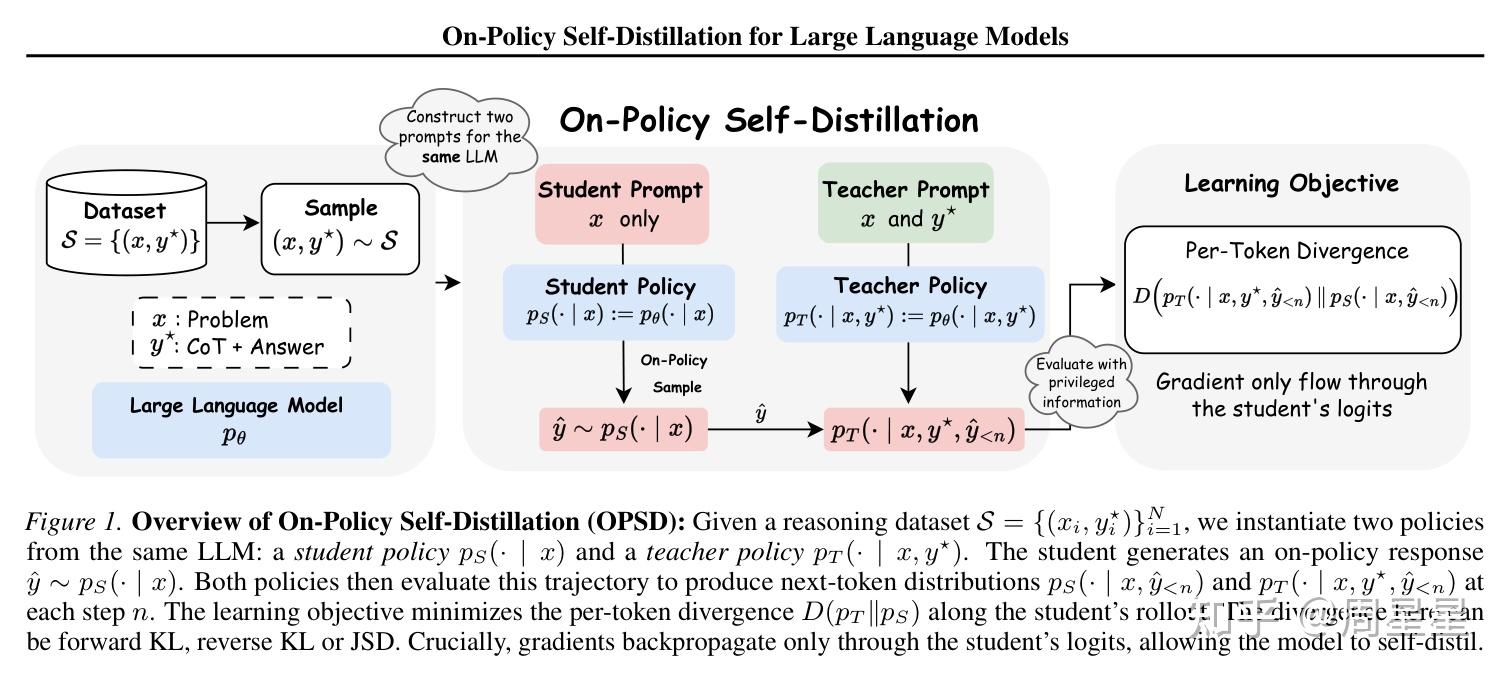
教师也可以是多看了信息的自己,这是自蒸馏。 比如,学生只看题目写代码;训练时,把参考答案或失败单测加入同一模型的提示词,让它充当教师。学生根据“题目+自己的前文”生成,教师则根据“题目+额外信息+同一段学生前文”提供概率指导。
目标是把这些指导学进参数,让学生以后只看题目时也能受益。如果拿不到教师概率,也可以把教师的指导转成 RL 奖励,这是黑盒蒸馏。 例如,让教师对照参考解法和学生回答,列出“结果是否正确、是否处理边界情况”等评分项,再由评估模型逐项打分,汇总成奖励,用 RL 更新学生。
无论教师是谁、提供的是概率还是文本,只要由当前学生模型自己生成回答(on-policy),再利用教师信号更新学生,都可以归入本文讨论的广义 OPD。
这篇就从白盒蒸馏讲起,再看自蒸馏和黑盒蒸馏,最后谈 OPD 训练的本质。
OPD,一篇就够了。
01. 白盒 OPD:从训练原理到工业实践
白盒 OPD 的训练从学生自己生成的回答开始。教师在这些回答的各个前缀上计算下一 token 的概率,学生再利用师生的概率差异更新参数。
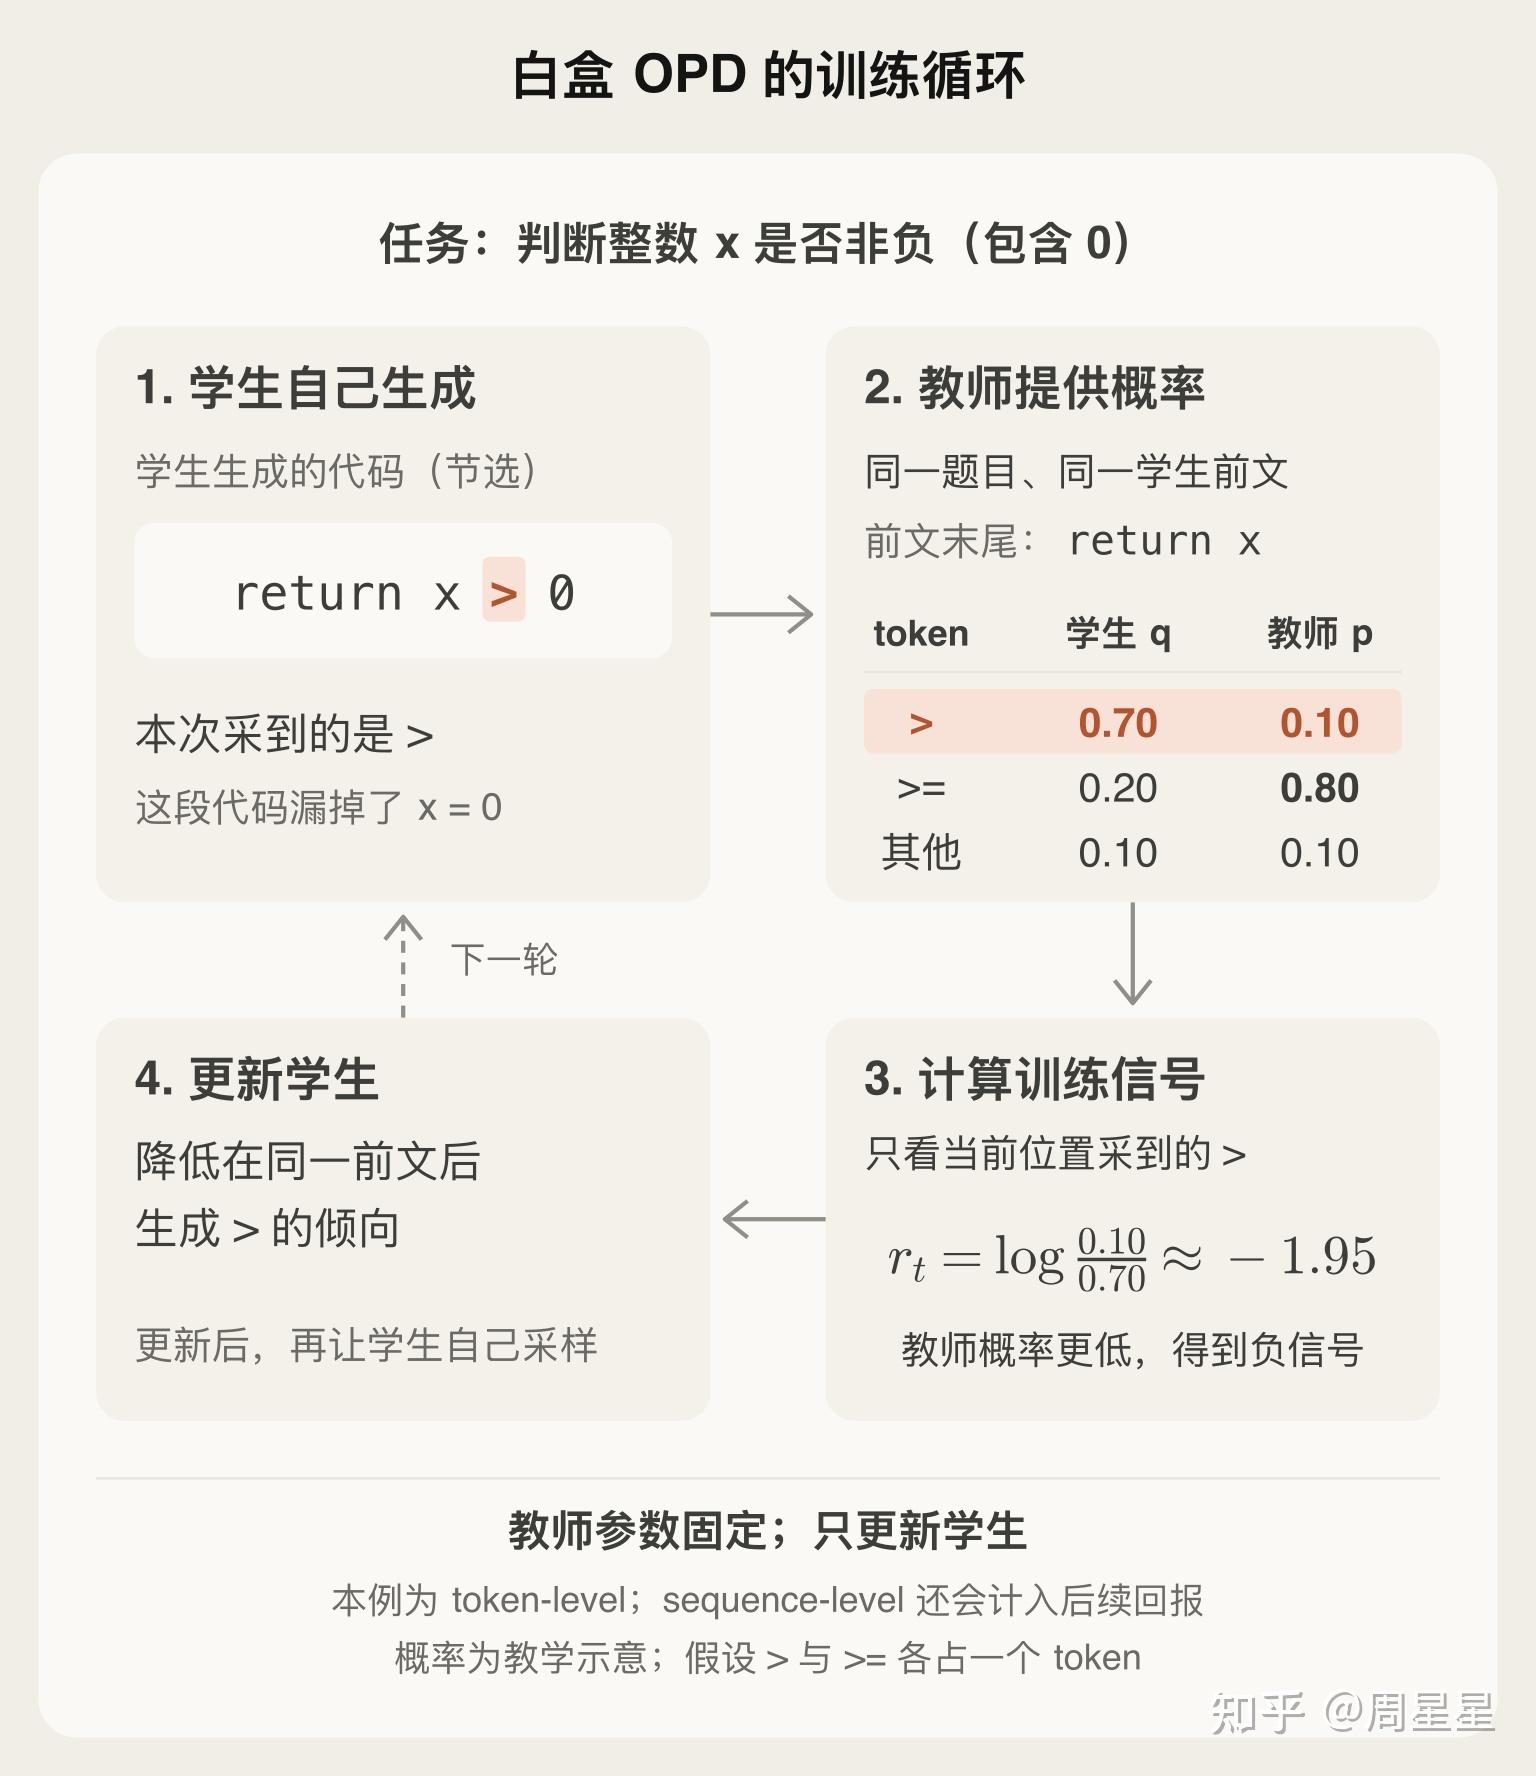
先从整句目标推导梯度,再看只用当前 token 的近似,最后说明两种训练实现。
从整句 reverse KL 推导 sequence-level 更新
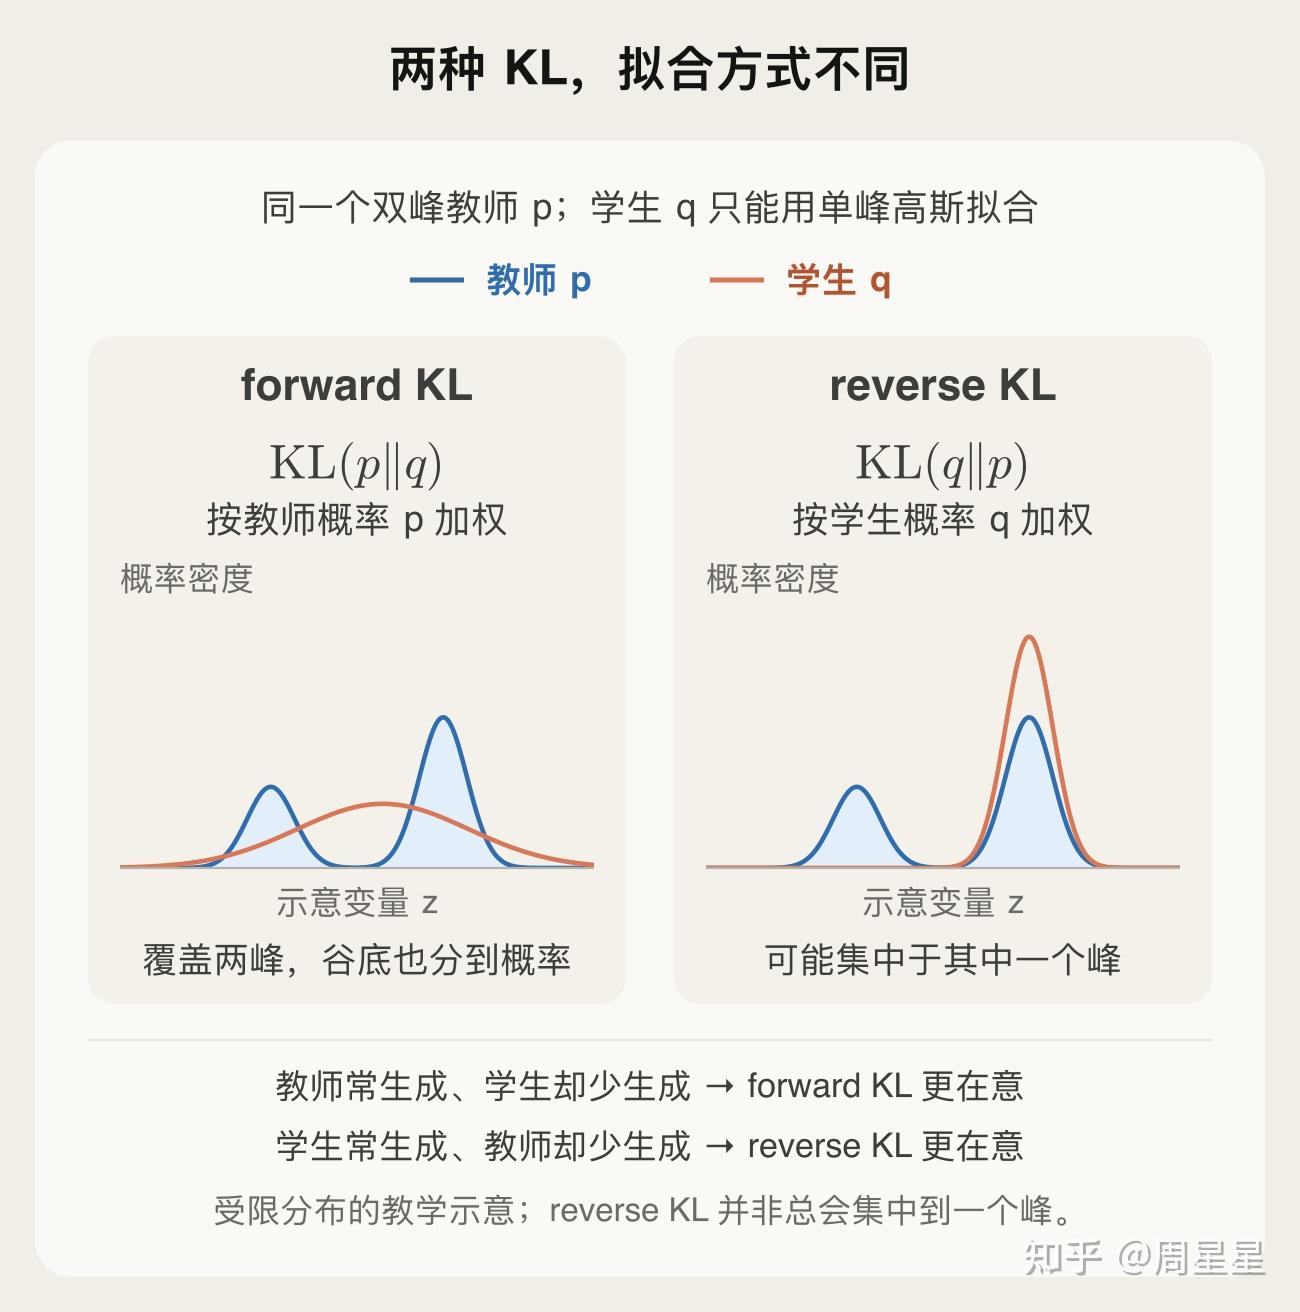
设教师为固定分布 p,学生为 q_\theta。这一节使用 reverse KL:它按学生的概率加权,重点惩罚学生经常生成、教师却很少生成的内容。forward KL 则按教师的概率加权,更强调覆盖教师的分布。
固定输入 x,将学生生成的回答记为 y=(y_1,\ldots,y_T),第 t 步的前缀记为 s_t=(x,y_{<t})。为方便推导,统一最大生成长度,遇到 EOS 后的贡献记为零。整句 reverse KL 目标是:
根据自回归分解,
定义每个位置的教师信号:
教师给这个 token 的概率比学生高,r_t 为正;反之为负。这里的信号衡量师生的概率差异。
整句目标因此可以写成:
目标虽然拆成了逐 token 求和,梯度仍然包含跨位置的影响。回答由学生自己采样,参数变化不仅改变当前 token 的概率,也改变后续会访问哪些前缀。
对 J 求导时,外面的采样概率和里面的 logprob 都要求导。再利用 \nabla_\theta q_\theta=q_\theta\nabla_\theta\log q_\theta,可以写成采样期望:
其中,常数 1 对应的项在期望下为零:
再把整句 logprob 和教师信号展开:
这里还可以去掉第 t 步之前的信号。对于 k<t,r_k 在前缀 s_t 确定后已经固定,而当前动作的 logprob 梯度满足:
因此,过去的 r_k 与当前 logprob 梯度相乘,期望贡献为零。最终得到:
这就是整句 reverse KL 对应的 sequence-level 策略梯度(policy gradient,PG):用当前及之后的教师信号构造 R_t,再用它更新第 t 个 token。这里的 sequence-level 指后续信号会影响前面的选择;教师监督本身仍然逐 token 提供。
这个推导对应 MiniLLM §2.2 与附录 A.2。论文保留了 R_t-1 的写法;常数项的期望梯度为零,所以与上式具有相同的梯度期望。
为什么使用 token-level 近似
sequence-level 用后续累积回报更新前面的选择。难点在于:我们想知道一个选择的后续表现平均怎么样,单条轨迹却只告诉我们这一次怎么样。
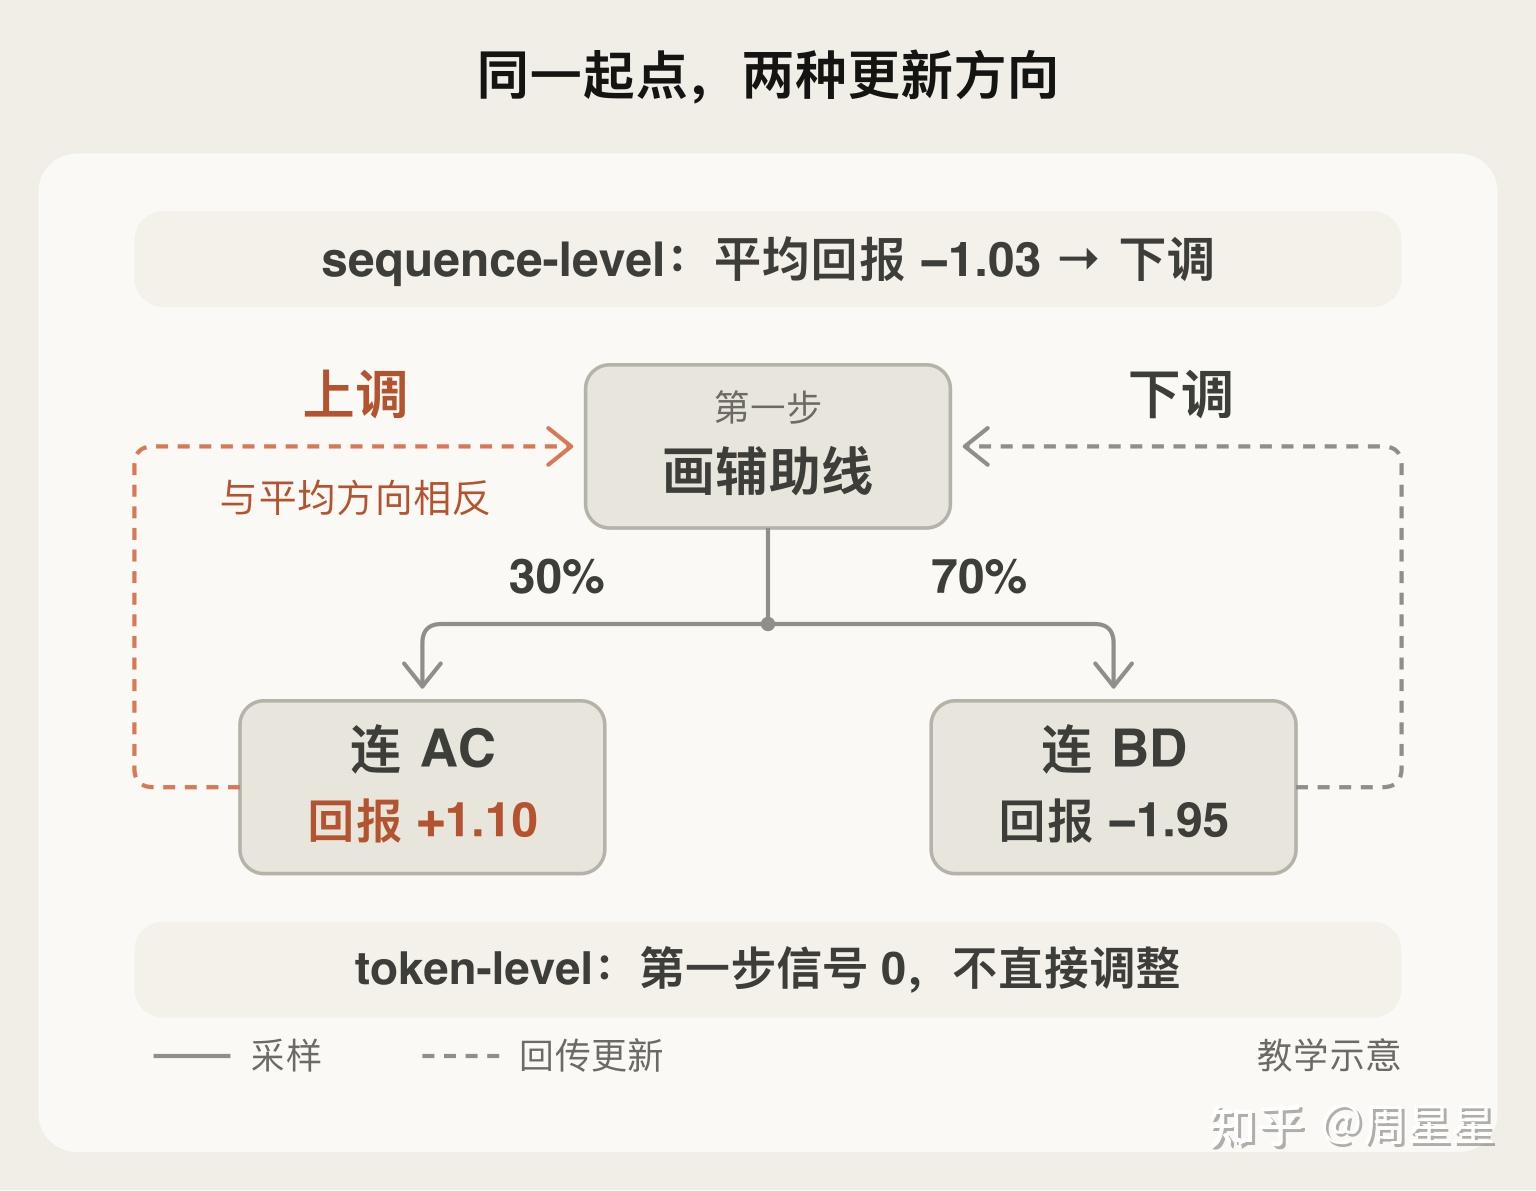
用一个简化的两步几何题例子来看。把每次决策当作一个 token,并先假设两步的概率由不同参数控制。第一步可以“列方程”或“画辅助线”,师生都各给 0.5,因此第一步的局部信号为 0。列方程之后,假设师生的下一步分布相同;画辅助线之后,则有两种连法:
| 第二步 | 教师概率 | 学生概率 | 教师信号 |
|---|---|---|---|
| 连 AC | 0.9 | 0.3 | 约 +1.10 |
| 连 BD | 0.1 | 0.7 | 约 −1.95 |
先看平均应该往哪边更新。 画辅助线后,学生有 30% 的概率采到 AC、70% 的概率采到 BD,平均后续回报约为 −1.03;列方程之后则为 0。因此,在这组参数下,sequence-level 的平均梯度会减少画辅助线、增加列方程。这个判断反映当前学生沿两条路线续写时,与教师分布的匹配程度,不是在给两种几何解法判对错。
但只采一条轨迹时,第一步可能收到相反的更新。 假设本次选择了画辅助线,随后恰好采到 AC,后续回报就是 +1.10,更新反而会增加画辅助线的概率,与平均方向相反;若采到 BD,回报为 −1.95,才会沿平均方向降低它。一次偶然采到的高分续写,就可能让前面的选择被过度强化。
这就是后续采样带来的方差。按当前学生采样、使用上面的完整梯度估计时,固定同一组参数反复采样,梯度估计的期望仍与真实梯度一致;无偏不保证每条样本的方向都正确。序列越长,前面的位置通常会累积更多后续随机信号,单条轨迹的估计可能更不稳定,但不能说长度越长,统计偏差就越大。
token-level 的近似,是把已生成的前缀当作固定输入,只优化当前位置的师生分布差异。按一条学生轨迹估计梯度时,就是把后续累积回报 R_t 换成当前信号 r_t:
在这个例子里,第一步的局部信号为 0,token-level 不会因 AC/BD 的采样结果直接调整第一步,第二步仍然会更新。它去掉了后续采样对第一步的直接干扰,也省略了长程信息:固定这组参数,无论重复采样多少次,第一步的直接更新都是零,而完整目标的平均梯度希望减少画辅助线。
这个期望上的差异,就是省略长程项带来的偏差,所以它一般不是整句 reverse KL 梯度的无偏估计。真实模型共享参数,第二步的参数更新仍可能间接影响第一步。
局部梯度怎么算:sampled-token、全词表与 Top-K
上一节讨论要不要计入后续回报。这一节固定已生成的前缀,只比较当前位置的梯度,是用一个采样 token 估计,还是把所有候选的贡献算出来。
这里要分清两个层次:sampled-token 可以无偏估计当前位置的梯度,但 token-level 更新仍然省略了整句目标中的长程项。 “局部无偏”和“对整句目标有偏”并不矛盾。
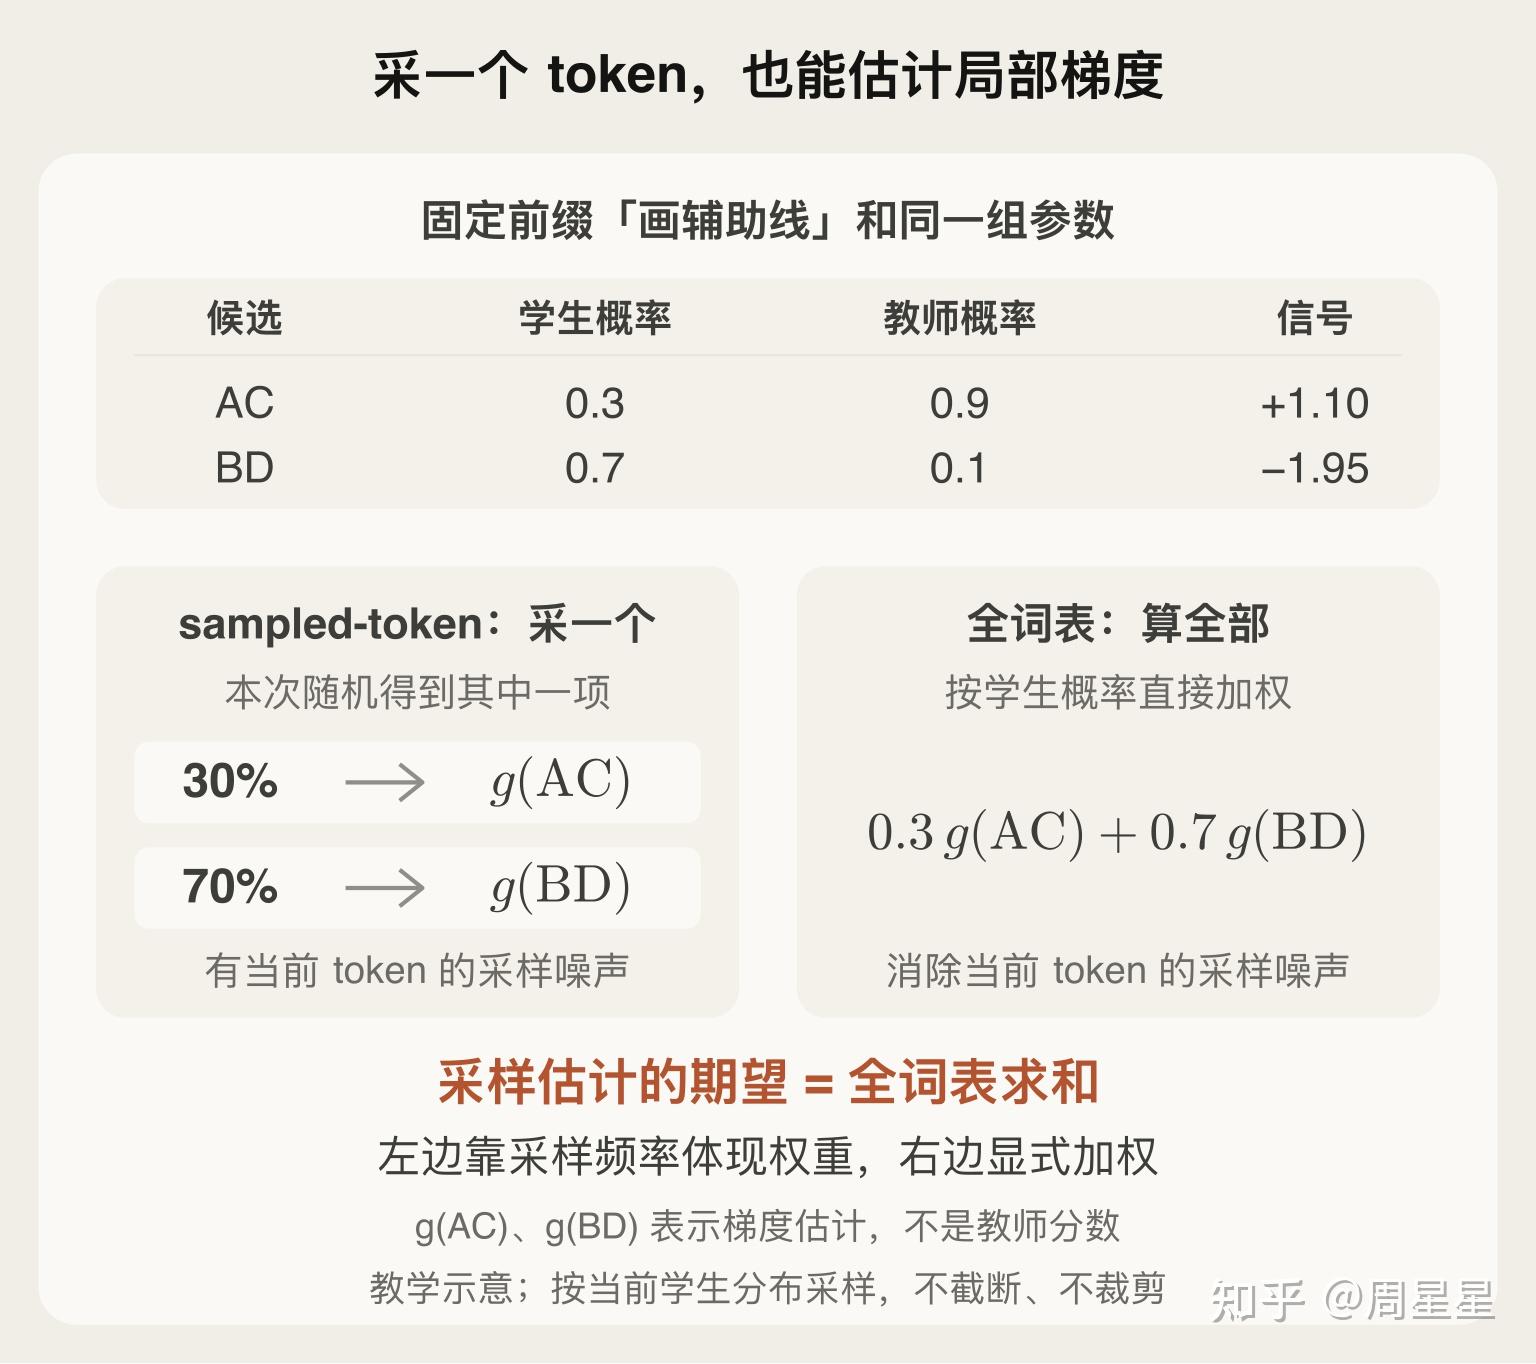
仍以“画辅助线”之后的 AC/BD 为例。固定前缀和参数,学生有 30% 的概率采到 AC、70% 的概率采到 BD。
sampled-token:每次用一个采样结果估计梯度。 采到 AC,就用它的教师信号 +1.10 构造梯度;采到 BD,就用它的信号 −1.95 构造梯度。一次只取其中一项,但在反复独立采样时,两项出现的频率会趋近 30%/70%。
全词表:一次加总所有候选的梯度贡献。 在这个只有两个候选的例子里,它把 AC、BD 对应的梯度分别乘以 0.3、0.7,再相加。sampled-token 通过采样频率体现权重,全词表则显式加权,因此两者的梯度期望相同。被平均的是梯度贡献,而不只是 +1.10、−1.95 这两个分数。
下面把这个关系写成公式。用 V 表示完整词表,固定前缀 s 后,局部 reverse KL 是:
对学生参数求导,利用 \sum_v q_\theta(v\mid s)=1 消去常数项,得到:
其中 r(v,s)=\log p(v\mid s)-\log q_\theta(v\mid s)。从当前学生分布采样 y_t,只取对应的一项:
按照学生分布取期望,就恢复了上面的完整求和:
这里不用再额外乘一次 q_\theta(y_t\mid s),权重已经体现在该 token 被采到的概率中。实现时,r 作为固定权重使用;stop-gradient 写法在下一节展开。
全词表则直接计算 K_\theta(s) 并反向传播,学生的概率权重 q_\theta 和 \log q_\theta 都参与求导,教师分布固定。固定前缀和参数后,它精确计算局部梯度,消除了“当前 token 恰好采到谁”的随机性。 这一项的方差降为零;整体训练仍有前缀采样、batch 选择等随机性。上面的无偏关系要求按当前学生分布采样,且不额外截断或裁剪。
sampled-token 每个位置只需教师返回一个 logprob,监督数据的传输与存储很小。全词表一次用上所有候选,代价是更大的分布存储、传输和 KL 计算开销。返回的数据少,不代表教师前向计算也能按相同比例减少。
Top-K/Top-p:全词表太贵时,只保留一部分候选。 这里讨论的是计算 loss 时保留哪些 token;学生生成回答时是否使用 Top-p,是另一项独立设置。
Top-K 保留概率最高的固定数量候选;Top-p 保留按概率从高到低累加、直到达到阈值的候选。选出集合 S 后,再让教师和学生在同一组 token上比较。
集合由谁决定,也有取舍:教师选集保留教师认可的主要候选,但可能漏掉学生经常生成、教师不认可的词;学生选集覆盖学生的主要行为,但可能漏掉教师希望学生学会的新候选。取两者的并集或补入当前采样词可以增加覆盖,代价是更大的集合。
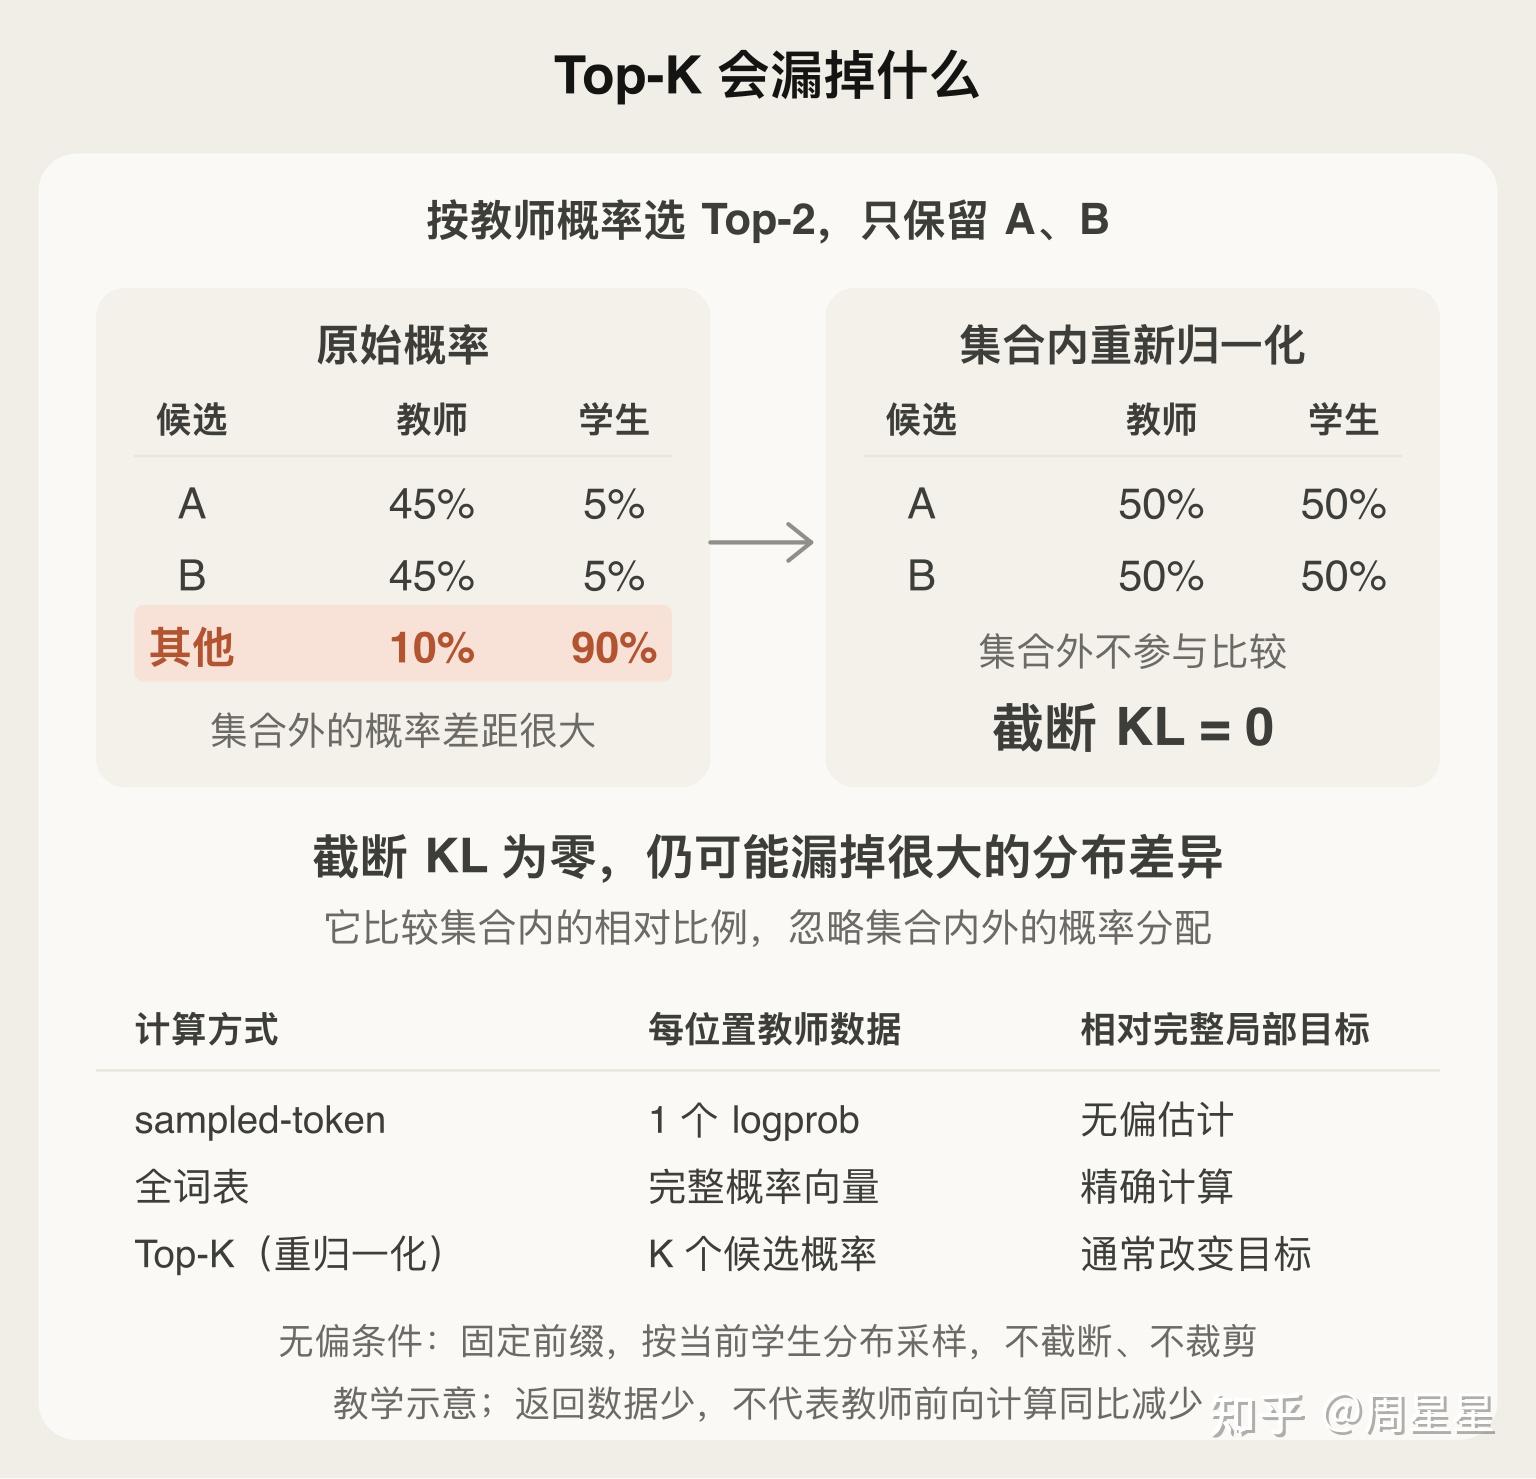
一种常见做法,是把集合内的概率重新归一化后再计算 KL。它只比较集合内部的相对比例,会忽略集合本身占了多少概率。 看一个教学例子:按教师概率选 Top-2,保留 A、B。
| 候选 | 教师概率 | 学生概率 |
|---|---|---|
| A | 45% | 5% |
| B | 45% | 5% |
| 其他候选合计 | 10% | 90% |
只看 A、B,教师的 45%/45% 和学生的 5%/5% 都会被归一化成 50%/50%,截断 KL 为零。但学生有 90% 的概率生成集合外的词,教师只有 10%;这个差异被截断目标忽略了。
对本次选定的集合 S,上述做法写成:
然后优化:
重归一化后的截断 KL 通常已经改变了局部目标。 即使保留原概率、只对集合 S 求和,也会漏掉集合外的贡献。要无偏估计完整局部梯度,就要补足尾部贡献,例如加入尾部采样并按采样概率校正。补入当前采样词或扩大 Top-K,本身不足以保证无偏。
训练怎么实现:PPO 风格更新与直接分布优化
用 PPO 风格实现 OPD,主要是为了复用成熟的 RL 基础设施和更新算法。 已有PPO的RL训练系统,例如 verl 通常已经支持学生生成回答、记录 logprob、分布式训练,以及同批数据的多轮更新。接入 OPD 时,可以让教师信号充当更新权重,沿用这些能力。
先看 PPO 的策略更新 loss。记生成本批回答的学生为 q_{\mathrm{old}}=q_{\theta_{\mathrm{old}}},正在更新的学生为 q_\theta,A_t 是每个 token 的优势值(advantage):
其中 q_\theta/q_{\mathrm{old}} 是新旧学生的概率比,\epsilon 控制裁剪幅度。PPO 通常用任务奖励和价值估计构造 A_t,再通过这个代理目标抑制过大的更新。PPO 论文 §3、§5
接入 OPD 时,这个策略 loss 可以保持不变,只把其中的 A_t 换成教师信号:
这里的当前信号 r_t 和累计回报 R_t,都用采样时的学生 q_{\mathrm{old}} 计算。\mathrm{sg} 表示 stop-gradient:权重固定,梯度从学生概率回传;也可以从累计回报中减去只依赖前缀的 baseline。
因此,同一个 PPO loss 既能做 token-level,也能做 sequence-level。 用 r_t 只看当前位置,用 R_t 就让后续信号影响前面的选择;两种情况下,概率比仍然逐 token 计算。
PPO 也可以使用 sampled-token 或全词表。 对局部信号,sampled-token 只用采到的词估计更新;全词表则给每个候选计算权重和概率比,分别裁剪后,按旧学生概率加权求和。
后者消除了固定前缀下当前 token 的采样噪声,但需要取得和处理完整词表的概率。若还要为每个候选计算长程权重,就需要额外的分支采样或价值估计;当前位置的全词表概率不能直接提供未来回报。
另一条路线是直接优化分布 loss。 学生先生成回答,固定这些回答的前缀,再直接计算师生分布的差异:
教师分布固定,学生通过当前分布直接求导,不经过 advantage 和概率比接口。D 可以是 reverse KL、forward KL、JSD,或明确的截断目标。这个 loss 本身只提供局部梯度;若要保留整句目标的长程项,还需补上相应的策略梯度。
在同一固定前缀上,使用局部 reverse KL 权重且 \theta=\theta_{\mathrm{old}} 时,上述 PPO 梯度的期望与直接完整词表 reverse KL 的梯度一致。后续更新会受到旧权重和裁剪的影响,通常不再等价。
MiniLLM 和 GKD:方法设计与取舍
《MiniLLM: On-Policy Distillation of Large Language Models》 · 2023-06-14
《On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes》(GKD)· 2023-06-23
MiniLLM 保留当前选择对后续生成的影响,GKD 直接优化固定前缀下的师生分布。下面看两篇论文具体怎么做,数值例子均用于说明机制。
MiniLLM:保留长程项,再控制采样和更新的波动
MiniLLM 从整句 reverse KL 出发,先做单步分解:当前项在固定前缀上计算全词表 reverse KL 的梯度,长程项用采样到的后续回报做策略梯度。当前信号 r_t 已由前一项处理,因此后一项从下一步开始,使用 R_{t+1}。这样既减少了当前项的采样方差,也保留了“这一步会把后续生成带向哪里”的影响。论文 §2.2–2.3还用以下设计处理采样和更新中的问题。
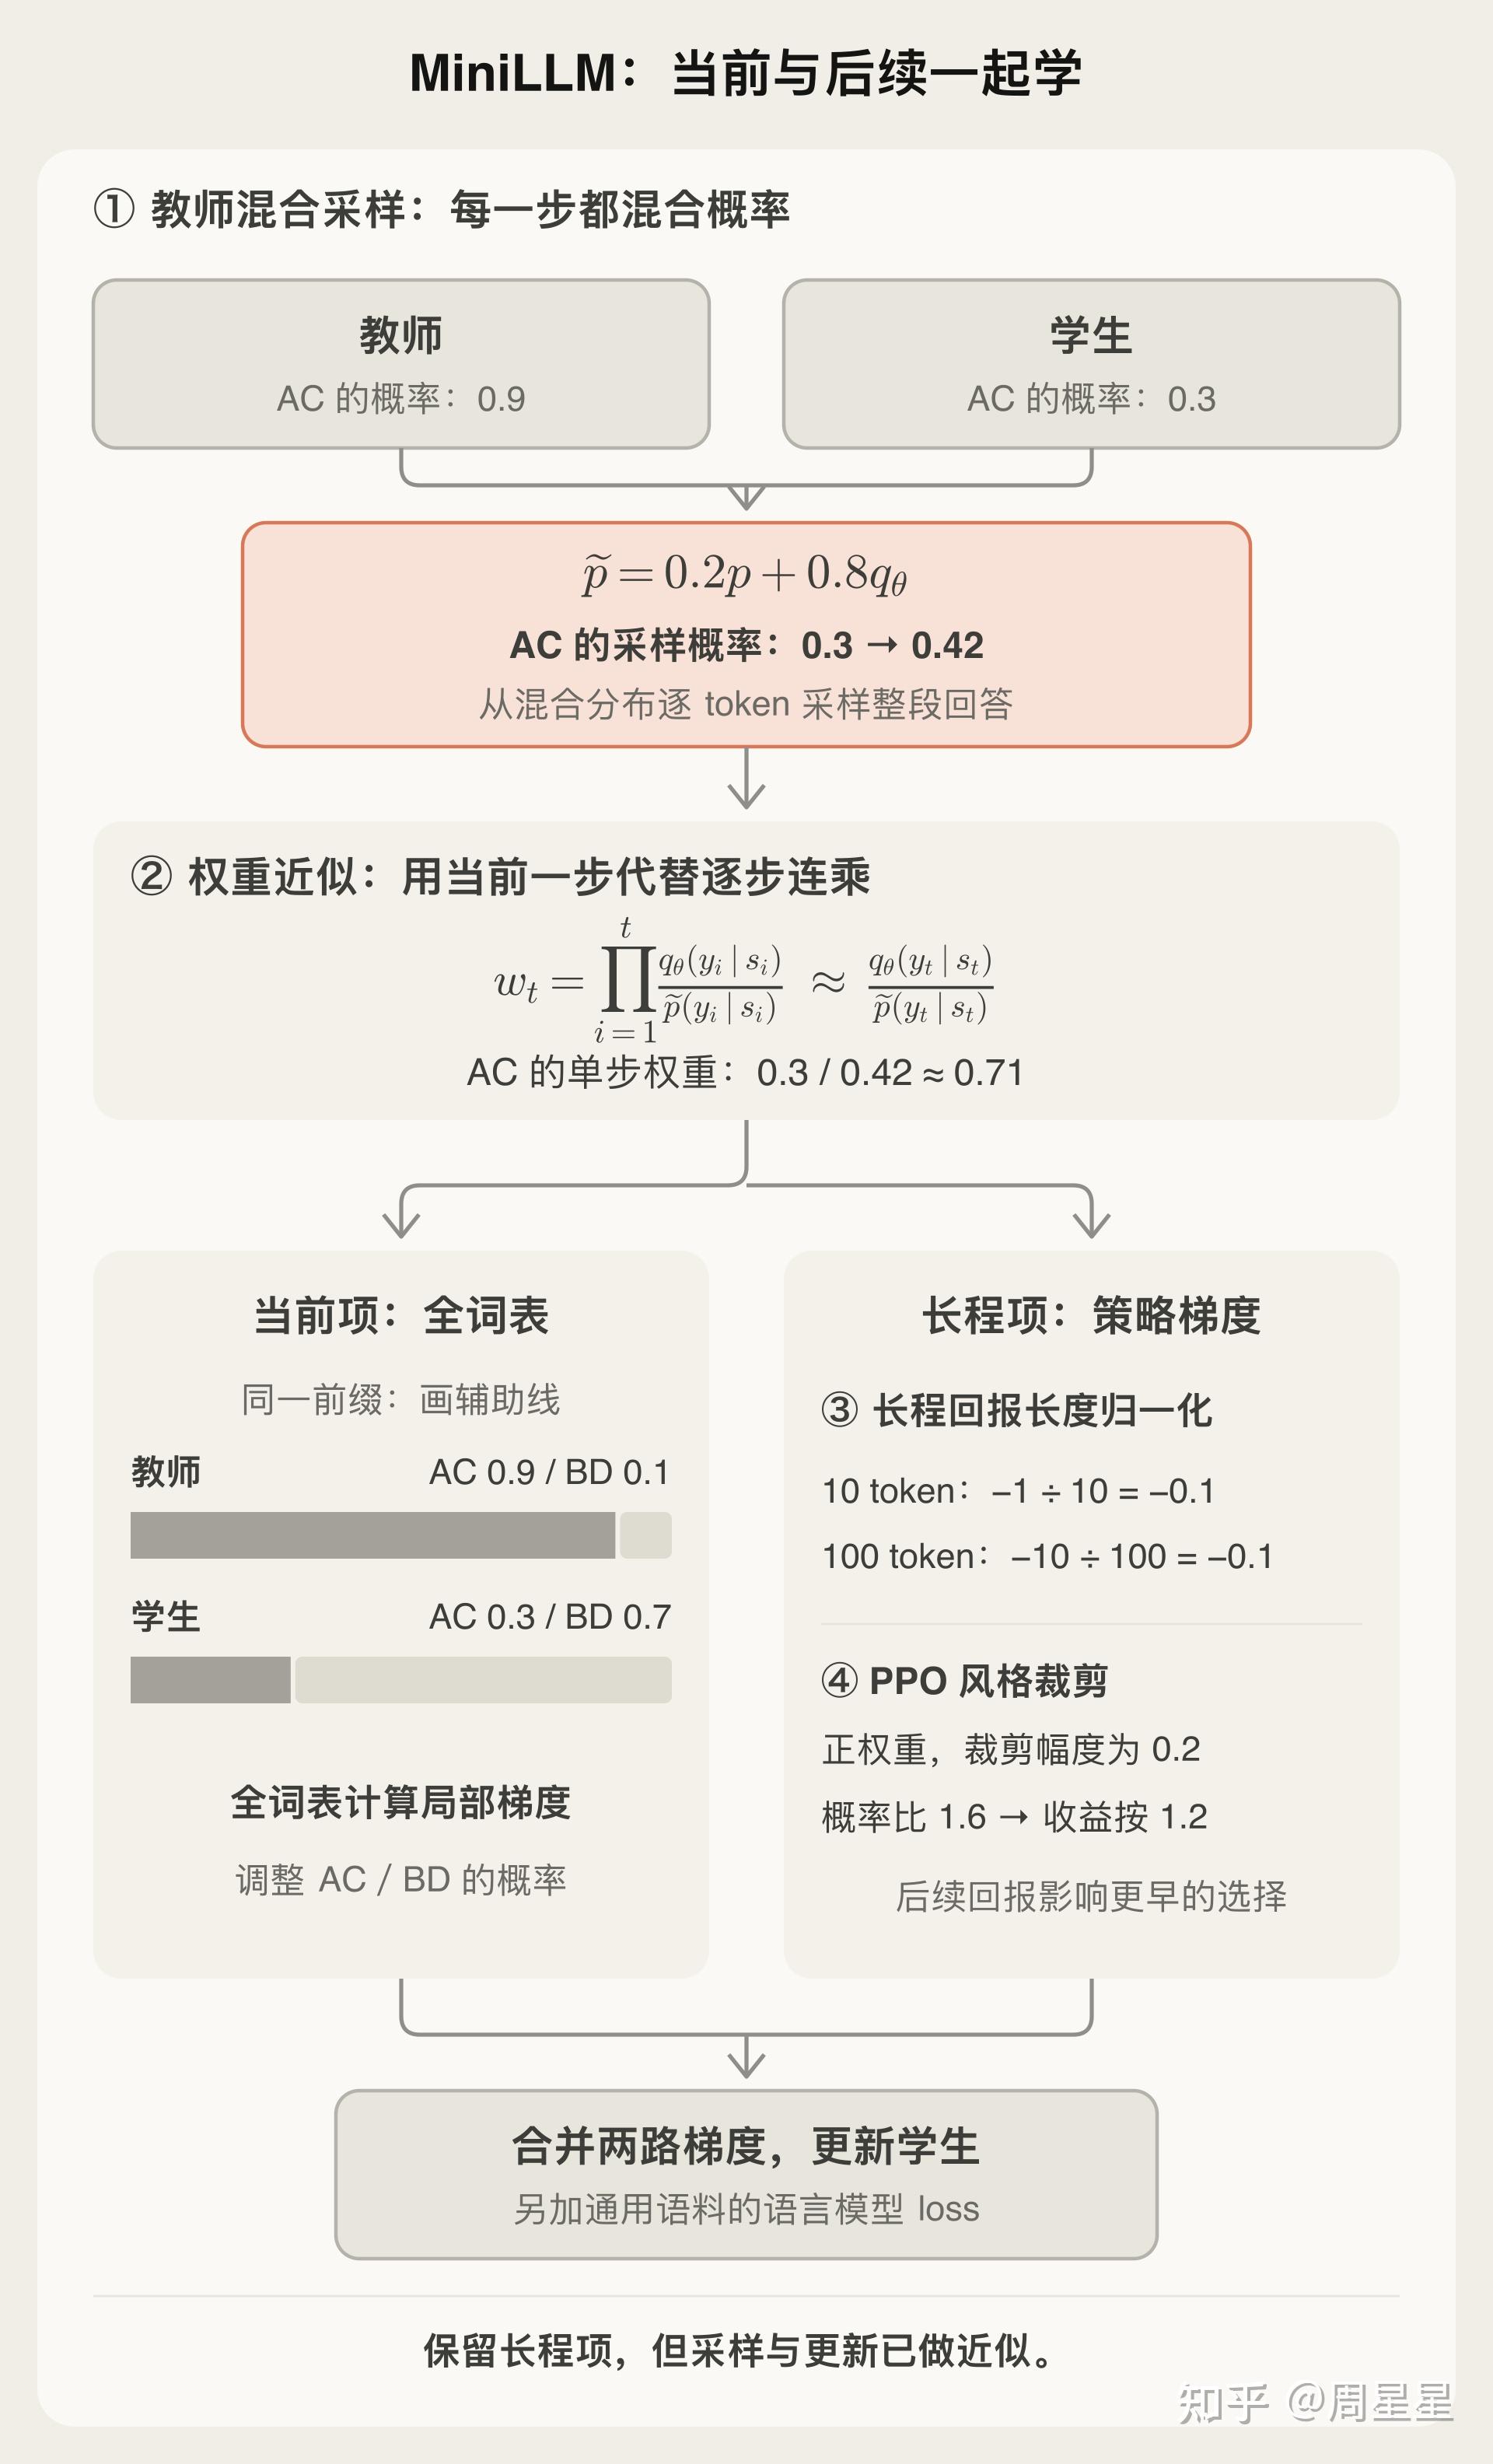
1. 教师混合采样:减少退化生成。
学生独自采样时,可能反复重复某句话,却仍获得较好的蒸馏分数。MiniLLM 在每个位置混合师生概率,再采样下一个 token:\tilde p=\alpha p+(1-\alpha)q_\theta。例如,教师给 AC 的概率为 0.9,学生给 0.3,取 \alpha=0.2,AC 的采样概率便提高到 0.42,让教师更认可的分支更容易出现。
2. 重要性权重近似:校正采样变化,同时控制权重波动。
采样改用了混合分布,目标仍以学生分布为准,因此需要概率比校正。上例中,AC 被多采了,它的单步权重就是 0.3/0.42\approx0.71,将这部分贡献调小。论文先写出沿前缀连乘的概率比,再近似为当前一步的 q_\theta/\tilde p。这样避免了多个比值连乘造成的剧烈波动,代价是引入偏差。
3. 长程回报长度归一化:减轻提早结束的倾向。
假设每个后续 token 的信号都是 −0.1,续写 10 个 token 的累计回报是 −1,续写 100 个则是 −10;模型可能仅因续写更长而受到更大惩罚。MiniLLM 按剩余生成长度归一化长程回报,改看平均信号,上例两者都约为 −0.1。它削弱了长度偏好,也改变了原先按总和计算的回报。
4. PPO 风格裁剪:抑制过度更新。
复用一批样本更新时,MiniLLM 对策略梯度项使用裁剪。按官方实现的 _pg_loss,概率比分母是采样时固定的混合分布。例如,正向更新权重下,概率比升到 1.6、裁剪上限为 1.2,这一项就不再奖励继续提高该 token 的概率。这里限制的是 loss 中的收益,并非把模型概率强行截断。
训练先用 SFT 初始化学生;蒸馏阶段还加入通用语料的语言模型 loss,以维持通用能力。单步分解本身不改变梯度,但后续的权重近似、回报归一化和裁剪,使实际更新不再是原始整句 reverse KL 梯度的无偏估计。
GKD:选定训练前缀,再学习教师分布
GKD(Generalized Knowledge Distillation,广义知识蒸馏)对应直接分布优化路线。纯学生自采时,先让学生生成一批回答,再固定这些回答的前缀,在每个位置比较师生的完整词表分布。先对每条回答内的 token 散度取平均,再对 batch 取平均,只更新学生;下一轮用更新后的学生重新生成回答。
例如,学生生成了“画辅助线 → 连 BD”。在“画辅助线”这个前缀上,教师对 AC/BD 的概率是 (0.9,\,0.1),学生是 (0.3,\,0.7)。即使这次采到了 BD,比较完整分布仍能推动学生提高 AC 的概率。学生回答决定在哪些前缀上学,教师分布决定学什么。
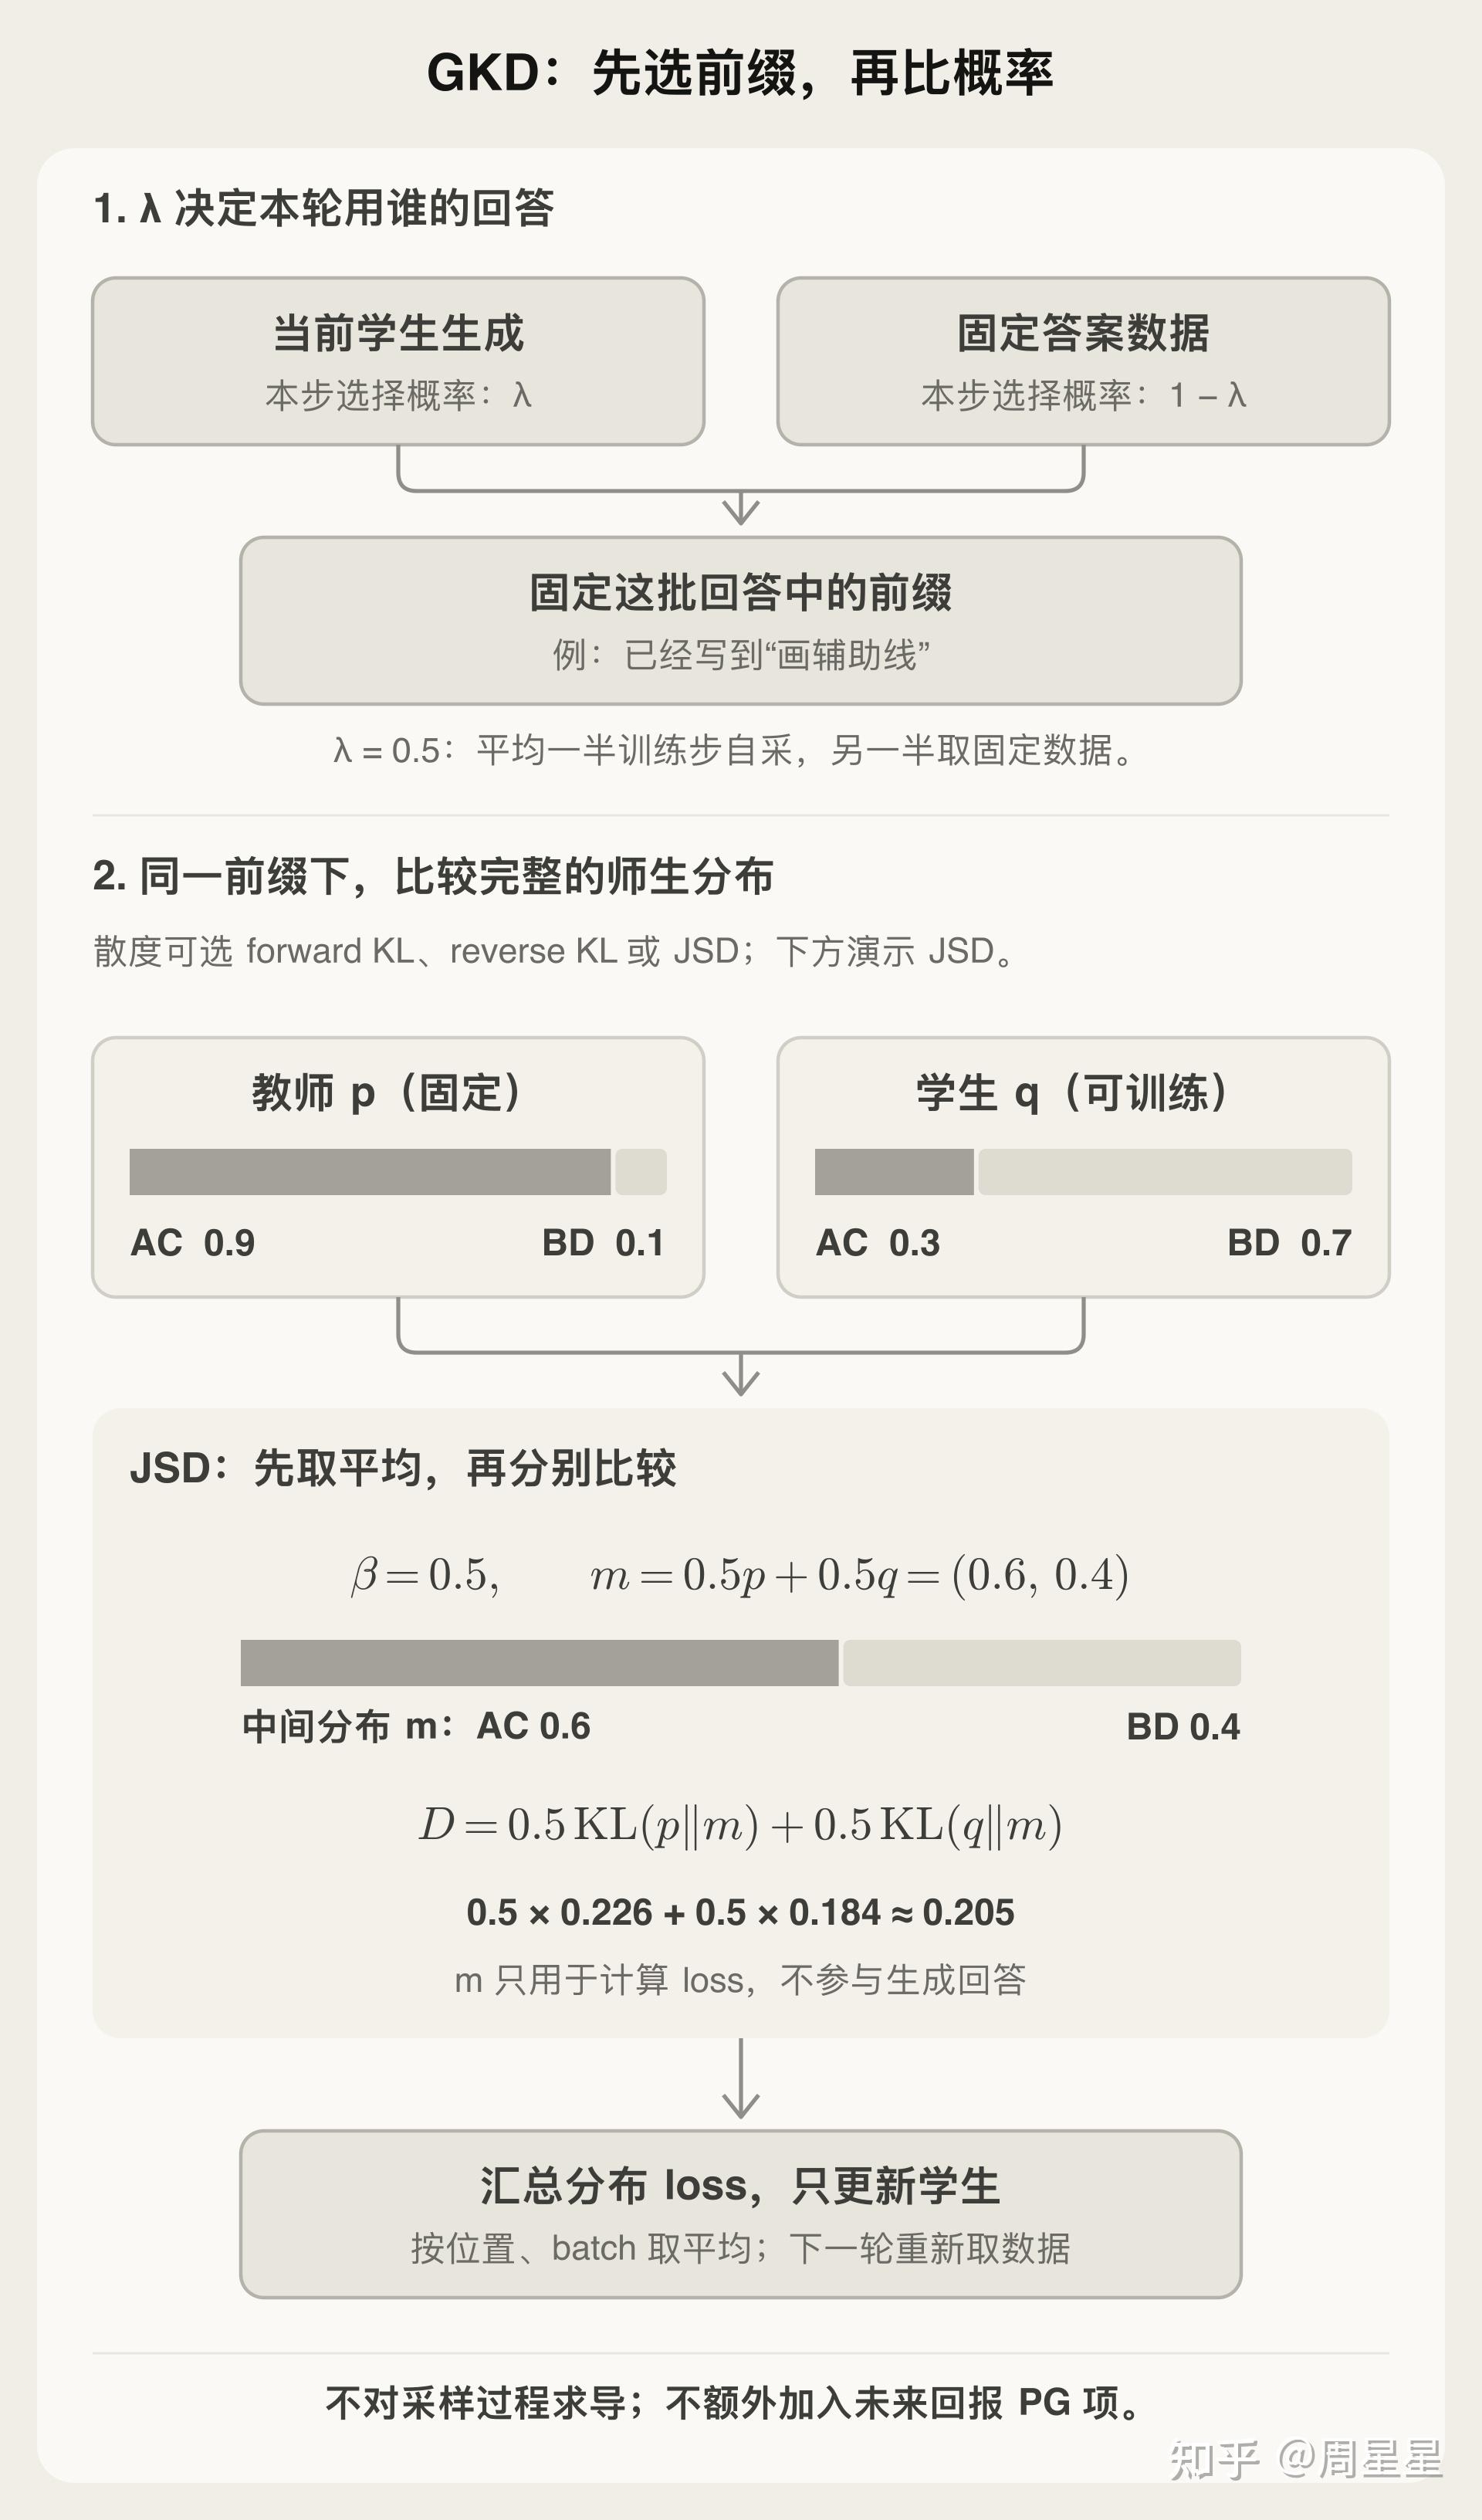
论文 §3.1把两个选择交给训练者:
1. 用哪些回答训练:由 \lambda 控制。
2. 怎样衡量分布差异:选择 forward KL、reverse KL 或 JSD。
学生容量不足以完整拟合教师时,forward KL 更强调覆盖教师认可的选择,reverse KL 更倾向集中在其中一些选择。JSD(Jensen–Shannon 散度)提供可调的折中。
论文 §2使用广义 JSD:先把教师分布 p 和学生分布 q_\theta 加权平均,得到中间分布 m_\beta,再分别计算两者到它的 KL:
取 \beta=0.5,上面的 AC/BD 分布得到 m=(0.6,\,0.4)。JSD 就是师生各自到这个中间分布的 KL 的平均;两者完全一致时,loss 为 0。中间分布不用于采样回答,JSD 也不是直接把 forward KL 和 reverse KL 加权相加。忽略整体尺度后,\beta 接近 0 时,梯度行为接近 forward KL;接近 1 时,接近 reverse KL。
我的判断是:这些技巧要按问题选用,超参和实现复杂度也要算进方法成本。 我倾向于先跑通简单基线,再针对明确问题逐项加入机制,用对照实验确认收益。如果一点提升需要反复调参才能维持,额外的试验和维护成本就可能抵消它的价值。
基模厂商怎么用 OPD:多教师合版与小模型蒸馏
从 MiMo、DeepSeek 和 Qwen 的报告中,可以看到基模工业界 OPD 的两种用法:把不同领域专家的能力教给同一个学生,以及把大size模型学的能力蒸馏到小size的模型中。
多教师合版:让同一个学生学会不同老师的专长。
MiMo-V2-Flash 的流程是:SFT 打底 → 分领域训练专家 → 多教师 OPD(MOPD)合版。数学题找数学老师,代码题找代码老师。学生自己生成回答,对应的领域老师在这些前缀上提供下一 token 的概率。所谓“合版”,就是通过这样的训练,把不同老师的专长集中到同一个学生中。
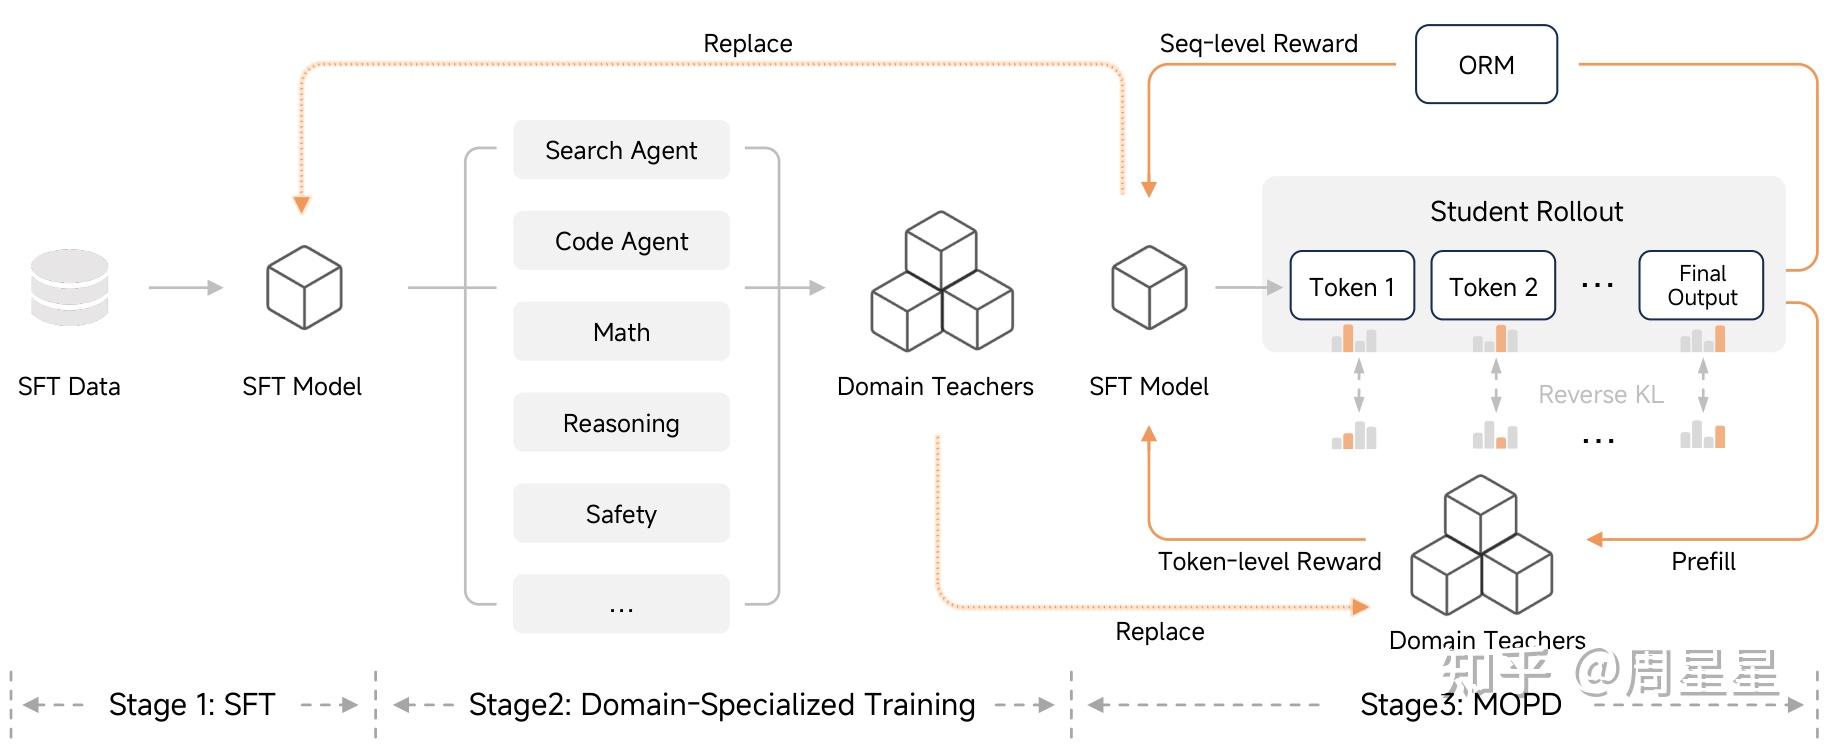
MiMo 还把教师指导与结果奖励结合起来。报告 §4.4在同一个优势值里,加入当前 token 的教师信号和整条回答的结果优势,再用于策略梯度更新:
其中,p_x 是题目对应的领域教师,\hat A_{\mathrm{ORM}} 是由结果评分算出的整条回答优势,\alpha 控制后者的权重,\mathrm{sg} 表示不对括号内的权重求导。例如,代码整体没过单测,某些局部 token 仍可能得到正的教师信号。两路信号共同决定更新;教师项只看当前 token,不累加后续教师回报。
DeepSeek-V4 也先训练领域专家,再用 OPD 合版。它选择计算全词表 reverse KL,以减少当前位置的 token 采样噪声。
但多个老师的完整 logits 很占空间,因此报告 §5.2.2做了几项配套设计:教师权重按需加载;只缓存最后一层隐藏表示,训练时再用输出层还原 logits;用专门的算子计算 KL。这也说明,选择全词表后,还得解决教师加载、数据缓存和 KL 计算的开销。
小模型蒸馏:先用教师答案打底,再做 OPD。
Qwen3 §4.5对小模型分两步训练:先用教师在思考、非思考模式下生成的答案做 off-policy 蒸馏,让学生学会基本推理和模式切换;随后由学生自己生成回答,在这些前缀上对齐强教师的概率分布、最小化 KL。这样,各个小模型可以复用强教师已经学到的能力。
报告 Table 21还给出了训练成本对照:从同一个完成 off-policy 蒸馏的 Qwen3-8B 模型出发,分别用 RL 和 OPD 训练数学、代码能力:
| 后续训练路线 | AIME’24 | AIME’25 | LiveCodeBench v5 | 追加 GPU 小时 |
|---|---|---|---|---|
| 起点:off-policy 蒸馏后 | 55.0 | 42.8 | 42.0 | — |
| 继续做 RL | 67.6 | 55.5 | 52.9 | 17,920 |
| 改做 on-policy 蒸馏 | 74.4 | 65.5 | 60.3 | 1,800 |
在这组数学、代码实验里,OPD 用约十分之一的追加 GPU 小时,取得了更高分数。这里比较的是已有强教师、同一起点之后的学生训练成本,教师此前的训练投入仍要单独计入。
02. 自蒸馏:让多看信息的自己当老师
这篇我们来聊聊自蒸馏,同一个模型,独立做题时可能犯错,看过答案或报错后却能发现问题。自蒸馏利用的就是这份上下文中的 context 信息差:让多看了一份信息的自己当老师,指导只看正常输入的学生。这里的老师也可以是同一模型的冻结副本。
这些额外信息只在训练时交给教师,称为特权信息。先看直接匹配师生分布的做法,一轮训练分三步:
1、 学生只看正常输入 x,自己生成回答 y。
2、 教师把额外信息 c 加入输入上下文,沿同一条学生回答的前缀 y_{<t},重新计算下一 token 的概率。
3、 用这些概率指导学生更新,梯度只通过学生分支。
学生看到的是 (x,y_{<t}),教师看到的是 (x,c,y_{<t})。回答始终由学生自己生成;教师多看的那份信息,决定了它能提供什么指导。下面几种方法主要在这里有所不同,RLSD 还改变了教师信号的用途。
| 方法 | 教师多看了什么 | 核心做法 |
|---|---|---|
| OPSD | 已有的参考答案或解法 | 让看过解法的自己回看原来的作答 |
| SDPO | 同题的成功尝试,或报错、失败单测等反馈 | 把尝试后获得的信息变成逐 token 监督 |
| Cursor | 针对某一轮行为构造的纠偏提示 | 在整条轨迹的 RL 之外,纠正指定行为 |
| OPCD | 可复用的系统提示或经验总结 | 将上下文中的指导学进模型参数 |
| OEL | 从部署交互中提炼、累积的经验 | 收集交互、提炼经验、蒸馏后再部署 |
| RLSD | 标准答案 | 用教师信号调整各 token 的 RL 奖惩权重 |
OPSD:把参考解法放进教师上下文
OPSD从已有的题目与答案数据出发。学生只看题目,教师额外看到标准答案或参考推理。参考解法放进教师的输入上下文,训练则沿着学生自己生成的回答进行。
用一道简单方程说明。题目是“解 2z+3=11”,参考解法写着“先得 2z=8,再得 z=4”。学生写到“2z=8,所以 z=”时,错误地续写了 8。教师多看了参考解法,就有机会在同一个前缀上更支持 4,给学生提供修正信号。
教师不需要再生成一遍正确解法。将“题目 + 参考解法”作为教师上下文,再接上学生原来的回答,就能通过一次前向计算得到各位置的概率。师生从同一模型初始化;论文的训练配置固定初始教师,只更新学生。
SDPO:把成功尝试和环境反馈变成逐 token 监督
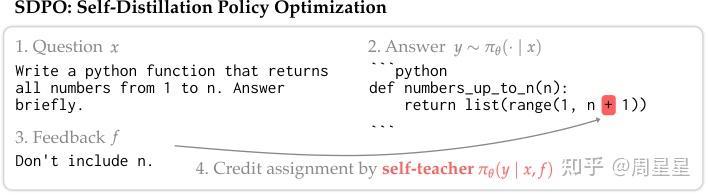
SDPO不必预先准备完整的参考解法。它先让学生尝试,再从尝试结果中构造教师需要的额外上下文。论文使用两类信息:
- 同一道题的成功尝试。 比如学生生成了三份代码,一份通过单测、两份失败。把通过的那份放进教师上下文,教师再沿失败回答的前缀计算概率,指导学生。成功代码提供参考,失败回答仍是被评价的原轨迹。
- 原尝试的环境反馈。 没有成功解法可参考时,把报错、失败单测等反馈交给教师,让它回看原来的回答。
例如,任务是“统计列表里的非负数”,学生写成:
def count_nonnegative(nums):
    return sum(1 for n in nums if n > 0)
单测输入 [-1, 0, 2],预期输出 2,实际输出 1。教师的上下文里多了这条反馈,就可能发现学生漏算了 0,在 if n 这个前缀上更支持接 >=,更不支持接 >。训练通过师生分布的差异,把一次单测失败转成相关位置的调整信号。
论文中的下图给出了类似的边界处理例子。反馈直接交给教师,教师重新评价原回答,无须先生成一份修改后的代码。
Cursor:用纠偏提示改进某一轮行为
长程 agent 可能中途调用错工具,后来又绕回来完成任务。最终结果是成功,过程中的这次错误却未必得到针对性的纠正。Cursor 在 Composer 2.5 中的做法,是为需要改进的那一轮构造一条短提示,加入教师的局部上下文。
官方例子中,学生调用了不存在的 ReadLints,收到“Tool not found”。训练时,在这次调用之前的上下文中加入提示:“当前可用工具是 Read、Write、Shell 和 StrReplace。”带提示的模型作为教师,重新计算原工具调用各位置的概率,降低对错误工具名的支持;学生仍使用原始上下文,通过蒸馏学习这些调整。
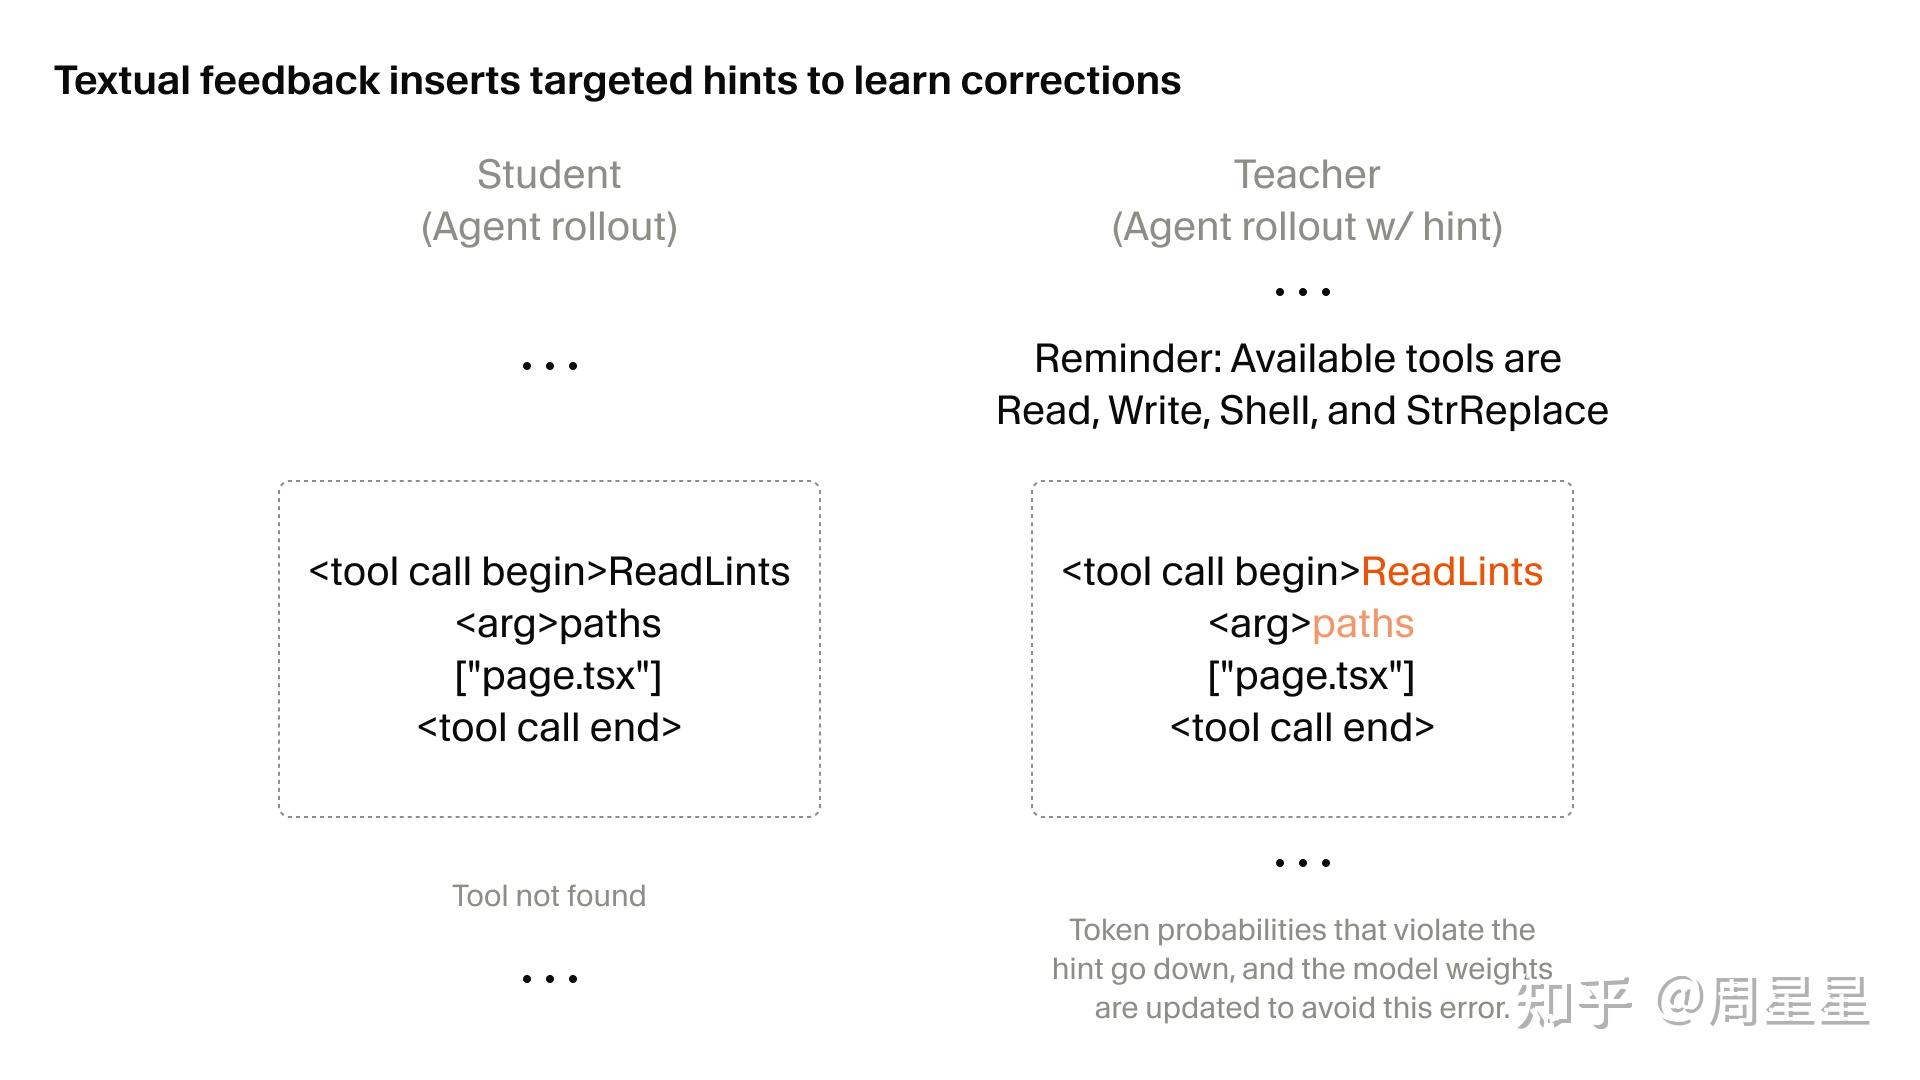
训练仍保留整条任务的 RL 目标,只在选中的那一轮追加蒸馏 loss。这样,一次没有明显影响最终成功的错误工具调用,也能得到明确监督。
OPCD:把提示与经验蒸进模型参数
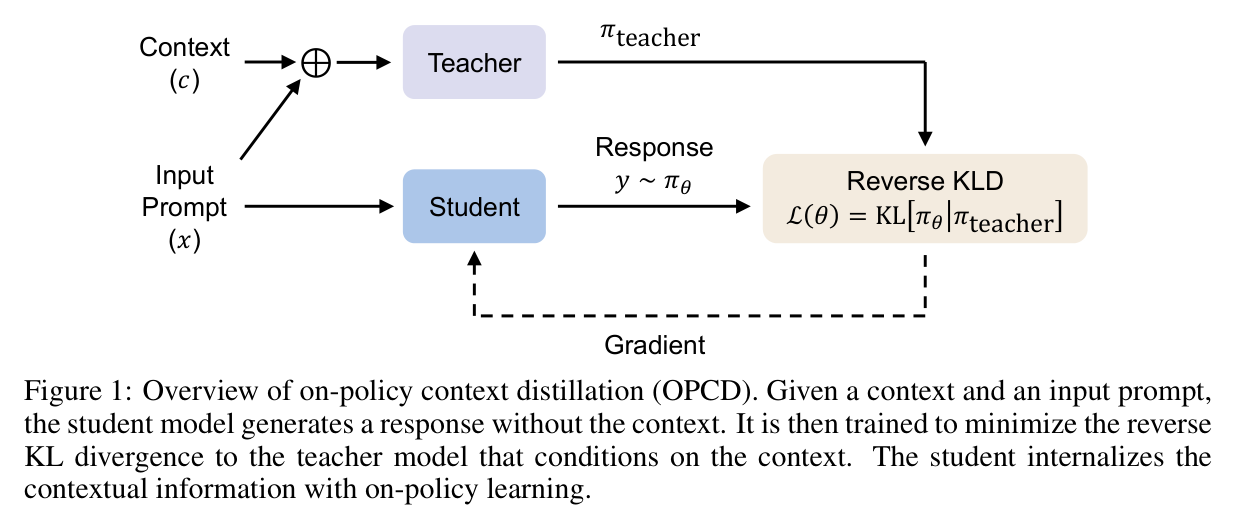
前面的参考解法和反馈主要针对当前任务或某次尝试。OPCD 关注可以反复使用的一份上下文,例如优化过的系统提示,或从多道题中总结的经验。它希望学生学会这些指导,以后不必每次都把它们放进输入。
OPCD的训练过程很直接:学生只看题目 x,生成回答;教师看“经验 c + 同一道题 x”,再沿学生原回答提供概率,通过 reverse KL 指导学生。OPCD 也允许使用外部教师,本节关注教师来自同一模型或其副本的用法。
经验 c 可以这样准备:模型先尝试一批题,再结合“题目 + 自己的解法”提炼可复用的经验,把不同题的经验写成条目、累积起来。论文的这一提炼流程不要求额外提供标准答案。经验写好后,才进入上面的蒸馏环节。
用一个简化例子说明:模型从几道求幂的个位数的题中,总结出“先找个位数的循环节,再按指数取余”。训练时,学生只看到新题“7^{103} 的个位数是什么”;教师还看到这条经验,并沿学生自己写出的推理提供指导。训练希望学生逐渐学会这个解题步骤,以后不再依赖额外的经验文本。
OEL:从部署后的交互中持续学习
OPCD 解决“已有一份经验,怎么教进模型”。OEL把它接进部署后的学习流程:模型在用户环境中执行任务,留下操作与文本反馈;服务器从这些交互记录中提炼经验,通过 OPCD 更新模型,再重新部署。教师多看的 context,来自模型实际经历过的交互。
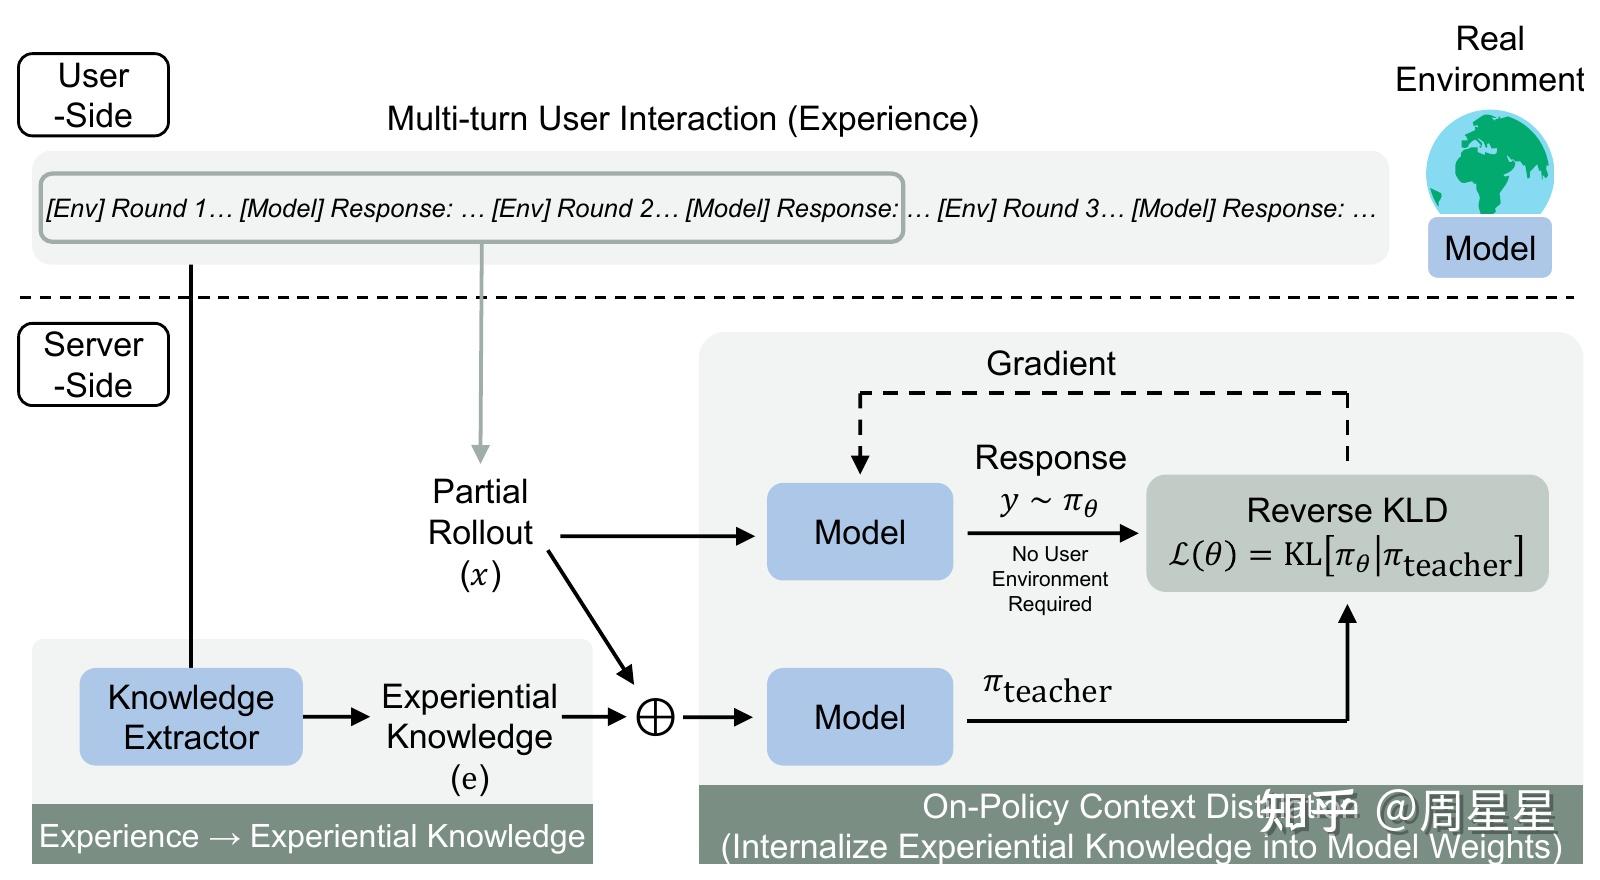
借论文中的冰湖任务举个简化例子:模型要根据地图走到终点,走进洞就会失败。它可以从交互反馈中提炼出“规划路径时,先排除地图上有洞的格子”。这条经验随后放进教师上下文,用来指导学生在类似局面下选择下一步。
服务器训练时,历史轨迹只提供起点,当前学生重新生成这一轮回答。具体来说,取某次移动前的完整交互历史作为 x;学生只看 x,生成新的动作回答;教师额外看到经验 c,沿这条新回答提供概率。教师使用本轮训练开始前冻结的模型副本。
服务器只需生成和评价这一轮回答,不必真的执行新动作、再把后续游戏跑完。因此,当前回答来自学生自己的策略,起始上下文来自历史记录;学习阶段不要求重新连接用户环境,也不需要另建奖励模型。更新后的模型重新部署,收集新交互,再提炼下一批经验。
on-policy 只说明这里的回答由学生自己生成,并不保证旧能力不会退化。持续更新时,仍要单独评测旧任务。
RLSD:结果定奖惩,教师调权重
RLSD同样让教师多看标准答案,但改变了教师的职责:结果导出的优势决定强化还是抑制,教师只调整各 token 的奖惩权重。 它不再另加一项拟合教师分布的 loss。
先让学生生成一组回答,用验证器判断结果,像 GRPO 一样算出每条回答的优势值 A。教师额外看到标准答案,再沿原回答比较每个 token 在师生两边的概率,把差异转成正权重,乘到 A 上。
沿用前面的方程例子:学生先写对了“2z=8”,却接着写“z=8”,整题做错。若这条回答的 A<0,看过标准答案“z=4”的教师可能更支持前一步、更不支持最后那个 8。RLSD 据此让前一步少受惩罚、最后一步多受惩罚;教师不会把其中某个 token 的负优势改成正数。
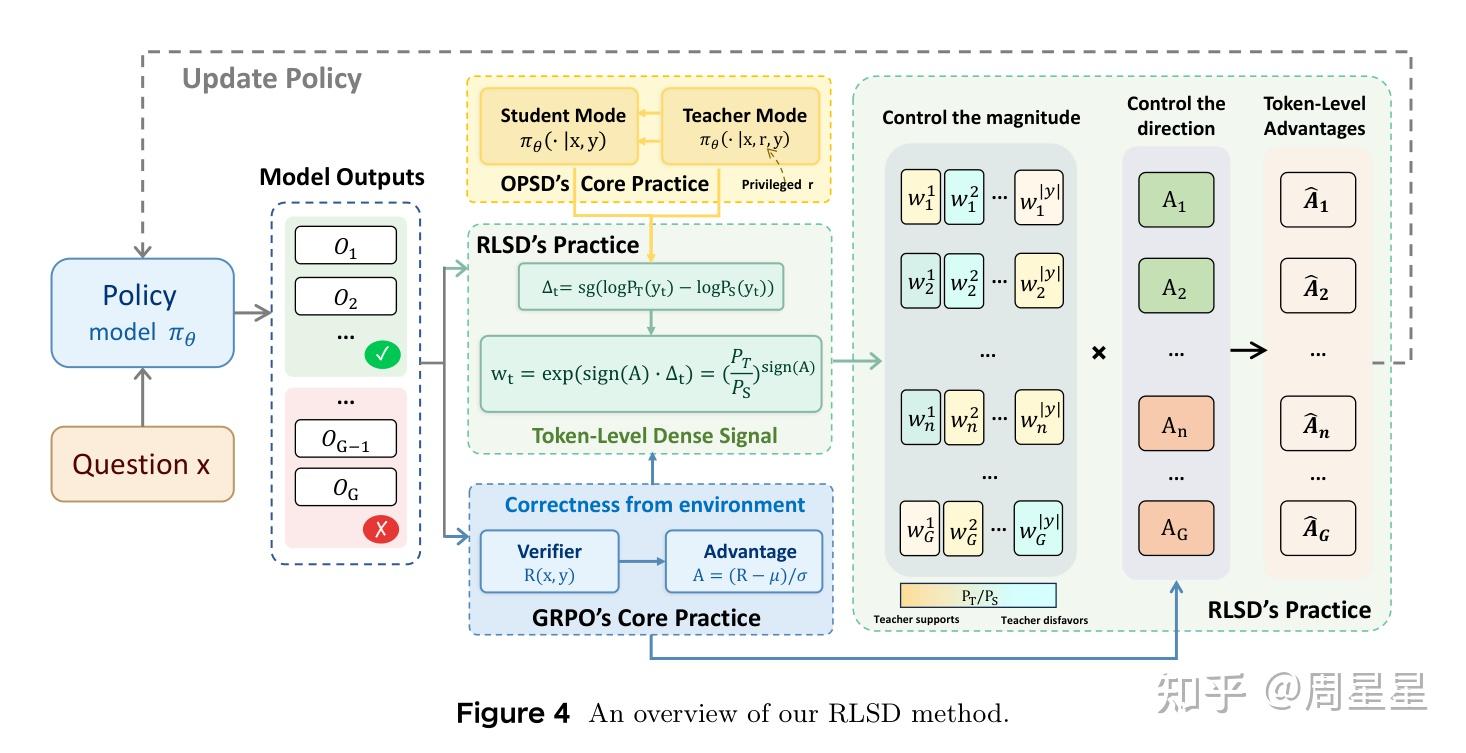
具体计算如下。P_T(y_t) 和 P_S(y_t) 都沿同一个学生前缀计算,教师额外看到标准答案;\operatorname{sg} 表示停止梯度,概率差只提供权重,不通过它反向传播:
A>0 时 ,w_t=P_T/P_S教师相对学生越支持的 token,得到越多强化;A<0 时,
w_t=P_S/P_T,教师相对学生越不支持的 token,受到越多抑制。裁剪把权重限制在正区间内,避免个别 token 的权重过大。
看一组示意数值。先忽略与原优势的混合,设 \epsilon_w=0.2,权重限制在 [0.8,1.2]:
| 回答优势 A | 概率比 P_T/P_S | 权重 w_t | token 优势 |
|---|---|---|---|
| +1 | 3 倍 | 3 | +1.2:多强化 |
| +1 | 1/3 | 1/3 | +0.8:少强化 |
| -1 | 3 倍 | 1/3 | -0.8:少抑制 |
| -1 | 1/3 | 3 | -1.2:多抑制 |
实际实现还把加权优势与原始 A 混合,再接回 GRPO;论文配置逐步减弱教师权重,并让教师快照定期与学生同步。若 A=0,这种乘法加权不会凭空产生更新信号。
MiMo 与 RLSD 结合两种信号的方式不同:前者相加,后者相乘。 MiMo把教师信号与结果优势相加,再送入同一个策略梯度 loss。
假设结果优势为 -1,教师信号为 +2,结果项系数为 1,合起来就是 +1,这个 token 可以得到正优势。RLSD 则用正权重乘原优势:例如 -1\times0.8=-0.8,教师可以让它少受罚,但不能翻转符号。
RLSD 这样处理,是为了限制直接模仿特权教师带来的问题,例如学生学会说“根据参考答案……”,而部署时它根本看不到参考答案。这里“结果定方向”只指 token 优势的正负;不同 token 的权重改变后,合计的参数梯度方向仍可能变化,也不能据此保证所有设置下都不会出现特权信息泄露。
03. 黑盒蒸馏:拿不到教师概率,怎么做 OPD?
继续,这章我们来讲黑盒蒸馏,如果教师只通过 API 返回文本,我们就无法直接计算师生的 token 概率差。用教师回答做 SFT,是常见的黑盒蒸馏;但它沿着教师答案学习,不属于这里讨论的 on-policy 路线。
本章介绍的两个方法都遵循:学生生成回答 → 从教师文本构造回答级奖励 → 用 RL 更新学生。GAD 训练一个判别器来打分;Rubric OPD 让老师先写评分标准,再按标准打分。它们保留了 on-policy 采样,但优化目标变成教师文本构造的奖励,不再是白盒的 token 分布匹配。
GAD:用师生回答训练评分模型
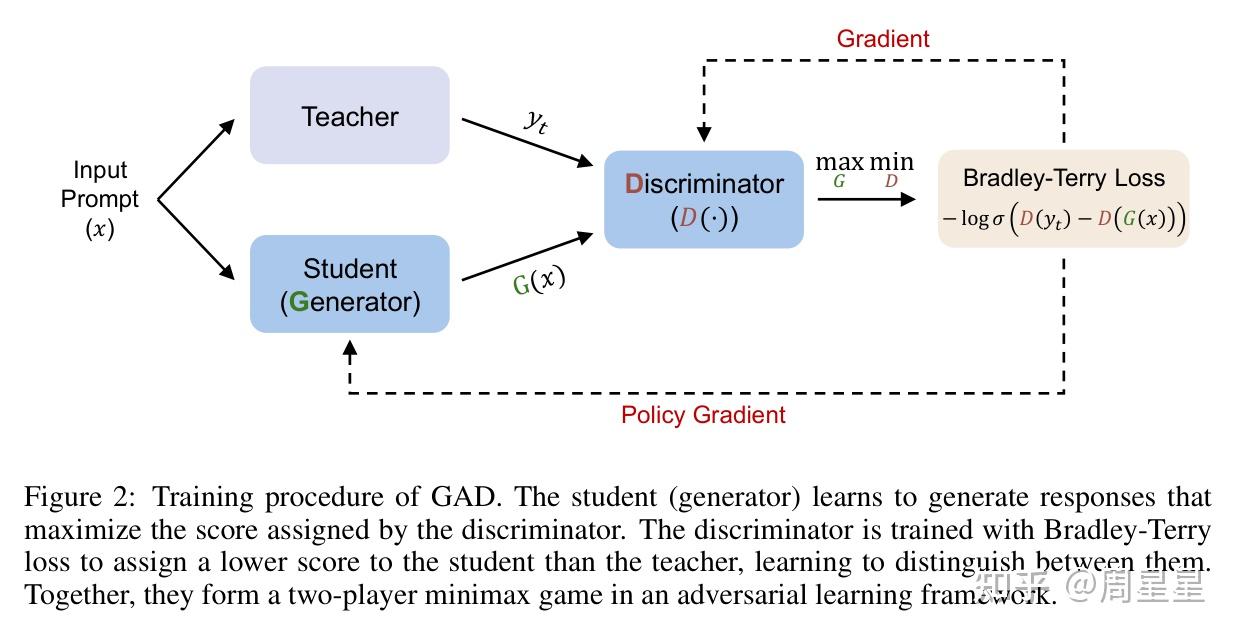
GAD(Generative Adversarial Distillation)先用师生回答训练一个评分模型,再用它的分数训练学生。这个评分模型叫判别器 D_\phi:输入题目 x 和完整回答 y,输出一个标量分数。论文用学生模型的权重初始化判别器,加一个评分头,随后将它作为独立模型训练。
判别器与学生的目标相反:判别器努力让教师回答得分更高,学生努力让自己生成的回答拿高分。教师只提供参考文本,参与交替训练的是学生和判别器。
训练前,先调用教师收集并缓存回答;用这些回答给学生做 SFT 预热,同时用师生回答对预热判别器。进入 GAD 后,每一批执行:
1、 学生生成。 对题目 x,当前学生采样一组新回答。
2、 更新学生。 固定判别器,用它给每条学生回答打分,把分数作为 reward,用 GRPO 更新学生。
3、 更新判别器。 把这批学生回答与同题的教师回答配成对,按“教师回答应得更高分”的标签训练判别器。这一步只更新判别器。
判别器用的是 Bradley–Terry 成对损失。对一对教师回答 y^T 和学生回答 y^S,最小化:
\sigma 是 sigmoid 函数。教师得分相对学生越高,这项损失越小;训练标签由“回答来自老师还是学生”产生,不需要另外请人标偏好。学生训练用的奖励则直接是 D_\phi(x,y^S)
,不是把上面的判别器损失反向传播穿过生成过程。
例如,题目是“计算 1+2+\cdots+100,并说明理由”。教师给出了等差数列求和公式,算出 5050。学生这轮生成了两条回答:
- A:“首尾配成 50 组,每组 101,所以和为 5050。”
- B:“首尾配成 50 组,每组 101,所以 50\times101=5000。”
假设判别器分别给 A、B 打 0.8、-0.4 分,组均值就是 0.2。GRPO 据此给 A 正优势、B 负优势,鼓励 A 这样的回答、抑制 B 这样的回答;随后,判别器再用教师回答与这两条新回答继续训练。这些分数只用于演示流程,真实评分由判别器学得,并没有程序在这里直接检查算术对错。
从学生的更新方式看,GAD 本质上仍是 RL,也有 reward hacking 的风险:判别器分数提高了,回答质量却未必提高。例如,若判别器偏爱篇幅长、措辞像老师的回答,学生就可能靠堆字数拿高分,推理错误却没有减少。
GAD 持续更新判别器,让评分器跟上学生的新行为,可以缓解对旧评分规则的利用,但不能保证消除这类漏洞。业务上仍要用独立的正确率或任务成功率检验收益,不能只看判别器分数。
代价是要同时训练学生和评分模型,而且“来自老师”只是训练标签,不保证每对回答里老师都更好。教师文本可以提前缓存;需要每轮重新生成的是学生回答,这也是 GAD 的 on-policy 部分。
Rubric OPD:对照师生回答制定标准,再逐项评分
GAD 把评分规则学进判别器参数。Rubric OPD(ROPD)则把规则写成可读的文本:先让老师说明“这道题应该怎么评”,再用这套标准评价学生。
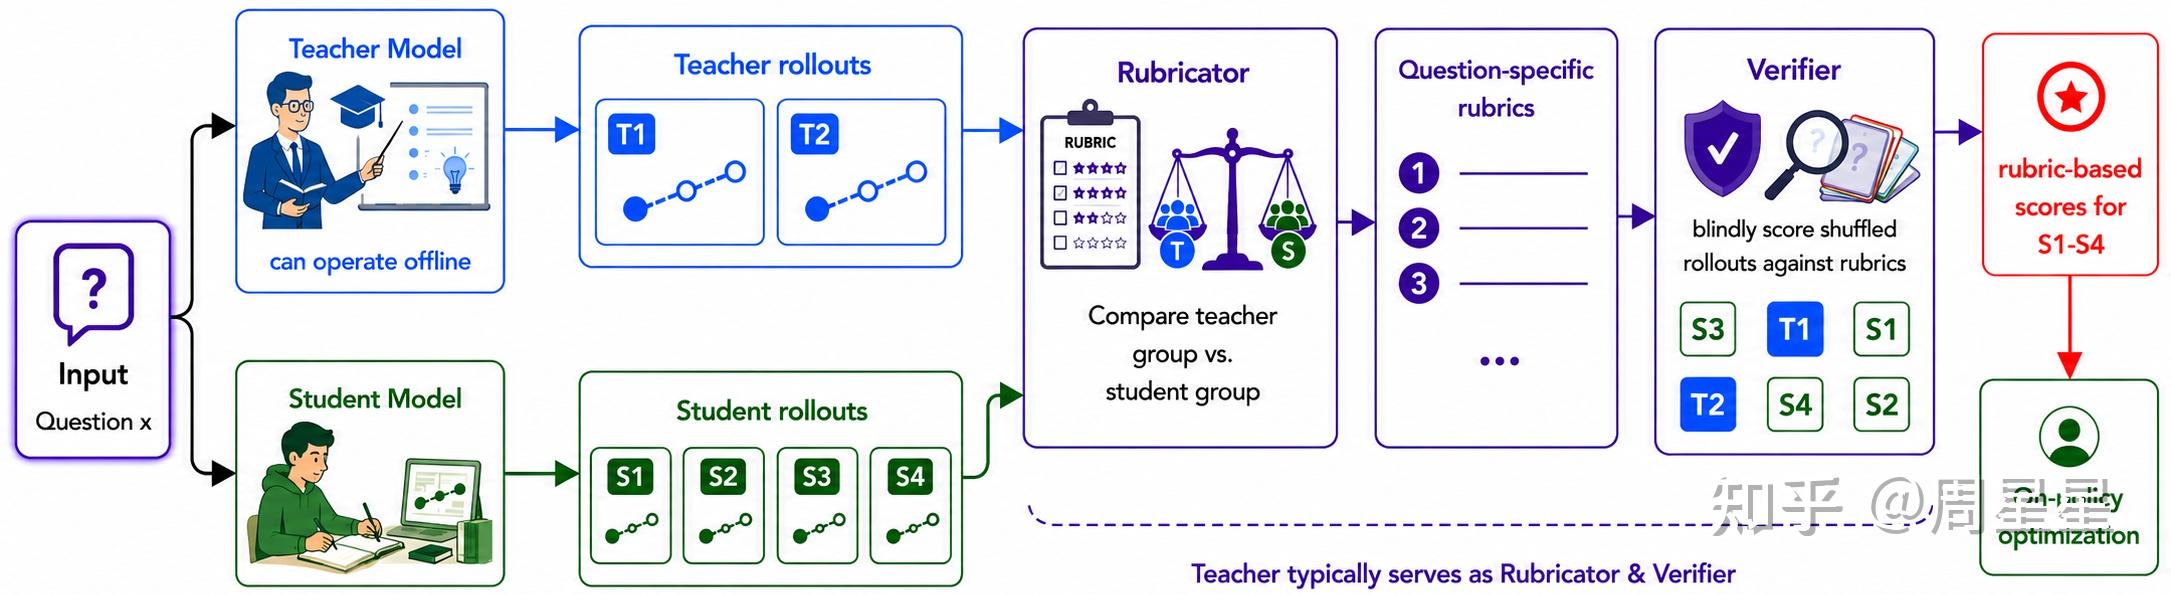
这里有两个角色:Rubricator 制定评分项,Verifier 按评分项逐项判断,通常都由教师模型通过不同调用完成。这套流程只训练学生;Rubricator 和 Verifier 的参数不更新,评分项则随新一批学生回答重新生成。
1. 对照师生回答,制定评分标准
对同一道题,收集多份教师回答和当前学生生成的回答。多份教师回答可以展示不同的正确解法,减少评分项只认可某一种解题步骤的问题;学生回答则暴露当前容易出现的缺口。Rubricator 同时读取题目和这两组回答,生成一套带权重的评分项,称为 rubric。
仍用刚才的求和题和学生 A、B,可以构造下面这份示意 rubric。教师可以用等差公式,学生也可以用首尾配对,只要方法成立:
| 评分项 | 权重 | 学生 A | 学生 B |
|---|---|---|---|
| 最终结果为 5050 | 4 | 通过 | 不通过 |
| 求和方法合法,配对或等差公式均可 | 3 | 通过 | 通过 |
| 中间与最终计算一致、无算术错误 | 2 | 通过 | 不通过 |
| 解释配对关系或所用公式为什么成立 | 1 | 通过 | 通过 |
A、B 都说清了配对思路,但 B 算错了最后一步。这套评分项把“方法是否合理”和“计算是否正确”分开判断;表中的通过与否由下一步的 Verifier 给出。
同一轮、同一道题的所有回答共用一套 rubric。如果每条回答各自生成标准,宽松标准下的高分就无法与严格标准下的低分比较,后面的组内优势也失去了共同尺度。
2. 逐项判断,计算奖励,再更新学生
将同题的师生回答混排、隐藏来源后,交给 Verifier 按同一套 rubric 逐条评分。教师回答留在其中,是为了提供质量参照;隐藏来源,则是为了减少“这是老师写的,所以应该给高分”的偏差。
这里按评分项判断,不像 GAD 那样预先把“教师优于学生”作为训练标签。论文 §4.3与官方实现说明了这一做法。
对第 i 条学生回答,Verifier 判断每项是否通过,记为 v_{i,k}\in\{0,1\}。若第 k 项权重为 w_k>0,奖励就是加权通过率:
上例中,A 四项全过,奖励是 10/10=1;B 只通过第二、第四项,奖励是 4/10=0.4。这份奖励区分了“方法合理但算错”和“完整做对”,最后仍汇总成一个回答级分数。再只用同题学生回答的奖励计算 GRPO 优势,更新学生;教师回答不参与学生的策略更新。完整流程见附录 F。
rubric 把评分依据写了出来,便于检查老师奖励的是正确性、推理过程,还是某种表达形式。但它同样可能被钻空子:比如“提到检查结果”可能奖励一句空话,“实际完成检查且结果正确”才更接近想要的行为。Verifier 的判断也可能出错,逐项评分不等于单测验证。
两种方法的取舍也由此清楚了:GAD 要训练和维护评分模型;ROPD 的开销则主要在持续制定标准和评分。两者的教师参考回答都可以缓存,但 ROPD 每批新回答仍需要模型调用。我会先检查奖励能否区分业务中真正的好坏回答,再比较达到同一效果所需的总成本。
两条路线最终都把教师文本转成回答级奖励,因此不要求师生 tokenizer 对齐,也不需要教师 logits。但它们仍通过学生的 token 概率计算策略梯度;回答级奖励并不等于第一章从整句 reverse KL 推导出的 sequence-level 蒸馏目标。这里是否学得好,取决于构造出的奖励能否反映值得学习的行为。
04. OPD 的本质与边界
继续,这章我们来聊聊 OPD 的本质和边界。
几种常见的后训练算法我们都有熟悉了:SFT 容易训推不一致,训练时跟着示范答案走,使用时却要接着自己的输出写;离线 DPO 受限于固定偏好对,未必覆盖模型当前会犯的错;基于奖励模型的 RLHF 可能出现 reward hacking,评分涨了,真实质量却没涨;RLVR 需要可靠的结果验证,且只按最终对错给分时,信号很稀疏,知道答错了,却不直接指出哪一步该改。
那问题来了,OPD 的弊端和短板呢?哪些场景不适合呢?
老师很强,为什么学生还是学不好?
假设老师独立答题很强,不代表它能教好当前这个学生。
这里要分清三类问题:老师接手后做不对、训练信号鼓励了无用的行为、学生没学会正确的做法。 它们可能同时出现,但要分别检查。
第一类:老师自己会做,却接不好学生写到一半的过程。 要检查这一点,可以让老师接着学生已经写出的内容,把题做完。
拿 2 + 3 × 4 举个示意例子。老师从头算能得到 14,学生却写下:“先算 2 + 3 = 5,再算 5 × 4……”假设老师接着完成解答时,也漏掉了前面的运算顺序错误,最后答成 20。这时出问题的是老师接手后的实际解题能力:它自己会做,却没能把学生已经走错的过程纠正过来。
OPD 把训练放在学生自己会写出的内容上,学生练得更贴近实际;代价是老师要指导它自己很少写出的错误过程。老师平时答题再准,在这些情况下能不能教好,也要重新验证。
第二类:训练信号在鼓励,任务却没有进展。 比如,学生解题时不断重复“Wait, Wait, Wait…”。重复片段中的部分 token,教师给出的概率仍高于学生,按局部 log-ratio 就会得到正向信号。但多写这些内容,并没有帮助解题。
这一类检查的是训练在鼓励什么。即使师生概率算得完全准确,正向信号也只表示老师比学生更倾向于生成这个 token,并不保证它能让任务做得更好。
不过,不能只盯着最后的答案,看它有没有被罚。TML 博客的冰块案例中,老师已经提供了纠错信号,只是信号主要落在前面的错误假设上。题目问煎锅里还剩多少完整冰块,教师独立作答能给出正确答案 0;学生却忽略融化过程,算出 20。教师惩罚了引入错误假设的部分词,但最后的“20”几乎没有被罚,因为在已有的错误前缀下,20 这个数字已经很容易预测。
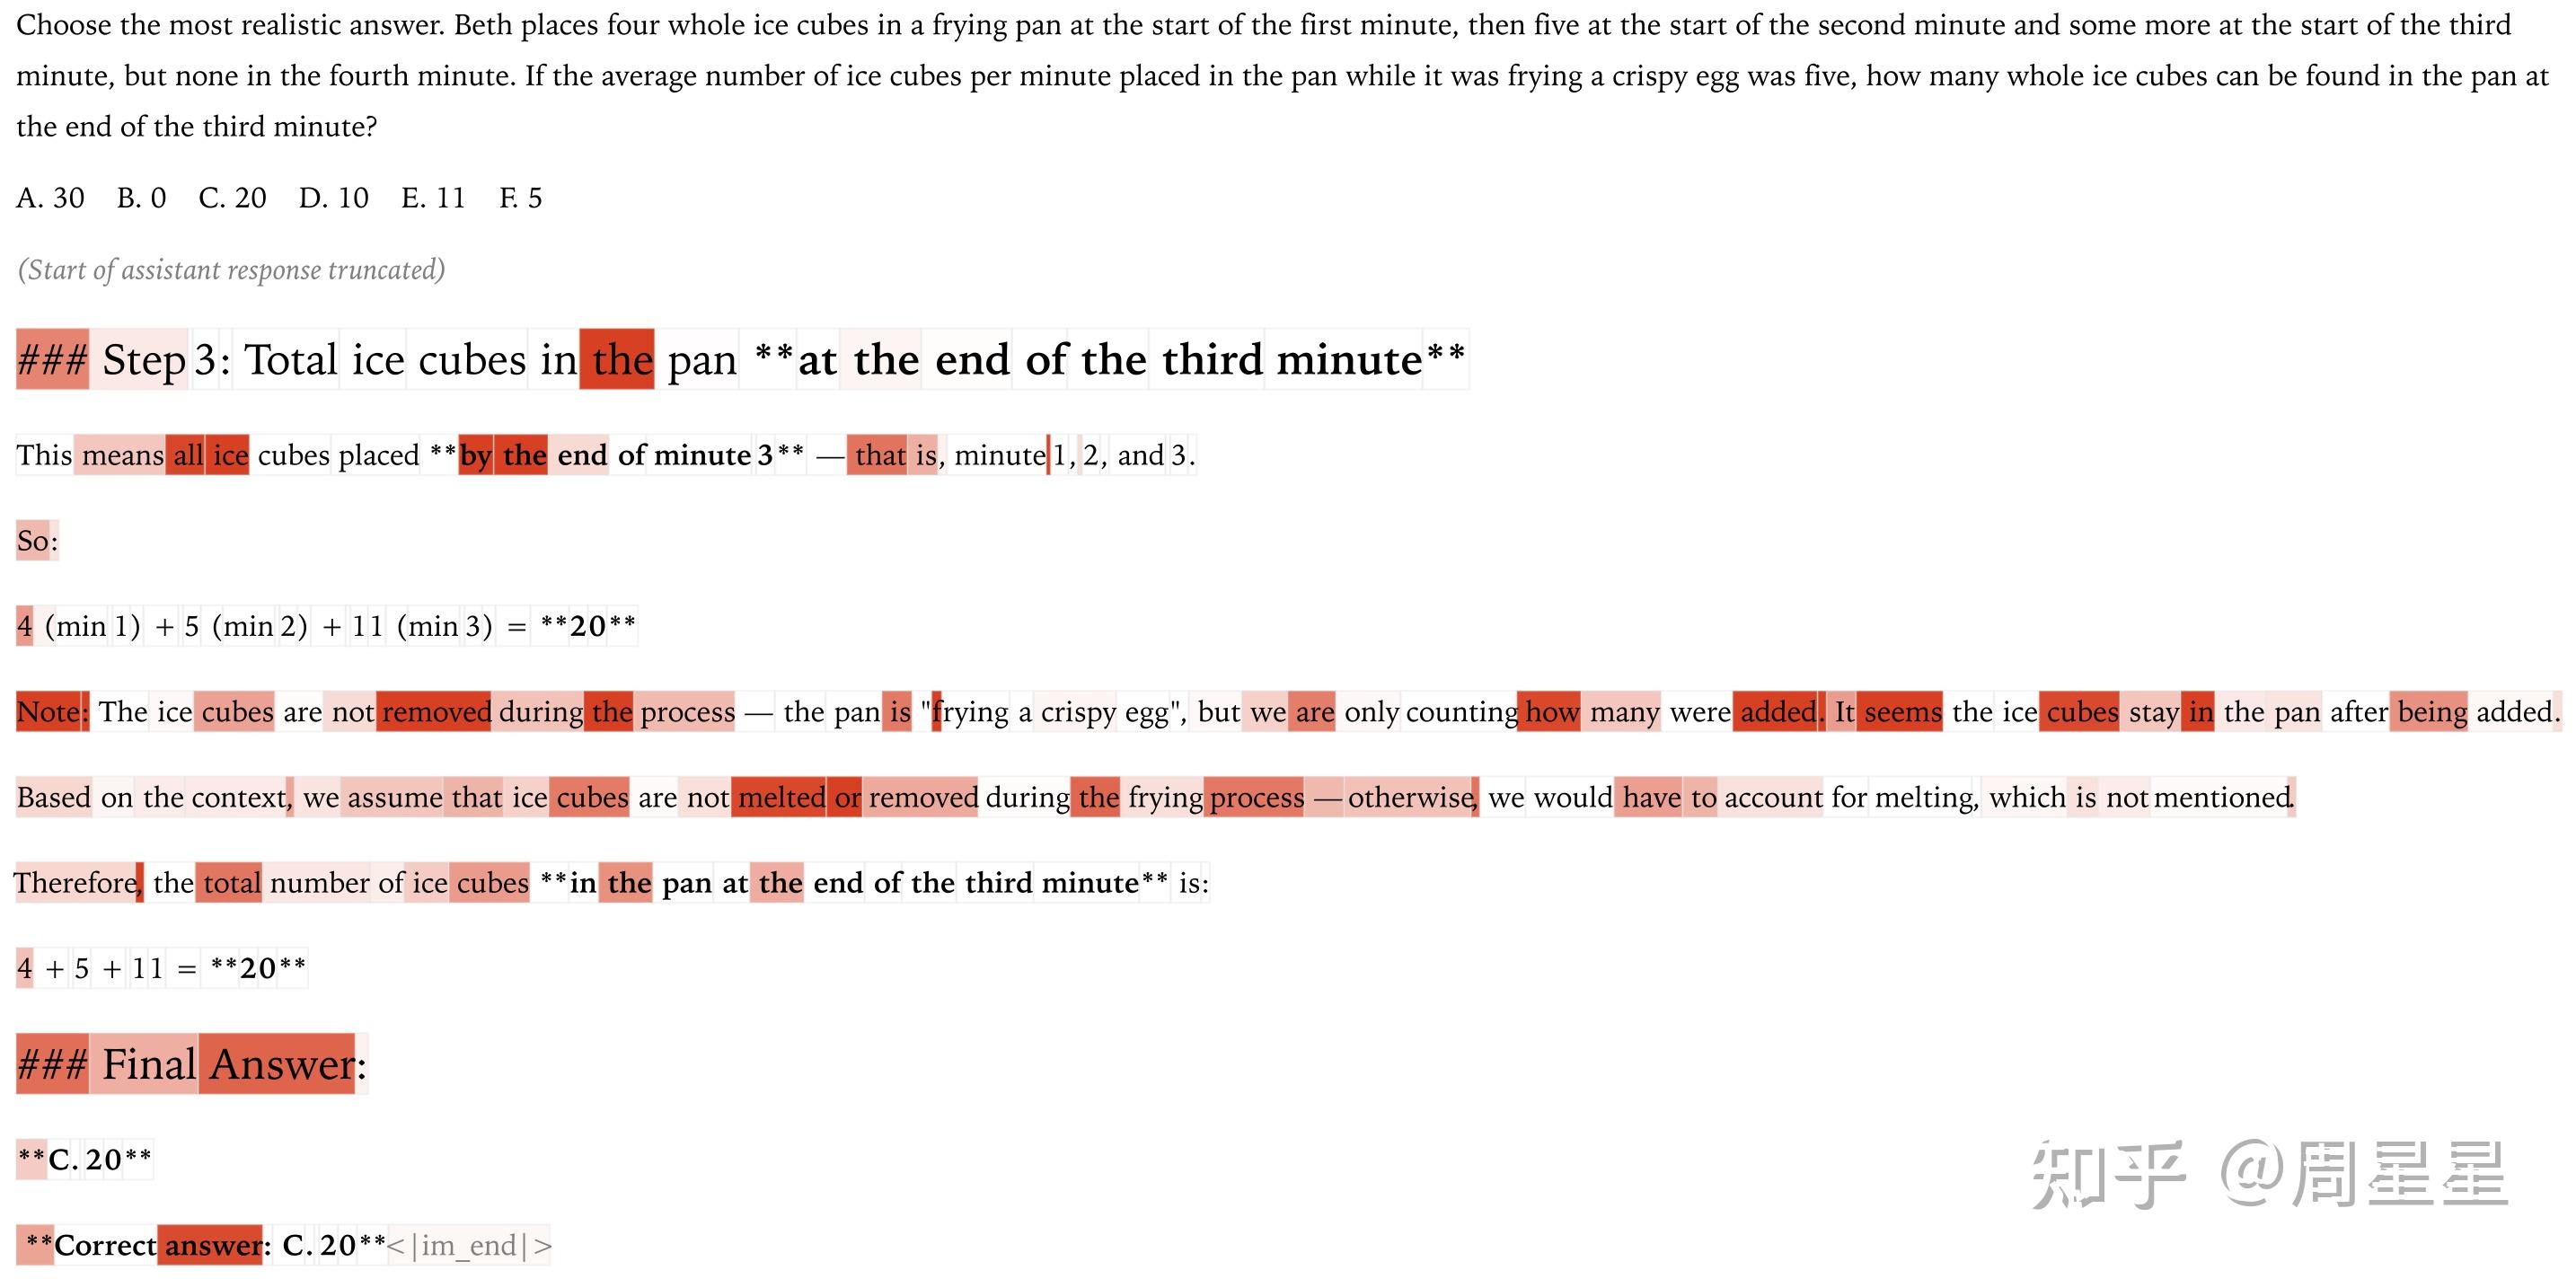
这个例子中,教师主要在引入错误假设的位置提供纠错信号。“20”没有被罚,本身不能证明教师教不好学生;要看学生能否利用前面的信号,减少同类错误。
第三类:老师的方法没错,但学生还不会执行。 举个示意例子:一道求最大值的题,老师推荐“先求导,再令导数为零”,这条路线确实能解出题。但学生连基本的求导运算都不熟练。训练后,它更容易写出“先求导”,后面的导数却仍然算错,最终也答不对。
这里,老师的指导正确、有用,但让学生更倾向于采用一种方法,不等于已经教会它执行这种方法所需的每一步。OPD 也会监督后续的计算步骤,只是当前训练还没让学生掌握这些能力。能学到多少,还取决于学生已有的基础和训练是否充分;先补齐基础,或采用它已经掌握的解法,可能更有效。
怎么定位问题,最简单的方法就是看样本。 像图 4-1 那样,把学生生成的内容和逐 token 的蒸馏信号放在一起,直接看哪里得到奖励、哪里受到惩罚:错误从哪一步开始,教师有没有在关键位置给出纠错信号,重复或无效推理有没有反而得到鼓励。再对照最终答案和训练前后的同类样本,检查这些信号是否让学生少犯同样的错。
找到问题后,再针对性地调整。 教师在错误前缀上指导不可靠,就尝试更合适的教师,或给教师补充答案、失败反馈;教师信号与任务结果不一致,就在有可靠单测或答案验证时加入结果奖励,让任务对错参与训练;指导正确但学生仍不会执行,就先补基础,或用教师答案做 SFT 冷启动,再转入 OPD。最终看未参与训练的目标任务是否改善,不能只凭 KL 下降或训练稳定判断成功。
只练一道题,OPD 也能泛化?
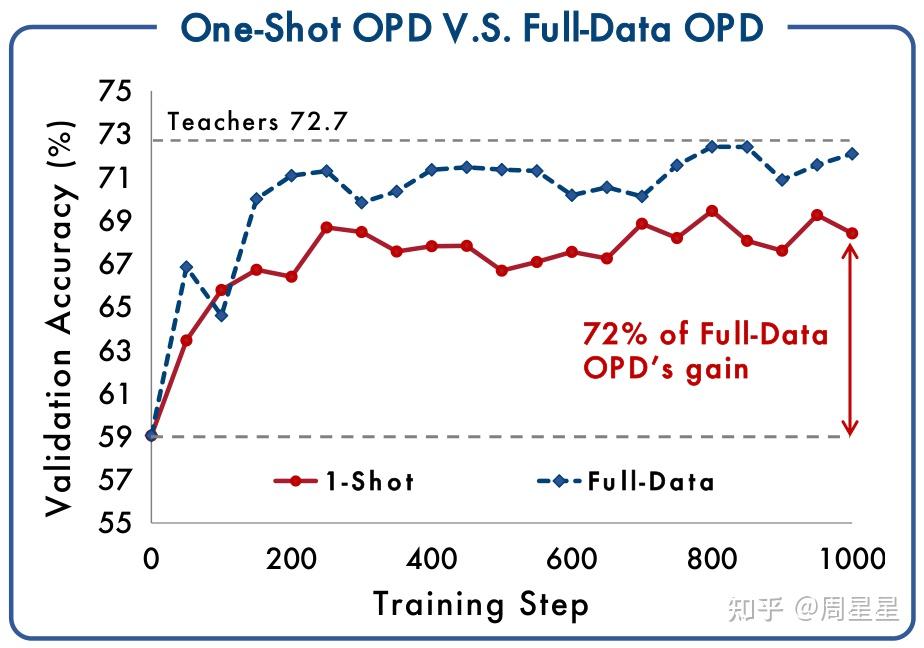
只反复训练同一道题,模型在其他题目上的表现也能提高。 Thinking Machines Lab 和 Rethinking OPD II 都观察到了这个现象。固定训练题目:学生每轮仍会生成新的回答,再根据教师的逐 token 信号更新参数。具体的
Thinking Machines Lab 的单题实验先把 Qwen3-8B-Base 用 RL 训练成教师,再让原始基模向它学习。固定一道题,训练 20 步,每步随机生成 256 条回答,学生在 AIME’24 上的表现就接近教师。
Rethinking OPD II:学生始终没有解对那道困难的训练题,其他评测题的表现却仍然提高了。 学习收益显然不必等到学生掌握这道题的正确答案后才出现。
用一个简化的示意例子理解这个过程。训练题始终是 12 × 13,学生一次直接写结果,一次拆成 12 × (10 + 3),另一次拆分正确,却把后面的计算写成 120 + 26。虽然题目没变,学生遇到的中间步骤已经不同。教师根据每个位置之前的内容,提供下一 token 的概率。例如,在写错计算结果的位置,若教师给错误 token 的概率低于学生,局部信号就会推动学生降低这个 token 的生成概率。整条回答即使答错,也仍然能从这些位置学习。
从学习的角度,OPD 直接调整的是这些前缀上的续写分布。 如果这些更新改善了其他题目也会用到的计算或推导行为,就可能产生题外收益。这是理解泛化的一种解释,但两篇实验还没有确定学生具体学到了哪种通用规则,不能直接把效果归因于“学会了检查”或“掌握了某种推理模式”。
Rethinking OPD II 的状态分析为这个解释补充了证据:作者用教师的隐藏表示对生成前缀聚类,发现一道题产生的轨迹,就覆盖了全数据训练所访问状态簇的 71.5%;增加到 16 道语义不同的题,覆盖率达到 98.9%,效果也接近全数据训练。这提示我们,新增题目的价值,要看它能否带来已有训练较少涉及的生成过程。
从这个角度来说,就很爽了,因为对已有基础的学生,迁移教师的部分后训练收益,可能只需要很少的题目。 教师已经付出了学习和探索的成本,蒸馏阶段可以直接利用这些成果。落到具体的应用上,我们可以先用少量有代表性的输入验证迁移,再根据未见任务中的失败类型补数据,不需要太多的数据。
写在最后
OPD 很迷人:在前面的白盒实验里,学生围绕一个输入反复采样,也能在其他任务上进步。对应用团队来说,可以先用少量代表性输入验证收益,再围绕真实失败补充训练。拿不到教师概率时,把教师文本转成奖励的黑盒路线也值得尝试。
我也看好自蒸馏与环境反馈的结合:把答案、失败单测和交互反馈放进教师上下文,让多看了信息的自己指导学生,再把更新后的学生放回应用中检验。这样,运行中暴露的问题就有机会成为下一轮训练的素材。这会不会成为走向 RSI 的一条路径?
但 OPD 的边界也很明确。纯白盒蒸馏直接优化的是师生分布匹配,并不直接以任务是否完成为目标。学生练的是自己真实会生成的内容,老师却可能要面对自己很少写出的错误过程,指导未必可靠。训练更贴近学生,不代表教师的指导就更可靠;学得更像老师,也不代表任务就做得更好。 无论用教师概率还是从教师文本构造奖励,最终都要回到真实任务上验证。
天下没有免费的午餐啊。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册