碎碎念
DeepSeek-V4发布CSA的时候,我对比了一下HISA和CSA的异同,跟身边的同学说,CSA相比HISA确确实实的能减少KV Cache,但是效果会比HISA差一些。但是当时也没有想到如何很好的把这种优势通过实验给展示出来。
看到字节Seed团队最新发布的论文《Periodic Weak Spots》之后,我意识到这就是一个很好的反例,用来区分HISA和CSA的能力差异。加上LongCat-2.0直接用了我们的HISA,以及DeepSeek-V4.1-flash引用了我们并提出一个Hierarchical Sparse Indexer,因此决定写这样一篇文章,来介绍一下HISA。
HISA是什么
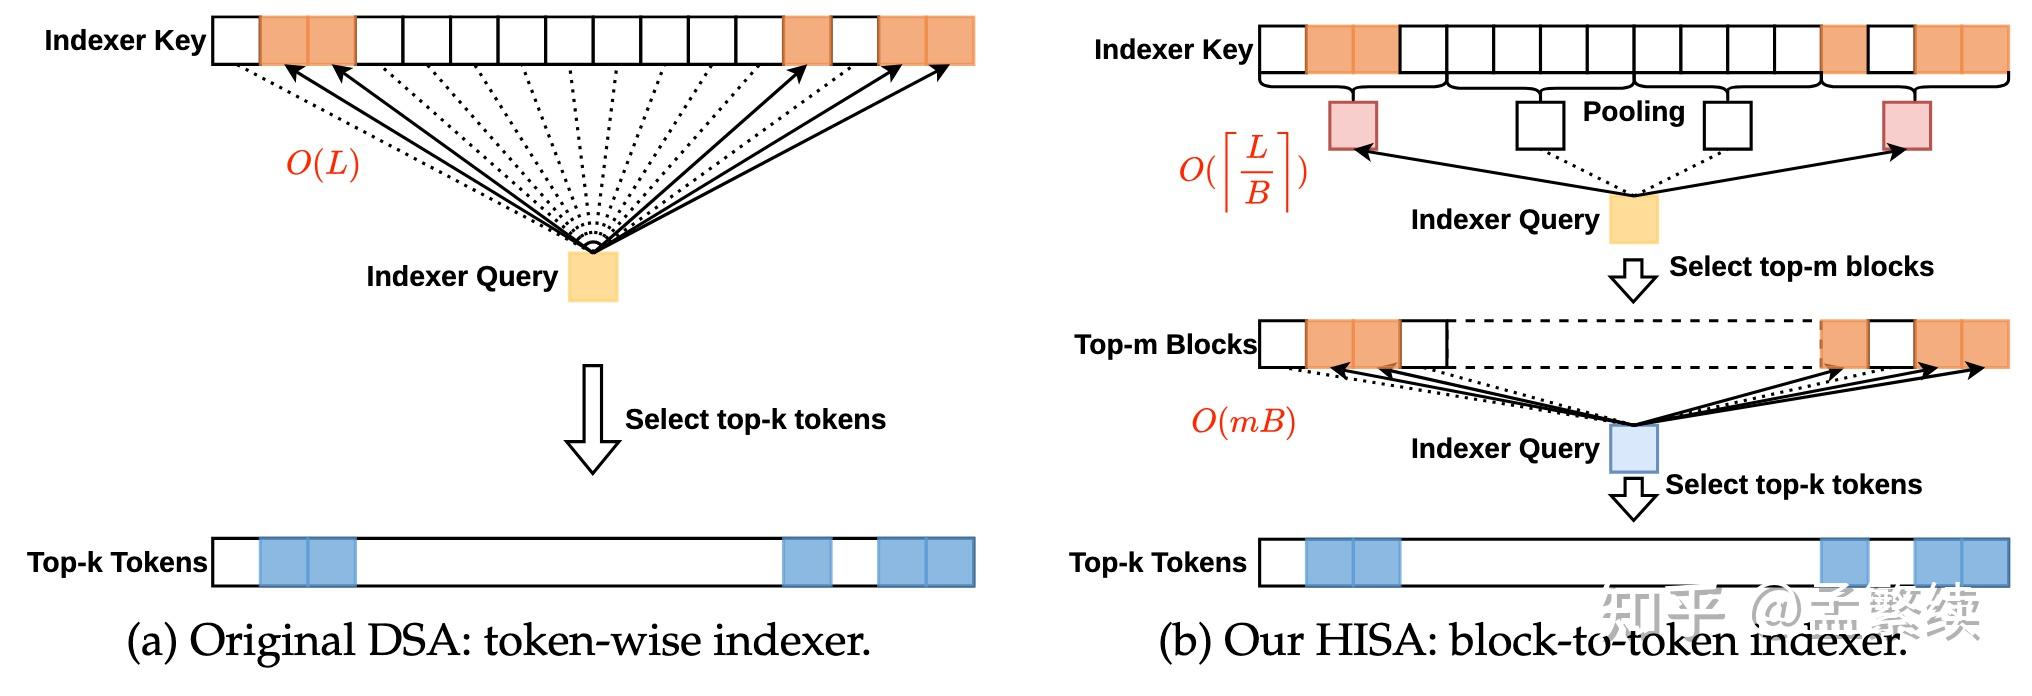
HISA是Hierarchical Indexing Sparse Attention的缩写,Hierarchical是一种计算机领域一种经典的分层执行任务的思想,我们将其引入DSA用于解决Indexer的速度瓶颈问题。DSA需要一个indexer以比较小的开销从全部上下文中召回top-k个token,交给core-attention计算。如何高效的设计indexer是一个关键问题。
HISA指出,可以先用比较小的开销快速筛传出c个候选token,然后再在这c个候选token中精确的选择top-k个token。 这个种先粗粒度挑选候选token,再精排得到topk的思想就是HISA的第一个核心思想。
那么如何快速的得到候选token呢?HISA给出一个解决方案,将所有的token切block,选择top-m个block内所有的token作为候选token 。当时选block的好处在于同时能够减少计算量和访存量,DSA出现时NSA和MoBA还有一定热度,那时block sparse好还是token sparse好还存在争论。
因此我希望通过HISA提供一种折中的思路:用block选token,用token算attention,达到一种效果和效率的平衡。
HISA和CSA的异同
对于DSA来说,indexer选一个token很贵,选中的token信息量又比较少。HISA和CSA都存在两次压缩:
- 对Indexer的压缩,二者都将indexer的多个token压缩成一个从而减少选择token的开销;
- 对取出的token的压缩,CSA直接将indexer block和main-kv block对齐,选中的block已经压缩成一个token了。
而HISA对于indexer选中的block,将其中的token展开,全局排序选择最大的top-k token。二者第一阶段一样,第二阶段的区别可以简单理解为局部低秩和全局稀疏的区别。因此当初V4出来的时候,我说HISA的效果是更好的。
当然,HISA还需需要保存全局cache,而CSA直接把kvcache压缩几倍,效率上还是CSA更高。未来HISA需要结合kv reuse和reindex等想法,把kvcache也降下来才能全面取得相比CSA的优势。
HISA不存在相位敏感性问题
前面铺垫了这么多,终于开始介绍正题。为了定位seed所说的相位敏感性问题的元凶,我复现了文章中的从头训练一个小模型的实验,对比DSA、CSA、HISA,发现DSA确实在每个相位准确率几乎一致,CSA则差距巨大,而用了block indexer,token attention的HISA则和DSA一样不存在相位敏感性问题。
因此得出,block core-attention是导致相位敏感性的原因,只用block indexer不会导致相位敏感性。
| 指标 | DSA(top-2048 token) | CSA(top-2048 block) | HISA(top-2048 token) |
|---|---|---|---|
| 平均准确率 | 37.30% | 45.41% | 50.05% |
| 相位 0 | 36.91% | 1.95% | 50.20% |
| 相位 1 | 36.91% | 39.45% | 50.00% |
| 相位 2 | 37.50% | 64.45% | 50.59% |
| 相位 3 | 37.89% | 75.78% | 49.41% |
| 准确率峰谷差 | 0.98% | 73.83% | 1.17% |
正常CSA应该取top-512,乘以4个token/block才和其他两项对齐setting,这里实验的时候没注意这个细节,回头会更新一下结果。
HISA的变体
HISA可以有一系列的变体,只要是能够更快的得到候选token的方法,都可以和HISA结合,用来做第一阶段的方法。indexer计算无非层、头、block、维度、精度这几个可以压缩的方向,每一种方法直接压缩,都可能会导致效果损失比较大,但是结合Hierarchical的想法,先用这些方法粗筛,再精排,就能够显著提升效果。
层压缩: 例如HISA结合IndexCache就得到了DeepSeek-V4.1-flash的Hierarchical Sparse Indexer,IndexCache直接reuse top-k会损失效果,但是V4.1-flash先选择一个更大的候选集,然后再精排,就能获得很好的效果,他们把这种方式起名叫做reindex。
我们的IndexCache也是层压缩的方法,利用了MLA的latent kv的思想来压缩indexer key,相比IndexCache有更好的效果。
头压缩: 再例如我们做的MISA,利用moe的思想动态的选择indexer头,但是直接这样选效果也会有比较大的损失,因此结合HISA,显著提升了training free的效果。
这里提一句,Qwen3.8-Flash-Next直接把indexer的头压缩成了4个,效果其实会有一定的损失的,不如MISA+HISA这种动态路由+两阶段效果好。
我们做的DoSA其实也可以理解为一种头压缩版本的HISA,但是由于其第一阶段是无损的加速的,因此是next-level的一个故事了。
block压缩: HISA是在key block压缩作为第一阶段,后面还有混元发的PIVOT压缩query block,压缩query block其实挺好的,只是需要配合MTP才能做decoding。
维度压缩和精度压缩: 目前还没看到有研究降低维度或者数值精度,用来找候选token,大家有看过的可以补充到评论区,如果真的没有,感兴趣的同学可以占个坑。
总结
HISA是一种加速indexer同时,缓解压缩损失的方法。原始版本的特点是block indexer的开销,token attention的效果。这种做法不存在CSA压缩kv cache带来的相位敏感性问题。HISA和其他方法结合就可以得到很多变种,是大家在做indexer压缩时,用于提升效果的一个好的trick。原版HISA的block size取得过大了(128),导致表现不如意,但是将来我们会修改这一点,以及结合一些其他的设计,希望能让HISA重新成为很有竞争力的方法。
阅读 -- 次作者:孟繁续
原文:https://zhuanlan.zhihu.com/p/2094012600119981083
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册