当推理模型需要连续生成几万 token 时,GPU 显存里保存的不只是输入问题,还有不断增长的中间推理历史。对于长链式推理(long-chain reasoning),KV Cache 往往成为限制并发和吞吐的重要瓶颈。
压缩 KV Cache 的常见做法是:先判断哪些历史位置最值得保留,再按照固定预算删除其余 KV。
过去几年,从 attention weight、value magnitude 到 key statistics,不同方法设计了越来越复杂的 importance score。但一个基础问题仍然值得检验:这些内容相关的打分信号,究竟为长推理带来了多少额外收益?
Salesforce AI Research 与伊利诺伊大学厄巴纳-香槟分校(UIUC)的研究人员提出 Random Attention,选择了一个近乎相反的方向:保护完整输入 Prompt,对其余 reasoning KV 不做内容重要性判断,而是在每个 KV head 中随机保留。
实验显示,这种极简策略在四个模型、六个推理任务上的整体准确率与最强的实验基线相近;在相同 KV budget 的 vLLM serving 测试中,相比 TriAttention 还取得 32%–43% 的吞吐提升。
更值得关注的是,论文通过一系列对照实验指出:相比精细的 KV 排名,Prompt 是否完整保留,以及 reasoning trace 自身包含多少冗余信息,可能更直接地决定压缩效果。
论文:Random Attention: Rethinking KV Cache Eviction for Efficient Reasoning
链接:https://arxiv.org/abs/2609.03430
代码:https://github.com/SalesforceAIResearch/Random-Attention
项目主页:https://arthur-heng.github.io/Random-Attention-page/
01|把 importance score 换成随机数
KV Cache eviction 的基本设置并不复杂:对每个 KV head 指定缓存预算 K,随着 decoding 进行,周期性删除一部分历史位置,让 cache 不再随输出长度无限增长。不同于只在当前 query 上跳过某些位置的 sparse attention,被 eviction 的 KV 将无法在后续步骤中再次访问。
SnapKV、R-KV、VaSE、TriAttention 等方法试图以不同线索预测历史 KV 的未来价值。例如,有的方法依赖 attention statistics,有的方法结合 value 或 key 的特征,也有方法将冗余性纳入评分。尽管 score 的来源不同,其共同思路都是优先保留“最重要”的位置。
Random Attention 则遵循两条规则:完整保留输入 Prompt;在每个 KV head 内独立随机保留 reasoning KV。实现时,可以为候选位置生成随机分数,再通过 Top-K 完成筛选,不必访问内容相关的 attention 或 KV 统计量。
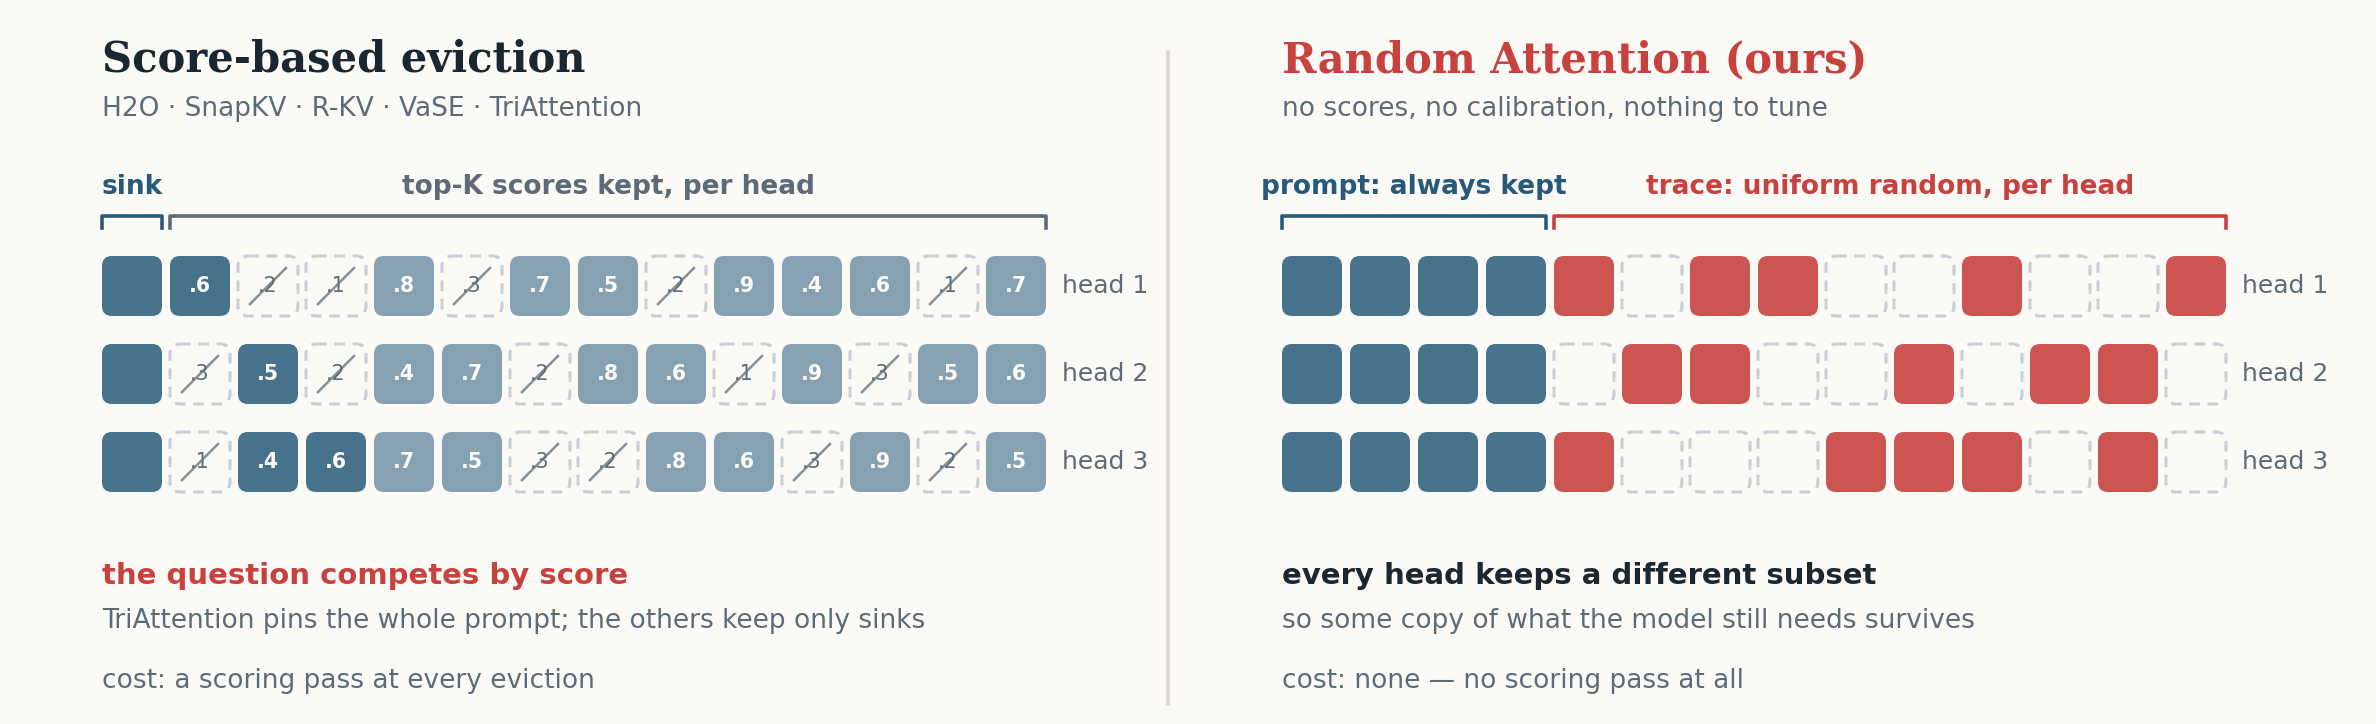
这个看似简单的 baseline 实际上提出了一个清晰的对照:如果一个更复杂的 selection signal 无法在相同预算、相同保护条件下稳定优于随机选择,那么它额外提供的有效信息究竟有多少?
需要说明的是,论文主要比较的是 无需额外训练、在推理阶段执行 eviction 的方法,并未系统比较通过训练或蒸馏得到的 learned selector。其结论不应推广为所有 KV selection 方法都不需要内容相关信号。
02|四个模型、六个任务:随机策略并不弱
研究在 Qwen3-4B、Qwen3-14B、Qwen3-32B 和 Phi-4-reasoning 上开展评测,覆盖 MATH500、GPQA-Diamond、AIME 2025、AIME 2026、HMMT 与 LiveCodeBench 等数学、科学和代码任务。
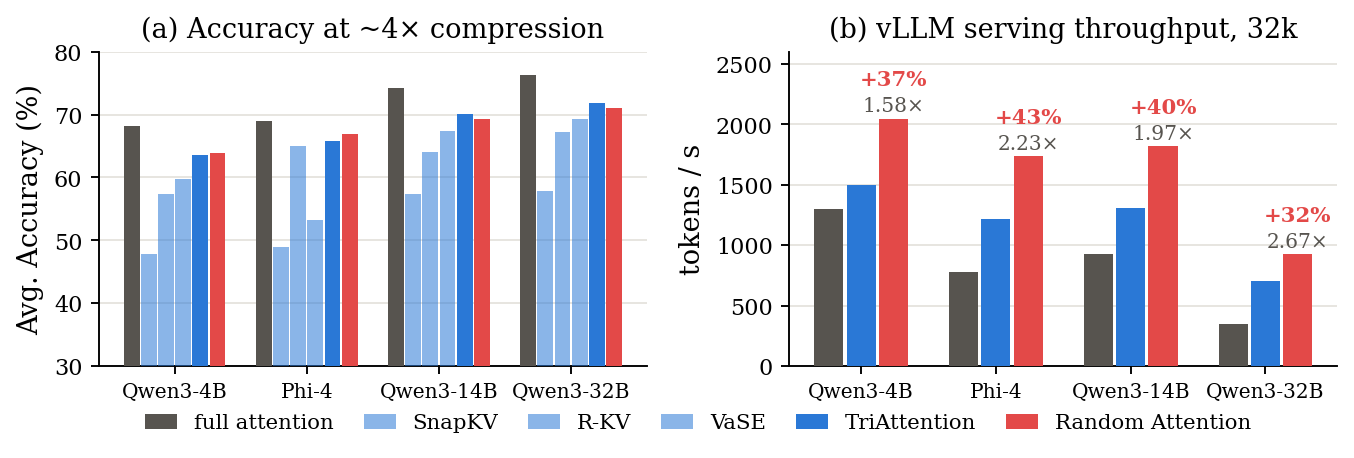
主实验在约 4× KV Cache 压缩下比较方法性能,LiveCodeBench 约为 3×;每个任务采用相同的 per-head KV budget,最大生成长度为 32k tokens。
在论文主结果表涉及的三个模型中,Random Attention 与四个 baseline 构成 60 组配对比较。其中,Random Attention 显著领先 31 组,显著落后仅 1 组。
唯一显著落后的主实验设置是 Qwen3-32B 的代码推理,TriAttention 约领先 3 个百分点。Qwen3-14B 的附录结果总体延续了随机方法的竞争力,但也存在其他方法显著领先的个别任务。
论文还将压缩因子从 2× 逐步提高到 16×,检验这种现象是否只在较宽松的缓存预算下成立。
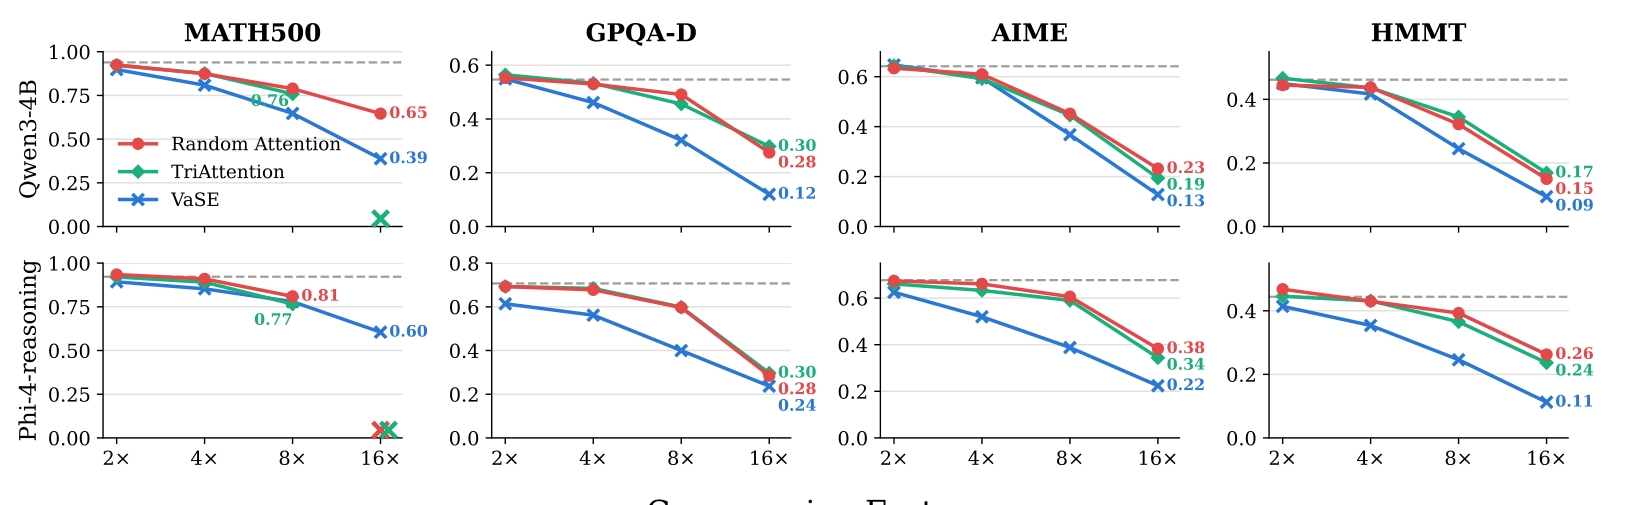
随着预算收紧,Random Attention 与 TriAttention 仍然保持相近的推理表现;与之相比,VaSE 在更高压缩率下出现更明显的下降。由此,研究者进一步转向机制问题:为何没有内容判断的随机策略,能够在长推理中保留足够有用的信息?
03|控制 Prompt protection,结果发生了什么变化?
一个容易忽略的实验变量是:不同 eviction 方法对 Prompt 的处理并不相同。
对于长推理,KV Cache 大体包含两部分:用户提供的输入问题,以及模型自己不断生成的 reasoning trace。两者在信息结构上有重要区别:Prompt 往往只出现一次,而模型在推理中可能反复写出当前变量、已知条件和阶段性结论。 如果输入条件被永久 eviction,后续生成未必有机会将它恢复。
TriAttention 与 Random Attention 都默认完整保护 Prompt;SnapKV、R-KV 和 VaSE 的原有设置则主要根据各自的 score 决定输入位置是否保留。因此,直接比较它们的最终 accuracy,可能同时混合了两种因素:selection signal 的质量,以及原始问题有没有被保住。
研究者做了一个受控实验:给不同方法统一加入完整 Prompt protection,再比较剩余的 selection score。
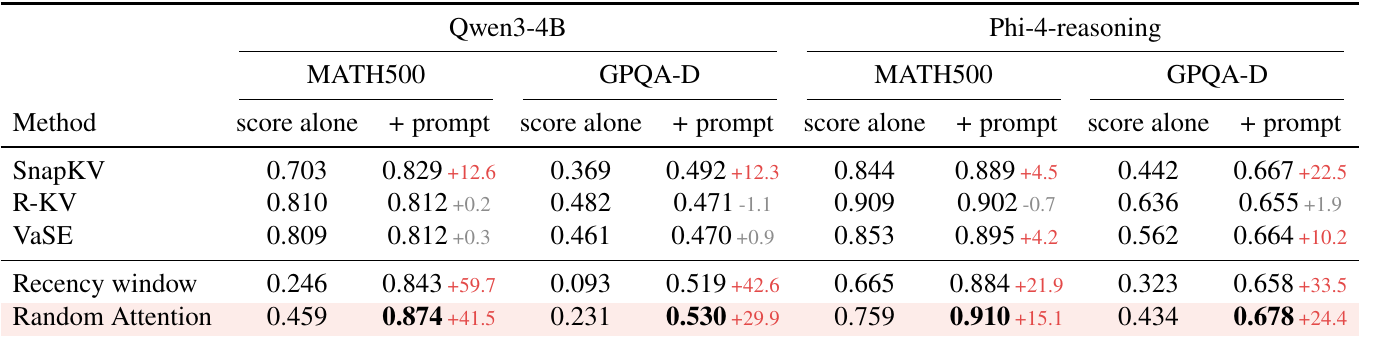
结果非常明显。SnapKV 在四个代表性设置中的准确率分别提升 12.6、12.3、4.5 和 22.5 个百分点;VaSE 在 Phi-4-reasoning 上提升了 4.2 和 10.2 个百分点。相比之下,R-KV 的提升始终不超过 1.9 个百分点,个别设置还略有下降。
统一保护 Prompt 之后,三种 baseline 在这些设置中的最终结果相差都不超过 2.2 个百分点。
不依赖复杂 scoring 的 recency window 也展示了类似现象。在 Qwen3-4B 的 GPQA-Diamond 上,如果不保护 Prompt,单纯的 recency window 只有 9.3% accuracy;加入完整保护后,可以提升至 51.9%。
这说明,部分方法原本较大的性能差距,并不完全来自“谁更会判断 reasoning KV 的重要性”,而是与 Prompt 是否完整保留有关。
当然,Prompt protection 并不能解释全部现象。TriAttention 从一开始就和 Random Attention 一样完整保护输入,但后者仍可达到相近准确率。因此,还需要解释 reasoning trace 本身为什么能承受随机删除。
04|Reasoning trace 的两种冗余:文本重述与跨 head 副本
论文将 reasoning trace 的容错性归纳为两层 redundancy。
第一层是文本冗余。 长推理并非一份只记录一次、以后从不重复的日志。模型经常重新表述仍在使用的信息,例如变量数值、已经得到的结果、下一步需要满足的约束。即使早期某个 KV 消失,后面的 trace 仍可能包含同一信息的其他表达。
第二层是 KV head 之间的冗余。 同一个历史 token 会在多个 KV head 中留下表示。Random Attention 按 head 独立选择,因此即使某些 head 删除了某个位置,其余 head 中仍可能存在可用的表示。
为了直接验证跨 head 冗余的作用,研究者设计了一个 planted-fact probe。 实验将一个随机事实(如 zq = 4729)插入真实 MATH500 推理文本,随后经过 1536 个 token 和 15 轮 eviction,再要求模型读出这个值。通过人为控制该事实在哪些 KV head 中被保留,可以观察不同 head 的信息如何共同支持事实恢复
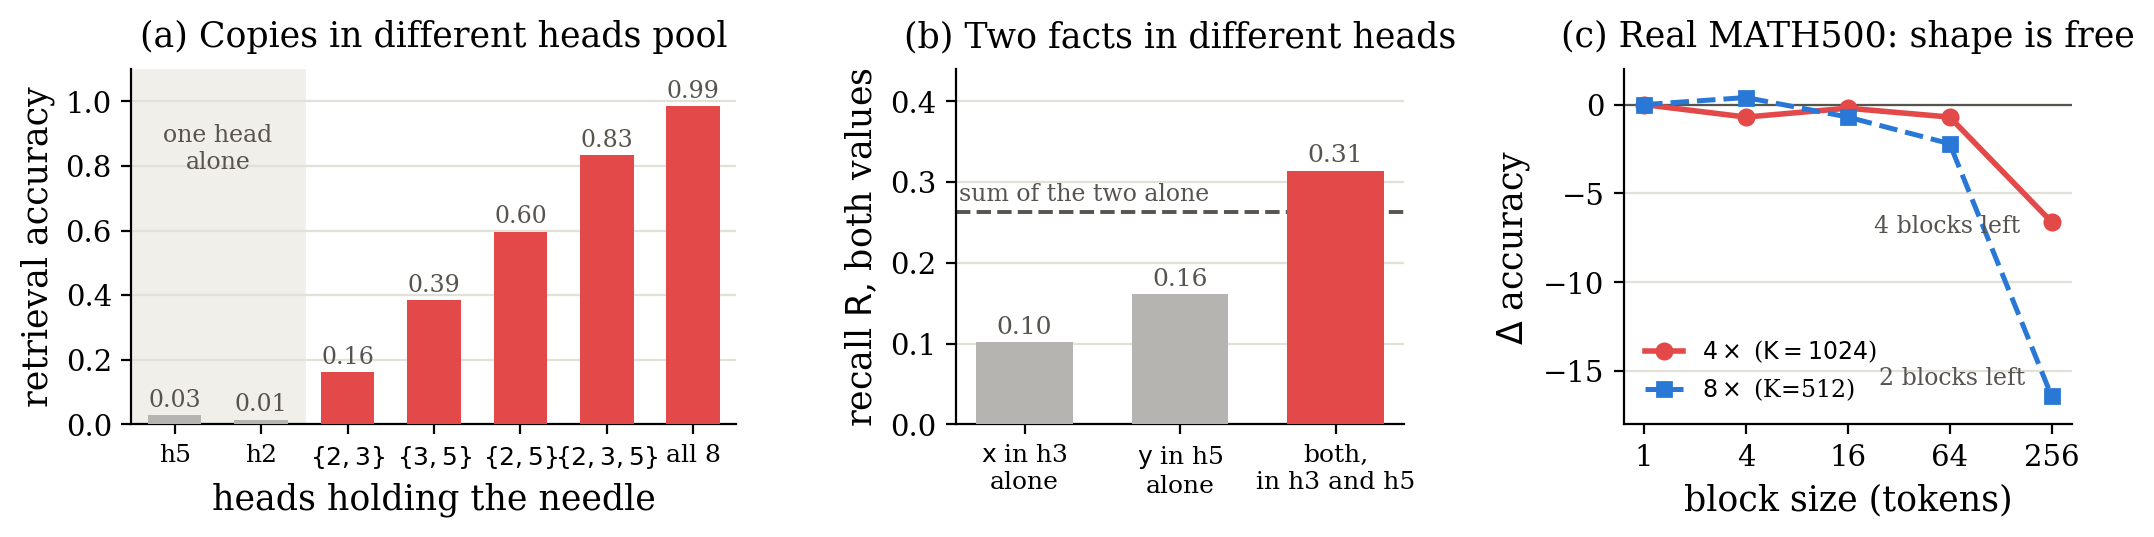
在 Qwen3-4B 的 8 个 KV head 中,仅让单个 head 保存事实时,最好的 retrieval accuracy 只有 3%;特定两个 head 同时保存时达到 60%,三个 head 达到 83%,八个 head 全保留时达到 99%。
进一步的实验表明,不同 head 中分别保存的事实也可以通过后续计算被组合利用;将保留位置从零散 token 改为连续 block,block size 从 1 增长到 64 时,真实 MATH500 的 accuracy 也基本保持稳定,直到极大的 block 才明显下降。
不过,论文的另一个控制实验提供了更细的解释:强制所有 head 使用同一组随机保留位置,真实 MATH500 的准确率几乎没有变化。 例如在 Qwen3-4B 的 K=1024 设置下,独立采样与共享采样分别为 87.4% 和 87.1%;K=512 时分别为 78.9% 和 78.8%。
这意味着在所测试的真实数学推理中,文本层面的重复表达可能已经提供了足够强的保护;跨 head 冗余则在事实本身不被重述时更有价值。 两种冗余不必同时是性能的必要条件,而可以在不同场景下相互补充。
05|随机并非没有偏好,且存在明确失效场景
Random Attention 的随机性也不等于所有历史位置始终拥有相同的生存概率。
每次 eviction 时,新生成的 reasoning token 才开始进入候选集合,而较早的 token 需要连续通过多轮随机选择。因此,旧位置的生存概率会随经历的 eviction 次数逐渐下降。在论文的一个设置中,其衰减可以近似写成 0.94ⁿ,其中 n 为经历的压缩轮数。
因此,它实际形成了一种带有稀疏历史长尾的 soft recency window:近期 reasoning 更容易留下,较旧的信息以一定概率分散保存在各个 head 中。
但这也引出一个问题:如果某个事实只出现一次,之后从未被重新陈述,随机选择还能保住它吗?
研究者构造了一个 passcode probe:一个随机密码在较早的 reasoning history 中只出现一次,经过 57 次 cache compression 后才要求模型重新输出。
这次结果完全不同:Random Attention 的 retrieval accuracy 为 0%,R-KV 达到 83.6%,VaSE 为 34.4%,TriAttention 和 SnapKV 则分别约为 1.6% 与 0.4%。
R-KV 在这一极端场景中体现了内容相关 selection signal 的价值。不过,它并非整体 reasoning benchmark 中表现最强的基线;而整体表现较强的 TriAttention,在 passcode probe 中却几乎无法找回孤立信息。
长期找回单个事实的能力,并不直接等同于整体推理任务上的表现。 当模型会反复重述有用内容时,随机保留可以依赖冗余工作;当信息只出现一次、又必须在很久之后重新访问时,更有针对性的 selection signal 就可能十分重要。
06|为什么简单的 selector 能让 vLLM 更快?
Random Attention 的另一项收益来自 serving 系统。在单张 H200 上,研究者将其集成到 vLLM PagedAttention,与 TriAttention 使用相同的 KV budget、attention kernels、scheduler 和 compression trigger,主要改变 eviction selector。
测试设置包含 K=2048、1k-token Prompt、32k-token generation。四个模型上,Random Attention 分别达到 2046、1737、1819 和 923 output tokens/s,较 TriAttention 提升 37%、43%、40% 和 32%。
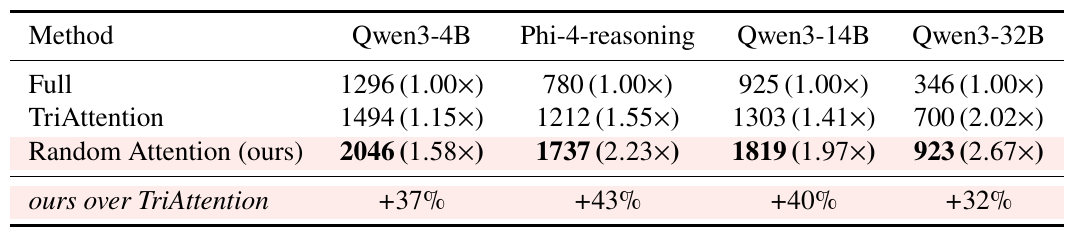
吞吐提升并不只是因为省去了 importance scoring 的计算,更重要的是避免了 content-dependent selector 在 paged serving 中额外访问 KV 状态,以及由此带来的反复同步等待。
首先,长生成会不断触发 compression。在并发 workload 中,不同 request 的压缩操作发生在 batched decoding 的同步点。即使单次 scoring 增加的时间不长,它也会让整个 batch 等待。论文的 128-request 工作负载中,累计发生了约 6.2 万次 compression。
其次,content-dependent selector 需要额外访问 cached KV 或 attention statistics。依赖 KV 特征的方法要遍历 paged KV state;依赖 attention weights 的方法则需要重新计算或显式暴露 fused attention kernels 默认不会保存的统计量。
相比之下,Random Attention 不需要这些内容相关的读取,只执行随机选择以及其他 eviction 方法也要完成的 cache compaction。
单独测量一次 eviction,Random Attention 约为 0.30 ms,TriAttention 则为 1.47–1.64 ms。单流解码下,这部分差别只占总体运行时间的几个百分点;但在高并发的长生成中,重复的 scoring pass 会不断落到服务关键路径上。
这解释了一个看似反常的现象:删除更复杂的选择逻辑,不只是简化算法,还可以减少 paged KV 的额外访问和反复出现的同步等待。
07|从“哪些 KV 分数更高”,到“哪些信息丢失后无法恢复”
Random Attention 的意义不在于证明所有重要性选择都无效。论文恰好展示了两类相反的情形:在有大量重复表达的数学、科学推理中,随机策略已经足够有竞争力;在长期保存一次性孤立事实的任务中,特定 selection signal 则可能显著优于随机保留。
这些结果提示,未来的 KV Cache 管理也许值得从单纯的 token importance ranking,进一步转向信息可恢复性:哪些内容可以从后续 reasoning 中重新获得,哪些内容一旦删除就无法再找回?
完整保护 Prompt 是一个有效但并非一劳永逸的选择。论文指出,LiveCodeBench 的 Prompt 平均约 557 tokens,是 MATH500 的约六倍;当输入本身很长时,永久保护全部 Prompt 会消耗可观的缓存预算。更聪明的方法能否区分其中可压缩的格式描述与真正不可恢复的任务条件,仍值得探索。
同样,文章中的主要比较限于无需额外训练的 decode-time eviction 方法。未来若引入 learned selector,在一致的 Prompt protection、KV budget 和 serving 条件下,能否同时做到更好的低冗余信息保留和更高的系统效率,也是尚未回答的问题。
Random Attention 提供的关键参照是:在设计更复杂的 KV selection signal 之前,先弄清楚该信号相较于“保护输入 + 随机保留历史”究竟带来了什么。
对于越来越长的 reasoning trace,问题可能不只是“哪些历史 KV 最重要”,而是“哪些信息值得付出额外的计算与存储成本去保留”。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册