一张表格,经过 OCR 和结构解析,变成了整齐的 Markdown。数字看起来齐全,语法也没有问题,但模型仍可能算出一个错误答案:它用到的数字,属于另一组表头;问题限定的高亮单元格,在转换后已经失去了颜色;决定数值含义的单位和脚注,也可能没有进入输入。
当证据在转成文本的过程中发生了变化,后续推理再流畅,也可能建立在错误的信息之上。
来自中国人民大学的研究团队提出的 MERIT(Multimodal Evidence Reasoning over Image Tables),从这个问题出发,把表格原图作为主要证据来源,并在有序列化表格时将其作为辅助输入。基于 Qwen3-VL-8B-Instruct,MERIT 将表格视觉适配、证据驱动的监督微调与可验证强化学习串联起来,让模型学习从图像中读表、找到相关单元格,再完成计算与判断。
在论文的五个表格问答与事实验证数据集上,MERIT 仅输入表格图像时达到 85.45% 的平均准确率,较原始骨干提升 9.40 个百分点;结合图像和文本时,平均准确率进一步达到 86.70%。
论文:MERIT: Multimodal Evidence Reasoning over Image Tables
链接:https://arxiv.org/abs/2610.17937
01 从表格图像到文本,哪些证据容易丢失?
表格问答的一条常见路线,是先把表格整理成 HTML、JSON 或 Markdown,再让语言模型读取这些文本并回答问题。这条路线通常依赖一个前提:转换后的表示,已经准确保留了解题需要的信息。
现实中的表格却经常藏在 PDF、扫描件、截图和网页中。将这些表格转成文本,需要同时处理字符识别、结构恢复和上下文关联。任何一个环节出现偏差,都可能改变模型看到的证据。
论文将这些问题概括为四类:内容错误、结构错误、视觉线索丢失,以及上下文丢失。数字可能被误读或遗漏,数值可能被挂到错误的表头下,多级表头和合并区域的关系可能没有被正确表达,颜色、阴影、单位与注释也可能未被保留。
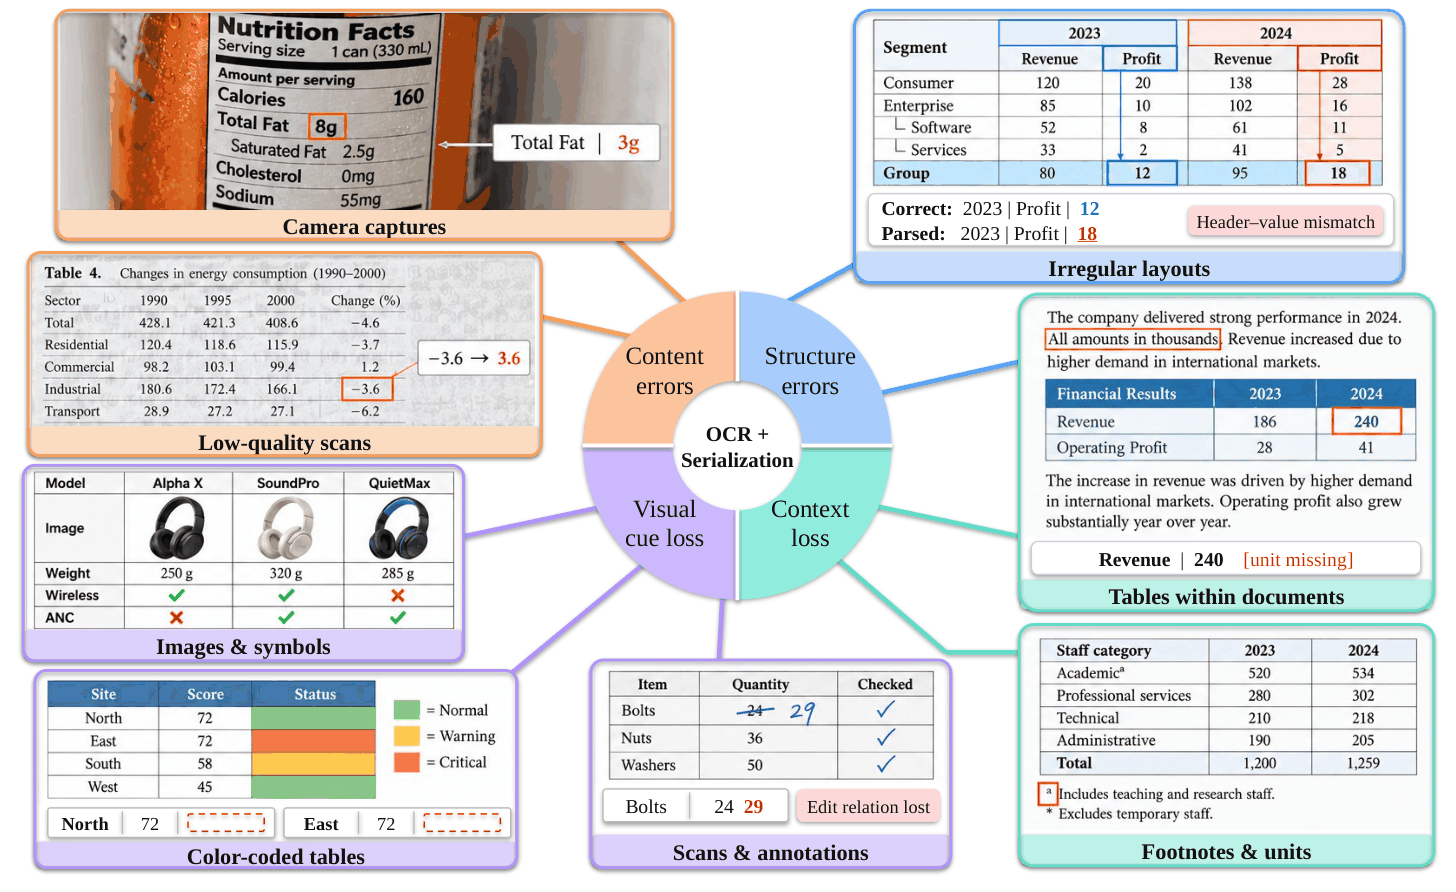
图 1:OCR 与表格序列化的常见失误。原图中仍可辨认的内容、空间关系与视觉线索,可能没有完整进入转换后的文本。来源:论文 Figure 1。
这里值得关注的是,转换结果即使存在问题,也可能保持合法、整齐的格式。下游模型未必知道自己拿到的表格已经错了,仍会继续查找、比较和计算。
表格原图因而提供了一个直接的补充:当结构化文本不可用时,模型可以从图像中获取证据;当文本可用但不完整时,原图中的行列位置、表头分组和视觉属性,也能帮助模型重新判断这些数值的含义。当然,这要求模型首先能够准确读懂表格图像。
02 图像保留了证据,模型能读出来吗?
把表格图片交给通用视觉语言模型,并不意味着问题已经解决。密集小字、相似数字、多层表头和精细的行列对应,都对视觉感知提出了要求。
为了理解证据获取的作用,研究者在 FinQA 上进行了一组受控实验:将 Qwen2-VL 的 NaViT 编码器,以及经过文档与表格训练的 MinerU 2.5 编码器,分别连接到同一个 Qwen3 解码器上。
在通常的图像输入条件下,两者的准确率分别为 57.8% 和 72.2%,相差 14.4 个百分点。而当研究者直接提供解题所需的正确支持事实(Gold Facts)时,两者的准确率分别为 79.8% 和 79.6%,差距基本消失。
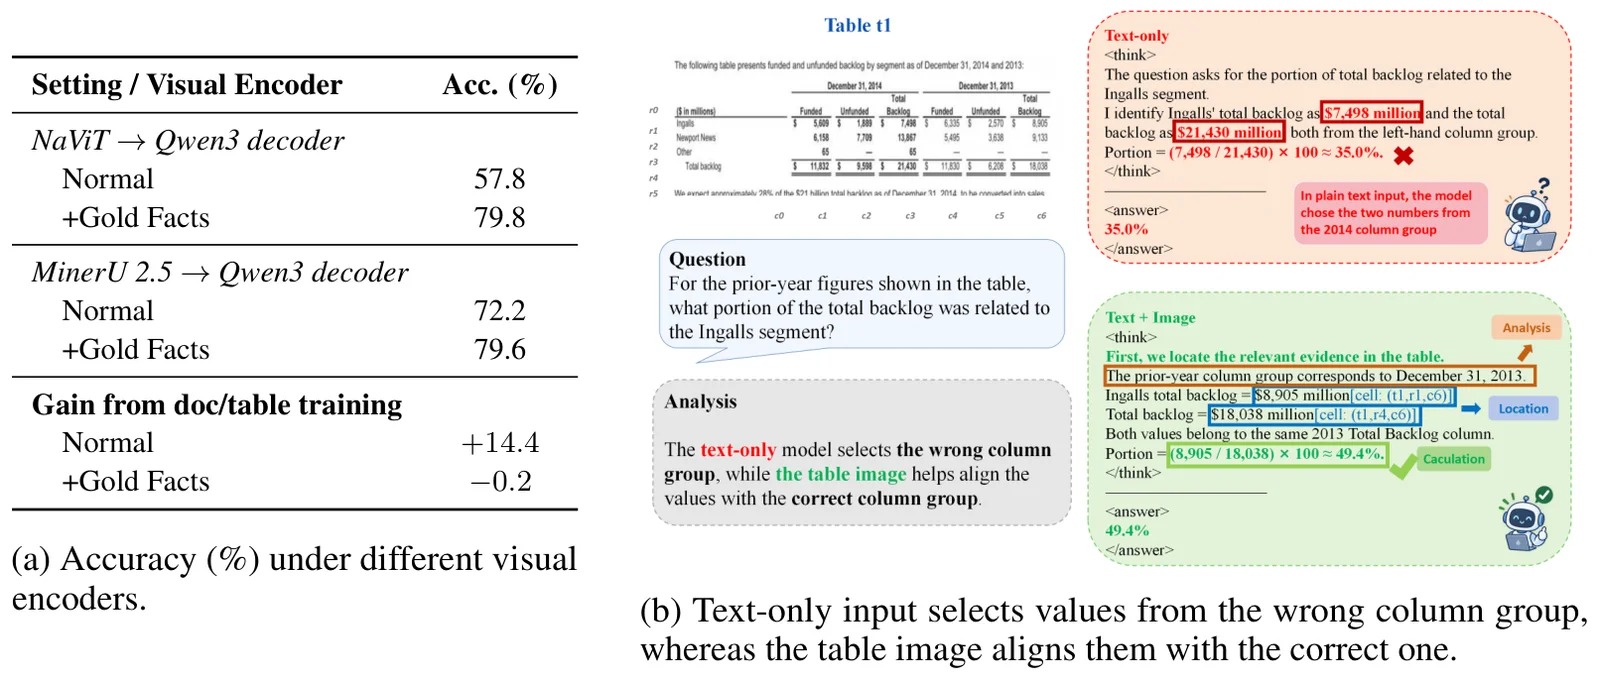
图 2:固定语言解码器后,编码器之间的差距在提供正确支持事实时基本消失。这提示视觉证据获取是值得优先改善的环节。来源:论文 Figure 3。
这组实验提示:模型表现受限时,一部分问题出在获取正确证据的环节;一旦证据被直接提供,后续推理能够完成得更好。它也为 MERIT 的第一步提供了动机——对视觉编码器进行专门的表格适配。
进一步的错误分析,让这个问题更加具体。研究者在 1,495 条纯图像 IID 样本和 486 条颜色探针问题上,将错误归为定位、内容识别、颜色、推理和问题理解五类。Qwen3-VL-8B 的 405 个错误中,前三类感知错误共有 167 个,约占四成。
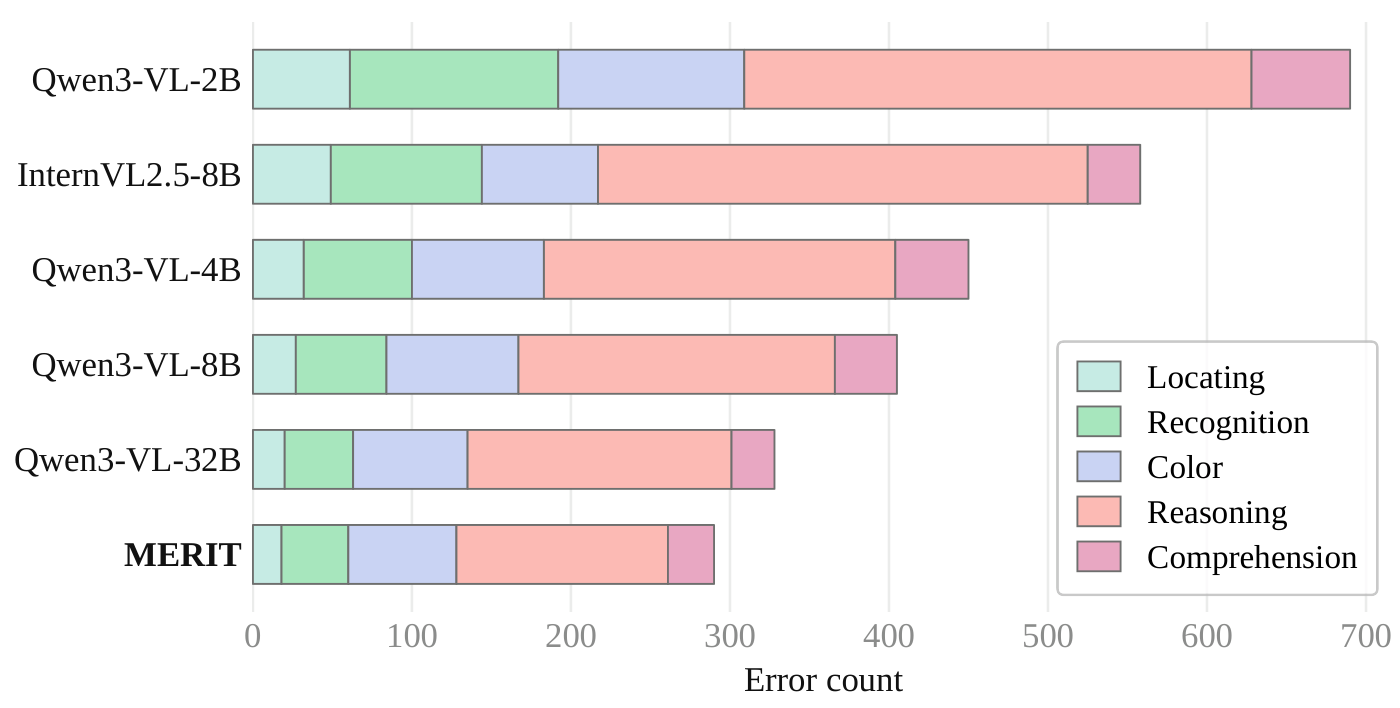
图 3:通用视觉语言模型与 MERIT 的错误类型分布。横轴为这组分析样本上的错误数量,涵盖定位、识别、颜色、推理和问题理解五类;该统计结合了 IID 子集与颜色探针。来源:论文 Appendix C.1、Figure 5(a)。
完成三阶段训练后,MERIT 在这组样本上的错误总数降至 290 个,低于 Qwen3-VL-32B 的 328 个。其内容识别错误从 57 降至 42,定位错误从 27 降至 18,推理错误也从 199 降至 133。这个变化与 MERIT 的整体设计相呼应:既改善表格感知,也训练模型围绕证据完成推理。
但论文随后发现,感知能力提升,并不会自动变成端到端问答能力的提升。模型还需要学习:当前问题需要哪些单元格,以及这些证据该如何参与计算和判断。MERIT 的三阶段训练由此展开。
03 MERIT:从读懂表格,到用对证据
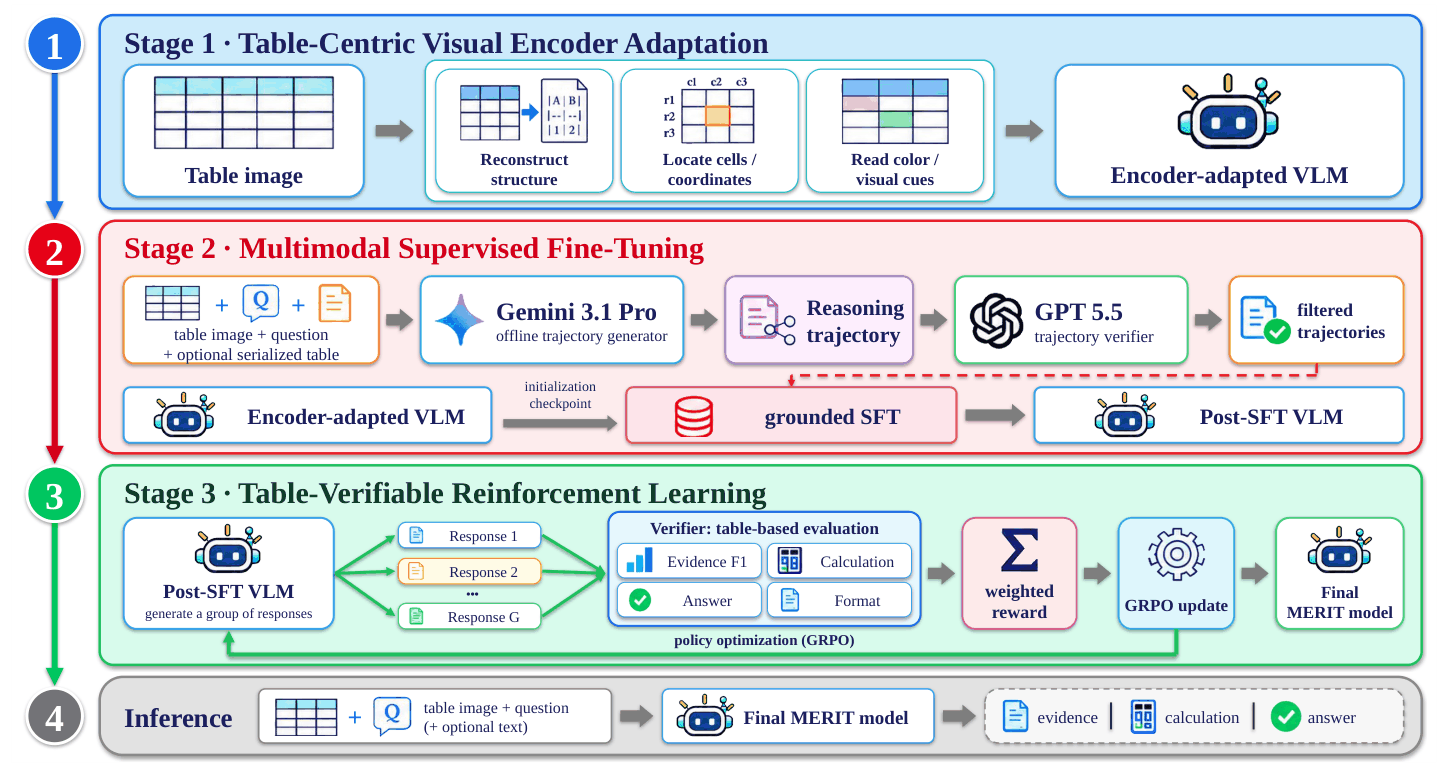
图 4:MERIT 首先进行表格视觉适配,再通过经过核验的示范学习证据选择与推理,最后用分解后的可验证奖励优化生成结果。来源:论文 Figure 2。
第一步:围绕表格特征,适配视觉编码器
MERIT 使用 Recon、Locate 和 Color 三类任务,为视觉编码器提供有针对性的监督。
Recon 关注内容与结构的整体恢复。 模型需要从表格图像重建文本表格,学习密集文字识别以及表格组织关系的保留。
Locate 关注视觉位置与逻辑坐标的对应。 训练围绕单元格、行和列提出查询,例如寻找指定行列的内容,或定位给定数值所在的位置,让模型把“读到了什么”和“它在哪里”联系起来。
Color 关注影响证据选择的视觉属性。 研究者随机给部分单元格设置背景色,再构造依赖这些颜色的问题,例如询问某种颜色单元格中的值。由于颜色独立于单元格数值随机分配,模型需要读取图像中的颜色信息才能作答。
这一阶段训练视觉编码器,冻结语言解码器。在六项表格结构理解任务上,适配后的宏平均得分从 46.89 提升到 53.51,其中单元格提取、定位和行列提取等能力均有所改善。
第二步:用经过核验的示范,教模型选择证据
视觉适配之后,模型需要进一步学习完整的解题过程。MERIT 通过多模态监督微调,将问题、相关单元格、计算和答案连接起来。
示范数据的构建分为生成与核验两步。Gemini 3.1 Pro 根据表格图像、结构化表格、单元格元数据、问题和标注答案,离线生成推理轨迹。轨迹显式记录相关单元格的逻辑行、列与数值,并在查找、比较、计算或事实判断之前,核对引用内容。
随后,GPT-5.5 独立检查三项内容:证据是否与源表格一致、推导是否有效、最终答案是否正确。只有同时通过三项检查的轨迹,才进入 SFT 数据集。
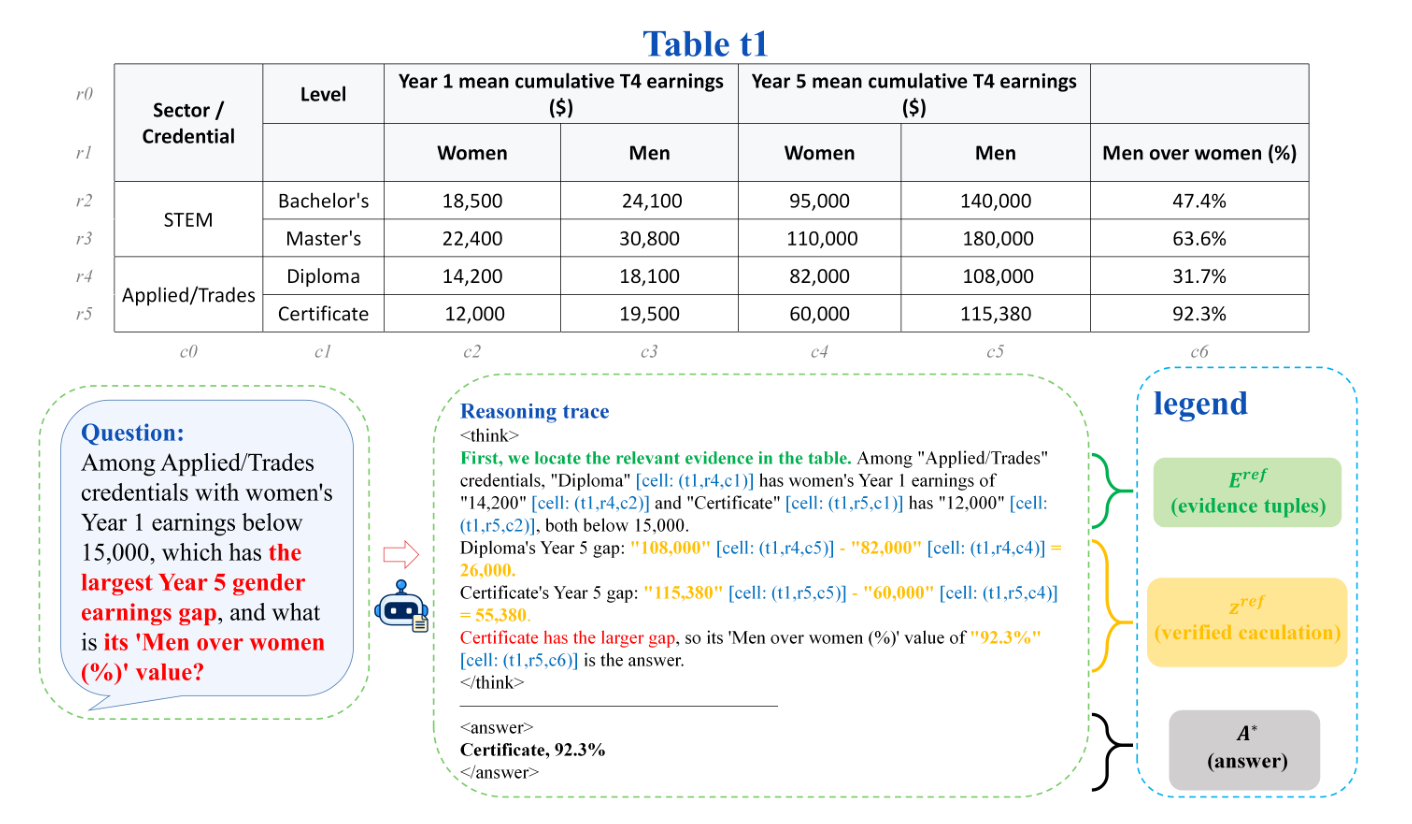
图 5:推理轨迹将支持单元格、计算与答案显式关联,为后续分别检查证据和计算提供接口。示例省略了部分中间步骤。来源:论文 Figure 4。
经过这一步,模型获得了证据驱动的解题示范,也学会了可解析的输出格式。该阶段冻结适配后的视觉编码器,训练语言解码器,为后续强化学习提供初始化。
第三步:分别检查证据、计算与答案
只根据最终答案给予奖励,能够判断一道题是否答对,却难以区分中间发生了什么:模型可能取错了单元格,也可能取值正确但计算错误。
MERIT 使用 GRPO 进一步训练,并将奖励拆成四个部分:
| 奖励项 | 检查什么 |
|---|---|
| 证据奖励 | 比较预测与参考证据单元格的集合 F1;行、列和归一化数值均匹配,才算命中 |
| 计算奖励 | 对算术题执行生成的计算表达式,与参考计算的归一化数值结果比较 |
| 答案奖励 | 对答案进行文本或数值归一化后,与标注答案比较 |
| 格式奖励 | 检查要求的证据、答案及适用时的计算字段能否解析 |
四项奖励加权后用于更新策略;非算术题不启用计算奖励。这一阶段同样冻结视觉编码器,更新语言解码器。
这样的设计,使训练反馈能够落到模型引用的单元格和显式计算上。当答案错误时,证据选择和数值计算都能获得各自的监督信号。
04 实验:原图带来了多少帮助?
论文在 TABMWP、WTQ、TAT-QA 三个表格问答数据集,以及 TabFact、InfoTabs 两个事实验证数据集上进行评测,报告五个数据集准确率的非加权平均。
| 方法或输入设置 | 五数据集平均准确率(%) |
|---|---|
| 原始 Qwen3-VL-8B | 76.05 |
| TURBO(论文报告结果) | 81.09 |
| Qwen3-8B + RL,文本基线 | 82.62 |
| MERIT,仅文本 | 83.42 |
| MERIT,仅图像 | 85.45 |
| MERIT,图像 + 文本 | 86.70 |
同一 MERIT 检查点的三种输入设置见原论文 Table 2。TURBO 的数值引用自其已发表结果,沿用原评测协议;其余列示结果来自本文评测。
仅使用表格图像,MERIT 就比原始骨干提升 9.40 个百分点,并超过表中的文本 RL 基线。 这一结果说明,经过针对性训练,表格图像可以独立支持较强的问答与事实验证能力。
图像也能补充文本。同一个 MERIT 检查点仅输入文本时,平均准确率为 83.42%;加入图像后达到 86.70%,提高 3.28 个百分点。在论文报告的这组评测中,图文输入的平均结果也接近 GPT-5.5 的 86.96%。
这种补充作用可以在具体案例中看到:面对跨年份的数值比较,文本输入下的模型可能把数值对应到错误的日期或余额类别;加入原图后,模型能够借助表格中的行列布局重新对齐证据。
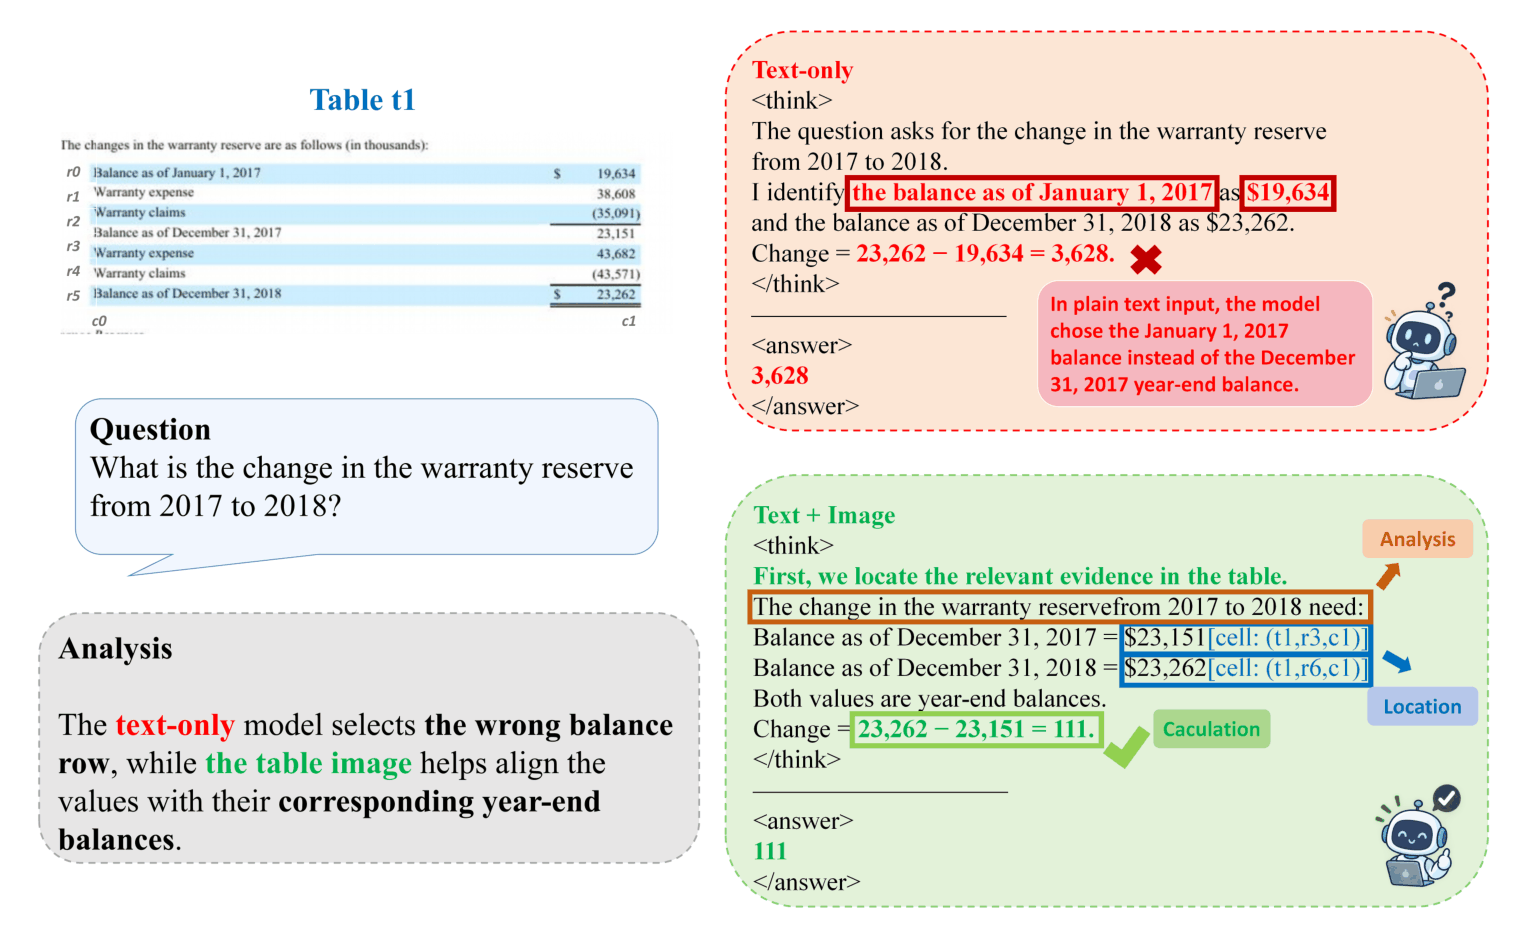
图 6:论文中的跨年份比较案例。图像提供的布局信息帮助模型将数值与对应行正确关联。来源:论文 Figure 6。
换到未参与训练的数据集,效果如何?
研究者进一步在 HiTab、FinQA、FinMMR、TableVista 和 MMMU-T 上直接评测,没有针对这些数据集继续微调。MERIT 的平均准确率达到 54.90%,较 Qwen3-VL-8B 的 52.27% 提高 2.63 个百分点,其中 FinMMR 从 33.02% 提升至 48.67%。
这里的输入设置需要明确:HiTab 和 FinQA 提供序列化表格;其余三个数据集由 MinerU 2.5 将图像转成 Markdown,视觉模型同时接收原图和文本。这组实验考察的是不同表格结构与视觉呈现下的迁移能力,以及缺少现成序列化表格时的表现。
提升也存在差异:MERIT 在 FinQA 和 MMMU-T 上的结果低于原始骨干。整体收益体现在跨数据集的平均表现和部分任务上。
05 为什么需要三个阶段?消融给出的答案
MERIT 的一个关键发现,是感知训练与推理训练需要衔接。
| 训练配置(均为纯图像输入) | 平均准确率(%) |
|---|---|
| 原始模型 | 76.05 |
| 仅视觉适配 | 76.07 |
| SFT + GRPO,无视觉适配 | 84.50 |
| 视觉适配 + SFT | 83.34 |
| 视觉适配 + SFT + GRPO | 85.45 |
视觉适配改善了表格结构理解,但单独使用时,问答准确率几乎没有变化;它在完整后训练流程中的作用更清楚:三阶段模型比没有视觉适配的 SFT + GRPO 高 0.95 个百分点,比视觉适配 + SFT 高 2.11 个百分点。
奖励消融则显示,完整奖励相对仅答案奖励,将平均准确率从 85.01% 提高到 85.45%,增益为 0.44 个百分点。这部分提升幅度较小,说明中间反馈带来了进一步收益;整体 9.40 个百分点的提升来自完整训练流程,不能全部归因于奖励分解。
06 面向真实表格推理,把证据获取纳入训练
MERIT 将表格理解中的两个环节连接起来:先从原图中获取内容、结构与视觉证据,再围绕问题选择单元格并完成推理。三阶段训练分别为表格感知、解题示范和生成结果优化提供监督。
当表格存在于截图、PDF 或扫描件中,结构化文本的质量往往难以保证。让模型能够直接利用原图,并显式引用和检查解题证据,为这类场景提供了一条可行路线。序列化文本可用时,它仍能作为辅助信息,与图像共同支持推理。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册