只有 1.7B 参数,却在双臂操作基准上超过 6B、8B 模型;四个操作基准,全部拿下论文对比方法中的最高整体成功率。
世界动作模型(World Action Model,WAM)的竞争,迎来了一条值得关注的新路线。
当不少研究还在借助预训练视频模型学习动作与未来画面时,香港中文大学(深圳)团队推出 UNITAS,直接把建模重心放到三维交互本身:让机器人在具有真实尺度的三维空间中,同时学习怎样行动、行动又会怎样改变世界。
这一次,亮点既在路线,也在成绩。LIBERO 成功率达到 99.8%;RoboTwin 2.0 双臂任务中,UNITAS 以约为 Motus 五分之一的参数量,超过 6B 的 Fast-WAM 和 8B 的 Motus;在动作条件场景预测中,相比 PointWorld,移动点平均轨迹误差进一步降低约 35%。
动作生成与场景预测,两头一起推进。UNITAS 把 WAM 的想象空间,从未来画面进一步推向了可度量的三维运动。
拿起一个杯子,夹爪要移动多远,杯子会跟随多少,桌面能否保持不动?UNITAS 用共享的三维点轨迹,把机器人的动作与环境响应连接起来。这正是它的核心主张:让模型直接学习物理交互中的空间变化。
推理与评测代码已开源,模型权重同步开放。这条三维原生 WAM 路线,已经可以上手体验。
论文标题:UNITAS: A 3D-Native World Action Model for Embodied Manipulation
论文地址:http://arxiv.org/abs/2610.12099
项目主页:http://unitas-wam.github.io/
开源代码:http://github.com/DexForce/UNITAS
模型权重:http://huggingface.co/RobbinWang123/Unitas
01 从操作结果看三维建模的潜力
UNITAS 的评测覆盖长程操作、双臂协作,以及相机与机器人初始状态变化等场景。在论文报告的设置下,主要结果如下:
- LIBERO:99.8%,其中长程任务子集 LIBERO-10 为 99.4%。
- LIBERO-Plus:89.1%,测试覆盖相机、机器人初始状态等七类扰动。
- RoboTwin 2.0:92.94% / 93.04%,分别对应 Clean 与 Randomized 设置。
- VLABench:56.2%,比 π₀.₅ 高 8.1 个百分点。
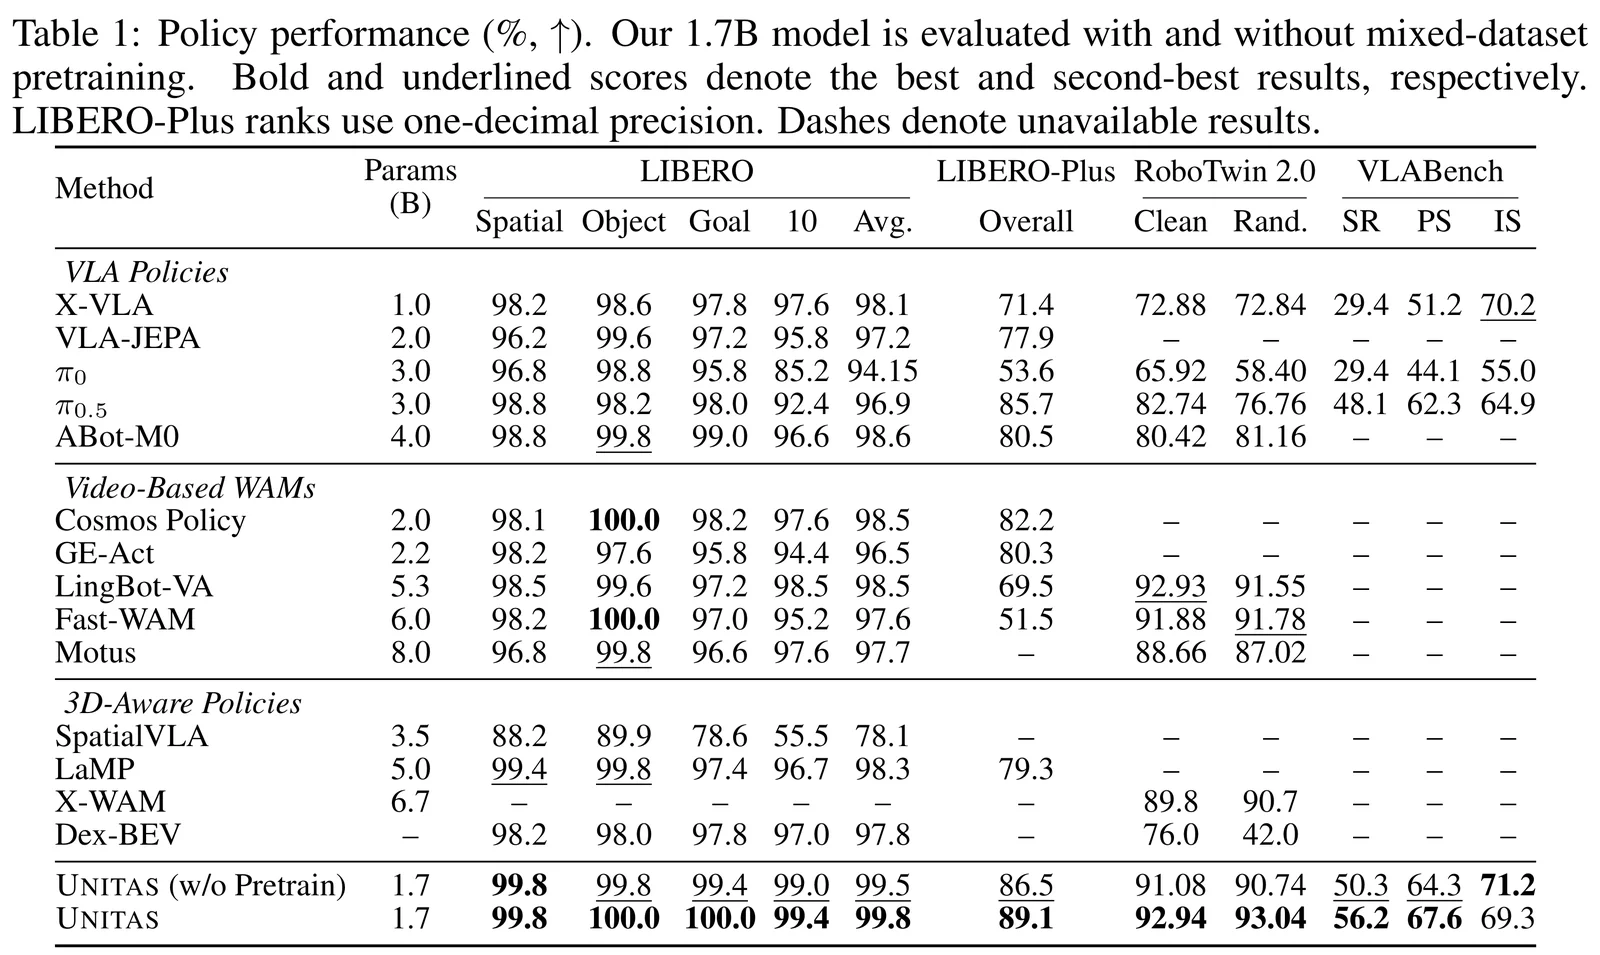
论文表 1|UNITAS 与对比方法在四个操作基准上的结果。
在 RoboTwin 2.0 的双臂任务中,1.7B 的 UNITAS 超过了 6B 的 Fast-WAM 和 8B 的 Motus。其参数量约为 Motus 的五分之一。对于 WAM 研究,这组结果说明:围绕三维交互设计表示与学习目标,也能成为提升操作能力的一条有效路径。
真机实验进一步考察了两类较复杂的操作:将书本对齐后放上书架,以及把球装进袋子并拉上拉链。
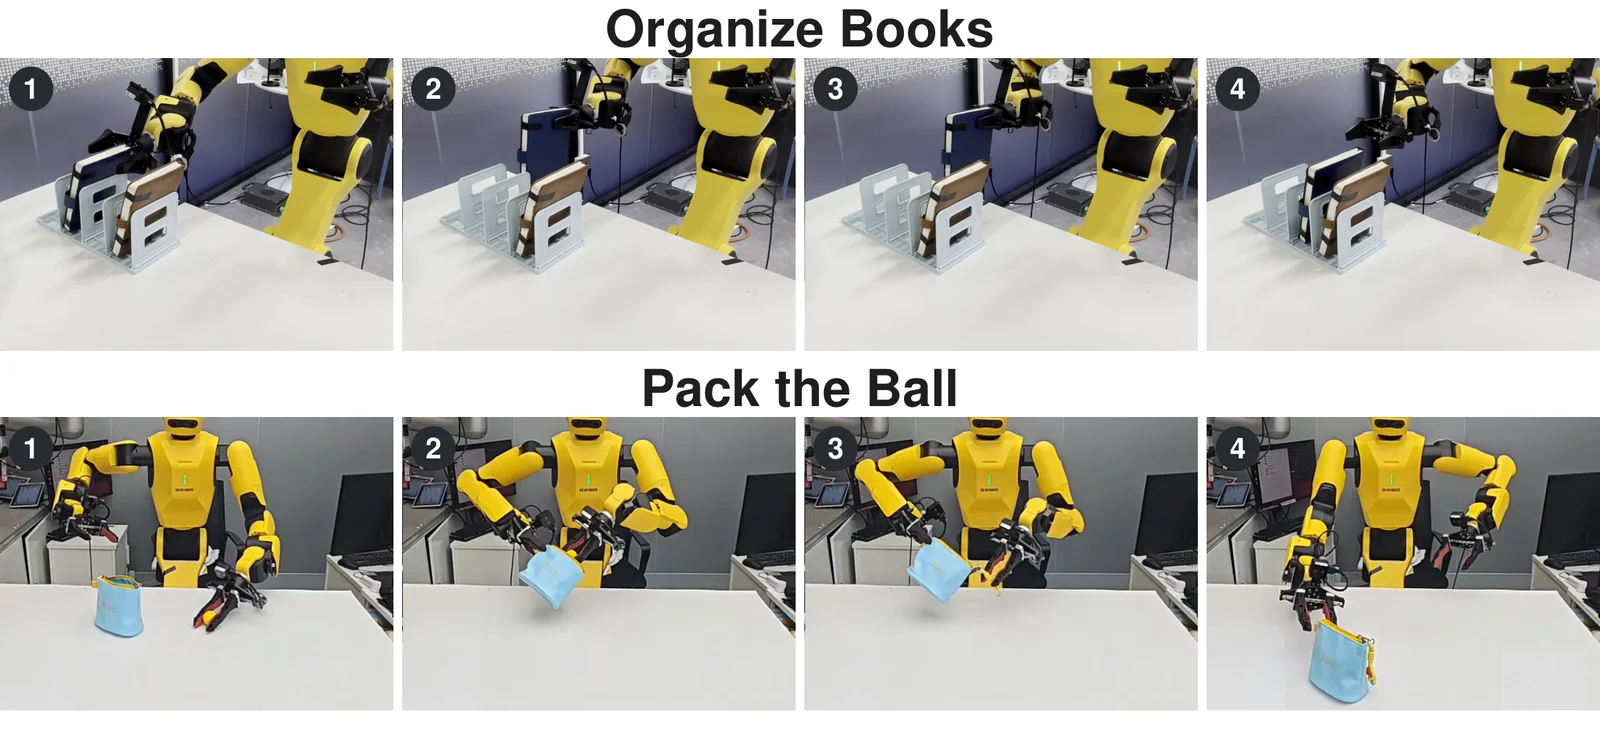
图 1|上排为整理书本上架,下排为装球并拉上拉链。
两项任务各测试 20 次,UNITAS 分别完成 18 次和 16 次,平均成功率为 85%。相较 π₀.₅,两项任务的成功率分别提高 15 和 25 个百分点。
02 为什么让动作与环境共享三维坐标
当前,不少 WAM 工作以预训练视频模型为基础,联合学习未来视觉观测与机器人动作。视频包含丰富的外观、语义和运动信息,但机器人执行任务时,还需要处理准确的空间关系。
例如,同样是把杯子向前推一段距离,换个拍摄角度,画面中的运动就会改变。预测视频看起来流畅,也不一定意味着物体位移准确、形状稳定,或背景没有漂移。
UNITAS 从这一差异出发,将交互中的运动直接表达为三维点轨迹。它使用两类相互关联的表示:
- 动作流(Action Flow):记录夹爪或人手上的点如何运动。
- 场景流(Scene Flow):描述环境中的点如何随交互发生变化。
两类轨迹在每个预测窗口内共享坐标系,并具有真实的物理尺度。夹爪向上移动、杯子随之抬起、桌面保持静止,这些关系可以在同一空间里表达。
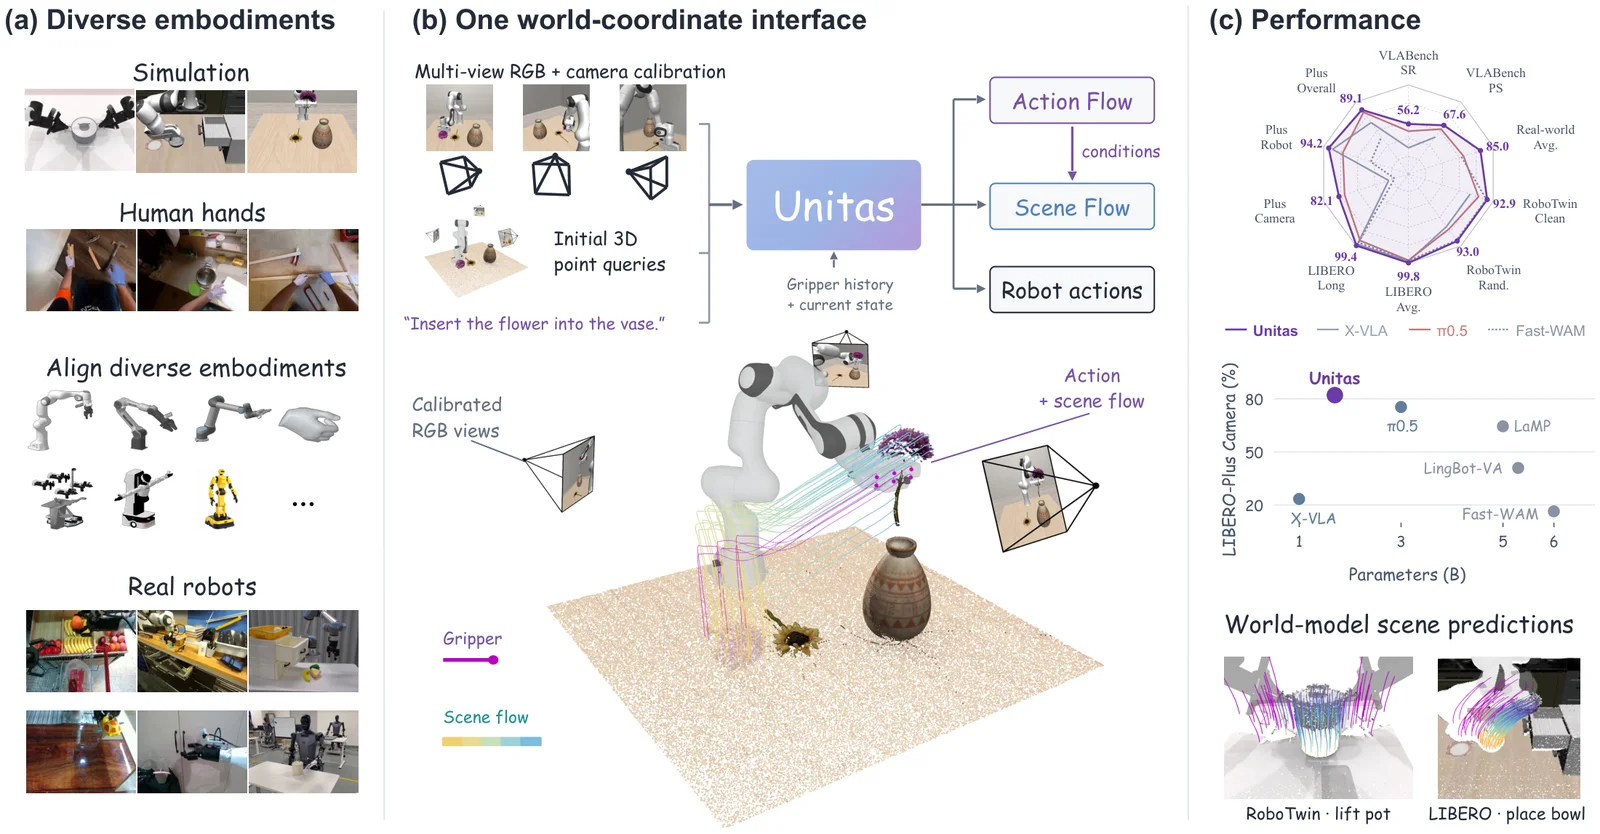
图 2|UNITAS 以共享三维表示连接观测、动作与场景动态。
图像仍然承担提供外观与语义信息的作用。为让视觉信息具备明确的空间位置,UNITAS 引入世界对齐的三维位置编码:有深度信息时,利用相机标定将像素映射到三维位置;缺少深度时,则沿标定相机的射线学习位置特征,从而支持 RGB 和 RGB-D 数据。
三维对齐的作用,在视角扰动下体现得较为直接。LIBERO-Plus 的消融实验显示,去掉视觉三维位置编码后,相机扰动下的成功率从 79.11% 降至 66.73%。这一结果支持了显式几何信息对视角鲁棒性的价值。
03 两个专家共同学习动作与后果
有了共享表示,模型还需要把“怎样执行”和“会发生什么”连接起来。
UNITAS 采用两个逐层耦合的专家。其中,点动力学专家预测动作流与场景流;动作专家生成机器人可以执行的平移、旋转和夹爪开合指令。两个专家共享观测与任务上下文,共同学习交互过程。
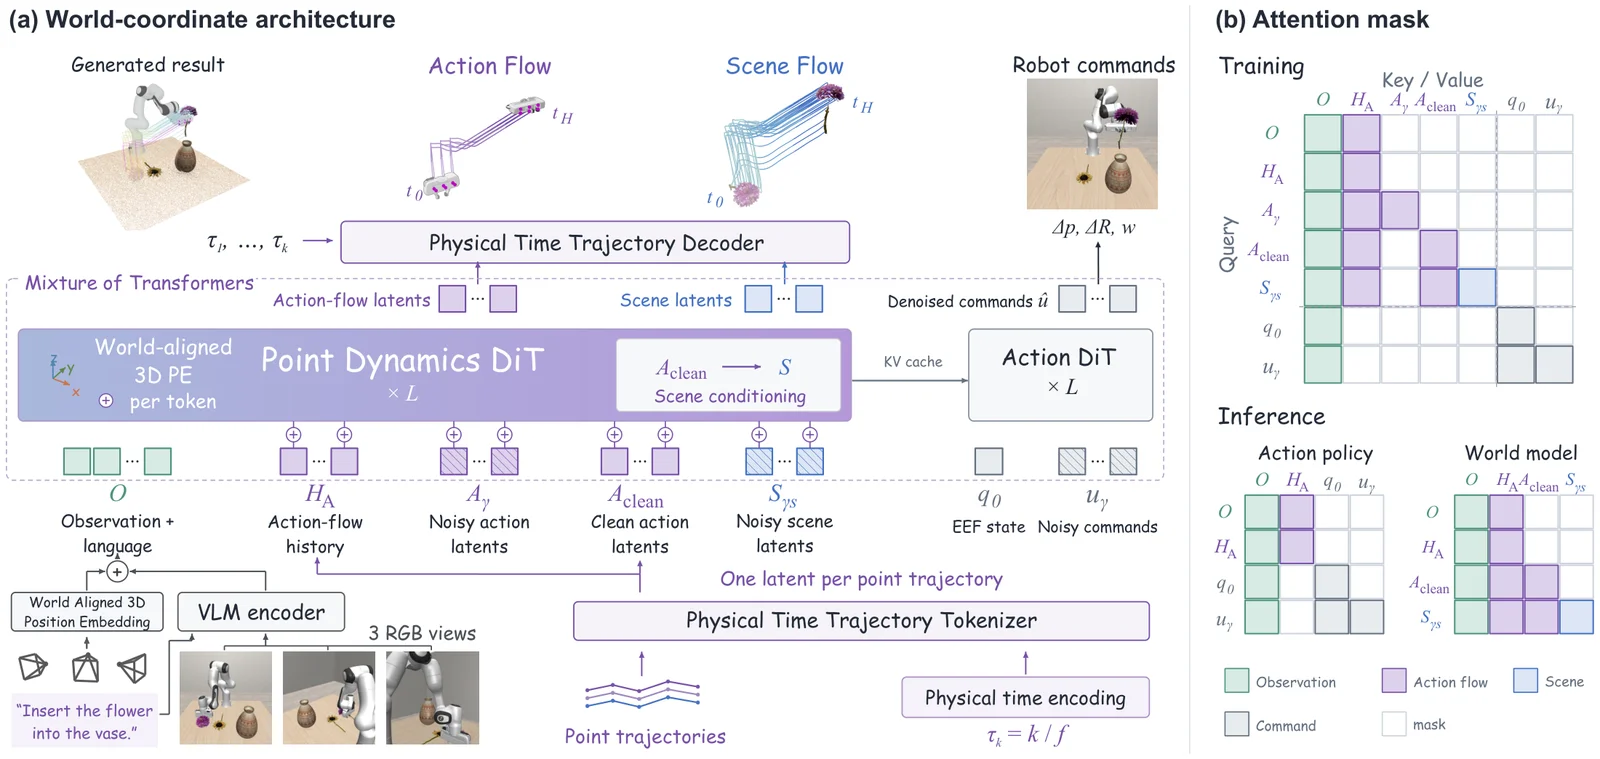
图 3|点动力学专家与动作专家耦合,联合学习三维运动和可执行控制。
模型先并行生成动作流和控制指令,再以动作流为条件预测环境响应。如果输入一段外部给定的动作轨迹,UNITAS 也可以预测这段运动将带来的场景变化。
联合训练并不意味着每次执行都要生成完整的未来场景。 在实际控制时,模型可以采用仅输出动作的 policy 模式,跳过未来点轨迹生成;需要分析动作后果时,再调用场景预测能力。
04 用厘米检验对动作后果的理解
把物体抬起时,它会跟随夹爪移动多远?双臂共同搬运时,物体形状是否保持稳定?没有参与交互的背景点,是否仍停留在原处?
这些问题可以通过三维轨迹直接检验。
在留出的 RoboTwin 测试轨迹上,各方法使用相同的初始观测与动作条件。UNITAS 将移动点平均轨迹误差从 PointWorld 的 0.656 cm 降至 0.427 cm,降幅约为 35%;静态点漂移误差降低约 49%,移动点预测误差在 1 cm 内的比例达到 92.31%。
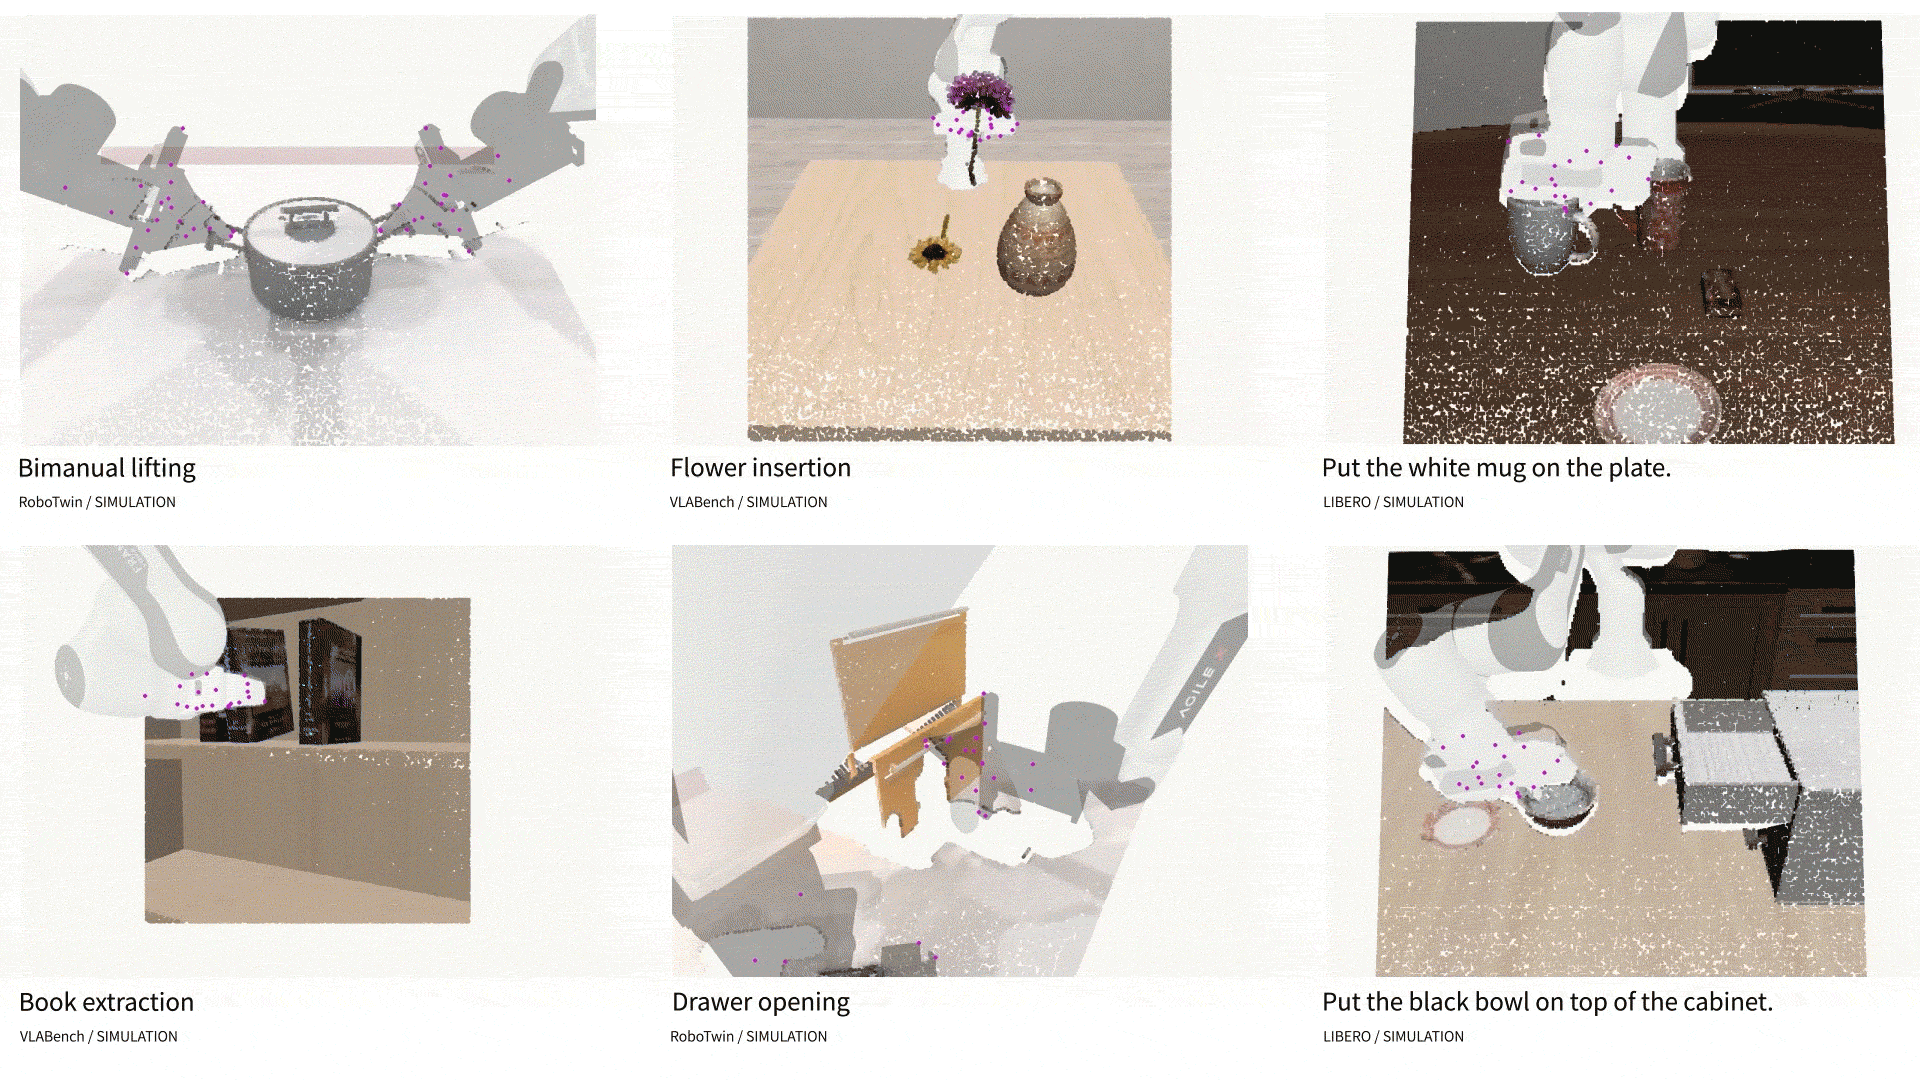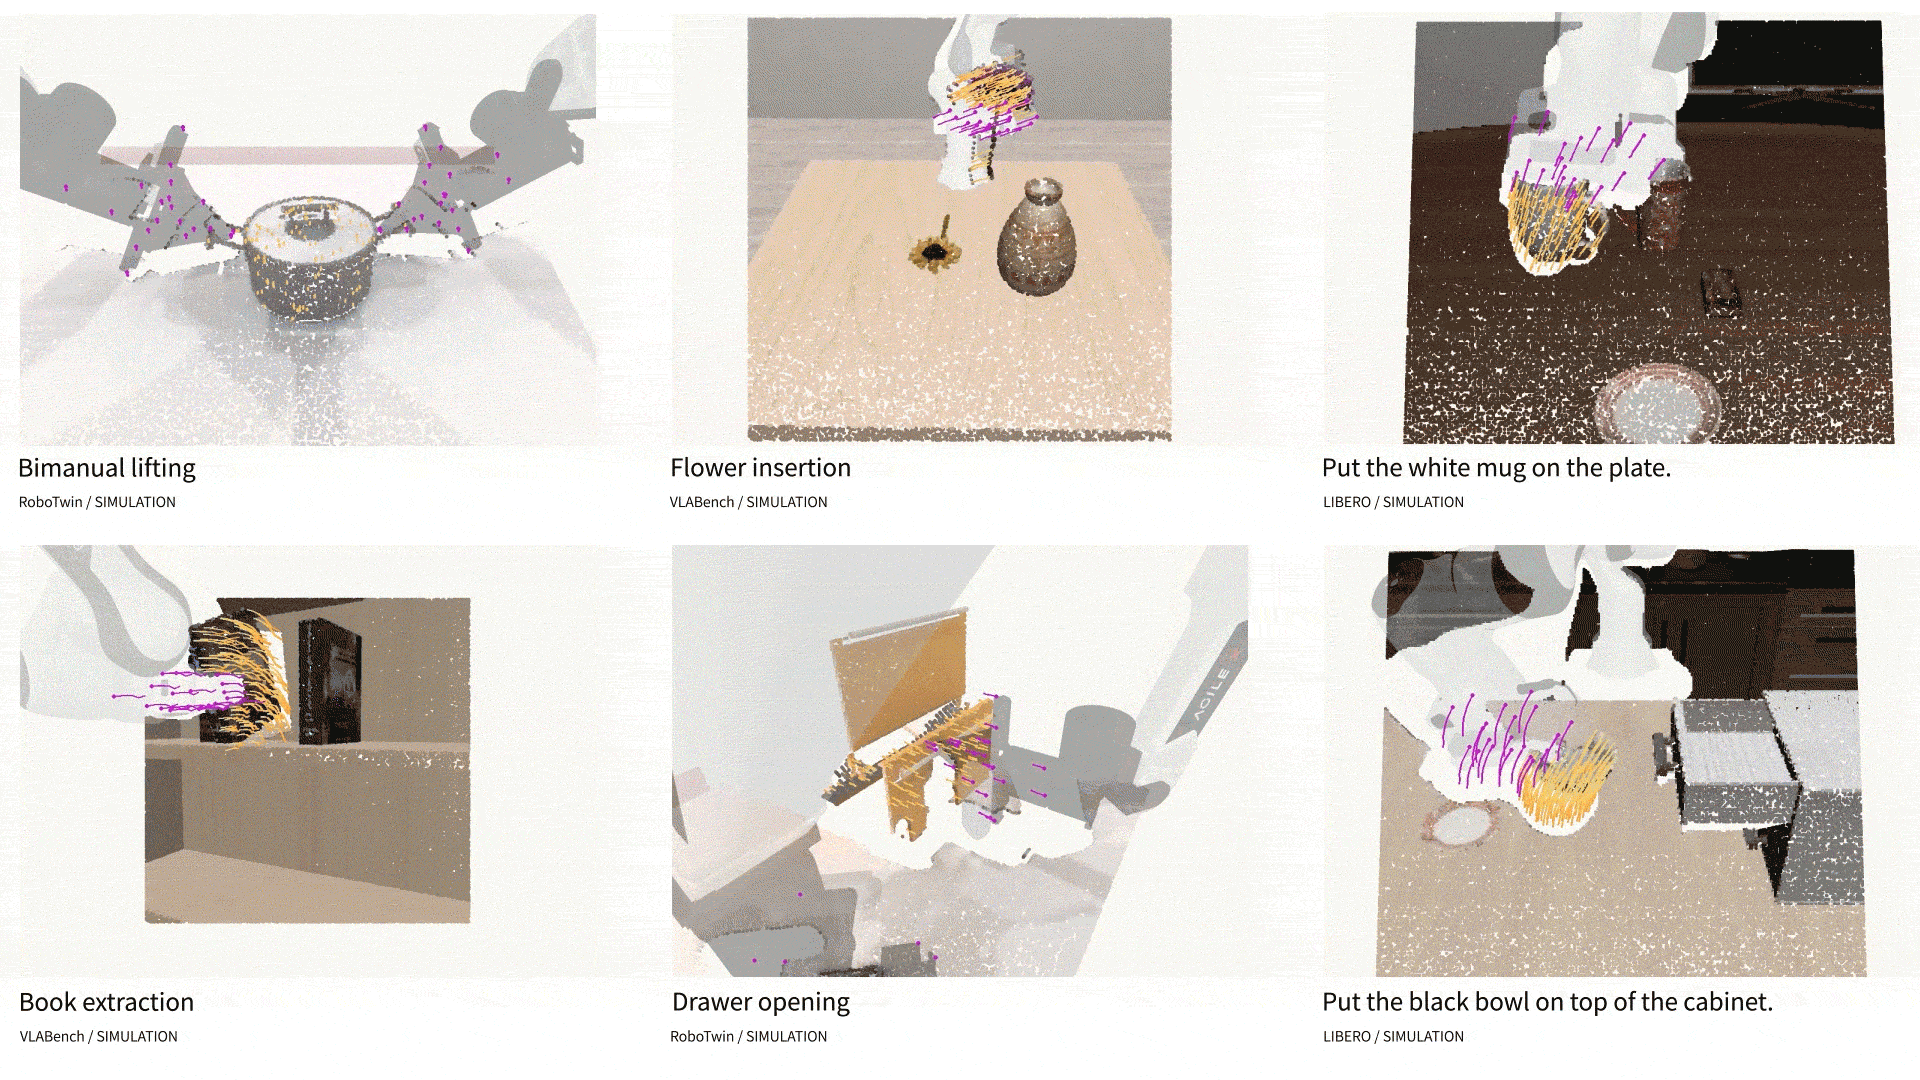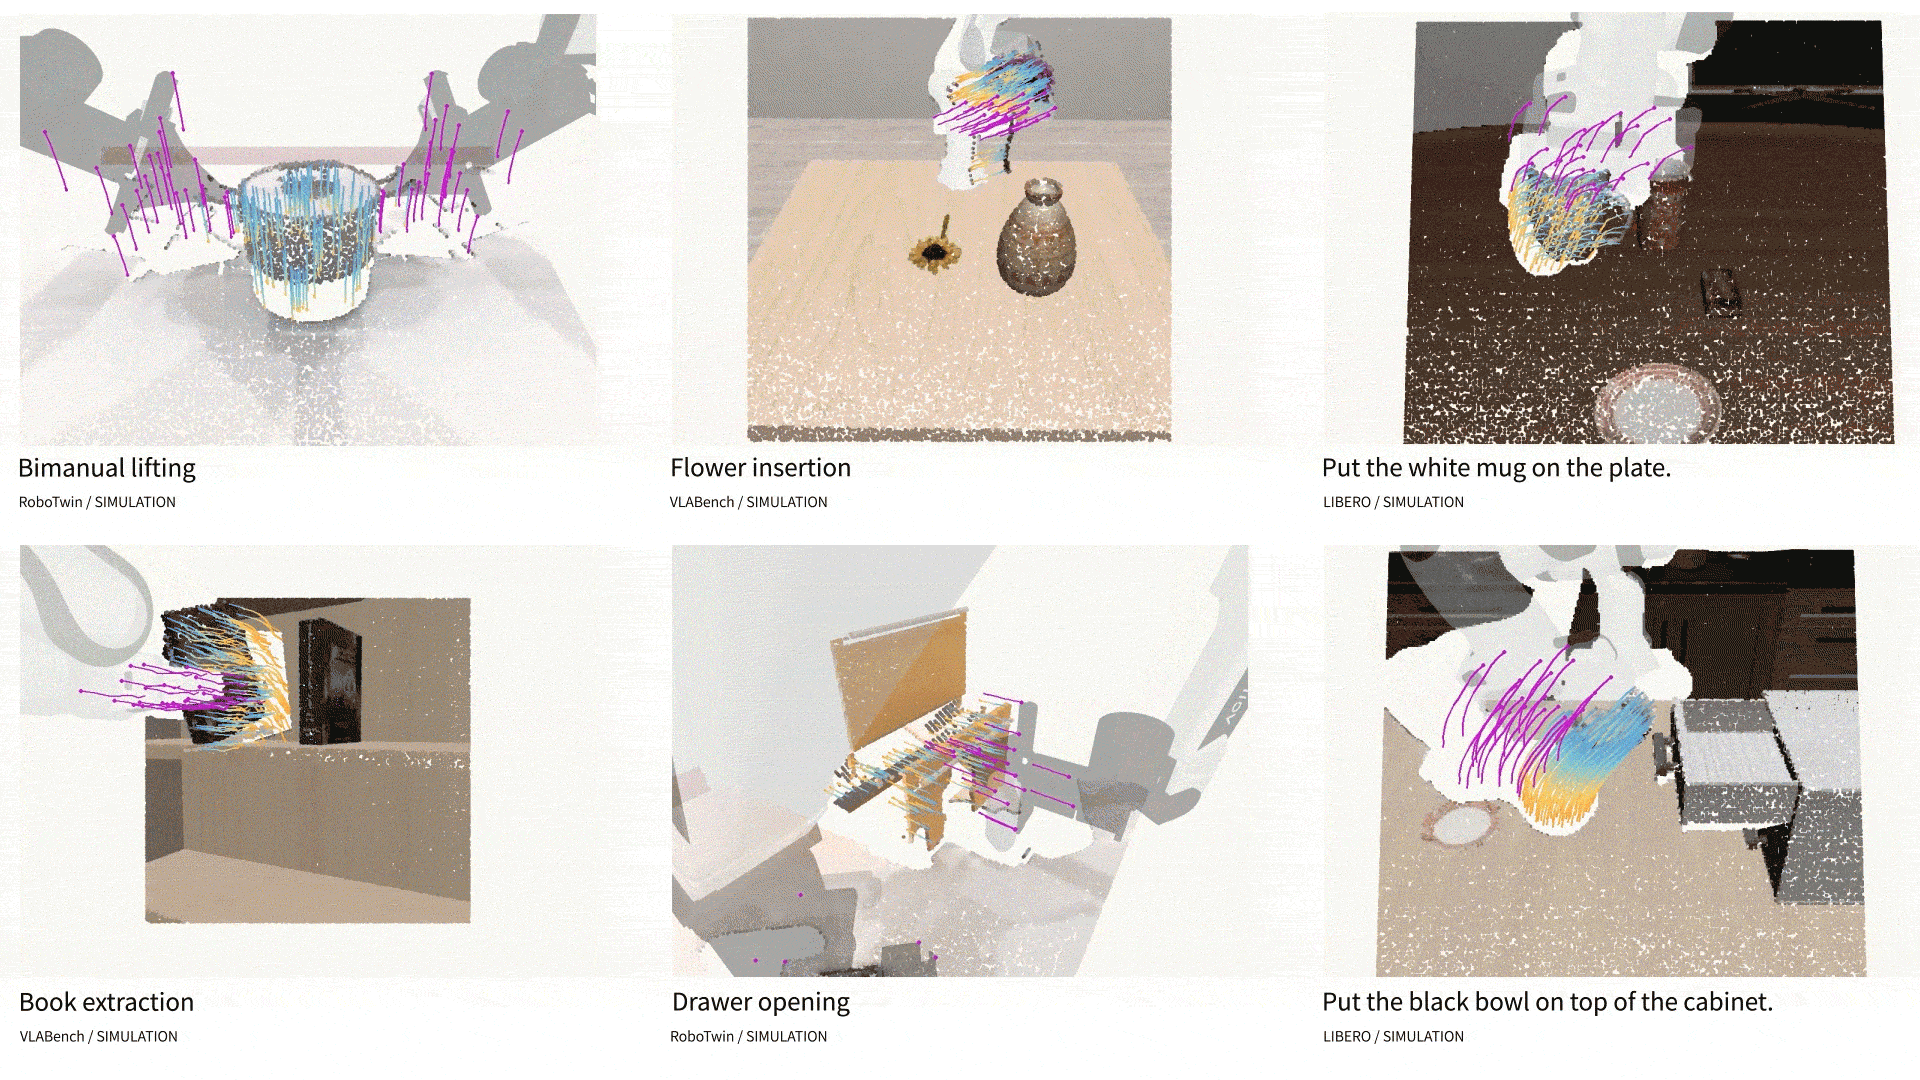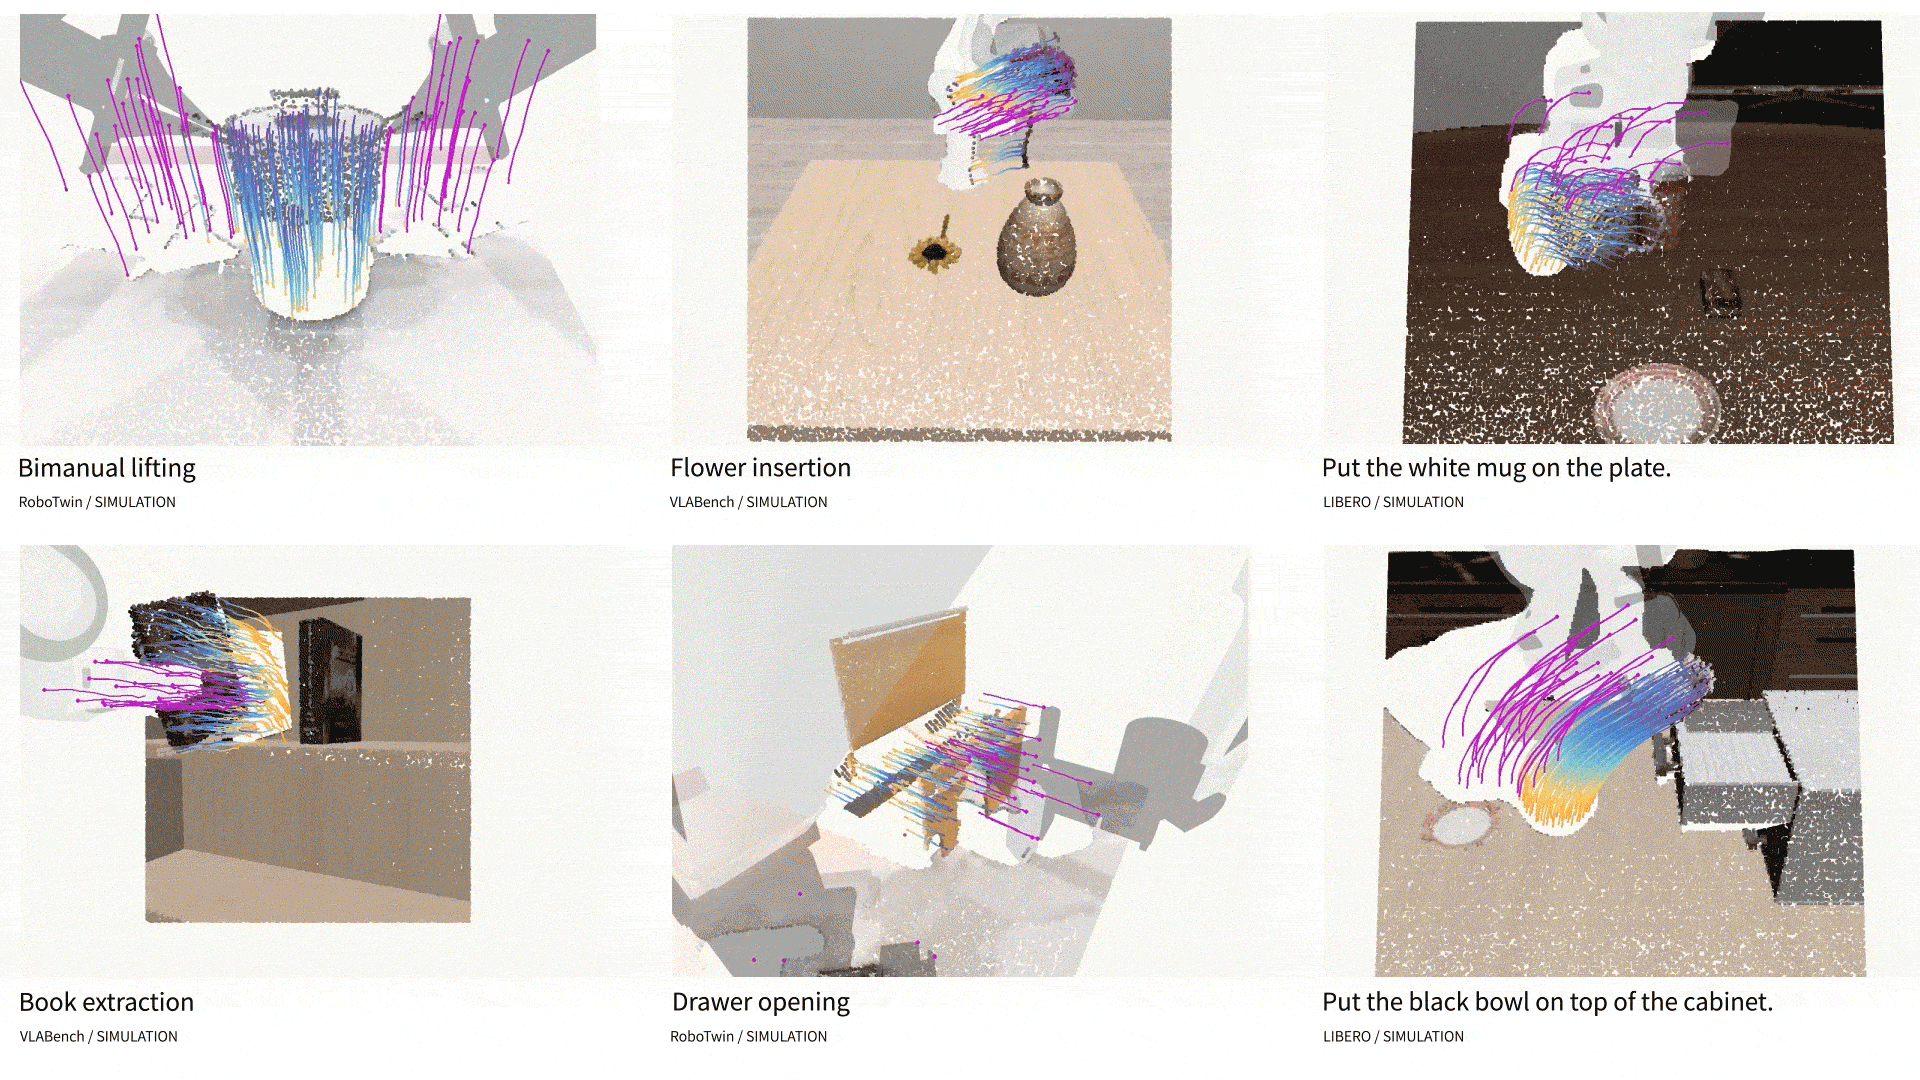
图 4|双臂抬物、插花、放杯、取书、开抽屉与放碗等任务中的运动预测。
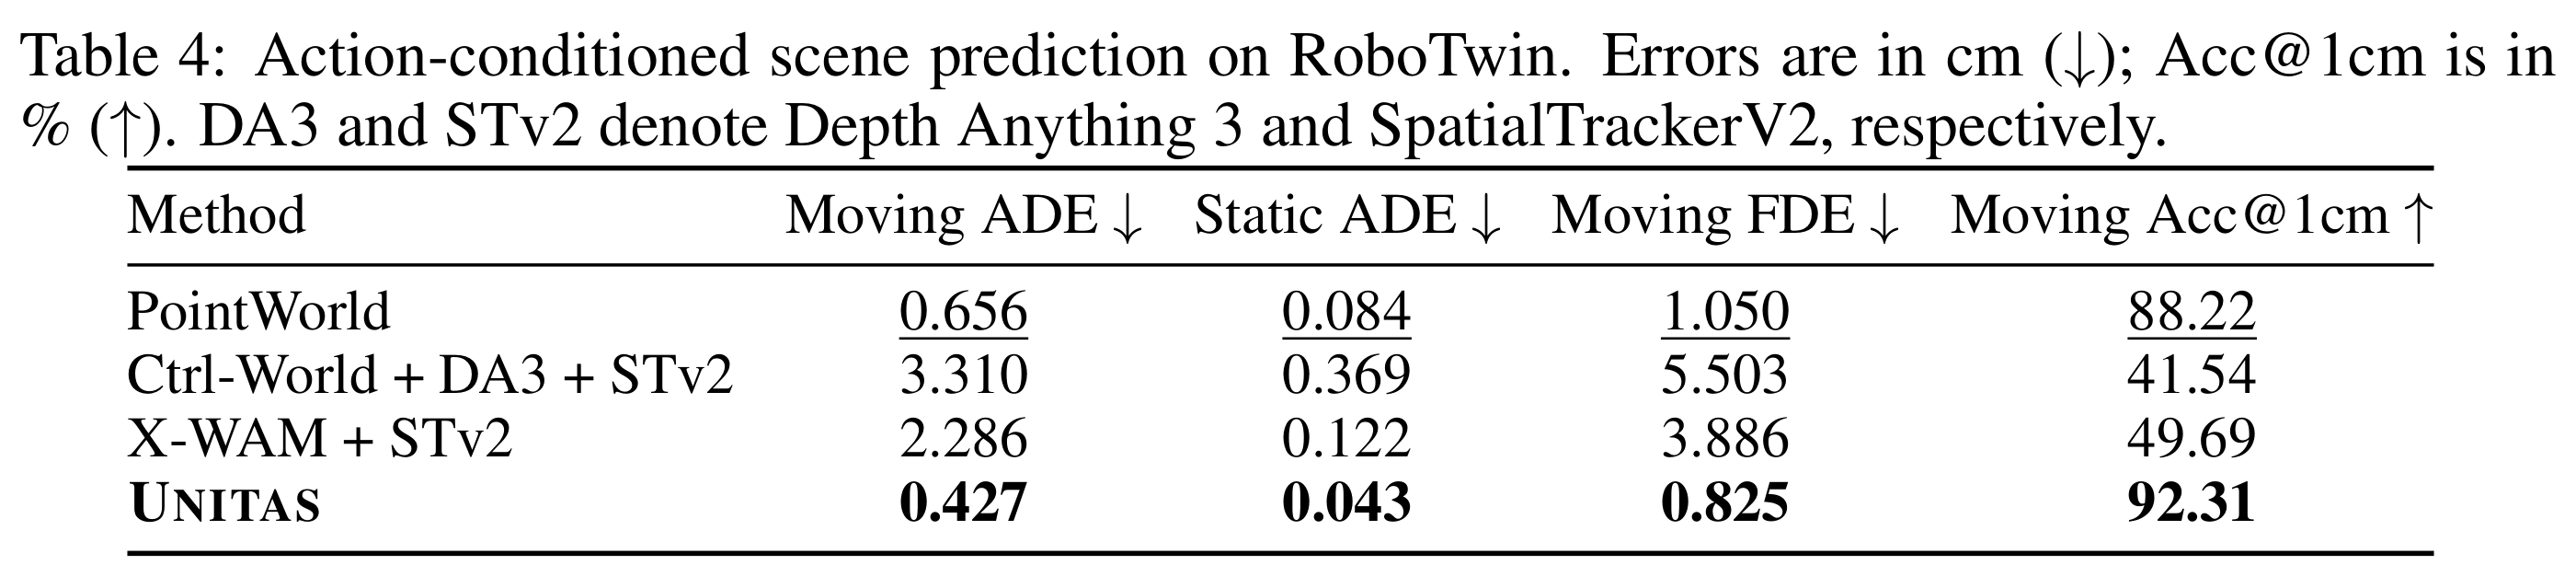
论文表 4|场景预测误差以厘米计。视频方法经三维重建与跟踪后参与比较。
移动点误差反映模型对物体运动的预测是否准确,静态点漂移则检验它能否保持环境中不该运动的区域。直接输出具有真实尺度的三维轨迹,使这些与操作紧密相关的目标可以被训练和评估。
研究还展示了从仿真场景流监督向真实场景迁移的能力。在 DROID、RH20T 的真实观测上,模型能够根据给定的夹爪运动预测场景点变化。训练使用了真实机器人动作数据,但没有使用真实场景流标注。
05 让不同机器人和人手共享操作经验
三维点轨迹的另一个价值,是为不同来源的数据提供共同描述方式。
人手、仿真机器人和真实机器人拥有不同的关节结构与控制接口,但它们与环境交互时,都可以用点在空间中的运动来描述。UNITAS 利用这一共同点,将九个来源的数据用于混合预训练。
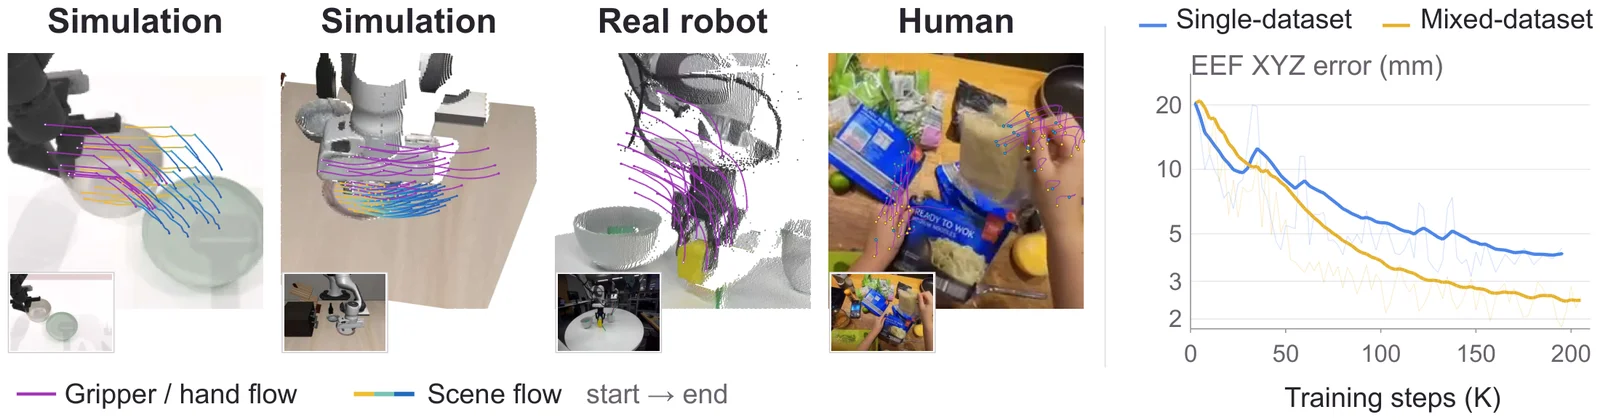
图 5|共享点轨迹连接多种数据来源;混合训练降低了 RoboTwin 测试集的末端位置误差。
为处理不同数据的采样频率和轨迹时长,模型按实际经过的秒数编码运动,将每个点的一段轨迹编码为一个 token,并锚定在该点的当前位置。
在 LIBERO-Plus 上,混合预训练带来 2.6 个百分点的整体成功率提升;其中,机器人初始状态扰动下的成功率从 84.8% 提高至 94.2%。
这一结果为跨本体学习提供了具体支持:在保留各自控制接口的同时,不同机器人与人手的数据可以围绕共享的三维运动表示组织起来,让操作经验得到更广泛的利用。
06 从开源模型继续探索三维原生 WAM
UNITAS 将 WAM 的学习目标进一步落到了交互几何上:机器人怎样移动,物体如何响应,两者如何在同一个具有真实尺度的空间中关联。
四个操作基准、真机任务与场景预测实验,为这一路线提供了相互补充的证据。它也为后续研究留下了值得继续探索的问题:如何利用更多跨本体数据,以及如何通过动作与环境动态的联合学习,提升机器人对交互的理解与执行能力。
目前,UNITAS 的推理与评测代码、模型权重均已开放。研究者可以从仓库提供的 RGB-D 样例开始,无需搭建仿真器即可体验三维轨迹预测,也可以进一步开展操作基准评测。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册