当你让 personal agent 帮你规划一次出行时,它能否结合过去的交流、近期的搜索和最新的反馈,理解你这次的预算、偏好与实际需求?几个月前你喜欢紧凑的行程,这一次却想轻松休息,agent 就需要识别需求的变化,并据此调整安排。
大模型已经从回答问题走向参与决策与执行。随着它们承担个人助理、复杂决策、长期规划与自主执行等任务,模型需要理解当前需求,联系过去的证据,并在新信息出现时更新判断。真实场景中持续积累的行为与反馈,也由此成为一种值得探索的训练材料。
在最新论文 Vela 中,探索“用户行为作为监督信号”:将经过匿名化、脱敏处理的真实行为记录,转化为可训练的任务与回答轨迹,检验它能否提升用户理解,并带来更广泛的大模型能力收益。
论文:Vela: User Behavior as Supervision Sparks LLM Intelligence
链接:https://arxiv.org/abs/2610.14709
项目主页:https://allspark-research.github.io/Vela/
GitHub仓库:https://github.com/AllSpark-Research/Vela
实验中,Vela-35B-A3B相对Qwen3.6-35B-A3B基座,在十项基准上全部取得提升:VelaBench提升11.5分,四项用户相关独立基准平均提升6.2分,五项通用基准平均提升4.0分。
一、从真实场景出发,重新看待用户理解
论文将这组能力概括为“LLM智能的用户维度”。它面向具体对象,跨越较长时间,并依赖行为证据:模型要判断某个人在特定情境下可能需要什么,理解需求与偏好如何变化,而相关线索往往分散在数周、数月乃至更长的历史中。
这要求模型区分长期偏好与临时意图,识别与当前问题相关的记录,并整合来自不同时间、不同类型的证据。一次浏览可能只是偶然,近期连续发生的搜索与反馈则可能改变对需求的判断。历史信息增加,也意味着模型需要在更多噪声中筛出有用线索。
静态文本与合成数据为大模型提供了丰富的知识和示范,但对个体长期行为及其演变过程的覆盖仍然有限。行为记录包含人在具体情境下的选择,以及随后产生的结果与反馈。Vela关注的问题,就是怎样将这些材料组织成具有明确学习目标的训练任务。
二、Vela:把行为历史变成可训练、可验证的任务
Vela基于经过匿名化、脱敏处理的行为数据开展研究,覆盖约10万个匿名化样本主体,涉及浏览、搜索、购买、发布、关注和负反馈六类行为。在任务构建前,移除用户资料、姓名、联系方式、账号ID等身份相关信息,并排除仍包含身份信息的记录。
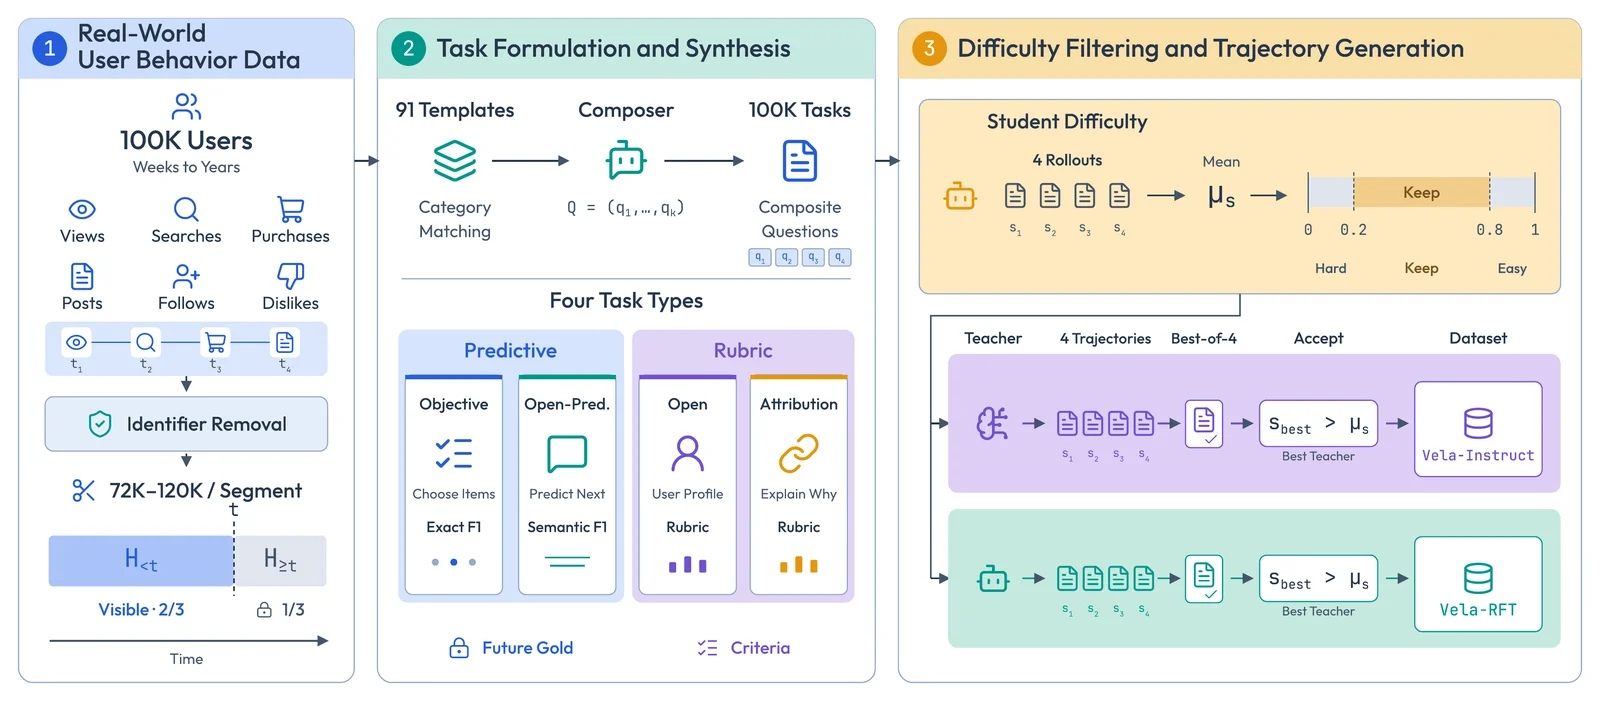
框架按时间组织行为历史,并保留完整行为记录。对于预测任务,模型根据截止时点之前的历史作答,参考答案从随后实际发生的行为中提取。这样可以区分模型作答时能够使用的证据,以及用于检验预测的后续结果。
任务构建采用91种真实场景模板,覆盖有候选项的选择题预测、不提供候选项的开放预测、兴趣与偏好等开放分析,以及对已发生行为的归因解释。具体任务根据当前历史实际包含的行为类型生成,最终构建10万条候选任务。
不同任务采用相应的验证方式。预测题通过比较预测对象与实际后续结果进行评分;总结、解释等分析题则使用任务专属评分细则,检查回答是否满足要求、结论是否得到证据支持。评分细则需要说明判断依据,避免将模型生成的一份分析作为唯一标准答案。
用一个示意例子理解监督从哪里来
论文中的徒步示例展示了这一过程:假设可见历史包含轻便徒步背包的搜索、20 L日用背包的对比、短途徒步计划,以及对大型登山包内容的负反馈;后续记录显示购买了20 L日用背包。这是手工构造的虚构示意,不对应真实个体。
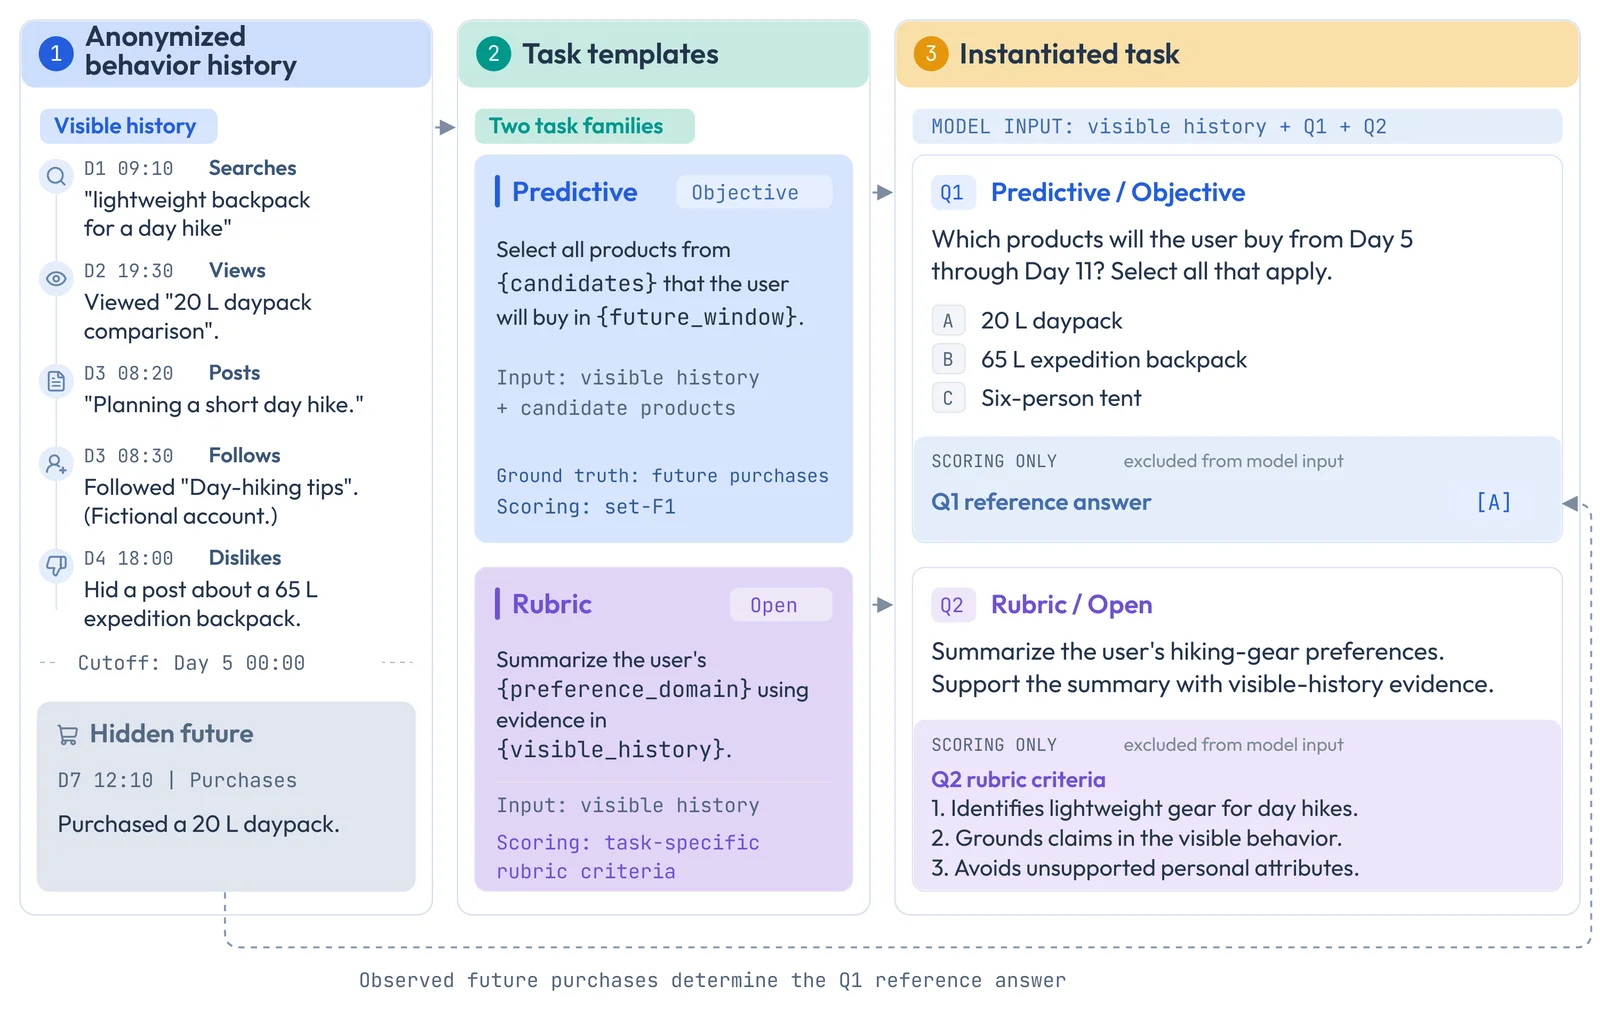
基于这些材料,预测题可以让模型判断后续会选择哪个背包,并用后续购买记录检验答案;分析题可以要求总结装备偏好,评分时检查是否识别轻便、短途等线索,以及结论是否超出了证据范围。两类任务共享行为背景,但监督依据各有侧重。
三、从候选任务到训练样本,质量如何筛选?
候选任务还需要经过难度筛选。Vela先让基座模型对每个任务回答四次,由评分模型计算平均得分,保留得分处于0.2—0.8区间的任务,以此聚焦具有一定挑战、同时又存在学习空间的题目。
随后,框架为保留的任务生成多条回答轨迹,考虑纳入得分最高的一条。只有这条轨迹的得分高于前一步基座模型的平均得分,才将其保留下来。筛选同时关注任务难度和示范回答的质量。
经过难度筛选与轨迹接受标准,10万条候选任务形成约7.5万条Vela-Instruct训练样本。论文同时构建了包含9,375条样本的Vela-RFT,其回答轨迹由Qwen3.6-35B-A3B基座自身生成,用于检验模型能否从筛选后的自身回答中学习。两套数据分别用于微调得到Vela-35B-A3B和Vela-35B-A3B-RFT。
四、十项基准全线提升,收益延伸到通用能力
论文从三个范围评估训练收益:VelaBench由训练之外的样本主体构成,包含982个评测任务;四项用户相关独立基准覆盖购买意图、画像与偏好理解、广告检索词生成等能力;五项通用基准覆盖数学、科学、指令遵循和上下文学习。
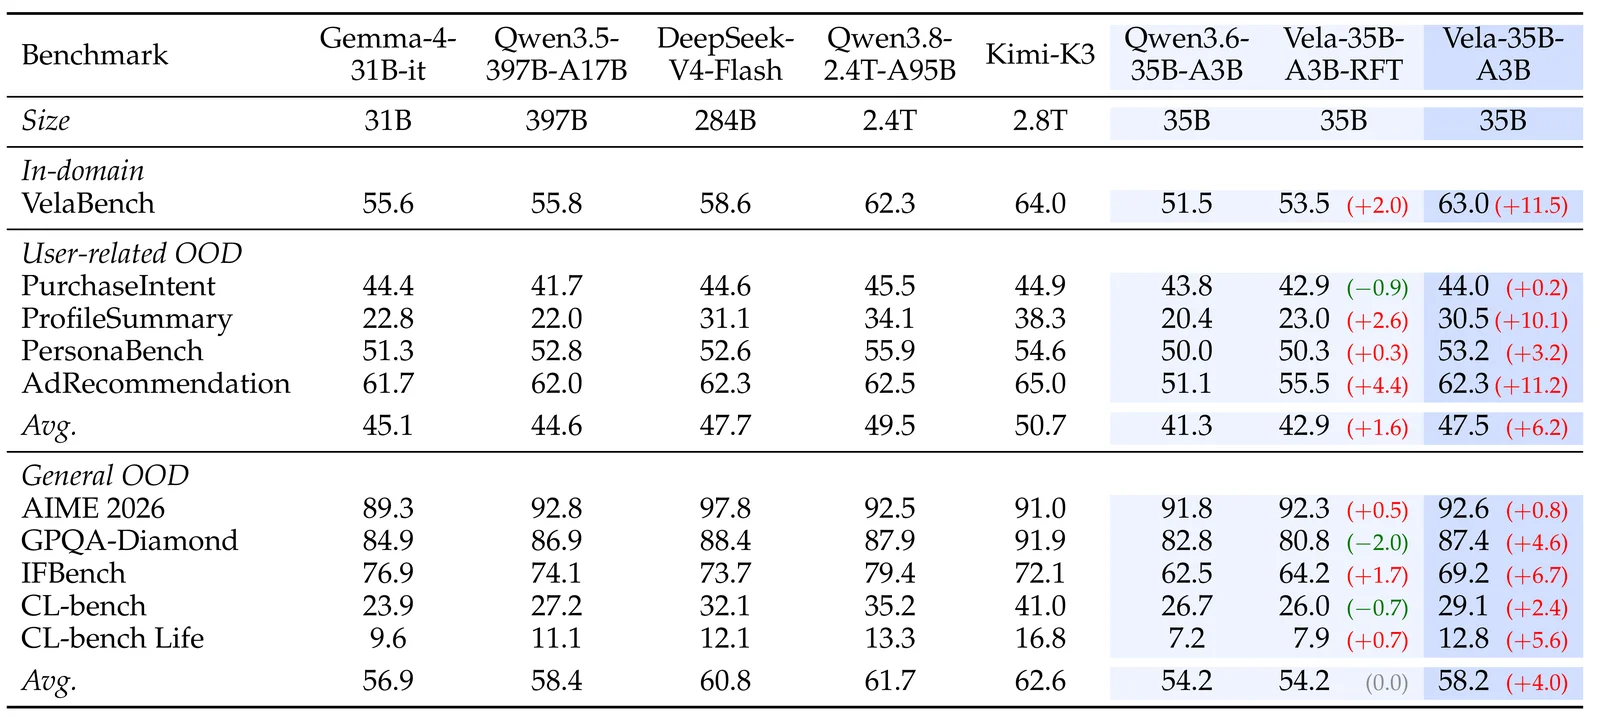
Vela-35B-A3B在十项基准上均优于同规模基座。VelaBench从51.5提升至63.0,增加11.5分;四项用户相关独立基准平均分从41.3提升至47.5,增加6.2分。其中,ProfileSummary从20.4提升至30.5,AdRecommendation从51.1提升至62.3。
在VelaBench这一具体基准上,35B规模的Vela取得63.0分,高于Qwen3.8-2.4T-A95B的62.3分,展示了行为监督在特定能力上的训练价值。
通用能力也观察到正向收益:五项通用基准平均分从54.2提升至58.2,增加4.0分。其中,IFBench提升6.7分,GPQA-Diamond提升4.6分,CL-bench Life提升5.6分。
使用基座自身生成轨迹训练的Vela-35B-A3B-RFT,在VelaBench上提升2.0分,用户相关独立基准平均提升1.6分,同时保持通用基准平均分不变。这表明,在论文设置下,经过筛选的自身回答也能提供一定的学习价值。
一种理解是,用户理解任务本身要求模型处理长上下文、整合证据并遵循具体任务要求,这些能力也会出现在通用评测中。不同监督任务分别贡献了什么,仍可以通过后续研究进一步拆解。
五、行为数据增加之后,模型还能继续提升吗?
论文进一步使用不同规模的随机训练子集,将样本数从4.7K扩展到75K,比较行为监督的数据扩展效果。VelaBench从59.2提升至63.0,用户相关独立基准平均分从43.5提升至47.5。
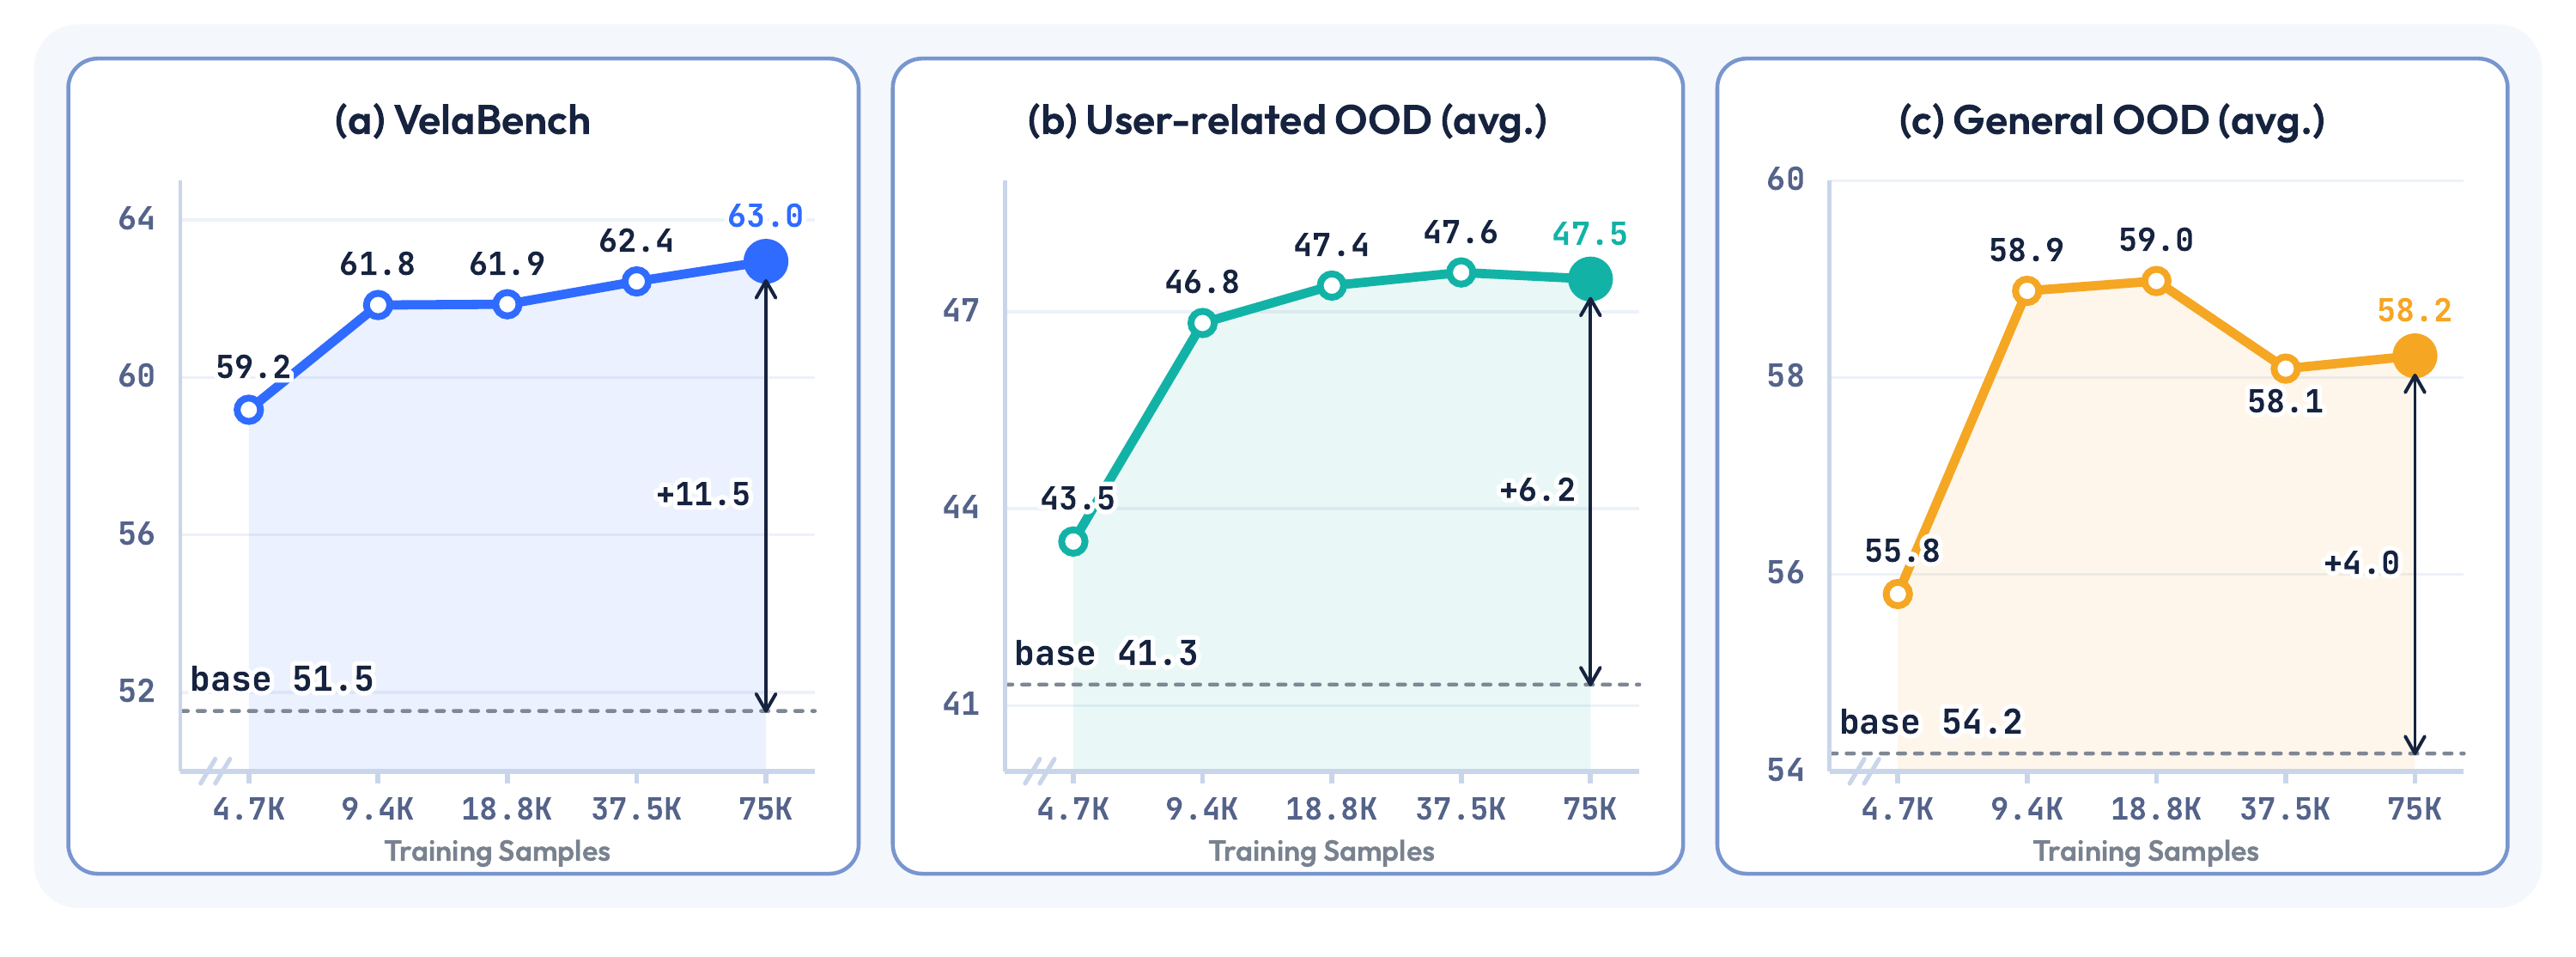
三组评测对数据规模的响应有所不同:VelaBench在较大规模下仍继续提升,用户相关独立基准在后段趋于平缓;通用基准平均分在所有测试规模上均高于基座,但曲线并非严格单调。数据扩展的收益因此需要结合具体能力分别观察。
六、行为监督,也能为后续强化学习提供更好的起点
除直接微调收益外,研究还比较了两种后续强化学习方式:直接从Qwen3.6-35B-A3B基座出发,以及先经过Vela监督微调再进行强化学习。两者使用相同的强化学习数据、算法与配置。此组实验中的Vela初始化使用18.8K样本检查点,与主结果中使用75K样本的模型区分。
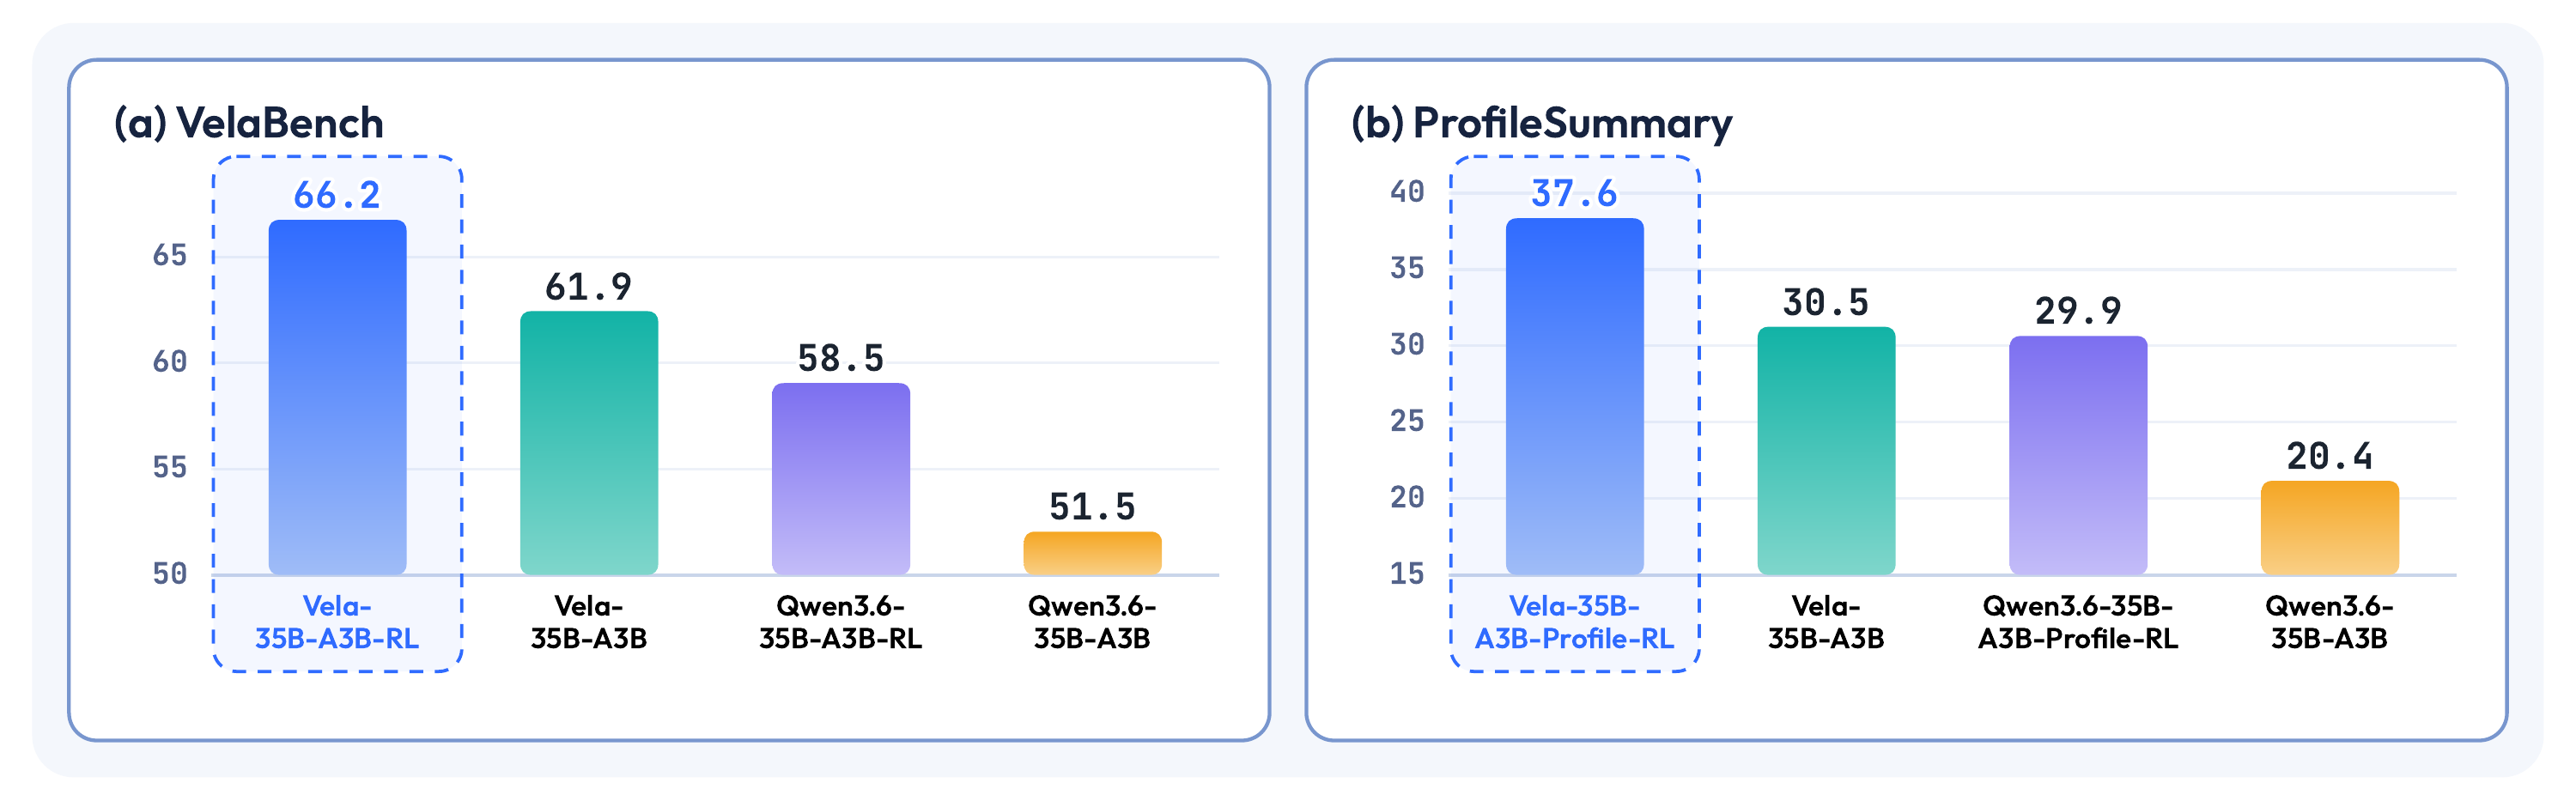
完成强化学习后,Vela初始化在VelaBench上达到66.2分,基座初始化为58.5分;在ProfileSummary上,两者分别为37.6分和29.9分,最终成绩都相差7.7分。这里的7.7分比较两种初始化在强化学习后的最终结果。
在这一实验设置下,行为监督不仅直接改善模型表现,还为后续强化学习提供了更好的能力基础。这也为研究不同训练阶段如何衔接提供了一个具体观察。
结语:从真实世界持续产生的反馈中寻找训练信号
随着大模型进入更多高价值真实场景,理解具体需求、跨越长历史整合信息、依据证据更新判断,将有越来越多的应用空间。Vela将这些要求转化为可训练、可验证的任务,并在用户理解、通用评测和后续强化学习中观察到了收益。
这项工作的启发在于,真实场景中积累的选择与反馈,可以成为扩展大模型训练信号的重要来源。如何覆盖更广泛的场景、选择更有价值的行为证据,并将这些能力迁移到复杂决策、长期规划与自主执行,值得进一步探索。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册