
机器人要做到实时控制,需要足够长的视觉历史,来判断物体怎么动、任务进行到了哪一步;但只要开始处理历史,动作就会变慢——这是一对天然矛盾。
更微妙的问题在于:给模型历史,它就会用吗?

来自 NVIDIA、MIT、香港大学与 UCSD 的团队提出 Long-WAM——一个面向实时控制约束、系统性扩展因果世界动作模型上下文的模型-系统框架。他们最重要的发现是:能访问历史,不等于会用历史。
更长的历史,只有在视频基础模型以自回归(AR)方式预训练时才真正带来收益。Long-WAM 的做法是:先在机器人视频与第一人称视频上学习因果预测(不需要动作标签),再在世界-动作适配阶段保留这种"历史到未来"的结构。
效果如何?在 RoboCasa GR-1 上,把上下文从 0 秒增加到 19.2 秒,成功率从 63.3% 提升到 78.7%;而用双向预训练的初始化,长历史几乎带不来净收益。机器人域的 AR 预训练,还进一步推高了 GR-1 与 LIBERO-Long 的峰值表现。
在 LIBERO-Long、RoboTwin 2.0、DOMINO 上,Long-WAM 都是对比方法中最好的。同时,通过流式观察编码、异步执行与硬件加速,它能在 RTX 5090、DGX Spark、Jetson AGX Thor 上部署,且不牺牲未来预测——在 RTX 5090 上,每个 action chunk(含未来视频 latent 预测)仅需 107.4 ms。

真机表现同样亮眼:Long-WAM 部署在 Unitree G1 与 YAM 上,支持动态与长时程操作;动态叠杯子任务达到 95% 的成功率,而 Pi0.5 与 Fast-WAM 在 20 次试验中一次都没有成功。

作为"带记忆的执行器",Long-WAM 还能在复合任务中配合更高层的规划——这正是"大脑与小脑"分工的由来。
论文:Long-WAM: Scaling the Context of World-Action Models
链接:https://arxiv.org/abs/2610.10528
项目主页:https://nvlabs.github.io/LongLive/Long-WAM/
代码:https://github.com/NVlabs/LongLive/tree/main/Long-WAM
模型:https://huggingface.co/collections/Efficient-Large-Model/long-wam
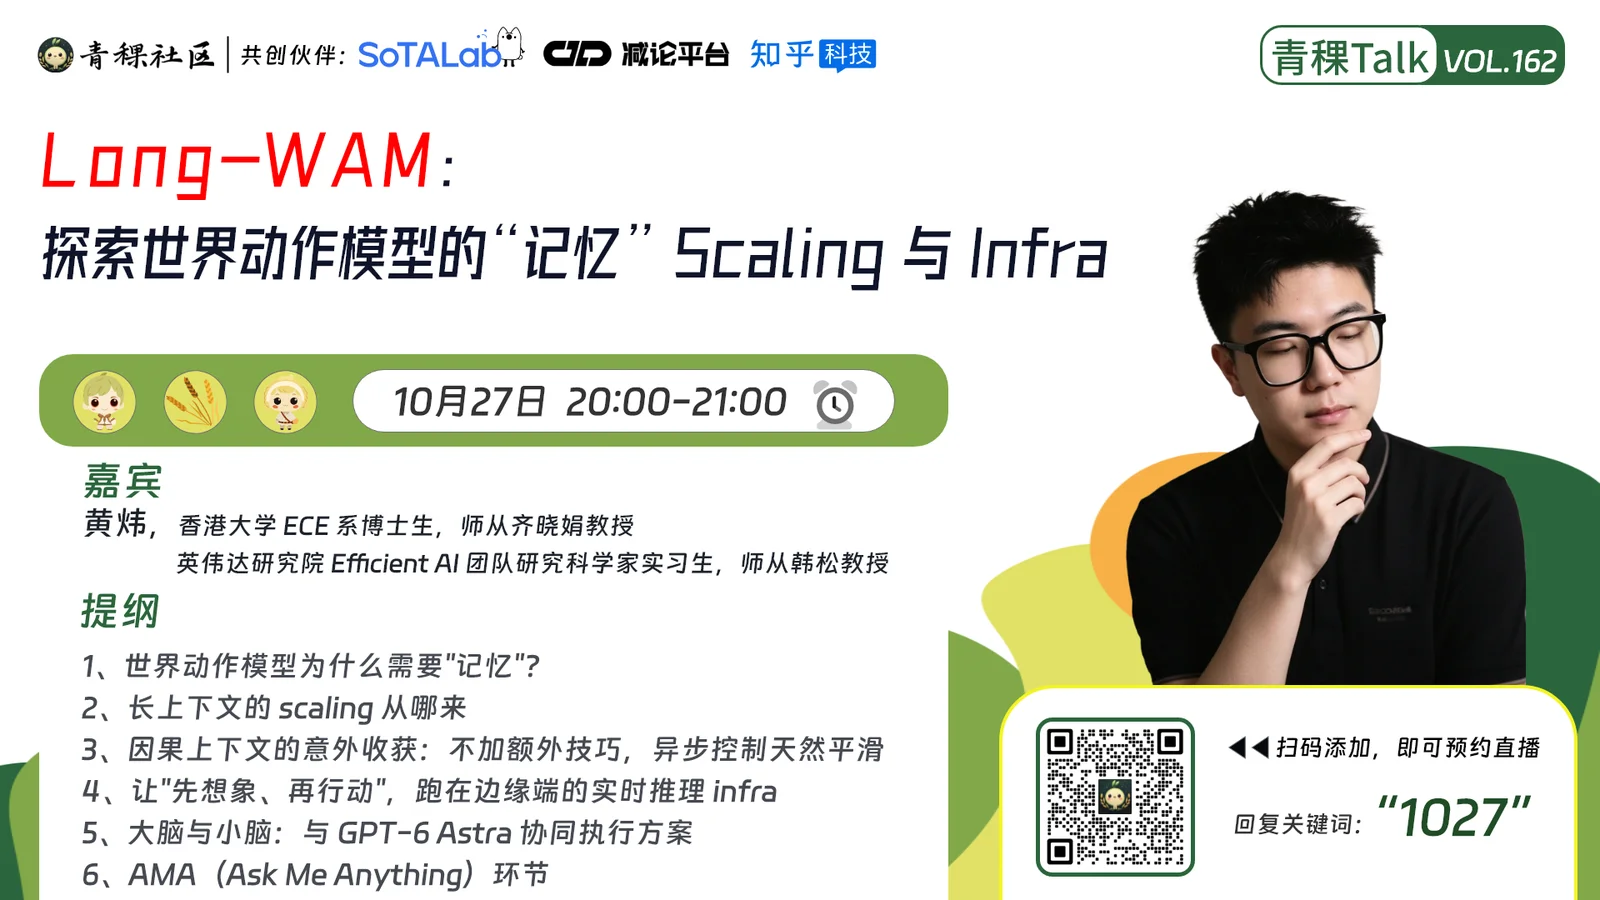
10月27日(周二)晚8点,青稞Talk 第162期,青稞社区邀请到 Long-WAM 第一作者、香港大学 ECE 博士生(NVIDIA Research Efficient AI 团队研究科学家实习生)黄炜,分享《Long-WAM:探索世界动作模型的"记忆"Scaling 与 Infra》。
分享内容
Long-WAM:探索世界动作模型的"记忆"Scaling 与 Infra
1、世界动作模型为什么需要"记忆"?
2、长上下文 scaling 从哪来
3、因果上下文的意外收获:不加额外技巧,异步控制天然平滑
4、让"先想象、再行动",跑在边缘端的实时推理 Infra
5、大脑与小脑:与 GPT-6 Astra 协同执行方案
6、AMA(Ask Me Anything)环节
嘉宾介绍
黄炜,香港大学 ECE 系博士生,师从齐晓娟教授;现于英伟达研究院(NVIDIA Research)Efficient AI 团队担任研究科学家实习生,师从韩松教授。研究方向为高效 AI 系统,关注让前沿多模态模型在算力、显存和时延受限的条件下真正可用。Long-WAM 第一作者,LongLive 1.0 / 2.0、Long-RL、QeRL、BiLLM 等工作的核心作者,开源项目累计获得 1 万余 GitHub Star。
直播时间
10月27日(周二)20:00 - 21:00
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册