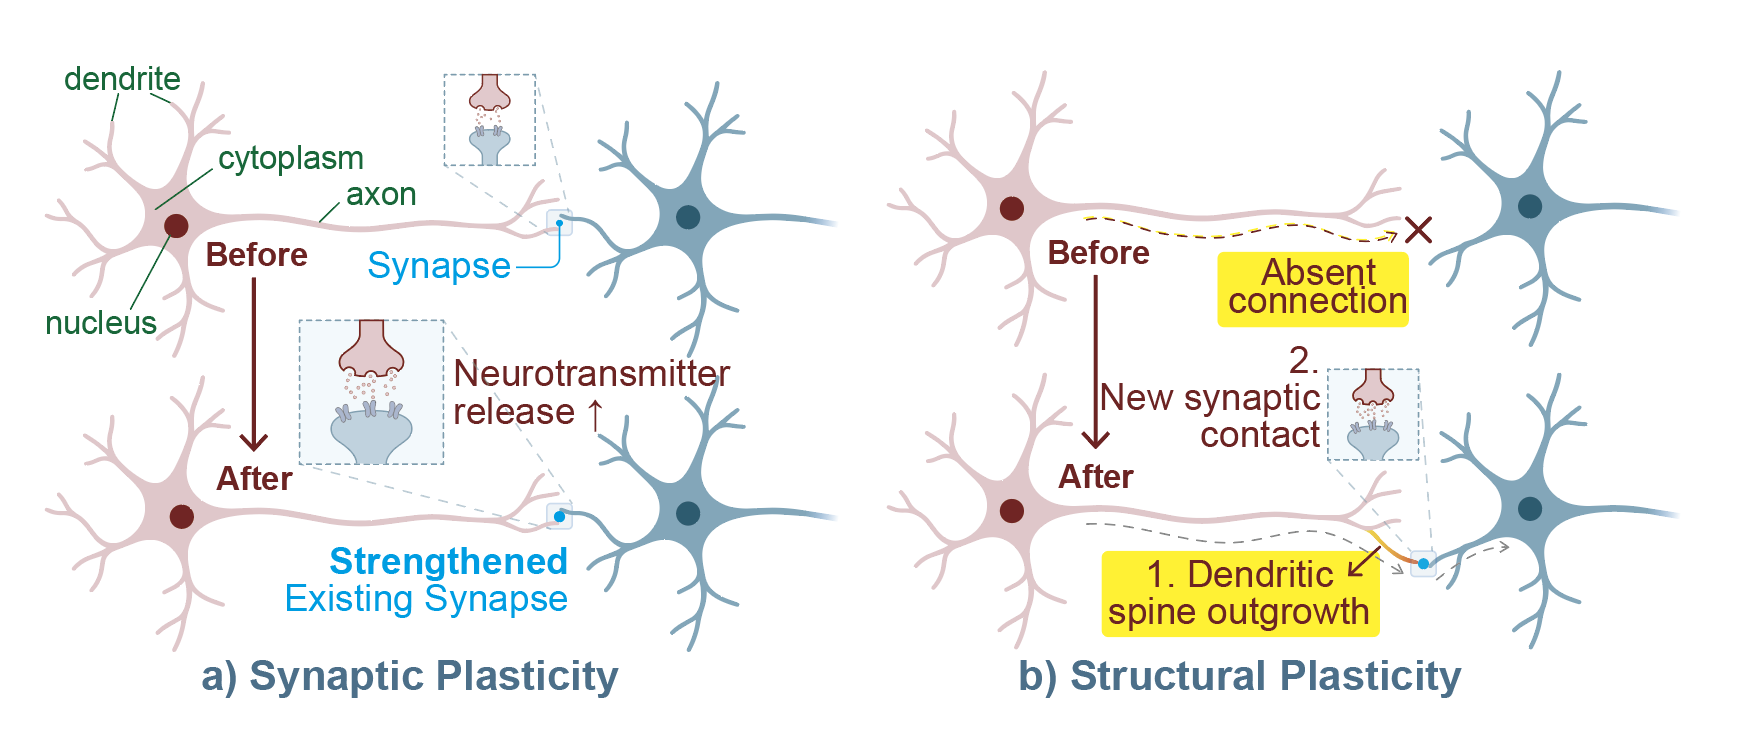
精选文章 把经验真正沉淀为长期参数记忆!浙大& Seed 提出 Cortex,探索 Agent 持续自我进化 一次成功操作、一段纠错反馈,能否成为智能体下一次进步的起点?Cortex 将经验带来的帮助沉淀为长期参数记忆,在学习新内容的同时尽量保留已有能力,为智能体的持续自我改进提供可积累的基础。 一个智能体(Agent)接到任务后,会查阅文档、调用工具、尝试不同方案。在解决问题的过程中,它可能借助文档用对了
青稞Talk 直播预告!世界动作模型为什么需要"记忆"?聊聊 Long-WAM 的上下文 Scaling 与边缘 Infra 机器人要做到实时控制,需要足够长的视觉历史,来判断物体怎么动、任务进行到了哪一步;但只要开始处理历史,动作就会变慢——这是一对天然矛盾。 更微妙的问题在于:给模型历史,它就会用吗? 来自 NVIDIA、MIT、香港大学与 UCSD 的团队提出 Long-WAM——一个面向实时控制约束、系统性扩展因果
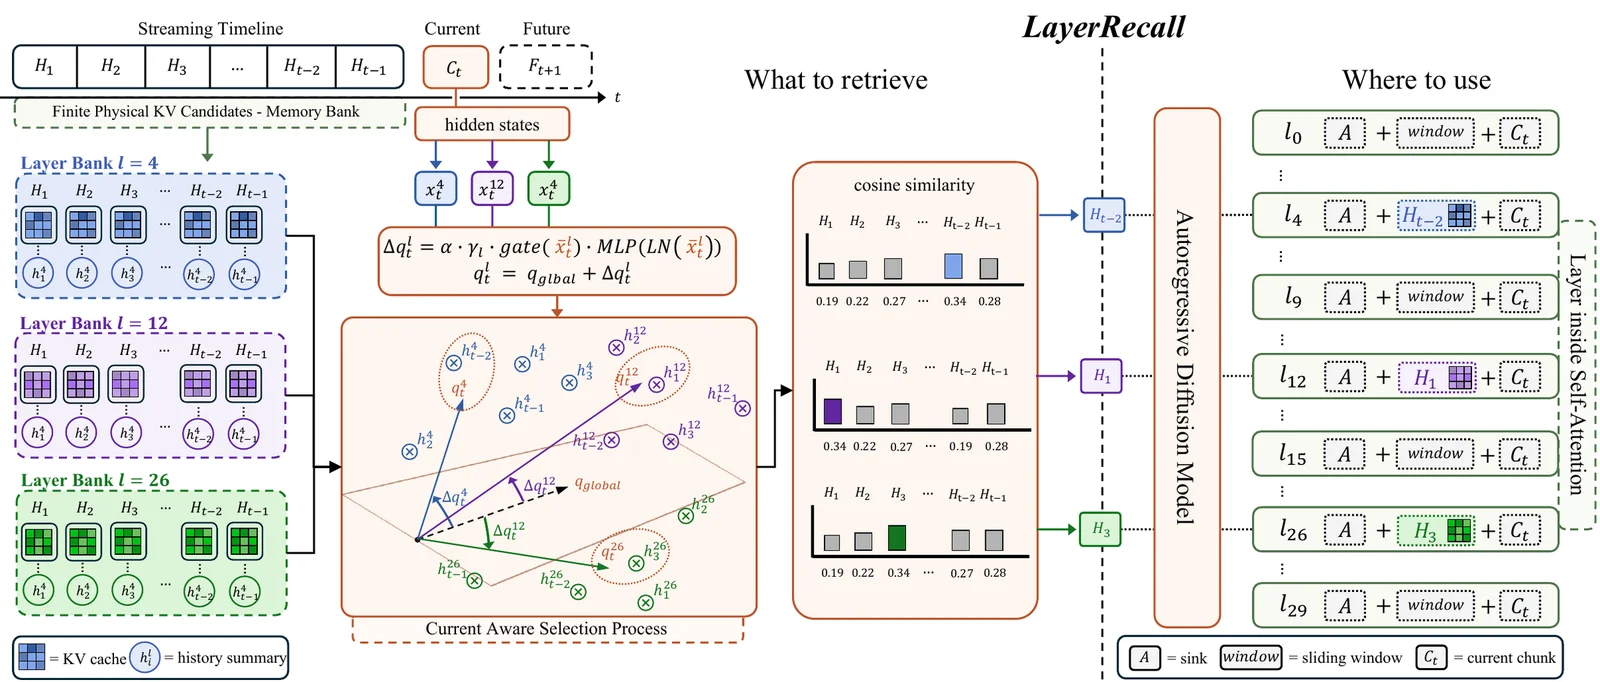
精选文章 不让每一层都“翻旧账”!浙大 & 港大最新开源 LayerRecall,让长视频记忆更准、用得更精 AI能连续生成一分钟视频,就算解决了「长视频」问题吗? 真正的考验,往往发生在主角离开镜头之后。 第一幕,一个穿特定服装的人出现在实验室;第二幕,他离开画面;第三幕再次返回时,模型可能已经给他换了脸、换了衣服,甚至把原本应该回来的物体也一起「忘」了。 原因并不神秘。自回归视频模型通常一段一段生成画面
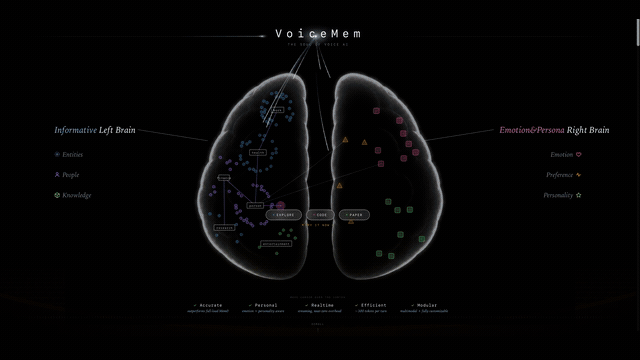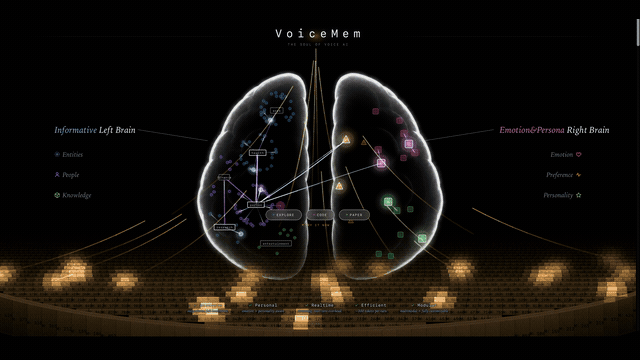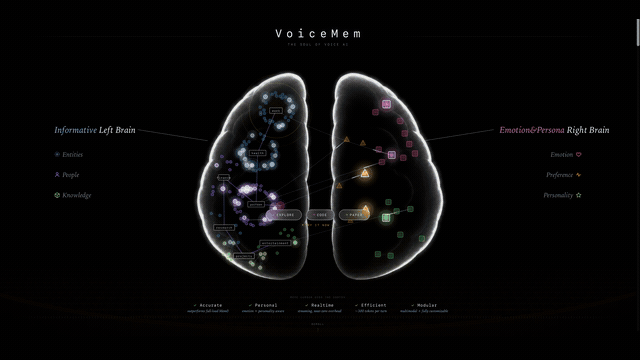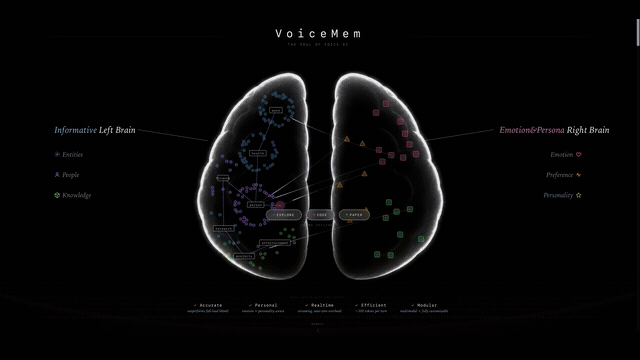
精选文章 语音 Agent 如何获得连续记忆?颜水成团队发布 VoiceMem!打造首个面向实时语音“流式双脑”记忆底座 当AI成为与人长期共生的AGI Being时,默契也将成为人机关系的一部分。 所谓默契,就是你不用反复交代过去,它也知道你为什么此刻提起此事;你的想法改变了,它也能及时跟上。 这种默契需要记忆。即使你没有重新提起过去的经历、偏好和感受,它也能听懂你此刻的话。 但在实时语音里,留给AI寻找这些的时间非
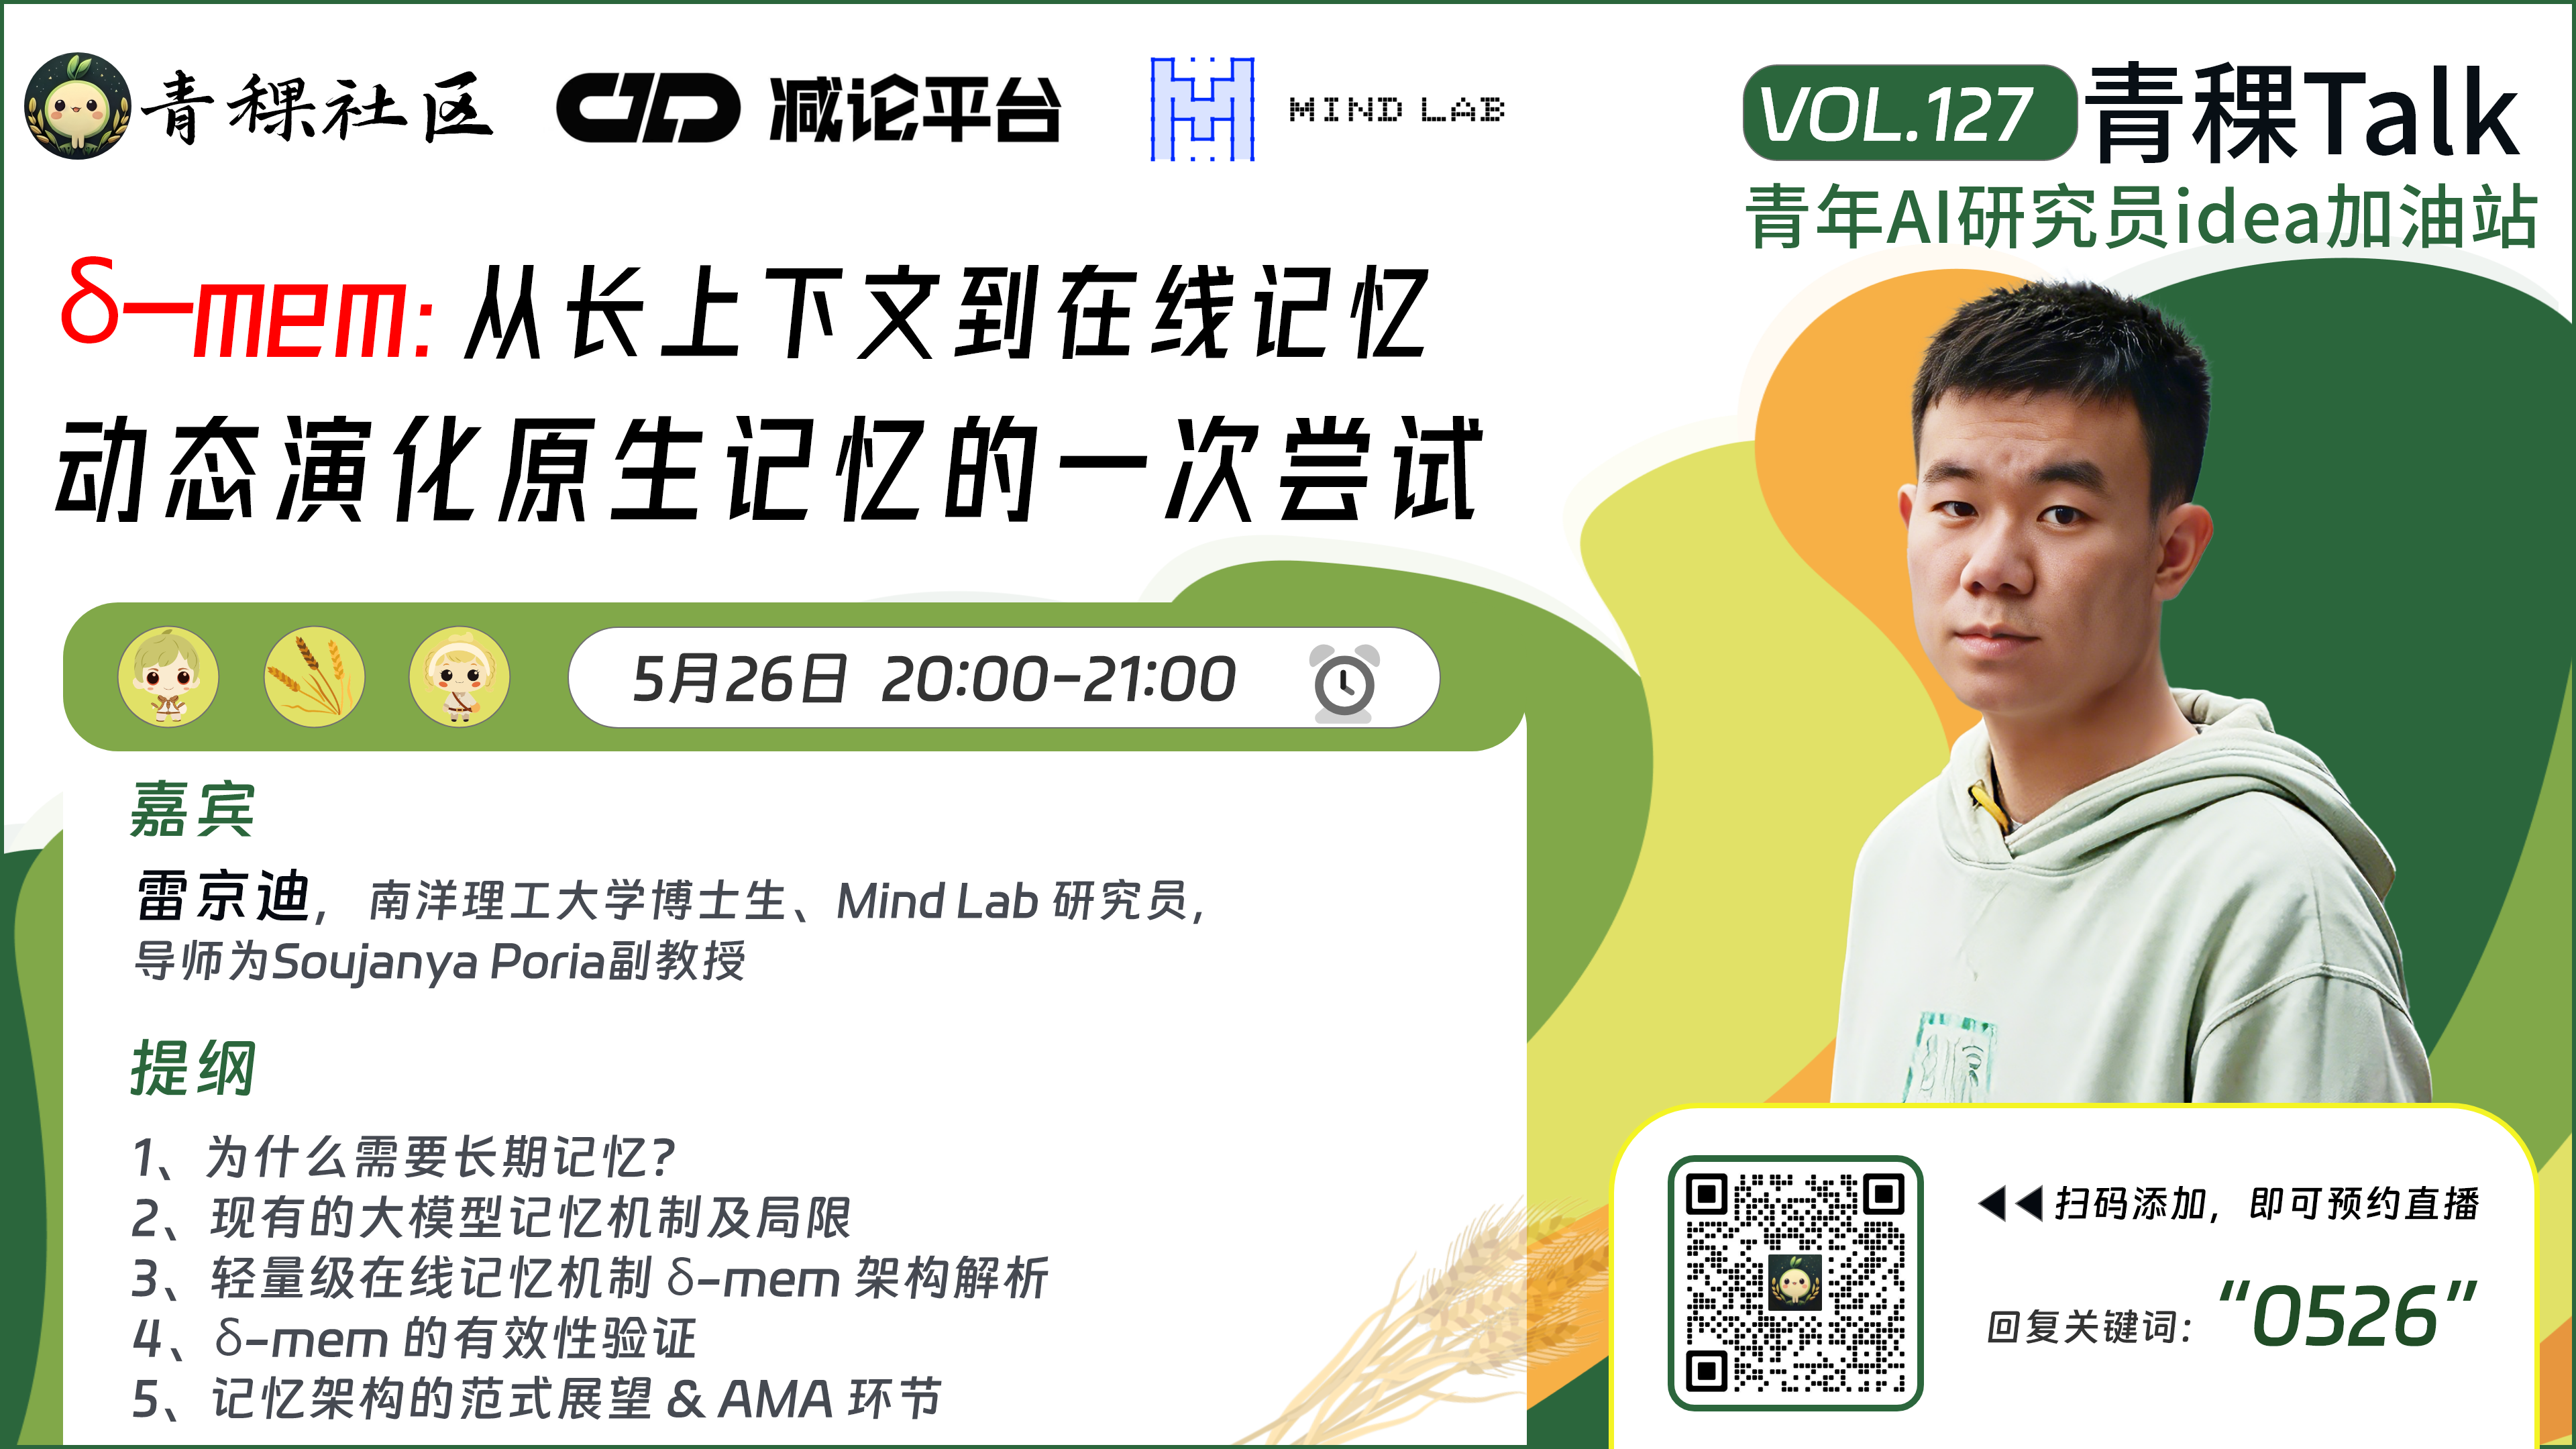
青稞Talk δ-mem:从长上下文到在线记忆,动态演化原生记忆的一次尝试 δ-mem是一种面向大语言模型的轻量级在线记忆机制。不同于把历史全部塞进长上下文,δ-mem 将过去信息压缩进一个极小的在线关联记忆状态,并在生成时通过低秩 correction 直接调制 frozen Transformer 的 attention computation。 主实验中,仅使用 8
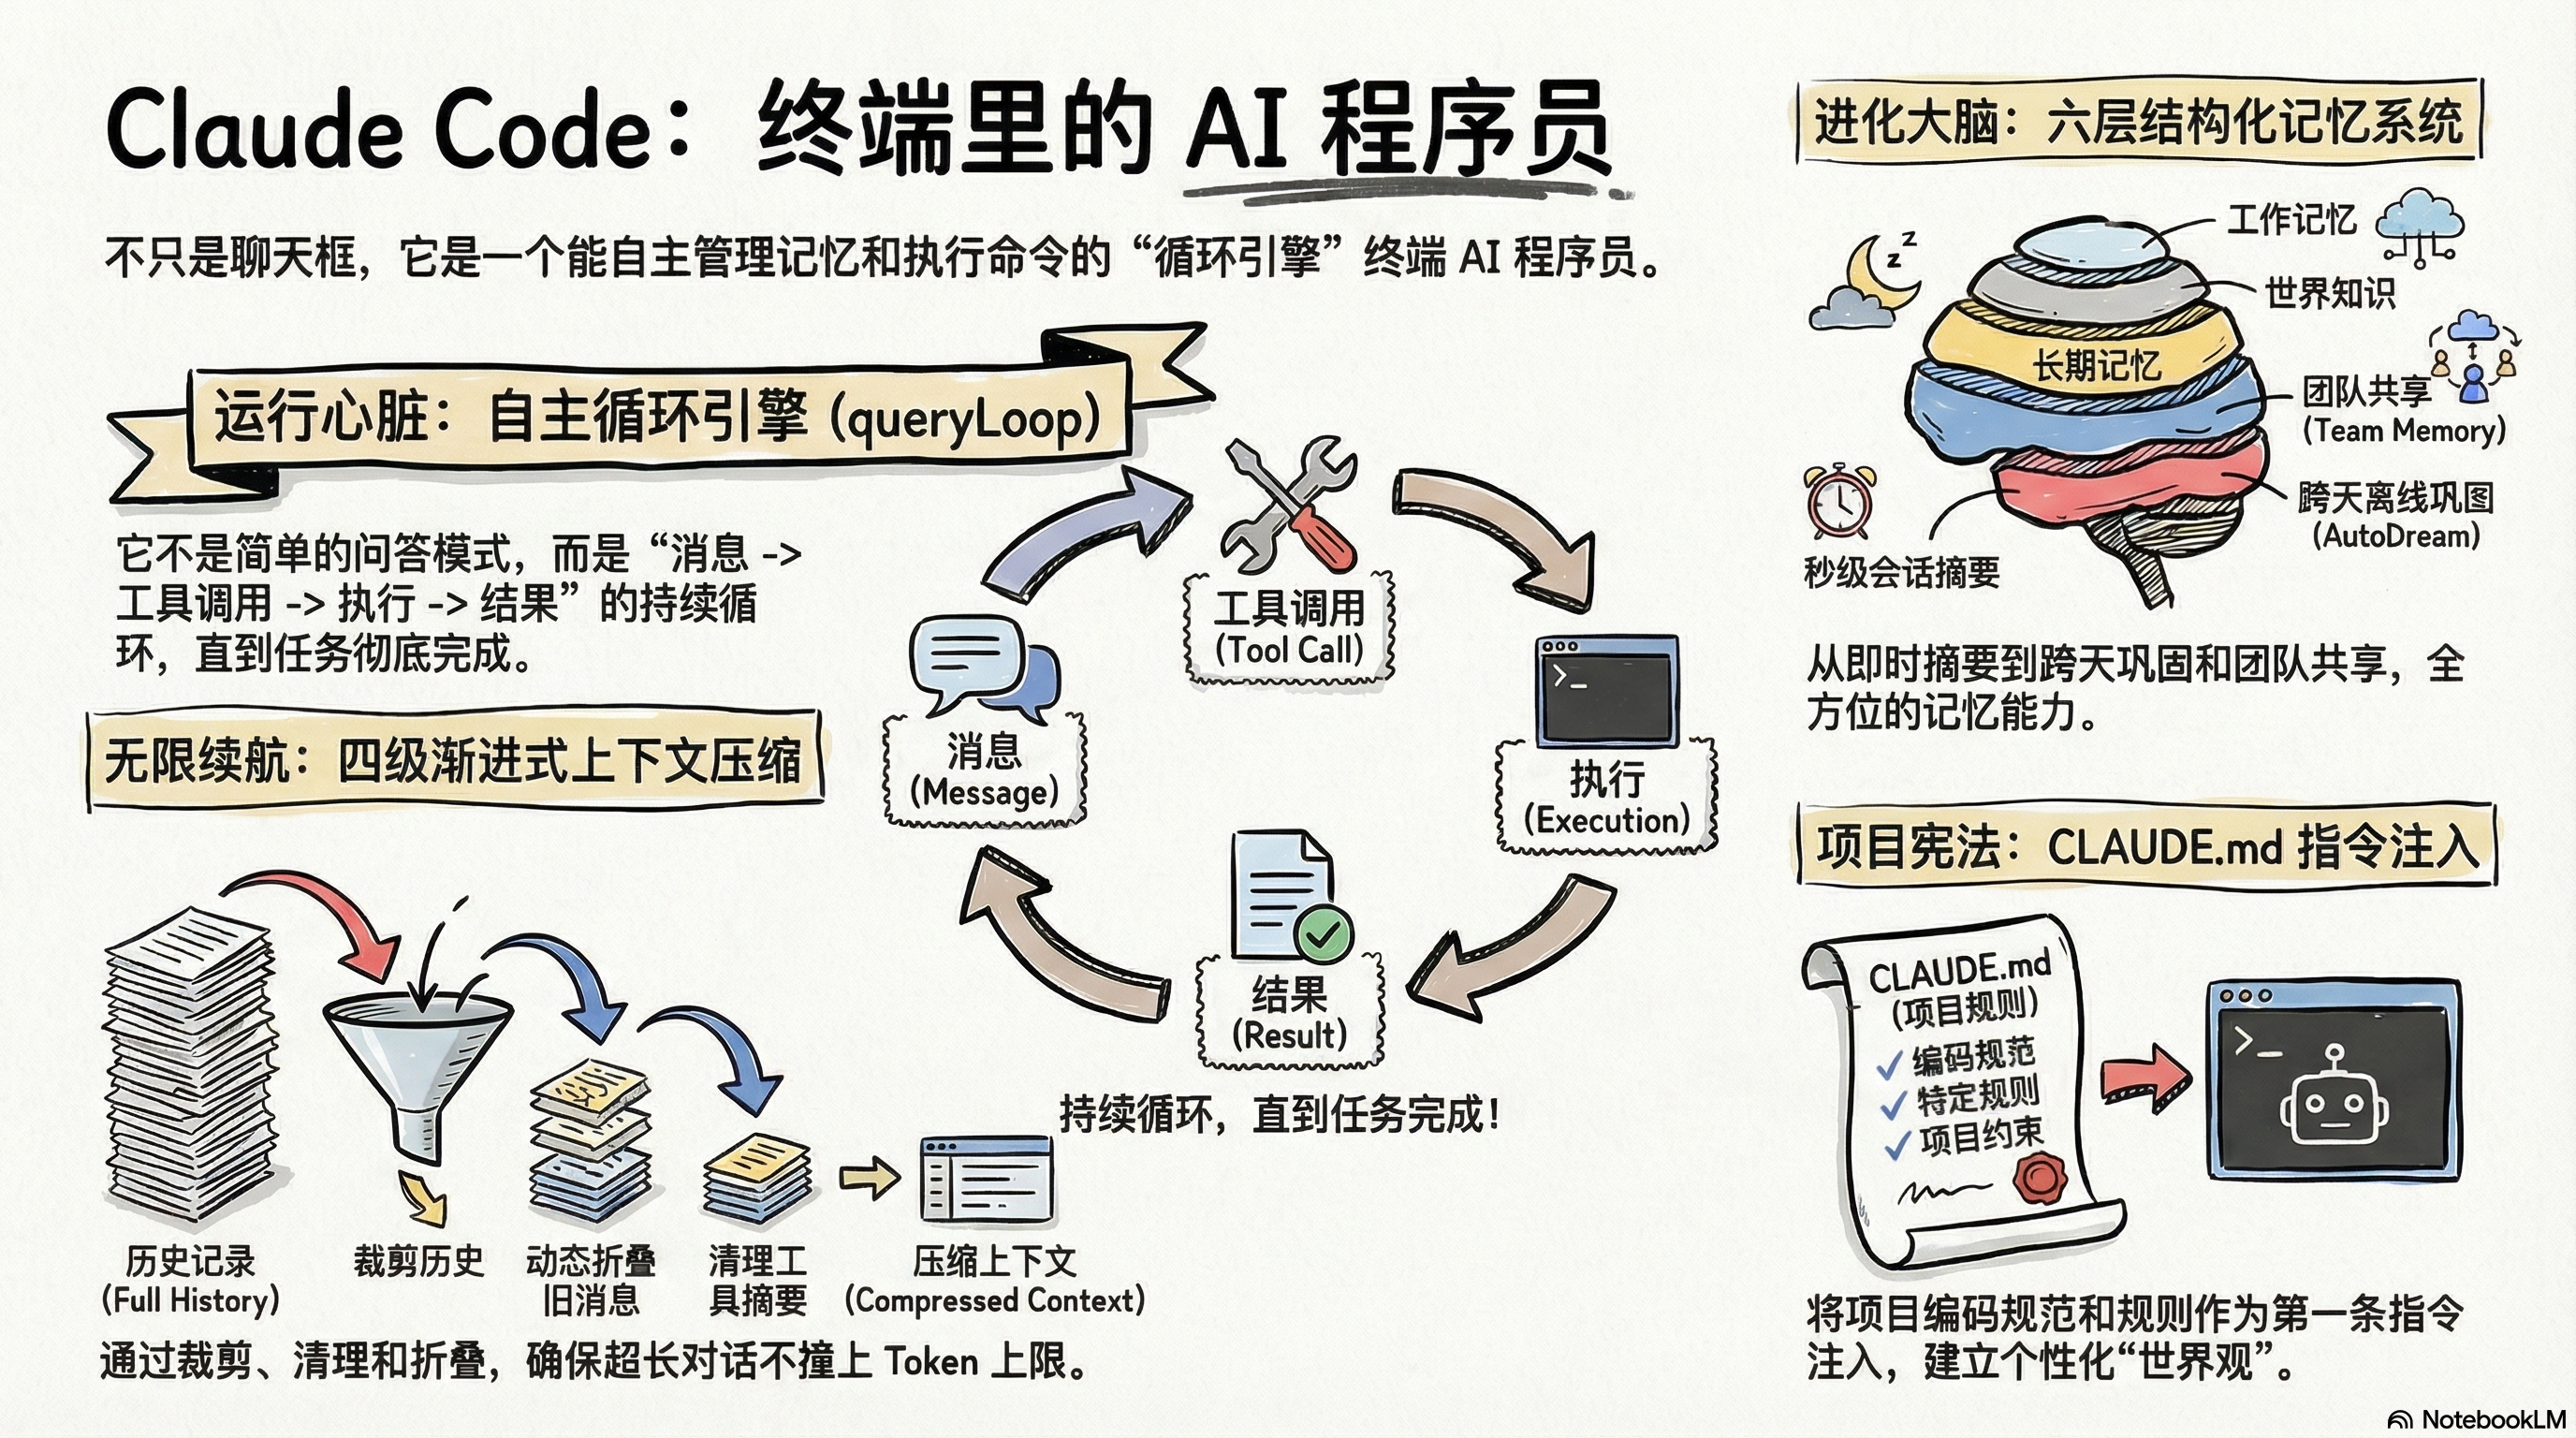
精选文章 Claude Code 源码深度解析:运行机制与 Memory 模块详解 本文档基于 Claude Code CLI 工具的源码进行深度分析,旨在用清晰易懂但专业的语言,详细讲解其内部运行机制。特别关注 Memory(记忆)模块的设计与实现。 1. 项目总览:Claude Code 是什么 Claude Code 是 Anthropic 官方开发的命令行 AI 编程助手(