用 Agent 写代码,一个任务通常不止一次问答。它要读文件、调用工具、修改代码、跑测试,再根据结果继续行动。
在同一个会话里做得越久,积累的历史就越多。之前读过的文件、重复的测试日志、已经结束的任务,都可能继续跟在后面的请求里。当前只想改一个小功能,却要带上越来越多的旧信息。
这段时间,我们围绕这个问题继续完善了以下功能:扩展常见 Harness 接入,提供可视化面板,并增加了由用户选择的任务级上下文清理。
我们的最终目的是希望 Agent 能在日常使用中积累经验、持续改进,同时减少运行和改进带来的开销。
当前我们先解决的一个具体问题:让 Agent 的执行过程更轻量,也让长会话中的上下文更容易管理。 相关论文 TokenPilot: Cache-Efficient Context Management for LLM Agents 已被 EMNLP 2026 录用。
项目:https://github.com/zjunlp/LightRSI
论文:https://arxiv.org/abs/2606.17016
实验复现:https://github.com/Xubqpanda/TokenPilot
01|从一次次执行,开始减轻负担
Agent 从接收任务,到调用工具、根据反馈继续行动,最终完成任务,这一段执行过程通常称为 rollout。过程中产生的回答、工具调用和反馈,则构成执行轨迹。
rollout 中的一份长日志,不只占据当前这轮请求。只要它留在上下文里,后面每轮请求都可能继续携带它。类似内容越积越多,推理开销也会增加。
有用的历史又不能随便丢掉。刚定位到的文件、还没解决的报错、后续要用的文档,都可能影响下一步工作。
TokenPilot 处理的就是这个问题:减少反复携带的冗余信息,同时考虑有用历史的保留和缓存的复用。
它是 LightRSI 当前用于轻量化 rollout 的上下文管理能力。围绕这套能力,我们也提供了查看运行记录、调整策略,以及由用户选择清理内容的入口。
三个名字的关系如下:
- LightRSI:面向低成本 Agent 递归自我改进的整体项目。
- TokenPilot:当前用于轻量化 rollout 的上下文管理能力。
- Context Cleaner:帮助用户按任务查看和选择清理历史上下文的工具。
02|少带冗余,也尽量保住缓存复用
少发一些 token,通常能减少输入开销。但对于支持前缀缓存的模型服务,还要看这些内容能否复用先前的计算。
如果请求开头的一段内容保持一致,服务端就有机会复用已有缓存。反过来,频繁删改、移动历史,也可能让原本能命中的缓存失效。
因此,TokenPilot 从三个方面管理上下文。
能复用的部分,尽量保持稳定
Agent 的请求里,常有反复出现的说明和结构。时间戳、临时标识等字段的变化,有时会打断前缀匹配。
TokenPilot 对适合处理的动态字段和布局做稳定化,减少不必要的变化,让支持缓存的后端更有机会复用计算。
工具输出先精简,避免后面反复携带
一份网页可能带着大量标签和导航,一次测试可能返回冗长日志。未经处理,这些内容会进入后续多轮请求。
TokenPilot 在工具结果进入上下文时,精简结构性噪声和过长输出,并配合原始内容归档与按需恢复机制。需要细节时,Agent 可以通过恢复入口找回完整内容。
旧任务的历史,根据后续价值管理
任务结束,不代表相关信息立刻没用了。刚读过的文档、已经定位到的文件位置,还可能服务于下一项工作。
在支持相应能力并启用策略的工具中,TokenPilot 根据任务状态和后续使用价值管理旧历史,延后清理仍有用的信息,并在满足条件时移出不再需要的内容。
这三部分一起减少 rollout 中的冗余上下文和重复计算开销。
03|接入六种工具,让优化过程看得见
目前,项目已提供 OpenClaw、Claude Code(CC)、Codex、pi、DeepSeek Harness(DSH)和 OpenCode 六种工具的适配入口。
其中,pi 和 OpenCode 是这轮新增的接入。两者通过工具内部的扩展或插件运行,不需要额外的请求代理。你可以继续使用熟悉的工具,再接入相应的上下文管理能力。
安装之后,怎么检查它是否在工作?LightRSI 提供了本地浏览器可视化面板。
完成相应安装并产生会话记录后,运行:
lightrsi visual
就可以切换工具和会话,查看已记录的运行快照。面板分为三个视图。
前缀稳定:哪些变化可能影响复用?
查看基于快照的缓存审计与前缀稳定性指标,检查请求前后发生了哪些变化。
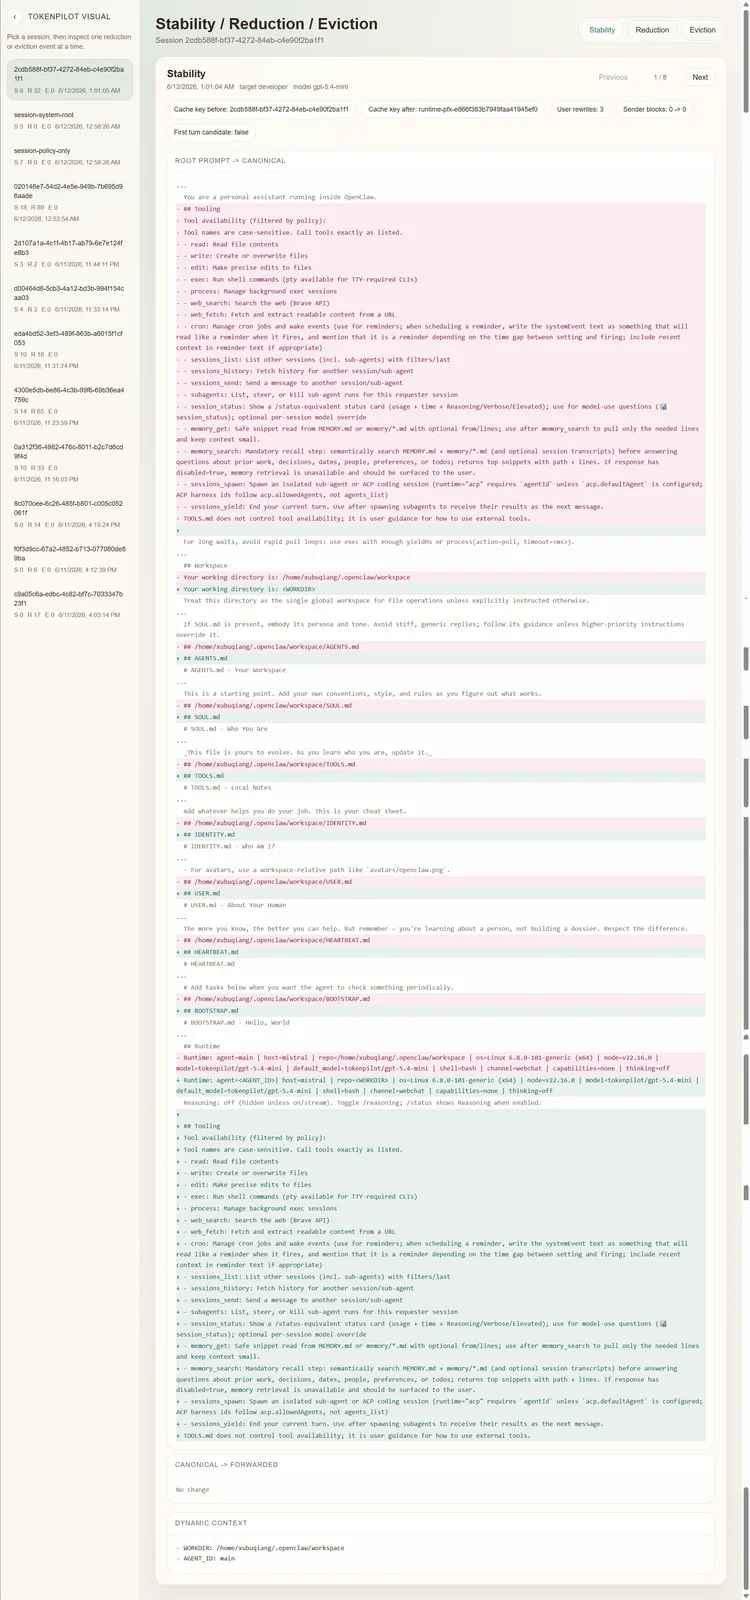
图 1|前缀稳定性视图。展示的是已记录的审计数据。
工具输出精简:哪些内容被缩短了?
查看工具输出处理前后的规模、精简记录和生效规则。如果感觉某项处理影响了所需信息,可以据此检查和调整。
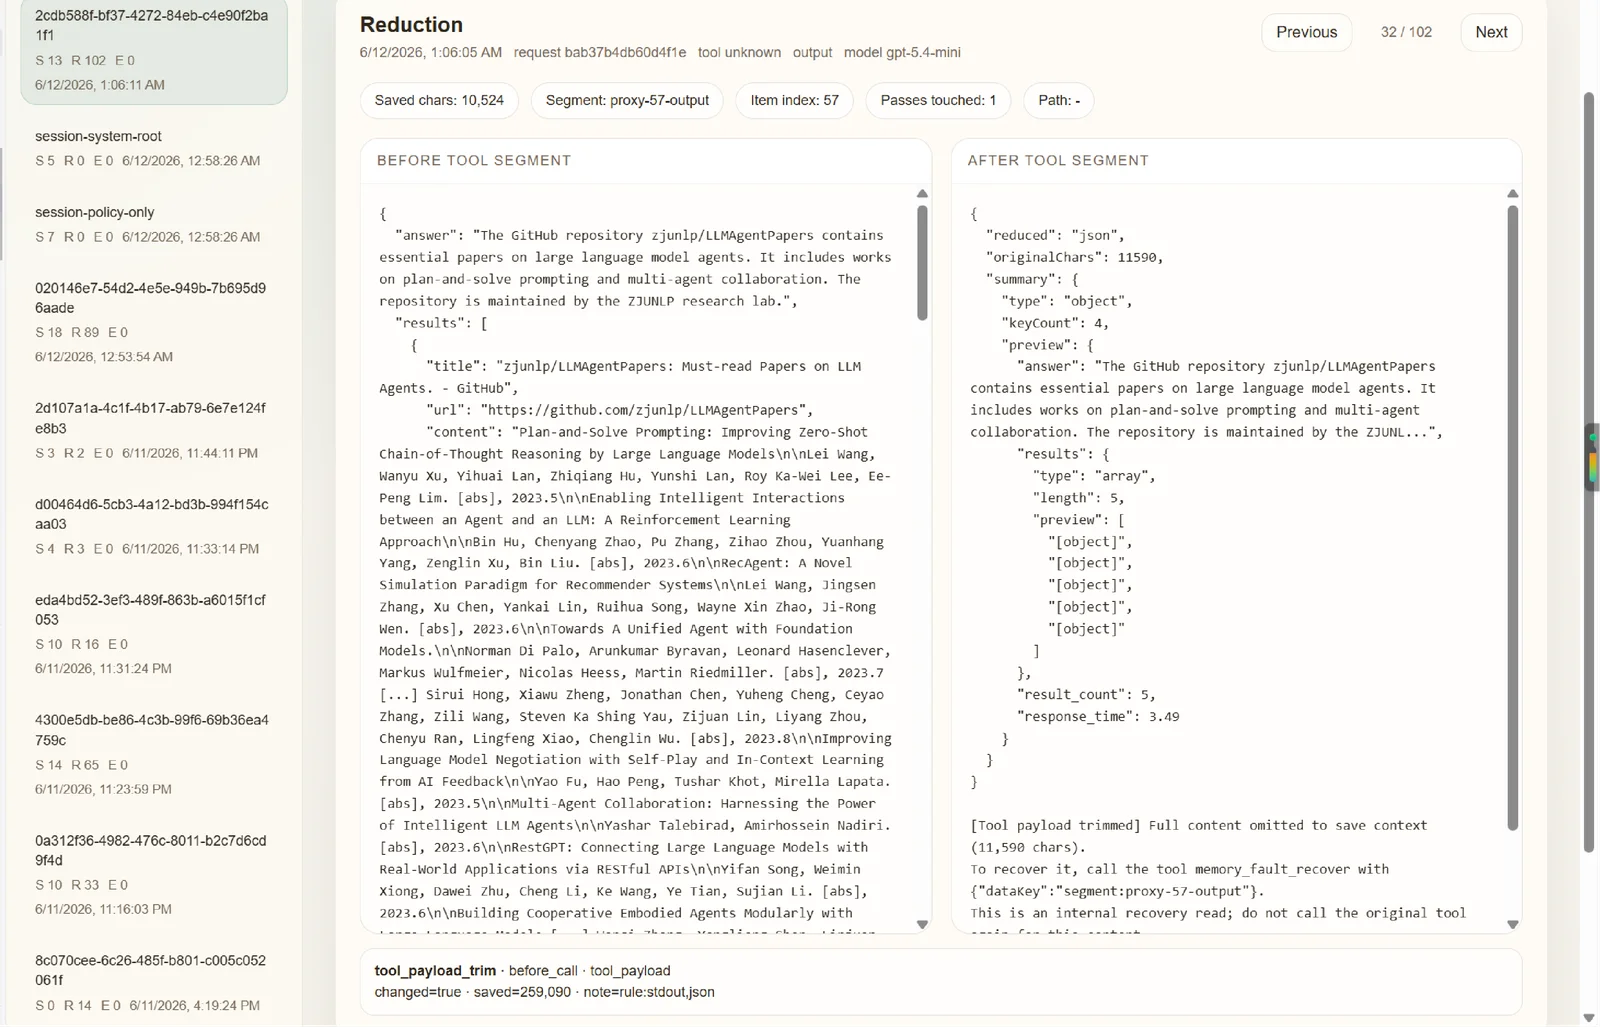
图 2|工具输出精简视图。查看长日志和结构性噪声的处理情况。
历史管理:哪些内容还在继续携带?
查看清理相关状态和记录,理解旧任务历史的保留与变化。
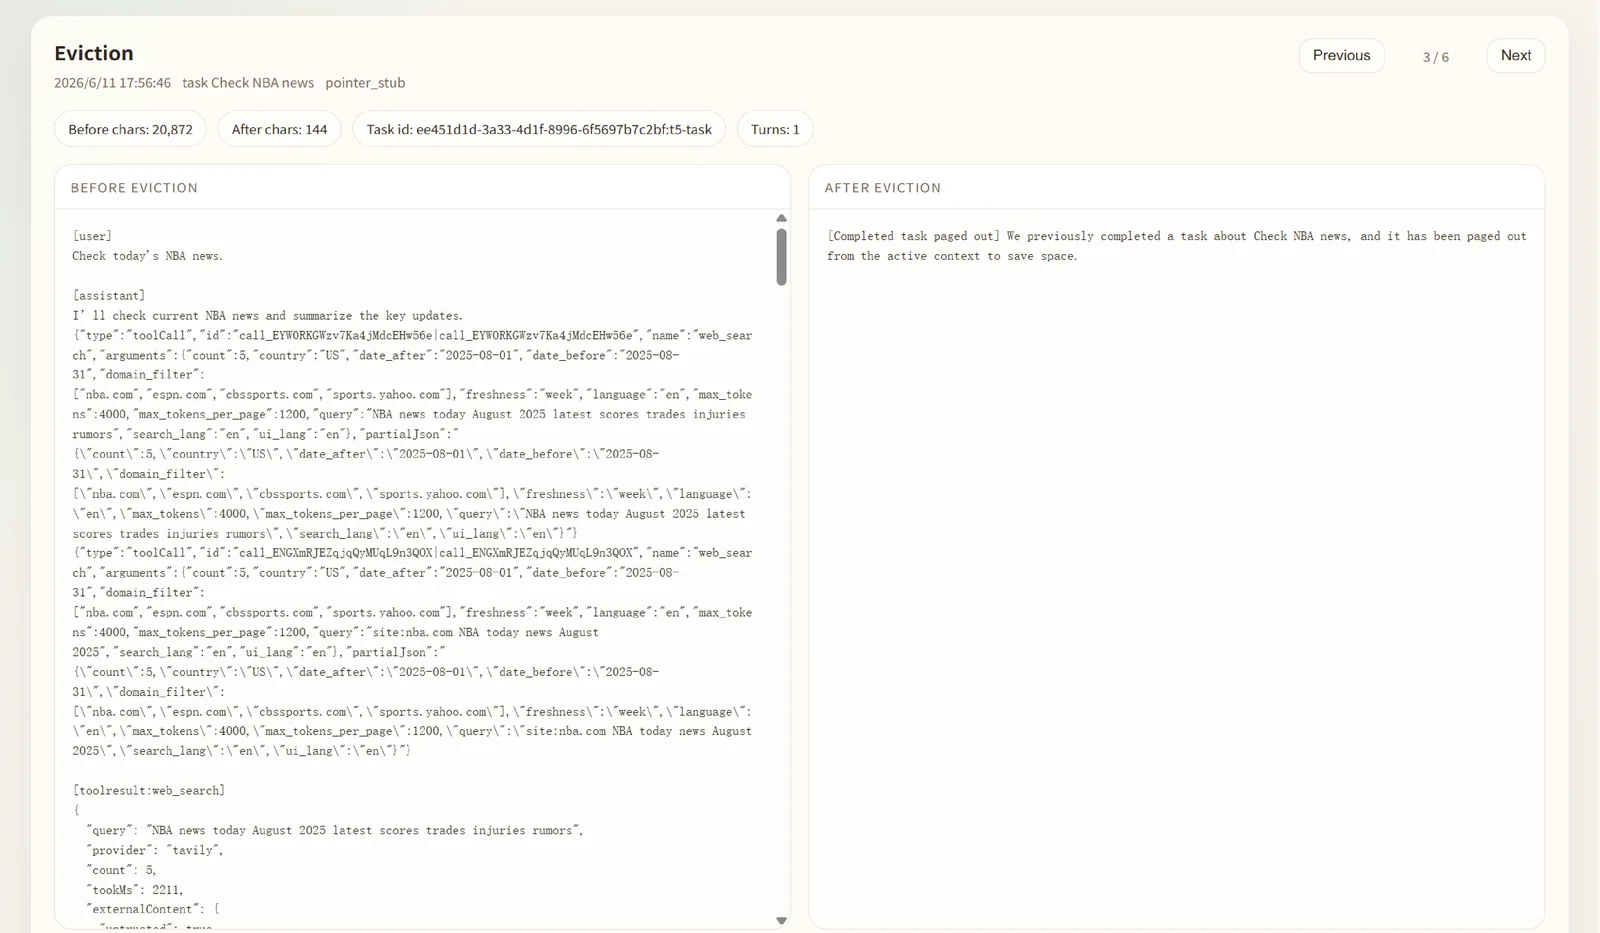
图 3|历史管理视图。展示内容取决于工具的接入能力和已有记录。
共享可视化目前支持 OpenClaw、Claude Code、Codex、pi 和 OpenCode;DSH 使用原生插件和状态命令。不同工具的能力和展示内容有所差异,pi 和 OpenCode 的自动历史清理默认关闭,需要主动开启。
新记录可以通过刷新查看。面板中的规模变化和缓存审计指标,用来帮助检查优化过程,不直接等同于服务商的账单节省。
04|Context Cleaner:按任务选择,清理决定交给你
自动处理之外,我们也提供了 Context Cleaner,让用户能够直接参与长会话的上下文整理。
比如,你在一个会话里已经完成安装排查、文档整理和登录逻辑修改。接下来准备开发新功能,前两项任务留下的大量细节可能不再需要,但登录逻辑的记录还值得保留。
Cleaner 会把可识别的上下文按任务列出来,展示任务描述、占用情况、保留或清理建议,以及受保护内容。你查看后,再决定清理哪几项。
先分析,再选择。没有你的明确确认,不执行清理。
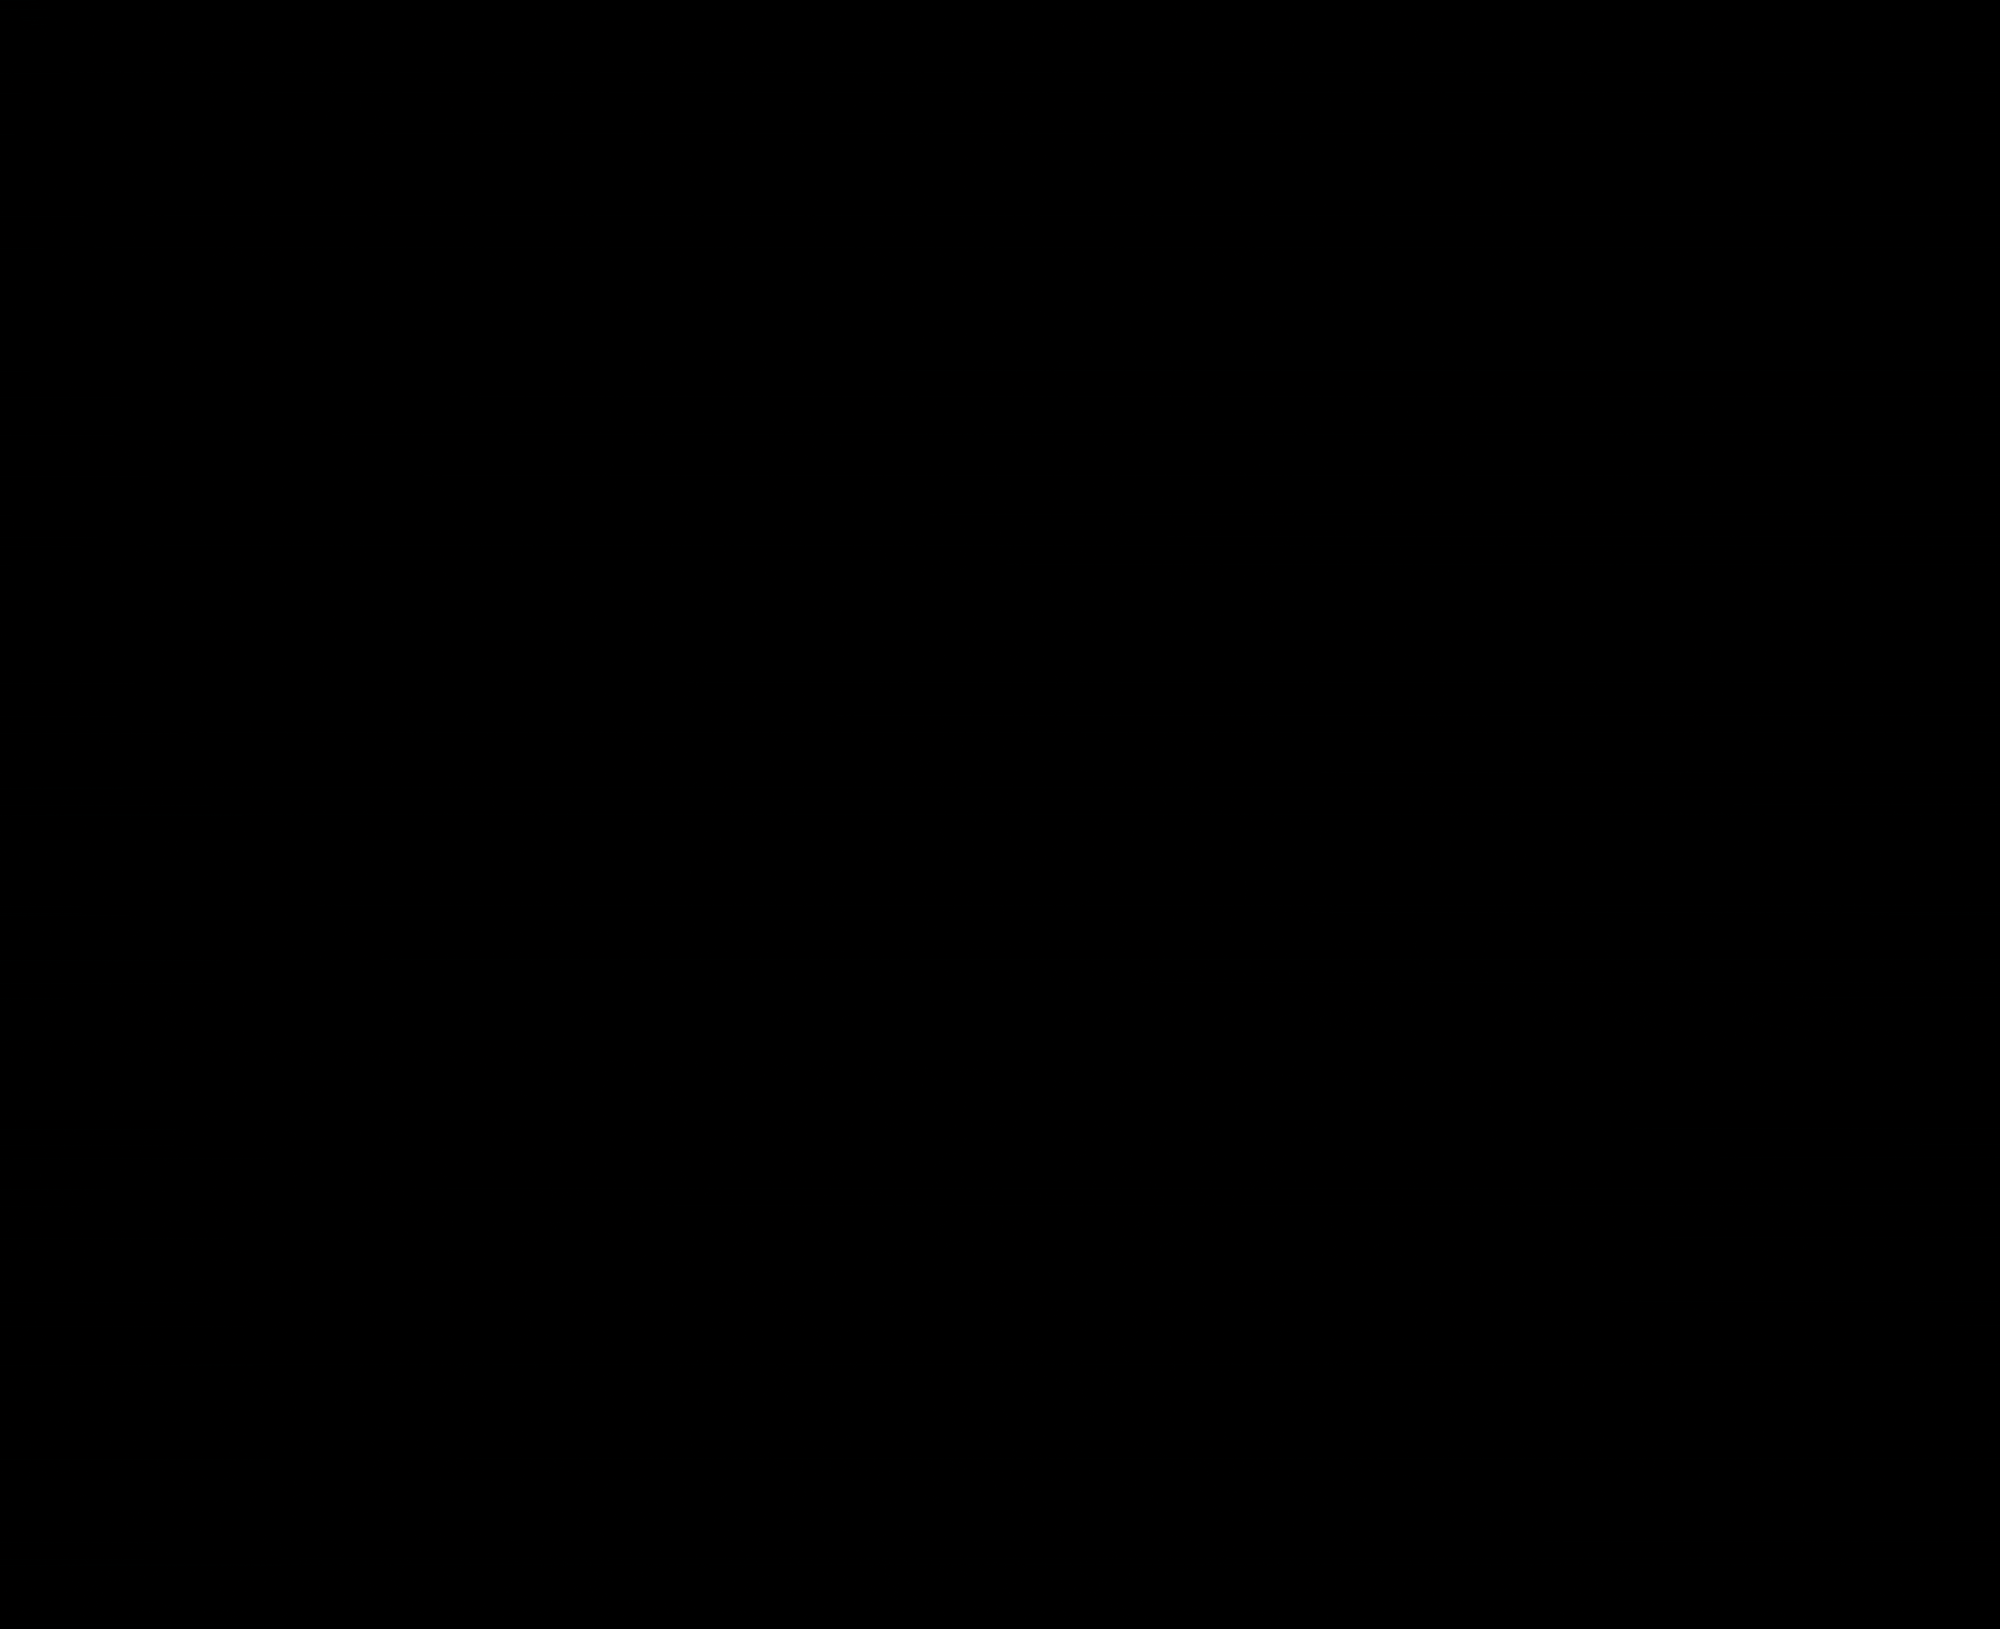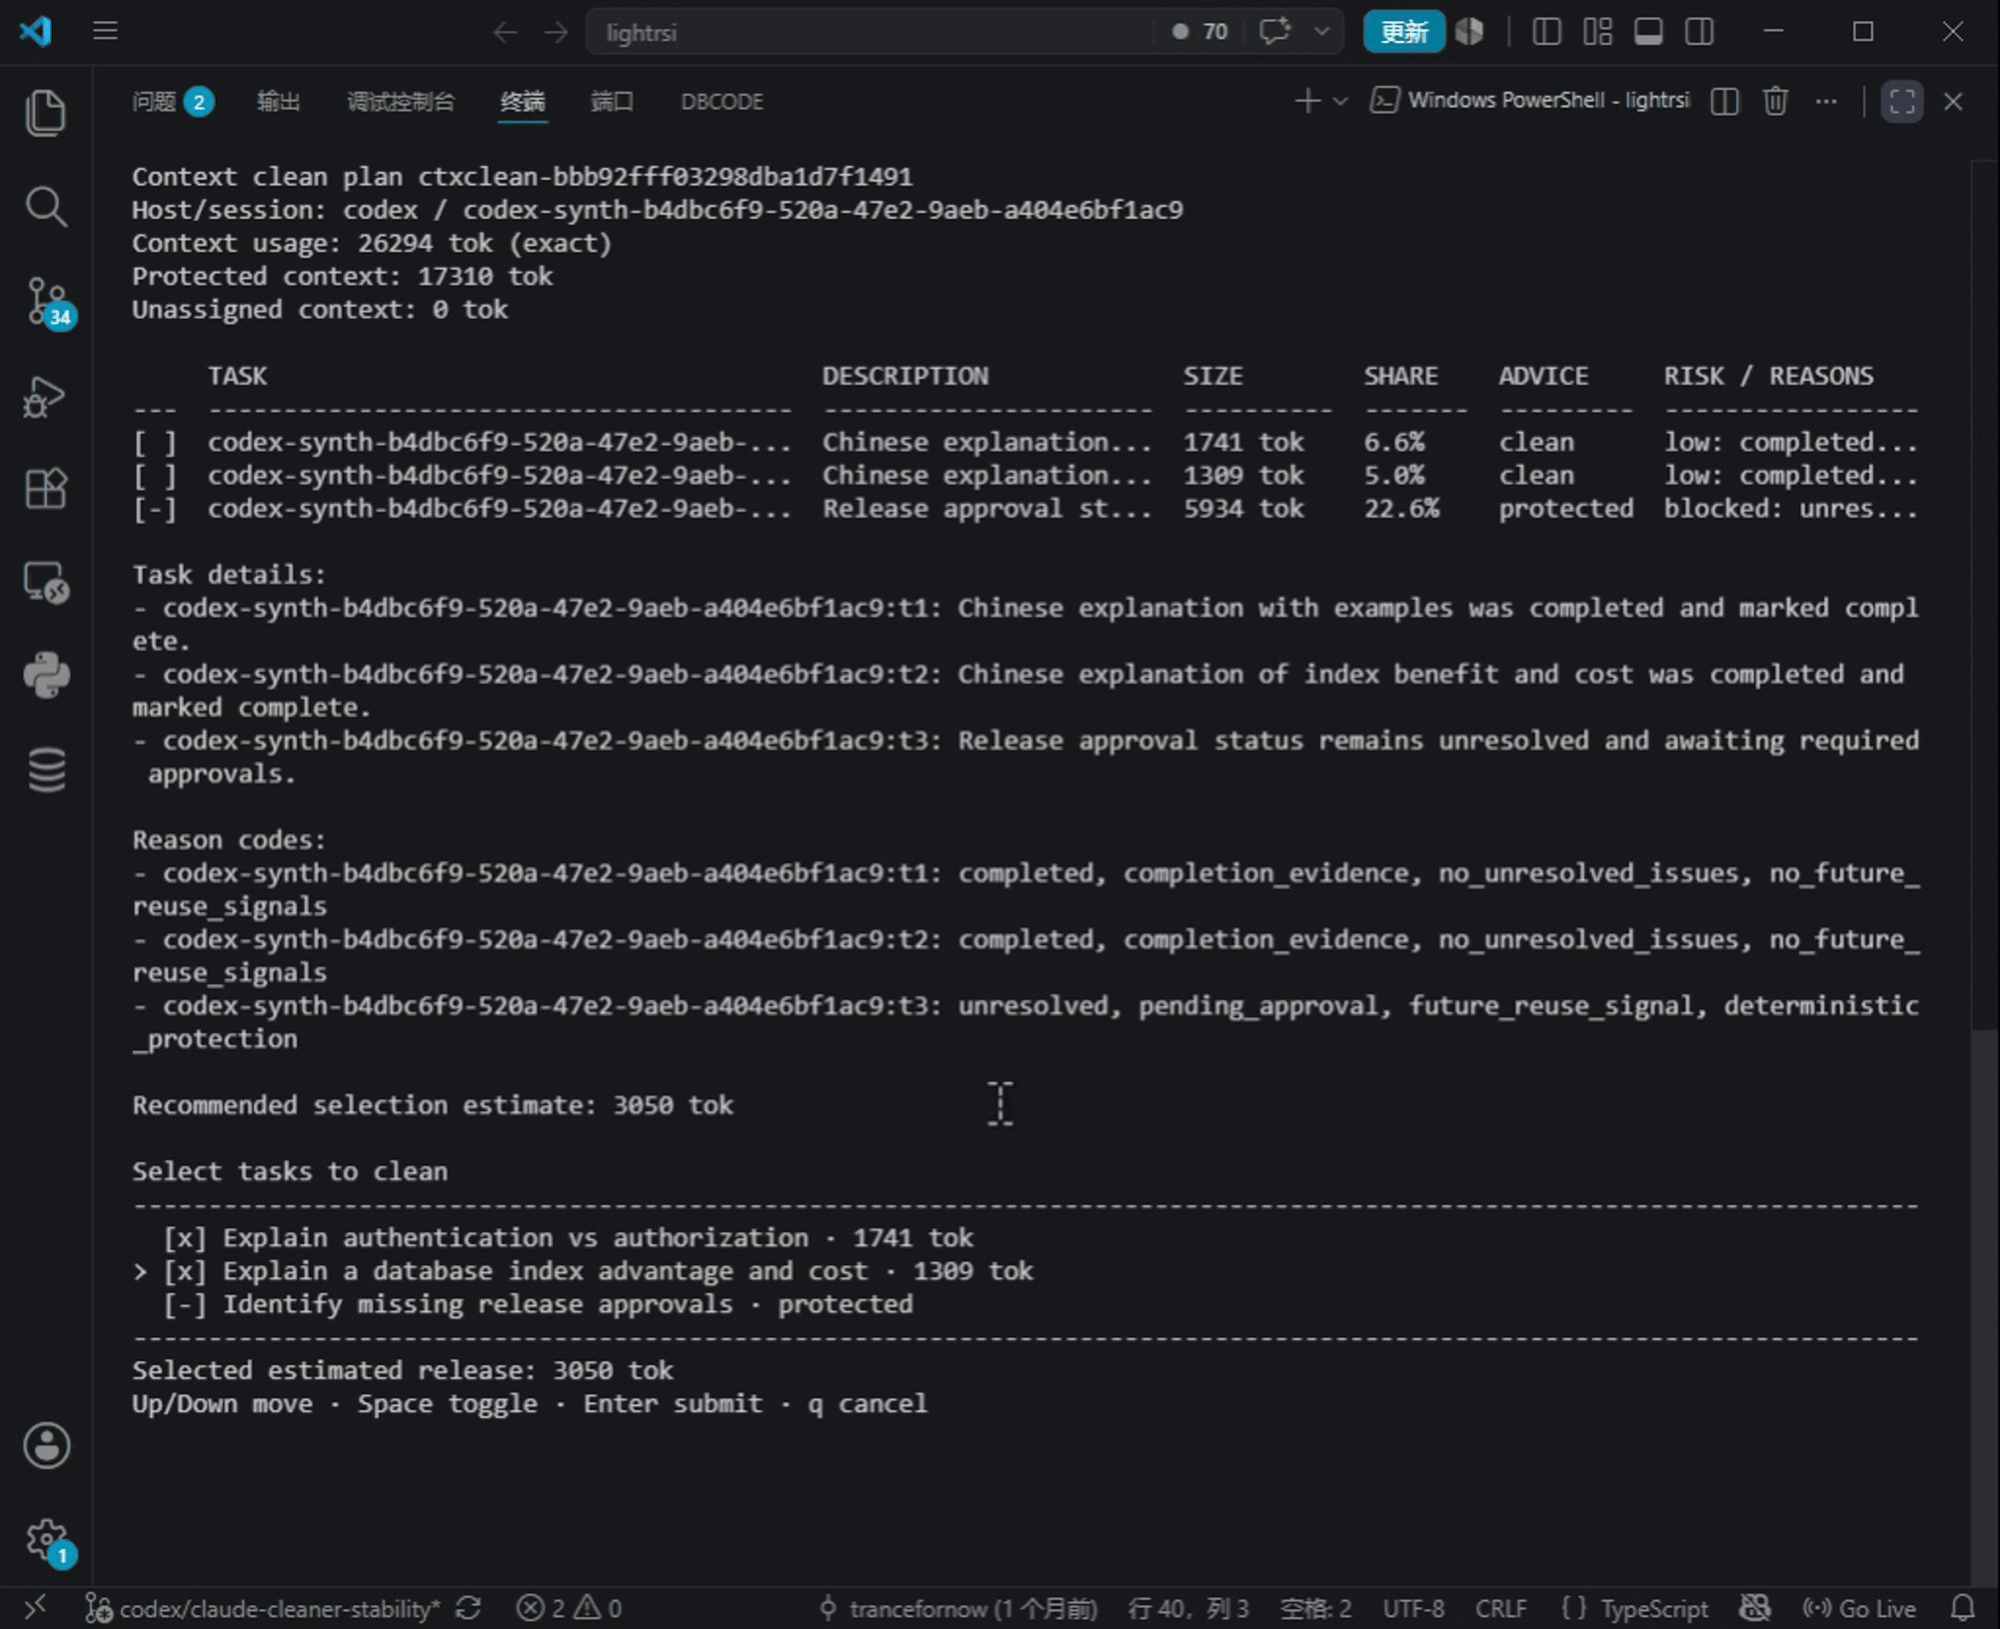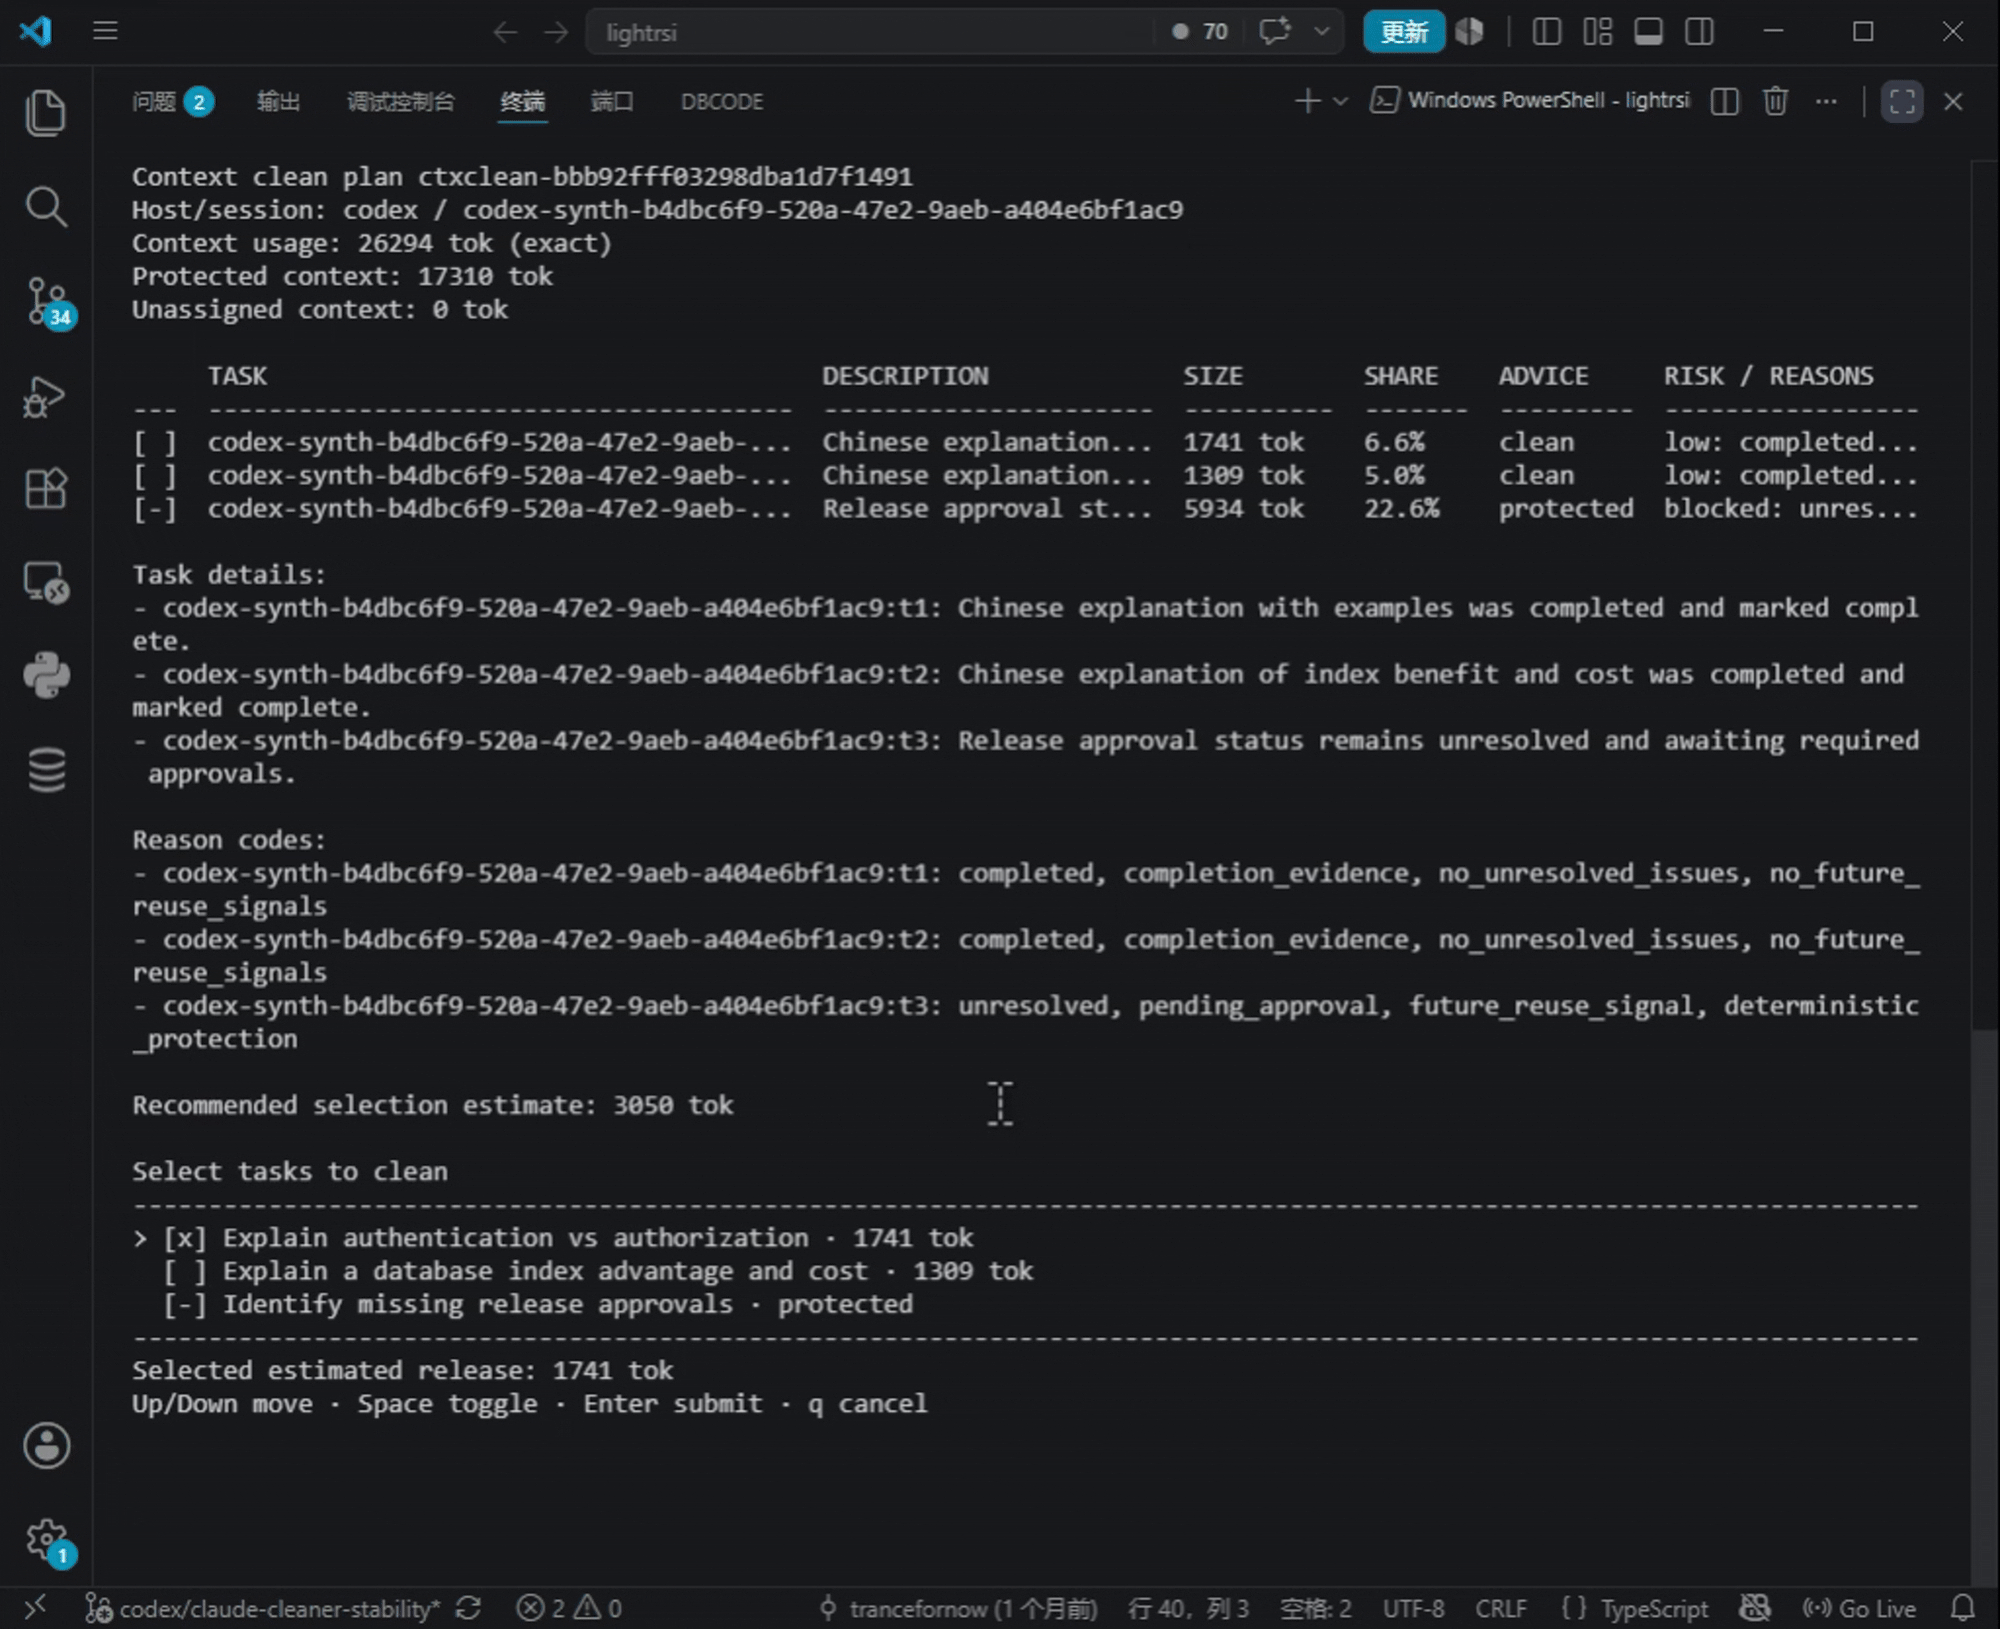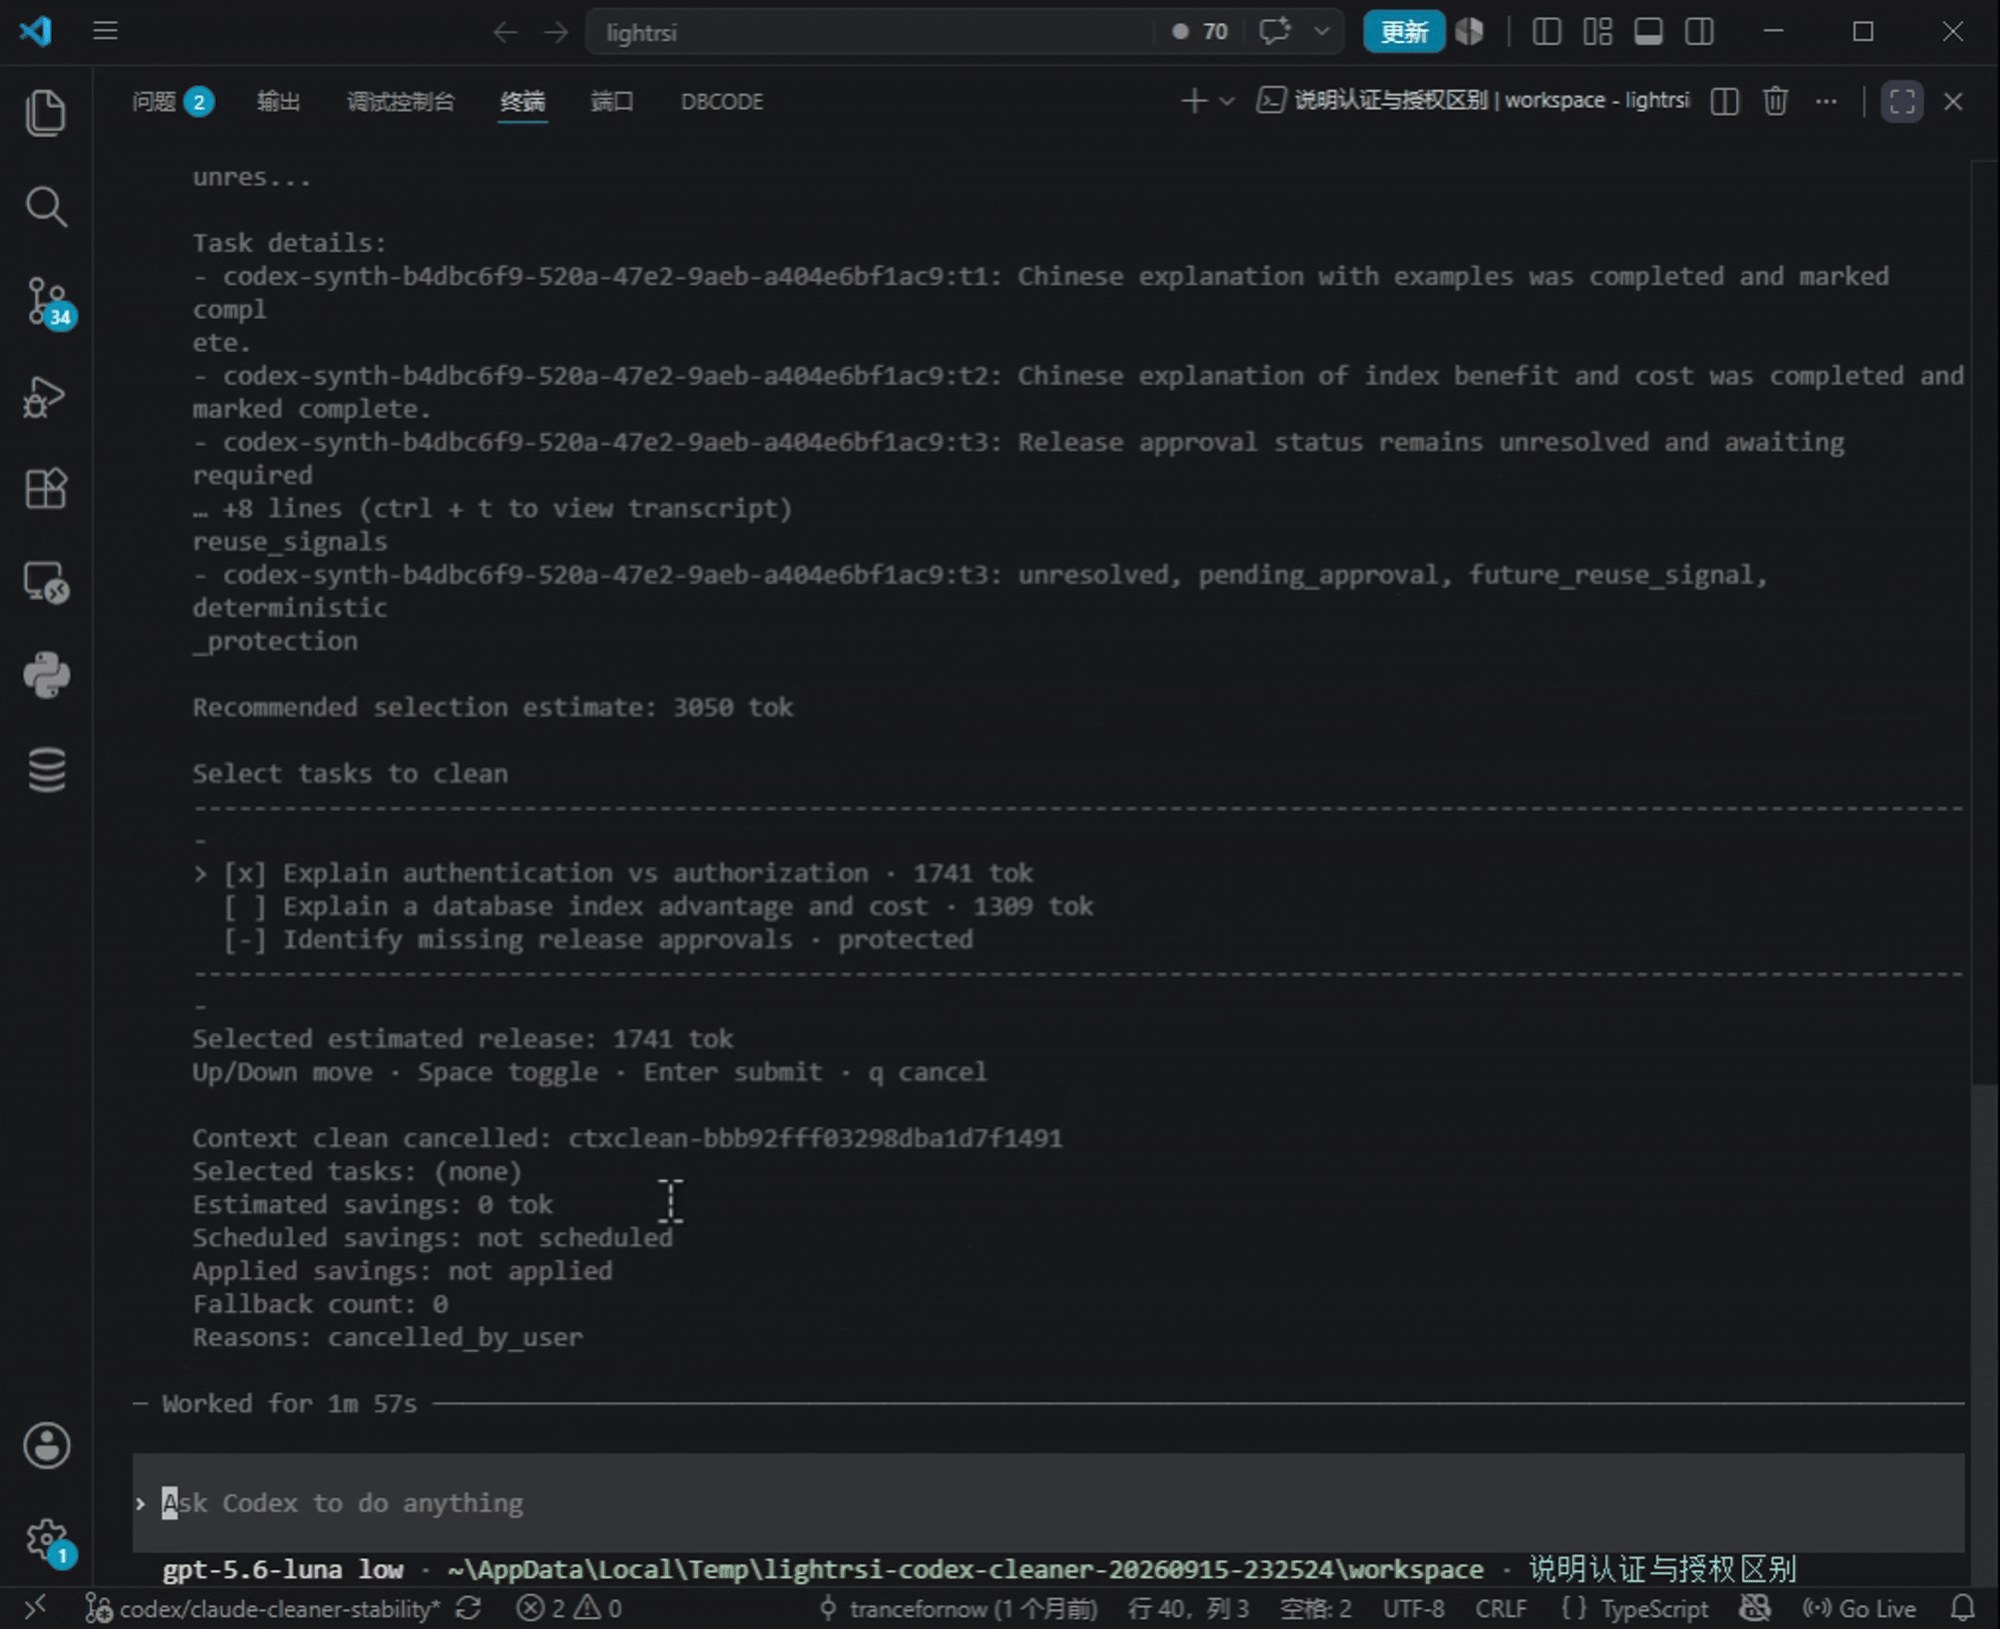
图 4|以 Codex 为例,用户查看任务列表,并明确选择要清理的内容。
正在进行的任务、未解决的问题、系统指令,以及不满足安全条件的内容,会受到保护。任务列表中的建议也不会替用户勾选。
目前,Cleaner 支持 OpenClaw、Codex、Claude Code 和 DSH,尚未接入 pi 和 OpenCode。用户确认后,计划会等待同一会话的后续正常请求执行,并提供状态查询。
清理作用于后续送给模型的上下文,项目文件不受影响。待执行的计划可以取消;已经执行的清理不能通过取消操作撤销。
05|效果如何?看连续任务中的成本变化
TokenPilot 不需要重新训练基础模型,主要改变每次请求携带什么,以及如何组织这些内容。
论文在 PinchBench 和 Claw-Eval 上进行了评测。在多个任务连续使用同一个会话的设置中,推理成本有明显下降:
| 论文连续任务实验 | 原始设置成本 | TokenPilot 成本 | 成本降幅 |
|---|---|---|---|
| PinchBench | $7.24 | $2.79 | 约 61% |
| Claw-Eval | $81.52 | $10.58 | 约 87% |
任务得分方面,PinchBench 从 79.2 提升至 81.3;Claw-Eval 从 63.4 降至 60.8。成本降低的同时,任务表现也存在差异,需要结合实际工作评估。
在论文的前缀稳定化分析中,两个基准的宏观缓存命中率分别从 38.7% 提升至 79.2%、从 67.2% 提升至 83.1%。
这些数字来自特定模型、任务和计费设置,不是六个平台的统一实测。日常使用中的收益,还取决于后端的缓存支持、工具输出规模和任务之间的关联。
这次工程更新,则把这些能力接入了更多工具,并补上可视化和用户清理入口,让上下文优化更容易查看和使用。
06|下一步:让积累的经验更容易被利用
当前,LightRSI 从 rollout 入手,让 Agent 的长会话少一些负担,也让用户更容易管理其中的历史。
我们会继续完善工具接入、可视化和清理体验。同时,更轻量的执行轨迹利用方式也已经在开发中:让 Agent 积累的经验以更低开销用于后续改进。具体方法和结果,将在后续更新中介绍。
如果你正在用 Agent 做连续任务,欢迎体验当前版本:查看上下文如何变化,检查工具输出如何精简,再按任务整理不再需要的历史。
我们希望,每次执行更省一些,积累下来的经验也能更好地服务于下一次工作。