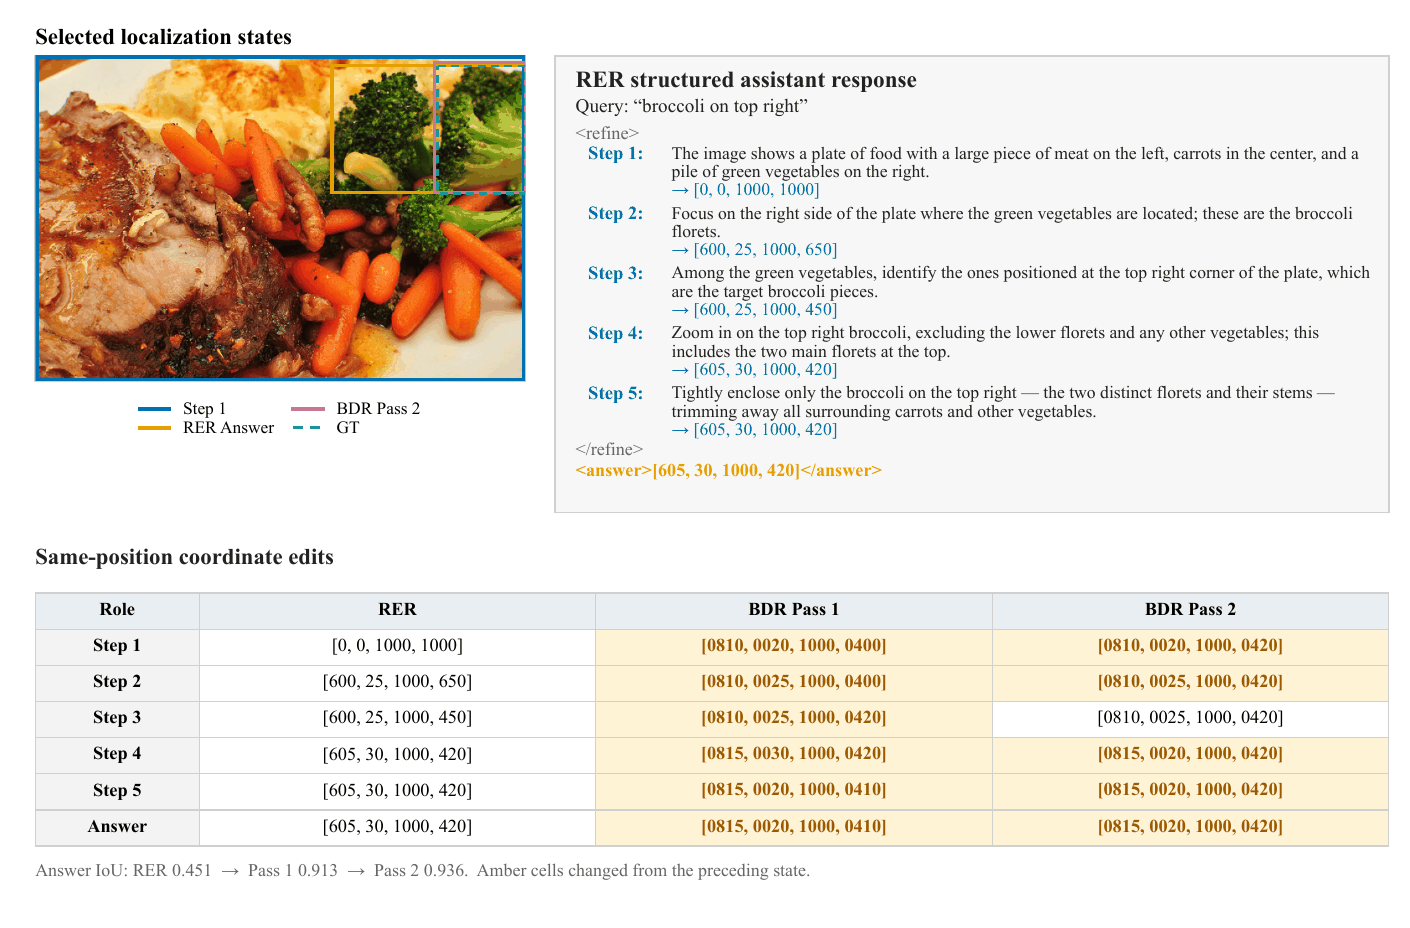
详细的语言描述,并不等于准确的视觉定位。 让模型框出“餐盘右上角的西兰花”,它可能完整描述了食物类别和相对位置,却仍把相邻的一簇圈进目标框。视觉指代定位要求将语言理解落实到具体区域与精确边界;流畅的解释本身,并不能保证中间空间判断可检查、最终坐标可纠正。
这一落差也要求重新审视后训练的终点。对于已经接受强化学习后训练的模型,继续围绕最终答案追加 RL,未必就是最优的优化路径。 当剩余误差涉及区域选择与边界偏差时,值得进一步研究的是:如何保留可操作的空间判断,并训练模型在已有判断上识别、取舍和修正错误。
CoEvolve 据此探索一种面向可修复性的构造—编辑后训练范式:先用强化学习将空间推理组织成显式区域轨迹,再训练双向编辑器,在保留语义上下文的同时修正坐标。RL 在这一流程中承担状态构造的职责,后续几何监督与编辑偏好分别学习“往哪改”和“值不值得改”,将后训练延伸到已有预测的可修复性。
保留语义上下文,通过坐标编辑修正定位偏差。
先看效果:9B 主干的定位表现与单轮纠错能力
在论文汇总的 RefCOCO 系列对比中,采用 9B 主干的 CoEvolve,整体定位准确率与总参数量达 241B 的模型相当。
表 1|标准视觉定位:八个划分的平均 Acc@0.5。
| 方法 | 参数规模 / 主干 | 准确率(%)↑ |
|---|---|---|
| Qwen3.5-9B | 9B | 89.48 |
| InternVL3.5-241B-A28B | 241B | 92.39 |
| CoEvolve | 9B 主干 | 92.41 |
数值摘自论文主表;公开方法沿用其报告协议,241B 为总参数量。
修复能力则通过三万余个受控扰动框单独检验。面对位置、尺度和长宽比偏差,一轮编辑就将平均框重叠度提高约 27.4 个百分点,并修复近 88% 原本未达标的输入框。
表 2|受控纠错:各方法接收相同扰动框,CoEvolve 编辑器仅运行一轮。
| 方法 / 状态 | mIoU(%)↑ | 修复率(%)↑ |
|---|---|---|
| 扰动输入,未修复 | 58.80 | — |
| Qwen3.5-9B 纠错 | 83.85 | 79.88 |
| CoEvolve 编辑器 | 86.19 | 87.99 |
mIoU 衡量平均框重叠度;修复率指初始 IoU < 0.7 的框被修复至 IoU ≥ 0.7 的比例。
空间状态显式化:让推理成为可度量的优化对象
上述构造—编辑分解通过显式状态连接两个分阶段训练的组件,形成状态—编辑器耦合(State–Editor Coupling)。
Region-Evolution Reinforcement(RER,区域演化强化)要求每个推理步骤给出候选框,将分析过程组织成“语义解释+区域坐标”的轨迹。强化学习同时评价结构、空间进展和最终定位,使中间空间判断获得可计算的训练信号。这些监督来自目标框标注,无需人工编写推理链或额外标注中间区域。
后续编辑因此拥有明确的操作对象:候选区域、定位历史,以及可供比较的输入坐标。
相对编辑效用:让优化方向与修正收益对齐
Bidirectional Denoising Refiner(BDR,双向去噪精修器)读取完整轨迹,将推理文字作为固定语义上下文,利用双向信息在坐标原位置同步预测修改结果。
BDR 区分目标几何与相对编辑效用:前者规定坐标应移向哪里,后者评价修改是否优于保留输入。训练中的质量门控选择保留、纠正或巩固的目标,逐坐标偏好则鼓励有益修改、抑制有害修改。
这一偏好目标具有明确的方向性质。对参与监督的坐标,记 (D) 为发生变化的数字位置上、输出相对输入的平均模型评分差,(y) 标记修改是否减小坐标误差。其偏好损失 (\ell) 满足:
有益编辑对应 (y=1),梯度下降推动 (D) 增大;有害编辑对应 (y=0),则推动 (D) 减小。这将编辑取舍落实为具有明确方向的优化信号。
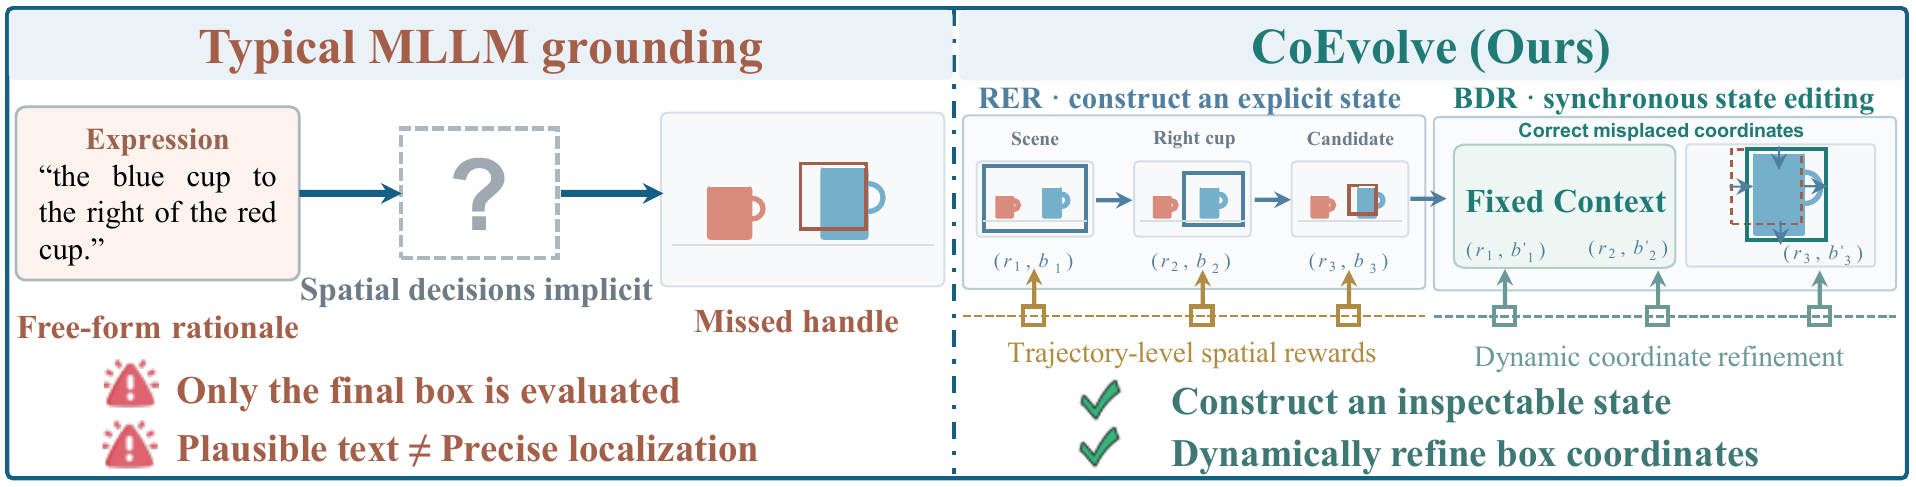
RER 构造显式空间状态;BDR 结合目标几何与相对编辑效用,学习坐标修正。
状态—编辑器耦合:用下游精修评价状态价值
论文分别为原生输出和 RER 状态训练匹配的编辑器。RER 路径的 mIoU 精修增益为 5.02 个百分点,原生输出路径为 2.41 个百分点;前者的最终 mIoU 也更高,达到 85.72%,对比 84.57%。
这一结果支持将可修复性理解为状态与编辑器的关系属性:评价中间状态时,还应考察匹配编辑器能从中获得多少改进,以及最终能达到怎样的质量。
对后训练的启发
CoEvolve 将输出准确率、空间状态构造和编辑效用纳入同一套后训练设计。由此,中间状态既是一次预测的结果,也是后续修正可利用的接口。
对于动作参数、代码补丁等可结构化编辑的输出,这提供了一条值得验证的路线:训练可供编辑的状态,学习相对输入的修正效用,并以状态与编辑器的组合表现评价系统。