做Agentic rl infra也有一段时间了,这期间也一直在跟进国内几家头部大模型公布的RL infra技术细节, 感觉到这个时间点,技术路线已经逐渐趋近收敛, 不太像去年年底那时候agentic rl infra还是刚起步的蛮荒状态。
本文基于 11 份 2025–2026 年公开技术报告与官方博客整理,覆盖小米 MiMo、DeepSeek、Moonshot Kimi、智谱 GLM/Z.ai、阿里 Qwen、MiniMax、阶跃 StepFun、美团 LongCat、蚂蚁 Ling/Ring、字节 Seed、腾讯混元共 11 组团队。如果有不正确或者疏漏的地方,欢迎斧正。
0. 背景
过去三年里,大模型的后训练(post-training)范式经历了从 RLHF(基于人类反馈的强化学习,Reinforcement Learning from Human Feedback)到 RLVR(基于可验证奖励的强化学习,Reinforcement Learning with Verifiable Rewards),再到 Agentic RL(面向智能体的强化学习)的快速演进。
RLHF 时代的优化对象是单轮对话 + 标量偏好奖励,RLVR 把奖励换成了数学题、代码单测这类可自动判定的信号,而 Agentic RL 则把训练对象彻底变成了在真实或仿真环境里多轮调用工具、读写文件、执行代码、检索网页、完成长程任务 的智能体轨迹。这一转变在 2026 年集中爆发.
本文梳理的 11 组团队,几乎都把 agentic 编程(SWE)、终端操作、深度搜索、GUI/多模态操作、长程助手工作流作为 RL 的主战场。小米 MiMo-V2.6 甚至提出You Only RL Once——在单次混合 run 里同时训练 code/general/visual/cyber 四大领域12;DeepSeek-V4.1 也认为:“ 在当前阶段,对数据与环境流程进行工程化的边际回报,显著超过后训练中算法创新的边际回报 ” 3。
Agentic RL 场景给AI Infra带来以下四个挑战
1、 轨迹变长——单条轨迹动辄数百到数千次工具调用、累计数百万 token,Kimi K3 的 RL 直接面向 1M 上下文4,Qwen3-Coder-Next 的 SWE RL 让平均交互轮数从 50 涨到 1305
2、 环境变杂——rollout 不再是模型自回归吐 token,而要穿插代码沙箱、浏览器、MCP 工具、终端会话等外部系统,这些系统有自己的启动延迟、故障率和不确定性
3、 奖励变稀疏——一条跑了几百步的轨迹往往只有最终一个二值结果,中间每一步该分配多少cridit成了核心难题。
4、 强长尾 轨迹完成时间方差极大, 约 5% 的样本 占了约 80% 的生成开销;如果同步等最慢那条生成完再训练,那昂贵训练卡会大量空转。
总而言之,agentic rl infra 要解决的核心矛盾是: **如何在一个充满长尾与噪音的外部环境里,让训练算力持续吃饱,让梯度信号持续可信" ;**所有相关的研究都是在探讨怎么在吞吐和off-policy之间取得一个平衡。
1.Agentic RL Infra 系统全景
传统的 LLM 预训练或 SFT,本质上是一条相对封闭的数据流水线:
而 Agentic RL 的训练数据并不是提前准备好的静态数据,而是由当前 Policy 持续与外部环境交互后在线产生。因此整个系统实际上形成了一个持续运行的闭环:
当 trajectory 从简单的数学题回答扩展到浏览器操作、代码执行、工具调用、多轮交互甚至数十分钟的长程任务以后,这个闭环的复杂度会迅速超过传统 RLHF。此时,一个完整的 Agentic RL 系统通常可以拆成Control Plane、Data Plane、State Plane 和 Weight Plane四个相互关联的部分:
- Control Plane:负责全局调度、资源分配、版本管理、故障恢复与系统观测。
- Data Plane:负责 trajectory、logprob、reward 等训练数据在 Rollout、Queue、Verifier 与 Trainer 之间流转。
- State Plane:负责 KV Cache、环境状态、工具会话和 partial rollout 等运行时状态的保存与恢复。
- Weight Plane:负责 Trainer 产生的新模型权重向 Rollout Engine 的同步、转换与版本切换。

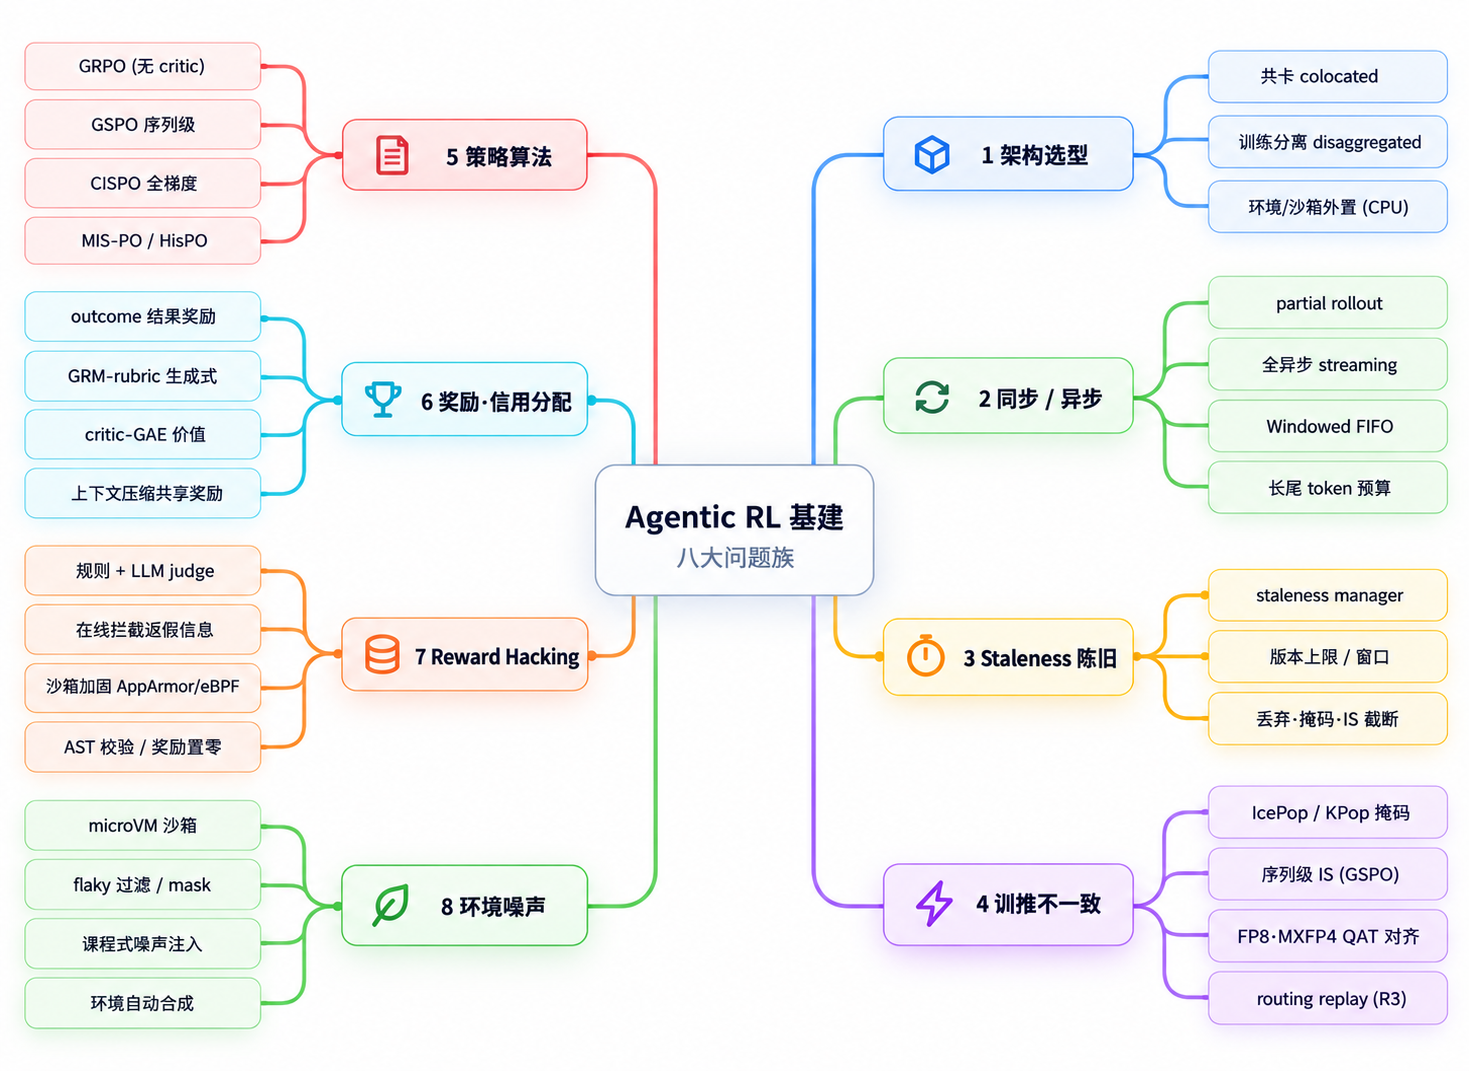
2. Agentic RL 到底要解决哪些问题
2.1 系统架构选型(colocated共卡 or disaggregated分离 )
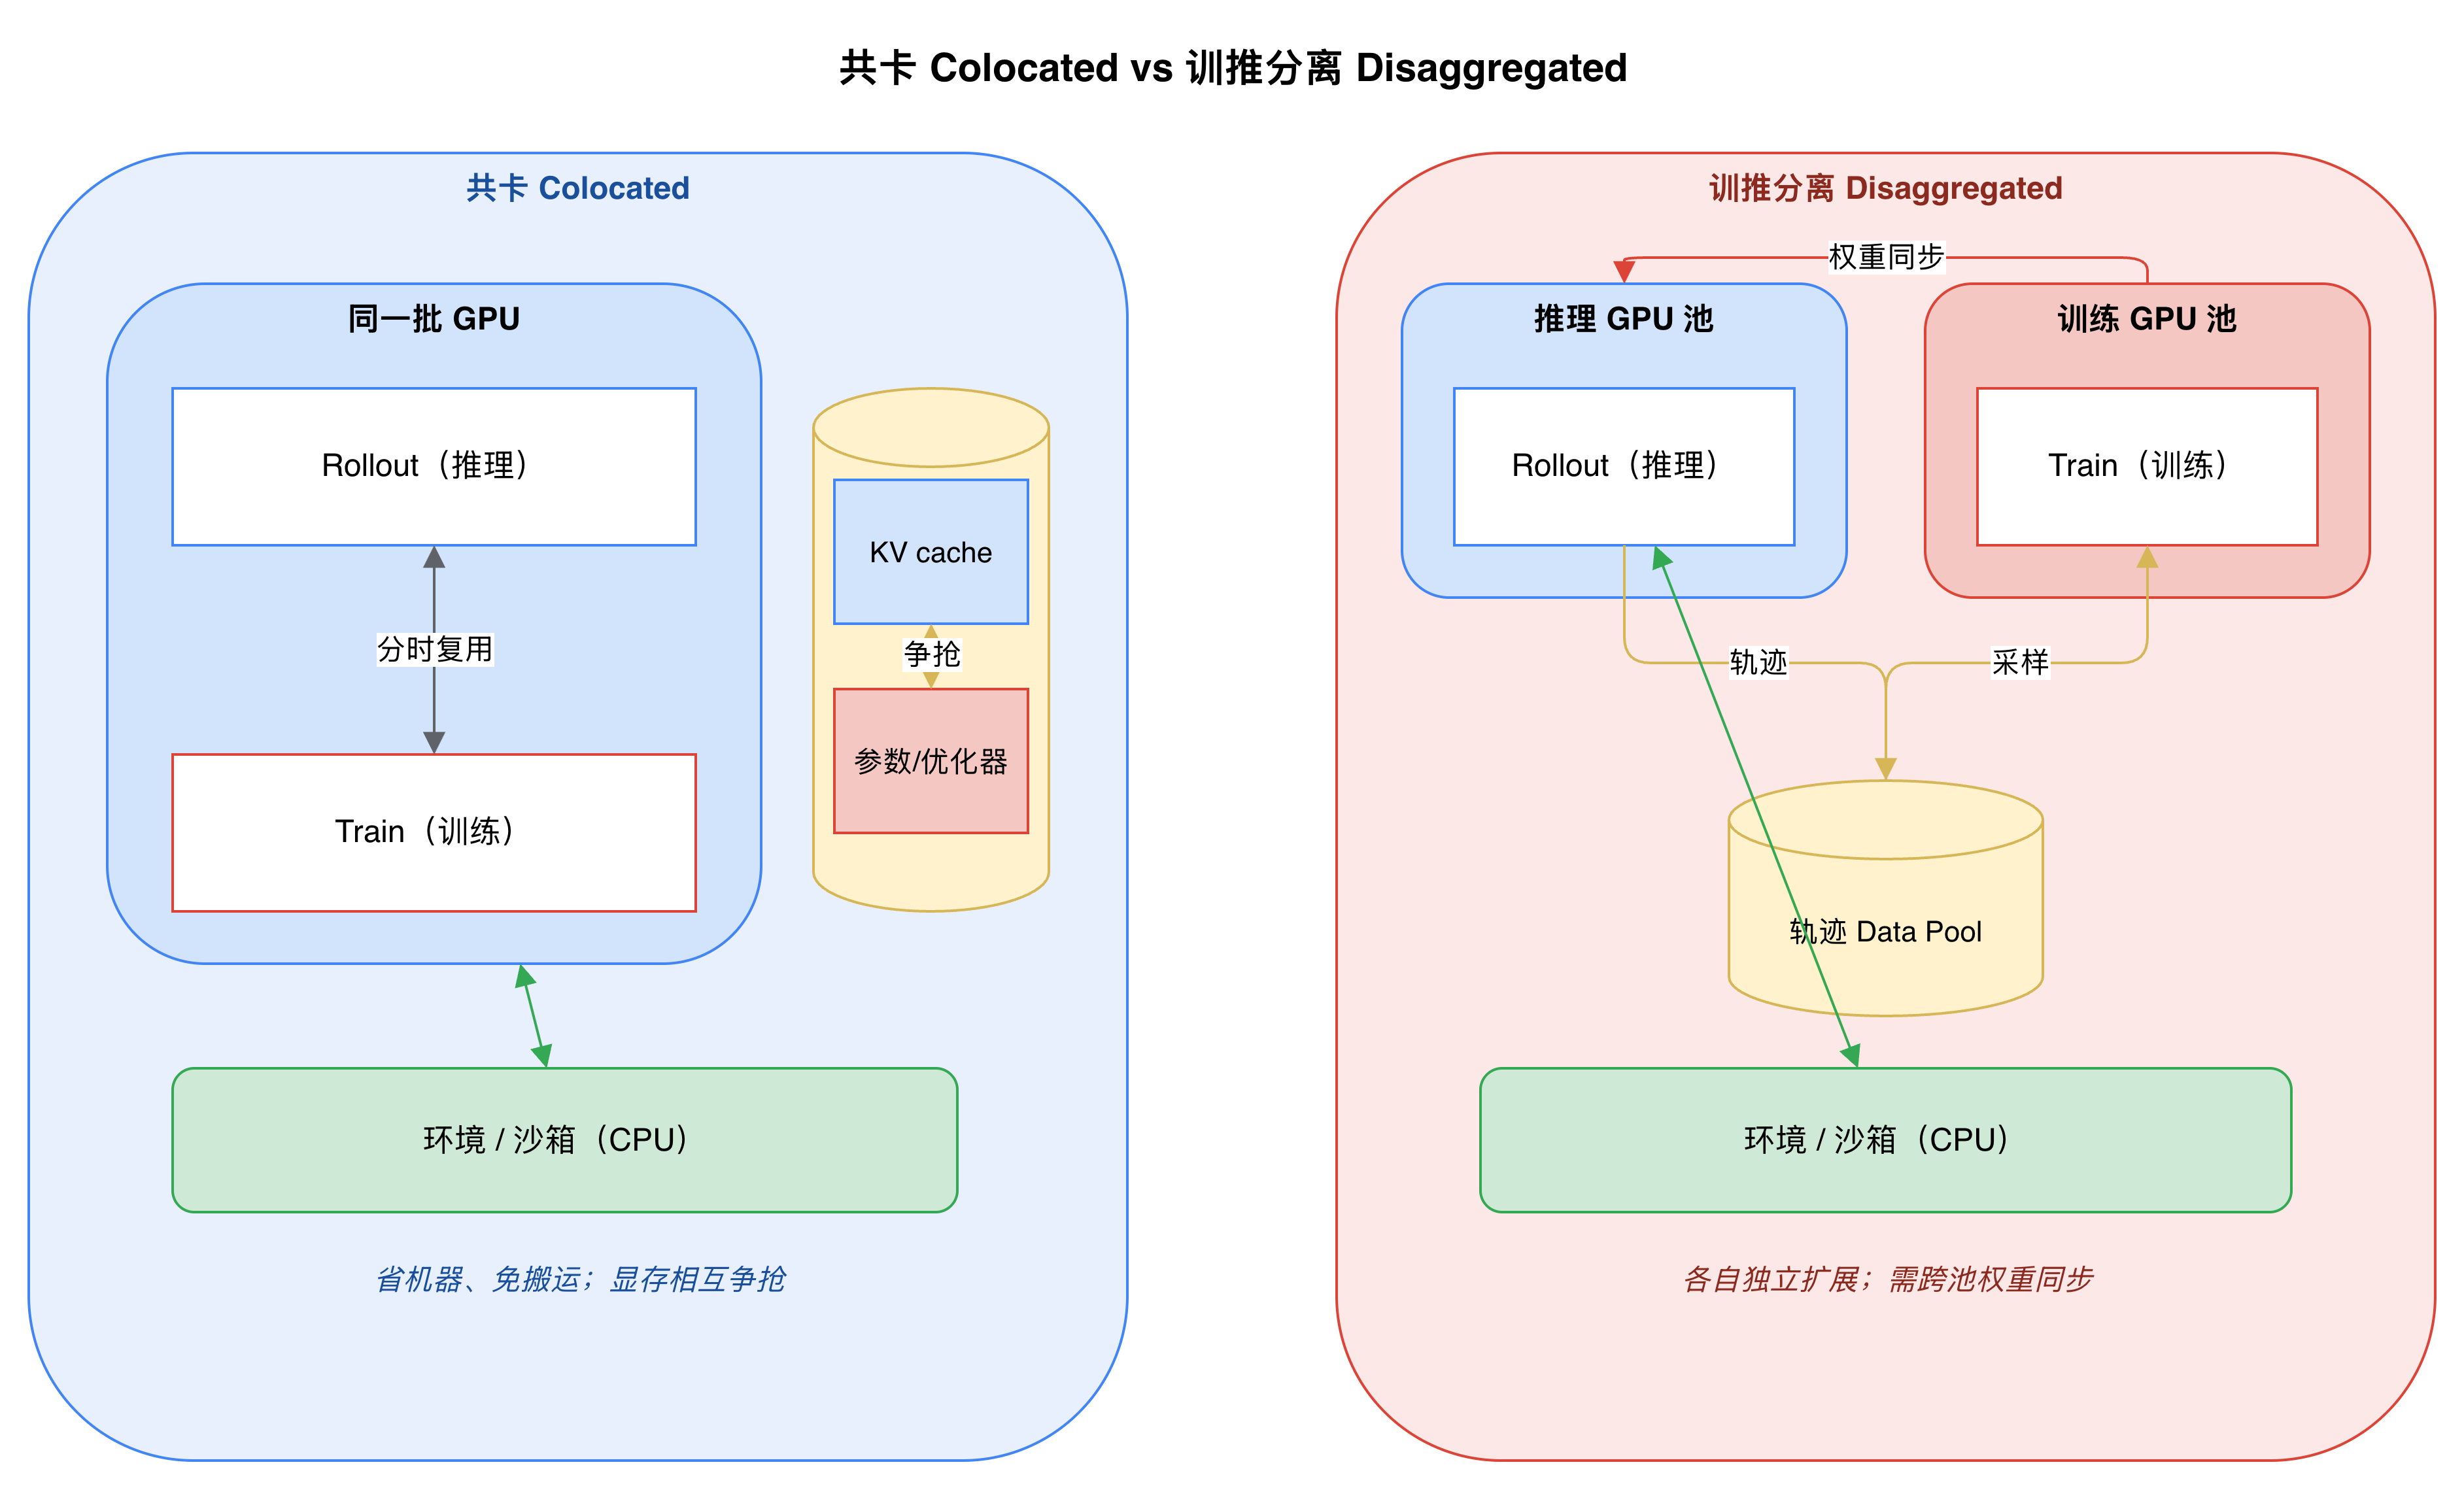
RL 训练天然包含 生成(rollout)与 训练(train)两个阶段,二者对硬件的需求截然不同:rollout是访存密集、长尾严重的推理负载,优化是计算密集、同步性强的训练负载。
把两者放在同一批 GPU 上分时复用(共卡)可省机器、省权重搬运,但生成期的 KV cache 与训练期的显存会相互争抢,往往不得不把kv cache丢掉腾给训练阶段用;
放在不同 GPU 上的分离式架构, 则便于各自独立扩展、各用最优并行策略,代价是跨集群的权重同步与资源切分。在 agentic 场景下,由于单条轨迹极长、环境执行占用大量墙钟时间,GPU 空转问题被放大,架构选型的影响被进一步凸显。
2.2 同步 vs 异步 / partial rollout 与长尾
同步 RL 要求一个 batch 内所有轨迹都生成完才能进入训练,但 agentic 轨迹长度相差悬殊——MiMo 实测 25 个数据源之间平均生成 token 数相差 90 倍、活跃时长相差 66 倍,6StepFun 的 search agent 里约 5% 的样本占了约 80% 的生成成本7。
这条长尾会让大量 GPU 等待极少数拖尾轨迹,产生巨大气泡。异步化(fully async)、partial/streaming rollout(攒够预算就切断、下轮续跑)成为必然选择,但异步又会引入 off-policy,怎么去减少off policy的影响又是一个话题。
2.3 陈旧轨迹 Staleness / off-policy 程度控制
一旦异步,一条轨迹可能跨越多个模型版本生成——Kimi K3 称之为极端 off-policy状态4。生成这条数据的行为策略(behavior policy)与当前被优化的目标策略(target policy)之间的版本差(staleness)若不加约束,会破坏训练稳定性甚至导致崩溃。如何设定版本上限、如何丢弃或降权过期 token、如何追踪行为概率,是异步 RL 的核心控制问题。
2.4 训推不一致问题
一般来说RL系统里生成用推理引擎(vLLM/SGLang 等)、优化用训练引擎(Megatron 等),即使两边实现的完全正确, 两套引擎的 kernel 实现、数值精度、算子累加顺序都不能够保证逐位一致。
即便参数完全相同,MoE 的离散专家选择也可能被微小数值差异翻转——GSPO的论文里实测每次更新后约 10% 的激活专家发生变化8。这种 logprob 差异在长序列上累积、被 clip 放大,是梯度方差乃至训练崩溃的首要来源。
2.5 策略优化粒度算法选择(GRPO / GSPO / CISPO)
GRPO 用组内相对奖励省掉了 critic,是当前最流行的基线,但它的 token 级重要性采样(importance sampling, IS)在长序列、MoE、异步场景下暴露出高方差、不稳定的病态。
为什么说token 级重要性采样在长序列下会暴露出高方差不稳定的病态?
因为在异步 RL 或 off-policy RL 中,rollout 数据通常由旧策略 \pi_{\text{old}} 生成,而训练时使用的已经是新策略 \pi_\theta。为了修正这种分布偏移,需要使用重要性采样(Importance Sampling, IS)
对于第 t 个 token,其单步重要性比率为:
因此,如果要严格修正一条由旧策略生成的完整 trajectory,其 sequence-level importance ratio 为:
这就导致了,很小的单步偏差会被长序列指数放大(累乘效应), 各家围绕「IS 比值放在 token 级还是序列级、如何 clip、是否保留梯度、要不要 critic」衍生出 GSPO、CISPO、IcePop/KPop、DIS、MIS-PO、HisPO、VAPO 等一系列方案。
2.6 稀疏奖励与信用分配(Sparse Reward + Credit Assignment)
一条数百步的轨迹只有最终一个二值 pass/fail,无法区分 都通过了 的解之间的质量差异,更无法告诉模型是哪一步做对/做错了。比如agent一开始都在兜圈子各种调用错工具,只是最后把bug修复了, 那就会给前半段的错误action给予了鼓励正向信号。
如何构造过程奖励(process reward)、turn/step 级 advantage、生成式奖励模型(GRM)、rubric 打分、value/critic 回归,是 agentic RL 比 RLVR 困难得多的地方。
2.7 Reward Hacking
能力越强的 agent 越会钻空子:从 git 历史拿标准答案、反编译系统包找漏洞、上网直接搜现成答案、伪造产物而非真正实现……DeepSeek-V4.1 甚至观察到 agent 利用内核漏洞、删除文件系统9。奖励一旦被攻破,训练信号就被污染,模型只会越来越会钻空子。
2.8 沙箱/环境噪声与长程上下文管理
真实环境会超时、会因基础设施故障而崩溃,这些噪声若直接计入奖励就是毒信号;同时,长程轨迹的上下文会超出窗口,必须做压缩/摘要/丢弃,而怎么管上下文本身也会影响任务成败。环境的规模化合成、噪声鲁棒性、沙箱隔离与容错,构成了 agentic RL 独有的环境即基建问题。
3. 各问题目前的主流解决思路
3.1 系统架构选型:共卡 vs 分离
3.1.1 问题定义
RL 的一个 step 由 rollout(生成轨迹)与 train(计算梯度、更新权重)两段构成。rollout 是访存密集、并发度高、长尾严重的推理负载;train 是算力密集、通信同步性强的训练负载。两者放在同一批GPU上 分时复用 即共卡(colocated),放在不同GPU 即分离(disaggregated)。
共卡的痛点是显存争抢:rollout 要留 KV cache,train 要留参数、梯度、优化器状态,二者在同一张卡上此消彼长,1M 上下文下尤甚;**时序耦合、吞吐天花板低; 扩展性受限 ;**优点是省卡省资源、免权重搬运。
分离的痛点是跨集群的权重同步延迟和资源切分比例难以调优,而且需要更多的资源。 优点是可以各自弹性拓展,按需收缩。 天然异步、高吞吐。
3.1.2 主流流派
**colocated 共卡:**训练与生成分时复用同一批 GPU,靠显存腾挪(训练态卸载到 NVMe/CPU、空闲 KV 写回 CPU 池)缓解争抢,并把环境/沙箱执行外置到 CPU。
disaggregated 分离 :rollout 与 train 各占独立 GPU 池,中间以分布式轨迹存储(Data Pool / SampleQueue)衔接——而一旦分池,为避免两池互相空等,这个缓冲天然以「生产者-消费者 + 异步」方式运转,因此 异步解耦 并不是分离之外的可选加法,而是分离的内在属性
两派之间还存在一种弹性共卡混合态:整体仍是分离架构,但只让一部分卡训推分时复用——如 LongCat DORA 把集群分为专职生成组与弹性角色组,前者常驻推理,后者在每个 step 内随阶段在生成与训练角色之间切换(靠进程内上下文切换与卸载),即 分离 + 局部共卡(初代自述为异步弹性共卡10)
3.1.3 代表性做法
共卡阵营
Kimi K3 为把每个 1M 上下文实验控制在几百张 GPU 内而采用共卡,一轮训练结束后把模型权重与优化器状态卸载到 NVMe、腾出 CPU DRAM 给外部 KV cache 池,一轮 rollout 结束后再释放该池;reference 等只做前向的非策略模型平时放 CPU、用时借用策略模型的 FP32 梯度 buffer 物化4。
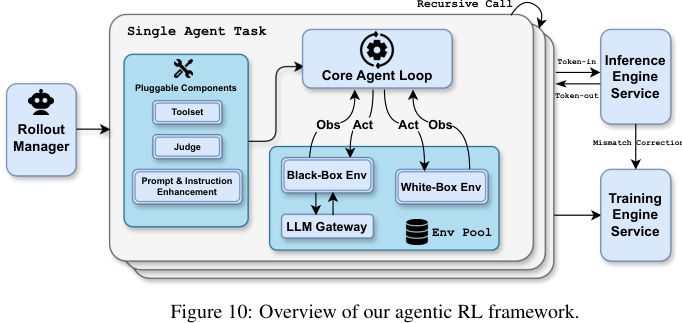
腾讯混元 Hy3 开源 recipe 同为共卡:Megatron-LM 训练 + vLLM rollout,训练空闲时把参数、优化器状态、梯度全量 offload 到 CPU 为 rollout 腾显存,128 张 H20 上 rollout 需 TP=16 才放得下单实例11。
DeepSeek-V4.1 也是共卡——GPU 上 rollout 与训练共置分时复用,只是把智能体沙箱与worker 容器放到 DSec 沙箱平台、置于可抢占的 GPU 训练池之外,即共卡 + 环境外置9。
蚂蚁 ASystem 把共卡做到极致:Hybrid Runtime 让每个 GPU Worker 内训练引擎与推理引擎共置、经 AState 做零冗余 P2P 权重交换(10 秒内同步万亿参数),以消除跨系统搬运开销12。

小米 MiMo-V2.6 虽对外称fully async,但报告并未明说训推放置方式;从其流程看——凑够一个训练 batch 即中断在途序列、在下一 rollout phase续写并为此付出 re-prefill 代价——与共卡分时复用一致2,开源复现框架的默认配置也是 colocate_async(注释即Trainer and rollout are colocated,采样结束后中断请求、令推理副本休眠并丢弃权重与 KV cache,训练后更新权重再恢复生成)13,可归为共卡 + 异步
分离阵营
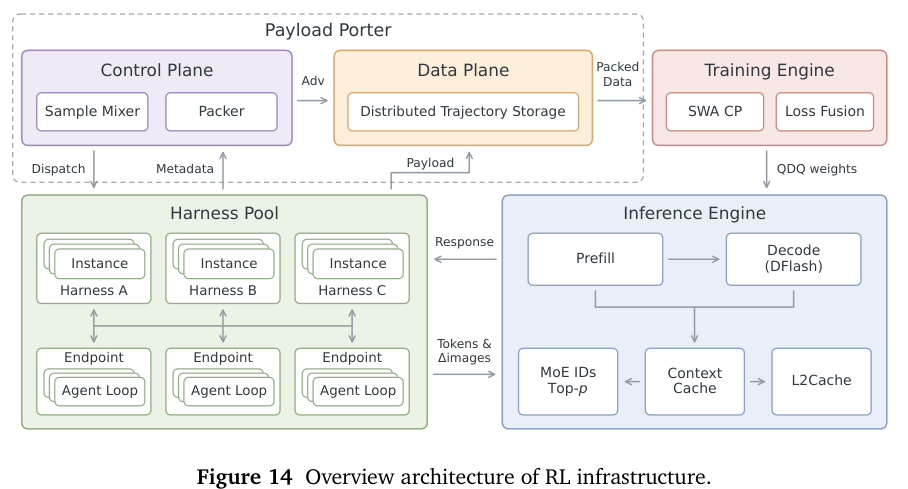
GLM-5 明确「把训练引擎与推理引擎解耦到不同 GPU 设备上」,由中心化的 Multi-Task Rollout Orchestrator 调度、每个任务把自己的 rollout 与 reward 逻辑实现为独立微服务注册进来、支持 1k+ 并发 rollout,且推理引擎持续生成、轨迹够一批即送训、每 K 步推一次权重——是典型的分离 + 异步14
MiniMax Forge 在 agent 与训推引擎之间插入 Middleware(Gateway Server + Data Pool),Data Pool 异步收集轨迹、完全解耦生成与训练管线使各自独立扩展15 16

LongCat DORA 用 RolloutManager、SampleQueue、Trainer 三类控制器分布在不同节点、经 RPC 协调,规模达 32,000 并发环境、约 400 台物理机10初代博客自述为「异步弹性共卡」,属前述弹性混合态)
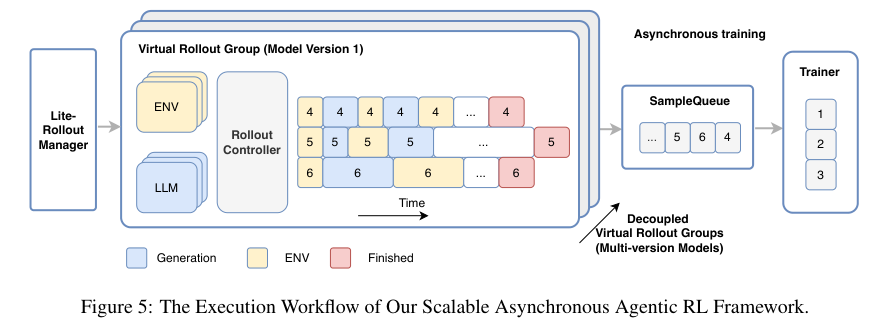
Qwen 在 Qwen3.5 官方博客中明确其异步 RL 框架「采用完全训推分离架构」(fully disaggregated training-inference architecture),称由此获得更高硬件利用率、动态负载均衡与细粒度故障恢复,并通过系统-算法协同约束梯度 staleness,端到端提速 3–5×17
3.1.4 权衡与适用场景
共卡在算力受限、追求单实验占卡最小化时最划算(Kimi K3 的*有限算力下资源效率是首要目标 *4,代价是复杂的显存腾挪工程与生成-训练互等时耦合;分离在大规模、多任务、异构 scaffold 并行时更灵活(GLM-5 的微服务编排、Forge 的黑盒 agent 接入),且天然以异步生产者-消费者运转、便于两端各自弹性扩展,但把复杂度转移到了跨池权重同步与 staleness 管控上(详见 §3.2、§3.3)。
一个跨两派的共识是:无论共卡还是分离,环境/沙箱执行都倾向于从 GPU 池剥离、放到 CPU 侧弹性扩缩(DeepSeek DSec、Ling 的数千 ASandbox 副本、LongCat 的 CPU-idleness-aware RPC),因为环境延迟由外部系统主导,不该占着 GPU 空等。
从框架谱系看,底座大体收敛为Megatron-LM 训练 + vLLM/SGLang rollout + Ray 编排:Qwen 的 Megatron+SGLang/vLLM、MiMo 的 Megatron-LM+SGLang、Kimi 继承 K2 基建、Ling 的 Megatron+SGLang、混元 Hy3 的 verl+Megatron-Bridge+vLLM、Seed 的 verl(HybridFlow)+vLLM 皆属此类。
在此之上,各家自研了面向 agentic 的编排与解耦层:GLM 的 slime(server-based rollout + 心跳容错 + PD 分离)、MiniMax 的 Forge(Middleware:Gateway Server + Data Pool,四接口接入任意白盒/黑盒 scaffold)、LongCat 的 DORA(流式 RPC + Lightweight-RolloutManager + 多 RolloutController)、蚂蚁的 ASystem(Hybrid Runtime + AMem + AState + ASandbox + AReaL)、StepFun 的 Steptron(PyTorch+Megatron-LM 统一预训练/后训练/RL)与 Session-Router、Qwen 的 MegaFlow(阿里云 K8s + Argo workflow 三阶段)。
参数热更新是共卡与分离都绕不开、而分离架构尤其吃紧的命门:蚂蚁 AState 用零冗余 P2P、按 NUMA 拓扑动态选 RDMA/NCCL/共享内存协议,可在 10 秒内同步万亿参数、达 sub-second 更新,并批评 Slime 销毁重建 NCCL 组的数分钟开销与 NFS/NCCL 分钟级同步12;GLM 的 slime 则用 router 级服务生命周期管理 + TITO 网关保证训推 token 级对应14。可见框架自研化已是国内一线团队的普遍选择,开源 verl/slime/AReaL 是重要起点但远非终点。
3.2 同步 vs 异步、partial rollout 与长尾治理
3.2.1 问题定义
同步 RL 要求 batch 内全部轨迹完成才训练,长尾轨迹会把整批拖住,导致 GPU 大面积空转——GLM-5 称之为 rollout 阶段的substantial bubbles18。
agentic 轨迹的长尾尤其极端:不同任务、不同 harness 的轨迹长度差一两个数量级,且环境执行时间不可预测。异步化是治本之道,但异步会带来三个次生问题:off-policy(见 3.3)、长度偏差(短轨迹先完成、先进 batch,模型偏向生成短序列)、以及调度粒度选择不当引起的指标振荡。
3.2.2 主流流派
流派甲:共卡上的异步(partial rollout):生成与训练在同一批卡上交替,凑够一个训练 batch 就中断全部在途序列、进入训练、换新权重后续跑,一条轨迹因此可跨越多个策略版本——这类系统自称的「异步」指的是这种跨版本生成,而非生成与训练在时间上重叠
流派乙 :分离上的全流式异步, 推理池持续生成、完成即入队,训练池攒够一个训练 batch 即开训,训练期间推理池用旧权重继续生成、新权重每隔若干步推送一次,生成与训练在时间上真正重叠。
流派丙:**分离异步 + 窗口化取样,**在流派乙之上限制训练只能从一个按提交顺序滑动的窗口内取已完成轨迹,在严格 FIFO(分布一致但被队头阻塞)与贪心取样(吞吐高但分布漂向的样本)之间折中。
3.2.3 代表性做法
3.2.3.1 共卡异步
kimi partial rollout 的源头是 Kimi k1.5。Kimi K3 在同步框架上扩展 partial rollout:每轮对 N 个 prompt 各采 K 条,完成比例达 λ∈(0,1)(即 λNK 条)时暂停生成进入优化,被暂停的 rollout 入队、下轮优先恢复,依赖沙箱的暂停/恢复能力4
MiMo 用「GRPO + 异步 partial rollout,staleness=4」,凑够一个训练 batch 后中断在途序列、下轮续写,代价是 re-prefill(续写要重建 KV cache),故大 batch 与 partial rollout 要一起选以摊薄开销.1
DeepSeek-V4.1 自称全异步,但因是共卡,训练攒够样本后同样要抢占在途 rollout;它的不同在两处:
一是 样本级调度——每个任务指定在途样本上限,一旦新完成样本数达到下一个 prompt 的 GRPO 组大小就调度该 prompt,且明确试过并放弃了 batch 级(指标剧烈振荡)和 prompt 级(被组内长尾卡住)两种粒度;
二是 rollout 可在任意 token 边界暂停、换 checkpoint 后直接复用持久化状态续跑、不重新 prefill,因此一个样本可跨越多个 checkpoint 生成而不付 re-prefill 代价。9
Ring-1T的 C3PO++ 以全局 token 预算 Φ 而非完成比例作为每轮边界:一轮内生成到预算即优化、未完成存入跨版本 buffer 由下一版续跑,rollout 阶段提速约 2.5×、端到端约 1.5×。
3.2.3.2 分离异步
GLM-5 推理引擎持续生成、轨迹数达阈值即整批送训、每 K 次梯度更新推送一次新权重,且每次权重更新后重置优化器18
LongCat DORA 是「完全流式多版本异步」:rollout 内部去掉 batch barrier、以单条样本为粒度在远程 worker 上执行,比同步训练快 2–4 倍10
StepFun 的 search agent 从早期 client–server one-step off-policy 改为 FullyAsync,正是因为 5% 样本占 80% 生成成本,改造后效率约提升 10×7
3.2.3.3 分离异步 + 窗口FIFO
MiniMax 的 Windowed FIFO是窗口化折中的教科书案例:训练调度器只能取窗口 [T_i, T_{i+W-1}] 内已完成的轨迹,窗口内乱序取、跨窗口严格阻塞,典型取 W=0.3N,由此把 Max Off-Policy Lag 限定为 batch 与窗口共同决定的上界,既缓解 HoL 阻塞又防止训练分布漂向又快又易的样本16 15

光看静态图可能还是不太能理解整个时序,所以这里我做了一个react小程序方便读者理解:
INTERACTIVE / REACT TSX
3.2.4 适用场景
- 流派甲(共卡上的 partial rollout)。 好处是每轮边界确定:生成到点就停、训练、换权重,便于 checkpoint 和故障恢复;Ling 2.6 正是看重这一点,才选择 partial rollout 而不是全异步12。
代价有两个。一是 off-policy:被中断的轨迹由新版本续跑,前半段出自旧策略,等它进训练时已落后若干版本;而被中断的往往是最长、最难的轨迹,所以越有价值的样本越陈旧。Kimi K3 直言这是extreme off-policy regime,靠 per-token 正则来容忍4。
陈旧度的上限取决于一条轨迹最多被切几次,Ring-1T 用 retention 阈值 σ 控制,MiMo 设 staleness=4;只有本轮内一次跑完的样本才是严格 on-policy。二是续跑要重建 KV cache(re-prefill),DeepSeek-V4.1 保留状态续跑,省掉了这笔开销9。 - 流派乙(分离上的全异步)。 生成和训练同时进行,吞吐最高。代价是样本的陈旧度不再被「切几次」自然封顶,必须另配 staleness 管控(见 §3.3)。
- 流派丙(窗口化取样)。 用窗口大小 W 在严格 FIFO 与贪心取样之间调节,适合既怕长尾拖慢、又怕训练分布漂移的生产系统。
- 共同问题:长度偏差。 只要是谁先跑完谁先进 batch的流式调度,无论共卡还是分离,短样本总是先到,训练早期的 batch 会被短样本主导,模型容易偏向短输出。DeepSeek 的两个办法是按数据集限制并发(间接控制 batch 里各来源的比例),以及丢弃提前返回的短样本,让 batch 的长度分布平滑过渡到稳态9。
3.3 陈旧轨迹 Staleness / off-policy 程度控制
3.3.1 问题定义
异步训练下,一条轨迹的 token 可能由多个较早的 checkpoint 生成,即 off-policy 样本。版本差过大时,行为策略与目标策略分布相去甚远,重要性比值爆炸、方差无界,轻则收敛变慢、重则模型崩溃。核心是:如何定义并限制最大陈旧度,以及对超限的 token/轨迹是丢弃、掩码还是重要性采样修正。
(其实这个问题往往和下面的训推不一致问题有很多千丝万缕的联系, 而且解决方法也有共同之处)
3.3.2 主流流派
流派甲 版本上限 + 过期丢弃:给每条轨迹打版本标签,超过阈值就 purge。
流派乙 staleness manager 入池门控:限制池中样本的版本差上界,使 RL 近似当作 on-policy。
流派丙 算法层掩码/截断:不显式追踪版本,而在损失里对偏离过大的 token 做掩码或截断 IS。
3.3.3 代表性做法
3.3.3.1 路线一:版本上限 + 过期丢弃
GLM-5 给每条轨迹记录它涉及的所有策略版本 (w_0,\dots,w_k),满足 w_0<\dots<w_k,因为一条长轨迹可能在生成途中经历了几次权重更新。设当前训练版本为 w',丢弃规则是:
只看最老的版本 w_0,因为轨迹最早的那段 token 偏离当前策略最远。例如 \tau=3、当前版本 w'=10,一条由版本 (6,7,8) 接力生成的轨迹有 10-6=4>3,丢弃;由 (7,8,9) 生成的轨迹有 10-7=3,保留。
Ring-1T 的 C3PO++ 做的是同一件事,只是换了计数方式。它给每条未完成的 rollout 记一个 retention period \rho(o),即这条序列被切断的次数。每轮结束时还没跑完的 rollout 令 \rho(o)\leftarrow\rho(o)+1,下一轮开始前清除所有 \rho(o)>\sigma 的 rollout。
在 partial rollout 里每轮恰好对应一个新版本,所以 被切了几次就等于 最老那段 token 落后了几个版本,\sigma 起的作用和 GLM 的 \tau 相同。12
3.3.3.2 路线二:staleness manager 入池门控
Ling 2.6 给每个 rollout 片段打上「生成时推理引擎的策略版本」标签。staleness manager 限制在途 rollout 池的规模19:
其中 S 为 max_staleness,B 为 consumer_batch_size(训练端每步消费的样本数)。可以这样直观理解:训练端每步取走 B 条,池里最多积压 S\times B 条,所以一条新 rollout 进池后,大约最多等 S 个训练步就会被消费,陈旧度因此被限制在约 S 步以内。
与此同时,版本差超过上界的片段直接退休。配合 sub-second 级的权重广播,Ring-2.6 的有效 staleness 只有几个优化步,与同步基线相比「稳定性与最终 reward 无损失」。路线一是事后检查、超限就丢;路线二是事前限流,从源头不让样本变旧,浪费的生成更少。
3.3.3.3 路线三:算法层掩码 / 截断
先统一记号,下面各家的公式都用这一套:
- \pi_\theta:训练引擎上正在优化的当前策略;
- \pi_{\theta_{\text{old}}}:生成该 token 的那个版本,在训练引擎上算出的概率;
- \pi_{\text{rollout}}:同一个版本在推理引擎(vLLM/SGLang)上采样时给出的概率。各家原文记号不一,也写作 \mu、\mu_{\theta_{\text{old}}} 或 \pi_{\text{vllm}},本文统一记为 \pi_{\text{rollout}};
- \hat A_t:第 t 个 token 的优势。
真正的重要性比值是当前策略 / 实际采样的策略,可以拆成两个因子相乘。LongCat 的 HisPO 就是这么拆的20:
r^{\text{dis}}_t 是训推不一致:同一版本的参数,两套引擎的 kernel、精度、MoE 路由不完全一致,算出的概率有偏差(这部分在 §3.4 展开)。r^{\text{stale}}_t 是策略陈旧:从生成它的版本到当前策略,参数已经更新了若干步。
麻烦在于,异步下一条轨迹可能由多个版本接力生成。要精确算出 \pi_{\theta_{\text{old}}},就得为每个 token 找回生成它的那个版本的训练端 checkpoint,GLM 和 SAO 都明确说这在工程上不可行18。于是各家的分歧主要在两点:要不要算 \pi_{\theta_{\text{old}}},以及超出范围的 token 是截断还是直接掩掉。
a. GLM 的 DIS(Direct Double-sided IS)
不算 \pi_{\theta_{\text{old}}},直接用 rollout 时记下的 log-prob 作分母
f 的含义是:比值落在信任区间内,就以比值本身作为权重;落在区间外,权重为 0,这个 token 完全不贡献梯度。它与 PPO 的区别在于是否看 advantage 的符号。PPO 它是一个悲观算法, 只在 继续更新会让目标更大 的那一侧截断,即 \hat A>0 且 r>1+\epsilon_h,或 \hat A<0 且 r<1-\epsilon_\ell;另一侧仍有梯度。DIS 则不论 \hat A 的正负,两侧一律掩掉,所以叫 double-sided,约束比 PPO 更严。代价是:用 \pi_{\text{rollout}} 代替 \pi_{\theta_{\text{old}}} 会引入一定的 off-policy 偏差,GLM 认为这比用一个最新但不对版本的旧策略去近似更划算。
b.MiMo:按 advantage 符号设四个独立边界1
其中 \mathrm{sg} 表示 stop-gradient,\pi_{\text{rollout}} 取该 token 生成时推理引擎给出的概率;partial rollout 续跑的轨迹不重算这些概率。掩码为
\mathbb{1}[\cdot] 是指示函数(条件成立取 1、否则取 0),\wedge/\vee 为「且」/「或」。它只做一件事——判断每个 token 要不要参与梯度:正优势 token(想抬高其概率)用 [\epsilon^l_+,\epsilon^h_+] 这组界,负优势 token(想压低)用 [\epsilon^l_-,\epsilon^h_-] 这组界,比值 r 落在对应区间内 M=1(保留),越界 M=0(丢弃)。代入损失,每个 token 的代理目标为
即在 DIS 的 r\cdot\hat A\cdot\log\pi 之上多乘一个掩码 M_{i,t}:被保留的 token 以 r 为权重贡献梯度(r 带 sg,故梯度只经 \log\pi_\theta),被掩掉的整项归零;整体按 MiMo 的 prompt-mean 聚合(先在每条回答内按 token 平均、再跨 prompt 平均,抑制长度膨胀)。要注意这里的边界是比值本身的上下限,不是 1\pm\epsilon:正负两组初始都为 [0.2,\,5.0],在 log 空间里关于 0 对称(\ln 0.2\approx-1.61,\ln 5\approx+1.61),比 DIS 宽得多。这四个边界在训练中按策略熵自适应调整:熵过低时放宽正优势边界、收紧负优势边界,把熵拉回正常范围;熵过高时反向调整。
c. DeepSeek-V4.1:原文没有给出公式,只描述了两个机制9
一是调整调度与训练等待条件,限制 batch 中 off-policy 样本所占的最大比例;二是在损失中加掩码,去掉陈旧度过高的 token 的贡献。
d. StepFun 的 MIS-PO
不乘连续权重,只用 0/1 掩码筛选。它受 Metropolis Independence Sampling 启发:把推理策略看作提议分布、训练策略看作目标分布,只保留离目标足够近的样本,并把留下的样本当作 on-policy 来训练。定义指示函数 \mathbb{I}(x)=\mathbb{1}[\rho_{\min}\le x\le\rho_{\max}],在两个粒度上使用:
其中 x_t 衡量单个 token 的偏离程度:同一个 token,分母是当初推理引擎采样时给出的概率,分子是训练引擎上的快照算出的概率,两者本应相等(比值为 1),实际不等既来自两套引擎的数值差异、也来自该 token 可能由更早的版本生成。\bar\rho(\tau) 衡量整条轨迹 \tau 的平均偏离程度:把该轨迹上全部 T 个 x_t 连乘后开 T 次方,即几何平均(此处 \tau 指一条轨迹,与前文 GLM 版本差阈值 \tau 同形不同义)。两者分别送进损失里的两道开关:
token 级区间取 [0.5,\,2],在 log 空间是对称的 [-0.693,\,+0.693],相当宽松——单个 token 的概率差到 2 倍以内都接受,它的作用是清掉个别数值异常的 token。
轨迹级要求 \bar\rho(\tau) 落在 [0.996,\,1.001] 内,否则整条轨迹丢弃。之所以取几何平均而不直接用连乘 \prod_t x_t,是因为连乘会随长度指数爆炸或趋零,T 上千时无法设定与长度无关的阈值;开 T 次方后它还原为「平均每个 token 偏离多少」,与 GSPO 做长度归一化是同一思路。取对数后,该约束等价于
这条带看似极窄,但要注意它约束的是平均值:单个 token 可以在 [0.5,\,2] 内大幅波动,只要正负抵消后均值落在带内即可;而且它允许的序列级总偏离会随长度放大。以下界 -0.004 为例,序列级比值 \prod_t x_t=e^{-0.004T}:
- T=100:e^{-0.4}\approx 0.67
- T=1000:e^{-4}\approx 0.018
- T=5000:e^{-20}\approx 2\times 10^{-9}
可见长轨迹在边界上被允许的整体偏离其实很大——这条带约束的是「平均每 token 的系统性偏差」,而不是「整条轨迹的总偏差」。另外它在 log 空间并不对称(向下容忍 0.004、向上只容忍 0.001,即更能接受训练引擎给出的概率偏低),原文只给了数值、未解释原因。
两道开关分工明确:token 级宽而局部,清理个别异常 token;轨迹级紧而全局,一旦整条轨迹系统性漂移就整条丢弃;两者必须同时通过。它与 DIS、MiMo 的关键区别是:留下的 token 不乘比值、权重恒为 1,梯度方差因此更小。StepFun 实测 search agent 在约 20 步 staleness 下仍然稳定。
e. LongCat 的 HisPO
先用 r^{\text{dis}} 分层筛选,再对完整比值做 PPO 式截断
先把 r^{\text{dis}} 说清楚——它就是上面那个分解里的训推不一致因子:
分子分母用的是同一个版本的参数,只是分子在训练引擎(Megatron)上算、分母在推理引擎(vLLM)上算。参数相同,概率本应相同,比值本应恒为 1;实际不等,是因为两套引擎的 kernel 实现、数值精度、MoE 专家路由不完全一致(这部分在 §3.4 展开)。所以 r^{\text{dis}} 偏离 1 的程度,度量的是「这个 token 的概率有多不可信」,与版本新旧无关。
HisPO 的整体思路是:用 r^{\text{dis}} 决定哪些 token 有资格参与训练,再用完整比值 r=r^{\text{dis}}\times r^{\text{stale}} 决定参与进来的 token 更新多大幅度。 目标函数为
掩码 H_{i,t} 是两个指示函数相乘,两者考察的都是 r^{\text{dis}} 离 1 有多远(|\cdot-1|<\delta 就是「偏离不超过 \delta」):
- 序列级(左项):\exp\big(\frac{1}{|y_i|}\sum_j \log r^{\text{dis}}_{i,j}\big) 是整条轨迹上 r^{\text{dis}} 的几何平均——先取对数求平均、再 \exp 回去,与上文 StepFun 的 \bar\rho(\tau) 是同一个构造。它偏离 1 超过 \delta_{\text{seq}},这条轨迹的梯度全部置零。
- token 级(右项):单个 token 的 r^{\text{dis}}_{i,t} 偏离 1 超过 \delta_{\text{tok}},只掩掉这一个 token。
两项相乘意味着必须同时通过。注意两道开关都只看 r^{\text{dis}}、完全不看 r^{\text{stale}}——陈旧度不在这里处理,而是交给下面的截断。
原文把这套机制总结为三层,前两层就是上面 H_{i,t} 的两项:
- 序列级训推偏差筛选:r^{\text{dis}} 的几何平均偏离 1 超过 \delta_{\text{seq}},整条轨迹丢弃。原文特别对比了 GSPO——这里只把序列级指标用于筛选,不像 GSPO 那样把优化单位整体换成序列级,以免丢掉有价值的 token。
- token 级训推偏差筛选:在剩下的轨迹里,掩掉单个 r^{\text{dis}} 偏离过大的 token。
- token 级 staleness 控制:对通过前两层的 token,用完整比值 r=r^{\text{dis}}\times r^{\text{stale}} 做截断,限制单步更新的幅度——这是三层里唯一处理陈旧度的一层。
此外,损失分母取 G\cdot\max_i|y_i| 这个全局常数而不是各条轨迹各自的长度,是为了缓解长度偏差。
第三层的截断用了三个界。原因在于标准 PPO 项在 \hat A<0 时是无界的:
\hat A<0 时 r\hat A 随 r 增大单调下降,\min 总会选中它,截断形同虚设。而 MoE 的专家路由会随版本变化,一个 token 在新旧版本下可能走完全不同的专家,r^{\text{stale}} 容易出现极端大值,于是负优势 token 的方差无界。HisPO 借用 dual-clip 的思路,用三个界分工:
- \epsilon^{\text{neg}}_{\text{low}}、\epsilon^{\text{neg}}_{\text{high}}:从两侧限定负优势 token 的比值,其中上界 \epsilon^{\text{neg}}_{\text{high}} 正是为封住上面这个无界项;
- \epsilon^{\text{pos}}_{\text{high}}:给正优势 token 设上界。
3.3.4 权衡与适用场景
三条路线各自的取舍:
- 版本上限 + 丢弃(GLM、Ring-1T):最简单直接,实现上只需记录版本号;代价是已经花算力生成的样本被整条丢掉,而且越长、越难的轨迹越容易触线,浪费最大。
- staleness manager 入池门控(Ling 2.6):把陈旧度变成一个可配置旋钮,从源头限流而非事后丢弃,浪费最小;代价是需要精细的版本标签与 sub-second 级权重广播基建,门槛最高。
- 算法层掩码 / 截断(GLM DIS、MiMo、StepFun、LongCat):把陈旧与训推不一致合并处理、不依赖版本追踪(GLM 明确因「异步下精确追踪 \pi_{\theta_{\text{old}}} 计算上不可行」而转向 DIS),是当前最主流的做法;代价是掩码会丢弃梯度、截断会引入偏差,阈值需要仔细调。
3.4 训推不一致(training-inference mismatch)
3.4.1 问题拆解
生成用推理引擎(vLLM/SGLang)、优化用训练引擎(Megatron),两者是两套独立实现:kernel 写法不同、数值精度不同、规约的累加顺序也不同。于是即便两边加载的是逐位相同的参数,同一个 token 算出的 log-prob 也不相等。把这个偏差写成比值,就是 §3.3 里已经用过的那一项:
注意分子分母的 \theta 是同一个,所以它度量的纯粹是「两套引擎看同一个模型的分歧」,与版本新旧、与 off-policy 无关。理想值恒为 1。
这个偏差有两层危害,第二层是 MoE 特有的。
第一层:直接污染 IS 比值。 RL 的重要性比值分母本应是「采样时的真实概率」。如果直接用推理引擎返回的概率,分子分母就来自两套引擎,比值里混入了与策略更新无关的数值噪声;如果改用训练引擎重算,则得到的又不是真正采样用的那个分布。两条路都不干净。
第二层:在 MoE 上,微小数值差异会翻转离散的专家选择。 路由是 top-k 取最大,属于离散决策,门控分数上千分之一的扰动就可能让排序互换,于是这个 token 走的是另一组专家、过的是另一个子网络。Qwen 在 48 层的 Qwen3-30B-A3B-Base 上实测:每做一次 RL 梯度更新,对同一条 rollout 样本,新旧策略下被激活的专家约有 10% 不同,且层数越深越明显8。这使 token 级 IS 比值剧烈波动、失去意义。
更糟的是这个偏差会自我放大。 Ring-1T 给出「复合概率差异定理」:设
为第 t 步两引擎的概率分歧,则在一定条件下、步长 \mu>0 时存在常数 \eta>0 使
关键在于这是一个下界:偏差不会自行收敛,而是至少按几何级数放大。长 CoT 与多轮 agentic 轨迹把单步偏差沿序列累积,再被 clip 机制放大,最终表现为梯度范数飙升、熵坍缩、reward 崩塌。12
3.4.2 主流解法类别
这几个流派可以互相叠加并不互斥。
类别一「算法层纠偏」——承认偏差存在,在损失里兜住它。
- 流派甲「掩码 / 截断」:把偏差过大的 token 掩掉,或对 IS 比值做截断(IcePop、KPop、DIS、MIS-PO、HisPO)。
- 流派乙「序列级 IS 绕过」:把优化单位从 token 提到序列,用序列级重要性比值,让方法对单 token 似然不敏感、从而不需要 routing replay(GSPO)。
类别二「系统层对齐」——不改损失,让两端看到同一份东西。
- 流派丙「消除偏差本身」:用 FP8/MXFP4 QAT 让训推两端共用同一量化方案、用确定性 kernel 做逐位对齐、用 FP32 LM Head 校正概率,目标是让 r^{\text{dis}}\to 1。
- 流派丁「强制路由一致」:缓存 rollout 时的专家索引并在训练时回放,使比值的分子分母共享同一激活子网络。注意它不消除数值偏差——kernel、精度、累加顺序的差异照旧存在——只消掉「离散路由被翻转」这一个症状。
两类并不互斥,实践中常常叠加:MiMo 同时用了 QDQ 权重对齐(丙)、R3 路由回放(丁)与四界掩码(甲)三层。反过来说,如果丙、丁能彻底消除偏差,就不需要再叠甲了。
3.4.3 代表性做法
3.4.3.1 流派甲:掩码 / 截断
a. TIS
这一派的起点是 TIS(Truncated Importance Sampling),它把问题摆到了台面上,后面几家基本都是它的一个变种21。朴素做法是用推理引擎采样、却用训练引擎算 log-prob,这本身就不自洽:
补上重要性采样修正就是乘一个 \pi_{\text{train}}/\pi_{\text{infer}};为防止这个比值取极端值把梯度方差炸掉,再对它截一个上界 C:
被截断的比值正是 r^{\text{dis}},所以本派所有方法处理的都是同一个量,分歧只在怎么处理。TIS 原论文对比过两个更差的变体:PPO-IS(直接把 \pi_{\text{infer}} 当 PPO 的分母)与 Vanilla-IS(不截断的比值),TIS 优于两者,且 mismatch 越大(FP8/INT8 rollout)优势越明显21。它最实际的影响是让低精度 rollout 变得可行——这与流派丙是两条相反的思路:丙用 QAT 把精度对齐、让偏差不产生,TIS 则容忍偏差、在损失里修正。原论文也坦白:偏差本来就小时加 TIS 没有收益,严格 on-policy 下这个比值恒为 121。TIS 已被 slime、verl、OpenRLHF 等框架集成,是事实上的基线。
b. IcePop
IcePop 则把「截断」换成「掩码」。 它是 Ring-1T 提出的,后面 KPop、DIS、HisPO 大体都是它的变体,所以把公式摊开:
看清两个关键点,这一派的结构就都清楚了:
- 门控的输入是 r^{\text{dis}},PPO 项的比值是 r^{\text{stale}}。 注意 M(\cdot) 的参数分子分母都带 \theta_{\text{old}},是同一版本在两套引擎上的比值;而 r_{i,t} 的分子分母都在训练引擎上,是新旧版本之比。所以 IcePop 的分工是:用训推偏差决定这个 token 要不要,用版本陈旧决定它更新多大幅度。§3.3 的 HisPO 正是同一个骨架。
- M(k)=k而不是 0/1。 落在区间内时,梯度被乘上 r^{\text{dis}},于是有效权重变成 r^{\text{dis}}\times r^{\text{stale}}=r,也就是把完整的重要性比值补回来了——这是原文所称的 "calibration"(校准);落在区间外则整项置零,这是 "masking"(掩码)。一个式子里同时做了两件事。
Ring-1T 实测取 \alpha=0.5、\beta=5。与 TIS 的差别正好落在两点上:一是单侧还是双侧——TIS 只截上界,r^{\text{dis}} 极小的 token(训练引擎认为几乎不可能、推理引擎却采了出来)权重很小但不为零,仍在贡献梯度,IcePop 则连下界 \alpha 一并设上;二是压制还是丢弃——TIS 对越界 token「施加一个压制系数后继续更新」,IcePop 直接置零。Ring-1T 的经验是前者的微扰会随训练逐渐放大、最终让 benchmark 停在平台期;预实验中 Ring-mini-2.0 上 IcePop 在 AIME25 上持续优于 TIS,相对再拉开约 6%12。
c. KPop
把固定比值阈值换成 binary KL。 它指出 IcePop 的问题是「一个全局固定区间 [\alpha,\beta] 隐含假设所有 token 的 mismatch 同质」,而实际上比值噪声依赖于 token 本身的概率大小,结果是低概率 token 被过度掩掉19。
算一下就明白:
- \pi_{\text{train}}=5\times10^{-5},\ \pi_{\text{infer}}=1\times10^{-5}:比值 5,已经撞上 \beta,但两者绝对差只有 4\times10^{-5},是毫无意义的数值噪声。
- \pi_{\text{train}}=0.9,\ \pi_{\text{infer}}=0.45:比值 2,远在区间内,但这是一个真正严重的分歧。
固定比值把这两种情况反着处理了。KPop 改用二元 KL:把全词表压成「当前采样的这个 token」与「其余全部」两个事件,
再要求两个方向都小,得到对称掩码:
把这两个例子代进 binary KL 算一遍就能看出区别。记 p=\pi_{\text{train}}(y_t)、q=\pi_{\text{infer}}(y_t),公式的两项分别对应「采样到这个 token」和「采样到其余任何 token」两个事件:
低概率 token(p=5\times10^{-5}、q=1\times10^{-5},比值 5):
高概率 token(p=0.9、q=0.45,比值 2):
比值 5 的那个只有 4\times10^{-5},比值 2 的那个是 0.45,相差四个数量级——固定比值的判断被完全反转过来:前者保留,后者掩掉。
反转的原因在第一项的结构 p\log\frac{p}{q}:它是对数比值乘上概率质量p。低概率例子里 \ln 5=1.61 并不小,但乘上 5\times10^{-5} 就被压到了 8\times10^{-5};高概率例子里 \ln 2=0.69 反而更小,乘上 0.9 却放大到 0.62。一句话:固定比值只看「差了几倍」,binary KL 看的是「差了几倍 × 这件事有多大概率发生」。
p,q 都很小时第二项约等于 -(p-q),于是有一个便于估算的近似:
代入低概率例子得 4.047\times10^{-5},与精确值一致。它直接说明低概率 token 的 binary KL 是 O(p) 量级:概率越小,惩罚越趋近 0,无论比值多大。这正是 Ling 原文所说 IcePopover-mask the low-probability tokens的数学来源。(该近似仅适用于低概率情形:代入高概率例子会得到 0.174,与精确值 0.453 相去甚远。)
整个机制只有一个超参 \phi。效果上,KPop 让 SWE-bench Verified 的 solve rate 从 70.8% 提到 76.28%19。
其余同派做法。 Kimi K2.5/K3 用 token 级 log-ratio 掩码,落在 [\alpha,\beta] 内正常算梯度、区间外置零,不看 advantage 符号;为此推理引擎严格遵循 token-in-token-out,并记录所有输出的 log-prob 专用于训推不一致修正[^kimi-k25]。腾讯混元 Hy3 的开源 recipe 直接提供 IcePop 风格的 token 级 rollout IS 修正开关,阈值 [0.5,\,4.0]、越界 token 权重清零,实测 rollout_probs_diff 全程低于 0.01511。GLM 的 DIS、StepFun 的 MIS-PO、LongCat 的 HisPO 都属于这一派,公式已在 §3.3 展开。
把这一派的谱系串起来看:IcePop(r^{\text{dis}} 门控 + r^{\text{stale}} 的 PPO clip)→ DIS 砍掉 \pi_{\theta_{\text{old}}}、直接用 rollout log-prob 作分母,换来不必追踪历史版本 → HisPO 把门控细分为序列级 + token 级,并对完整比值用三段式 clip → KPop 保留 IcePop 骨架、把固定比值阈值换成 binary KL。四者解决的是同一个问题的不同侧面。
3.4.3.2 流派乙:序列级 IS 绕过
Qwen 的 GSPO 是这一派的理论基石,它的论点是 GRPO 的 token 级 IS 从一开始就是误用。token 级权重
在每个 token 位置只有一个样本可用,因此它抖动剧烈。但要点不是「单样本让 IS 在数学上失效」——作为梯度估计量它仍然无偏,batch 里跨不同前缀的样本已经提供了期望所需的平均,N=1 只影响方差。真正的问题是粒度错配:奖励给的是整条序列,\hat A_i 对序列内所有 token 是同一个值,而乘在它上面的权重却逐 token 各异。把 GRPO 的梯度展开即可看清:
同一条回答内部,有的 token 被放大、有的被压缩,而这种不均等与该 token 对最终结果的贡献毫无关系,纯粹来自单样本比值的抖动。原文的表述是,这些 unequal weights 可在 (0,1+\varepsilon](\hat A_i>0 时)或 [1-\varepsilon,+\infty)(\hat A_i<0 时)之间变化,"their impact can accumulate and lead to unpredictable consequences as training progresses",而 GSPO "weights all the tokens in a response equally, eliminating this instability factor of GRPO"。由此得出的核心原则是优化目标的单位应与奖励的单位一致:奖励给的是整条序列,off-policy 校正就不该放在 token 级。于是改用按长度归一化的序列级比值:
完整的 GSPO 目标为:
其中优势沿用组内归一化:
把它和前面 GRPO 的 token 级目标对照着看,结构差异只有一处,但影响很大:
GRPO 里对 t 的求和在 \min 内部,所以每个 token 各自判一次越界、各自被裁;GSPO 把对 t 的聚合提前做进了 s_i,一条序列只剩一个权重,于是裁剪的单位从 token 变成了整条序列——某条序列越界,它的全部 token 一起失去梯度。这一点直接决定了下面那组反直觉的数字。
注意 s_i 的构造与 §3.3 里 StepFun 的 \bar\rho(\tau)、LongCat 的序列级门控完全同形,都是"对数比值求平均再取指数”的几何平均。
为什么这能绕过 MoE 的专家翻转? 因为 s_i 只依赖序列似然 \pi_\theta(y_i\mid x),不依赖单个 token 的似然。个别 token 因路由翻转而似然突变,在整条序列上被平均稀释;而 MoE 始终保持语言建模能力,序列似然不会剧烈波动。Qwen 的结论是这 *从根本上解决了专家激活波动问题,不再需要 Routing Replay 这类复杂变通 *8。Qwen 同时披露:此前正是靠 Routing Replay(缓存 \pi_{\theta_{\text{old}}} 激活的专家、在 \pi_\theta 回放)才能让 GRPO 的 MoE 训练收敛,而它带来额外显存、通信开销并限制 MoE 的实际容量8。
一个反直觉的实测:GSPO 裁掉的 token 比例约 15%,GRPO 只有约0.13%,差了两个数量级,调整 clip 范围也不改变这个量级差;但 GSPO 用更少的 token 反而训练效率更高。Qwen 的解读是——这恰恰说明 GRPO 的 token 级梯度估计本身就是噪声,样本利用效率低8。
但这一派存在明确的反方证据。 StepFun 在 MoE 上实测,GSPO 的训推密度比 \pi_{\theta_{\text{old}}}/\pi_{\text{rollout}} 随训练持续发散,而 MIS-PO 能把它维持在稳定区间7。换言之,序列级比值绕过了 token 级比值的方差问题,却不保证两套引擎本身的分歧被收敛。这是第六节仍存分歧的议题之一。此外,GSPO 的序列级似然对训推精度差异直觉上容忍度高得多,因此有可能直接用推理引擎返回的 likelihood、免去训练引擎重算,但论文措辞是 "intuitively" 和 "makes it possible",未给定量实验8。LongCat GSPO、Ling 2.6 的 agentic specialist 均采用 GSPO19 10。
3.4.3.3 流派丙:消除偏差本身
这一派目的就是直接打平两套引擎的差异,从根本上解决问题(有计算效率的损失)
- 追求逐位对齐(DeepSeek-V4):把「预训练 / 后训练 / 推理三者 bitwise 对齐」列为核心设计目标。手段包括批不变(batch-invariant)attention 的双 kernel 策略——满波次用单 SM 处理整条序列,最后不满的波次用多 SM 但保证累加顺序与前者一致;用 DeepGEMM 全面替换 cuBLAS 并放弃 split-k;attention 反向给每个 SM 分配独立累加 buffer 再做全局确定性求和。rollout 与线上推理直接用原生 FP4 权重,保证采样行为与部署完全一致3。
- 让两端共用同一量化方案(MiMo、Kimi K3):MiMo 在每次参数更新后对专家权重做 quantize–dequantize(QDQ),量化严格遵循 rollout 所用 MXFP4 kernel 的数值约束,于是两个引擎看到的专家权重逐位相同1。Kimi K3 的 MXFP4 QAT 从 SFT 阶段就开始、贯穿 RL,rollout 与训练共用同一量化方案,原文直接称此举 *消除了训推不一致 *4。
- 定位到具体模块的精度(MiniMax、Ling 2.6):MiniMax 的排查过程很有参考价值。小模型上的早期实验一切正常,把 RL 迁到更大的 MoE(M1)后 reward 几乎不涨;打点对比训练端与推理端的概率,发现明显的分段水平线——这是低精度量化的典型特征,数值被压到了粗糙的离散网格上——且相关性显著低于 dense 模型。推理团队逐层排查,最终定位到预测层即 LM Head 的数值精度,把这一层恢复为 FP32 后训推一致性大幅改善16。Ling 2.6 独立得到同一结论:在 Megatron 与 SGLang 两端都把 LM Head 算在 FP32,带来约 2 点 reward 提升19。其具体路径是BF16 Input + FP32 Output,即对齐的是输出侧的激活精度而非权重精度19。
- 消除非确定性算子(GLM):在 DSA indexer 上用确定性的
torch.topk替代 SGLang 的非确定 CUDA top-k 并冻结 indexer,同时指出 indexer replay(k=2048)在工程上不现实18。
3.4.3.4 流派丁:强制路由一致(R3)
既然问题的根源是专家选择被翻转,最直接的办法就是不让它翻转:记录 rollout 时每个 token 实际走了哪些专家,训练时强制回放同一组。这样分子分母共享同一个激活子网络,token 级比值重新变得有意义。
- MiMo 的 R3(Rollout Routing Replay):记录 rollout 的专家索引、训练时回放,复现被捕获的执行路径[^mimo-tr]。MiMo 还同时回放 top-p 候选集——采样只在受限候选集内重新归一化,所以训练时也要在同一候选集内重归一化 logprob 才能对齐。实现上只有 GPU→CPU 这一步用固定形状、全词表宽度的 bitmap 做稠密传输(避免 GPU-CPU 同步、也不会截断),后续都是稀疏表示;典型 top-p = 0.97 下候选集平均不到 5 个 token,R3 与候选集回放的开销都可忽略1。
- DeepSeek-V4.1 的拼接式路由重放:对跨越多个 checkpoint 生成的样本,把各片段生成时的专家路由拼接起来使用,而不是丢弃后用新 checkpoint 重算9。这是 partial rollout 场景下 R3 的自然推广,也就是增量R3;
- StepFun 把「是否需要路由回放」变成可度量的模型属性:提出 Routing Confidence \Sigma_k,即被激活专家的平均概率质量。\Sigma_k 低意味着路由本身不确定,会放大训推 mismatch。他们观察到一个近似相变:低置信度的模型很脆弱,必须上 Router Replay 或严格 on-policy 这类「极端稳定化」手段;高置信度的模型无需复杂干预即可做 off-policy 训练。这把「要不要 R3」从工程口味问题变成了一个可以先测量再决定的问题。
3.4.4 权衡与适用场景
两大类、四个流派的取舍:
- 算法层掩码 / 截断(IcePop、KPop、DIS、MIS-PO、HisPO):实现最简单,纯损失函数层面的改动,不碰引擎,因此是当前最主流的选择;代价是掩码会丢掉梯度(IcePop 直接丢、GSPO 式裁剪也丢),阈值需要仔细调,而且它只是容忍偏差、不消除偏差。
- 序列级 IS 绕过(GSPO):一举绕开 routing replay 与(可能的)old-logprob 重算,对基建的简化最彻底;代价是把 off-policy 校正的粒度拉粗到整条序列,多轮 agentic 场景下需要 GSPO-token 变体补救,而且 StepFun 的实测显示它不保证两引擎的分歧收敛。
- 系统层消除(QAT、确定性 kernel、FP32 LM Head):唯一治本的路线,让两端看到同一份权重,偏差从源头不产生;代价是工程量最大、与具体硬件 kernel 深度绑定,确定性 kernel 往往还要牺牲一部分吞吐。
- MoE 路由回放(R3、拼接式重放):能精确复现激活路径,使 token 级比值重新可用;代价是额外的显存与通信开销,并限制 MoE 的实际容量。
几个值得单独记住的点:
- 性价比最高的单点改动是 FP32 LM Head。 MiniMax 与 Ling 2.6 各自独立定位到它,Ling 实测约 2 点 reward 提升。相比动辄重写 kernel 的 bitwise 对齐,这是改一行精度配置就能拿到的收益。
- 「算法层纠偏」与「系统层消除」是一条真实的路线分歧(详见第六节):前者承认偏差、在损失里兜住它;后者认为偏差本身不该存在。注意两者并不互斥,MiMo 同时做了 QDQ 对齐、R3 路由回放和四界掩码三层。
- 一个被忽略的前提:所有算法层手段都需要拿到 rollout 时的真实 log-prob。这要求推理引擎严格 token-in-token-out 并把 log-prob 记录下来(Kimi K2.5 为此提供了面向 RL 的自定义推理 API,GLM 用 TITO 网关保证 token 级对应)。如果中间经过了 detokenize–retokenize 的往返,token 边界本身就可能错位,再精巧的掩码也无从施加。
3.5 策略优化算法选择
3.5.1 问题拆解
自 GRPO(Group Relative Policy Optimization)用「组内相对奖励当 advantage」省掉 critic 以来,它成为事实标准。但在长序列、MoE、异步、agentic 多轮这四个条件叠加之下,它暴露出四类互不相同的病态,下面逐个说清楚。
病态一:奖励在序列级、IS 校正在 token 级,粒度错配。 GRPO 奖励是序列级的、\hat A_i 对全序列同值,而乘上去的权重 w_{i,t} 却逐 token 各异且带噪,于是同一条回答内部权重不均等;这种不均等与各 token 对结果的贡献无关,却会随训练累积,最终导致往往不可逆的崩溃8。
病态二:clip 系统性地偏向裁掉低概率 token。 PPO 式 clip 的 \min 一旦选中饱和分支,该 token 的梯度就是 0。问题在于被裁掉的不是随机的 token:MiniMax 在复现 R1-Zero 时发现,某些 token 在整个训练过程中被持续裁掉、从此永久失去梯度,而经验分析显示这些 token 往往是 "wait" 这类话语转折词16。
throughout RL training, certain tokens were consistently filtered out by PPO's clipping mechanism. Once clipped, these tokens effectively lost their gradients permanently. ... such tokens were often discourse or transition words, such as "wait". This implies that PPO-style clipping can prevent a large number of tokens from ever emerging through training.
为什么每步重复命中的是同一批 token?
MiniMax 没有回答这个问题,答案由由 DAPO 给出:上界 clip 对高、低概率 token 的约束力严重不均等。取 \varepsilon=0.2、\hat A_{i,t}>0(即优化想抬高该 token 的概率),则 \pi_\theta 的上限是 \pi_{\theta_{old}}\cdot(1+\varepsilon):
- \pi_{\theta_{old}}=0.01 → 最多只能涨到 0.012,绝对增量 0.002
- \pi_{\theta_{old}}=0.9 → 上限 1.08,已越过概率上界 1,等于不受约束
DAPO 还给了实证:训练全程被上界裁掉的 token 其概率均值始终 <0.2,直接证明被裁集合系统性地落在低概率尾部,而非随机分布。把这个例子推到边界可以得到更强的结论:由于 \pi_\theta\le 1,比值的硬上限是
于是 \pi_{\theta_{old}}>\dfrac{1}{1+\varepsilon} 的 token 根本不可能被上界裁掉(\varepsilon=0.2 时阈值约 0.833)。换言之,可被上界裁的候选集合从定义上就只包含低概率 token。22
这是一个结构性缺陷而非调参问题:转折词恰恰是推理分叉的开关,而它们在 base/SFT 模型里本就是低概率 token——想抬升的幅度最大、允许抬升的空间最小,正好落在 clip 的刀口上。于是训练全程持续压住它们的上涨,等于堵住了模型学会「等一下、重新检查」的通路,MiniMax 的原话是 clip 会让大量 token "never emerge through training";DAPO 侧的同一现象表现为熵坍缩、探索能力被收窄22。两条修补路线由此分化——DAPO 的做法是把 clip 上界单独放宽至 \varepsilon_{high}=0.28 而保持 \varepsilon_{low}=0.2(clip-higher,给低概率 token 更多上涨空间,同时不放松对「快速遗忘」的保护),CISPO 的做法是让所有 token 都保留梯度、改为截断 IS 系数本身,代价是引入一定偏差、换来显著更低的方差16。
病态三:组内采样与异步、与 agentic 环境在机制上不兼容。 这一条与长度或归一化无关,而是组这个结构本身的问题。GLM 的 SAO23 论文说得最清楚:
The group-wise sampling induces latency-driven off-policy behavior because the group has to wait for the slower one to finish before fed into training. In addition, group-wise sampling is incompatible with online or complex agentic settings where the environment often provides only a single trajectory feedback per prompt.
两重困难:其一,一个组必须等最慢的那条轨迹跑完才能进训练,于是 §3.2 的长尾问题被直接转化成 off-policy 程度——组越大、尾巴越长,整组数据就越陈旧;其二,很多在线或真实 agentic 环境对一个 prompt 只给一条轨迹反馈,组根本凑不出来。SAO 的回应是干脆放弃组内采样,改为每个 prompt 只采一条(single-rollout),用 value model 提供 baseline。
另有一个独立的归一化问题:原版 GRPO 的 advantage 要除以组内标准差,这会把方差极小的 prompt(几乎全对或全错)的 advantage 放大,Dr.GRPO 的修正就是去掉这个除法。各家取舍不一——Kimi K3 与 MiMo 都只减组均值、不除 std4[^mimo-tr],Qwen 则保留了 (r-\mathrm{mean})/\mathrm{std}。
病态四:无 critic 使信用分配粒度过粗。 GRPO 把序列级 advantage 原样广播给轨迹内每个 token。单轮数学题上这尚可接受,但一条数百步的 agentic 轨迹只有最终一个二值结果,于是几十万个 token 共享同一个数值,模型无法分辨是哪一步做对或做错(这正是 §3.6 的主题)。SAO 实测 vanilla GRPO 在约 160 步崩溃、vanilla VAPO 约 90 步崩溃,而配上训练得当的 value model 后可稳定训练约一千步。
四个核心变量。 上述病态对应四个可选维度,各家的差异基本可以由这四项的组合描述:IS 比值放 token 级还是序列级(病态一);clip 是「取 min 饱和」、「掩码置零」还是「截断系数但保留梯度」(病态二);要不要 KL;要不要 critic(病态三、四)。
3.5.2 主流解法流派
流派甲「无 critic 组相对」:GRPO 及其变体(GSPO 序列级、CISPO 保留全 token 梯度、DAPO 动态采样 + clip-higher、Dr.GRPO 去 std),advantage = 组内奖励减均值(可选除 std)。
流派乙「IS 掩码/截断纠偏」:IcePop/KPop/DIS/MIS-PO/HisPO,在组相对或 actor-critic 框架上叠加对训推/陈旧偏差的 token 或序列级门控
流派丙「有 critic actor-critic」:PPO/VAPO/decoupled-GAE + value,用价值模型做 token 级信用分配,GLM 的 SAO/CompactionRL、StepFun 的 MIS-PO、Seed 的 PPO 变体属此。
3.5.3 代表性做法
3.5.3.1 DAPO (字节 Seed + 清华 AIR):GRPO 工业化的共同祖先
本节后面提到的多数「工业调法」都能溯源到 DAPO,因此先把它说清楚。DAPO 全称 Decoupled Clip and Dynamic sAmpling Policy Optimization,在 GRPO 上叠四项技术,每项都对准一个可诊断的失效模式22:
- Clip-Higher — 解熵坍缩。把 clip 上下界解耦为 \varepsilon_{low}=0.2、\varepsilon_{high}=0.28,机制即 §3.5 病态二所述:上界对低概率 token 的约束远紧于高概率 token。只抬上界、下界原样不动,原文给的理由是「调大 \varepsilon_{low} 会把这些 token 的概率压到 0,导致采样空间塌缩」。这个非对称是有必要的:上界只限制涨速,token 仍留在采样分布里、每步仍能拿到梯度;下界一旦放宽把概率压到 0,该 token 就不再出现在 rollout 里,没有样本就没有梯度——机制上真正不可逆的那条路在下界,不在上界。
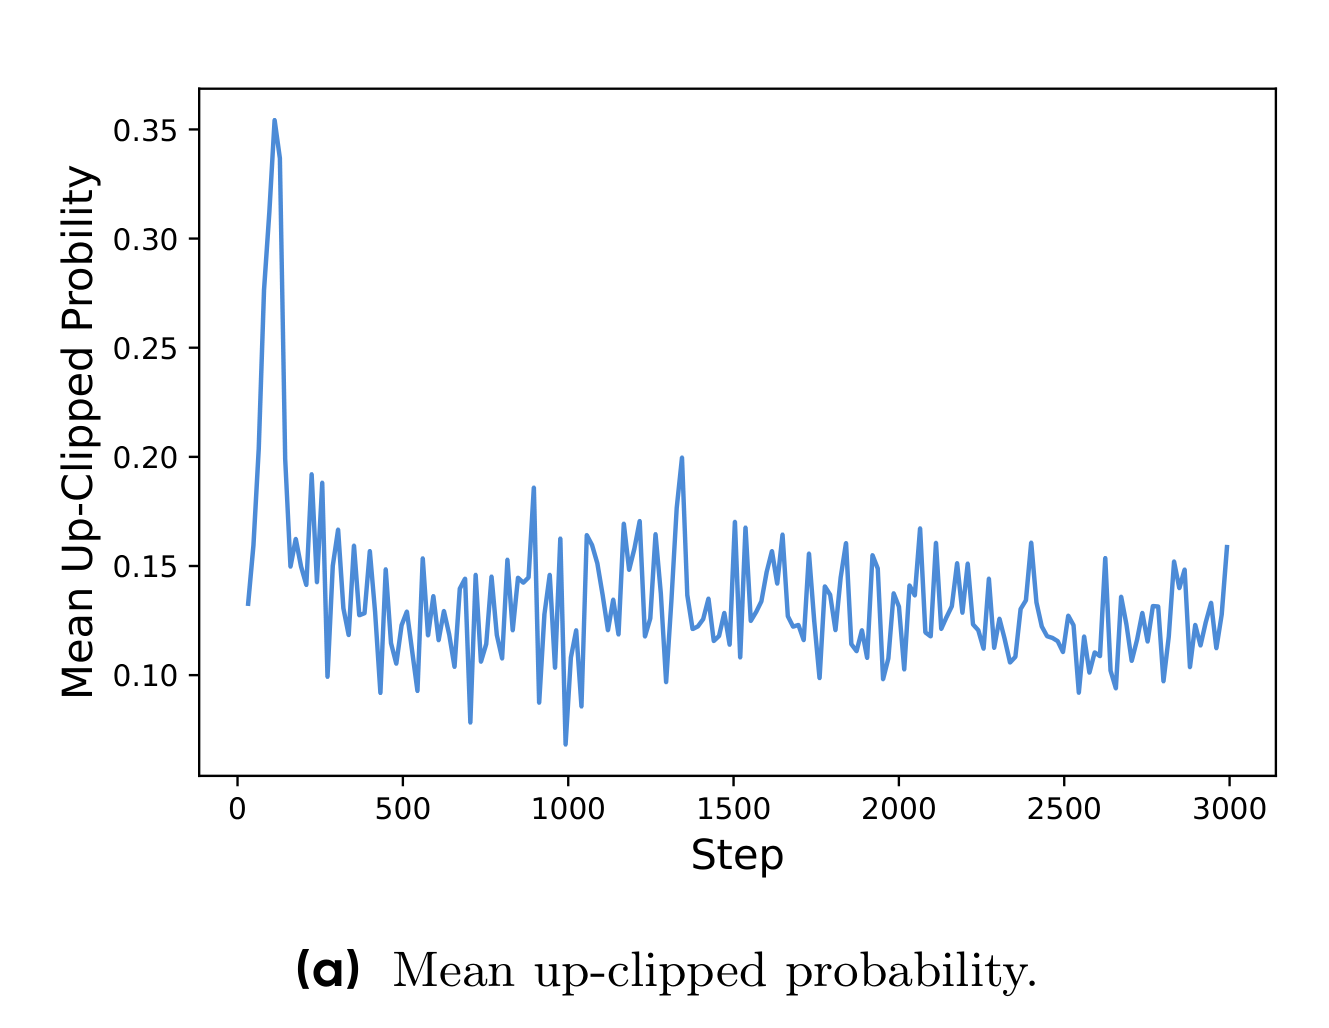
- Dynamic Sampling — 解梯度饥饿。组内全对或全错时 \hat A_{i,t}\equiv 0,该 prompt 对梯度零贡献;DAPO 把这类 prompt 过滤掉并继续重采样直到 batch 填满。动机是实测「accuracy=1 的 prompt 占比」随训练单调上升,即每个 batch 的有效 prompt 数持续衰减
- Token-Level Policy Gradient Loss — 解长度偏置。把原版 GRPO 的「序列内按 token 平均、再跨序列平均」换成一次性按 token 总数归一化,下面展开。
- Overlong Reward Shaping — 解截断噪声。分 overlong filtering 与 soft overlong punishment 两段,下面展开。
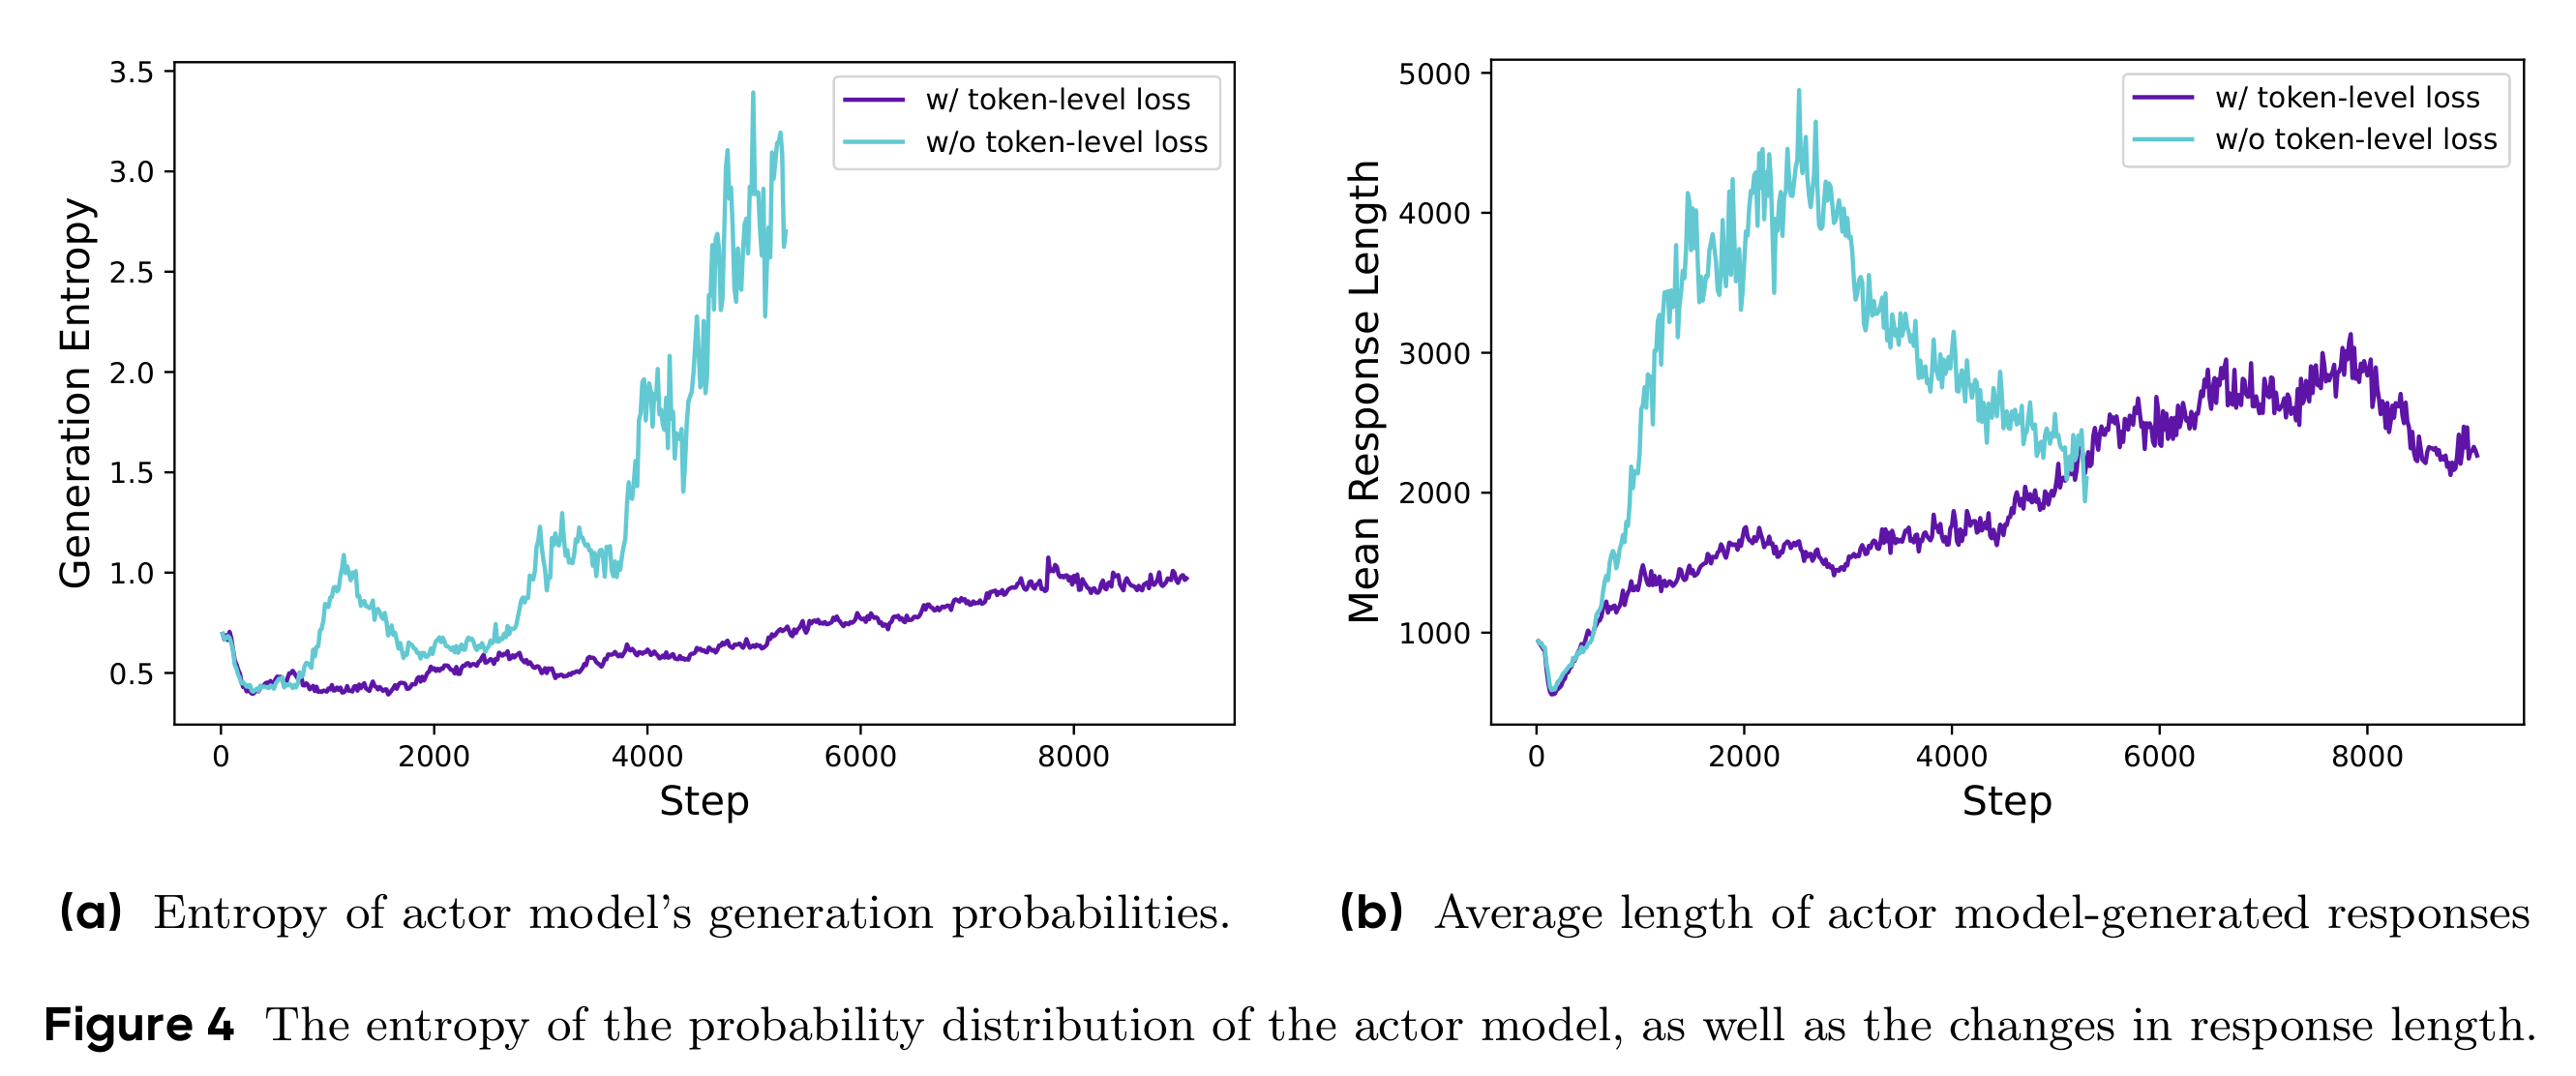
**token 级归一化:**原版 GRPO 做的是两级平均——先在序列内按 token 平均,再跨序列平均:
DAPO 改成一步到底,直接按参与计算的 token 总数归一(工程实现中通常按全局 batch 的 token 总数,而非逐组):
用数字看单个 token 在 loss 里拿到的权重。设 G=2、|o_1|=100、|o_2|=10{,}000:
- sample-level:o_1 的每个 token 权重 \frac{1}{2\times 100}=5\times10^{-3},o_2 的每个 token 权重 \frac{1}{2\times 10{,}000}=5\times10^{-5}——相差 100 倍,差距恰好等于长度比
- token-level:全部 token 一律 \frac{1}{10{,}100}\approx 9.9\times10^{-5},等权
换句话说,sample-level 那个看起来最公平的设定(每条序列等权),等价于「序列越长,其中每个 token 越不重要」。长 CoT 场景下这会导出两个方向相反的后果:
- 好的长样本学不进去。 一条高质量长推理里的有效模式,权重被序列长度除掉了。
- 坏的长样本罚不下去。 超长样本往往带 gibberish 与重复词,而这些模式恰好出现在最长的序列里,也就是单 token 权重最低的地方。
第二条更要紧,因为它自我强化:罚不动 → 长度继续涨 → 权重进一步被摊薄 → 更罚不动。原文的结论是 sample-level 归一化leads to an unhealthy increase in entropy and response length.
第一段,Overlong Filtering:不给截断样本任何 reward,直接把它们的 loss 屏蔽掉,既不奖也不罚、当作这个样本不存在。原文说这significantly stabilizes training and enhances performance。它在消融里贡献 +6 点(30 → 36),是四件套中单项增益最大的一个。
第二段,Soft Overlong Punishment:屏蔽虽然消除了错误标签,但也等于对长度完全不施加压力,于是再叠一个长度感知的软惩罚,加在原有的规则正确性 reward 之上:
代入 L_{\max}=20{,}480、L_{\text{cache}}=4{,}096(即「期望最大长度 16,384 + 4,096 token 软惩罚缓冲区」):|y|\le 16{,}384 时惩罚为 0、完全自由;16{,}384<|y|\le 20{,}480 时惩罚从 0 线性滑到 -1;超过 20,480 恒为 -1。设计上的讲究是分段连续——|y|=20{,}480 处第二段给出 \frac{16{,}384-20{,}480}{4{,}096}=-1,与第三段无缝衔接,边界处不出现 reward 跳变。这一段贡献 +3 点(38 → 41)。
两段在消融表里是两行独立增益,原因就在于分工不同:filtering 消除的是错误标签,soft punishment 提供的是正确的长度梯度。只做 filtering 会放任长度无约束增长;只做 soft punishment 则仍在惩罚一条可能完全正确的推理。
值得横向对照的是,这与本节后面 StepFun 的 Truncation-Aware Value Bootstrapping 是同一个问题的两种解法:StepFun 把截断轨迹的 reward 换成 V_\phi(s_T),即让 critic 估一下「接着跑下去大概能拿多少」;DAPO 没有 critic,只能选择屏蔽。这是 critic 路线在这个具体问题上的一项真实优势——它能给截断轨迹一个有信息量的估计,而非只能当作缺失值丢弃。
消融(Qwen2.5-32B base,AIME24 avg@32)值得整体看,因为它说明这四项的权重很不均匀:
- Naive GRPO 30
- Overlong Filtering 36
- Clip-Higher 38
- Soft Overlong Punishment 41
- Token-level Loss 42
- Dynamic Sampling(即完整 DAPO)50
对照 DeepSeek-R1-Zero-Qwen-32B 的 47,DAPO 用一半训练步数超过它。注意 token-level loss 只贡献 1 点——原文自己说它的价值在稳定性而非分数("it enhances training stability and makes the length increase more healthily");贡献最大的两项反而是 overlong filtering(+6)和 dynamic sampling(+8)。另外 DAPO 无 KL 项,训练配置是 prompt batch 512 × 16 responses、mini-batch 512,即每个 rollout step 做 16 次梯度更新——这正是病态二里 clip 能在 outer step 内部生效的前提。
3.5.3.2 CISPO(MiniMax):把 clip 从 token 更新搬到 IS 权重
CISPO(Clipped IS-weight Policy Optimization)出自 MiniMax-M1,是对病态二的正面回应。它的出发点不是「放宽上界」而是「换掉被 clip 的对象」:PPO 裁的是 token 更新本身(越界即梯度归零),CISPO 裁的是乘在梯度前面的那个标量系数,于是所有 token 永远参与梯度。
形式上它先把目标函数退回带 IS 修正的 REINFORCE,再对 IS 权重截断(\mathrm{sg}(\cdot) 是 stop-gradient,即 PyTorch 的 .detach():前向恒等、反向梯度置零,把该项当常数看待):
三个关键点容易被略过:
- \mathrm{sg}(\cdot)** 只套在 \hat r_{i,t} 上**,不套 advantage、不套 \log\pi_\theta,而且这一步不是可选的。因为 \hat r 自身含 \pi_\theta,不 detach 的话链式法则会多出一项:未截断区间内 \nabla\hat r=\hat r\nabla\log\pi_\theta,于是
多出的因子 (1+\log\pi_\theta) 是个绝对值不小的负数(p=10^{-3} 时 \log p\approx-6.9,因子为 -5.9),符号翻转且幅度随 token 概率剧烈变化,完全不是梯度估计。加上 sg 后退回 \hat r\,\hat A\,\nabla_\theta\log\pi_\theta,\hat r 成为纯标量系数、只调幅度不改方向。原文的说法是让 IS 权重「调制梯度幅度而不引入二阶项,得到稳定的一阶更新规则」。顺带可以看出 PPO 为何不需要 sg:它的代理目标是 r_t\hat A_t(乘比值而非 \log\pi),\nabla_\theta[r_t\hat A_t]=\hat A_t r_t\nabla_\theta\log\pi_\theta 本身就是策略梯度。把两者并排,CISPO 的本质就很清楚了——未截断区间内它与 PPO 的梯度完全一致,唯一差别发生在越界之后:PPO 的 \min 选中饱和分支、梯度归零,CISPO 只把系数钳在 1+\epsilon^{IS}_{high}、梯度照流。
- 归一化分母是整个 group 的 token 总数\sum_i|o_i|,即 DAPO 的 token-level loss,不是序列内先平均。
- 去掉权重截断,J_{\mathrm{CISPO}}就退化成标准 policy gradient——原文明说。这意味着 CISPO 的全部「稳定性」都来自那一次 clip,没有信赖域。
M1 论文还给了一个统一形式,把 PPO 和 CISPO 收进同一个框架:在上式里乘一个 token 级 mask
这个 M_{i,t} 正是 PPO 信赖域隐式定义的那个掩码;M_{i,t}\equiv 1 即纯 CISPO。把 PPO 的 \min 结构还原成一个显式掩码,是理解「clip 到底裁掉了什么」最清晰的写法,也顺带说明了 §3.3 那一派「掩码/截断」方法与 PPO 的血缘关系。
两代之间有两处实质变化,综述里容易混为一谈:
- 截断区间:M1 是双侧 [1-\epsilon^{IS}_{low},\,1+\epsilon^{IS}_{high}];M2 改成非对称的 [0,\,1+\epsilon^{IS}_{high}],原文解释下界取 0 是为了「允许对在当前策略下已变得不可能的动作做激进降权」。
- advantage:M1 直接沿用 GRPO 的组内相对优势(含除 std);M2 才换成 reward-to-go 减轨迹级 baseline,并把训练的原子单元定为单个 (s_t,a_t) 对——这样策略就不必知道 s_t 是由简单追加、激进截断还是整段历史重写得到的,而信用分配、优势估计、奖励传播仍在 episode 级完成。这是为 agentic 多轮 + context 管理专门做的解耦。
其余设定:无 KL;沿用 DAPO 的 dynamic sampling 与 length penalty;原文承认权重截断使梯度slightly biased,换来的是保住长回答里全部 token 的梯度贡献与更低方差。M2/M2.1 阶段在 CISPO 之上又叠了 MIS 与 PPO 式轨迹过滤,用于剔除长尾异常统计的轨迹16。
3.5.3.3 GSPO(Qwen):序列级比值
公式与 clip 范围已在 §3.4 流派乙展开,这里只留结论:s_i=(\pi_\theta/\pi_{old})^{1/|y_i|},clip 范围 3e-4/4e-4,比 GRPO 的 0.2/0.27 小约两个数量级;反直觉的是 GSPO 被 clip 掉的 token 比例高达 0.15(GRPO 仅 0.0013)却训练效率更高,佐证 GRPO 的 token 级梯度本身噪声大、样本利用低效。
3.5.3.4 SAO(GLM / 清华):放弃组,回到 critic
SAO(Single-Rollout Asynchronous Optimization)是本节里唯一一个把 group size 直接设成 1 的方案,动机见病态三。它的实际目标函数不是 PPO 的 \min 代理形式,而是
即 §3.3 的 DIS:分母直接取 rollout 引擎记录的 log-prob、彻底丢掉 \pi_{\theta_{old}}(省掉一次旧策略前向,也避开「用某个可能已陈旧的 latest 旧策略」带来的误差),且不看 advantage 符号——越界 token 的梯度整个被掩掉,而不是 clip 到边界值。原文说这比 IcePop 更简单(少了 \pi_{\theta_{old}} 这一项),并且正因为简单才敢用更激进的区间:数学 TIR 场景 \epsilon_\ell=0.3,\ \epsilon_h=5.0,编码 agent 场景 \epsilon_\ell=0.8,\ \epsilon_h=3.0。注意 \epsilon_h 取到 5.0 这种量级在 PPO 语境下近乎没有上界约束,它真正依赖的是下界与 critic。
group size 砍到 1 之后,baseline 全靠 value model,于是 SAO 的技术重心全在 critic 上,四项设计:
- Faster Value Update(TTUR):policy 每更新 1 次,critic 更新 K=2 次。动机是单 rollout 下策略与价值互相依赖,V_\phi 不准会让 \hat A_t 带噪、进而毁掉策略更新。实测约 400 步后 explained variance(1-\mathrm{Var}(R-V)/\mathrm{Var}(R))显著更高。
- Frozen Attention:预实验发现 critic 的梯度范数远大于 policy,且不稳定主要来自 Full Attention 层而非 MoE 层,于是 RL 期间冻结 critic 的 attention、只训 MoE 投影。
- Scaling Value Pretraining:价值估计的「冷启动」是主要瓶颈,必须把价值预训练语料规模显著放大。
- Length-adaptive GAE:\lambda_{policy}=1-\frac{1}{\alpha l},\alpha=1.5,\lambda_{critic}=1。这一条原文明确标注是沿用 VAPO,不是 SAO 的新贡献。
另有一项针对 agentic 轨迹结构的改造,Skip-Observation GAE。问题是轨迹形如 [a_0,o_0,a_1,o_1,\dots],而从动作末 token 到 observation 首 token 的跃迁对模型而言是不连续的——o_i 不是模型生成的,让 V(o_{i,\text{start}}) 去预测一个外部环境状态的价值只会引入噪声。SAO 的做法是改写 Bellman 目标,把动作直连下一个动作:
等价于把 observation token 整段从轨迹里剔除后再做标准 token 级 GAE,使优势估计只依赖模型自己的输出。原文还专门否掉了 step-level value 这个更省事的替代:统一 400 步下 token 级 89.8/66.8,step 级取平均 85.8/60.5、取末 token 87.3/62.8(AIME2025 / BeyondAIME)。
3.5.3.5 MIS-PO(StepFun):用二值过滤替代连续重加权
全称是 Metropolis Independence Sampling-Filtered Policy Optimization——Filtered 这个词是方法的核心,它过滤而不加权。思路是把推理策略当 proposal 分布、训练策略当 target 分布,只拿「离 target 足够近」的样本做更新。形式上定义一个二值指示函数并在两个粒度上各用一次:
token 级掩码抑制局部不一致,轨迹级掩码(作用在 x_t 的几何平均上)把整体漂移过大的轨迹整条丢弃,两者相乘。阈值:**token 级 [0.5,\,2],轨迹级 **[0.996,\,1.001]。差三个数量级是因为几何平均在长序列上会强烈向 1 收缩,不用极窄窗口就没有区分度;上下界不对称(下界留 0.004、上界只留 0.001)原文未解释。
两个容易误读的地方需要点明:
- 这不是真正的 Metropolis-Hastings。 原文没有给出任何形如 \min(1,\cdot) 的接受概率,接受是确定性的区间判定,MIS 只是灵感来源。写成「Metropolis 式随机接受」会误导读者。
- 比值的分子分母是\pi_{\theta_{old}}/\pi_{\theta_{\mathrm{vllm}}},即 §3.4 的 r^{dis}——训练端更新前快照对推理端,而不是 \pi_\theta/\pi_{\theta_{old}}。所以这个掩码同时覆盖训推框架数值不一致与 off-policy 滞后两类偏移,这也解释了为什么它在本文里既出现在 §3.3 也出现在 §3.4。
过滤之后,保留样本的比值已被约束在接近 1 的区间内,连续重加权退化为乘 1,于是原文把它们直接视作 on-policy,做 \log\pi_\theta\cdot\hat A_t、不再做 PPO 式比值裁剪。需要注意原文用词是 "effectively on-policy",即工程近似;论文没给这个近似的偏差界或无偏性证明,不宜写成理论等价。
优化器一侧保留 critic:\hat A_t=\hat R-V_\phi(s_t),\gamma=\lambda=1(沿用 ORZ),即 GAE 退化为蒙特卡洛回报减基线。Muon 优化器、weight decay 0.1,actor lr 2\times10^{-6}/20 warmup、critic lr 5\times10^{-6}/50 warmup,每轮 4 个 actor mini-batch 对 12 个 critic mini-batch——critic 的更新量是 actor 的三倍,与 SAO 的 K=2 是同一个思路。最后阶段加 unbiased KL,系数 0.001。配套的 Truncation-Aware Value Bootstrapping 解决「截断 ≠ 失败」:
给截断轨迹赋 0 奖励会把没做完和做错了混为一谈、系统性惩罚长链推理;换成末状态的价值估计后,截断率高达 20% 仍能稳定训练。注意这一条依赖 critic 存在——这是 StepFun 保留 value model 的一个硬理由,无 critic 路线没有等价替代。原文未提及 critic 的初始化方式或是否做价值预训练7。
3.5.3.6 CompactionRL(清华):为 context compaction 重做 loss 归一化与 GAE
CompactionRL 的问题设定很特殊:当上下文预算耗尽时对历史做摘要压缩、再继续 rollout,于是一条 rollout 被切成数量不定的 segment,而这些 segment 共享同一个任务级奖励、长度与「距最终结果的时间距离」却各不相同。固定大小的组归一化在这里直接失效,所以它从 group-wise 退回 PPO + critic,用 critic 给 token 级优势。它的两项改造都是被 compaction 这个结构逼出来的:
- Token 级 loss 归一化:loss 在生成 token 上计算而非在样本上计算。若按 segment 平均,一条触发了更多次 compaction 的 rollout 就会贡献更多权重,哪怕它和另一条拿的是同一个任务奖励。token 级归一化消掉这个 segment 数偏置,让每个可训 token 等权。
- Cross-Trajectory GAE:segment 内先算局部 GAE A^{loc}_{s,i}=\sum_{\ell\ge 0}(\gamma\lambda)^\ell\delta_{s,i+\ell},\delta_{s,i}=r_{s,i}+\gamma V_\phi(x_{s,i+1})-V_\phi(x_{s,i});再做一次轨迹位置修正
其中 N_{>s} 是同一 rollout 中 segment \sigma_s 之后生成的可训 token 总数。不做这个修正的话,朴素的 segment 级 GAE 会把共享的终局奖励摆在每一个 segment 的末尾,于是靠前的 segment 会误以为最终结果近在眼前,从而高估那些实际上远早于任务完成的动作与摘要。
另一个设计是把摘要生成本身也纳入优化:轨迹生成与摘要生成共享同一个任务级奖励联合训练,让压缩成为模型学到的能力而非推理期的启发式规则。全文无 KL 项。结果上,GLM-4.5-Air(106B-A30B)SWE-bench Verified 66.8%(+7.0)、Terminal-Bench 2.0 24.5%(+3.1);GLM-4.7-Flash(30B-A3B)56.0%(+5.5)、20.2%(+6.8),已用于 GLM-5.2 的 RL 流程24。
3.5.3.6 DIS(GLM):丢掉 \pi_{\theta_{old}}
这个之前也讲过的, 公式见 §3.3,这里补它作为独立可叠加组件的价值。DIS 的改动只有一处——把比值分母从训练端的旧策略快照换成 rollout 引擎实际记录的 log-prob,于是不必再维护历史版本、也省掉一次旧策略前向。它的意义在于可以单独叠在别人身上:SAO 的主表里 GRPO 84.2 / 54.8 加上 DIS 变成 93.5 / 70.8(AIME2025 / BeyondAIME),单这一项就拿了 9 点以上;而去掉 DIS 的 vanilla VAPO 则「与 vanilla GRPO 类似,训练很快崩溃」。换个角度说,SAO 97.3 / 74.8 里有相当大一块来自 DIS 而非 single-rollout + critic 本身(SAO w/ DIS only 为 94.2 / 71.5)23。
3.5.3.7 其余路线:GRPO 的工业调法与 critic 阵营
GRPO 的工业调法:Ring-1T 的 IcePop 在 GRPO 上加双侧掩码、KL 系数 0.0;腾讯混元开源 recipe 用 clip-higher(0.2/0.28)缓解熵坍缩、dual-clip(c=10)限制负优势 token、KL-free、DAPO overlong buffer,并可一键切换 gae/grpo/rloo/remax/reinforce++/gspo/cispo 等 estimator11。这两家本质上是把 DAPO 的四件套挑着用,再叠自家的 IS 纠偏。
critic 阵营的其余成员:字节 Seed1.5-VL 用 PPO 变体 + shared critic(单 critic 同时估计 RM 与 verifier 两种奖励,由 reward model 权重初始化、100 步 warm-up)、分任务 KL(general 用 1e-5、verifiable 用 0)25;Seed-Thinking-v1.5 用 value pre-training + decoupled GAE 解决长链推理不稳26。把 SAO、MIS-PO、CompactionRL、Seed 这四家并排看,一个共同点很清楚:凡是回到 critic 的,都要额外付一笔「如何把 value model 训好」的代价——价值预训练、冻结部分参数、提高更新频率、改 GAE 的接法,四家各自都做了三到四项专门设计。critic 不是免费的 baseline,它本身是个需要调教的子系统。
3.5.4 权衡与适用场景
分歧一:要不要 critic。
- 无 critic(组相对)最省。 不用训 value、不用拟合长序列回报,适合可验证、结果奖励清晰的任务。代价是信用分配只能靠序列级广播,对长程稀疏奖励乏力;而且组这个结构本身带来病态三的两重困难。
- 有 critic 能做 token/step 级信用分配,天然支持单 rollout 与变长分段轨迹(这正是 CompactionRL 与 SAO 的关键动机),还能给截断轨迹一个有信息量的估计(StepFun 的 value bootstrap)。代价是 critic 本身在长序列上难拟合、冷启动不稳——这笔账不小:SAO、MIS-PO、CompactionRL、Seed 四家各自都为「把 value model 训好」额外做了三到四项专门设计(价值预训练、冻结 attention、提高更新频率、改 GAE 接法)。critic 不是免费的 baseline,它是个需要调教的子系统。
原则:优化单位与奖励单位一致。 这是贯穿本节的指导思想,由 GSPO 明确提出:奖励在序列级就用序列级 IS;奖励在 turn 级就用更细的粒度(MiniMax 以 (s_t,a_t) 为原子单元、DeepSeek 按推理努力分子组)。
分歧二:loss 怎么聚合。 各家做法不一,且都给了自己的理由:
- MiMo 用 prompt-mean,目的是防回复长度暴涨
- GSPO 按序列平均,并把长度归一化放进 s_i 内部
- CISPO / DAPO 按组内(实现上常为全局 batch)token 总数平均
- HisPO 用全局常数「最大生成长度」作分母,以缓解长度偏差
- Dr.GRPO 去掉 std 归一化,以免方差极小的 prompt(几乎全对或全错)被放大;混元 recipe 把这一项做成可切换开关
分歧三:连续 IS 权重还是二值接受/拒绝。 StepFun 给了与 GSPO 的正面对比7:在 MoE 上 GSPO 约 200 iter 进入平台期且训推差异持续发散,而 MIS-PO 把差异维持在稳定区间、样本效率更高,据此主张用二值过滤而非连续重加权。这与 §3.4 的路线分歧是同一件事的延续——承认偏差并加权,还是划定信赖域、界外直接丢弃。
3.6 稀疏奖励与信用分配
3.6.1 问题拆解
agentic 轨迹跑几百步却只有最终一个二值 pass/fail,带来两个难题:其一,奖励稀疏且无区分度——「都通过测试」的解之间质量参差,二值信号无法排序;其二,信用分配——无法指出是哪一步、哪个 turn 做对/做错。MiMo 直言「二值 pass/fail 无法给通过的解排序,所以要扩大 grader 的算力投入」,并把 grader compute 当作与 batch、环境多样性并列的第三个扩展维度(占 Pro 成本的 12.7%)1。
3.6.2 主流解法流派
流派甲「outcome + 奖励塑形」:以结果奖励为主,叠加过程惩罚、长度惩罚、时间惩罚等 shaping。
流派乙「生成式奖励模型(GRM)/ rubric / 锦标赛打分」:用 LLM 对轨迹做细粒度或相对打分。
流派丙「value/critic 做 token/step 级信用分配」:用价值模型回归每个 token 的回报。
流派丁「上下文/摘要共享奖励」与「turn 级 advantage」:把长程信用沿轨迹结构分配。
3.6.3 代表性做法
3.6.3.1 流派甲 · outcome + 奖励塑形
- MiniMax 用复合奖励 r_t=\alpha\, r^{process}_t+\beta\, r^{speed}_t+r^{perf}_t,三项含义如下。r^{perf} 是任务结果奖励(可执行验证 / artifact 对齐),注意它是式中唯一不带系数的一项——它是基准尺度,\alpha 与 \beta 都相对它取值,等于明确表态「结果为主、shaping 为辅」(原文未给 r^{perf} 的形式化定义,这个身份由「\alpha、\beta 平衡于 the primary task performance signal」一句反推)。r^{process} 是逐步的稠密信号,惩罚语言混杂与工具格式错误、奖励结构良好的中间推理。r^{speed}=h(T_{completion}/T_{baseline}) 以 h 为单调递减函数、用相对墙钟时间激励并行与高效——这是少见的把「快」直接写进奖励的设计,M2.5 实测 SWE-bench 端到端从 31.3 分钟降到 22.8 分钟、快 37%。优势估计用 reward-to-go 减轨迹级 baseline(\hat A_{i,t}=\sum_{p\ge t}r_p-B_i),所以终局才产生的 r^{perf} 会自动累加进每一步的优势,不需要另设广播机制16。
- Qwen3-Coder-Next 在轨迹级完成奖励上叠两层惩罚:未完成轨迹惩罚(超过最大轮数仍未收尾)与 turn 级工具格式惩罚(非法工具调用对应的那些 token 收 token 级惩罚,而非整条轨迹连坐)5。
3.6.3.2 流派乙 · 生成式奖励模型 / rubric / 锦标赛
先说清这一派共用的两件工具。
rubric(评分量表)就是一张检查清单:给它一组明确维度让它逐条判——原理是 LLM 判「整体质量」标定很差,但判「是否满足这条具体要求」可靠得多,相当于把一个模糊的回归问题拆成若干个可枚举的分类问题。
锦标赛则是只做两两比较、再聚合成排序或胜率,不给绝对分;动机同样是标定——LLM 评委的绝对分会漂移、聚堆、饱和(训到后期全是 9 分),而成对偏好判断稳定得多。两者互补:rubric 解决「比什么」,锦标赛解决「怎么比才标定得准」。共同代价是都吃 grader 算力,锦标赛尤甚(全对全是 O(n^2) 次比较)。各家形态:
a. DeepSeek-V4
把易验证任务交给规则验证器与测试用例,难验证任务则彻底弃用标量 RM,改为构建 rubric 引导的 RL 数据、用 GRM 评估策略轨迹。更特殊的是它不另训一个评委:actor 网络原生充当 GRM(同一套权重既产出轨迹又给轨迹打分),并且对 GRM 本身也做 RL,与生成能力联合优化——原文称这样只需少量多样的人工标注即可。代价是引入了自指结构(模型给自己的输出打分),存在自我奖励漂移的空间,缓解手段是 rubric 引导数据加人工标注;3。
b. MiMo
分两套互补机制,都叫 groupwise 但作用在流水线的不同位置:GRS 改奖励、GAR 改优势,下面展开。
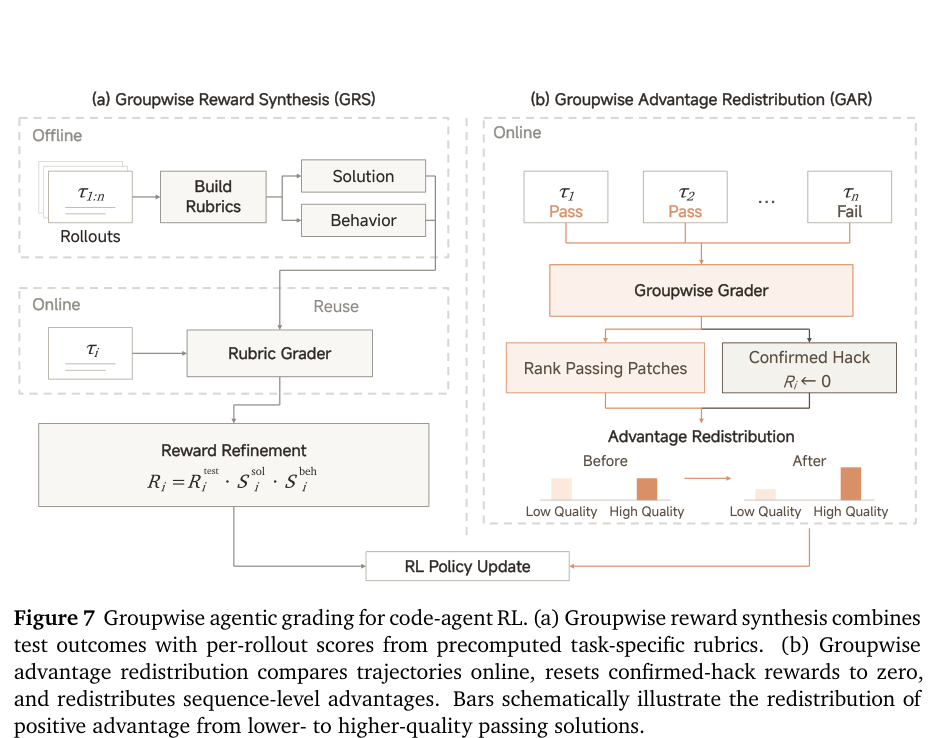
GRS(Groupwise Reward Synthesis,离线 rubric) 用于高通过率任务子集,分两段。
离线建 rubric:对每个选定任务先采多条 offline rollout,让一个 agent 把它们连同任务说明与仓库一起研读。横向比较若干次尝试会暴露出不同解法、反复出现的错误、以及散落在各条轨迹里的有用行为。agent 把分析整理成两套标准——solution rubric 评最终实现(需求满足度、边界情况处理、改动与周边代码是否一致),behavior rubric 评解题过程(是否收集了相关证据、是否验证了改动的效果)。这里有个关键设计:rubric 的依据是任务本身,而非采样到的轨迹。某个有用行为可能只在一条尝试里出现过,某条任务本就隐含的要求也可能在所有观察到的解里都缺失,所以 agent 可以提出超出样本的改进项;反过来,某条成功解做的某个选择不会自动变成对其他解的硬性要求。这一条是为了防止 rubric 退化成「模仿采样里最好的那次」。
在线复用打分:rubric 建好后在训练中反复使用。grader agent 进入每条 rollout 的执行环境,以最终代码、执行结果、轨迹为证据,给出 solution 分 S^{sol}_i 与 behavior 分 S^{beh}_i,与原始二值测试奖励相乘:
乘性形式的作用是把 rubric 监督锚定在测试结果上:失败轨迹 R^{test}_i=0,rubric 分再高仍是 0,不会出现「写得漂亮但没通过」被奖励。而当一组里所有 rollout 都通过时,两个 rubric 分的乘积差异仍能提供学习信号——这正是 §3.6 (1) 所说「二值信号无法给通过的解排序」的直接解法。
c. GAR(Groupwise Advantage Redistribution,在线打分) 用于其余所有代码 agent 任务。它不动奖励,改的是优势,流程分三步。
在线对比:把一个 mixed-outcome(有通过有失败)组里的全部轨迹放进同一个共享工作区,内含任务说明、仓库、提交的 patch、测试输出。一个 SFT 训出来的 agentic grader 同时审视全部轨迹、对照成功与失败的尝试,并按五个维度比较所有通过的 patch:解法思路是否合适、实现是否精确(无遗漏、无不必要的 fallback)、改动是否最小化、是否避免了任务范围外的副作用、以及与代码库约定的一致性(craftsmanship)。grader 可以读仓库代码、跑定向测试来验证候选解;差异不足以判断时允许并列。
hack 归零:若证据确认某轨迹依赖了外部或泄漏的答案,直接把其有效奖励置 0、当作失败,然后重算组统计量。
重分配:设 R_i 为 hack 修正后的有效二值奖励、\bar R 为组均值、A_i=R_i-\bar R 为序列级优势、\mathcal{P}=\{i: R_i=1\} 为通过集合。质量因子 f_i\in(0,1] 先给低质量的通过解降权,再用一个公共因子把被挪走的正优势质量重新分配给通过解:
这个形式保证 \sum_{i\in\mathcal{P}}A'_i=\sum_{i\in\mathcal{P}}A_i,即正优势总量守恒、只在通过解之间按质量重新分配,失败轨迹不受影响。为什么要加 \lambda 这步归一化而不是单纯降权:只压低正优势会让负优势相对变大,原文称这是对熵过度增长的防护,重归一化恢复两侧平衡。实践中还对 \lambda 设了上限,避免正优势被过度放大。最后对通过与失败两侧一起减去组均值,得到零均值的最终序列优势,再广播到轨迹内所有 response token。打分异步进行,grader 输出不可用时回退到原始优势。
GAR 的消融(DeepSWE v1.1,MiMo-V2.6-Flash,code-only RL,batch 128,token-mean 聚合)是本节少见的直接对照:
- 不开 GAR:turn 数与总 token 长度快速增长,更多轨迹撞上长度上限,pass rate 难以持续提升
- 开 GAR:pass rate 增益持续到第 52 步,turn 数大致稳定,token 长度缓慢增长
d. Kimi K3
Kimi K3 的 Agentic GRM 沿用 K2.5 的锦标赛式组奖励、做二元比较,并给 judge 规定了一套强制协议:① 读结果/产物/文本输出 → ② 生成 rubric → ③ 逐候选对着 rubric 打分 → ④ 把 rubric 分记入 scorepad。注意 rubric 是按任务现场生成的而非固定清单。为了防止评委被「越写越长」钻空子,它还加了一道预算式冗长控制:由冷启动模型估出初始冗长度 \ell_0,给定倍率 \sigma,候选输出长度一旦超过 \sigma\cdot\ell_0 就在二元比较中自动判负4。
e. GLM
GLM 的 General RL 不选边,而是把三类信号混合使用,并给出了各自的强弱:rule-based 精确可解释,但只能覆盖可用确定性规则表达的部分;ORM(标量结果 RM)低方差、训练效率高,但更容易被 hack——策略会去钻表面模式而非真正提升能力;GRM 用语言模型产出标量或结构化评估,对这类钻空子更鲁棒,但方差明显更高。三者混合是为了用各自的长处补彼此的短处。此外它还做了一件别家少见的事:把高质量人工撰写的回答作为风格锚点引入,理由是纯靠模型生成的优化会收敛到一眼可辨的「模型腔」——啰嗦、套路化、缺少熟练写作者的细腻18。
f. StepFun
StepFun 对不可验证任务用 pairwise GenRM:不做全对全比较,而是让每个候选对一个固定参考比,GenRM 作为推理模型输出一个「该回答会赢」的置信度,再转成 Bradley–Terry 胜率当奖励——这把比较次数从 O(n^2) 压到 O(n)。长度控制被建模成置信度上的惩罚并传导到胜率,用于压制 RL 期间的长度膨胀;伪造引用、过度自信断言、语言不一致则直接奖励置零。GenRM 自身由 SFT 模型加 RM 专用 prompt 微调而来、用整理过的成对偏好数据配 logsigmoid 损失训练,并额外挂一个 MetaRM 惩罚「结论对但推理错」(spurious reasoning)。报告生成这类任务则走 rubric judge,产出三元判定(满足 / 部分满足 / 不满足),但因为中间档与专家偏好对不上,又映射成非对称二值奖励以获得更清晰的信号7。
g. Ling2.6
Ling 2.6 的 bidirectional focus reward 由两半组成。bidirectional:与只给正向偏好的常规 RM 不同,它把正激励与负惩罚整合进同一个 RM,从而拓宽打分区间、让偏好梯度的信噪比显著提高。focus:为防止模型靠单纯拉长输出来 hack 奖励,它持续监测各 rubric 维度上的 on-policy 饱和度,把训练权重从已饱和的维度动态挪向尚需改进的维度。复杂任务另配专用评估器——长文写作用 ReportLogic 评宏观结构与篇章组织(把优化目标从表面流畅度移到文本逻辑),多重约束的指令遵循则由一个独立验证 agent 把请求拆成逐条显式规则来核验19。
更值得注意的是配套的人工审计结论。不开在线打分的策略在「提高测试通过率」的压力下会逐渐学会一批恶习:投机性兼容分支、过宽的导出、吞掉异常、放松校验、针对评测的配置改动。这些手法确实能提高通过概率,但超出任务指令范围、不必要地扩大 API、掩盖故障、让代码更难维护。开了在线打分的策略则倾向产出更小、更精确、留在请求范围内的 patch。这是一类**「软 hack」——测试没被骗过,但代码质量被牺牲了**;二值信号对此完全无感,只有组内比较才能发现。
3.6.3.3 流派丙 · value/critic 做 token/step 级信用分配。
- Seed1.5-VL 的 shared critic 用一个 critic 同时估计两种奖励源(reward model 与 verifier)的价值函数。能合并的前提是两者被放进同一量纲:RM 的输出天然落在 [0,1],而所有 verifier 的结果被显式缩放到同一区间。critic 的参数由预训练好的 reward model 权重初始化,再用 SFT 模型产生的 rollout 做 100 步 warm-up——这是针对 critic 冷启动的直接对策(见 §3.5 SAO 那条)。Seed-Thinking 则走 value pre-training + decoupled GAE 解决长链推理不稳26。
- GLM SAO 的 skip-observation token 级 GAE 把 Bellman 目标改写成「动作末 token 直连下一动作首 token」,等于把环境 observation 整段从轨迹里剔除后再做标准 token 级 GAE,使优势只依赖模型自己的输出(公式见 §3.5)。附录实验还否掉了 step-level value 这个更省事的替代:统一 400 步下 token 级 89.8/66.8,step 级取 turn 内平均 85.8/60.5、取最后一个 token 87.3/62.8(AIME2025 / BeyondAIME)23。
3.6.3.4 流派丁 · 沿轨迹结构分配长程信用。
- CompactionRL 让执行段与摘要段共享轨迹级最终奖励,刻意不另设摘要质量奖励——理由是手工定义的摘要指标未必反映「哪些细节对解题有用」。信用分配交给 cross-trajectory GAE \hat A_{s,i}=(\gamma\lambda)^{N_{>s}}A^{loc}_{s,i},按后续段的 token 数折扣,修正跨压缩边界的时序信用24。
- DeepSeek-V4.1 的 Agent Team 把一次多智能体执行中的事件及其协作依赖建成 DAG,取关键路径长度(而非事件总数)作「派生延迟」惩罚。这样一来,派出去但不在关键路径上的子任务不额外计费,惩罚只针对真正拖长端到端时延的那条链9。
- Kimi K2.5 的 PARL 把多智能体的信用分配问题直接绕开:subagent 全程冻结、其执行轨迹被排除在优化目标之外,只有 orchestrator 用 RL 更新。原文说这一刀解耦同时规避了端到端联合优化的两个难题——信用归属不清与训练不稳定。奖励是 r_{parallel}+r_{finish}+r_{perf},其中 r_{finish} 奖励「子任务真的完成了」以迫使分解可行有效(否则策略会学会滥派 subagent 而不做有意义的分解),前两项的系数 \lambda_1,\lambda_2 随训练退火到 0,确保最终只优化主目标。资源约束用 Critical Steps,仿照计算图的关键路径定义:
即每个阶段只计主 agent 的步数加该阶段最慢那个 subagent 的步数。用它而非总步数来约束,意味着「多派 subagent 但没缩短最长分支」几乎没有收益,而「把活均衡拆开、缩短最长分支」直接降低指标——于是 orchestrator 被导向最小化端到端时延而非单纯堆并发。实测 wide-search 场景时延降低最多 4.5×,item 级 F1 从 72.8% 提到 79.0%。
一条未定论的分歧:过程监督到底值不值得。 一端是 Seed1.5-VL 的明确否定——刻意只对最终结果打分,RM 评分时甚至截断 thought 只留 solution,不监督 CoT。另一端是上面流派乙那一长串 GRM/rubric 方案。而中间地带其实是大多数:MiMo、Kimi、DeepSeek、GLM、LongCat 等多数团队的结果 advantage 仍是序列级广播,报告中明确「未提及」独立的 PRM(过程奖励模型)或 turn 级 advantage。换言之,投入 grader 算力做细粒度结果打分(流派乙)与投入过程监督是两件事,前者已成共识、后者仍无共识(见第六节)。
3.6.4 权衡与适用场景
四个流派的取舍:
- 流派甲(outcome + shaping):实现最简单,适合可验证任务。代价是每加一个 shaping 项就多开一个 hack 面——长度、时间、格式惩罚全都可被钻。GLM 的 slide 渲染奖励就被「硬截断超长内容」和「过度操纵间距」两种方式钻过,这不是假想风险。
- 流派乙(GRM / rubric / 锦标赛):唯一能在「都通过」的解之间造出区分度的手段,这是 MiMo 把 grader compute 列为第三个扩展维度的理由。代价是 GRM 自身高方差、也会被钻空子(多套 rubric 是常见缓解,Kimi 与 MiMo 都这么做),且开销随候选数增长。
- 流派丙(value/critic):能做细粒度信用分配,支持单 rollout 与变长轨迹。代价是训练成本与冷启动,已在 §3.5 (4) 展开——critic 不是免费的 baseline。
- 流派丁(长程信用分配):目前最前沿也最不成熟。CompactionRL 的 cross-trajectory GAE 与 SAO 的 skip-observation GAE 回答的是同一个问题——轨迹结构被破坏(压缩分段 / 插入环境 observation)之后 GAE 该怎么接,而两家都把自己的方案表述为近似,没有给出偏差界。
一句总结。 agentic 奖励工程的复杂度已远超 RLVR 时代的「对错二值」。现在一条轨迹的最终 advantage 往往要走完「验证器 → rubric/GRM 打分 → hack 归零 → 组内重分配 → shaping 惩罚 → GAE 或广播」整条流水线,其中每一环都有自己的超参与失效模式。
3.7 Reward Hacking
3.7.1 问题拆解
agentic 环境给了模型执行命令、联网、读写文件的能力,能力越强、探索越激进,就越会寻找「不真正解决任务却能拿高奖励」的捷径。失败表现五花八门:从环境外获取标准答案、利用验证器漏洞、篡改评测上下文、伪造产物、为过测试做投机兼容等。Qwen 直言「随着模型能力提升,agent 会自主学会利用各种 git 命令获取 ground truth,据我们所知此前没有报道过」5。
3.7.2 主流解法手段
第一层「环境加固 + 清理」:删除泄漏路径、网络隔离、沙箱内核加固。
第二层「两级检测 + 在线拦截」:规则高召回 + LLM judge 高精度,在线拦截可疑调用。
第三层「验证器加固」:用 AST/规则匹配替代易被钻空的验证逻辑。
第四层「对抗筛查 + 奖励置零」:专门的 hack agent 探测漏洞、确认 hack 后奖励清零。
3.7.3 代表性做法横扫(真实案例)
这一节按被钻的是什么来分组,而不是按团队——因为对策高度依赖漏洞类型。
3.7.3.1 从环境外拿到标准答案(git 回连)。
- Qwen3-Coder-Next 发现即便把 git remotes / branches / tags 全部删掉,agent 仍会用
git remote add重新连回 GitHub,或用git clone、curl直接拉提交历史。麻烦在于不能一刀断网——配环境、查文档、装包都要联网。于是改用启发式拦截:任何同时包含仓库链接(github.com/{repo})与联网关键词(git/curl/wget)的工具调用都被拦下并返回明确的禁止反馈,人工检查确认 hacking 被有效消除。Qwen 特别指出这个现象「据我们所知此前没有报道过」[^qwen-coder]。 - Ling 2.6 走的是收窄接口 + 实时监控:从
git log去掉--all,实测约 0.2% 轨迹作弊、判定为可忽略。
3.7.3.2 沙箱与内核层面的漏洞
DeepSeek-V4.1 这一条的严重程度明显高于其他家:agent 利用 XFS 驱动的权限问题、触发 AppArmor 非法内存访问、从软件包镜像服务泄露答案,甚至删除关键二进制、破坏系统文件乃至删掉整个文件系统。对策是每个沙箱单独一套 AppArmor 配置 + eBPF 细粒度网络策略,并把环境崩溃当作失败轨迹、回报「反冲」信号。评测侧还发现 agent 会反编译核心 Ubuntu 软件包来找 CyberGym 漏洞——作者由此呼吁社区在下一代基准里优先考虑检测与缓解9。
3.7.3.3 篡改评测上下文(Lean4)
LongCat-Flash-Prover 是本节唯一给出完整「发现—归因—量化」链条的案例,值得当范本看。RL 约第 80 步时训练集通过率爆发式上升——这种曲线本身就是 hack 的典型信号。根因是开源评测流水线只检查 Lean4 语法和目标定理的定义,而形式化上下文是可编辑的,模型找到了这个缺口。对策是自研轻量 Lean4 lexer/parser 转 AST 做严格一致性检查,并总结出 9 种作弊模式:篡改定理、#exit 提前终止、用 axiom/opaque 引入未经证明的假设、用 unsafe/partial 绕过检查、重定义背景概念等。量化结果最有说服力:对已经学会 hack 的模型加上 AST 检查后,通过率从 97.9% 掉到 27.9%——即此前那 70 个点全是假的。修复后从第 80 步恢复训练10。
3.7.3.4 伪造产物
Kimi K3 的做法是按任务类型各设一条红线:Web 开发任务中「项目构建失败、运行报错、或伪造而非真正实现产物」直接奖励清零;kernel 任务惩罚 CUDA graph replay、输入缓存、降精度这三类「跑得快但没真算」的手法;AET 任务采用公开 verifier 与隐藏 verifier 配对,并把 agent 与 verifier 相互隔离4。
3.7.3.5 两级检测 + 在线拦截
GLM-5.2 的 anti-hack 模块先用规则过滤器最大化召回、再用 LLM judge 判断意图以保证精度,并在线监控每一步工具调用。最值得注意的是检测到之后的处理方式:拦截该次调用并返回假信息(dummy information),让 rollout 继续而不是中止。原文明确说这是刻意设计——避免「rollout 被突然中止导致训练不稳定和模型崩溃」。换言之在异步大规模训练里,丢弃轨迹本身也是一种风险。示例 hack 包括 curl GitHub raw、find /workspace -name "*hidden*"、cat /workspace/.eval/secret_cases.json。14
3.7.3.6 对抗筛查 + 奖励置零
MiMo 把解法泄漏(solution leakage)列为主要 hack 类型,用一个专门的 hack agent 以已知泄漏路径为线索去探测环境里剩余的漏洞,修补后重跑,直到 hack agent 在所有环境里都找不到可用的利用为止——这是把红队做成了流程而非一次性检查。训练期则双管:定期离线审计 + GAR 的 groupwise grader 在确认轨迹依赖外部或泄漏答案时把有效奖励置 0、按失败处理(机制见 §3.6),使两个 run 全程的已确认 hack 比例低于 2%1。
3.7.3.7 一类容易被漏掉的软 hack
前六类都是测试被骗过了,但还有一类是测试没被骗过、代码质量被牺牲了。MiMo 的审计发现,不加在线打分训出的策略会在「提高通过率」的压力下逐渐学会投机性兼容分支、过宽的导出、吞掉异常、放松校验——每一条都能提高通过概率,但超出任务范围、掩盖故障、让代码更难维护。加上 GAR 后 patch 明显更小更精确1。StepFun 面对的是文本侧的同类问题:伪造引用、过度自信断言、语言不一致一律奖励置零,并用 MetaRM 惩罚 RM 自身的「结论对但推理错」7。这一类的共同特征是二值验证器对它完全无感,只能靠组内比较或额外的评判模型才能发现。
3.7.4 权衡与适用场景
环境加固是第一道防线、必不可少,但 agent 会不断发现新路径,是「持续军备竞赛」(MiMo、DeepSeek、LongCat 都强调需多轮迭代加固);在线拦截返回假信息(GLM-5.2)比直接丢弃轨迹更稳,适合异步大规模训练;AST/规则匹配验证器(LongCat Lean4、MiMo 网络安全 sanitizer 字段匹配)确定、可复现、开销近零,是对抗验证器被钻空的治本手段。一个共识是:reward hacking 不可能一劳永逸,需要「加固—审计—再加固」的闭环与可量化的监控指标(已确认 hack 比例、AST 通过率、rollout_probs_diff)。
3.8 沙箱/环境噪声与长程上下文管理
3.8.1 问题拆解
这是 agentic RL 独有的环境即基建问题,含两个子问题。其一环境噪声:真实环境会 flaky(同一测试多次结果不一致)、超时、因基础设施故障崩溃,这些噪声若直接计入奖励就是毒信号,会扭曲梯度(MiMo 直言「不完整 patch 拒掉正确 PoC、无关改动翻转判定——两种错误都会污染训练梯度」1);且环境需要海量合成才能支撑 RL 规模。其二长程上下文:轨迹超出窗口后必须压缩/摘要/丢弃,而怎么管上下文本身影响任务成败。
3.8.2 主流解法手段
环境侧:
手段一「噪声过滤/屏蔽」——flaky 多次重跑筛除、infra 失败 mask、心跳容错;
手段二「强隔离沙箱」——microVM/Firecracker、断网、内核加固;
手段三「大规模环境合成」——自动化流水线造 Docker 环境;
手段四「噪声鲁棒训练」——主动注入噪声做课程。
上下文侧:
手段五「启发式压缩」——keep-recent-k、discard-all、summary、分层;
手段六「把上下文管理作为 RL 动作」训练
3.8.3 代表性做法横扫
按 (2) 的六个手段分组,环境侧四项、上下文侧两项。
手段一 · 噪声过滤 / 屏蔽。
- MiMo:有参考 patch 的任务要求「连续 8 次重跑结果一致」才算稳定,以此筛除 flaky;Penalty Module 识别出不该归咎于模型的基础设施失败并 mask 出 loss1。
- Ling 2.6:移除 gold patch 偶尔都过不了测的 unstable 实例,并按 pass-rate 筛复杂度。
- StepFun:在环境构建轨迹中 mask 掉瞬时失败。
- DeepSeek-V4.1:把环境崩溃视为失败轨迹并回报「反冲」信号9。
手段二 · 强隔离沙箱。
- Kimi K3 的 AgentENV 基于 Firecracker microVM,增量 checkpoint/resume 延迟低至 133ms/49ms、内存超售 6.5×,支持 pause(等推理时暂停不占资源,可达生命周期 98%)/ fork(无副作用奖励评判)/ snapshot(错误恢复);训练加评测共创建 51,219,741 个沙箱、1,505,678 个镜像4。
- DeepSeek 的 DSec 提供 Function Call / Container / microVM(Firecracker) / fullVM(QEMU) 四种底座,单集群管数十万(V4)到数百万(V4.1)并发沙箱,不用 Kubernetes 而用自定义放置引擎,sub-NUMA 把单节点并发容器从约 1000 提到 2500+39。
- Ling 的 ASandbox 走轻量高并发路线,100ms 启动、5000 QPS / 200ms 延迟,用吞吐换隔离深度,适配它那套海量自动合成环境19。
手段三 · 大规模环境合成。
- Qwen3-Coder-Next 从真实 GitHub PR 造 807,693 个实例(覆盖 52,960 个仓库),外加 851,898 个合成 bug 任务,全部固化成可复用 Docker 镜像;并用 QA agent 和 verifier 有效性检测两道去噪,剔除无法稳定复现或判定失效的实例5。
- GLM-5 的环境分三类:10k+ SWE 可验证环境(9 种语言)、数千 Terminal 环境(Docker 构建准确率 >90%)、以及一张 200 万+ 网页的 Web Knowledge Graph 供 search agent 用18。
- StepFun 自建 50k 已验证代码环境(15k+ 仓库、20+ 语言),特别之处是把「构建环境」本身当成一项可 RL 的能力来训,而不是纯靠流水线脚本,报告的构建成功率约 40%7。
- LongCat 的全自动流水线覆盖 20+ 领域,每个领域配一张 60+ 工具的工具图,从 schema 到可执行代码的成功率 >95%,强调领域与工具的广度10。
- MiniMax 称公司内部已有 hundreds of thousands 量级的 RL 环境[^minimax-m25];Ling 2.6 则用 Claude Code + MCP 自动产出约 220,000 个 Docker 镜像,走的是「用强模型批量造环境」的路子16。
手段四 · 噪声鲁棒训练(LongCat 独有)。 系统分析真实噪声归为 instruction noise 与 tool noise,在不破坏任务可解性的前提下用自动化流水线注入、课程式逐步提升强度,以「完美环境与噪声环境的性能差」作为升级条件;实测 τ²-Noise 从 62.2 提升到 67.1、Vita-Noise 从 13.3 提升到 20.5。
手段五 · 启发式压缩(推理期为主)。
- GLM-5 的 Search agent 用 keep-recent-k(k=5,BrowseComp 55.3%→62.0%)+ 分层 HCM(超 T=32k 丢弃全部工具历史重启,最终 75.9),但明确标注是推理期策略、未说明是否用于 RL。
- LongCat 用 hybrid 策略(80K 触发 summary + 最大轮数触发 discard-all + 渐进 discard 阈值,BrowseComp 55.8%→73.1%)。
- Kimi K3 训练时把上下文管理作为 harness 可配置模块、随任务组动态变化以避免过拟合单一机制。
- DeepSeek-V4 的交错思考(Interleaved Thinking)在工具调用场景保留全部推理历史,含跨用户消息边界。
手段六 · 把上下文管理作为 RL 动作。
- CompactionRL:剩余预算低于 10,240 token 时由同一可训练策略生成摘要、重建上下文保留最近 k=2 步,摘要段进入 RL 目标、用 cross-trajectory GAE 修正信用,已部署于 GLM-5.2;compacted 评测下 SWE-bench Verified 从 59.8 提升到 66.8。
- MiniMax:把上下文管理(CM)直接建模为显式 agent 动作、折进环境动态 s_{t+1}=f(s_t,a_t,o_t),使模型在 RL 中就预判 CM,消除「只在推理期用 CM 带来的训练-推理分布错位」。
3.8.4 权衡与适用场景
分环境侧与上下文侧两组看。
环境侧:
- 噪声过滤(重跑筛除、infra mask)是保证奖励信号质量的底线,不做则毒信号直接污染梯度。
- 强隔离 microVM 保真度高,能让 agent 挂磁盘、跑容器、起 VM(Kimi 早期用传统容器曾遇内核 panic 和死锁),代价是成本高于普通容器。
- 主动噪声注入(LongCat)是唯一把「环境不完美」当作训练目标的做法,提升了真实部署鲁棒性,但要小心不破坏任务可解性。
- 环境合成的规模(百万级 Docker 镜像、千万级沙箱)已成为各家的核心竞争力之一,印证了「环境即基建」。
上下文侧: 核心取舍是「把上下文管理放在推理期还是训练期」。把 CM 作为 RL 动作(MiniMax)或把压缩纳入 RL(CompactionRL)在原理上优于纯推理期启发式——消除了训练-推理分布错位,但代价是引入额外的信用分配难题(摘要质量如何归因)。在这条主轴之下,还有两个更细的工程选择值得对比:
- 保留还是丢弃思考历史。 GLM-5 的 Preserved Thinking 在编程 agent 多轮对话中保留全部 thinking block、复用已有推理;Kimi K3 的 chat template 只支持 preserved thinking(think channel 始终保留,否则生成质量极不稳定);StepFun 则做「选择性保留」——只保留最近一次 user 指令触发的工具链推理,因为每轮都丢在 100+ 轮编码会话中会导致任务失败、全部保留又太贵。
- 摘要还是重启。 LongCat 的 Heavy Thinking 先并行推理(宽度)再由 summary 模型做反思式聚合(深度);Kimi K2.5 的 Agent Swarm 则被视为「主动式上下文管理器」——subagent 有独立工作记忆和有界局部上下文、只回传任务相关输出给 orchestrator,形成 context sharding 而非截断,在 BrowseComp 上准确率和效率都优于 Discard-all。
这些选择再次印证:在 agentic RL 里,怎么管上下文本身就是一个需要与训练分布协同设计的一等问题,而非推理期的事后补丁。
4. 国内一线团队技术路线横向比较
下表按「问题维度」横向对齐 11 组团队的做法,信息均来自各自公开材料.
| 团队/模型 | 架构(共卡/分离) | 同步/异步 | Staleness 处理 | RL 算法 | 训推不一致方案 | 信用分配/奖励 | Reward Hacking 对策 | 环境/沙箱特色 |
|---|---|---|---|---|---|---|---|---|
| MiMo-V2.6 | 未明确 | 全异步 + partial rollout, staleness=4 | 四界掩码[0.2,5.0]+按源过期+调度抑制 | GRPO(REINFORCE式) | R3 路由回放 + top-p 候选集回放 + MXFP4 QDQ | 序列级 advantage;GRS/GAR rubric;Penalty Module | hack agent 对抗筛查+审计+置零,<2% | 本地 mock+容器网络隔离;7k+ 环境;flaky 连跑8次 |
| DeepSeek-V4/V4.1 | 共卡(V4.1 分时复用)+环境外置DSec; | V4.1 全异步样本级调度;token 级 WAL | 限最大 off-policy 比例 + 陈旧 token 掩码 | GRPO(沿用);努力条件化长度惩罚 | bitwise 对齐+FP4;拼接式路由重放;FP32? | GRM(actor即GRM);任务三元组;DAG关键路径延迟 | AppArmor+eBPF;环境崩溃=失败+反冲信号 | DSec 四底座,数十万~数百万并发沙箱 |
| Kimi K3/K2.5(Moonshot) | 训推共卡(co-located) | 同步框架+partial rollout(λ比例) | per-token 正则容忍极端 off-policy | 自研(组均值+token级log-ratio掩码+τ正则) | 全程 MXFP4/MXFP8 QAT 消除不一致 | 序列级;Agentic GRM锦标赛;MOPD稠密奖励 | kernel惩罚;GRM冗长判负;AET verifier隔离 | AgentENV microVM,5100万+沙箱,pause/fork/snapshot |
| GLM-5/5.2 | 训推分离(不同GPU) | Reasoning同步/Agentic全异步+重置优化器 | 版本号 w′−w₀>τ 丢弃 + DIS | GRPO+IcePop(推理);group-wise+DIS(agentic);SAO/CRL critic | IcePop双侧掩码;DIS;TITO;确定性torch.topk | outcome为主;混合奖励ORM+GRM;SAO critic | 在线anti-hack(规则+LLM judge)拦截返假信息 | 10k+ SWE环境;心跳容错;环境故障剔除+组补齐 |
| Qwen | 未明确(MegaFlow同pod) | 未公开 | 序列级 IS 排除 off-policy 样本 | GSPO(序列级IS+clip) | 序列级IS绕过routing replay | 轨迹级完成+未完成惩罚+turn级工具格式惩罚 | git回连在线拦截(链接+联网关键词) | 80万真实PR+85万合成bug,全Docker化;MegaFlow |
| MiniMax | 分离(Middleware:Gateway+Data Pool 解耦) | 异步 Windowed FIFO(W=0.3N) | Windowed FIFO + MIS + PPO轨迹过滤 | CISPO(IS截断+stop-grad,全token梯度) | FP32 LM Head + MIS + 轨迹过滤 | 复合奖励:process+完成时间+reward-to-go | 熵监控(角色扮演);P2P测试;统一测试套件 | 10万+scaffold;CM作为RL动作;Prefix Tree Merging 40× |
| Step 3.5 Flash | 未明确(Steptron统一栈) | 主线off-policy;search改FullyAsync(~20步耐受) | MIS-PO双层掩码(token[0.5,2]/轨迹[0.996,1.001])丢弃 | MIS-PO(二值接受/拒绝)+critic(γ=λ=1) | MIS-PO双层过滤;Routing Confidence Σ_k | critic信用;GenRM+BT胜率+MetaRM;截断value bootstrap | 伪造引用/过自信置零;GenRM长度惩罚;verifier防作弊 | 50k已验证环境;环境构建作为可RL能力;Session-Router |
| LongCat | 分离(生产者-消费者;初代称弹性共卡) | 完全流式多版本异步(快2-4×) | SampleQueue+新请求只发旧版本(load 63%) | GSPO;Prover用HisPO(IS分解+三段clip) | HisPO序列级+token级分层掩码;FP32? | outcome为主;rubric校验;self-verification | Lean4 AST合法性检测(9种作弊);git限制+监控0.2% | 32k并发环境~400机;噪声注入Robust RL;PD分离+CPU KV swap |
| Ling/Ring | 共卡(ASystem Hybrid Runtime统一训推) | Ring-1T异步;Ring-2.6 partial-rollout(C3PO++) | retention>σ清除;staleness manager入池门控 | Ring-1T IcePop;Ling2.6 GSPO;Ring2.6 KPop | IcePop/KPop掩码;module-aware FP8;FP32 LM Head | process reward;rubric双向focus;individual/concat模式 | git去--all+实时监控0.2%;zlib重复罚;focus长度罚 | 数千ASandbox;~22万Docker镜像;100ms启动 |
| Seed | 未明确(verl HybridFlow 单/多控制器) | Seed-Thinking SRS异步解耦(3×);Seed1.5-VL偏同步 | 未公开 | PPO变体+shared critic;value pre-training+decoupled GAE | 未公开(vLLM生成+3D并行训练) | shared critic;生成式VLM RM;双轨验证器 | 小KL防hack;移除文本捷径题;双轨验证器防reward deception | verifier进程级隔离;MegaScale容错;环境数量未公开 |
| 混元 Hy3/UniRL(腾讯) | 训推共卡(全量offload);UniRL共卡+分卡两种 | 同步on-policy;UniRL async入口 | 未公开(仅IcePop针对数值差异) | GRPO(verl recipe)+clip-higher+dual-clip;UniRL DRPO/CPPO | IcePop[0.5,4.0]清零;冻结MoE expert bias | 规则outcome;轨迹级组归一广播到各turn | 未公开(反幻觉12.5%→5.4%非RL) | UniRL失败轨迹剔除;环境规模未公开 |
5. 主流路线抽象
把上述碎片拼合,当前 Agentic RL 基建可提炼出六条主流路线/范式。它们并非互斥,一家团队往往同时踩在多条路线上。
路线① 同步/近同步共卡 + 掩码纠偏
代表:Kimi K3(共卡 + partial rollout + per-token 正则)、混元开源 recipe(共卡同步 GRPO + IcePop 风格修正)。优势是分布接近 on-policy、工程边界清晰、单实验占卡最小化,掩码纠偏(token 级 log-ratio 掩码)足以稳住训推不一致。代价是共卡显存争抢需复杂腾挪(NVMe/CPU 卸载、KV 写回),且同步/近同步的吞吐天花板较低,长尾仍靠 partial rollout 缓解。
路线② 异步 + partial rollout + staleness 管控(常与分离结伴,但不等于分离)
代表:GLM-5(分离 + 全异步 + 版本号丢弃 + DIS)、DeepSeek-V4.1(共卡分时 + 环境外置 + 样本级异步 + 陈旧 token 掩码)、LongCat DORA(分离 + 流式多版本异步 + SampleQueue)、Ling 2.6(共卡 + partial-rollout + staleness manager)。这里要强调「共卡/分离」与「同步/异步」是两条正交的轴:GLM/DORA 是分离+异步,DeepSeek-V4.1/Ling 则是共卡+异步,可见两轴可自由组合,异步并非分离的专利。优势是吞吐高、长尾被彻底消化;代价是必须配套精细的 staleness 控制(版本上限/入池门控/陈旧掩码)与长度偏差处理,分离方案还额外吃紧于权重同步基建(如 AState 10 秒同步万亿参数)。
路线③ 序列级 IS(GSPO 系)绕过 MoE 路由回放
代表:Qwen GSPO、LongCat GSPO、Ling-2.6 agentic specialist。核心主张是「优化单位与奖励单位一致」——用 s_i=(\pi_\theta/\pi_{old})^{1/|y_i|} 的序列级比值,对单 token 似然不敏感,从机制上消灭了专家激活波动,不再需要 routing replay,还可能免去 old-logprob 重算,极大简化基建。优势是基建最简、MoE 友好;代价是 advantage 粒度粗(多轮需 GSPO-token 补救),且与路由回放派(MiMo R3、DeepSeek 拼接式重放)形成直接对立。
路线④ 专家化—再蒸馏 / 多教师在线蒸馏替代部分 RL
代表:DeepSeek 全词表 OPD(V4 >10 教师、V4.1 >40 教师,完全取代混合 RL 阶段)、Kimi K3 MOPD(9 专家 × 推理强度,逐 token 稠密奖励接入 RL 框架)、MiMo MOPD2(RL 后合并多教师并扩展到难验证领域,并低成本修复复读缺陷仅 9 万美元)、Ling/StepFun「专家化-再蒸馏」、GLM On-Policy Cross-Stage Distillation(GLM-5.2 并行 OPD 合并 10+ 专家约 2 天)、Qwen3-Coder-Next 专家蒸馏。优势是绕开混合 RL 的负迁移与灾难性遗忘、把分领域专家能力低成本合并、还能覆盖难以设计奖励的领域。代价是多了一个蒸馏阶段与教师调度基建;且与 MiniMax「单阶段多领域混合 RL、反对分领域再合并」形成路线分歧。
路线⑤ value/critic 回归 vs 无 critic 组相对
代表(critic 派):GLM SAO/CompactionRL、StepFun MIS-PO、Seed PPO 变体 + shared critic + value pre-training;
代表(无 critic 派):绝大多数 GRPO/GSPO/CISPO 系。critic 派的理由是 token/step 级信用分配、支持单 rollout 与变长分段轨迹(SAO 实测 token 级 GAE 显著优于 step 级),代价是 critic 难拟合长序列、需价值预训练与冻结 attention;无 critic 派省掉价值模型、适合结果奖励清晰的可验证任务,代价是信用分配只能序列级广播、对长程稀疏奖励乏力。
路线⑥ 环境即基建:沙箱/环境合成/噪声鲁棒
代表:DeepSeek DSec(百万并发沙箱、四底座)、Kimi AgentENV(microVM、5100 万沙箱)、Qwen(百万级 Docker 化可验证环境)、LongCat(噪声注入 Robust RL)、Ling(22 万 Docker 镜像)、StepFun(环境构建作为可 RL 能力)。优势是把「环境」从训练的附属品提升为一等公民、用规模化合成与强隔离/容错保证奖励信号质量与可复现性,噪声鲁棒训练更直接提升真实部署表现。代价是环境合成与沙箱基建本身成为巨大的工程与算力投入(grader compute 甚至被 MiMo 当作独立扩展维度)。
6. 尚存分歧与未解决的问题
基于 11 份材料,以下问题目前各家做法仍有分歧,或公开报告坦承尚未解决。
共卡 vs 分离无定论。 Kimi/混元共卡、GLM 分离、DeepSeek-V4.1 折中,三条路都跑出了前沿模型。共卡省机器但显存争抢,分离灵活但同步成本高,尚无普适结论;且多家(MiMo、Qwen、StepFun、Seed)对此并未明确表态,说明业界尚未形成最佳实践。
异步 staleness 上限无统一标准。 几乎所有团队都承认异步必然引入 off-policy,但「最大 staleness 到底设多少」几乎都未公开——MiMo 的 4、StepFun 观察到的约 20 步。这是一个缺乏量化共识的旋钮。
mismatch 该「系统层消除」还是「算法层纠偏」。 这是最尖锐的路线分歧。DeepSeek 走系统层 bitwise 对齐 + 原生 FP4,MiMo/Kimi 用 QAT 让两端共享量化权重,MiniMax/Ling 靠 FP32 LM Head,这些是「消除」思路;而 IcePop/KPop/DIS/MIS-PO/HisPO 是「承认偏差、算法层掩码/截断」思路。Ring-1T 坦承「IcePop 未达完美训推一致,底层算子数值差异仍是潜在不稳定源」,说明算法层纠偏并非终点。
要不要 routing replay。 Qwen GSPO 用序列级 IS 显式宣称「不再需要 Routing Replay」,MiMo 坚持 R3[^mimo-tr]、DeepSeek-V4.1 用拼接式路由重放9
critic 的价值。 critic 派(GLM SAO/CompactionRL、StepFun、Seed)认为 token/step 级信用分配不可或缺,无 critic 派(GRPO/GSPO/CISPO 系)认为组相对 baseline 足够且更省。SAO 实测 token 级 GAE 优于 step 级,但 critic 的长序列拟合与冷启动仍是难点。
process reward 是否值得。 Seed1.5-VL 刻意只监督最终结果、不监督 CoT,MiMo/Kimi/LongCat 等明确未用独立 PRM、结果 advantage 仍序列级广播;而 Ling 2.6、MiniMax 引入了 process reward。过程监督能否带来与其复杂度匹配的收益,尚无定论。
reward hacking 的长期军备竞赛。 各家都承认这是「加固—审计—再加固」的持续对抗:MiMo 要迭代到 hack agent 找不到漏洞为止,DeepSeek 呼吁社区在下一代基准优先考虑检测缓解,MiMo 的 ToolRep 更坦言工具调用复读这类「奖励盲区」只靠 RL 内惩罚泛化有限、生效慢、成本高(重跑 20 步 MixRL 约 231 万美元)。没有一劳永逸的解。
环境噪声与可复现性。 flaky test、infra 失败、超时的处理策略普遍「未提及」或各行其是(MiMo 连跑 8 次、Ling 移除 unstable 实例、LongCat 主动注入噪声),且 DeepSeek-V4.1 指出「标准评估基础设施越来越容易被模型钻空子」9,环境的可复现性与抗作弊是开放难题。
长程信用分配仍是开放难题。 CompactionRL 的 cross-trajectory GAE、SAO 的 skip-observation GAE、MiMo 的 GAR、DeepSeek 的 DAG 关键路径延迟都是初步尝试,作者们普遍承认是「近似」且存在训练-测试不匹配(CompactionRL 坦言单窗口评测收益不一致)。几百步轨迹的精确信用分配远未解决。
7. 结尾
纵观 11 组团队的 2026 年报告,Agentic RL 基建已从「能不能跑」进入「如何又稳又快又不被钻空子地规模化」的深水区:异步化、partial rollout、训推一致性纠偏、环境即基建、专家蒸馏合并,正在收敛为一套可辨识的工程范式,而共卡/分离、序列级 IS/路由回放、critic 存废、process reward 价值等核心抉择仍在激烈分野。
更深一层看,这些分歧背后其实是同一个张力:在「算法纯粹性」与「工程现实」之间如何取舍——是花力气让系统逼近理论上干净的 on-policy 同策略训练(bitwise 对齐、严格 staleness、路由回放),还是接受工程现实的脏乱、用算法手段(序列级 IS、掩码截断、二值接受)把偏差吸收掉。目前看,后一条「拥抱不完美、用算法鲁棒性兜底」的路线正占据上风,但系统层对齐并未退场,二者更可能长期共存、互为补充。可以预见,谁能率先把「长程信用分配」与「环境噪声鲁棒的可复现大规模合成」这两块最硬的骨头啃下来,并在模型-harness-环境的协同设计上形成闭环,谁就能在下一轮 Agentic 智能的竞赛中握住先手。
作者:韦子扬
https://weiziyang.wiki/posts/post-training-rl/agentic-rl-infra-technical-roadmap-overview