作者:苏浩阳,复旦大学Ph.D
Claude Code、Codex 让我们看到了编程智能体的潜力,也让一个训练问题变得更加具体:当模型能够连续执行命令、修改文件并根据反馈修正策略时,强化学习如何充分利用这些交互经验?任务最终是否成功提供了监督,但一条轨迹中包含的动作结构与决策差异,远比一个最终分数丰富。
复旦大学、上海交通大学联合上海创智学院提出 A3(Action Advantage Assignment),面向 Command line interface (CLI) 智能体,利用 shell 命令的程序结构细化多轮信用分配。
相关论文 Learning CLI Agents with Structured Action Credit under Selective Observation 已被 NeurIPS 2026 接收。
论文标题:Learning CLI Agents with Structured Action Credit under Selective Observation
论文:https://arxiv.org/abs/2605.08013
代码:https://github.com/Hoyant-Su/Agentic-RL-A3
数据:https://huggingface.co/datasets/Hoyant-Su/ShellOps
模型:https://huggingface.co/Hoyant-Su/A3-Qwen3-14B
论文探讨的是agentic RL中的核心问题:关于如何做advantage的细粒度分配。 A3在实现中,从动作结构中构造轨迹、轮次和树结构三个层级的advantage信号,将最终reward用于更细粒度的策略更新。
同时,研究提出 σ-Reveal,在有限上下文预算内筛选任务相关的工作区观测,从初始信息获取与训练反馈两个环节改善智能体的任务执行能力。
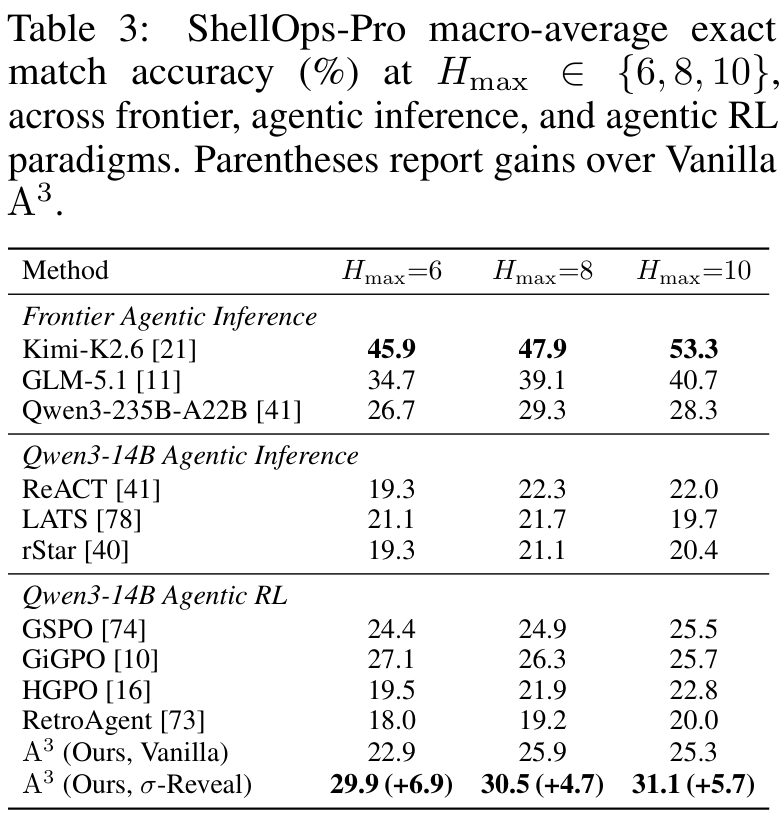
基于 Qwen3-14B,A3 配合 σ-Reveal 将 ShellOps 混合任务的精确匹配率(Exact Match,EM)从最佳对比基线的 11.3% 提升至 24.6%,达到两倍以上;在更具挑战性的分布外评测 ShellOps-Pro 中,以 31.1% 的 EM 超过总参数量约为其 17 倍的 Qwen3-235B-A22B(28.3%)。
这意味着,14B 模型通过结构化信用分配训练与工作区观测筛选,能在未见过的复杂任务中超越大规模模型。与此同时,A3 的advantage计算开销相对经典agentic RL训练方法保持在更轻量级。
01:一个最终奖励,能解释多少步决策?
CLI 智能体的决策依赖于动态工作区中的局部观测。任务相关信息可能分布在目录结构、文件内容、程序输出与中间产物中,而策略每一轮只能利用已经进入上下文的证据。工作区真实状态与策略观测之间的差异,使初始上下文构建成为影响探索与执行的重要因素。
与此同时,轨迹级reward概括的是整条交互轨迹的结果。检索、变换、编辑与验证等操作在轨迹中承担不同作用,直接以整段轨迹的相对reward指导所有轮次,难以充分利用这些动作之间的结构差异。
部分agentic RL通过重复状态锚定或观测分组细化advantage估计。然而,CLI 环境的文件状态与文本观测具有较高多样性,相同任务下的不同采样轨迹也可能形成不同的执行历史。这会削弱重复状态作为归一化依据的适用性。
A3 关注的是另一个可利用的信息来源:CLI 动作本身具有可解析的程序结构。控制流、命令动词与参数组织为跨轨迹比较提供了动作空间表示。研究据此将 shell 语法纳入advantage构造,并通过工作区观测筛选补充策略的初始信息条件。
02:Command line 结构里,还有未被充分利用的学习线索
Shell 命令可以表示为抽象语法树(Abstract Syntax Tree,AST)。A3 使用 Tree-sitter 解析 Bash 动作,通过确定性遍历,将控制结构、规范化命令动词与归一化后的字面量转化为 AST signature,再使用归一化编辑距离衡量 AST signature 之间的差异。
这一表示支持对单步动作与多步动作子链进行统一比较。在同一任务的同组采样轨迹中,A3 据此组织reward统计,构造三个互补的advantage分量。
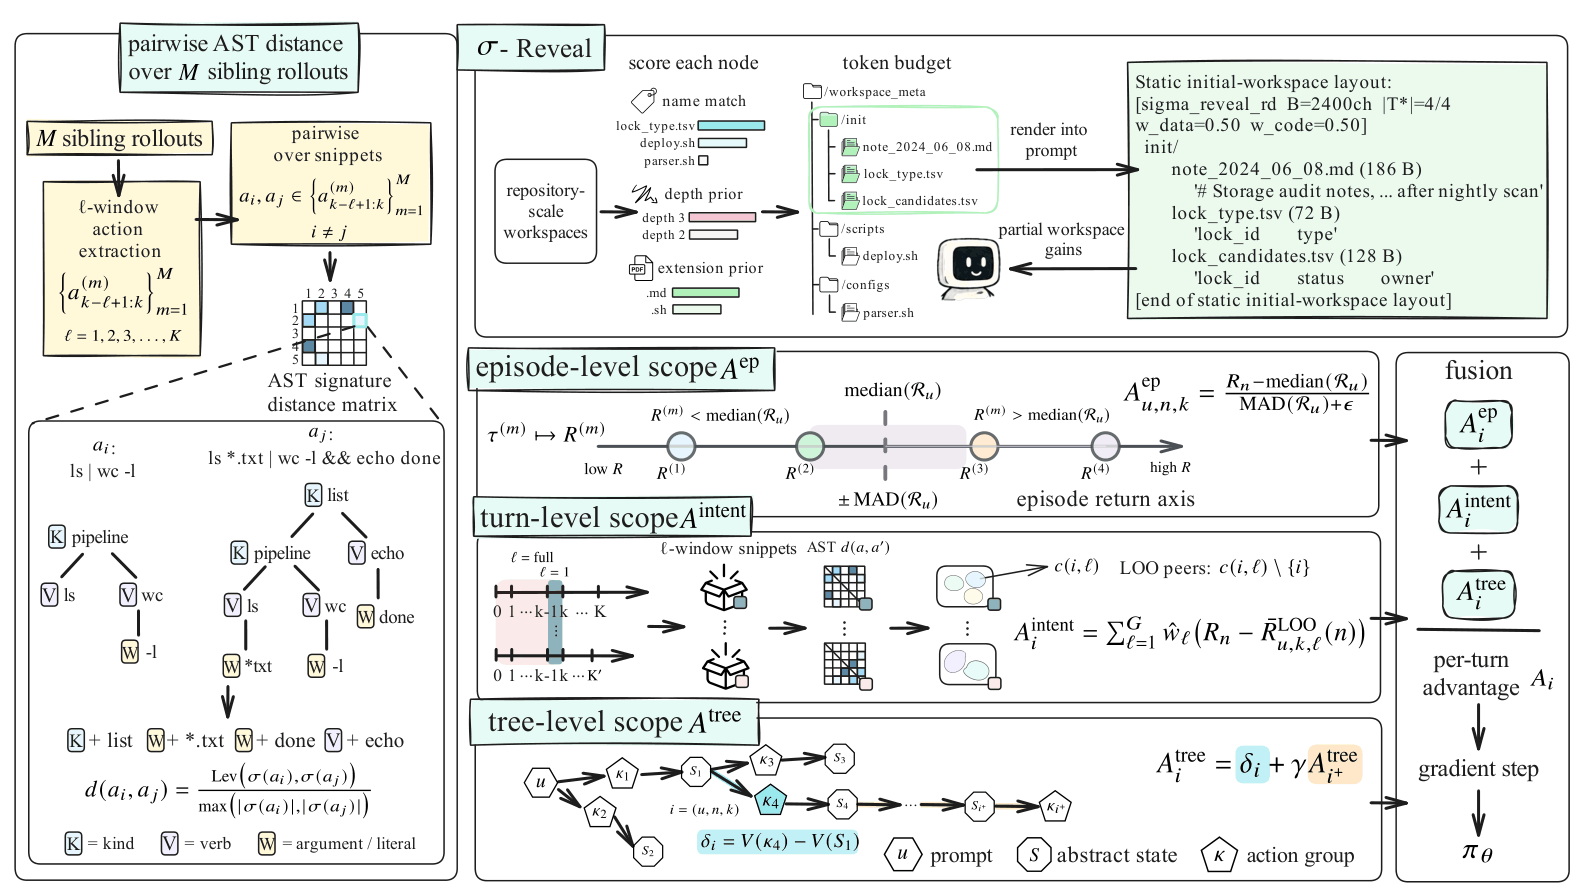
A3 在轨迹级基础advantage的构建上继承了 GSPO 的方法。这一分量保留任务级结果监督,衡量同一任务提示下当前采样轨迹相对于同组轨迹的整体表现。
在此基础上,A3 引入轮次级动作子链残差。在同一任务、同一轮次下,根据不同长度动作子链的 AST signature 距离进行分组。每个分组内,以其他轨迹的留一平均reward为参照,计算当前轨迹的reward残差,并对不同子链范围的残差进行加权聚合。
这一设计将最终reward与局部动作结构联系起来:执行相近命令片段的轨迹构成可比较的统计集合,多种片段长度则提供不同时间尺度上的行为信息。得到的残差为每轮更新补充了轨迹级基础advantage之外的结构条件信号。
A3 还通过树结构advantage比较相近执行历史下的不同分支。方法利用历次动作的分组标签构建抽象交互历史,基于历史标签的时间加权汉明距离,将相近交互历史归入抽象状态,再对当前动作分支进行分组。
抽象状态的价值由到达该状态的采样轨迹平均reward估计,分支价值由选择该动作分支的采样轨迹平均reward估计。二者之差形成局部分支价值差,并沿轨迹折扣累积为树结构advantage。对于样本支持较少的分组,方法通过基于组内样本量的衰减降低该信号的影响。
三个分量经过尺度对齐、加权和有界变换,形成逐轮advantage,并用于序列级策略优化。整个advantage构造过程复用已有采样轨迹的reward与动作信息,无需额外训练价值模型,也无需调用外部大语言模型逐步评判动作。
与训练阶段的信用分配相配合,σ-Reveal 在推理阶段构建任务相关的初始工作区观测。它将上下文选择表达为文件树上的预算约束优化问题:在上下文呈现成本不超过预算的条件下,选择累计相关性得分较高、并保留目录依赖关系的节点集合。这一机制为策略提供轻量级工作区先验。
03:答案正确,文件却可能改错
CLI 智能体的能力体现在对工作区的实际操作中。尤其在跨文件任务中,正确的最终回答并不足以说明任务已经完成:要求修改的文件是否全部更新,生成的内容是否满足约束,同样决定了执行结果。因此,研究多轮交互能力,需要将文本答案与文件状态共同纳入评测。
基于这一需求,研究人员提出了 ShellOps, 这一数据集将信息查找、跨文件聚合和文件编辑组织为可执行的工作区任务,并为每项任务提供初始文件环境与参考结果。任务分别考察文本输出、文件修改,以及二者的联合正确性,使模型的每次交互最终都能通过执行结果得到检验。
数据集进一步区分了基础能力学习与复杂任务泛化两个层次。ShellOps 标准语料包含 1,624 项简单任务;ShellOps-Pro 则以 150 项更具挑战性的分布外任务,检验同一策略在更复杂工作区中的表现。
后者合计包含 4,063 个文件,平均每项任务约 27.1 个,涵盖配置、结构化数据、日志、代码与文本等类型。这样的设置将评估延伸到更复杂的文件组织与操作要求,考察模型能否迁移已有的检索和执行能力。
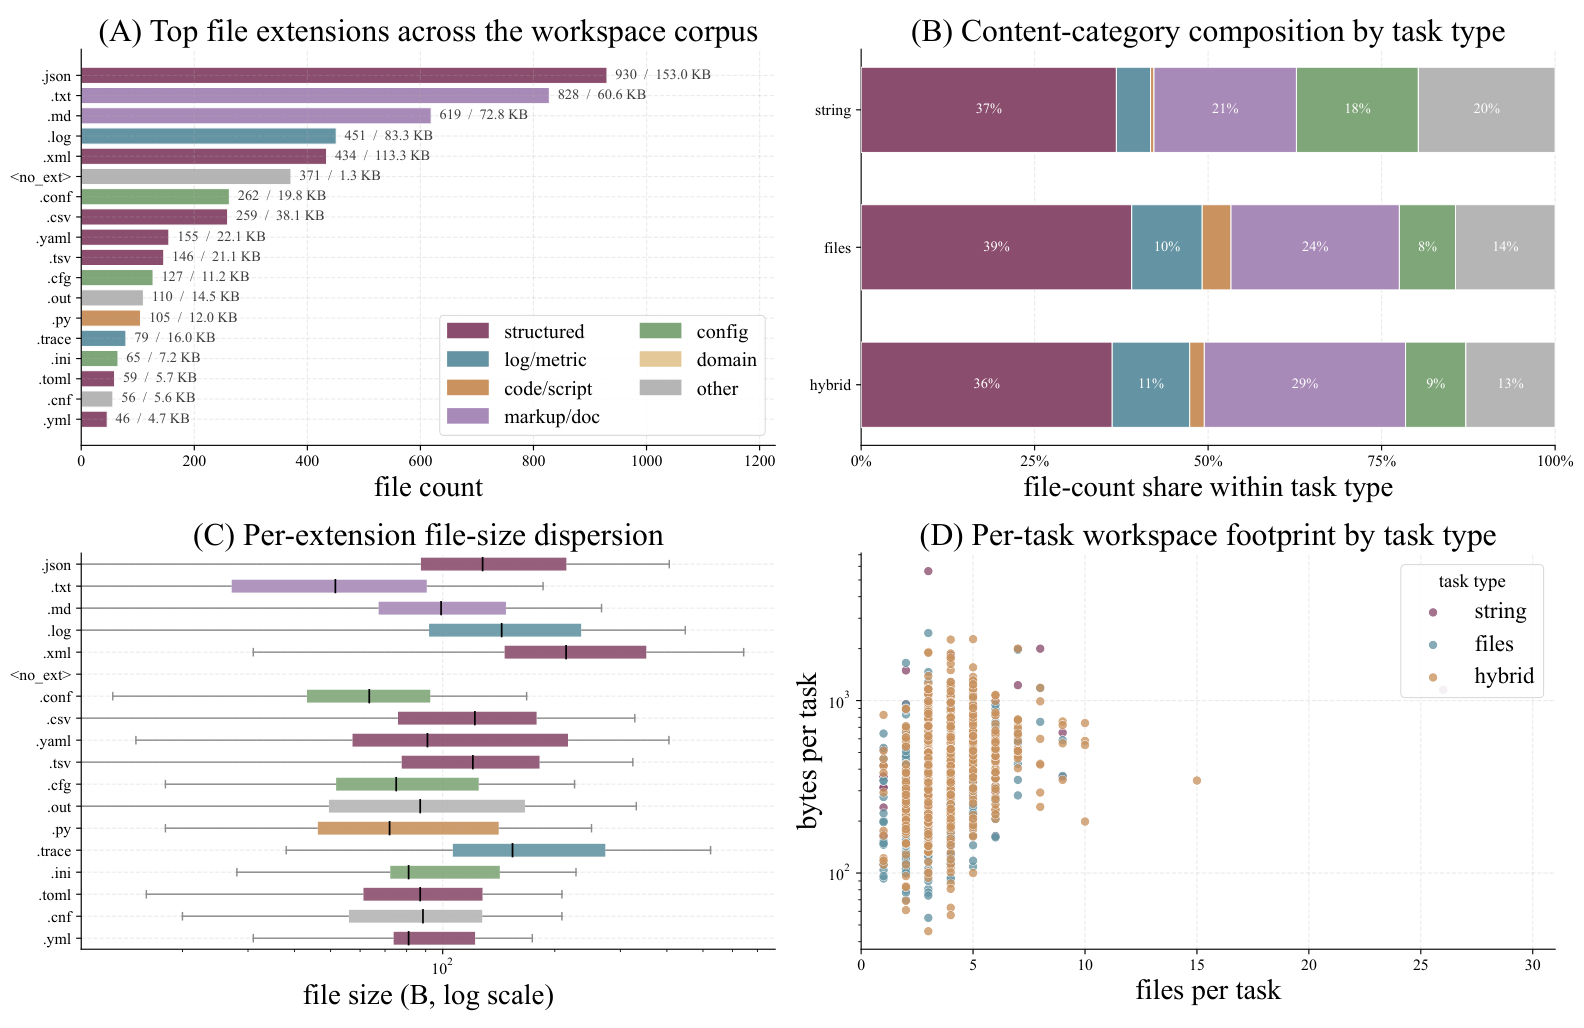
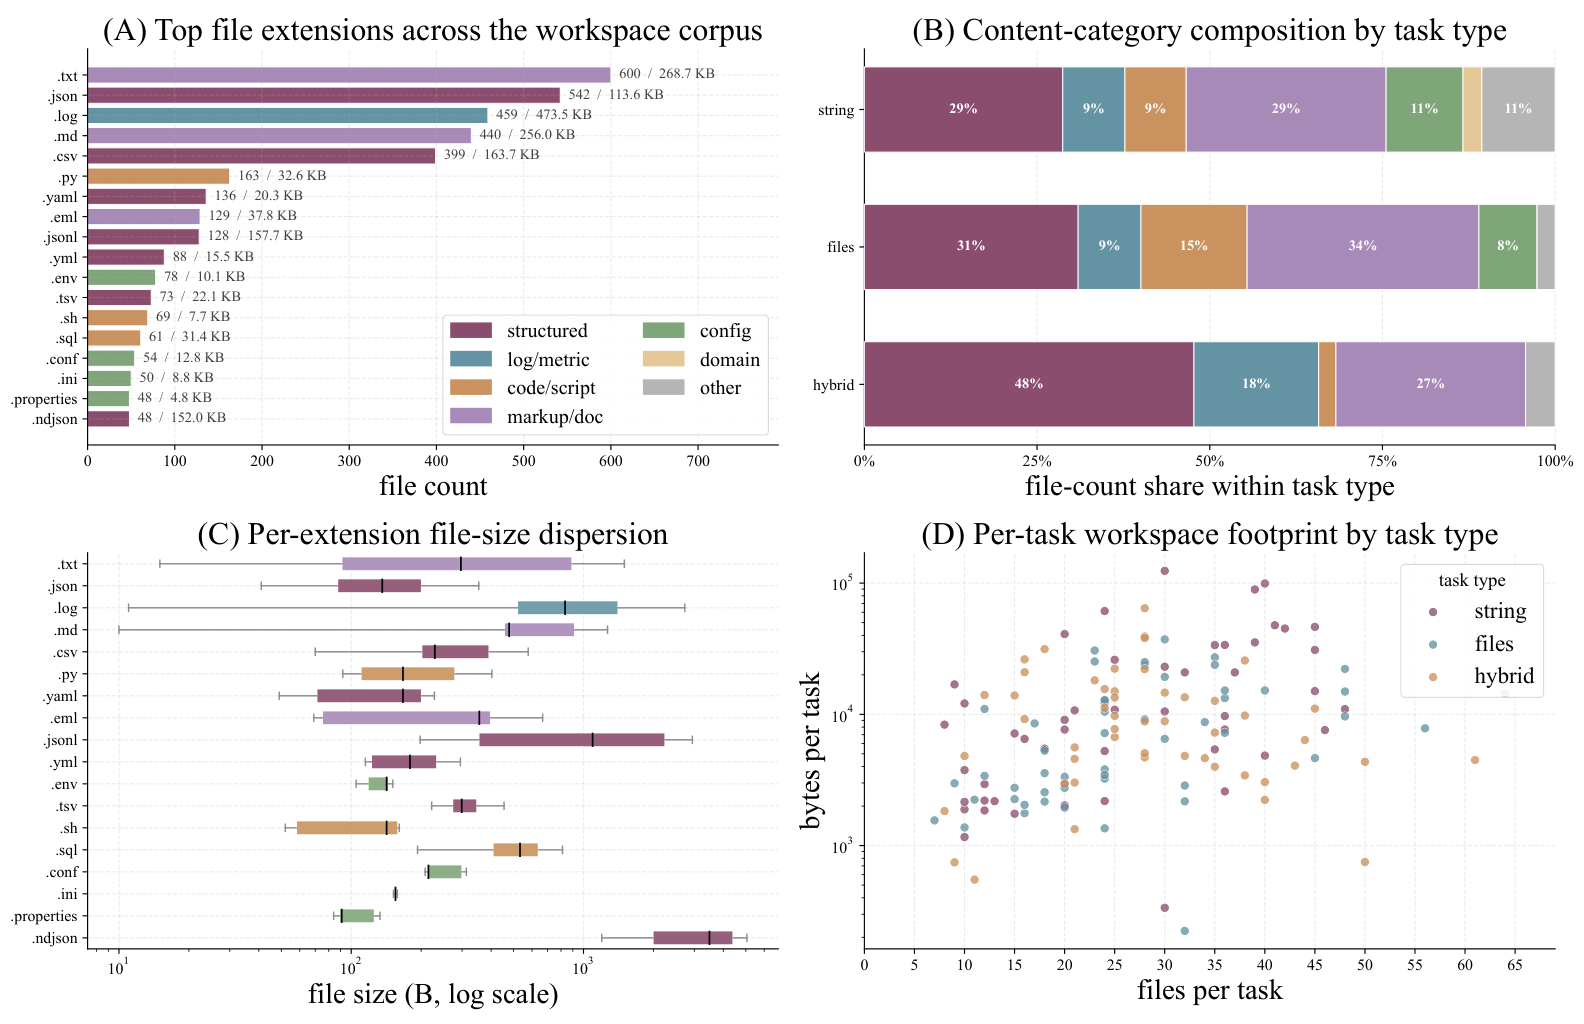
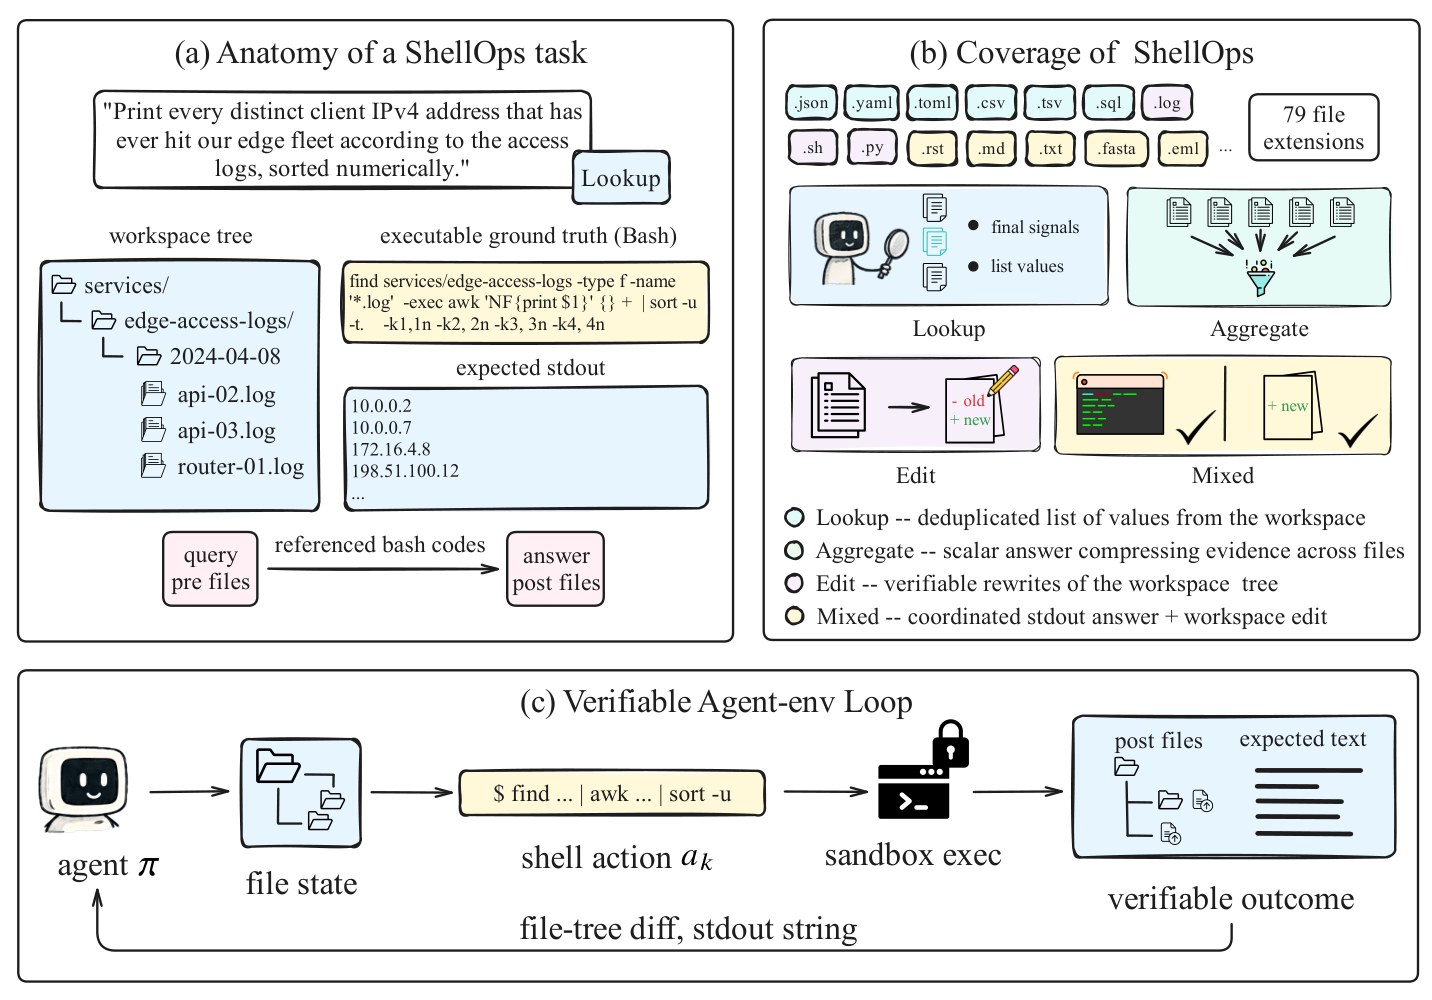
评估区分 String、Files 与 Hybrid 三种任务类型,分别关注文本结果、文件状态,以及二者的联合正确性。
除 ShellOps 外,实验还覆盖 AgentBench-OS、AgentBench-DB、DataBench、EHRCon 与 TableBench。这些任务来源分别涉及操作系统交互、数据库操作、表格问答与事实一致性检查,共同构成六个评估任务流。
04:混合任务准确率翻倍,advantage计算仍保持低开销
主要实验以 Qwen3-14B 为策略模型。A3、GSPO、GiGPO、HGPO 与 RetroAgent 在相同训练配置下比较;ReACT、LATS 与 rStar 作为智能体推理基线参与评估。
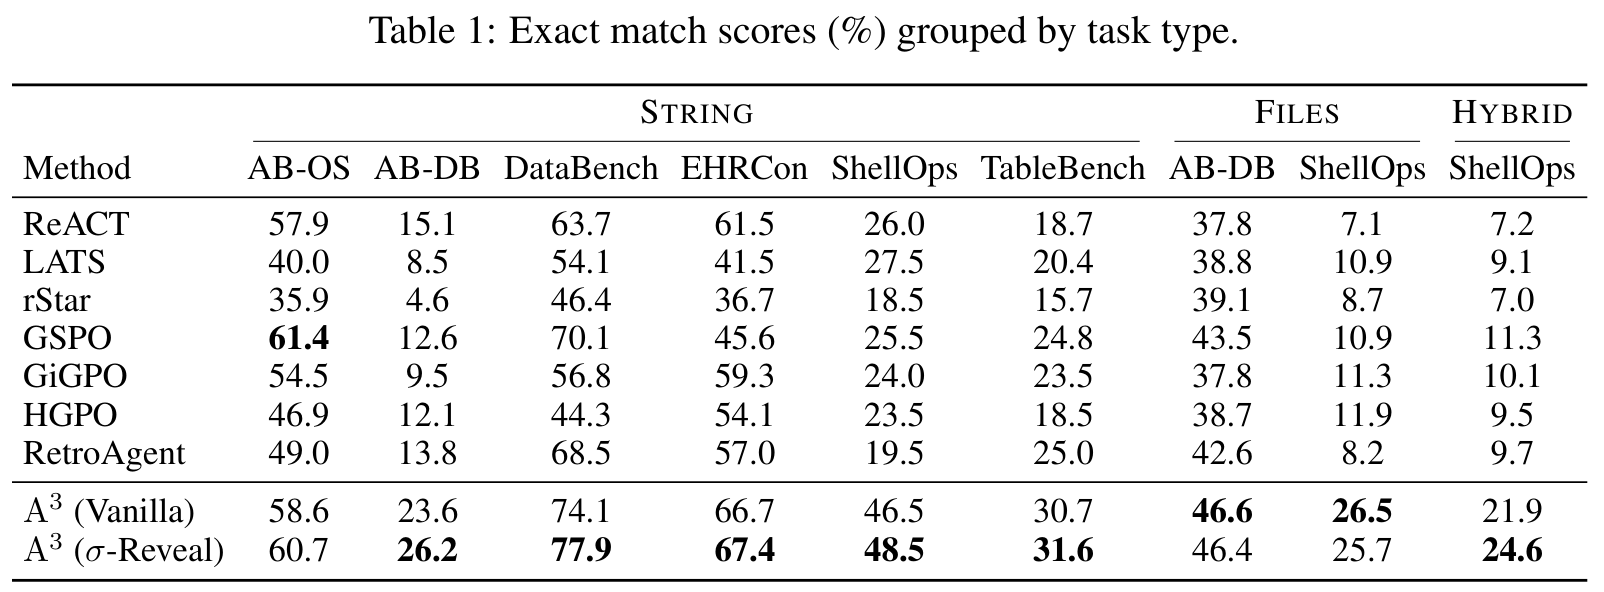
A3 在 ShellOps 三类任务上全面领先对比基线。结合 σ-Reveal,混合任务准确率从最佳基线的 11.3% 跃升至 24.6%,提升超过一倍,ShellOps Pass@5 也接近翻倍。
面对更复杂的分布外任务,14B 模型同样展现出越级竞争力:无需额外训练,A3 配合 σ-Reveal 在 ShellOps-Pro 上超过总参数量约为其 17 倍的 Qwen3-235B-A22B。
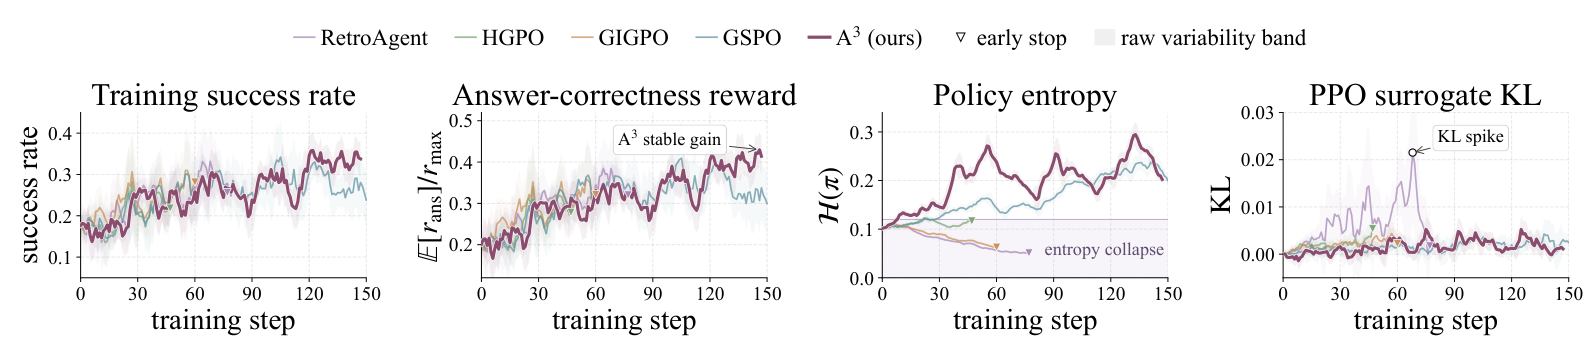
训练动态显示,在匹配的数据和采样轨迹设置下,A3 的任务成功率与答案奖励持续提升, KL 保持相对稳定。这些曲线反映了训练过程中的策略优化动态。
动作结构究竟有多重要?移除轮次级与树结构信用分配后,混合任务准确率直接从 21.9% 降至 10.9%,几乎减半。更细粒度的学习信号,也没有带来高昂的计算成本:A3 的advantage计算仅耗时 0.023 秒,与 GSPO 保持同一量级。
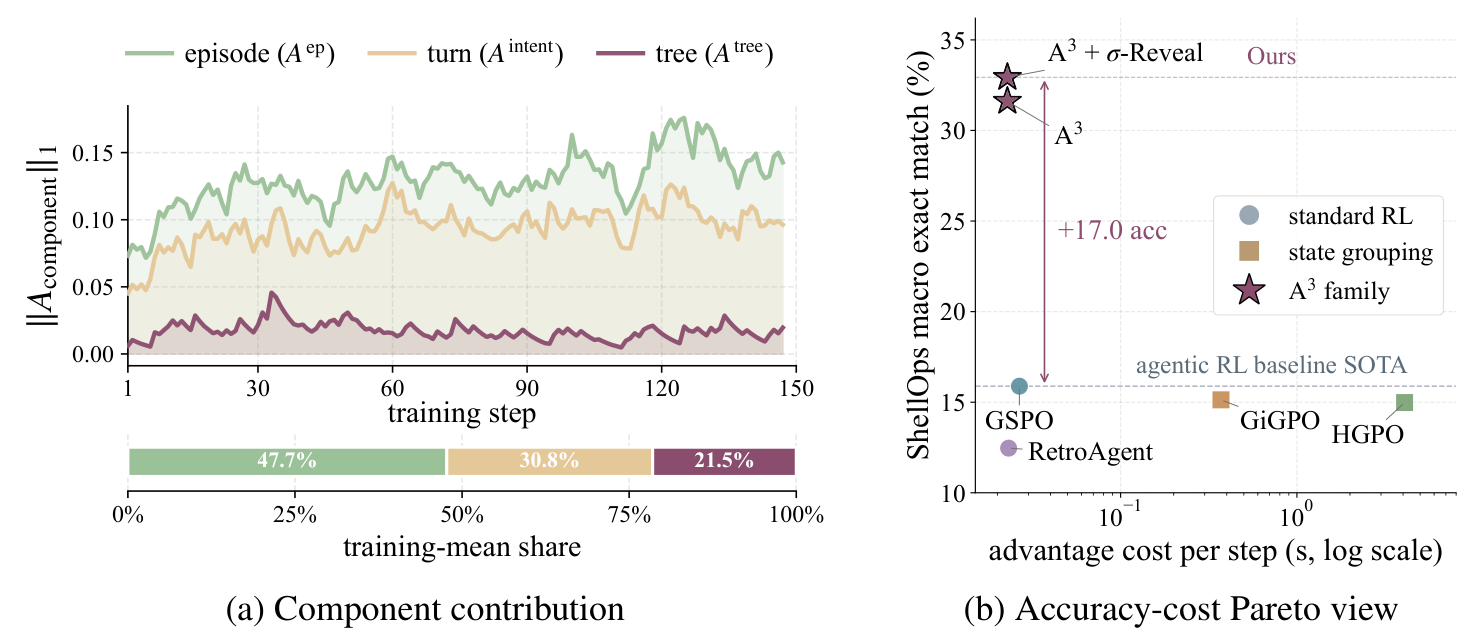
σ-Reveal 的成本主要体现在推理输入:平均每轮输入由约 0.99K tokens 增至 1.11K tokens,平均交互轮数由 4.33 降至 4.18。这呈现了初始工作区证据、上下文开销与交互过程之间的实际权衡。
05:智能体的下一步,藏在交互细节中
A3 展示了智能体能力跃升的另一条路径:让模型从交互过程中学得更充分。通过挖掘命令结构中的信用分配线索,14B 模型在复杂任务中实现了准确率翻倍,更在分布外评测中超越 235B 模型,展现出训练方法突破参数规模差距的潜力。
这一结果为 Agentic RL 带来了更广阔的想象空间:智能体执行的每一步操作,都蕴含着值得利用的学习信号。如何将这些信号转化为决策能力,将成为推动智能体走向复杂、长程任务的重要方向。A3 连同开放的 ShellOps 系列数据集,为这一方向提供了方法与实验基础。