本文介绍中国科学院大学人工智能学院、清华大学车辆与运载学院与蚂蚁集团联合完成的最新研究成果《Object-Uni: A Unified Model for Object-Centric Spatial Understanding and Controllable Generation》。论文由谭米宁、王以诺等完成,通讯作者为中国科学院自动化研究所董未名教授。
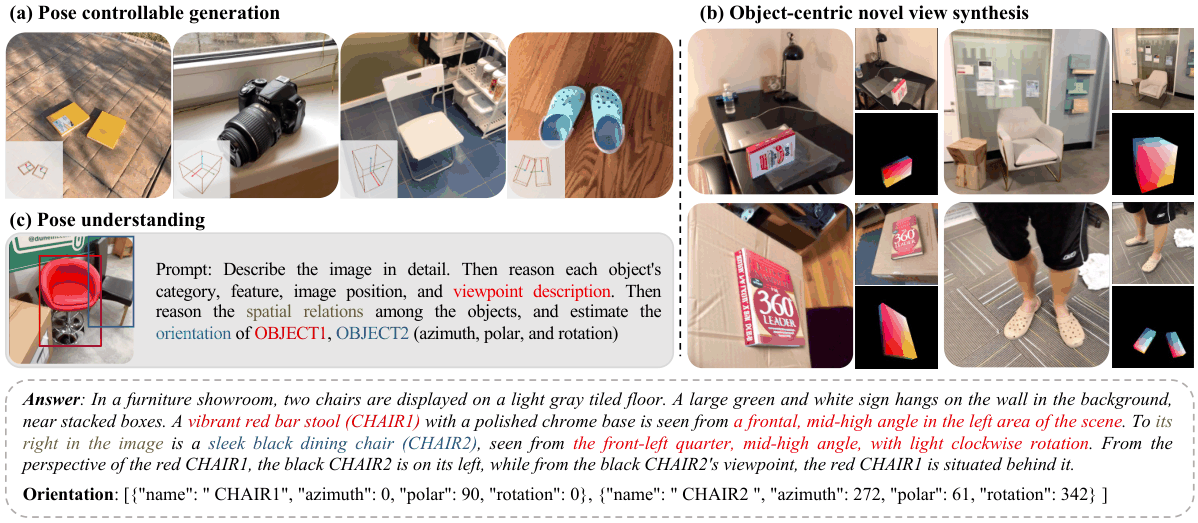
该研究提出 Object-Uni——一个面向物体级空间理解与可控生成的统一模型。它把物体姿态当作理解与生成共享的显式几何变量,在同一个框架内完成物体朝向估计、空间关系推理、姿态可控的文生图,以及物体级新视角合成。
arXiv:https://arxiv.org/abs/2608.22757
一、统一模型的"空间盲区"
近两年,视觉理解与生成的统一模型发展迅速。从 Chameleon、Janus、Show-o 到 Ming-Lite-Uni,同一个模型已经可以看图说话、回答视觉问题、生成和编辑图像,视觉智能正在从"看懂图像"走向"看懂并生成视觉世界"。
但真实世界的视觉智能不止于认出"图里有什么"。一个模型还应当知道:每个物体在哪里、朝向哪边,以及换一个视角之后它应该长什么样。论文将这种能力称为物体级空间智能(object-centric spatial intelligence)。
现有方法在这件事上存在两个明显短板:
第一,语言描述缺少几何约束。 当前模型通常用自由文本表达物体的空间状态,比如"左边那只鞋""从高处俯拍的汽车""朝右的椅子"。这类描述自然、灵活,但无法精确刻画连续的三维姿态。实验中,GPT-4o 在街景数据上估计物体方位角(即物体朝向)的平均误差达到 73.38°,而随机猜测的误差是 86.18°,差距并不大。
第二,理解与生成各自为战。 传统的物体姿态估计只负责从图像中回归角度数值;姿态可控生成只负责按给定姿态合成图像。两条研究线长期分开推进,缺少一个能同时刻画"姿态感知—空间推理—姿态条件生成"的统一问题定义。
二、核心思路:姿态是理解与生成共享的几何变量
Object-Uni 的核心观点是:物体姿态既不应只是姿态估计的预测标签,也不应只是图像生成的外部控制信号,而应当是连接理解与生成的显式几何变量。 在这一设定下,模型既要能从图像推断物体的空间状态,也要能按照目标空间状态生成几何一致的图像。
随之而来的关键难题是:如何让多模态大语言模型(MLLM)"读懂"并"写出"物体姿态? 物体位置和相对关系可以用"左边""后面""上方"等语言自然表达;但物体朝向是一个多维、连续、带周期性的几何量,很难直接对齐到 MLLM 以离散 token 为基础的语言推理空间。
围绕这一难题,论文给出了四项贡献:视角化朝向抽象、UniSpatial-80K 数据集、物体 token 锚定的姿态预测机制(PoseAnchor),以及统一的多阶段训练方案。
三、关键技术
3.1 视角化朝向抽象:给连续角度配一套"视角词汇"
沿用 Orient Anything 的约定,每个物体的三维朝向由三个角度描述:方位角 \phi(物体正面相对相机的朝向)、极角 \theta(相机相对物体的俯仰)和旋转角 \psi。
直接把这些角度数值丢给 MLLM 效果并不好,因为数字 token 本身不携带"从哪个方向看过去"的感知含义。Object-Uni 因此为姿态构建了双重表示:
- 连续角度保留下来,作为度量监督目标,也用于定量评测和生成控制;
- 结构化视角描述通过确定性规则从角度映射而来,供 MLLM 用自然语言理解和推理。
具体映射规则如下:
| 角度 | 划分 | 语言描述 |
|---|---|---|
| 方位角 \phi | 每 45° 一档,共 8 档 | front、front-right quarter、right side、back-right quarter、back、back-left quarter、left side、front-left quarter |
| 极角 \theta | 共 7 档 | overhead、high-angle、mid-high、eye-level、mid-low、low-angle、bottom-up |
| 旋转角 \psi | 共 3 档 | 几乎无旋转、逆时针旋转、顺时针旋转 |
需要强调的是,这套抽象并没有用离散标签替代连续姿态,而是在两者之间架起桥梁:连续姿态保证几何精度,视角描述让模型能在语言层面推理姿态。
此外,模型还会用"左/中/右、上/中/下"等词描述物体在画面中的位置。对于多物体场景,论文同时从观察者视角和物体自身视角描述相对关系。后者会结合参照物体的方位角,表达"在 A 的左侧""在 B 的身后"这类以物体为参照系的关系。
3.2 UniSpatial-80K:面向理解与生成的物体级空间基准
为了系统训练和评测物体级空间智能,团队构建了 UniSpatial-80K 数据集。数据来源包括:
- KITTI、Cityscapes(取自 OmniNOCS):街景中的车辆与行人;
- Objectron(取自 OmniNOCS):室内物体视频;
- ImageNet3D:类别覆盖广泛的通用物体场景。
构建过程中,作者剔除了背景过于杂乱或前景实例过多、难以明确"哪个姿态属于哪个物体"的样本,排除了没有明确正面的物体类别,并设置类别采样数量上限以缓解类别不均衡问题。最终,UniSpatial-80K 的训练/验证集包含 83,252 张图像、91,392 个标注物体、122 个类别,另设 4,092 个单物体测试样本和 924 个多物体测试样本。每个样本都包含一段通用图像描述、一段物体级空间描述以及连续姿态标注。
与只服务单一任务的传统姿态数据集不同,UniSpatial-80K 被组织成一组相互关联的理解与生成任务:
| 任务 | 输入 → 输出 | 作用 |
|---|---|---|
| 空间理解 | 图像 → 空间描述 + 朝向 | 描述场景并估计每个物体的连续朝向 |
| 空间推理桥接 | 文本 + 姿态 → 空间描述 | 把姿态条件转写成结构化空间语言,连接理解与生成 |
| 姿态可控生成 | 文本 + 姿态 → 图像 | 按文本和指定物体姿态生成图像 |
| 物体级新视角合成 | 图像 + 姿态 → 图像 | 把图中物体"转"到目标视角 |
3.3 PoseAnchor:把每个姿态"钉"在对应的物体上
让 MLLM 直接以文本形式输出角度数字,再从回答里解析,这种做法并不稳定:一方面数字 token 的校准性很差,另一方面在多物体场景中,模型生成的文本很可能把角度"张冠李戴"到错误的物体上。
为此,Object-Uni 设计了物体 token 锚定的姿态锚点(Object-Token-Grounded Pose Anchor, PoseAnchor):
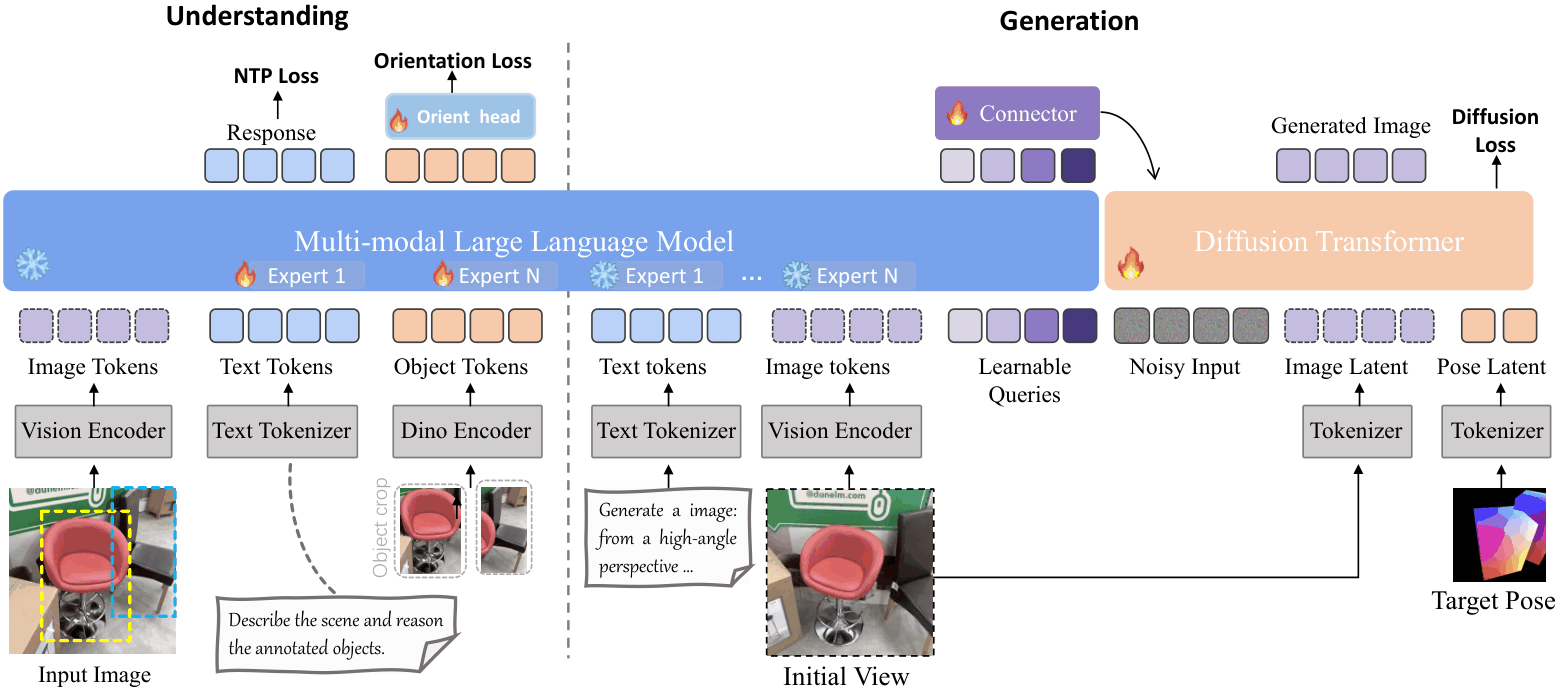
1、 按边界框裁剪出每个物体,用冻结的 DINOv2 视觉编码器提取物体级特征;
2、 将该特征投影到 MLLM 隐空间,作为该物体专属的 token 插入输入序列;
3、 这个 token 对应的隐状态 h_i 即为该物体的姿态锚点:
其中 I 为图像,T 为文本,b_i 为边界框,e_i 为投影后的物体特征。
4、 在 h_i 上接轻量预测头,分别估计方位角、极角和旋转角。
这样,每一个姿态预测都显式绑定到对应的物体实例上,在多物体场景中尤为关键。
在损失设计上,论文沿用 Orient Anything 的做法,把朝向预测建模为离散角度区间上的分布拟合问题:以真值角度为中心构造类高斯的软目标分布。方位角和旋转角使用环形角距离以尊重周期性,极角则在 [0°, 180°] 上使用普通距离。姿态损失为有效物体上的平均软交叉熵:
理解阶段的完整目标在下一 token 预测损失之外加上姿态损失:
3.4 统一架构与三阶段训练
Object-Uni 以蚂蚁集团的统一多模态模型 Ming-Lite-Uni 为基座:MLLM 一侧负责语义理解与空间推理,DiT 扩散模型一侧负责高保真图像合成,两者通过多尺度可学习查询相连。
由于语言只能提供粗粒度的空间约束,生成一侧还额外引入了几何条件:参照 SceneDesigner 的 9 自由度姿态控制方式,将目标姿态转换为 CNOCS 图,经 VAE 编码器送入扩散模型,为生成提供稠密的图像空间几何引导。
训练分三个阶段进行:
1、 空间理解阶段:训练"图像 → 空间描述 + 朝向"和"文本 + 姿态 → 空间描述"两个任务,仅更新 MLLM 的 MoE 层、物体 token 投影模块和朝向预测头,其余预训练参数保持冻结;
2、 姿态可控生成阶段:训练 DiT 生成器完成 "文本 + 姿态 → 图像";
3、 新视角合成阶段:训练 DiT 生成器完成 "图像 + 姿态 → 图像"。
整个训练流程在 8 张 H20 GPU 上约需 18 小时。
四、实验结果
4.1 姿态理解:方位角估计全面领先通用大模型
论文在 UniSpatial-80K 的 KITTI-Cityscapes、ImageNet3D、Objectron 三个子集上,分别在单物体和多物体设置下评测朝向估计,对比对象包括 GPT-4o、Gemini-2.5-Pro 两个通用多模态大模型,以及专用朝向估计模型 Orient Anything V1/V2。其中,Orient Anything 以真值边界框裁剪出的物体图像作为输入。
方位角最能体现模型是否真正理解了"物体朝哪边",下表列出各方法的方位角平均误差(单位:度,越低越好):
| 方法 | KITTI-C 单 | KITTI-C 多 | ImageNet3D 单 | ImageNet3D 多 | Objectron 单 | Objectron 多 |
|---|---|---|---|---|---|---|
| Random | 86.18 | 90.20 | 87.52 | 90.43 | 91.66 | 90.13 |
| GPT-4o | 73.38 | 82.94 | 50.02 | 55.39 | 49.50 | 69.37 |
| Gemini-2.5-Pro | 69.32 | 48.43 | 53.77 | 55.00 | 49.95 | 68.51 |
| Orient Anything V1 | 27.33 | 22.17 | 41.75 | 52.11 | 37.70 | 47.26 |
| Orient Anything V2 | 29.94 | 54.93 | 28.25 | 34.40 | 30.34 | 32.58 |
| Object-Uni | 22.87 | 28.12 | 24.13 | 33.84 | 22.67 | 25.89 |
几点值得关注:
- 相比通用大模型优势明显。 在 Objectron 多物体场景中,GPT-4o 的方位角误差为 69.37°,Object-Uni 降至 25.89°;在 KITTI-Cityscapes 单物体场景中,误差从 73.38° 降至 22.87°,约为前者的三分之一。
- 作为统一模型,可与专用模型正面竞争。 6 组设置中,Object-Uni 在 5 组取得最低方位角误差。在 KITTI-Cityscapes 多物体场景中,Orient Anything V1 平均误差更低,但 Object-Uni 的 AUC@5 达到 47.06,是 V1(22.57)的两倍以上,高精度区间的命中率明显更高。
- 极角与旋转角同样精准。 在 KITTI-Cityscapes 单物体场景中,Object-Uni 的极角误差仅 0.56°、旋转角误差仅 0.23°,AUC@5 分别达到 98.18 和 99.67。
4.2 姿态可控生成:位置、朝向、语义一起对齐
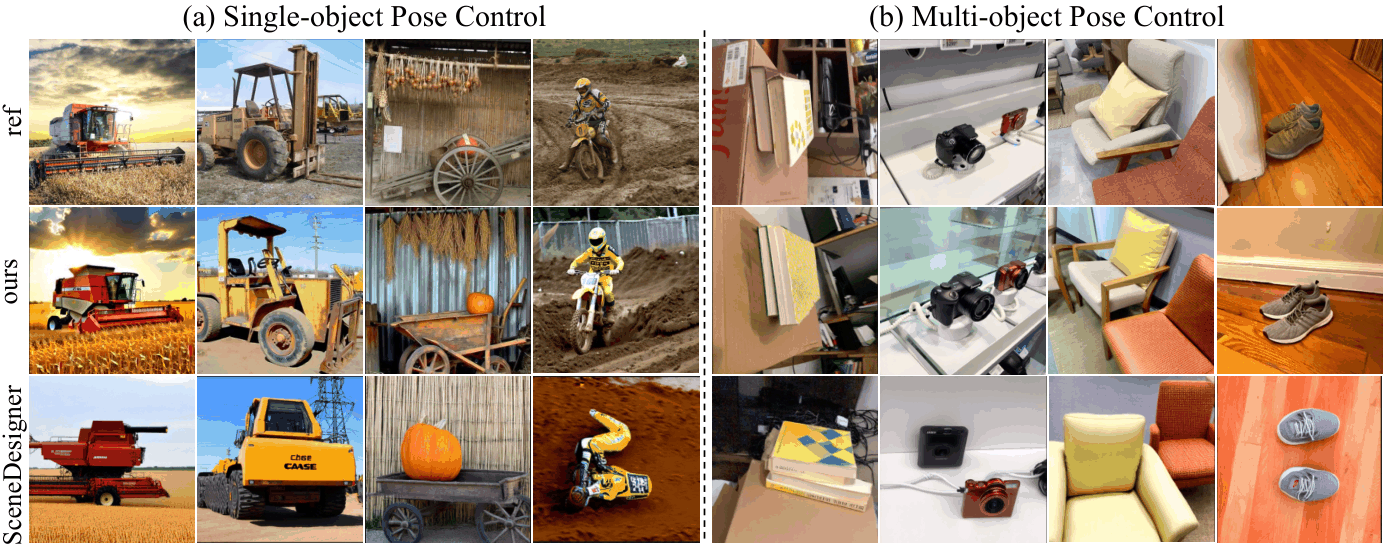
在生成侧,论文与支持 9 自由度姿态控制的多物体可控生成方法 SceneDesigner 对比,从三个维度评估:用 Grounding DINO 检测生成物体并计算 mIoU 与定位成功率 \mathrm{Acc}_{ls}(IoU > 0.6 的比例);用朝向估计器测量生成物体的角度偏差;用 CLIP 分数衡量图文一致性。
| 数据集 / 设置 | mIoU ↑ | \mathrm{Acc}_{ls} ↑ | 方位角误差 ↓ | CLIP ↑ |
|---|---|---|---|---|
| ImageNet3D 单物体 | 66.45 → 74.31 | 68.81 → 83.40 | 62.10 → 34.40 | 0.333 → 0.341 |
| ImageNet3D 多物体 | 39.03 → 54.43 | 20.89 → 44.86 | 67.83 → 50.66 | 0.334 → 0.344 |
| KITTI 单物体 | 38.40 → 62.75 | 26.45 → 68.60 | 68.17 → 69.83 | 0.319 → 0.331 |
| KITTI 多物体 | 17.17 → 53.34 | 11.72 → 49.34 | 89.48 → 81.36 | 0.315 → 0.323 |
| Objectron 单物体 | 40.77 → 78.23 | 13.56 → 93.12 | 53.44 → 32.10 | 0.326 → 0.335 |
| Objectron 多物体 | 27.25 → 69.08 | 4.53 → 79.37 | 82.27 → 36.26 | 0.319 → 0.334 |
(箭头左侧为 SceneDesigner,右侧为 Object-Uni)
- 空间定位大幅提升,多物体场景尤甚。 在 Objectron 多物体场景中,mIoU 从 27.25 提升到 69.08,定位成功率从 4.53% 提升到 79.37%。
- 朝向控制更准。 在外观随视角变化显著的 ImageNet3D 和 Objectron 上改善最为明显,Objectron 多物体场景的方位角误差从 82.27° 降至 36.26°。KITTI 单物体场景的平均方位角误差与基线基本持平,但 AUC@10/30 仍更高,且 KITTI 多物体场景的旋转角误差从 20.35° 降到 5.96°。
- 语义保真不打折。 所有设置下 CLIP 分数均高于基线,说明模型在满足几何约束的同时,更好地理解并遵循了场景描述。
4.3 消融实验:PoseAnchor 让方位角误差近乎减半
对比去掉物体 token、让模型以文本形式直接输出角度的版本(Object-Uni w/o),PoseAnchor 在方位角上带来了稳定提升:
| 设置 | 无 PoseAnchor | 有 PoseAnchor |
|---|---|---|
| KITTI-C 单物体 | 46.16° | 22.87° |
| KITTI-C 多物体 | 52.02° | 28.12° |
| ImageNet3D 多物体 | 42.08° | 33.84° |
| Objectron 多物体 | 33.95° | 25.89° |
在 KITTI-Cityscapes 上,方位角误差几乎减半。另一个有意思的现象是:不带 PoseAnchor 时,模型在 KITTI-Cityscapes 上的方位角误差不如专用模型 Orient Anything。这说明"让大模型直接用文字吐出角度"确实不可靠,把姿态预测显式锚定到物体实例上是必要的。
4.4 应用:物体级新视角合成
除了朝向估计和文生图,Object-Uni 还能完成物体级新视角合成:给定一张图像和目标姿态,模型对目标物体进行编辑,使其呈现目标视角下的外观,同时保持类别、局部纹理和周围环境不变。
这项任务要求模型具备"空间想象"能力:它需要推断物体转过去之后应该长什么样,而不能简单复制输入图像中的像素。从论文 Figure 1(b) 的结果看,生成结果在外观上与输入保持一致,同时准确匹配了目标姿态。
五、总结与展望
Object-Uni 提出了一个清晰的观点:物体姿态应当成为统一模型中理解与生成共享的显式几何变量。
围绕这一观点,研究团队用视角化朝向抽象打通了连续几何与语言推理,用 UniSpatial-80K 建立了覆盖理解与生成的统一评测,用 PoseAnchor 解决了多物体场景下的姿态归属问题,最终在一个模型中同时实现了更准确的朝向估计和更可控的姿态条件生成。
从"描述物体"到"操控物体的空间状态",Object-Uni 为统一多模态模型补上了物体级空间智能这一块关键拼图,也为自动驾驶场景数据合成、具身智能中的物体姿态感知等方向提供了新的思路。
参考文献
[1] Tan M, Wang Y, Zhou Z, et al. Object-Uni: A Unified Model for Object-Centric Spatial Understanding and Controllable Generation[J]. arXiv preprint arXiv:2608.22757, 2026.
[2] AI I, Gong B, Zou C, et al. Ming-lite-uni: Advancements in unified architecture for natural multimodal interaction[J]. arXiv preprint arXiv:2505.02471, 2025.
[3] Wang Z, Zhang Z, Xu J, et al. Orient anything v2: Unifying orientation and rotation understanding[J]. Advances in Neural Information Processing Systems, 2026, 38: 52622-52645.
[4] Qin Z, Shuai X, Ding H. Scenedesigner: Controllable multi-object image generation with 9-dof pose manipulation[J]. Advances in Neural Information Processing Systems, 2026, 38: 133376-133400.