作者:王昊,中山大学博士
01. 倒一杯水之前,大脑先做了什么?
倒一杯水,看起来只是一个动作。但手还没伸出去,大脑已经忙了一轮:先认出杯子和水壶在哪,再预想手怎么移过去、水会怎么流进杯子,最后才决定手腕倾斜多少、什么时候停。
心理学家 Kenneth Craik 在 1943 年就写过类似的想法:人的头脑里装着一个"外部现实的小规模模型",行动之前,我们会先用它把结果预演一遍。今天大家常说的世界模型,思想源头之一就在这里。
那机器人呢?如果不告诉它这个顺序,它能不能自己学会先理解、再想象、后行动?
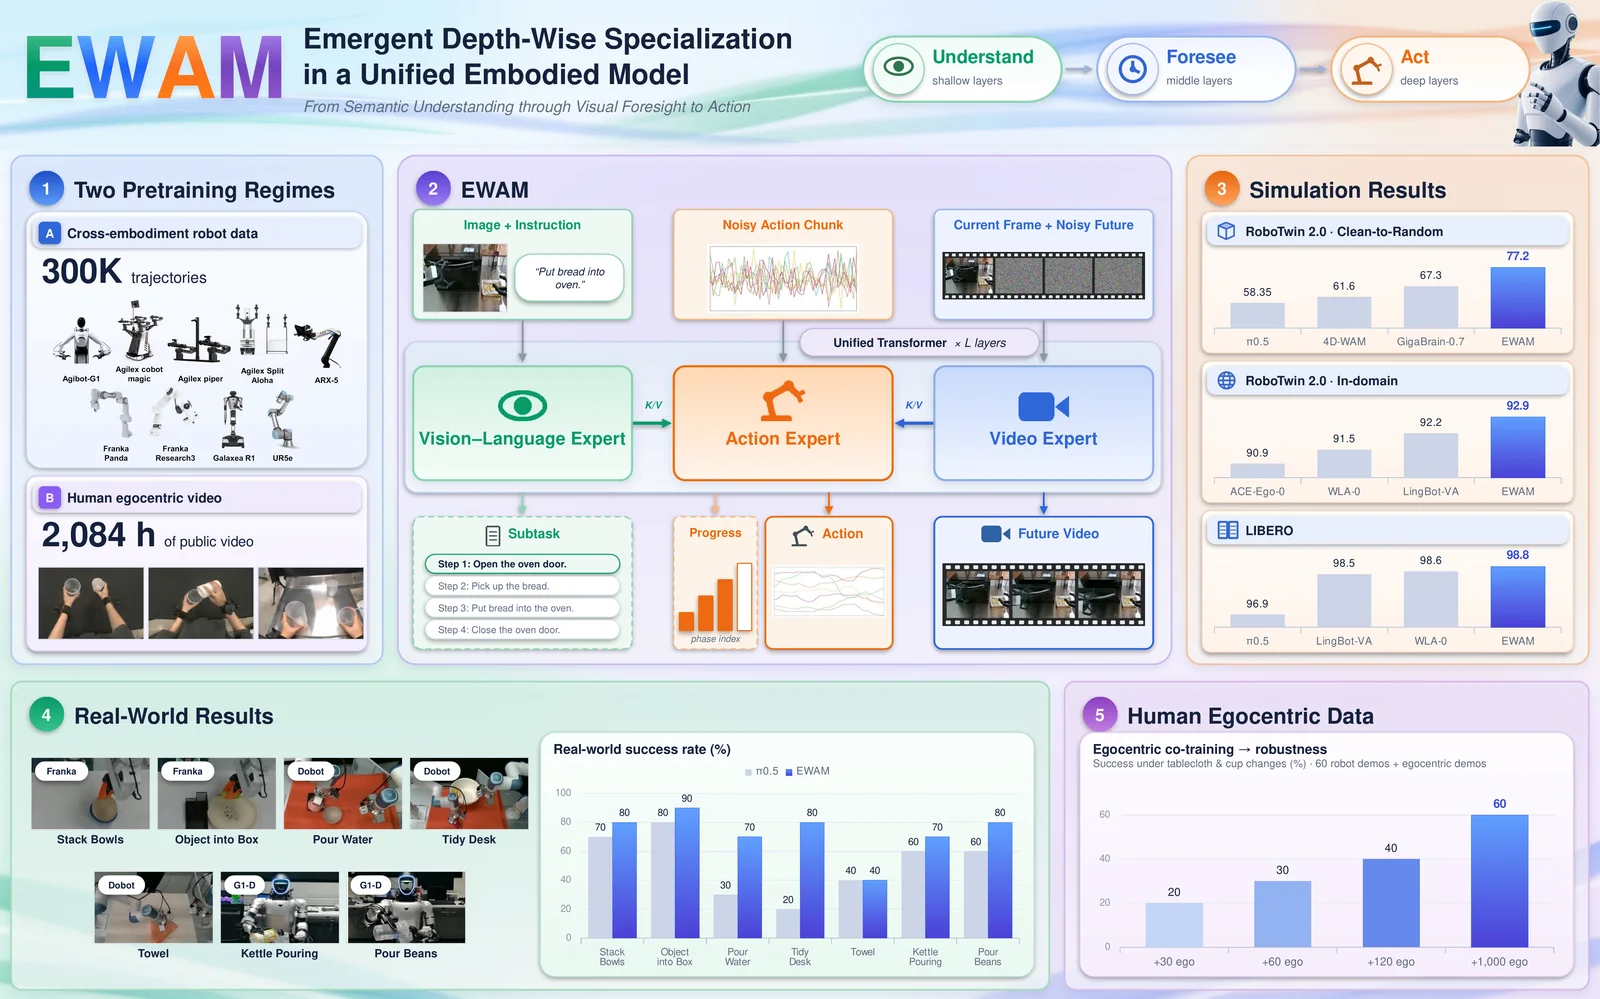
近日,中山大学、引望智能等9家机构联合提出了统一具身模型 EWAM,给出的答案是:能。
- 论文标题:EWAM: Emergent Depth-Wise Specialization in a Unified Embodied Model -- From Semantic Understanding through Visual Foresight to Action
- 论文链接:https://arxiv.org/abs/2609.39973
- 项目主页:https://wanghao00pro.github.io/EWAM-project/
- 代码:https://github.com/Wanghao00pro/EWAM
- 模型权重:https://huggingface.co/HaoWang00/EWAM
02. 两类模型,各会一半
现在做机器人策略,大致有两条路。
一条是 VLA(视觉-语言-动作模型):在图文预训练好的视觉语言模型后面接一个动作头,强项是听懂指令、认出场景里的物体。
另一条是 WAM(世界-动作模型):从视频生成模型出发,同时预测未来画面和动作,学的是"动作做下去,世界会怎么变"。
一个擅长理解,一个擅长想象,把两者接在一起是很自然的想法,Motus 这类多专家模型就是这么做的。但接上了,动作就真的会同时用上两边的信息吗?
研究团队统计了几类代表性模型里动作 token 的注意力分配,也就是动作在每一层主要从哪里取信息。结果并不乐观:π0.5 的动作主要看视觉语言模型,Fast-WAM 的动作主要看视频;Motus 虽然两路都接了,动作注意力还是常常被其中一路占满。
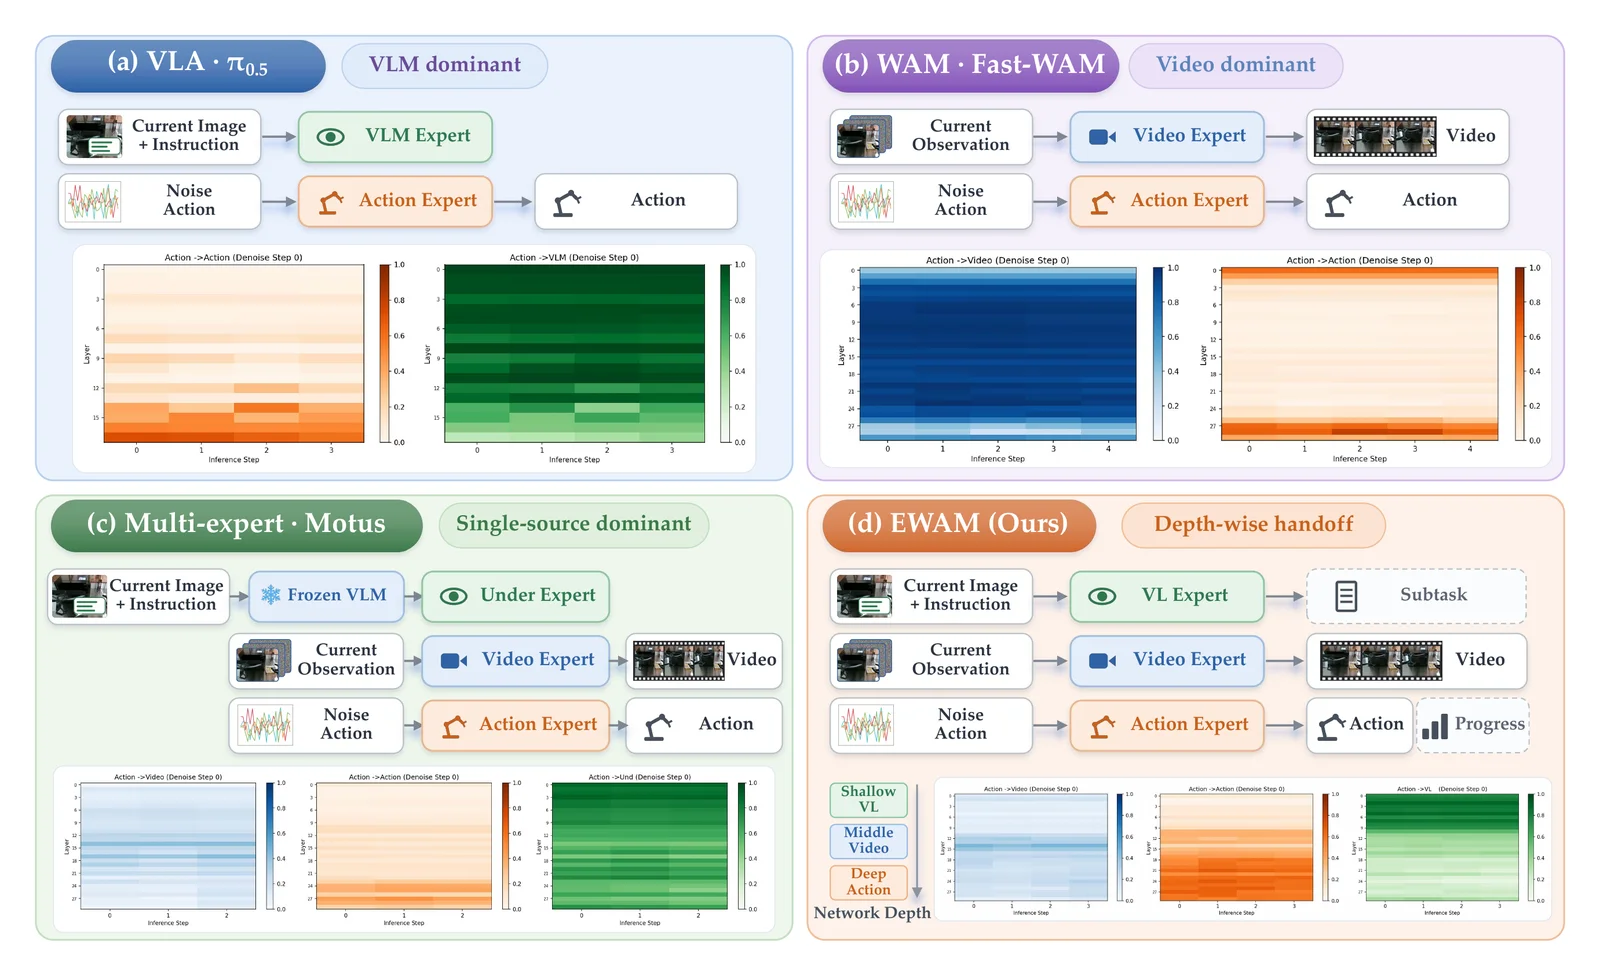
这就引出了 EWAM 想回答的问题:把语义理解、视觉预测和动作生成真正放进同一个网络,它们会互相抢,还是会自己分好工?
03. EWAM 怎么做:只规定"能看什么"
EWAM 把三个专家放进同一个 flow-matching Diffusion Transformer 里联合去噪。视觉-语言专家基于 Qwen3-VL-2B-Instruct,负责理解指令和当前画面;视频专家基于 Wan2.2-TI2V-5B,负责预测未来视频;动作专家是一个轻量 Transformer,负责生成一段连续动作。Qwen3-VL 的 28 层和视频专家的 30 层逐层对齐,动作在每一层都能拿到对应深度的语义特征。
三路之间怎么连是关键。团队用了一种非对称的联合注意力:动作在每一层都可以读 VL、视频(当前帧和预测的未来帧)以及动作自己;VL 和视频只在各自内部做注意力,不读带噪的动作 token。这样感知专家不受动作噪声干扰,动作这边则可以在任意深度自由选择信息来源。
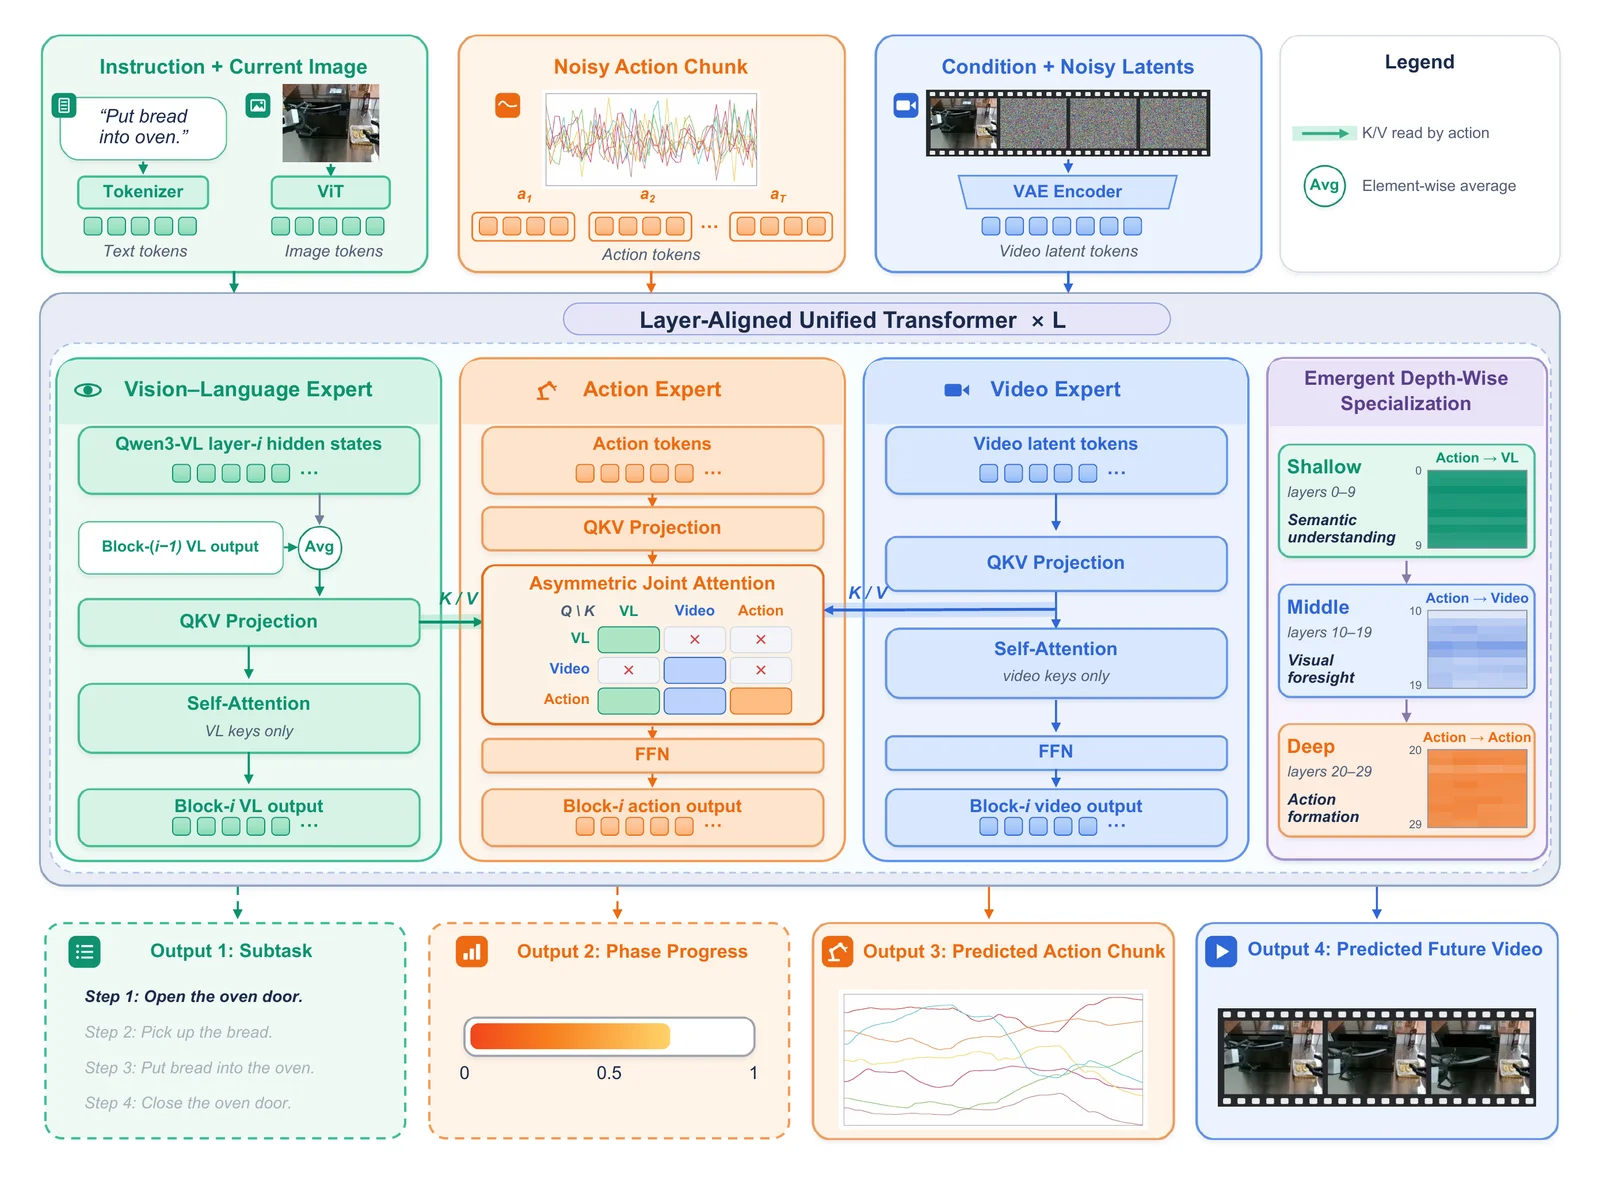
注意力掩码只决定哪些信息读得到,并没有规定哪一层该读什么,训练时也没有任何逐层监督。后面看到的分工,都是模型自己学出来的。
预训练有两套,彼此独立。一套是跨本体机器人数据,从约 3,250 小时开源数据中筛出约 1,800 小时、30 万条轨迹;另一套是约 2,084 小时的人类第一视角视频,人手腕的运动被换算成相对相机的末端位移,和机器人末端共用一套动作表示。
04. 没人教,它自己排出了顺序
团队把动作能看到的信息分成五类:VL 文本、VL 图像、当前帧、预测的未来帧和动作 token,然后逐层统计动作的注意力落在哪里。
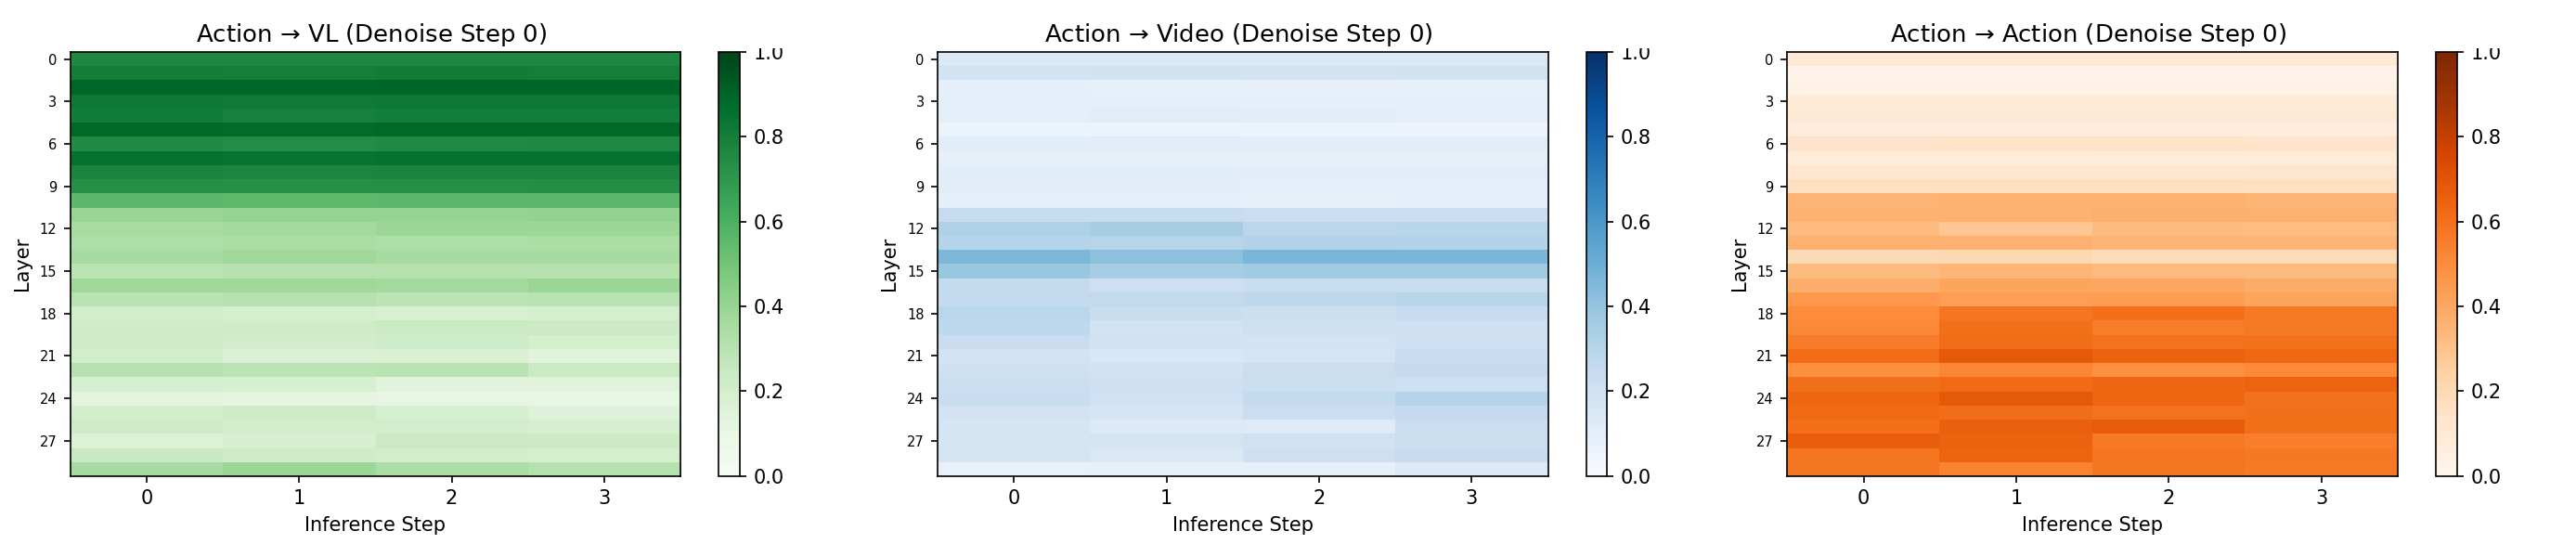
结果是很清楚的三段。第 0–9 层,动作主要看 VL,占 75.4%,相当于先把指令落到眼前的场景里;第 10–19 层,大约从第 13 层开始,预测的未来帧超过当前图像,成为主要的视觉来源;到了第 20–29 层,动作主要看自己,自注意力占 59.5%,开始精修轨迹。
这和倒水时的三步正好对上。而且它不是个别任务上的巧合:RoboTwin 的 50 个任务全部出现了完整的三段,浅层都是 VL 占比最大,中层都出现了从当前图像到未来帧的交接(交接位置的中位数在第 13 层),深层都是动作自身占比最大。不同去噪步之间,注意力分布的平均相关系数也达到 0.998。
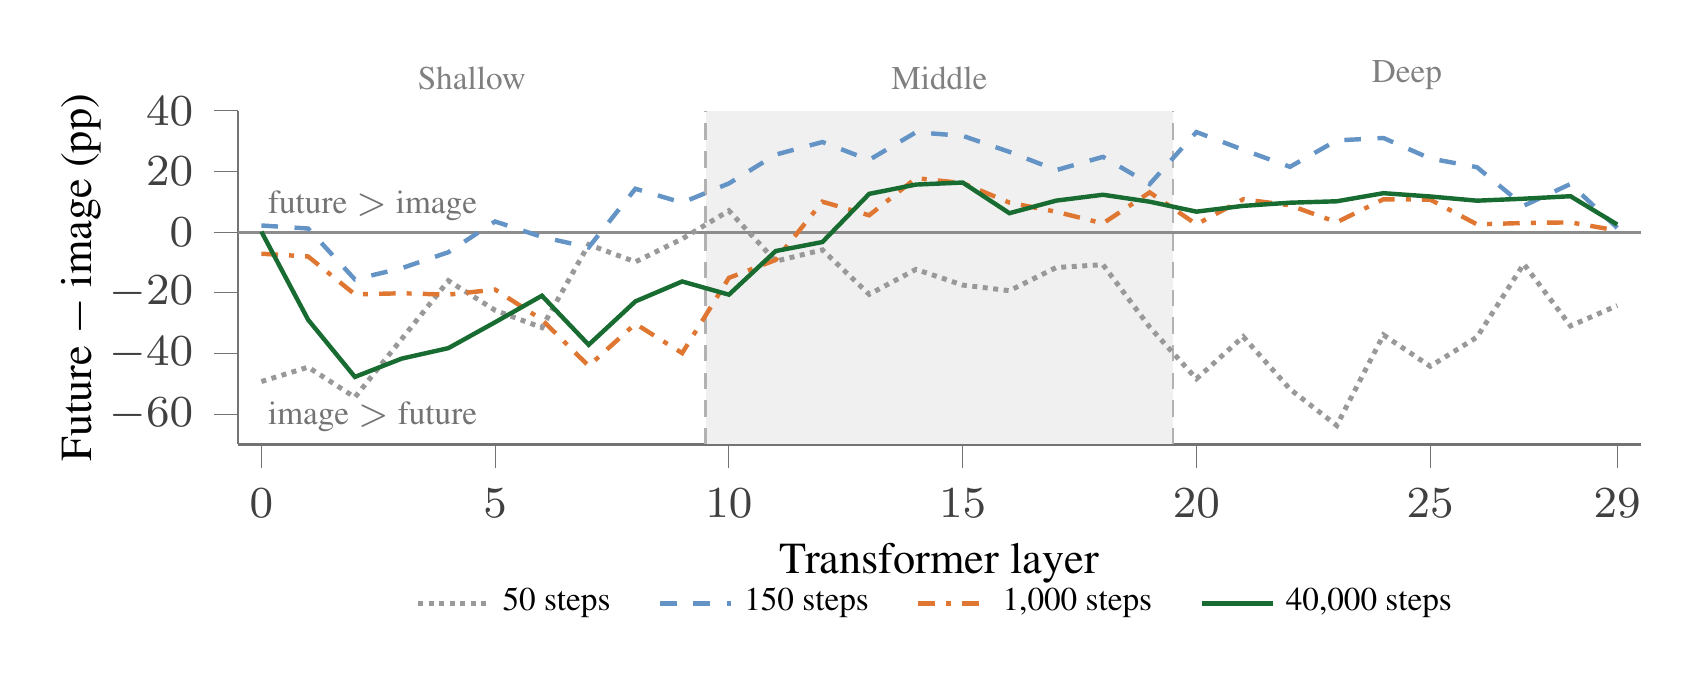
更有意思的是,这个顺序出现得很早。团队跟踪了一次不做机器人预训练的训练过程:第 50 步时几乎每一层都是当前图像领先,还没有分工;到第 150 步,从第 8 层开始预测的未来帧已经领先;训练到 40,000 步,浅层又回到以当前图像为主,未来帧从第 13 层起领先。分工在最初几百步就开始萌芽,之后慢慢调整到最终的位置。
05. 是真的在用,还是只是看看?
注意力统计只能说明动作在看哪里,说明不了动作是不是依赖这些信息。为此,团队做了两类干预实验。
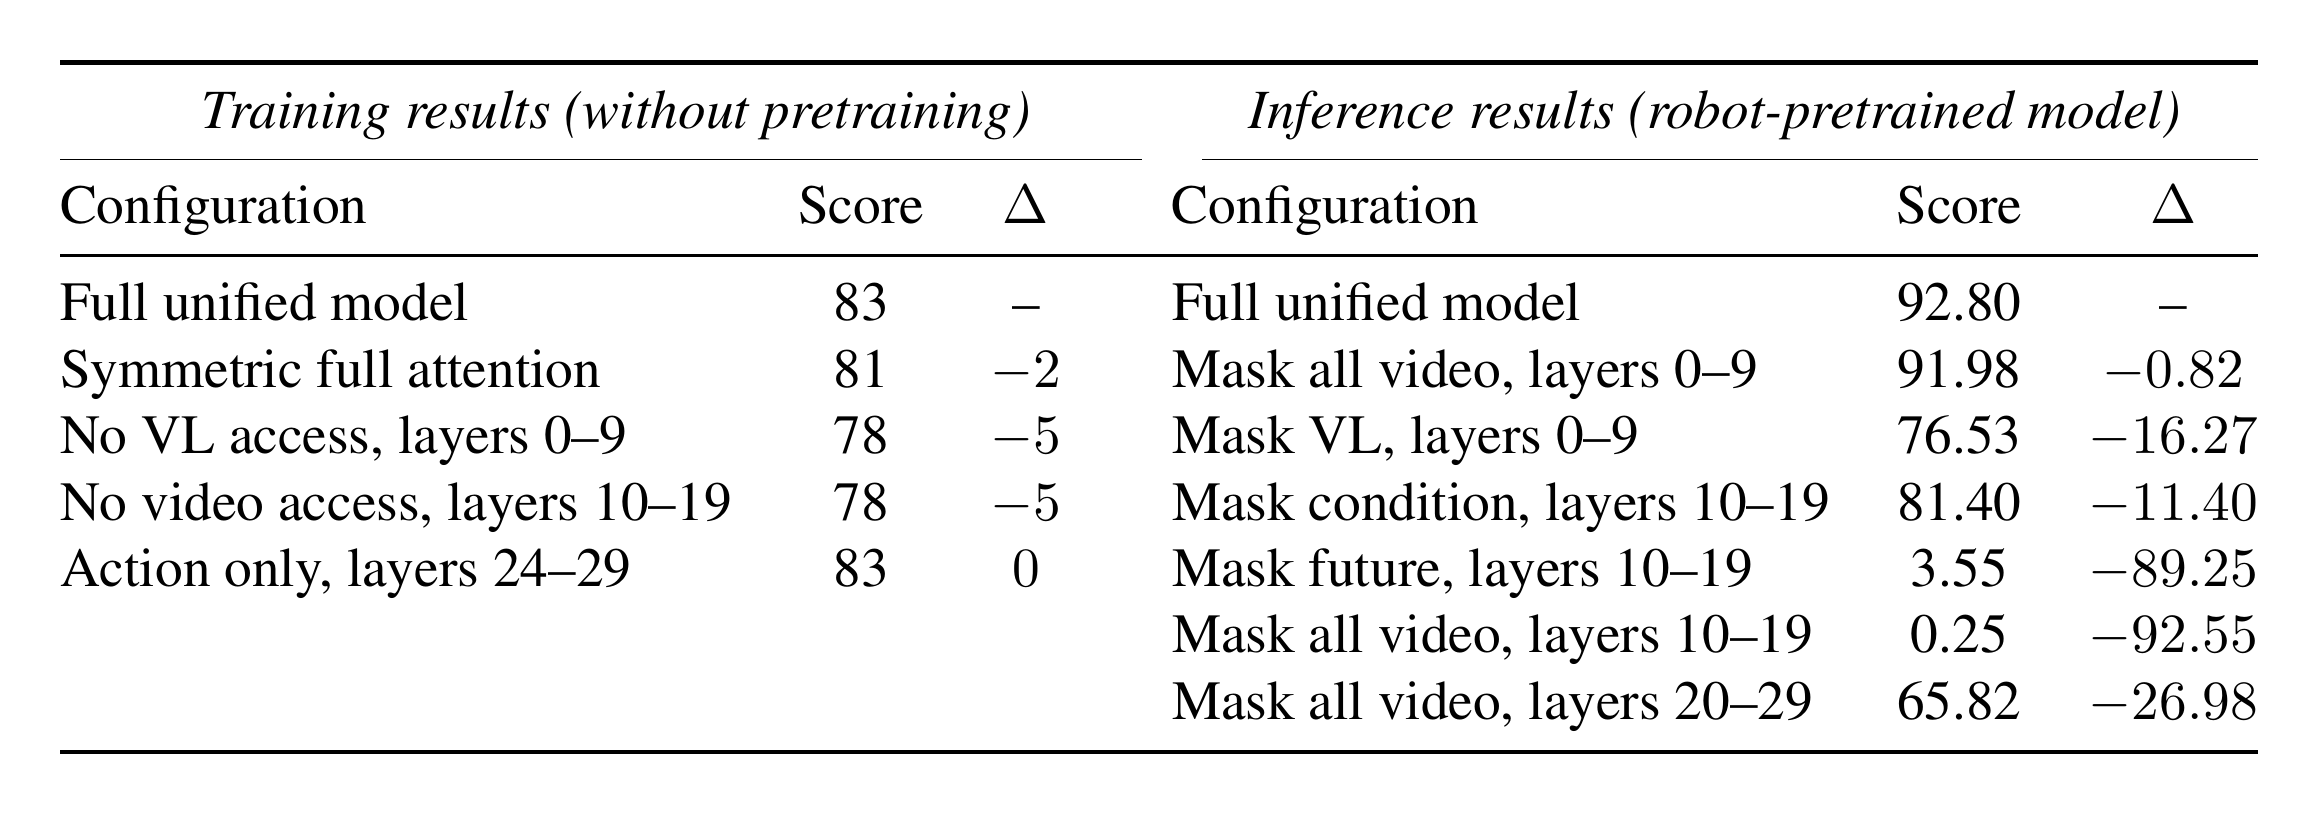
先看按层屏蔽。拿同一个机器人预训练模型,只在推理时把某几层、某类来源从动作的注意力里拿掉,不重新训练,在 RoboTwin 随机化场景的 50 个任务上各测 100 个 episode。
完整模型的成功率是 92.80%。在浅层拿掉全部视频,几乎没有影响(91.98%);在浅层拿掉 VL,降到 76.53%。而在中层只拿掉预测的未来帧,成功率便直接掉到 3.55%。哪一层缺什么最致命,和前面的注意力统计完全对得上。
团队还从头训练了几组结构消融模型,看的是另一个问题:一开始就切断某条通路会怎样。完整模型 83%;训练时去掉浅层的 VL 访问或中层的视频访问,都降到 78%;把第 24–29 层限制为只看动作自己,仍然是 83%;换成各路互相都能看的对称全注意力,反而降到 81%。
再看反事实注入:不拿走"想象",而是换一个。在 5 个任务中,团队把另一条成功轨迹的未来帧特征,在前三次策略调用里注入到目标轨迹的第 10–19 层,其余信息保持不变。成功率从 25/25 掉到 4/25。在 Adjust Bottle 任务里,有的轨迹甚至跟着别人的"未来"伸出了右手,而这个任务其实需要左手。
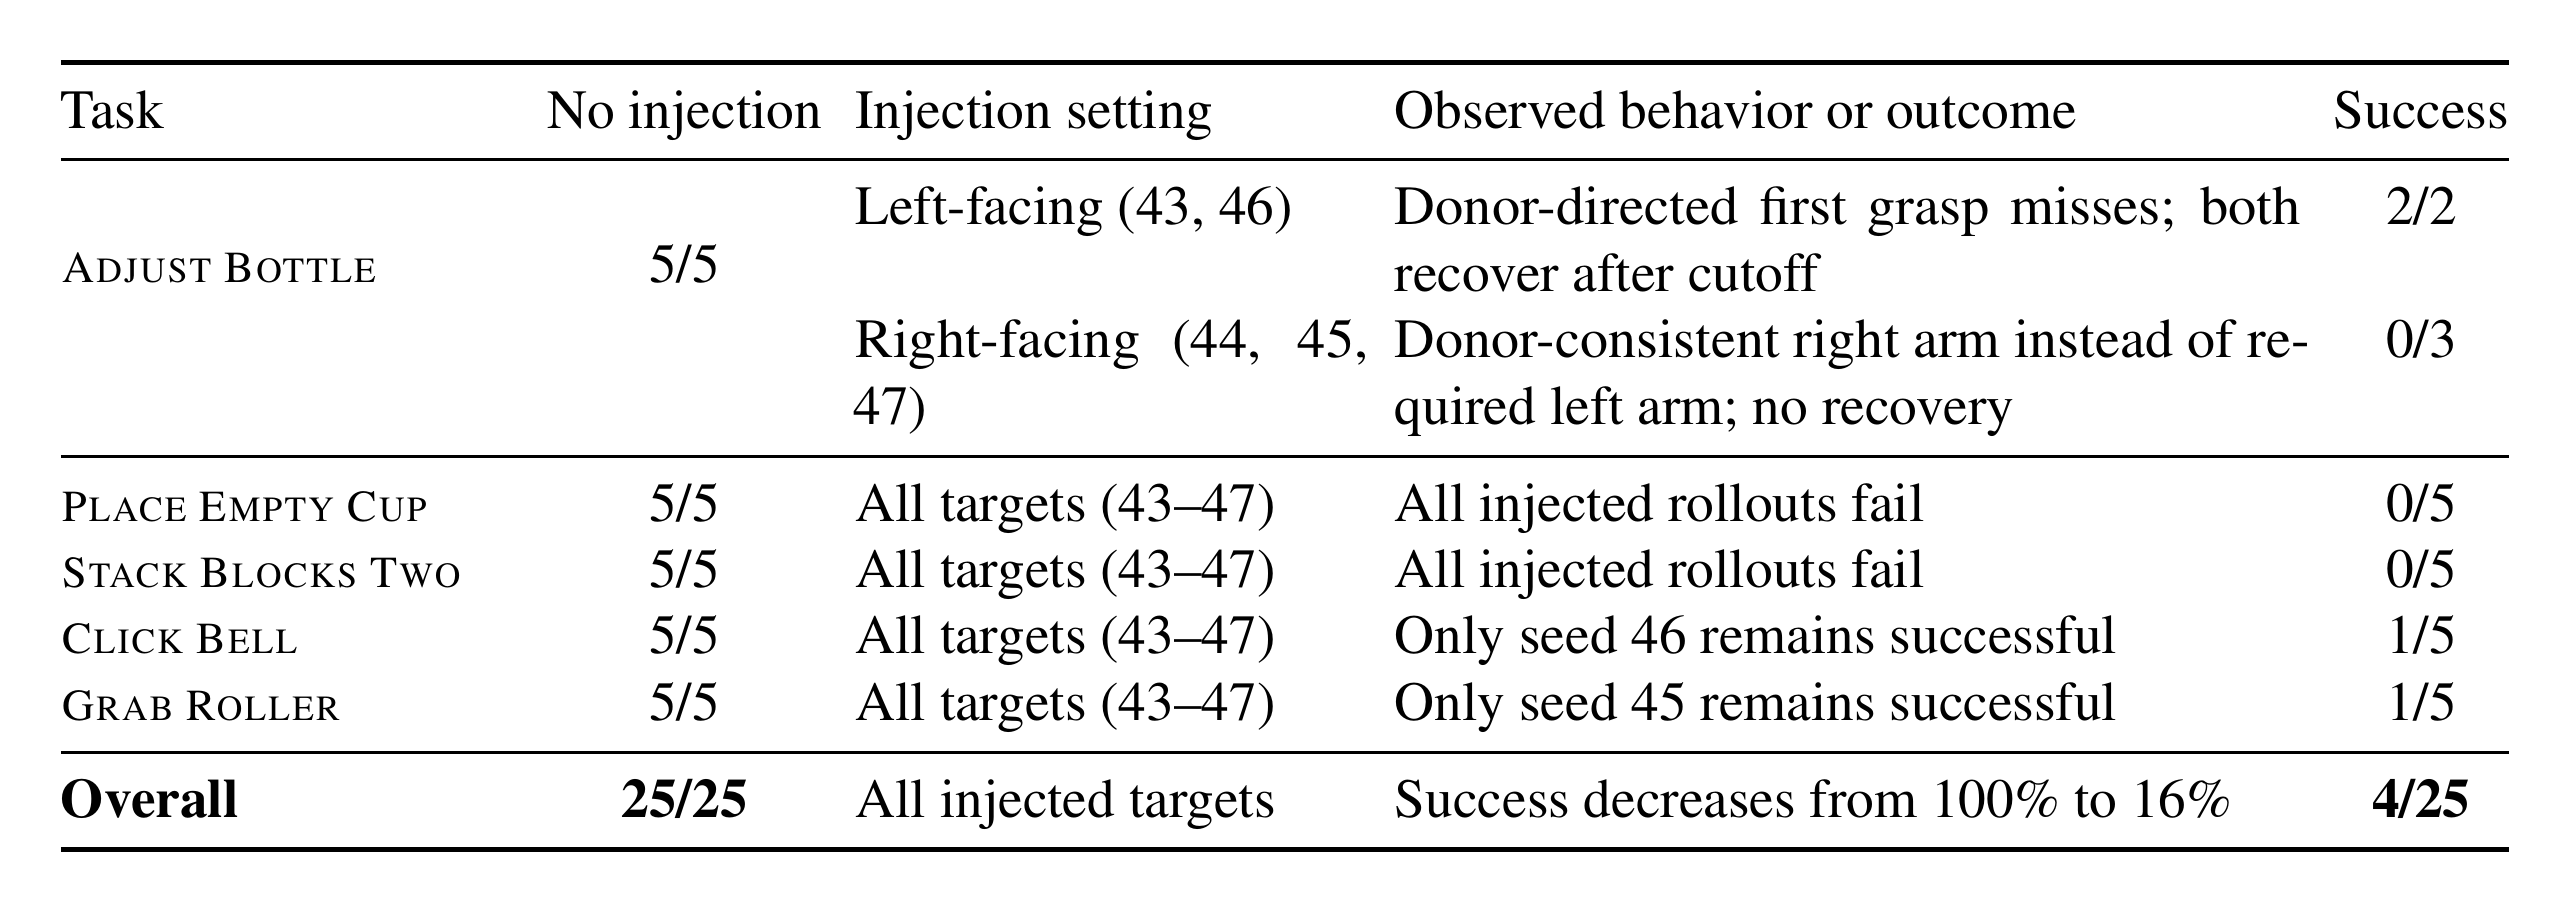
换掉中层的未来,动作就跟着变。EWAM 并不是把视频预测当成辅助任务顺便学一学,它是真的在按自己想象的未来行动。
06. 实验:仿真与真机
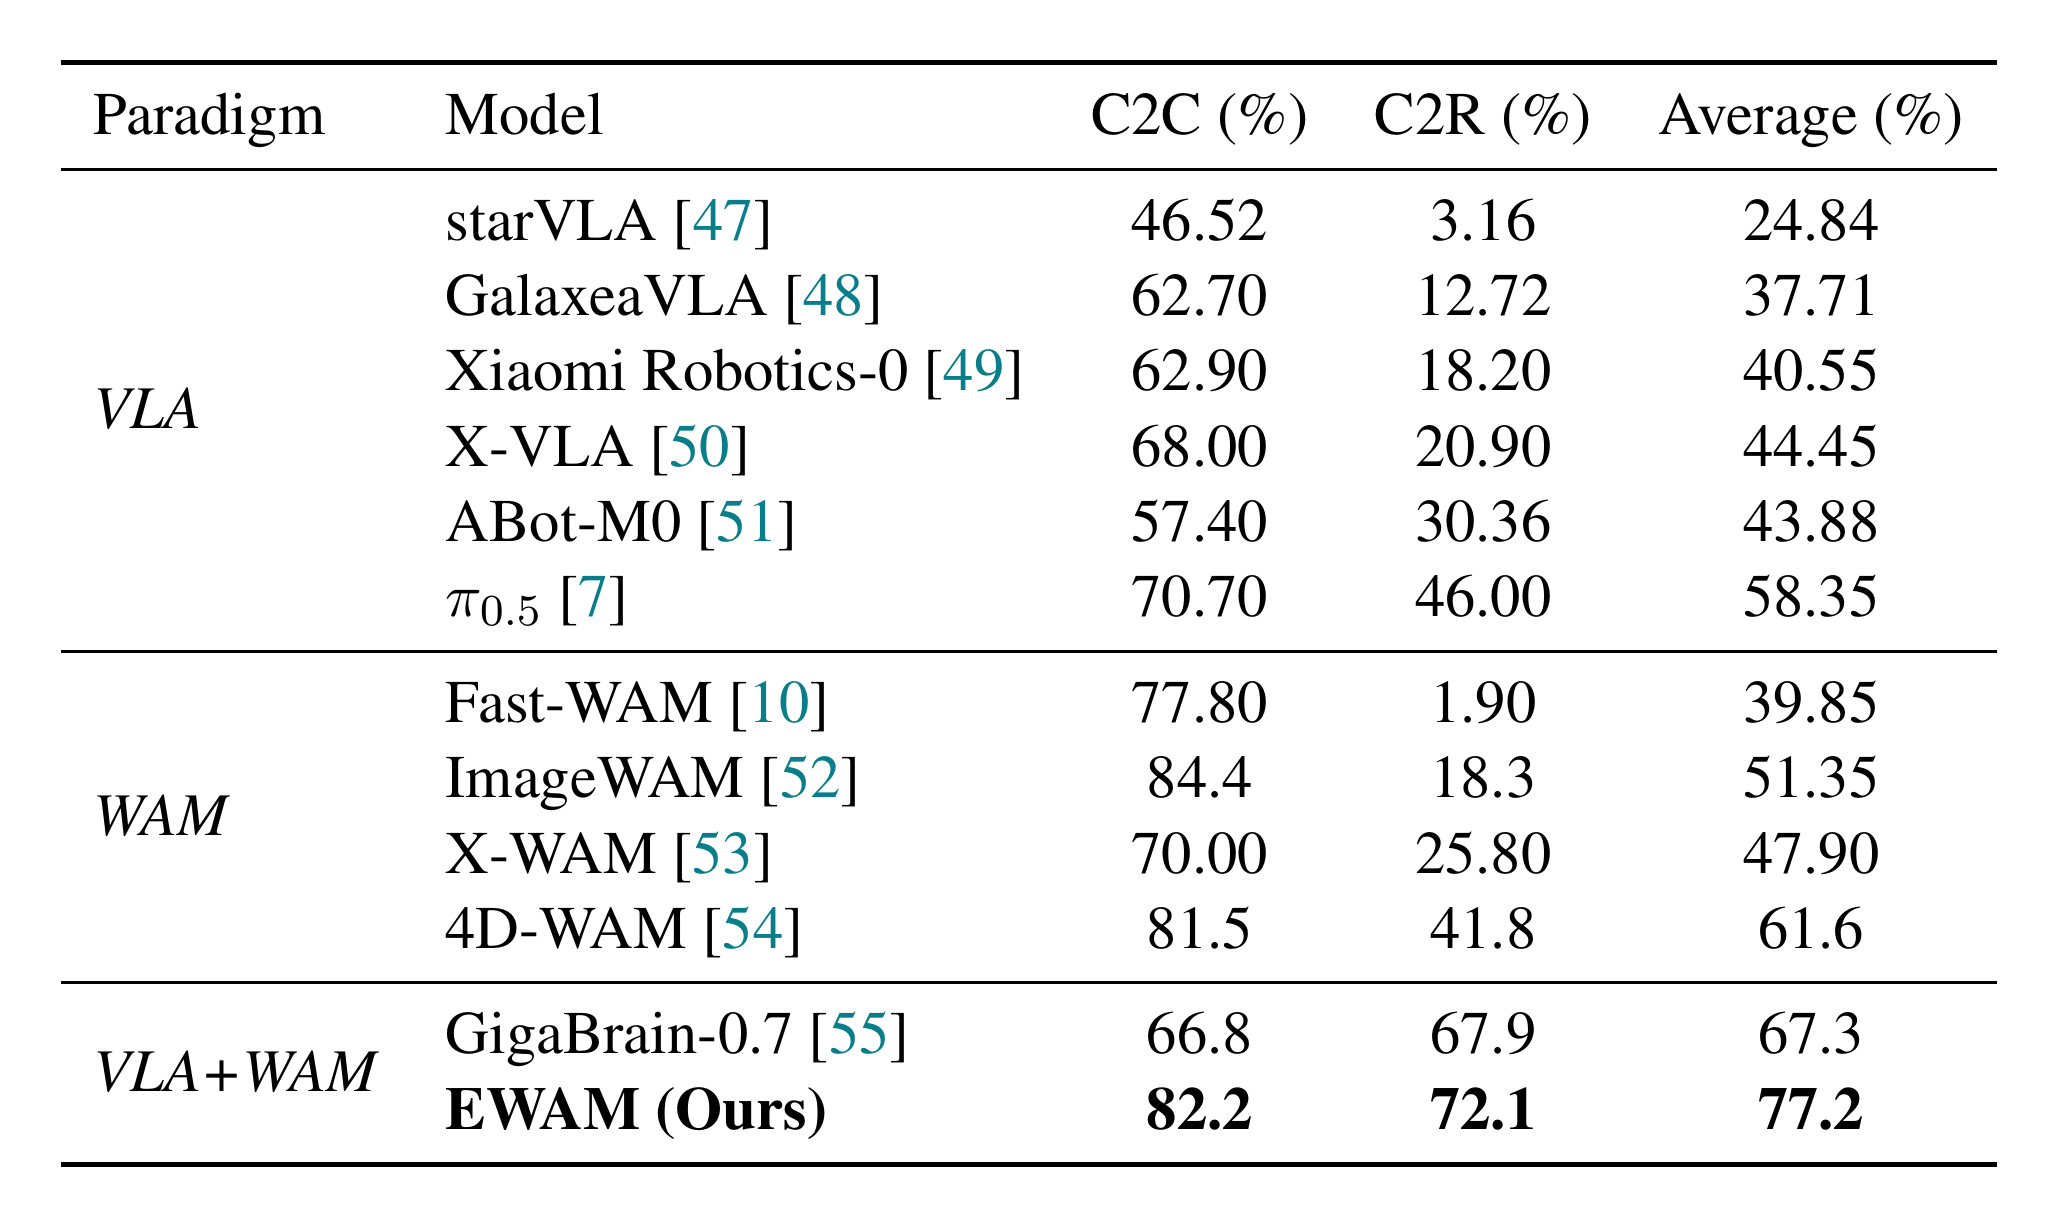
先看 RoboTwin 2.0 的 clean-to-random 设置。它测的是很多人都碰到过的问题:只用干净桌面上的示范训练,换了桌布、加了杂物、改了光照,还能不能做。策略只用干净场景的示范适配,再分别在干净场景(C2C)和随机化场景(C2R)测试,50 个双臂任务,每个任务 100 个 episode。
不少方法在这里落差很大:Fast-WAM 在干净场景是 77.8%,到了随机场景只剩 1.9%;π0.5 从 70.7% 降到 46.0%。EWAM 干净场景 82.2%,随机场景 72.1%,平均 77.2%;随机场景比 GigaBrain-0.7 高 4.2 个点,比 π0.5 高 26.1 个点。
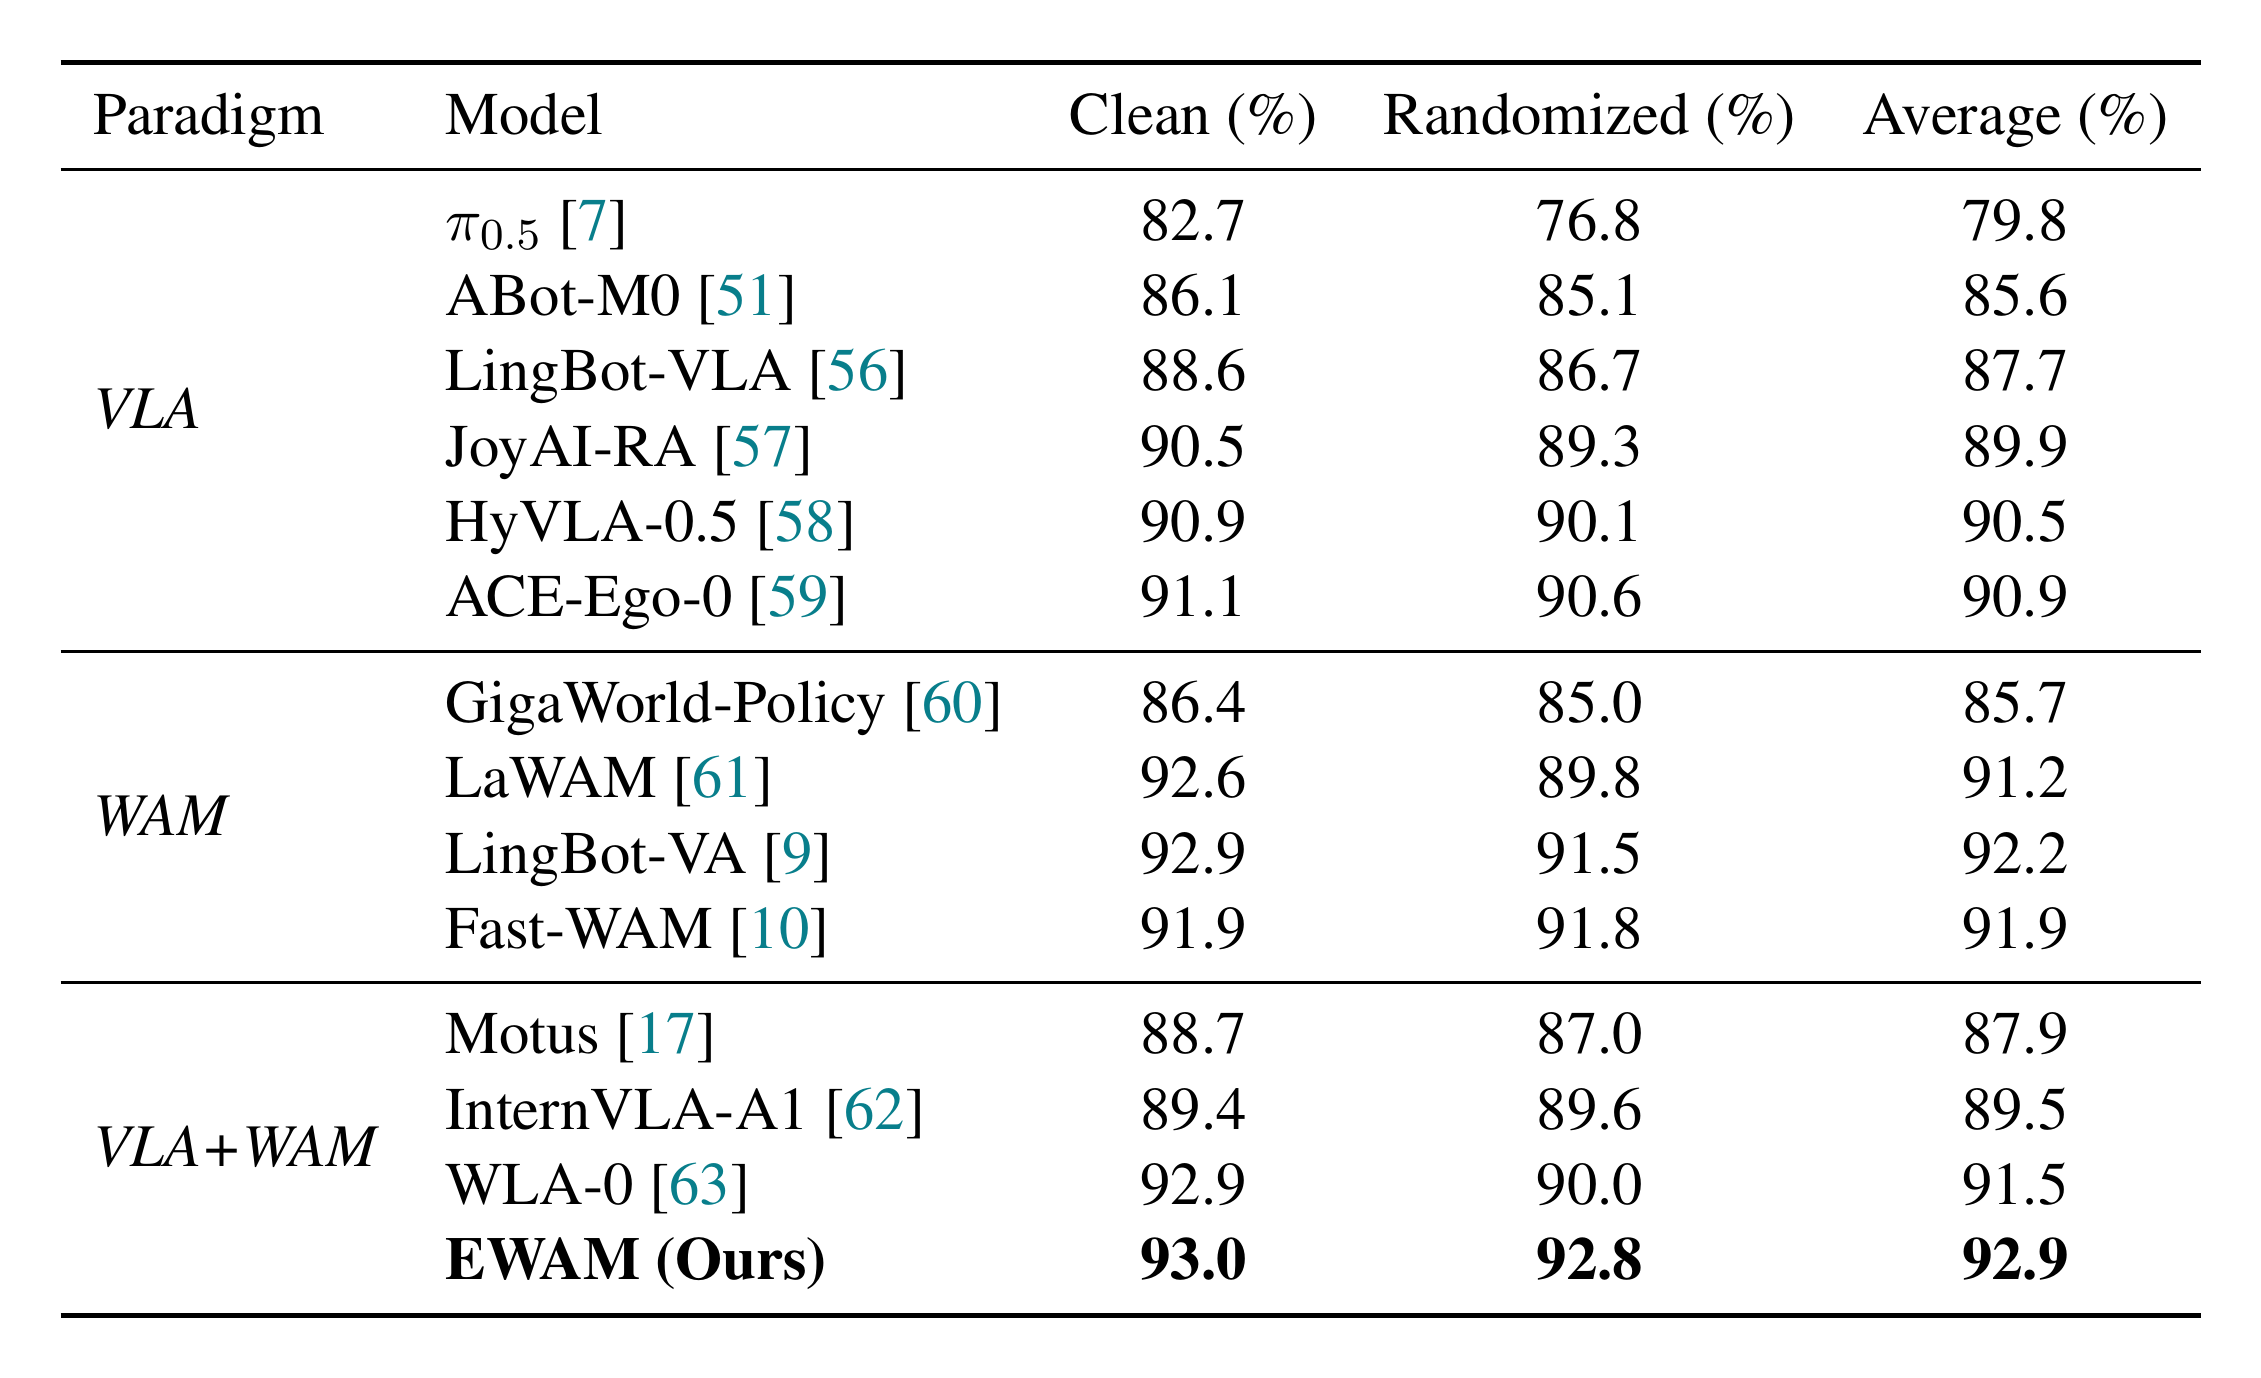
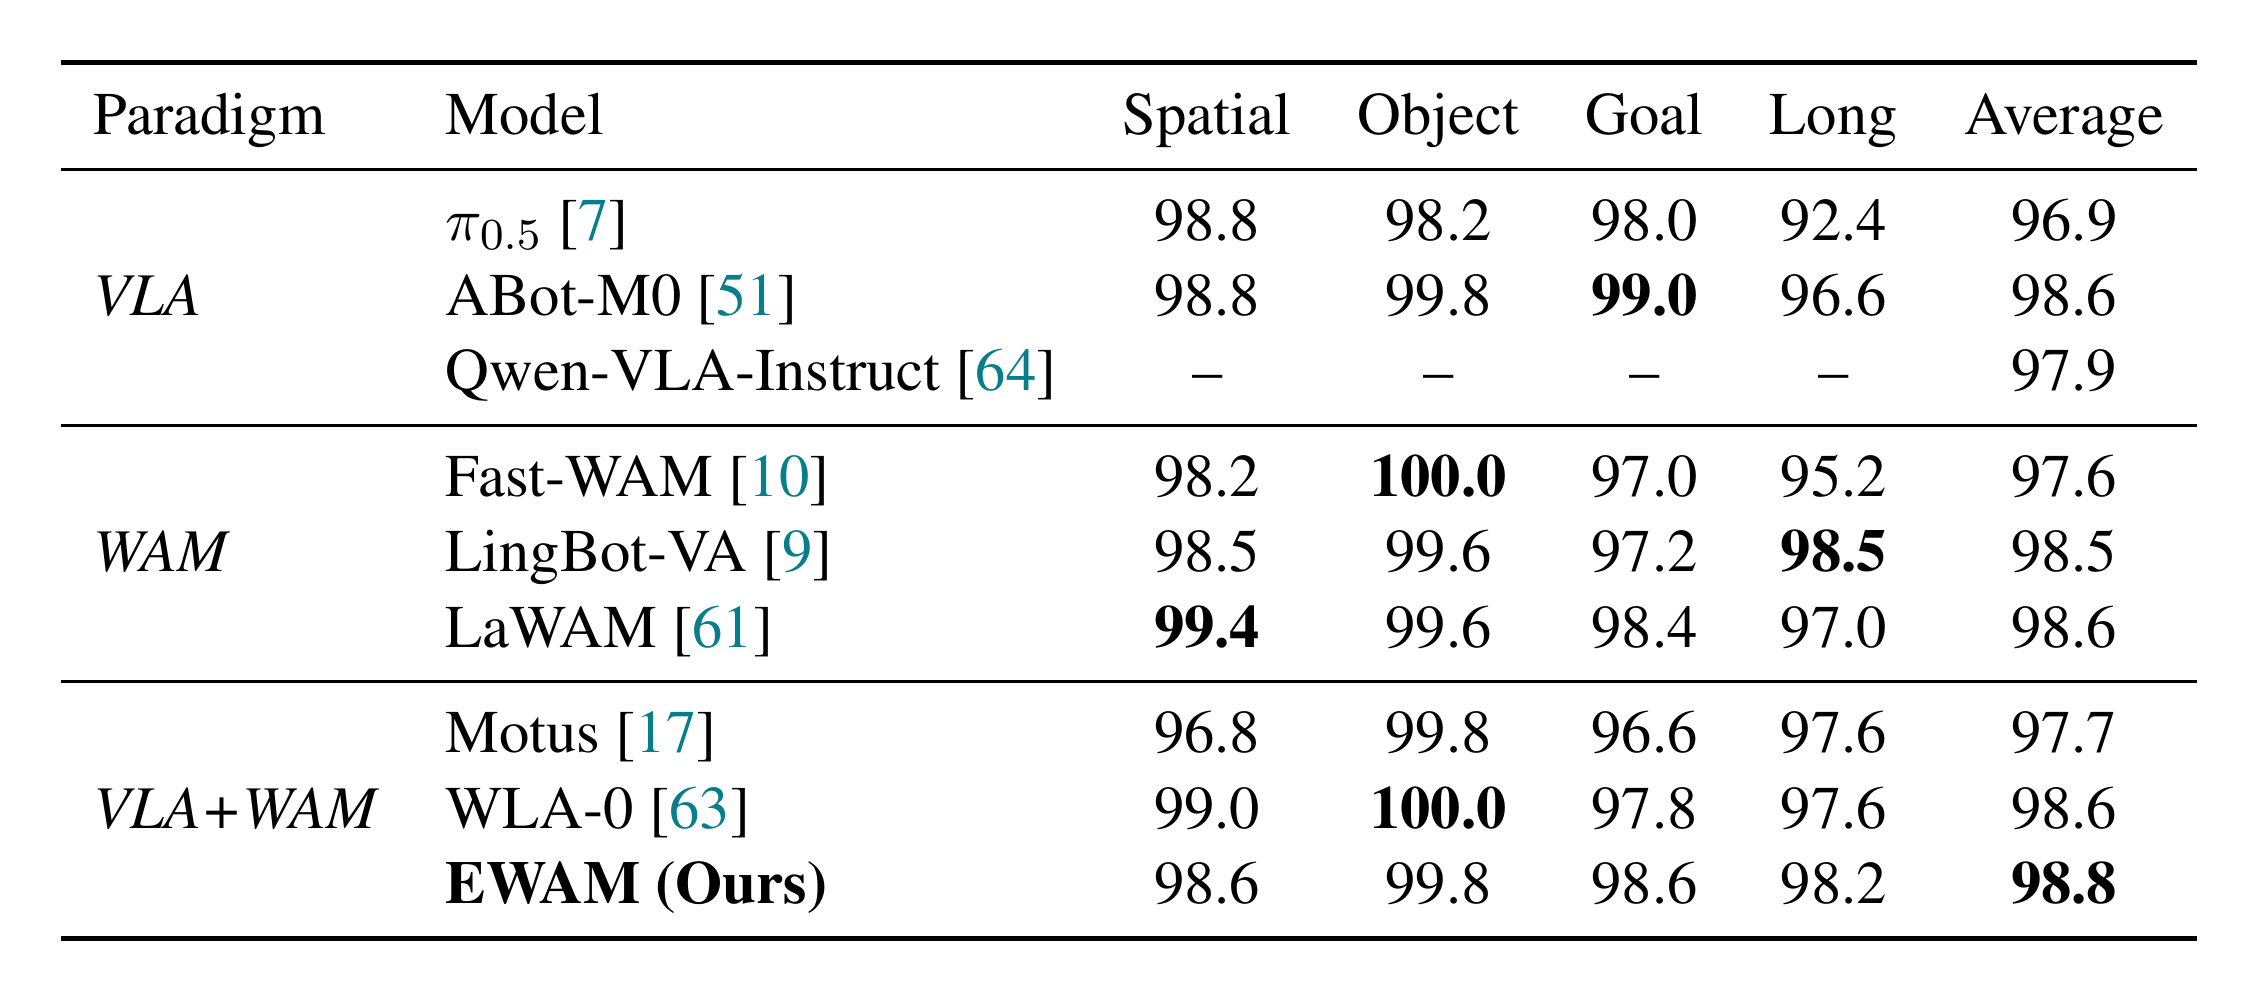
在干净和随机示范都参与训练的 in-domain 设置下,EWAM 干净场景 93.0%、随机场景 92.8%,平均 92.9%,高于 VLA、WAM 和混合路线里各自最强的基线。LIBERO 上四个套件平均 98.8%,是表中最高的;EWAM 的特点是各场景表现均衡,四个套件都在 98% 以上。
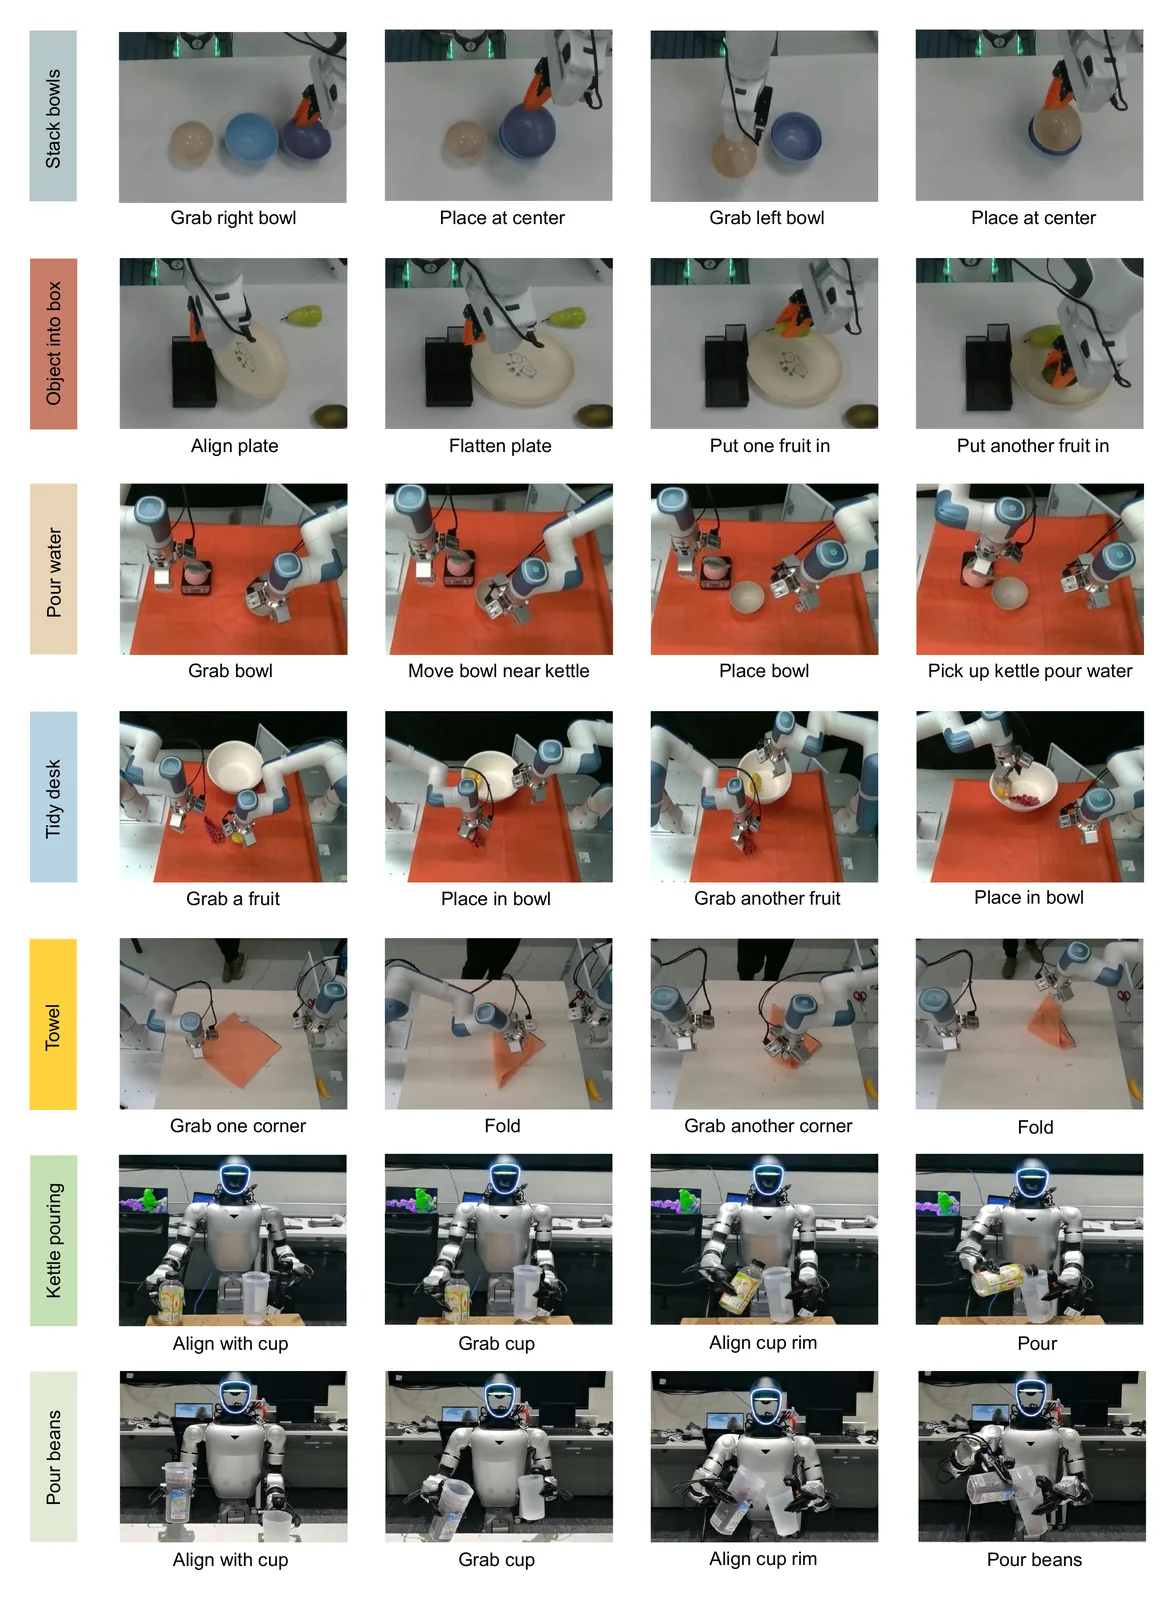
真机部分,团队在 Franka 单臂、Dobot 双臂和 Unitree G1-D 人形三种本体上测了 7 个任务。
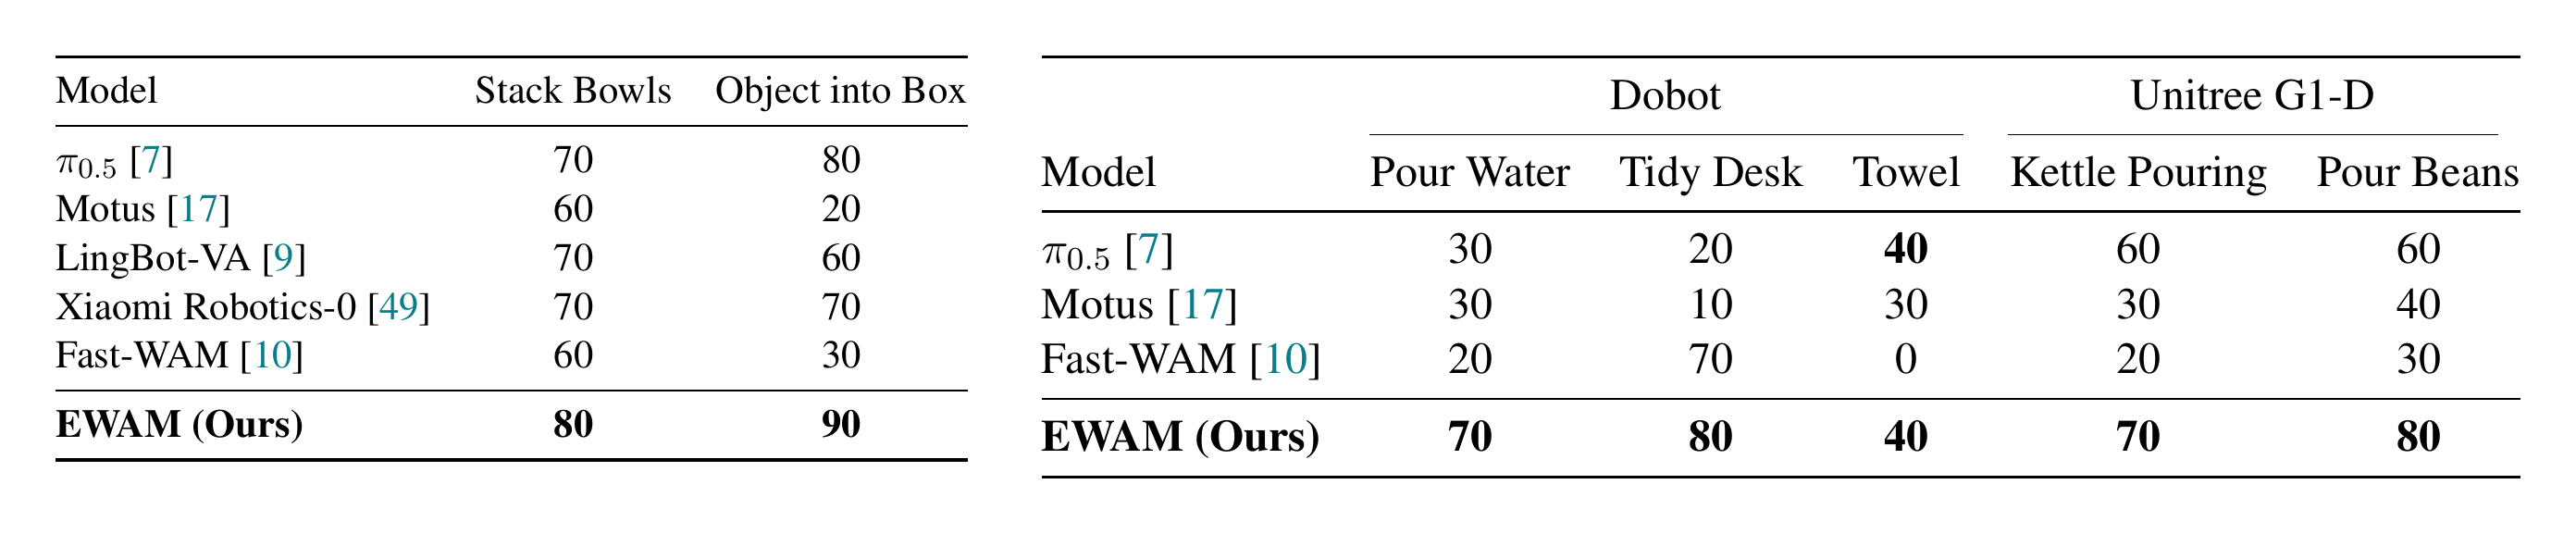
EWAM 在 7 个任务上都是表中最高,7 个任务平均 72.9%,π0.5 是 51.4%。基线方法常常偏科:π0.5 在 Dobot 倒水和整理桌面上只有 30% 和 20%,Fast-WAM 整理桌面有 70%,叠毛巾却是 0。
07. 人类数据能帮多少?
真机数据贵、采得慢,团队也测了人类数据能补上多少。
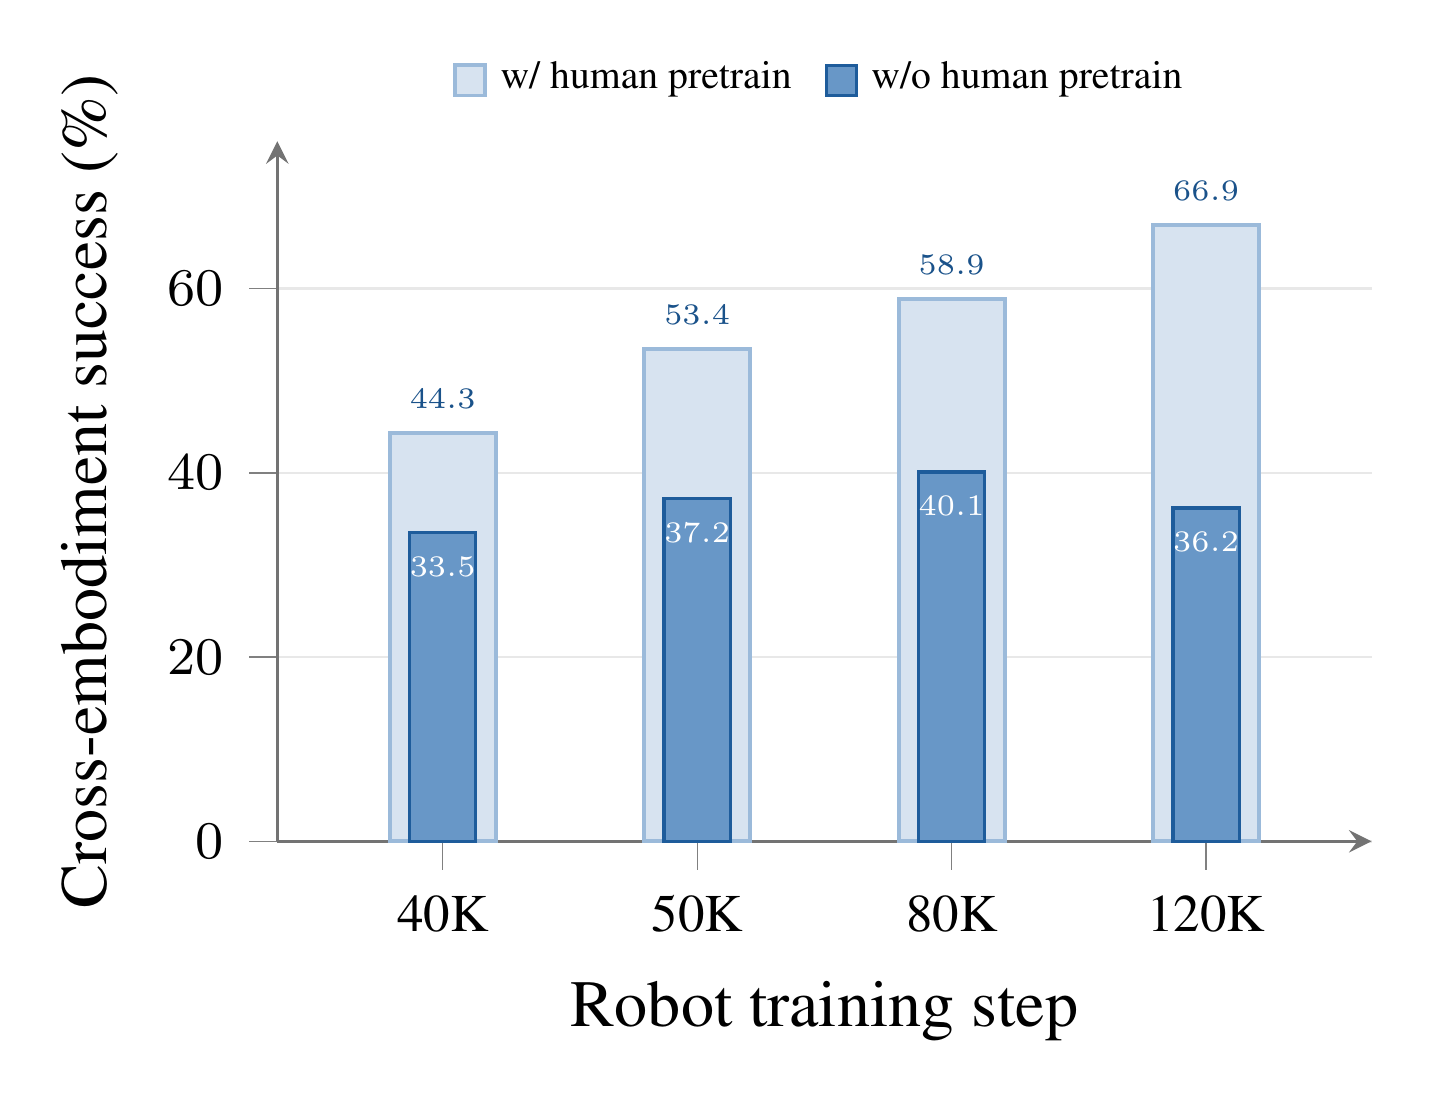
第一个实验看公开的人类视频。在 RoboTwin 里用 ARX-X5、UR5、Franka、Piper 四种机器人训练,再到没见过的 Aloha-Agilex-2 上测试。两组设置完全相同,区别只在于是否从人类视频预训练开始。同样训练 12 万步,成功率从 36.2% 提升到 66.9%。
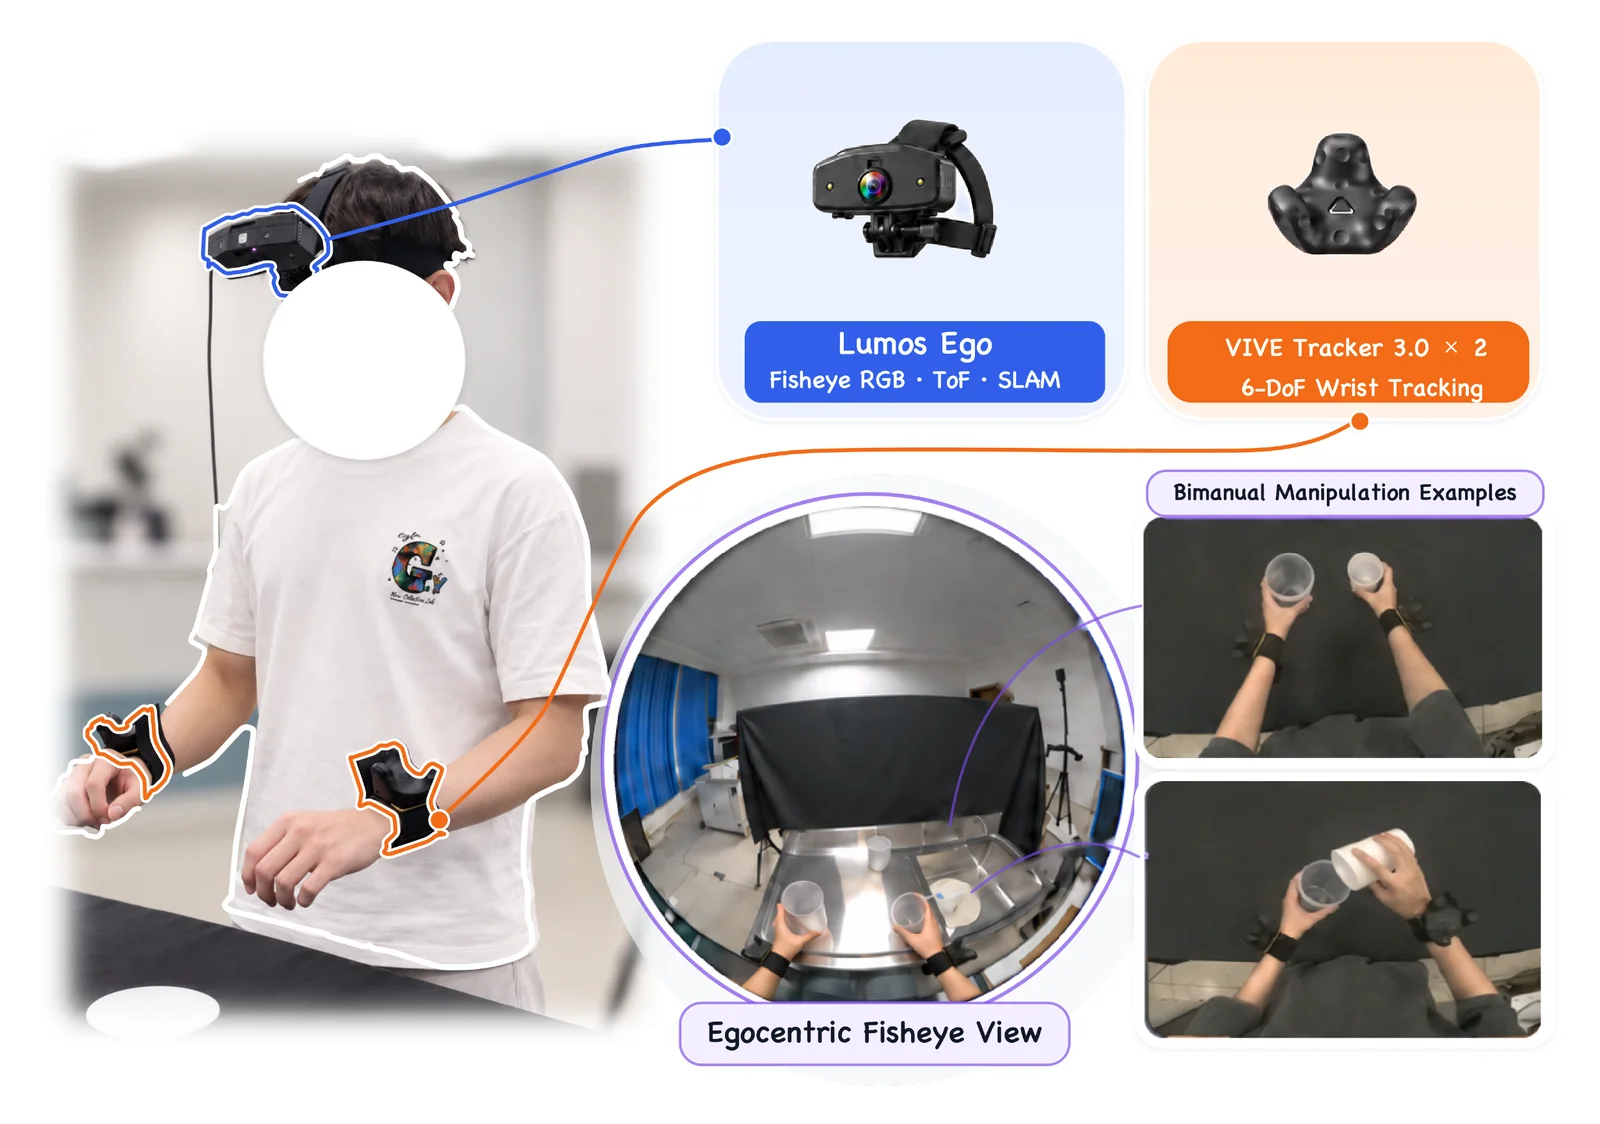
第二个实验看自采的人类示范。团队搭了一套采集系统:操作者戴 Lumos Ego 头显,两只手腕各绑一个 Vive Tracker 3.0,录下第一视角画面和真实尺度的手腕运动,再转成机器人能用的观测-动作轨迹。
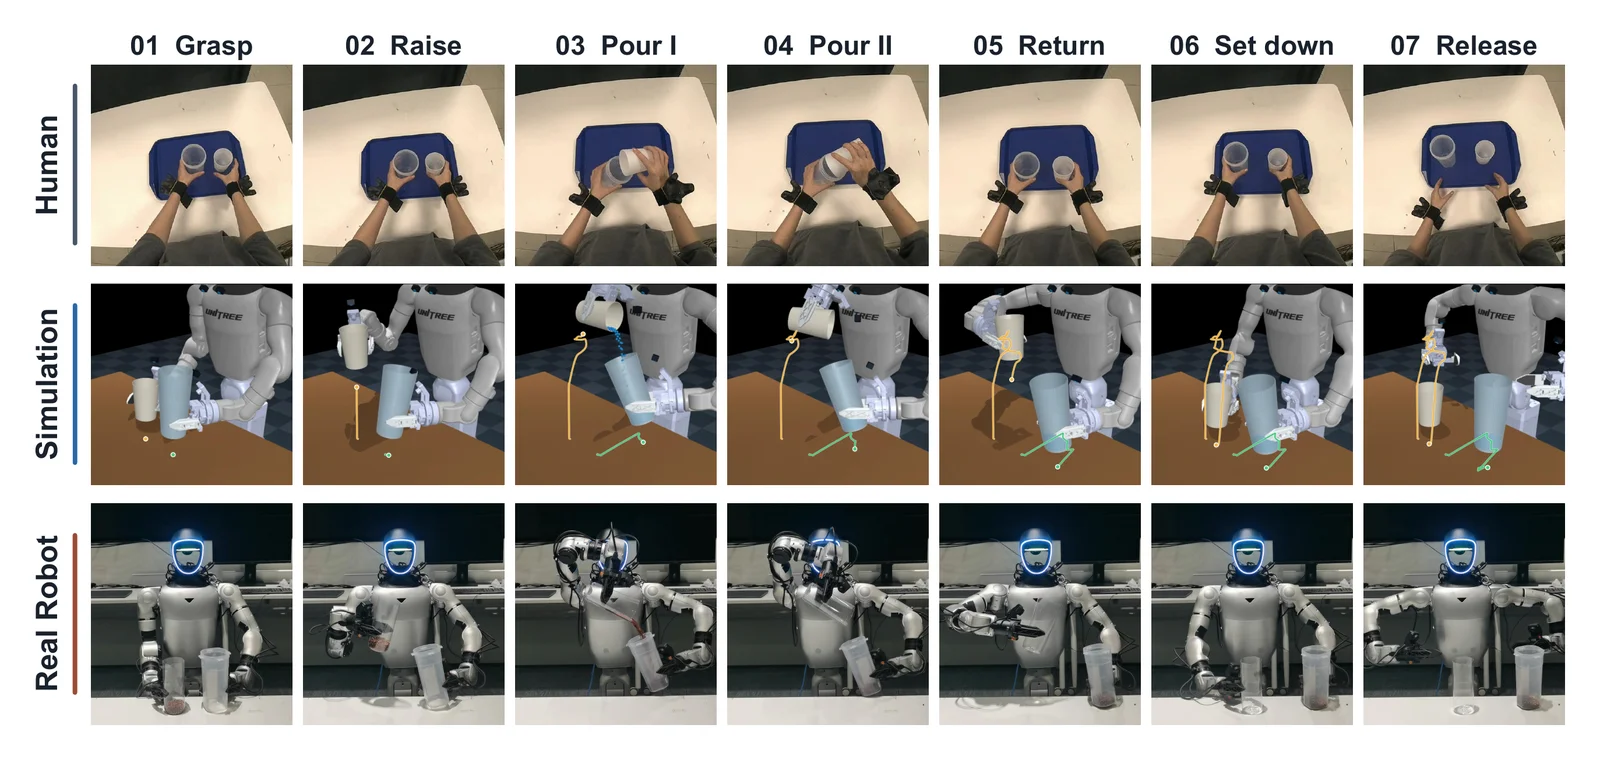
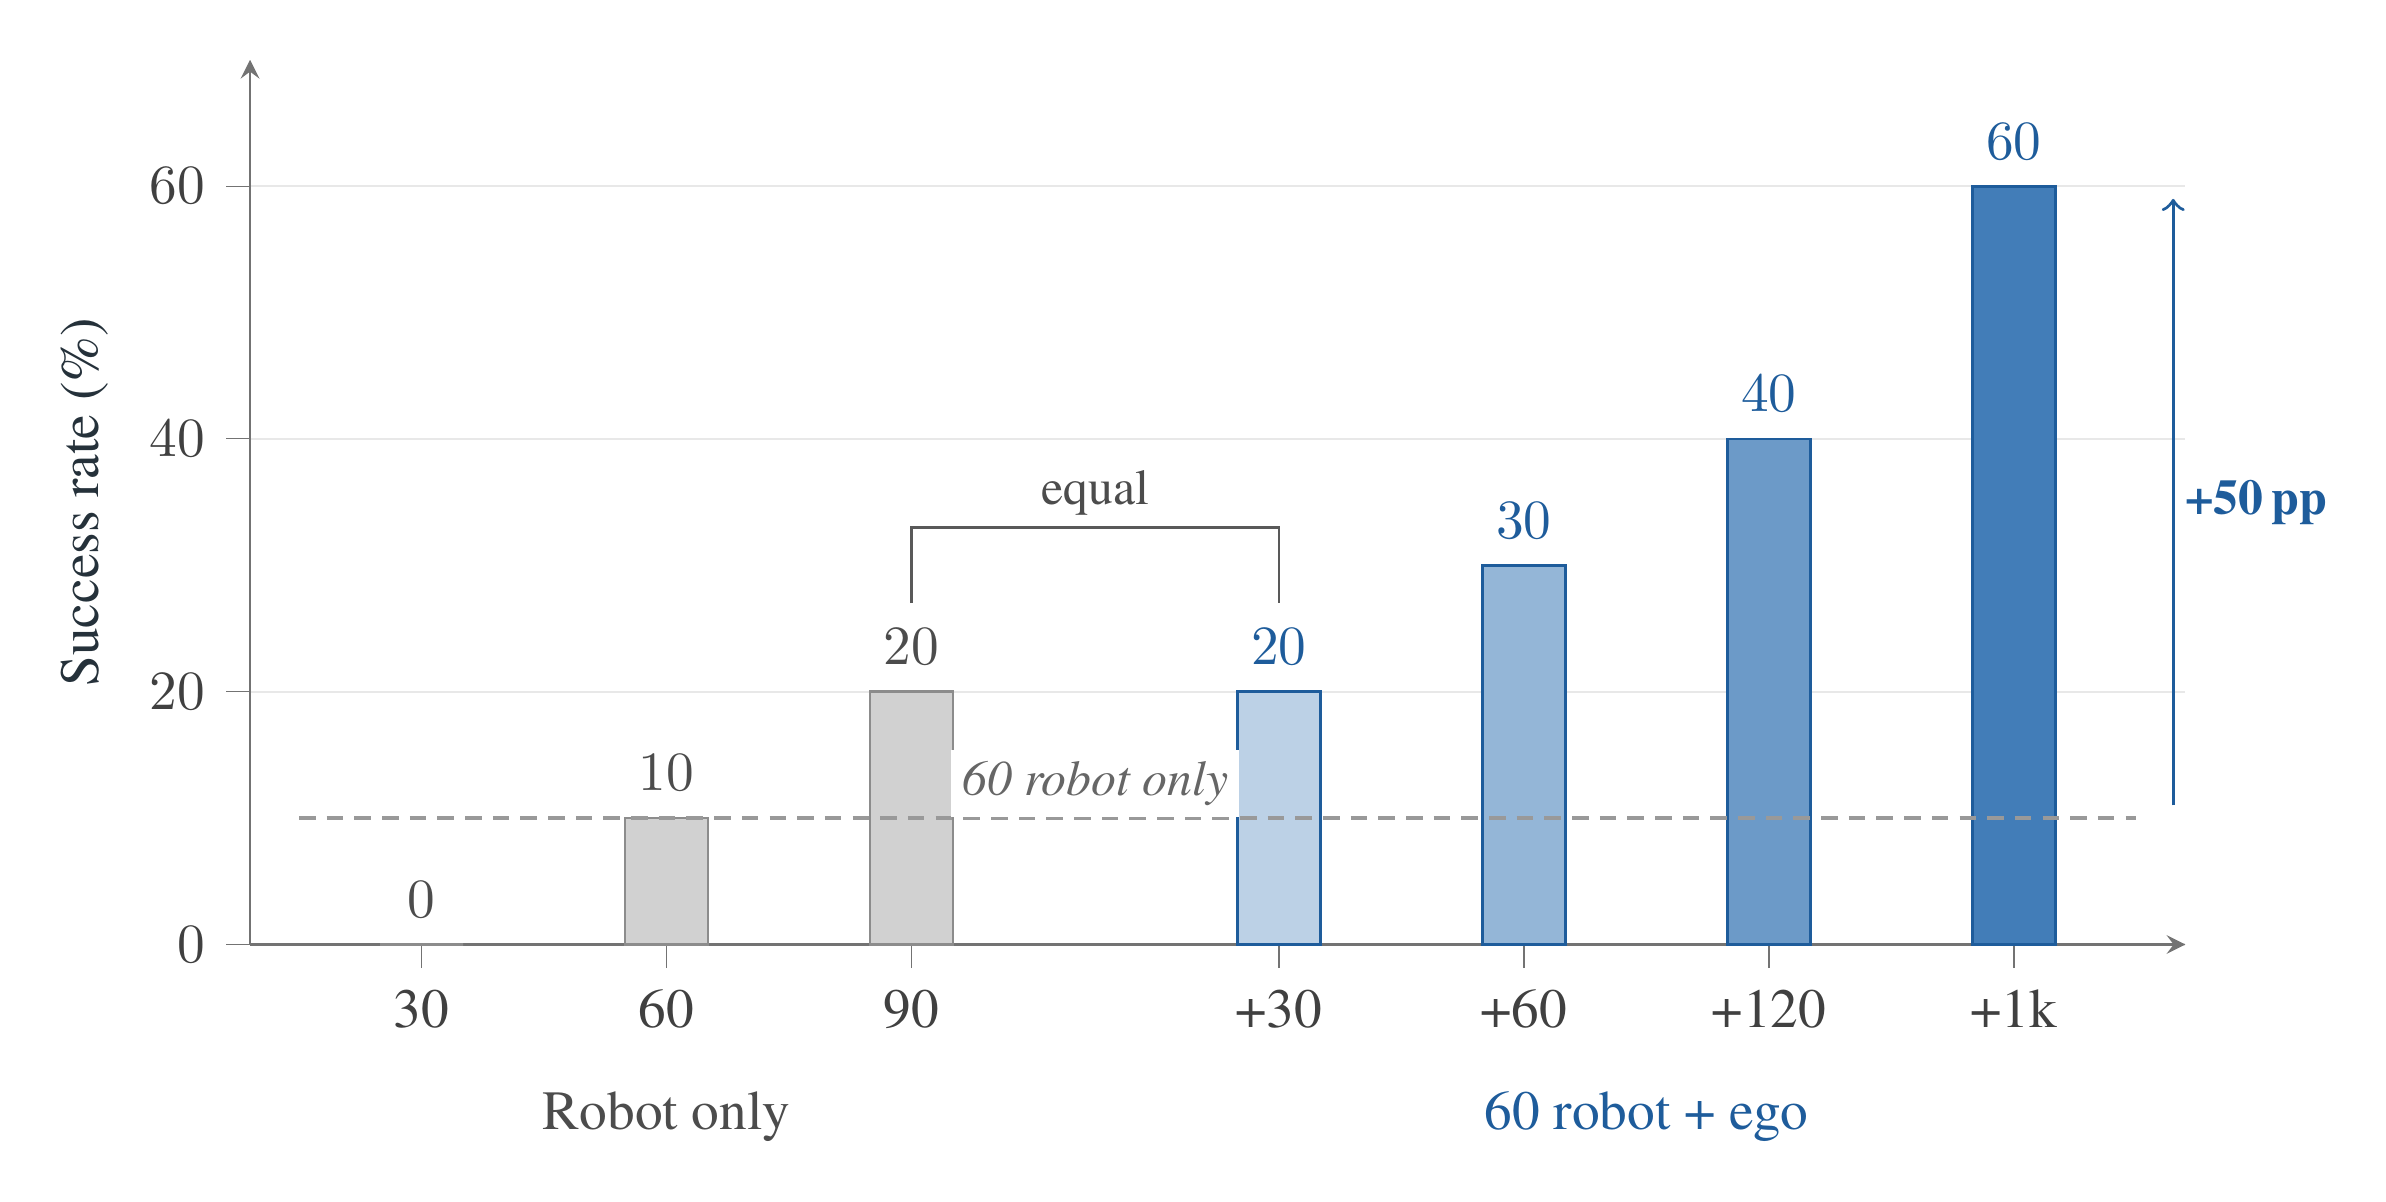
在换桌布、换杯子的倒水测试里(不使用任何 EWAM 预训练),只用 60 条机器人示范,成功率是 10%;加 30 条人类示范到 20%,和 90 条纯机器人示范一样;人类示范加到 1,000 条,成功率到 60%,曲线还没有饱和。这套采集不需要机器人在场,成本比遥操作低得多。
08. 长程任务:知道自己做到哪一步
长程任务里,机器人经常不知道自己做到哪了:一步失败后反复重试,或者直接跳过某一步。EWAM 在后训练时可以加两个轻量的头,一个预测当前在做哪个子任务,一个预测这个子任务完成了多少,不需要外部规划器。
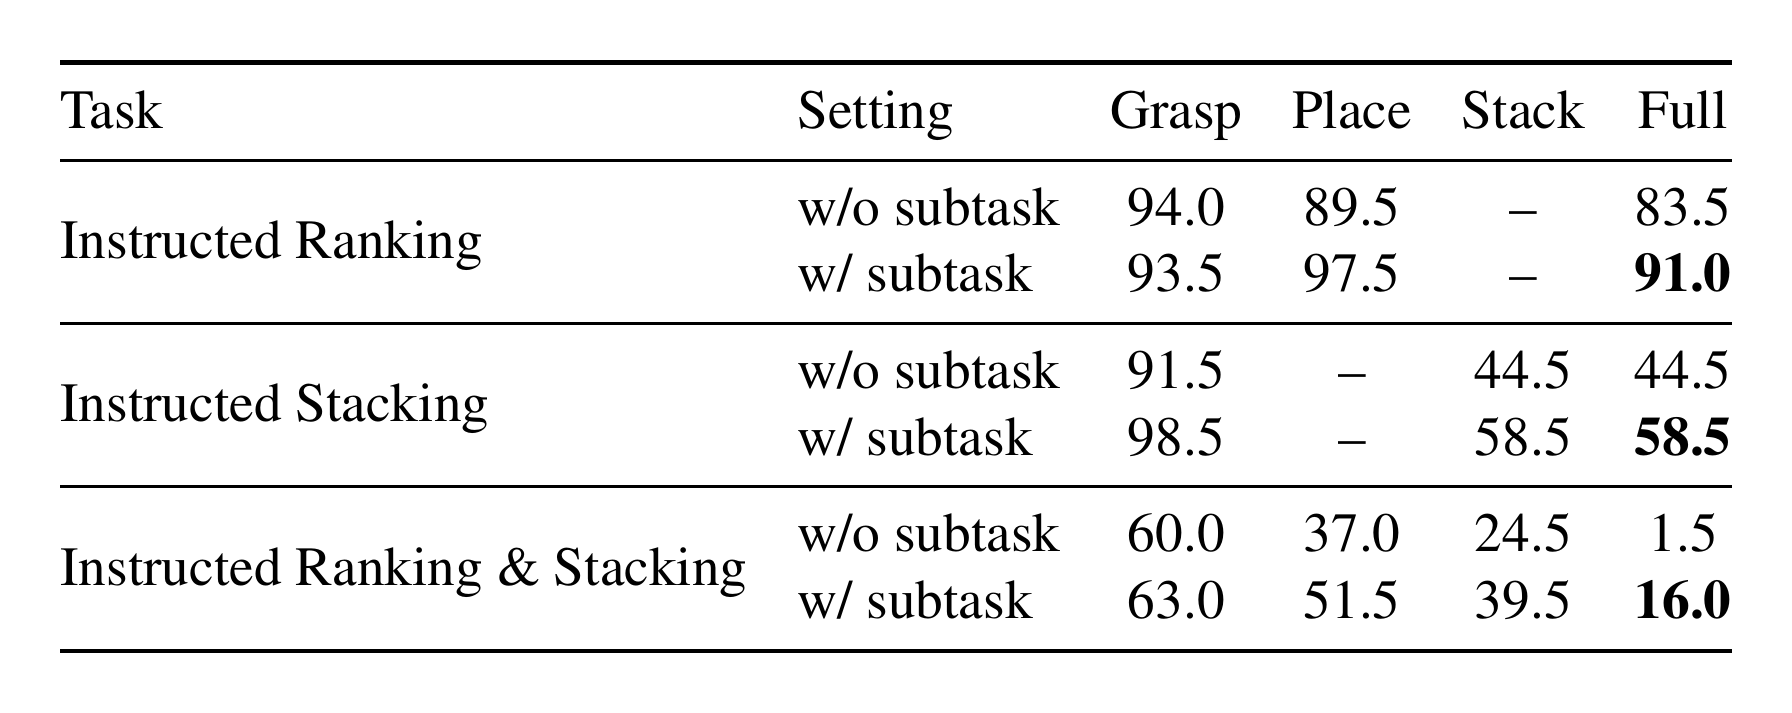
团队在 RoboTwin 积木场景上改了三个按指令执行的长程任务,每个测 200 个 episode。加了子任务监督后,指令排序从 83.5% 到 91.0%,指令堆叠从 44.5% 到 58.5%,最难的排序加堆叠从 1.5% 到 16.0%。
提升主要出现在后面的步骤:排序任务的抓取率几乎没变,放置率从 89.5% 提到 97.5%。子任务监督帮模型的不是怎么抓,而是抓完之后下一步做什么。
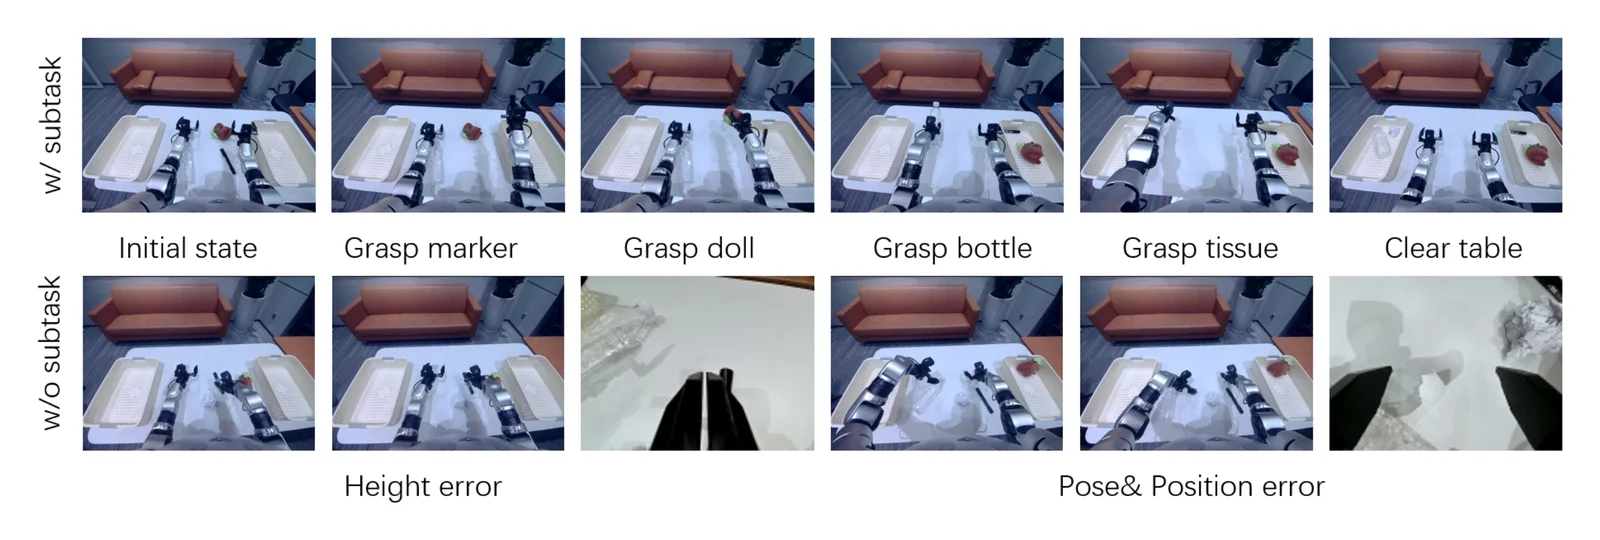
真机上,G1-D 要把桌上的玩偶、马克笔、纸巾和水瓶分进两个篮子,有用的放右边,垃圾放左边。加入子任务监督后,平均正确放置的物体数从 1.0 个提升到 2.2 个。加了子任务监督的模型在马克笔上抓不起来时,会先去处理别的物体,回头再试;没加的则一直卡在同一个失败的抓取上。
09. 总结
回到开头的问题:机器人能不能在没人教的情况下学会先理解、再想象、后行动?EWAM 的答案是可以。只要把理解、想象和行动放进同一个网络,并让动作在每一层都能自由取用信息,这个顺序就会自己长出来,而且动作确实依赖它。
这套"按来源统计注意力、再按层屏蔽"的方法,也可以拿去检查别的多专家模型:接进来的预测分支到底有没有被动作用上,又是在哪一层被用上。
目前这套分工对所有任务都是一样的。接下来,团队希望模型学会看情况分配精力:指令含糊时多花几层去理解,局面不确定时多想象几步,动作明确时更早进入执行。
代码和四个 checkpoint(跨本体预训练、RoboTwin clean-to-random、RoboTwin in-domain、LIBERO)均已开源,链接见文首。