AI 能否改进自己的推理、训练方法和 Agent 系统?
当模型能够生成改进方案、构建实验环境、验证结果,并将有效改进带入下一轮迭代,我们距离真正的 RSI(递归自进化)还有多远?
RSI 正在成为 AI 研究中的一个重要议题,但它并不是一个边界清晰、人人理解一致的概念。
Self-Evolution、Continual Learning、Test-Time Training 等方向究竟有什么联系与区别?
模型性能持续提升,是否就意味着 RSI 已经发生?
自我改进的能力能否形成正反馈,又会受到哪些技术瓶颈、评测方法与基础设施的限制?
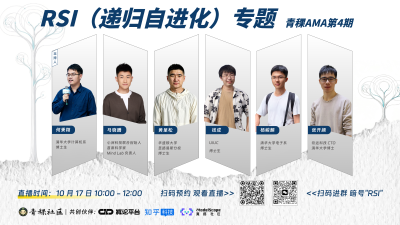
在 10 月 17 日,青稞AMA 第 4 期:RSI(递归自进化)专题中,青稞社区邀请到来自学术界与产业界的六位研究者,围绕 RSI 的概念边界、技术路线、能力天花板、基础设施、评测方法与实现判据进行了讨论,并延伸到人类研究者的角色变化;同时强调不预设 RSI 必然到来,而是关注哪些机制已被验证、哪些能力仍有缺口、什么证据才能证明系统真的在改进自身。
参与嘉宾有:
- 主持人|何秉翔,清华大学计算机系博士生
- 马骁腾,心洲科技联合创始人、首席科学家,Mind Lab 负责人
- 黄呈松,华盛顿大学圣路易斯分校博士生
- 钱成,伊利诺伊大学厄巴纳-香槟分校(UIUC)博士生
- 杨峻麟,清华大学电子系博士生
- 张开颜,衔远科技 CTO
浅识一下
何秉翔(主持人):
大家好,欢迎来到这一期青稞 AMA,今天希望跟各位嘉宾讨论的主题是 RSI(Recursive Self-Improvement,递归自进化)。
简单介绍一下自己,我目前是在 THUNLP,读直博三年级,平时也会做一些后训练,强化学习,最近比较关注 RSI 相关的 Topic。很荣幸来做这一场的主持,也有不少问题希望能跟各位讨论出一些火花。
我们可以看到,Anthropic 披露自今年 5 月起,其合并代码的八成以上都出自 Claude。OpenAI 也披露,至 8 月中旬,其研究部门 Research Agent 的运行时长,已经达到普通研究员工作时长的 3.1 倍。由此可见,写代码、跑实验这类工作,已经大量交由 Agent 完成。
说实话,RSI 这个概念在这一年被使用得比较宽泛:从模型修改自身输出,到 AlphaEvolve 搜寻更优算法,再到 AI 自主开展 AI 领域研究,都被纳入 RSI 的讨论范畴。
希望借今天这两个小时,和几位一线嘉宾把话题聊得更具体:究竟是什么在进化、何种反馈在驱动闭环、闭环最终在何处达成。
今天我们准备了若干问题,下面先请各位嘉宾依次做个简短自我介绍,之后我们再围绕各个问题展开讨论。先从骁腾博士开始,请您做个自我介绍。
马骁腾:
大家好,我也是青稞的老朋友了,之前我们有好几个工作都来青稞做过一些分享。我是 Mind Lab 的联创马骁腾,主要是负责我们 Lab 的 Research 工作,我们主要是关注怎么在真实的场景里面做 Continual Learning,核心是围绕 RSI 做一些像 LoRA 这种 Training 的 Service 。目前我们也希望尽可能把实际生产中的一些任务,变成 RSI 化的 pipeline,降低交付成本,让模型能够持续在真实环境里面去学习。
何秉翔(主持人):
谢谢骁腾博士,然后下一位要不请开颜博士来给大家自我介绍一下。
张开颜:
大家好,我是张开颜,博士毕业于清华大学电子系,现任衔远科技 CTO。目前我们也在主要做 AI4AI 相关的工作,包括怎么用 AI 快速的构建以及持续优化 AI,服务于各类场景,面向企业、科研与工程场景打造专业的 AI 模型和智能体。后面希望和大家多讨论,分享我们在工业落地场景中遇到的 AI4AI、RSI 相关问题。
何秉翔(主持人):
下一位请呈松博士做一下自我介绍。
黄呈松:
我现在是华盛顿大学圣路易斯分校博士四年级的学生,过去的相关工作,大多围绕语言模型利用自身合成数据迭代提升性能展开。此前在青稞有幸介绍过 Rzero、Environment Harness,都是这方面的工作。
何秉翔(主持人):
好,下一位邀请钱成博士。
钱成:
谢谢秉翔,我是钱成,现在是 UIUC 三年级的 Phd ,我也是青稞老朋友了,不久前刚在青稞这边介绍过 AI4AI 的相关工作,我自己主要做各种各样的 Agent 和 To Learning 相关工作,目前也在关注 RSI 和 AI4AI 的方向,期待今天和各位嘉宾的讨论。
何秉翔(主持人):
请峻麟博士。
杨峻麟:
大家好,我是杨峻麟,我是清华大学博士一年级,很荣幸能和大家一起交流。我主要关注 Agent,早期做过一些电脑使用智能体,之前也跟开颜师兄合作做了 Frontis-MA1,探索在 MLE 场景下如何实现 Meta Evolution 和 AITrainAI,这次来主要也是跟大家多多请教多多学习。
何秉翔(主持人):
各位嘉宾的自我介绍已经结束,我们正式进入讨论环节。在深入探讨 RSI 这一主题前,有一个绕不开的问题:我们先从定义聊起,应当如何定义 RSI?目前大家口中提到的 RSI,所指代的往往并不是同一件事,很多时候完成某一项工作,就会被称作实现了 AI Evolve AI 或是 RSI。
今年也已经有一些博客专门梳理了 RSI,或是 Self Evolving Agent 的分类方式,例如例如可以按照进化对象拆解:进化的是 Model、Harness 还是 Artifact。
接下来想听听各位的观点,大家心中 RSI 的定义是什么。举个例子,为什么缩写选用 Recursive,而不是 Iterative?期待听听各位的想法。我们先请开颜博士分享。
如何定义 RSI:Recursive 与 Iterative 的区别,Evolve 的对象是什么
张开颜:
我觉得这里的概念区分问题还是挺大的。刚才各位自我介绍时都提到了 RSI、AI4AI,我认为首先要厘清,我们当下做的其实是 AI4AI。
因为 RSI 里面有 R,还有 S,其中 S 也就是 Self,这个定义非常关键。在我理解中,RSI 更多是针对整套 AI 系统,包含数据构建、模型训练、后面的 Infra 推理优化等等,进行系统层面的工程优化。而我们大部分工作,是用一个更强的 AI 去优化、训练一个专用 AI 或者说 Specific AI。因此我认为,我们做的更多属于 AI4AI。
再说回前面提到的 R,可能中文来说就是迭代和递归。迭代更多的是针对同一件事循环执行;而 Recursive 递归的含义是,我们搭建的 AI 系统,包含模型、Harness、Agent整个系统,再到训练数据、训练与推理全链路,我们怎么利用 AI 改进这套系统;改进完成后产出更强的模型,这个更强的模型反过来继续优化这套系统。
最典型的例子是 Anthropic 之前博客里的一张示意图:最开始他们构建 Claude 3.5,接着迭代到 Claude 4,再开发出 Claude Code;Claude Code 反过来继续优化 Claude Code 整套系统,优化训练流程、合成数据、推理等环节,整套系统持续变强。这就是我理解的 RSI。
真正的 RSI,是整套 AI 系统持续自我增强。从这个角度看,这类工作大多是基础模型公司才有条件开展;我们大量实践的属于 AI4AI,用一个强 AI 去构建另一个专业 AI,而不是对自身整套系统做闭环优化。
以上是我目前对 RSI 和 AI4AI 的理解,算是抛砖引玉,欢迎大家后面讨论指正。
何秉翔(主持人):
明白,下面请呈松博士来聊聊您的看法。
黄呈松:
我最近的工作,大多强调以 Data 作为媒介提升 Model 的性能。我理解的 Recursive Self Improvement,需要找到一种方式,让 Model 通过一系列方法提升自身性能。我过去工作的核心想法是:不管训练端采用什么算法,都需要对应的训练数据提升模型性能。模型可以自己生成新的 Data 以及充足的训练信号,模型在这批 Data 上训练,实现 Self Improvement。训练方式可以是传统 RL,或是现在大家常用的 Harness Optimization 这类方法。
在我眼中 Recursive 就是模型生成 Data 提升自身,再继续生成新 Data、继续提升自身。通过不断生成能够增强模型能力的数据,持续提升模型效果,也就是 Self Evolving,所谓的 Recursive Self Improvement。之所以选用 Recursive 这个词,就是希望这个过程可以持续循环发生。
当然目前这套方法还存在一些问题,后面的讨论我们可能会可以讨论到这一点。我们希望这个 Recursive 过程尽量减少 Human In The Loop,最好完全不需要 Human In The Loop,依靠生成 Data 让 Model 提升自己。
我最近的工作会从 Text Reasoning Model 的数据、还有 Agent 的 Environment 角度来思考这个问题。对于包含语言模型的系统,通过读取、处理数据提升自身性能,这个过程本身就属于 RSI。在此基础上,我们还可以再套一层,如何生成这样一批 Data,让模型更好地完成 RSI。
何秉翔(主持人):
好,峻麟博士,这里面最年轻的一位。
杨峻麟:
今天主要也是跟大家请教。我觉得开颜博士和呈松博士说的都非常有道理。我感觉完全符合定义的 Recursive Self Improvement,大概率是在大厂里面率先落地。毕竟要让基础模型系统真正改进自身、参与下一代模型的迭代,需要大量算力和训练能耗。
OpenAI 技术报告里有一个很务实的定义,开发下一代模型时,统计 GPT 参与研发的百分比。这个定义虽然依旧存在 Human In The Loop,但能直观体现我们距离 No Human In The Loop 还有多远。能看到 GPT 每一代发布之后,AI 在研发中的占比都在提高;占比达到 100% 之后,就不需要人工参与了,我觉得这个对RSI的定义或者测量方式很务实。
何秉翔(主持人):
好,钱成博士。
钱成:
我之前做过一些相关工作。就像开颜最开始提到的,我做 AI4AI 相关的工作会更多一些。不过我之前也在想,怎么把 AI4AI 和 RSI 关联起来:如果 AI4AI 里,前一个 AI 和后一个 AI 是同一个模型,这种情况算不算 RSI?这个问题,我也想听听开颜博士的看法。我之前觉得,这或许也是 RSI 的一种可行模式。
当然,说到 RSI 本身的定义,在我看来,关键要看我们提升的是哪个层面。如果要给 RSI 下定义,要分清我们优化的是模型本身,还是模型外部的组件,比如 Harness 这类模块。
从方法层面,可以像呈松说的,从 Data 的角度切入;或者像峻麟说的,从人类参与度的角度来定义。
还有一个视角:当我们讨论 RSI 的时候,系统边界到底划在哪里?得先把这个界定清楚,后面才更容易形成统一的定义。我觉得现在大厂不管是外层的 Harness、Environment,还是内层的模型,都在同步做优化。关于这一点,我也想再向开颜请教一下看法。
张开颜:
Ok,那我就再补充一下。我觉得,确实 AI4AI 里面两个 AI,我们可以讲一下,我们之前有一篇 Survey,在5月份发布的 Self Improvement AI Agent 的 Survey,在里面我们也做了一个分类。这两个哪个更大,我觉得可能不太好判断。但是,如果这两个 AI 是同一个,那么可能就是自己去优化自己了。这确实和 RSI 的一个定义比较像。其实我们做的大部分工作,并不是 For 自己。就像钱成还有前面几位同学提到的,如果是让 AI 它自己去生成数据去 Train 自己,包括之前很多 Self Play 的一些工作,我觉得可能算是某种 RSI。
我们在做的可能更多的是,第一个 AI 它去优化的是第二个 AI,不是同一个 AI。在场景上面,我们当时提了两类:第一种可以叫 Self-Evolving,第二种我们更称它为 Meta-Evolution。第一个 AI 它可能是一个具体的 Task AI,第二种里面的 AI,它是一个 Meta 的 AI 或者 Meta Agent,最近有工作在讨论这类方向。在这种场景下面,我们是用一个 Meta AI 去构建更多适配不同场景的专业的 AI。那么,我觉得它可能是一种广义的 RSI,但严格来说,它确实不是 Self。
我们一直在做的就是这样一件事情:用一个 Meta AI 去构建和优化 Task AI,这两个 AI 就不是同一个 AI。在这里面,训练 Meta AI 的能力,就是改进“构建与优化其他 AI 的能力”。这种能力我觉得在递归改进里面也很重要。在 RSI 里面,我们其实没有区分两件事:模型本身解决任务的能力,以及模型改进自身的能力。这两个能力我觉得是不一样的。我们现在做的,虽然说是 AI for AI,做的是一个 Meta 的 AI,我觉得这种 Meta 能力在 RSI 里面也是很重要的。但在 RSI 的讨论里面,现在大家可能更关注最终的效果。
刚才峻麟提到 OpenAI 的思路,关于自我改进的这类数据,大家虽然有关注,但目前还没有特别严格的衡量公式。不过我们刚才聊到,如果具备 Meta 改进能力,它对能力提升斜率的刻画,是一个很好的角度。
何秉翔(主持人):
最后我们请骁腾老师,骁腾老师也是作为工业界的代表,可能比如从工业界的视角来看,我们怎么定义 RSI。
马骁腾:
我觉得大家说的都非常有道理。不管是 RSI 还是 AI4AI,Hype 的比重都比较大,大家实际在做的还是 Post Train 和数据相关工作,基本都是这几年的事情。我想提出两个视角来看当中的变化,解释为什么我们会从 RSI、AI4AI 的角度看待模型训练:一个是奖励函数或者可验证环境的生成,另一个就是数据来源。
关于奖励和环境:最开始训练模型,我们依靠人做 RLHF 对齐;后来引入 Verifier,基于各类可验证奖励做对齐,但本质上还是依靠人工制定的 Rubric 来对齐。到现在,我们认为模型可以自己生成 Verifier 去判断对错。我的感受很明显,今年年初我还在研究怎么做 RLHF、训练好的 Reward Model,现在思路完全变了,只需要用更强的 B 端模型做价值判断。
我和很多大厂的同学交流怎么构建环境,他们的答案就是换更强的模型。这里有一个根本性差异:以前开源模型做不到这件事。我记得今年 1 月,我用 Qwen3 30B 做标注,它和人类的对齐分数只有 60~70。但现在提升非常多,有 GLM、DeepSeek V4、Kimi 这类强能力模型。这给我们做 Skill 方向的创业公司带来机会,过去我们没法调用 Claude 迭代,现在可以基于 GLM、Kimi 迭代。
第二点是数据。我觉得工业界更大挑战是数据。搭建环境、启动训练,各位老师都可以快速实现,但获取有效的数据是很大难题。开场前我们聊到很多人在做 AI For Science,我的理解是很多领域的问题已经不值得深挖,而科学领域仍然是值得挖掘的数据与问题方向。
还有一个更重要的话题:AI 本身没有能力自主获取更多数据。想要数据,只能采购。Anthropic 直接收购公司拿到数据,这还能叫 AI4AI 吗?我觉得这是 Money For AI。假设我们拿到这批数据,打开之后会发现噪声巨大,大部分数据对模型提升没有价值,里面混杂好坏不一的用户反馈。模型能不能在这些高噪声数据中识别出可供提升的信息?
目前我认为这项能力还很弱。之前我们讨论 AI,讨论的是 AI 怎么替代基础设施工程师、Post Train 工程师。而现在更大的议题,是 AI 如何替代产品经理:怎么基于历史用户数据判断产品效果。这件事目前很难解决,模型和人的评价标准很难对齐,仍然需要大量人工参与。
何秉翔(主持人):
产品经理这个视角非常独特。我简单总结一下,刚才大家聊到 RSI 有几个关键点:由谁来驱动,是 Self 驱动,还是 Meta AI / 更强的 AI 来驱动;同时也讨论了进化的对象,可以是模型权重,也可以是外部 Harness,甚至是环境、数据等。大家也提到了不同的技术路线,比如从数据或者环境出发,同时聊到了各类技术瓶颈。
接下来这个问题,我们继续从技术路线展开。目前学术界、工业界,已经存在哪些相关技术路线?如果大家想要落地实现 AI4AI 或者 RSI,可行路径有哪些,以及为什么会选择主攻这条路线?
要不我们也先请钱成博士讲一讲自己的看法?
RSI 的技术路线有哪些,各自会 Battle 哪条路线
钱成:
我是这样看的。就像上一轮我说的,RSI 首先和你要提升的 Component 有关系。总体来说我大概分成四类:
· 第一类是数据和模型权重的改进,属于 Policy 层面;
· 第二类,也就是我之前部分工作做的 Harness 层面,Harness 包含 Policy 外围的部分,比如工具、记忆等等;
· 第三类是训练算法层面,训练算法也包括改进模型架构、基础设施;
· 第四类是任务层面,任务层面包含构建 Agent 或者 Policy 的评测环境、Curriculum。
这四点侧重点不太一样。Policy 和 Harness 是从 Agent 系统层面,分为模型和外围组件。任务环境是和 Agent 交互的,任务环境和 Harness 环境并不一样,外部交互环境里面也可以带有自己的 Harness。
结合我的观察和读过的论文,大致是这几个类别。我自己之前 AI4AI 相关工作,更多关注第二点 Harness。前面提到,Test Time 更多在 Harness 层面做优化,Training Time 更多做数据和模型权重层面。
从研究角度,一个有意思的方向是怎么让 AI 学会设计自己的执行环境,这也是我一直在做的研究。在 Test Time 的 AI4AI 当中,可以用更强的 AI 模型为弱 AI 模型 Build Harness。在不新增 Policy 参数的前提下,通过优化代码、Router 和验证机制,提升整套系统 Performance。
这个思路还可以迁移到第四类任务环境。我们可以持续 Diagnose Agent 的表现,定位失败案例,搭建能够自我提升的环境,也就是 Evolve Of Benchmark,这也是一条可行的路径。
我先抛砖引玉,大概分成这四类。我想现场各位嘉宾的侧重点和方向也不一样,很想听听后面嘉宾的看法。
何秉翔(主持人):
刚刚钱成博士也聊到了 Harness。我比较好奇,呈松博士此前也有 Harness 相关工作,比如 EnvHarness。想听听呈松博士对此的看法,您是否看好 Harness Evolve 这条路线?
黄呈松:
我维持我的观点,Evolve 这件事需要通过 Data 作为媒介产生。算法和 Data 是两个正交的层面,算法归算法,Data 归 Data,无论算法变成什么样子,Data 都是必需的。
在算法层面,Harness Optimization 是一个思路,是一种轻量级的方案,可以把 Agent 优化到目标 Domain,使用起来比较方便。但大家最终想要的是效果更好的基础模型,模型本身底子要好。Harness Optimization 是很便捷的优化方式,尤其适合 Personalized Agent 或者 Domain Specific Agent。
回到我做的数据相关工作,为什么我认为 Data 是必要的?从最早的 Language Model,Pre Training,再到后面 RLHF、RLVR,再到现在 Group-based、Critic Free 的 Post Training,大家一直在探索更高质量的数据来提升模型。不管算法怎么变,Data 始终是刚需。我们也能看到,一些向前沿实验室出售数据的公司、做 Benchmark 的团队,都在专注搭建更好的环境。
我今年实习做 Environment Harness,思路就是:模型想要 Improve,Data 也要同步 Improve,这里存在一套对应的范式。我觉得 Data 方向拥有更大的提升空间。基于 Harness Optimization 的 RSI,是模型依靠自身轨迹优化 Harness 甚至权重,但它受限于模型本身能力,没法获得额外信息增益。如果把整套 pipeline 放在 Data 层面,新 Data 会给模型带来更大增益。
所以我认为用 Data 实现 RSI 最大的好处就是:就算 RSI 不再火热,行业依旧需要 Data。我们在人工设计的 pipeline 之外,提出了一套新的数据生成范式。哪怕后续算法层面放弃这套 RSI,或是出现更好的 RSI 算法,我们在 Data 上的所有贡献,都可以延续到下一个时代。
何秉翔(主持人):
下面请峻麟博士,你之前也做过一些像 Frontis MA1 的一些实践,比如说你在那样的工作里面,你觉得什么样的技术路线是你比较 Bet On 的。
杨峻麟:
我觉得钱成学长和呈松学长说的都很有道理,钱成学长分的类别很精确,我也认同呈松学长说的,Data 是 RSI 里面非常重要的一环。呈松学长之前做的更多是自生成 Data,让模型自己给自己出题、自己求解;我们这边的 Data 更多从外界挖掘。
我来讲讲我们在 Frontis-MA1 里面做的工作,主要分为两块:数据,还有搜索 Harness。我们的工作不算严格定义的 RSI,而是 AI4AI。但就像刚才师兄所说,AI4AI 很多能力可以迁移到最终 RSI 里面。
数据方面,我们想大规模构建高质量 AI4AI 任务,搭建对应的环境,打造一套 Gym,让模型在 Gym 里面大规模训练,提升模型 AI4AI 能力。在 Frontis-MA1 里,我们提出 OpenMLE-Gym,基于互联网大量机器学习任务构建环境和 Reward,模型可以在 Gym 里面做 SFT、RL 相关训练,大规模训练 AI4AI 能力。
在我们之前,开源社区的 MLE 相关工作放出的任务不多,最多几百条。我们合成了 5000 多条任务,提升了一个数量级。课题组还有 NatureBench 这项工作,基于 Nature Machine Intelligence 这类期刊构建前沿 AI for Science 科研问题,同样搭建 AI4AI 的 Gym 和任务集。
搜索 Harness 方面,我觉得做 AI4AI 类工作值得思考的一点是:怎么高效让模型通过迭代式搜索找到更好的解。如果简单让模型一遍遍迭代,效率很低。迭代 20 轮之后,把前面 20 个解喂给模型,模型很难拿到信息增益,容易迷失在长上下文里。所以我们需要进化式搜索机制,可以是蒙特卡洛树,或是我们提出的 OpenMLE-Evo 搜索树,总而言之,是用搜索树管理模型过往全部探索,通过搜索算法挑选最有价值的父节点交给模型继续探索。
最近也看到不少实验室在持续优化 Evolutionary Search 算法。我觉得更有意思的一个问题其实是:能不能让 LLM 自己决定怎么做 Evolutionary Search,把选择父节点和基于父节点生成下一代候选解这两件事统一起来。这件事其实挺 Non-Trivial 的。像 Jenny Zhang 的 Hyperagents,其实就尝试过让 Agent 自主优化 Parent Selection,但实验结果似乎还没有超过人工设计的搜索策略,所以最终还是保留了外部的 Archive 和 Parent Selection 机制。不过我觉得,从长期来看,我们未必还需要这种显式、人工设计的外部搜索机制,而是可以让 LLM 自主决定整个搜索过程,包括探索哪些方向、何时回溯、如何利用历史经验。因此我觉得这个问题还是挺有意思的。
何秉翔(主持人):
然后想听骁腾博士,你会怎么去尝试这件事?
马骁腾:
我正在认真思考呈松跟峻麟说的内容,我觉得都非常有道理,不少也是我们正在尝试的事情。那我就换个角度,站在我们这边,更多从 Infra 和 Model 的角度来讲。因为我们一直在做 LoRA,刚才也提到,大的能改动的模块就是 Data、Model、Harness,Harness 跟 Data 大家都聊过,我这边补充 Model 这个视角。
在模型层面,我觉得 RSI 或者 AI4AI 里面非常重要的一点,就是模型迭代的效率。
想做模型迭代,必须要让模型 Train 够快。如果一年只 Train 一次,就算 Search 找到了一个节点,也没法充分试错。所以迭代速度必须足够快。
在快速迭代这件事上,首先我们观察到,更好的 Infrastructure 对迭代帮助很大。比如 DeepSeek V4.1 架构出来之后,吞吐马上提升很多,可以尝试的次数变多,那成功率自然就高了。
我们自己的工作更多用 LoRA 去做,这种方式比较轻量。可以在一个大 Base 模型上跑几十个 LoRA,不同 LoRA 之间可以切换。如果想把之前的方案拉回来继续跑,直接加载之前的 LoRAdapter,就能直接 Inference。
所以我的看法和呈松刚才说的一样,在变化之中寻找不变。数据是一方面,Infra 也是一方面,持续提升 Infra 的效率。不管后续算法怎么变,我们都可以保持领先。在这个基础上,再结合呈松的 Data 方案,就无敌了。
以上是我的看法。
何秉翔(主持人):
骁腾老师刚刚也提到了,关于 Infra 我有一个比较好奇的问题想追问请教下,现在有没有关于 RSI 的 Infra ,它是什么样的形态,AI 构建 AI 这套体系所需要的 Infra,可能会是什么样子?
马骁腾:
我自己比较关注 Reef,我还挺看好它。Somehow,我觉得它其实是为模型自我迭代创造了一套 Harness。我刚才说,未来模型想要自己迭代自己,它一定要管理自己的版本,每个版本处理训练数据、所有 Hyperparameter;还要收集新的 Experience,甚至自己上网查找公开数据,筛选可用于训练的素材,这些都需要统一管理,所以我觉得 Reef 是一个比较好的尝试。
理想状态下,模型会先在线上收集很多 Bad Case 或者不好的 Experience,不管来自 Benchmark 还是真实环境。拿到数据之后,它自己分析、构造数据集,完成迭代,然后做小规模批量上线。大部分用户继续使用原有 Checkpoint,新的 Checkpoint 只在 5% 流量上运行。放到研究场景里,就先选取 Benchmark 的子集,在子集上快速验证,之后再判断要不要升级为主版本。
这套体系里面,一方面要有快速切换基座模型的机制,在我们这里就是 Multi-LoRA 机制;外层还要管理所有这些复杂版本。这两者搭建在一起,就给 AI 自我迭代准备好了基础能力。
何秉翔(主持人):
明白,我简单总结一下。大家提到了很多有意思的路线,未来 AGI 场景下 AI Build AI 可能的形态:人类不一定需要亲自写代码、调代码、做实验、做分析,很多原本属于人的决策权,可以交给 AI。现在 AI 已经可以帮忙改代码,后续我们希望它可以帮忙跑实验。
当然也存在一些问题,就像刚才峻麟博士提到的,AI 会迷失在上下文当中,不知道该做出怎样的决策。AI 虽然很容易生成各种各样的 Action,但这些 Action 不一定有用,很多时候还是需要 Human In The Loop 来判断,这也是目前存在的瓶颈。
刚好聊到这个话题,想听听大家的看法:未来想要实现 RSI、实现 AI Build AI,各位认为核心的技术瓶颈在哪里?要不先从钱成博士开始?
实现 RSI / AI Build AI 的技术瓶颈在哪里
钱成:
那我就抛砖引玉。这个问题之前好像也聊到过。既然是 RSI,Recursive Self Improvement,我们要把上一轮的系统迭代,放到下一轮当中继续改进。从我实践的角度来看:
让 AI 做自进化、自迭代,很关键的一步就是对之前的失败做 Failure Diagnosis。人类在看推理结果、训练过程的时候,如果训练失败或者性能碰到瓶颈没法突破,我们依靠经验和 Debug 思路,用 Top Down 的方式思考。凭借经验,看到对应的曲线,就能判断哪里出问题,知道模型和系统下一步该怎么迭代。
但如果让 AI 自己做 Self Improvement,自主对之前的系统做 Diagnosis,目前很多 Coding Agent 更倾向 Bottom Up,从底层看大量 Case,从具体问题往上推导改进方案。模型过于关注细节,缺少人类优化系统时那种宏观的 Perspective。
这样就容易出现 Overfit,或是诊断出来的核心问题本身存在偏差。当让 Agent 系统做 Self Improvement 的时候,带来的提升会很有限,因为优化路径并不是最高效的。
所以我觉得现在的一大瓶颈就是 Failure Diagnosis,这一块目前还是比较依赖 Human Insight。如果按照最开始的定义,想要 Agent 实现自进化,最终要减少人类 Oversight 和人工监督,这块能力还有很大提升空间。
我的分享就到这里,也想听下后面嘉宾觉得还有哪些瓶颈。
何秉翔(主持人):
那开颜博士?关于现在 RSI 可能的技术瓶颈,不同路线是不是可能有不同的瓶颈?
张开颜:
我从比较宏观的角度来说。我们之前做了不少强化学习的工作,在强化学习里面,Agent 和 Environment 的交互关系,放到 RSI 或者 AI4AI 里面依然很契合,两者有很多共通之处。
从这个角度,如果说存在瓶颈,主要就在两个交互位置:一是 Agent 执行 Action 的过程;二是 Environment 返回 State、Reward 的过程。当然外层还有迭代优化环节,稍后再说。
现在大部分 AI 是数字 AI,在数字环境做决策。不管模型多大,它生成 Action 本质都是推理,这块我觉得不是瓶颈。瓶颈反而在 Environment 返回 State 和 Reward 的阶段。
接下来大家做 AI4AI,基本都会往物理世界走。数字世界的数据,模型基本学的差不多了,当然还有很多内部私有数据。所以 Environment 本身的构建是瓶颈,怎么构建更多样性更复杂的环境,不少大厂都在采购环境,前面也提到,甚至为了获取环境而去收购公司。另外环境反馈周期很长,OpenAI、Anthropic 都在往科学方向探索,从物理世界拿到很多软件数字世界给不了的反馈。
了解 AI4Science 会知道,科研分干实验和湿实验。干实验现在可挖掘空间不大,大模型在干实验上做得不错,像芯片前期设计验证、蛋白质结构修改这类任务,干实验反馈快,是 AI 擅长的。但湿实验反馈周期非常漫长,制约了学习流程。
所以 Environment 是接下来的瓶颈:怎么构建更多环境,怎么加快环境反馈。最近也有相关工作,World Model 的思路从具身领域引入 AI,大家考虑搭建 AI 的 World Model,实现更快反馈。这是第一个瓶颈。
第二个瓶颈,是 Agent 和 Environment 的交互。想增强整套系统,要同时变强 Agent 和 Environment。这里就有峻麟刚才提到的搜索问题:怎么更高效地搜索,产出具备 Novelty 的成果,实现真正创新,这是另一个瓶颈。不管是设计 Novelty 奖励函数,还是用算法生成更多样的方案,这块目前都很难。
现在大家对于 AI4AI 能不能产出新东西,评估体系还没有做好;评估没做好,搜索环节自然也做不好。
总结下来,回到 AI 的基础范式,核心就是学习和搜索两个问题。学习上,学习信号来源是瓶颈;搜索上,搜索效率是瓶颈,这两点还会衍生很多细分子问题。
以上是我的分享。
何秉翔(主持人):
刚刚开颜博士提到了两个关键过程:Agent 执行 Action 的过程,以及 Environment 反馈 Reward 的过程。讲到环境给出的学习信号,我有个好奇的问题。开颜博士刚刚也提到,当前存在环境层面的瓶颈,我们需要构建更多样、更真实的环境。
在现实世界可求解的任务当中,有没有哪些任务,可以依靠构建更多样的环境逐步解决;同时是否存在另一部分任务,很难验证、无法通过 RSI 这条路径解决,本身存在能力天花板?
张开颜:
是的,我觉得再往上区分,不管是做区分还是看瓶颈,根源其实在人。本质上 AI 要解决什么事,都是人来定义的。那些 AI 解决不好的任务,瓶颈本质上是人没有定义清楚。前面也有同学提到,AI 很难替代产品经理。放到企业里来说,AI 没法替代甲方,很多时候甲方自己都想不清楚想要什么。
所以我觉得,只要你能想清楚目标,明确要达成的结果,这个任务就可以被抽象出来。当然这里面有大家常说的可验证问题和不可验证问题,大部分现在看起来不可验证的问题,其实都可以转化成能够计算奖励的形式。
只要能够定义问题,知道我们要优化什么,我们就可以大规模构建任务。比如我们很关注的 AI4AI 任务,如何让 AI 自动做 AI 研发,我们就可以围绕数据、模型、训练、推理各个环节去构建任务。
最后的瓶颈,还是人对任务的定义。只要定义清楚,我认为都是可以优化的。
何秉翔(主持人):
好的,感谢开颜博士。刚刚钱成博士、开颜博士都提到了数据还有环境的重要性,前面讨论里也说到,我们怎么从真实用户回流数据里去构造环境、搭建 Benchmark。我们知道 TerminalBench2.0 花了一千多个专家小时构造数据,ApexAgent 构建环境花费大概 160 万美元。从成本结构来看,纯手工搭建环境这条路,很难支撑 RSI 所需要的规模。
这里想讨论一个比较现实的问题:我们怎么自动化地从真实数据中构造环境,从真实数据里挖掘用户需要的能力,并且对应生成 Benchmark。想听听骁腾老师的看法?
马骁腾:
我先 Comment 一下你这个问题,再谈谈刚才的议题。先说怎么造数据,我们现在有一套相对清晰的 Pipeline。首先你得有一套和专家对齐的 Benchmark,后续新产出的内容要尽量和 Benchmark 对齐,再拿 Benchmark 做测试。
如果是全新的合作方,我们会先做专家访谈,问清楚他们想要什么样的数据。第二步告诉对方 Benchmark、好的 Reward Environment 是什么,引导他们把想法变成 Rubric,产出几条 Sample Environments。如果对方做不到,就说明需求没想清楚,回去继续访谈。如果可以,我们拿到 Rawdata,结合这些 Seed 数据,再去生成新数据。这样 Pipeline 会比较顺畅。当然里面还有不少 Challenge,比如 Data Access、各类数据整理。All in all,方法论大概是这样。
回到刚才 RSI 的重大挑战,我觉得有两类问题,前面也大致聊过:一类是 Scale Data 可以解决的,一类是就算有 Scale Data 模型也解决不了。就像钱成说的,模型做事情的那些 Sense,应该放在哪里。我认为核心卡点有两个。
第一个是 How to skill。不知道大家有没有接触过前沿任务,接入难度很高。像 TB4.0,调试测试要好几天。越来越多任务都变得很 Heavy。我们做 RSI,部分 RSIBenchmark 迭代模型时,数据非常珍贵,跑一天可能只产出一两条样本,产量持续下降。我觉得这是 Fundamental 的瓶颈。或许就像前面嘉宾提到的,可以借助 World Model,通过 Mock 仿真来提速。这是本质挑战:容易处理的任务基本做完了,剩下的都是数据生产很慢的任务。
第二,就算数据充足,模型也学不到 High-level Meta 能力,也就是怎么做 RSI、怎么做科研。这里有个重要瓶颈:现在模型没有长期记忆。
我读博的时候,读完三四百篇论文,对领域就有很深理解。新 Paper 过来,一眼就能分辨好坏,快速抓到 Insight。但现在模型读完 300 篇,只能输出摘要。就算快速读完,想要基于这些积累产出新内容,只能把 300 篇全部塞进 Context 窗口。我觉得当前模型架构缺少长期认知的存储模块。我猜想 OpenAI 解决了这个问题,它可以处理科学、数学问题,甚至做到一周量级的 Reasoning。以 OpenAI 的 Infra 水平,一周推理肯定不是在上下文窗口里完成。我猜测除了 Harness 迭代之外,它在模型架构上做了改动,推理的时候可以继承之前积累的 Sense,带入后续推理。
这也是我现在很关心的 Topic。我们自己也在探索 TTT Model 和 Long-term memory 模型,看到了一些不错的特性。我觉得这是非常 Promising 的方向。
何秉翔(主持人):
明白,我想也请教一下呈松博士。呈松博士前面提到 Data 也是比较重要的一个基础设施。呈松博士会怎么看,从真实数据里面去构造一个 Environment ,可能怎么去做。
黄呈松:
好的。今年做 Environmental Harness 的时候,我们也想要解决人工标注的 Environment 成本很高这个问题,希望把它自动化。这个过程最大瓶颈就在 Verifier。如果你有一个大的 Sandbox,可以从中 Sample 一些 Task 加上对应的 Rollout,这一步可以自动完成。但问题是,给到 Task 之后,怎么验证这个任务是否被正确完成,这个步骤很复杂。
在我们的工作中,沿用之前的思路,对 Environment 做类似 Augmentation 的操作,通过各种 Operator 改造环境,生成新环境。我们认为在数据有限的条件下,这是简单好用的方式。
如果放到真实环境里,依托用户轨迹来构建,我们需要更好的 Reward Model 或者同类模型,用来判断结果质量,筛选可用的训练数据,这是很重要的部分。当然以现在的 Methods 来看,这一步还是需要大量 Human In The Loop。
回到刚才的问题,从真实环境获取数据最大的难点,就是校验提取出来的 Task Environment Pair,以及配套 Verifier 是否正确。Verifier 需要额外开发。所以我们目前的可行方案,就是 Environment Augmentation,类似 Data Augmentation 的思路。
何秉翔(主持人):
明白。下面听听峻麟博士的看法。
杨峻麟:
前面几位学长说的都非常有道理。我结合自己之前的实践,顺着开颜师兄刚才提到的 Novelty 和品味这个话题,聊聊我对 RSI 瓶颈的看法。我觉得这个问题很有意思,值得去解决,目前做这块工作的人好像并不多。
我分成两点。第一点是我们如何定义 Novelty 和品味;第二点是我们如何训练模型去追求 Novelty,这是两个问题。
第一个问题比较 Tricky。比如 Post Train 问题或者 MLE 问题,我们怎么判断这个方法到底是不是新的?现在来看好像只能靠人。把训练轨迹给人看,人可以判断它是不是提出了新算法,或者是不是做了蒸馏,人工是可以判断的。但怎么把 Novelty 的判断做成 LLM Judge 或者 Verifier,这块还值得探索。
第二个点,如何奖励 Novelty,这件事也很 Tricky。我们之前做 Frontis-MA1 的时候,LLM 是在进化搜索树下面一步步搜索,但是训练的时候,奖励的是单步的实现。这种奖励方式,未必能直接奖励到 Novelty。举个例子,好的科研创新,一般都是大量失败之后才产生的。类比搜索树,就是在生成很多失败节点之后,才可能有一个成功节点。如果训练的时候把所有失败节点都惩罚了,模型就很难走到成功节点。这里就涉及 Credit Assignment 的问题:怎么分配信用,去奖励那些前期不断失败、但最后有可能成功的路径。我觉得这也是很有意思的问题。
何秉翔(主持人):
刚刚峻麟博士也提到 Novelty 还有奖励相关的问题,特别是在 AI4AI 或者 RSI 这类场景下,一条数据的轨迹会非常长。骁腾老师刚才也提到,像 TB4,或是 OpenAI 那种一周的 Reasoning,上下文规模难以想象。这么长的过程下来,最后在可验证场景,可能也就涨了几分。这几分到底怎么归因到中间的过程,我感觉这也是一个瓶颈。
我自己也做过一些 AI4AI 的实践,有一些体会。比如我们在 PostTrainBench 上做实验,让 Agent A 指导 Agent B 持续迭代。结果发现,它执行某一个 Action,比如调整数据比例之后,Benchmark 分数降了两个点,它就直接判定这个 Action 不行。这里忽略了几种情况:Action 本身方向是对的,只是实操环节出问题,或是评测本身存在噪声,带来这两个点的波动。但模型简单归因为 Action 无效,后续几十步甚至上百步决策都不再采用这个 Action。
就好比我们尝试拉动一个老虎机的臂,拉一次拿到负向 Reward,之后就再也不去尝试这一个臂。我的感受是现在很多 Agent 都比较保守,倾向复用已有经验;而且归纳过程容易出错,产生错误归因,之后就不再继续探索。
刚才聊到 RSI 评测存在各类瓶颈。最近涌现出很多 RSI 相关 Benchmark,比如 RSIbatch、Data、Code、Infra 相关的工作,ICLR 上都可以搜到。还有 RSIexam、RSIarena、RSIbenchmark,以及较早的 PostTrainBench、AutoharnessBench 等等。每个 Bench 都宣称自己在测对应的能力。
这里想和大家讨论:整个自迭代过程中,最应该衡量的是什么?这些 Benchmark 测的到底是不是同一件事?想先听听峻麟的看法。
杨峻麟:
好的,既然轮到我,那我抛砖引玉一下。最近的 RSI Benchmark 实在太多,都看不过来,我也不敢说每一篇都跟进了。
我的感觉是,有一部分 RSI Benchmark 其实就是 AI4AI Benchmark。他们收集很多 AI4AI 任务打包在一起,然后称之为 RSI Benchmark。我觉得这类 Benchmark 有价值,就像开颜师兄前面提到的,提升 AI4AI 能力,也能间接对 RSI 有所贡献,这类能力可以迁移,所以这类 Benchmark 是有意义的。
另外一类 Benchmark 和 Post Training 相关,用来评测后训练能力,这里又分两种。一种评测完整全栈后训练能力,也就是 Post Train Bench;一种评测模型训练中的一个环节,比如RSIBench-Data。我一开始觉得 Post Train Bench 已经足够了,但后面看到 RSI Bench Data 还有其他 RSI 系列 Benchmark后,我现在觉得,把后训练整件事情拆成几个部分分别评测,也很有价值。比如说,我们想要提升模型后训练能力,当然可以让它跑完完整的后训练流程,但耗时太长。像 Post Train Bench 一次要跑 10 小时,我们很难承担这么长的 Rollout。更务实的办法,可能是把 Post Train 分而治之,拆成几个核心问题,针对每个问题单独优化。秉翔哥之前做的 AutoSFT,就是针对 SFT 这个环节做优化,拿到了不错的提升。在这个思路下,RSIBench-Data 和其他同类 Benchmark 去评测 Post Train 里的子能力,对整个社区还是很有价值。
何秉翔(主持人):
感谢峻麟博士,下面想听一听骁腾老师的看法,你站在工业界视角,现在出来这么多 RSI Benchmark,你会不会考虑拿它们来评测自己这边产出的模型?
马骁腾:
我觉得刚才峻麟说得挺好的,我们现在就在刷 Post Train Bench 和 RSI Bench。它确实很 Grounding,就是给小模型做后训练。就算你 Hack 它,出来的也是整体结果。这里有一点我想 Highlight 一下:
我们跑 RSI Batch Bench,基准默认是用 Tinker 来做的。但我们有自研的 Tinker,这里耦合了两件事,我们还可以改造我们自己的 RSI Harness。Tinker 这件事,就像前面说的,关乎迭代 Efficiency,这里面存在套娃现象。我可以通过提升自研框架的迭代效率,让我在 RSI Data 任务上能做更多次尝试。我觉得这点挺有意思。其他没有更多 Comments,就是速度太慢,平时跑起来比较耗时。
何秉翔(主持人):
明白,那钱成博士?
钱成:
是的,我觉得刚才峻麟和骁腾说得都挺好。说实话我也没法读完大量 RSI Benchmark,最近一下子出了非常多。像最早的 Post Train Bench,现在大家还经常在用。
回到最开始的问题,RSI Benchmark 到底应该测什么。很多 Benchmark 的思路,是给定固定 Budget,看怎么让下游模型在训练里拿到更高 Performance,相当于在给定预算下做模型优化。任务本身就是对模型做改进,不管是训练下游模型,也包括 Harness 相关工作,比如 Auto Harness,研究怎么优化 Harness。
回到最开始的问题,定义 RSI 的时候,为什么叫 Recursive,而不是 Iterate?我觉得重点是,第一轮改进出来的结果,要放到第二轮继续改进,存在这样的循环递进关系。
早期像 Post Train Bench,是在固定 Budget 下自动做后训练。而未来真正的 RSI Benchmark,需要把系统拆成不同 Checkpoint,每一轮优化完成之后,把调好的模型继续投入第二轮优化,从更长周期看成本和最终 Performance,体现长期持续改进的能力。
当然 RSI 有不同方向,前面提到,可以是 Environment 在 Evolve、Harness 在 Evolve、Policy Model 的 Weight 在 Evolve;或者像 RSI Bench Data,从 Data 层面切入做演化。我觉得在不同层面,都要体现这种长程持续改进的能力。
何秉翔(主持人):
感谢钱成博士,然后也想听一听开颜博士看法。开颜博士也是工业界的代表,像咱们这边本身也会产出模型,会不会用这类 RSI Bench,去体现模型的 AI4AI 能力?
张开颜:
OK,我觉得前面大家说的各种 Benchmark,包括 PostTrainBench,以及其他各种 RSI-Bench,这些都挺好的。Benchmark 基本上就是对于我们想让 AI 去自动化做的事情,能够把任务形式化地定义出来,我觉得这是非常好的事情。当然,这也意味着一旦这个任务被定义出来,其实这个指标,或者说只要这个指标能够被定义出来,它肯定就不是一个好的指标了,我觉得古德哈特定律在这块也能有一些体现。但前面也说了,现在可能面临的一个瓶颈是,大家的任务环境越来越复杂,越来越难采样。
这块我可能想说的是,在真实给到用户去用的时候,我们也有一些平台产品,包括做 Agent Harness 自动优化的平台,以及自动做模型训练的平台。特别是 Agent Harness 优化这块,我们能够直接把用户使用的反馈回流回来,自动帮他去做了这样一个 Agent 的优化,因此我们能够基于 User Data 以及它的一些反馈,自动去做 Agent Harness 的迭代优化。
但在这块里面,很多时候我们现在面临的问题还不是说效率的问题,反而是成本的问题。很多时候虽然说我们能够优化、能够有很好的效果,但它也带来了额外的成本。因为很多时候我们现在去做优化,整个优化流程里面,它其实想做出很好的效果,就得大量地去优化、去训练,然后去做评测,那这块会带来额外的成本。这个时候,成本问题可能是比较大的一个问题。这块我觉得可能我们需要去评估它的投入产出比。前面也说了,现在大家可能更多关注的是,在固定预算之下,下游模型能有一个更高的 Performance。一方面,只关注你给定的一个预算还不够,还得继续看它能不能在更低的预算下面达到更好的效果。包括我们看整个 RSI,如果它是 Recursive 的话,我们就看它改进效率的斜率,我觉得这个是我们现在可能更需要去关注的。现在大家整个 RSI 里它就是一个收敛的曲线,最终大家只关注最终曲线的效果,但前面这个斜率我觉得是需要单独拿出来去看的。
因为真实去用的时候,客户是不关注你的方法的:你人去做也好,RSI 去做也好,都无所谓,他只关注最终能不能付更少的钱,拿到一个更好的 Agent、拿到一个更好的模型。因此从这个角度来说,我们可能需要对这些 Benchmark 给出一些在成本上、投入产出比上的精细指标。我觉得这可能从工业落地角度去考虑,是比较重要的问题。
第二个就是,最终客户、目标用户的目标需求,比如 PosTrainBench,要求在所有 Benchmark 都达到一个最好的效果。最终客户的目标不是这样的单一目标,它可能是很多元的:它既要有效果,又要最终推理得非常快,又要最终部署的资源很少。这种多元的目标,是目前在现有的这些 SOTA Benchmark 里面没有体现出来的。大家可能现在初步来说,先去抓 Benchmark Performance;但最终你这个模型的速度也好、资源也好,它可能是多维的,甚至是一个帕累托的结果。这种定义也是需要有真实的客户才能定义出来的。我觉得这个问题对于学术界来说,可能不一定是很好去定义的。这块我觉得能够有一个 Benchmark 把这些东西定义出来,是一个很好的事情。
我觉得大概就这 2 点吧:一个就是投入产出比这样的一个衡量;第二个就是最终有真实用户多元需求的这样的 Benchmark。
何秉翔(主持人):
感谢开颜博士,接下来听听呈松博士的看法。
黄呈松:
我觉得现在 RSI Benchmark,还有学术界大家常用的那些 Benchmark 最大的问题是:我们一直在优化通用大语言模型,但很多时候我们更需要领域相关,也就是 Domain Specific、带有领域偏好的模型。而这类 Benchmark,大概率不是 AI 方向的人单独就能设计出来的,还需要很多其他领域专业人员参与。
就像 Apex Agent 这类 Benchmark,需要对应领域的人告诉我们想要什么,才能设计出好的 Benchmark。还有前面大家提到的,很多 Benchmark 运行成本很高。我最近关注的,像 RSI Post Train Bench,跑一次耗时很久,不管是资金成本还是时间成本都非常高,很难做高效优化。尤其外层还嵌套一层基于大语言模型的 RSI 系统,本身就要耗费很长时间。
所以对于 Benchmark,我们希望能用一个小规模 Subset,就能代表它在全部任务上的性能,解决评测耗时过长的问题。结合前面提到的多领域思路,我理想里一套好的 RSI Benchmark,是每个领域只设一两个任务,这一两个任务就能很好体现这个领域的能力;再收集几百个领域,拼成一套完整的 RSI Benchmark。
何秉翔(主持人):
明白。刚刚各位老师都提到了 Benchmark 的看法,钱成和开颜博士都提到成本问题,大家也都说到评测维度慢慢变得多元。AI 发展早期,大家关注对话能力、Reasoning 能力,上下文不会很长,评价重点看最终效果。到 Agentic 场景之后,context 会越来越长,评测不再只看效果,还要兼顾很多其他维度。开颜博士刚才提到的斜率,就是更贴近真实场景的评测指标。
峻麟最开始也提到,评测不一定只是端到端评测,分模块评测也很重要。像 PostTrainBench,可以评测 Agent A 和 Agent B 谁做 Post Train 做得更好。但就算 A 的表现大于 B,也不一定能指导我们怎么提升 AI 做后训练本身的能力。
AI4AI 里面本身存在这样一个 Loop:首先要诊断本轮实验的问题。如果外部 AI 连本轮实验运行是否正常都无法判断,那递归自进化就很难继续。就算诊断出异常,能不能定位具体 Issue?只看到曲线异常,找不到问题根源,还是走不下去;就算找到 Issue,如果提不出更好的改进方案,也没法赋能下一轮迭代。这一块我们最近也正在做一个关于后训练 RL 中的诊断与修复的 benchmark,我们称之为 AutoRLBench,在最近一两周内会 call contribution,欢迎大家关注并且贡献困扰了自己很久的 RL 任务!未来会有更多分模块、分阶段、多维度的评测标准,我们期待看到更多这类工作。
最后想和大家聊一个更宏观的问题。这两年 OpenAI、Anthropic 这些前沿机构多次给出时间预判,有人说几年内就能出现可以独立做科研的 AI 研究员,甚至给出具体年份。很多宣传说 RSI 迭代速度会越来越快;AI 能力越强,迭代自身基础设施的能力越强。骁腾老师一开始也提到,现在 AI 已经能够迭代、创造自己的基础设施,提升整体效率,RSI 速度可能持续加快。
我把这个拆成三个小问题,大家可以简单聊一聊:
第一,什么样才算真正实现 RSI?
第二,大家预估这件事大概需要多少年?
第三,如果实现之后,人类在其中扮演什么角色?
我记得李飞飞之前一篇博客提到,当 AI 达到 AGI 的场景,人类大概有两类角色:一类是特定领域最顶尖的资深研究员;另一类是能熟练使用 AI,在多学科交叉方向做研究的人。到那个时候,人类还有哪些事情要做?
我们先请峻麟博士简单讲一讲。
怎样才算实现 RSI?又需要多久?届时人类将扮演什么角色?
杨峻麟:
好的,这三个问题都颇具挑战性。先说第一个问题,其实前面大家讨论过什么是 RSI。在我看来,从字面来说就是 Recursive Self Improvement,也就是一个 AI 系统能够递归地自我改进,它通过一些方法优化自身,优化之后的版本再参与下一轮改进,这是字面含义。
如果说得更直观一点,比如 OpenAI 某一代 GPT 模型,大部分甚至全部研发工作都是 GPT 自己完成,人在里面基本不做事情,这就是一个比较直观的 RSI。
至于人在 RSI 体系里做什么,我觉得人可能主要是提供方向、建模任务。模型会在我们给定的 Metric、要求和 Instruction 下去做提升,最终还是由我们决定模型该往哪个方向提升。
何秉翔(主持人):
感谢峻麟,呈松?
黄呈松:
好的。我理解什么是 RSI,我们现在的系统,是我们告诉 Agent 去做一件事。如果真的实现 RSI,整套系统就会变成,我们告诉 Agent,我们想要一个具备什么功能的 Agent,它就直接 Output 这样一个 Agent,这就是我想象中的 RSI System。
也就是说,我们可以有一个 Agent,能够生成各种各样我们想要的 Agent,整个生成过程包含从 Data 到 Training 再到 Harness 的全套步骤。我觉得这套过程需要很强的 Base Model 能力,至少是三年之后才会发生的事情。
到那一天,大家不再是 Engineer,所有人都变成 PM。我们只需要思考我们想要 Agent 去做什么事情,不再去研究怎么实现这件事;变成我们提出问题,解决问题完全交给 Agent 代劳。那个时候 Researcher 主要做这类工作,其余人该退休退休,该休息就休息,我们的科技发展也会到达一个新的地步。
何秉翔(主持人):
好,感谢呈松博士,钱成博士有什么看法。
钱成:
是的。关于什么时候能实现 RSI,我之前看过一些报告,OpenAI 我记得之前说,目标大概在 2028 年,打造完全可以取代人类研究员、全自动化的 AI 研究员。结合我们最开始的讨论,如果 RSI 定义里要求 Zero Human Involvement,目前大部分企业都把 2028 年左右作为目标,想要实现完全自主的科研自动化。
但是我想说,RSI 本身,它核心是 Improvement,是系统递归的进化。单纯让 AI 完成一项 Research,这不算是 RSI。RSI 的核心是要有持续改进。如果只是做到自动化 AI 研究,没有包含整套系统持续迭代优化的机制,那还不算真正的 RSI。像 OpenAI 定下 2028 年,目标是自动化科研;而一套真正可以自我递归进化的系统,可能还需要再多一段时间。我觉得这个时间不会很长,就像《三体》的技术爆炸,技术发展是有加速度的。
然后聊聊未来人的角色。计算机学科本身就是工具型学科,尤其是 Agent,是非常 Application 导向的东西。当我们拥有 Agent 之后,可以把 Agent 当成我们的工具。人更该思考的,是拿到这个工具之后,怎么助力其他领域发展,比如基础科学。不只是让 AI 加速 AI 自身的 Research,还要把 AI 工具拓展到更多社会领域,也就是大家现在做的 AI For Science。数学比较容易验证,相关工作最多,后面还会拓展到更多基础学科,这需要很多领域 Expert。
我和一些真正做科研的人交流发现:科研人员希望 Agent 帮他们做的事情,和我们理解 Agent 能为科研人员提供的能力,中间还有很大的 Gap。这个 Gap 未来一定可以弥补,但现在两边关注的重点还不太一样。
除此之外,除了在基础科学领域保有专业 Expertise 之外,我也认同刚才黄呈松的观点:我们需要产出更多 Idea,交给 Agent 去实现。我们不再是单纯打造更好的工具,而是思考能提出什么更好的 Idea 或者 Topic,让工具帮我们落地。这更考验人类的洞察力、创造力。我们产生创造性想法之后,让 Agent 来执行。我觉得这就是 AI Agent 全面普及之后,人类依然可以贡献价值的地方。
何秉翔(主持人):
我其实感触很深的一点就是,计算机,我也觉得更像是工具,AI 本身也更像是工具。它被发现、被完善的初衷,可能就是效率、效果至上。但我们人去做很多事情,不一定只追求效率或者效果,很多时候我们也很看重过程本身,就是踩坑探索的这个过程。在探索过程里积累的经验、视野,也是我们人会更加看重的地方。接下来想听听骁腾老师的看法。
马骁腾:
首先我觉得我们讨论 RSI 什么时候实现这件事,有点像一个伪命题。最开始有 AI 的时候,我们在讨论 Emerge。但现在我们都知道,其实它就是平滑的 Loss 下降。后来我们讨论什么时候实现 AGI,OpenAI 已经宣布他们实现了 AGI,然后我们现在不怎么提 AGI 了,换了新的概念,也就是 RSI。所以我觉得,是人一厢情愿在给这些东西做定义。
要这么看的话,OpenAI 跟 Anthropic 显然都已经实现 RSI 了。他们内部大量迭代假设都是 AI 在做。比如说设定一个 Threshold,如果 90% 左右的 Effort 都是 AI 完成,人的占比很低,按这个比例算,就已经是 RSI 的状态。回到现实,我们到底希望 RSI 能帮我们做什么?对我来说,我们做客户商业化场景下的模型 Training,希望尽可能减少沟通扯皮,减少人员驻场交付,尽量让模型自己完成客户模型的训练。
如果把这个作为 Target,我的预期大概在一年以内可以实现。我设想的交付 pipeline 是,我先和对方对齐 Benchmark,对齐 Data,这部分需要 FDE 投入时间去做;后面的环节尽可能交给我们自己的 Agent,甚至可以让客户那边的专家介入迭代。在我的定义里,这就算一套很不错的 RSI pipeline,它还可以持续 Continual Learning,在环境里面迭代提升。
回到最后一个话题,这些全部实现之后,人要做什么? 我觉得,强 AI 出现之后会带来两种可能。第一种,超强 AI 包揽所有职业,所有人失业,经济学、社会结构全部崩塌,我们要重新 Build 一套新的社会结构,这是可能性 A。但我觉得所有 Researcher 都会尽力去避免可能性 A。第二种是可能性 B,有了这些 Tools,我们生活会有很多新机会、更多多样性。未来每个人都可以 Train 自己的模型,每个人 Own 自己的 Benchmark,对外提供自己的 Service。我觉得我们所有人的工作,都是在为第二种可能性服务,希望技术让社会变得更加 Colorful。
我觉得未来很可能是这样一种模式:大部分时间人不需要工作,或者一直在寻找灵感。当积累足够的 Expertise,就可以输出 Benchmark,产生创意去创造东西,这部分就是知识产权最核心的内容。不管模型怎么变化,他都可以依靠自己这套 Data pipeline,去提升模型或者 Judge 模型。
举个例子,就像奢侈品里的爱马仕,提到爱马仕大家就知道价值很高,贵的核心是独特品味,我们甚至会说面包里的爱马仕,比拼的就是品味。我觉得未来,每个人都可以在自己的领域成为属于自己的爱马仕,这就是我理想中比较好的结果。
何秉翔(主持人):
感谢骁腾老师,最后也想听听开颜博士的看法。
张开颜:
好的,我很赞同骁腾老师的看法。我觉得 RSI 它是一个光谱,是连续的,很难说在哪一个瞬间就完全实现了。包括昨天晚上我看到 Claude 的消息,Claude Code 好像已经能够自动优化内部 80% 还是 90% 的代码。它是一个连续的过程,很难找到一个节点,说这一刻 RSI 就完全落地。
可以分成两方面看。很多问题本质上都是优化问题,RSI 也是优化问题,不断产生新需求,持续优化。大家做的大模型新架构研究方向五花八门,但对头部大模型机构而言,他们只关心最终能不能 Scaling 把曲线推上去,其他事情并不在意。对他们来说,这就是一个优化问题。
而对于我们,就像前面钱成说的,AI 是工具。我们思考怎么用 AI 创造更多工具,甚至能够改变世界的工具。
前几天我看到一份分析,对我启发很大。上一代工业革命,电力、内燃机实现大规模机械化,把人的体力劳动从 1% 替代到现在 99%。高楼、大桥,我们现在身边大量物品,都是机械化自动化、替代体力劳动带来的。下一步,AI 能够自己研发 AI,研发更多工具,智力劳动也会被 AI 逐步替代。现在大概只能替代 1~3%,未来有可能替代人类 99% 的脑力劳动。我们更关注 AI 这种自我改进、自主研发能力,它带来更多工具,替代大量智力劳动,甚至带来科研爆炸。我们更关心这件事什么时候催生新的生产模式,甚至社会体系的变化,这也对应我们最后这个问题。
如果 AI 最终可以成为全自动研究员,开发各种各样 AI 工具和系统,人类一方面负责提出问题,更重要的是评估、审核。从这个角度来说,如何评判 AI 的结果会更加重要。最近我还看到 GPT 在网络攻击方向的进展,是很可怕的。给定目标之后,AI 为了达成目标,只看最终目标,中间环节不受约束,就可能产生大量 Hacking 行为。如果放开 GPT,让它可以在互联网上随意操作,整个互联网可能都会崩溃。所以审核验证这件事,会是更大的问题。
不过整体我对未来还是比较乐观。上一轮工业革命,体力劳动自动化,带来了新的社会体系,福利制度、双休日这些都随之出现。等到智力劳动自动化之后,说不定未来我们每周只需要上三天班。当然现在还远远不是这个状态,现在 AI 反而让大家干更多活,冒出更多需求。
总结来说,RSI 更多是一件连续演进的事情。未来 AI 会创造更多工具,替代更多智力劳动。明年各类工具会迎来巨大变化,长期来看未来会越来越好。我们人类会去承担更高价值的工作。大概就是这些,这里面还有很多有意思可以继续讨论的地方。
何秉翔(主持人):
感谢开颜博士,我也深有感触。我也希望未来当 Agent 能力变强之后,每周可以只上三天班。我现在的核心感受是,虽然有了 Agent,我们干活效率提升了,写代码、写论文、做实验、数据分析这些工作,我们可以在大屏上开好几个 CC 窗口,让 Agent 各自处理任务,但实际上我们反而越来越累,这点我自己感受很深。
第二个点我也很有感触,当 AI 具备输出 Proposal 的能力之后,验证本身就会成为瓶颈。很多时候我们大量的工作就是审核 AI 产出的结果。AI 可以一次性吐出大量文档,我们人工审阅起来压力很大。这里面还有很多有意思的问题,时间有限来不及深入讨论。就像前面呈松提到的,想要实现 RSI,很关键的一点是需要很强的基座模型能力。现在很多 RSI 相关工作,大家更多从上层去解决问题,但底层依然依赖模型本身的算法,比如长文本理解和生成。在这块,是不是需要更好的 Credit Assignment,来做基座模型的 Post Training 等等。
因为时间关系,我们这个话题就讨论到这里。接下来我们简单看一下讨论区观众的提问。我浏览一下,挑选问题,指定几位嘉宾回答,其他嘉宾有想法也可以随时补充。
观众提问
第一个问题:实现 RSI,感觉需要外部信息流入;如果没有新信息进来,就只是挖掘模型本身的潜能。有没有办法在改进系统里设置门控,控制新信息的涌入?
钱成:
我也看一下这个问题:门控系统来控制新信息的流入。我感觉是这样,如果我们把 Agent 系统当成一个整体,包含 Policy、Harness 等等,虽然叫自进化,但这套系统肯定还是依赖外部知识源做支撑。就像前面提到的 RSI Bench data,就是从数据流角度,看 Policy 怎么进化。
我的理解是,对于整套系统,就类似 Unsupervised RL。如果所有信号都来自系统内部,能力提升会遇到瓶颈,性能到某个点之后就很难继续上涨,相当于只是挖掘模型原本就有的潜能,没有注入新的知识。对于 Policy Model 加上 Harness 的这套 Agent 系统也是一样。
如果没有外部信息输入,就只能挖掘系统本身的潜能。系统潜能会更复杂,不只是 Policy Model 能激发出更多能力,Harness 在进化的过程中,怎么辅助模型、辅助整套系统拿到更好的 Performance,也是有上限的,一定需要外部知识的加成或者流入。
那具体是什么样的知识?类比我们人类做系统优化或者 Debug 的时候,我们会看工作流,看 Execution,原来这么做,现在要调整数据,才能提升系统能力。但现在我们注入的,不一定是底层 Execution 工作流上的 Insight,我们更需要 Meta 层面的 Insight。人类需要去设计,我们需要注入的数据,更多是在 AI4AI 场景里,作为 Harness 的构建者、Training configuration 的构建者。你为训练流程挑选 Data,为 Agent 系统设计 Harness。这个时候你的 Design Space 是什么?你注入 Training data 的时候,Data 需要包含哪类能力。
也就是说信息流或者人类 Insight 的注入,更多要从 Meta 层面去考虑。我觉得这也是在 RSI 或者 AI4AI 时代,和过去往系统里注入信息流,很不一样的地方。
第二个问题:现在很多 RSI 的工作其实也在做 Harness 的 RSI ,他理解的 Harness 带来的提升上限是比较有限的,迭代进化个几次是不是基本就到上限了?
黄呈松:
我们现在所谓的 Agent 就是 Model 和 Harness 两部分。只靠 Harness 带来的提升,肯定远小于 Harness 和 Model 共同 Evolve 的过程。现在有很多工作也提到了 Agent model 和 Harness 共同 Evolve,所以这个说法没有错。
Harness Optimization 是比较容易实现的步骤,相比于对 Model Weights 做更新。因为更新 Model Weights 需要很多卡,尤其是做 Model Training 的时候,它需要的 GPU Memory 比模型部署大非常多,所以很多场景下,我们没办法做 Model Weights 的 Update。
Harness Optimization 是一种 Trade-off。当我们希望 Optimize Agent,但又不想消耗大量资源去优化 Agent 的时候,就会选择 Harness Optimization 这种方式。
正如提问的同学所说,Harness Optimization 有上限,效果肯定不如直接 Update model Weights。但是很多场景下,我们只能选择这样的方式。
第三个问题:专门想请教峻麟博士,Dreamrsi 这一类的 RSI 工作就是其中的 Meta Policy 和 Policy 对于 Agent 来说,具体指什么?
杨峻麟:
Ok,感谢这位同学的问题。这个问题和我刚刚讲的内容刚好重合,能看出来他一直在认真听我们的讨论。我刚才提到,训练 AI train AI 的时候,需要一个 Evolutionary Search 的过程,我们要构造搜索树,让模型作为搜索节点完成单轮优化。
所以说问题里提到的 Policy 就是单轮优化,比如怎么把 MLE 问题改写得更好,怎么把 Kernel 写得更好。而 Meta Policy,就是决定接下来往哪个方向探索,哪个节点适合继续深入,应该采用并行探索还是串行探索的方式。
我仔细看了 DreamRSI 这份工作,很有意思的一点就是它尝试让 Agent 自己修改 Meta Policy,这也是我刚才觉得很有趣有意义的地方。我认为到最后,Meta Policy 和 Policy 都应该交给 LLM 来完成,当 LLM 足够成熟之后,它能够自主决定并行规模,选用什么搜索算法,来做进化式搜索。
第四个问题:有个问题提到,模型一次改进,只在公开榜上指标变好,但是真实任务上没有提升。靠什么指标去发现这个问题?有没有一些内部自检指标,能够比公开 Benchmark 更早预警?
张开颜:
好的。榜单确实比较重要,我们很多优化也会针对特定榜单去做。说到内部指标,我觉得可以往前再讲一层,工业界里整套监控体系会更加重要。我们需要监控 Agent 本身的 Trajectory,还有它做优化的 Trajectory,覆盖前后端以及整个优化过程。整套评价监控体系是重中之重,体系里面会定义各种各样的指标。
像 LangChain 配套的 Langfuse,就是我们现在在用的很好的工具,它可以做很好的监控。哪怕是 Agent 在做 Self Improving,只看最终结果肯定不够,它一定需要更细粒度的过程轨迹日志。我们训练模型会用 W&B 这类平台,查看 Reward、Entropy 等各类指标。
一方面这些指标对 AI 很有用,能让 AI 的优化更有针对性;另一方面我们人类也会看这些监控平台,这类平台现在也不少,Langfuse 就是比较典型的。最近 DeepSeek Harness 里面,对于轨迹,不管是 Token 的消耗量、回复速度,还有整个过程的 Response To Call,都会详细展示,我觉得会更有用。
至于具体用哪些指标,要根据任务来看,我觉得更重要的是搭建完整的监控体系。现在我们也会用 Agent 做分析,任务 Agent 和分析 Agent 通过某种制衡方式,避免 Reward Hacking。
第五个问题:现在 MLE 的工作好像大多都在特定领域,很少有跨 Domain 的设计,跨 Domain 这类工作比较少,是因为工作量太大,还是存在一些根本矛盾难以实现?
马骁腾:
这个问题问得比较宏大。我感觉很多团队的资源,能在两张卡上面跑 MLE 就已经很不错了。在我们的实践里面有一些观察,因为我们做 LoRA,如果把多个不同领域的内容合并到一个 LoRA 里面,模型其实记不住这么多知识。
所以我们更倾向于,每个领域单独训一套 Checkpoint 序列,持续迭代 LoRA,维护多个不同的 Track,每一条 Track 对应不同的 LoRA。等到使用的时候,我们按需 Switch。我们做的这个方案叫 Mixture Of LoRA,这样就可以避免 Model 在 Evolution 的时候,合并权重带来的冲突问题。
至于 General 能力提升,更多是在每一个不同的 Checkpoint 产出更多 Experience 之后,再把这些 Experience 一次性放回 CPT 里面,才有可能看到通用性能提升。
第六个问题: DSH 提供了一个统一可优化的模块插件。从这个角度看, DSH 是不是有可能成为一个更有潜力的 Harness Baseline?
钱成:
我觉得现在大家做 Harness,都想把它做得更 General,同时更轻量级。我看到很多 Harness Design,有点类似前面提到的 MCP 的概念:你有一个统一的 Interface,可以在 Interface 里面接入不同的模块。
不同模块面对各类任务,可以具备很强的 Generalization 能力。这种结构化的 Harness 模式,不管是评测还是实际使用,都会更好用。比如我们要用不同 Harness 去测试 Agent,这类框架测试起来更方便,也是做 Research 的人一般会更 Prefer 的方案。
何秉翔(主持人):
好,感谢钱成博士。这块我自己有个私货想问一问。我记得之前有不少工作,也都讨论 Harness 在未来 Agent 系统里面,它到底存不存在,或者说它是不是一定是必要的。有人说现在的 Harness 更多是基座模型能力还不够的时候的一个中间桥梁,Harness 到底会不会被模型能力所吸收?想听听钱成博士或者呈松博士怎么看这个问题。
钱成:
我可以先说一下。我觉得最近一段时间内,Harness 肯定还是不太会消失的。以现在的范式来看,很多 Harness 更能够保证整个系统运行的稳定性。Harness 本身包含的内容很多,可以理解成,除了模型 Policy 之外的很多外部组件,都可以叫做 Harness。不管是 Tool 还是 Memory 这类 Design ,这些东西,在现在包括 GPT 里面都已经验证过,对 Performance、用户体验一定是很有帮助的。我觉得这类东西短期之内不太可能被取代。现在大家训练的时候,一般也都会带着自己的 Harness,对模型做一些 Adaptation。模型对于自家 Harness 的使用,也会更加熟练、灵活。这是当下的范式。如果未来真的出现能力极强的模型,那这个事情确实不好判断。但短期内 Harness 还是不会消失。
黄呈松:
我觉得在短时间内,大概三年之内,Harness 这个东西会存在。因为我们的 Base Model 没有强到它可以 Solve 所有的 Task,你需要给它做类似 In Context Learning,或者小规模 Fine Tune。现在这部分工作是用 Harness 来承担,所以这部分东西会一直存在。
随着训练带上这些 Harness,模型自然可以学到 Harness 自带的能力。在不断迭代的过程中,我们先把新的 Harness 能力融合到模型里,再 Provide 新的 Harness 给模型,类似于不断提供新的 Data。经过很多次迭代之后,等到基座模型达到足够的性能,它可以很轻松地 Adapt 到任何 Domain 上,到那一天才不需要 Harness。我觉得这一天终会到来,但这一天可能还很久。
写在最后
何秉翔(主持人):
由于时间关系,还有很多有价值的问题来不及继续讨论,我简单总结一下。今天跟各位嘉宾讨论的话题很多,讨论也挺深入。
我们从 RSI 的定义开始,聊到现有的技术路线,不同技术路线各自的瓶颈,还有哪些任务上会存在天花板。
针对这个 Topic,现在有很多 Benchmark,我们也探讨了该评测什么样的能力、哪些能力值得评测。
我们也简单聊了 RSI 未来可能是什么形态,人在里面会扮演什么样的角色。非常感谢五位嘉宾今天的分享。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册