作者:The SGLang Team
原文:https://www.lmsys.org/blog/2026-10-24-dsv41-deepinfer
摘要
在 DeepInfer 自己的基准上打平或领先
4x GB300 和 4x B300 上,prefill 吞吐最高到 1.04 倍;64x GB300 上,decode 单步耗时最多缩短 7.4%;其余测试点差距在 1% 以内。
DeepInfer 的优化,SGLang 里都有
包括 Mega 系列在内的一批 DeepSeek kernel、DSpark 投机解码、SWA bounded replay,以及 Engram 的两种放置方式,都已经跑在 SGLang 主干上。
一套完整的服务系统
SGLang 本身就是 API server,还带 KV cache 系统、prefill/decode 分离和跨副本负载均衡。这三样正是 DeepInfer 的 README 里写明“本次发布不包含”的部分。
DeepSeek 开源了 DeepInfer,也就是支撑自家服务的推理引擎,以及它运行所依赖的一整套 kernel。这套东西基本定义了 DeepSeek-V4.1-Flash 现在能跑多快,所以我们用 DeepInfer 自己的基准、在同一批硬件上把 SGLang 和它做了对比。
集成了什么
从支持 V4.1 的第一天起,SGLang 就在跑 SWA bounded replay 和主机内存里的 Engram 表。此后又陆续接入了 DeepSeek 的 Mega 系列 kernel、跨 GPU 切分 Engram 表时的点对点直读,以及一批执行层面的优化。
DeepSeek 的 kernel
SGLang 集成了 FlashMLA、DeepGEMM、DeepEP、DeepSelect 和 TileLang kernel,以及 Mega 系列:MegaAttention、MegaMoE、MegaGate 和 Mega-mHC。
MegaMoE 把 token 分发、专家 GEMM 和 combine 融进一个 kernel。MegaAttention 是 B300 和 GB300 上的默认注意力路径,单机如此,prefill 和 decode 两侧也都如此。
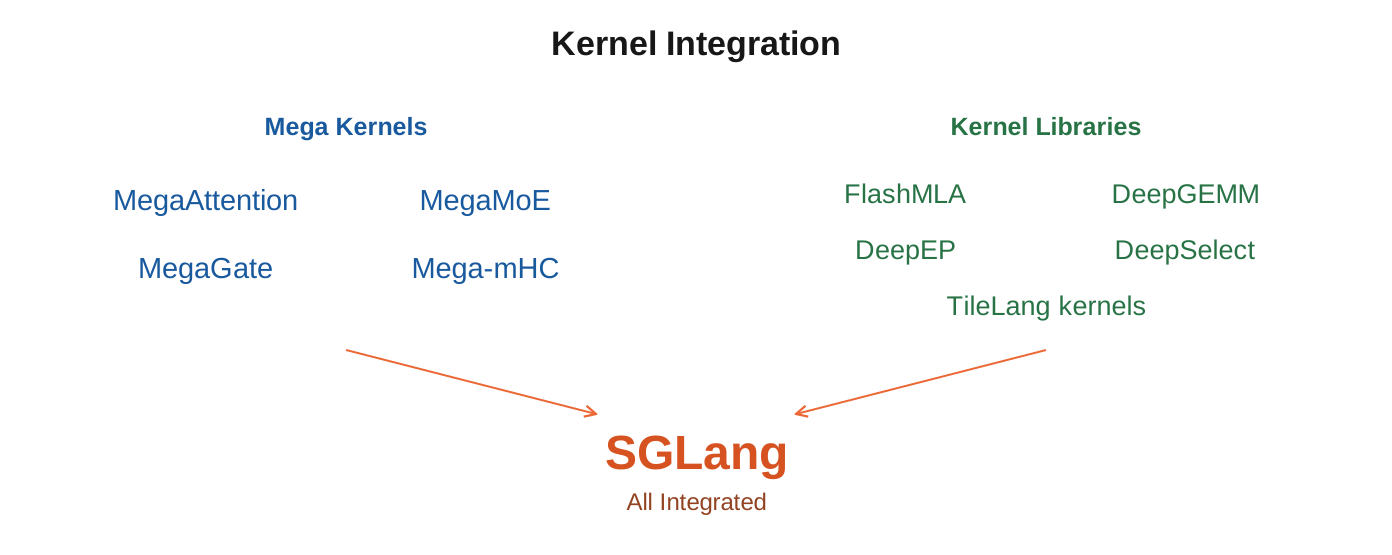
图 1: SGLang 集成的 kernel。
并行策略
SGLang 在 prefill 和 decode 两侧都采用 DP attention 加专家并行(DEP)。下面的基准在 64 张 GB300 上运行,prefill 用 DEP4,decode 用 DEP64。
在大规模 EP 部署里,SGLang 还支持用 EPLB 平衡专家负载,具体见我们的 MoE 负载均衡博客。
DSpark 投机解码
SGLang 会跑 checkpoint 自带的 DSpark draft 模型,一次提议一组 token,交给目标模型统一验证,从而减少生成一段回复所需的目标模型前向次数。
SWA bounded replay
解码重放只让靠后的 decoder 层处理最后 128 个 prompt token,靠前的源层仍然处理完整 prompt。命中前缀缓存时,编码重放用最后 128 个已缓存 token 重建缺失的滑窗 KV。
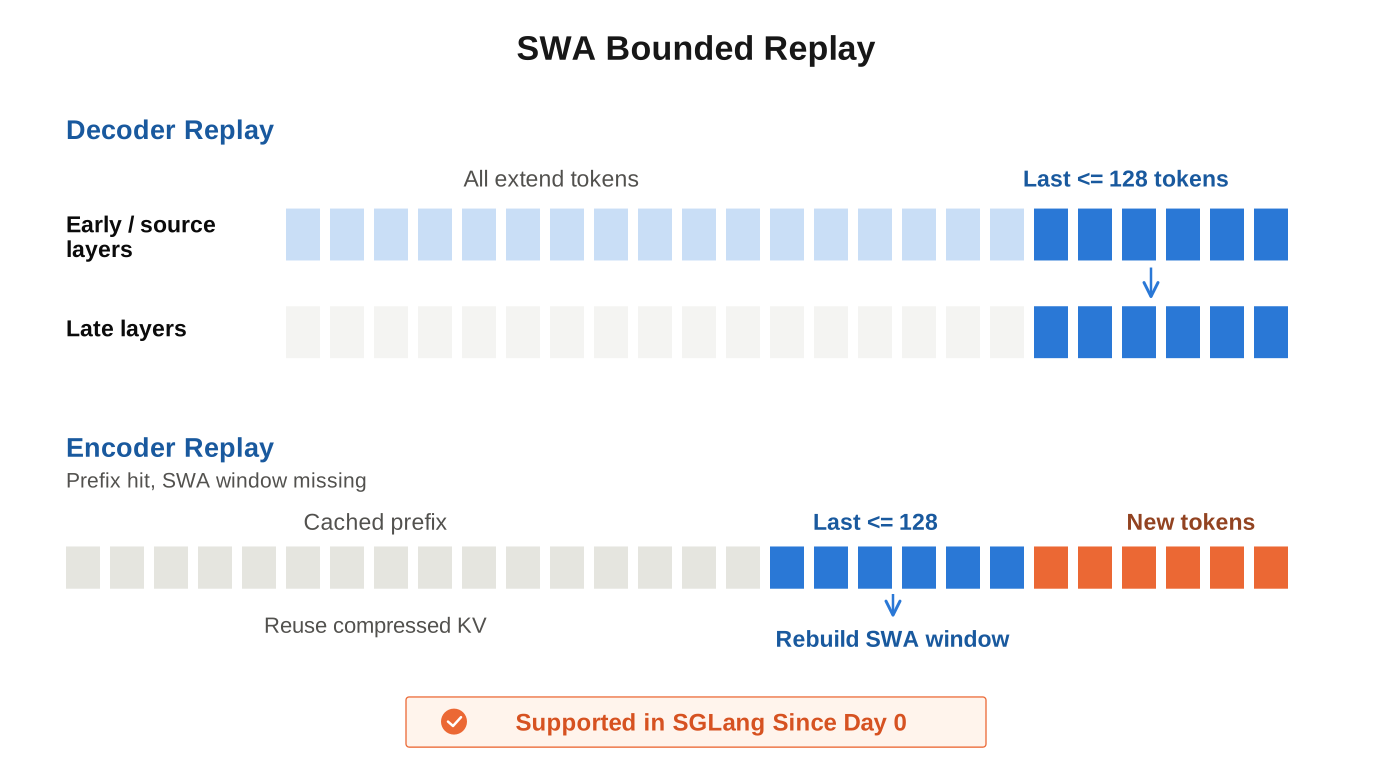
图 2: SWA bounded replay:解码重放与编码重放。
Engram 放置
DeepInfer 允许把 Engram 表放在主机内存,也允许放在显存,SGLang 两种都支持。
设置SGLANG_ENABLE_DSV41_ENGRAM_HOST_TABLE=1 时,每个节点在主机内存里存一份表,能把最多的 HBM 留给 KV cache;
设置 SGLANG_OPT_DSV41_ENGRAM_PEER_SHARDS=1 时,表按 GPU 切分,每张卡通过 NVLink 直接读对端上自己需要的行,查找过程不涉及 all-gather 和 reduce-scatter。
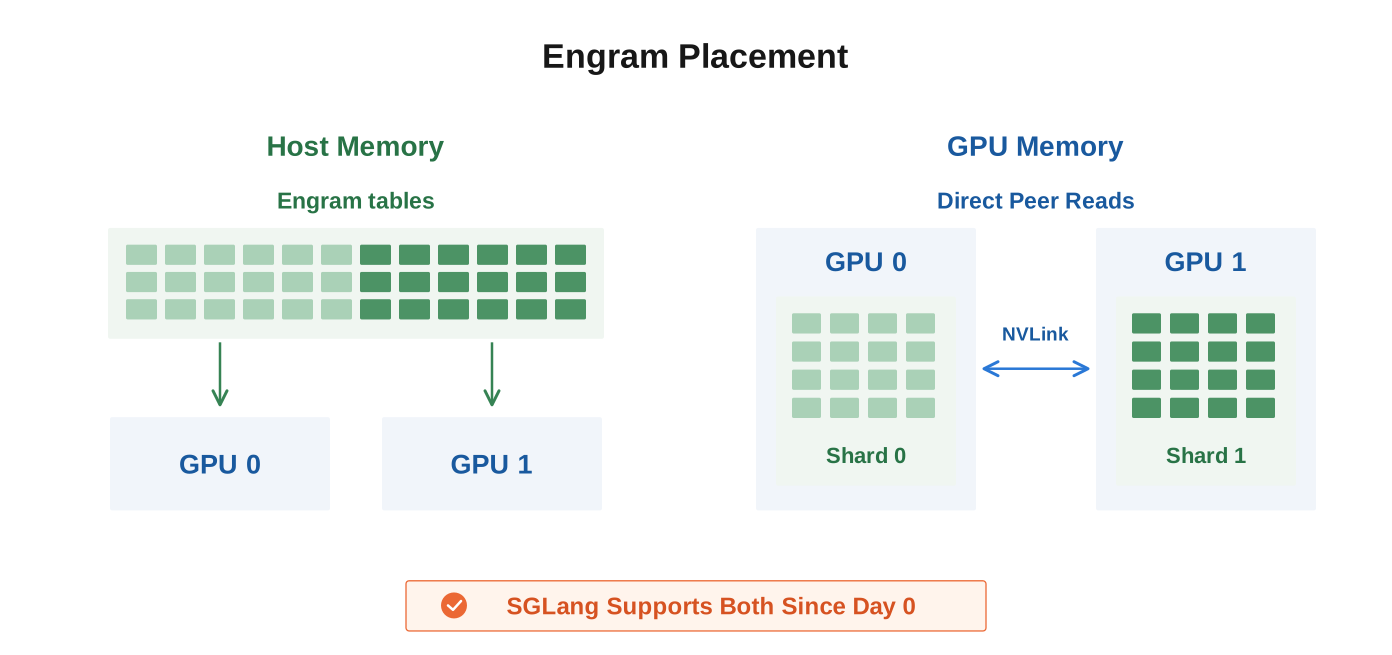
图 3: Engram 表放在主机内存,或跨 GPU 切分并点对点直读。
零开销调度
从 v0.4(2024 年 12 月)开始,SGLang 的调度器在 GPU 跑第 N 步时,用 CPU 准备第 N+1 步,让调度与 GPU 执行重叠起来。DeepInfer 的文档把这一设计归功于 SGLang。
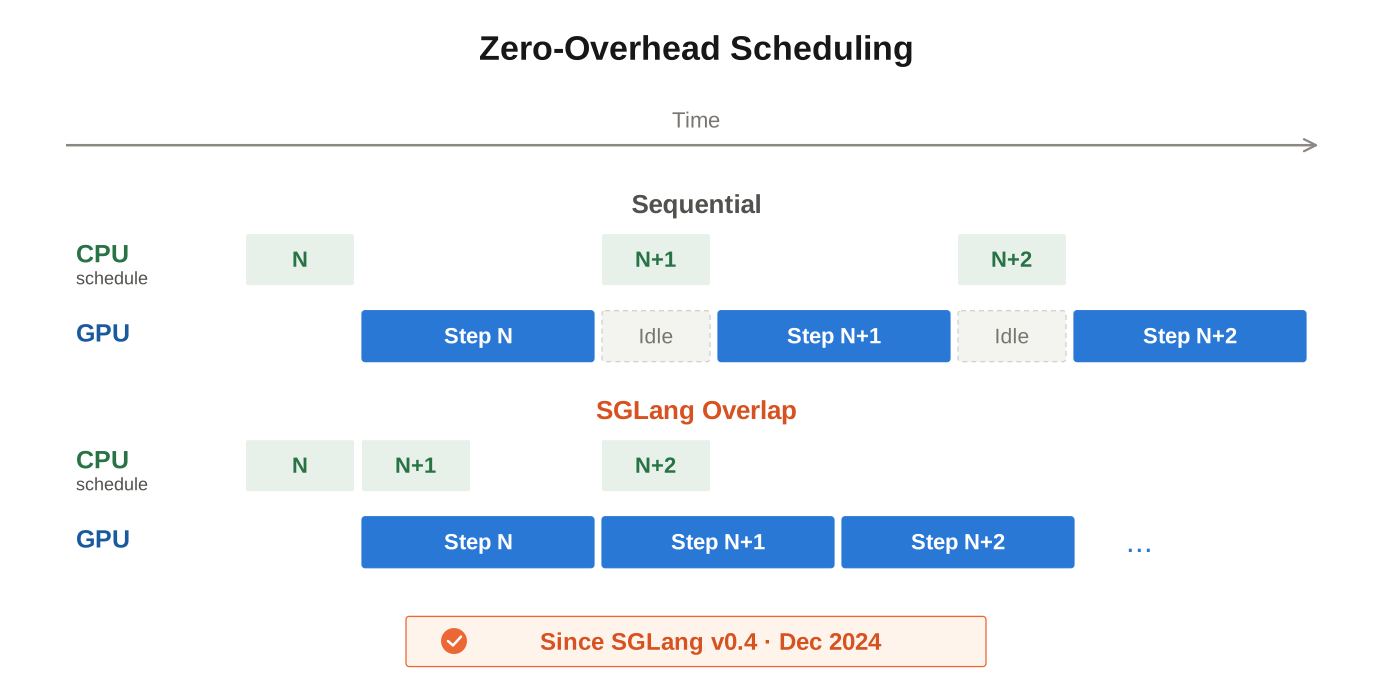
图 4: 零开销调度:GPU 跑当前步,CPU 同时准备下一步。
DeepSeek 的对话格式
prompt 的渲染和输出的解析都走 DeepSeek 自己的 deepseek-recipe 包(#45315、#45907、#46219),因此 SGLang API 里的推理过程和工具调用都遵循 DeepSeek 的格式。语法约束解码支持 JSON schema、正则和 EBNF。
结果
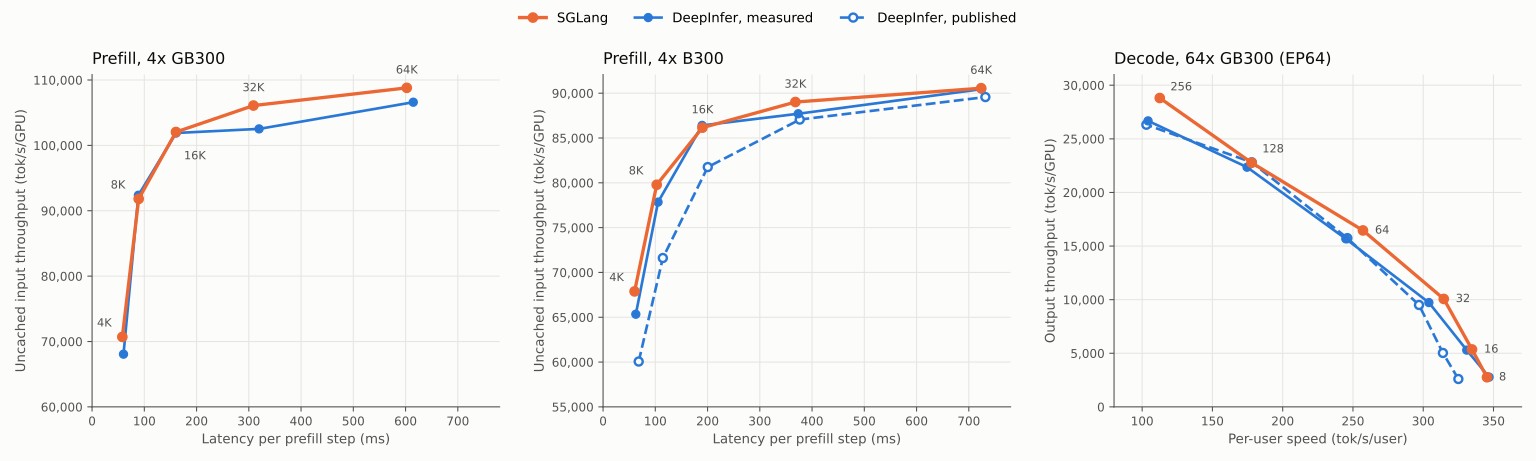
图 5: 4x GB300 和 4x B300 上的 prefill,64x GB300(EP64)上的 decode。
实测(实线)是我们自己跑 SGLang 和 DeepInfer 的结果。已发布(虚线)是 DeepInfer 最初公布的 prefill 和 decode 结果,数值从这两张图里读出来。正文中的 prefill 对比用的是实测的 DeepInfer 曲线,每个测点取它测过的最快配置。


设置见文末附录。简版:
- Prefill,4x GB300。 SGLang 的 prefill 吞吐最高到 1.04 倍:在每卡每步新增 4K、32K、64K token 时领先,8K 和 16K 打平。
- Prefill,4x B300。 最高 1.04 倍:4K、8K、32K 领先,16K 和 64K 打平。
- Decode,64x GB300(EP64)。 每卡 16 到 256 个请求时,SGLang 的单步耗时短 1.1% 到 7.4%,8 个请求时打平。
速度从哪来
Mega-mHC 直接喂给 MegaMoE,注意力输出 MXFP8 结果供输出投影使用,prefill 压缩器和请求窗口的 KV 拷贝都走融合 kernel。这些改动减少了中间访存和 kernel 启动次数。
可断点的 CUDA graph 覆盖每卡最多 8K token 的 prefill 步,长上下文和 DP attention 都在其中。解码重放使用另一套按有界后缀单独定尺寸的 graph,因此当一个大的 prefill 步的其余部分以 eager 方式执行时,这些层仍然能从 CUDA graph 里重放。
SGLang 补上了什么
DeepInfer 的 README 列出了完整推理服务需要的三个组件,而这次的发布没有包含它们。SGLang 三样都提供。
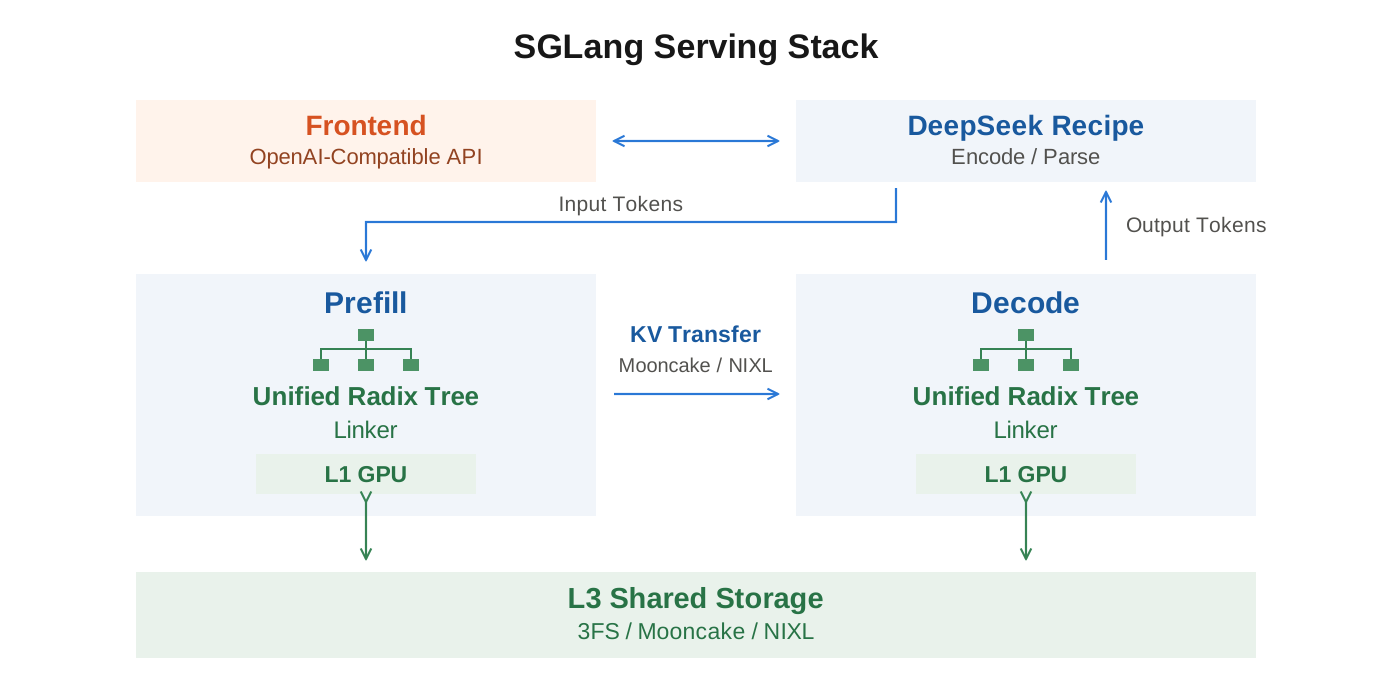
图 6: Linker 把本地 L1 GPU cache 直连到共享的 L3 存储。
KV cache 系统。 SGLang 的统一基数树缓存能在请求之间、对话轮次之间复用 KV,本文这种混合模型同样适用。上图配置用 Linker 把 L1 GPU cache 直连到共享的 L3 存储,比如 3FS 或 Mooncake;对于需要二级层的部署,HiCache 也支持把主机内存当作 L2。
Prefill/decode 分离。 SGLang 把 prefill 和 decode 放在不同服务器上跑,KV 传输后端可选 Mooncake、NIXL 或 MORI。
跨副本负载均衡。 SGLang 的模型网关把请求分发到各个副本,并支持按缓存前缀路由。
在这些之上,SGLang 本身就是 API server,带推理过程和工具调用解析,覆盖 NVIDIA GB300、B300、B200、H200 以及 AMD MI355X。
附录:基准测试设置
两个引擎跑的都是 DeepInfer 自己的基准,硬件相同。SGLang 的 prefill 用 7d996300b9,decode 用 3b95120f00,DeepInfer 用 774ce24。两边的启动命令和基准客户端都在这个 gist 里。要真正部署模型,请走 cookbook 页面;下面这些设置(比如均衡专家路由)只为对比而存在。
Prefill
负载与机器。 我们用 DeepInfer 的 prefill 基准:每个请求 128K token 上下文、4K 新增 token,每张卡每步 prefill B 个新 token,B 从 4K 到 64K。两个引擎跑在同一个 4 卡节点上,权重相同,DP4/EP4,均衡专家路由,关闭 EPLB,32 个冗余专家。
DeepInfer 在每个测点上取两种 Engram 放置(主机内存或显存)中较快的一种,各自用它自己的默认设置和 64K 设置。SGLang 把 Engram 表切到多卡,冗余专家均匀铺开,并开启了少量尚未默认打开的优化。
差异。 DeepInfer 测的是 GPU 0 上大约 9 个 batch 的 prefill 耗时。SGLang 的结果取的是 20% 到 90% 请求完成之间,所有 GPU 上每个完整 batch 的平均值。DeepInfer 让同一张卡上的请求复用同一个 prompt,SGLang 每个请求的新 token 不同。
Decode
负载与机器。 在 64 张 GB300(16 节点,DP64/EP64)上对齐 DeepInfer 的 decode 负载:128K token 上下文加共享缓存前缀,每张卡固定请求数,每步 3 个 draft token 且采用静态验证(每个请求都验证完整的草稿块),均衡专家路由,384 个路由专家加 64 个冗余专家。图表按每步接受 3.25 个 token,把步耗时换算成 token 数。
差异。 SGLang 把 Engram 表放在显存,DeepInfer 放在主机内存;DeepInfer 的 draft 模型带 64 个冗余专家,SGLang 的 draft 不带。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册