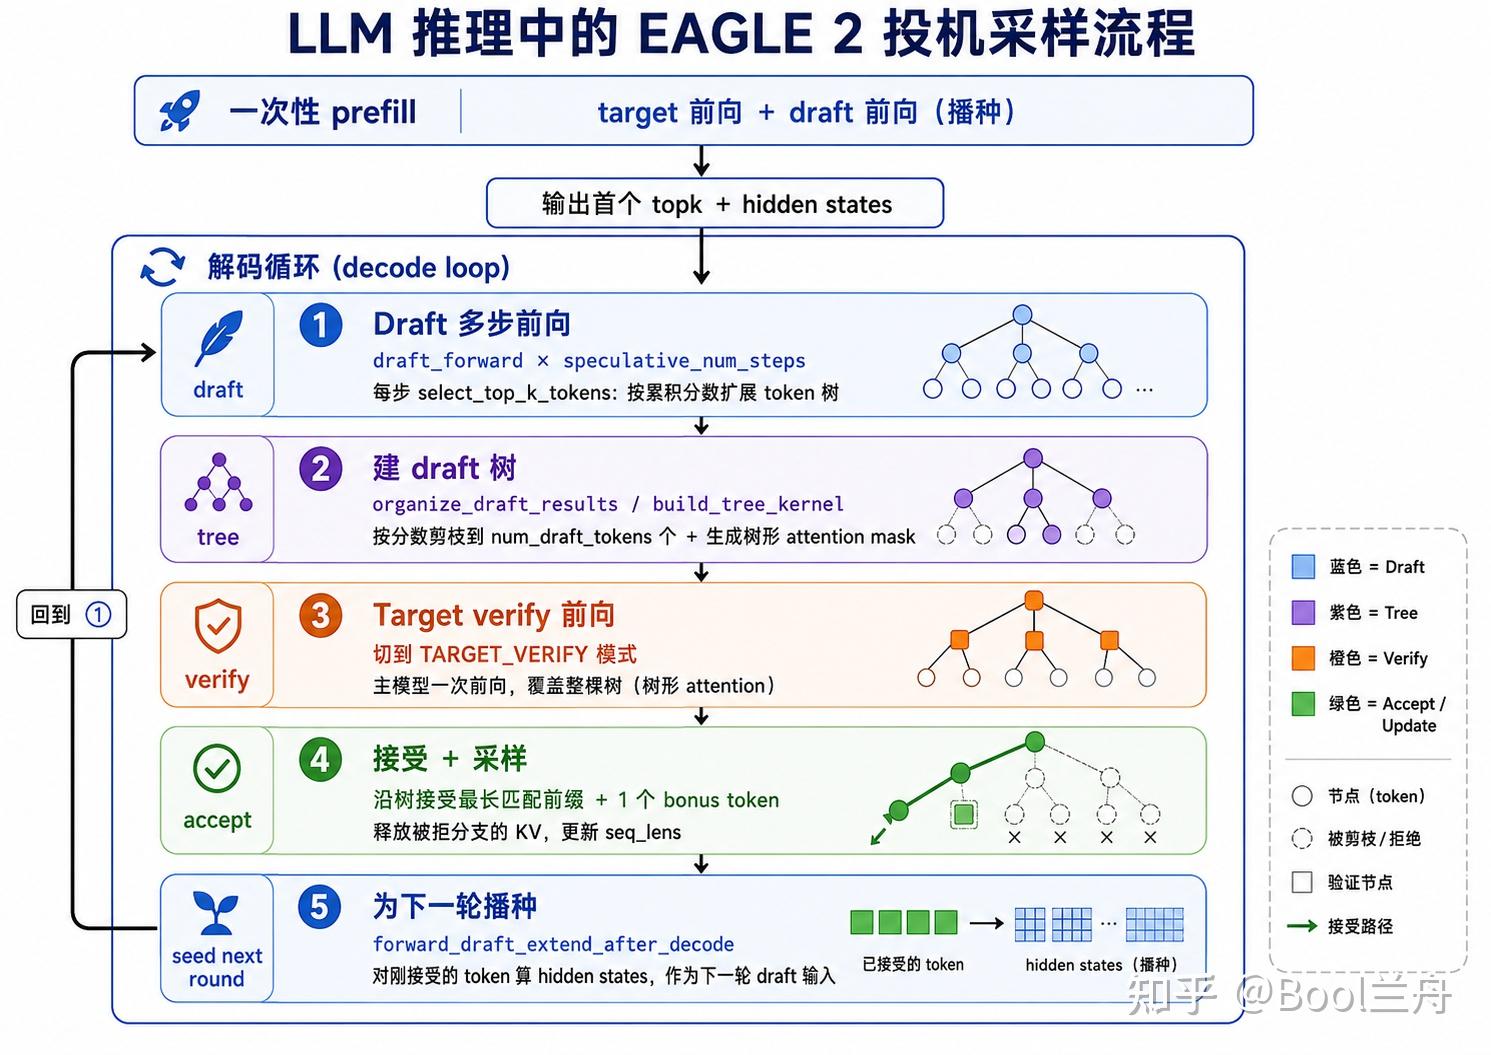
精选文章 把投机采样讲透:以 SGLang 中的 EAGLE-2 为例 投机采样(Speculative Decoding)这两年几乎成了 LLM 推理加速的标配,但真正理解它的人不多。很多人停留在”小模型猜、大模型验”这一句话上,一到细节就懵:主模型 verify 的时候到底在算什么?为什么一次前向能验好几个 token?长上下文到底是帮忙还是帮倒忙? 这篇文章以 S
青稞Talk DeepSeek V4 模型在 SGLang 中的系统级优化与全栈适配 4月25日,当 DeepSeek-V4 带着 1.6 万亿参数(Pro版)和百万级上下文窗口的震撼配置横空出世时,整个大模型圈的目光都聚焦在了它极具野心的架构革新上:混合稀疏注意力(CSA+HCA)、流形约束超连接(mHC)以及 FP4 专家权重。 然而,对于广大开发者和企业用户而言,面对如此庞大且
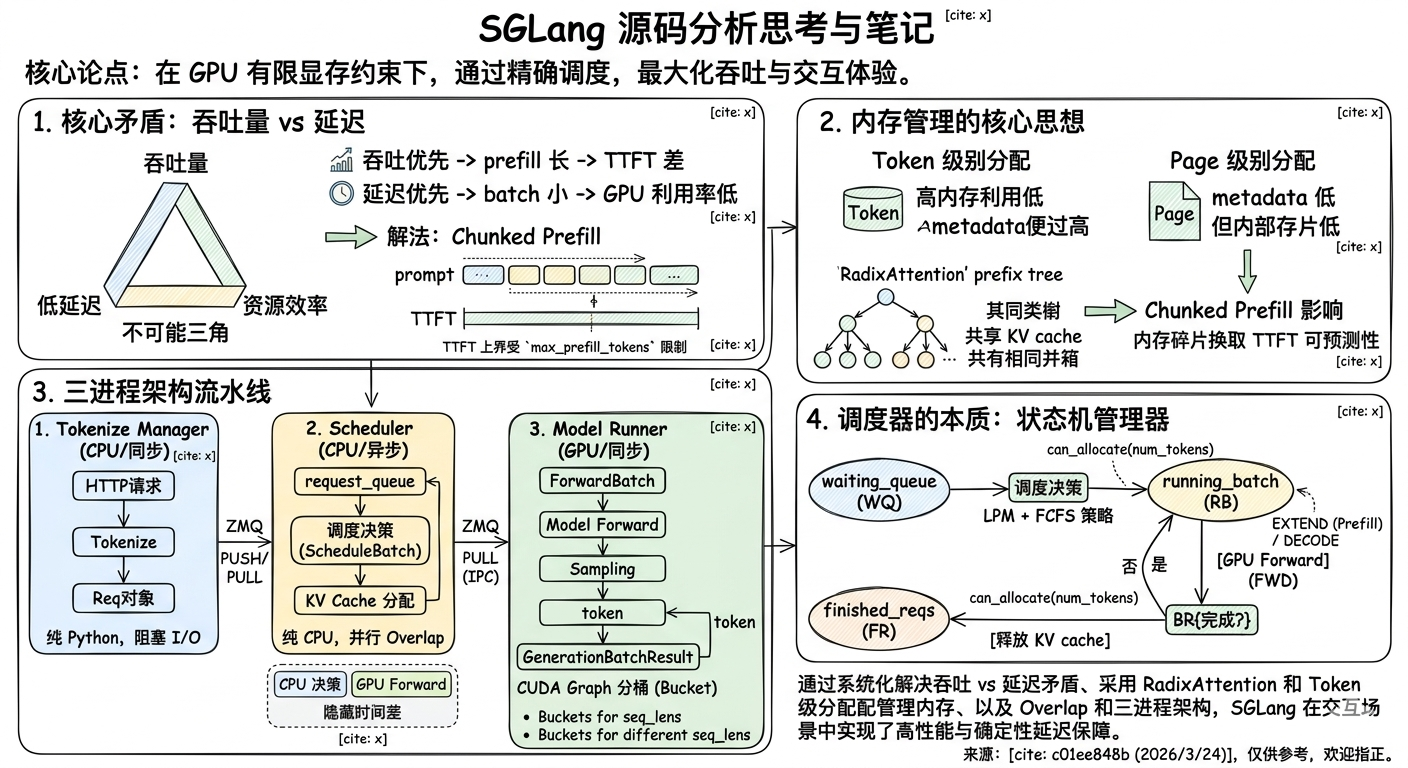
精选文章 SGLang Overview:设计哲学与关键机制 作者:方弦 https://zhuanlan.zhihu.com/p/2020514624856957623 记录整理一下最近学习vllm和sglang源码的一些思考和笔记。 其中包含了和LLM交互问答得到的一些内容(源码分析和注释等部分),用于加深对现代高性能推理引擎实现的理解。分析基于的源码版本
青稞Talk SGLang v0.2:面向 LLM 和 VLM 的快速、高效通用服务引擎 9月3日11点,青稞Talk第21期,Databricks Mosaic Research研究科学家,斯坦福大学博士盛颖 ,将直播分享的《SGLang v0.2:面向 LLM 和 VLM 的快速、高效通用服务引擎》。 主讲嘉宾 盛颖,Databricks Mosaic Research研究科学家,斯