转眼间已经距离Astra横空出世过去了好几个月了,这段时间也出了非常多的RSI、Harness系统刷爆了仿真,特别是之前被誉为珠峰的Robodojo,平均一周榜首换两三个,还基本上都是Agentic系统。
在这个狂欢下,我们不禁注意到,仍然有若干问题是agent无法解决的,以及一些是即使到GPT7、8也和难解决的系统问题,因此特开一帖来梳理一下这几个问题。以及在Agent时代,我们应该做什么?不应该做什么
我们应该做什么:什么问题是有价值的?
一个思考:为什么Astra会有具身能力
其实OpenAI在一开始并没有直接训练astra具身操作的后训练(虽然有说法认为Astra带了很多ego数据,但是我仍然觉得这个更偏理解,而非具身),但是究竟是什么让astra具备了相关能力呢?我认为有两点:
1、Computer Use:这是一个和Embodied Manipulation同构的问题。都是高闭环响应性,都必须针对observation输出action。
2、 3D Blender建模:Blender操作的后训练让GPT Astra的3D能力得到史诗级增强,一下子把类似Embodied-R1.5等具身特攻VLM的所有能力壁垒攻克了,3D能力的增强允许Astra更好的理解空间关系,进而完成操作。
Agent + 灵巧手(或人形机器人),超高自由度和实时控制带来的问题?
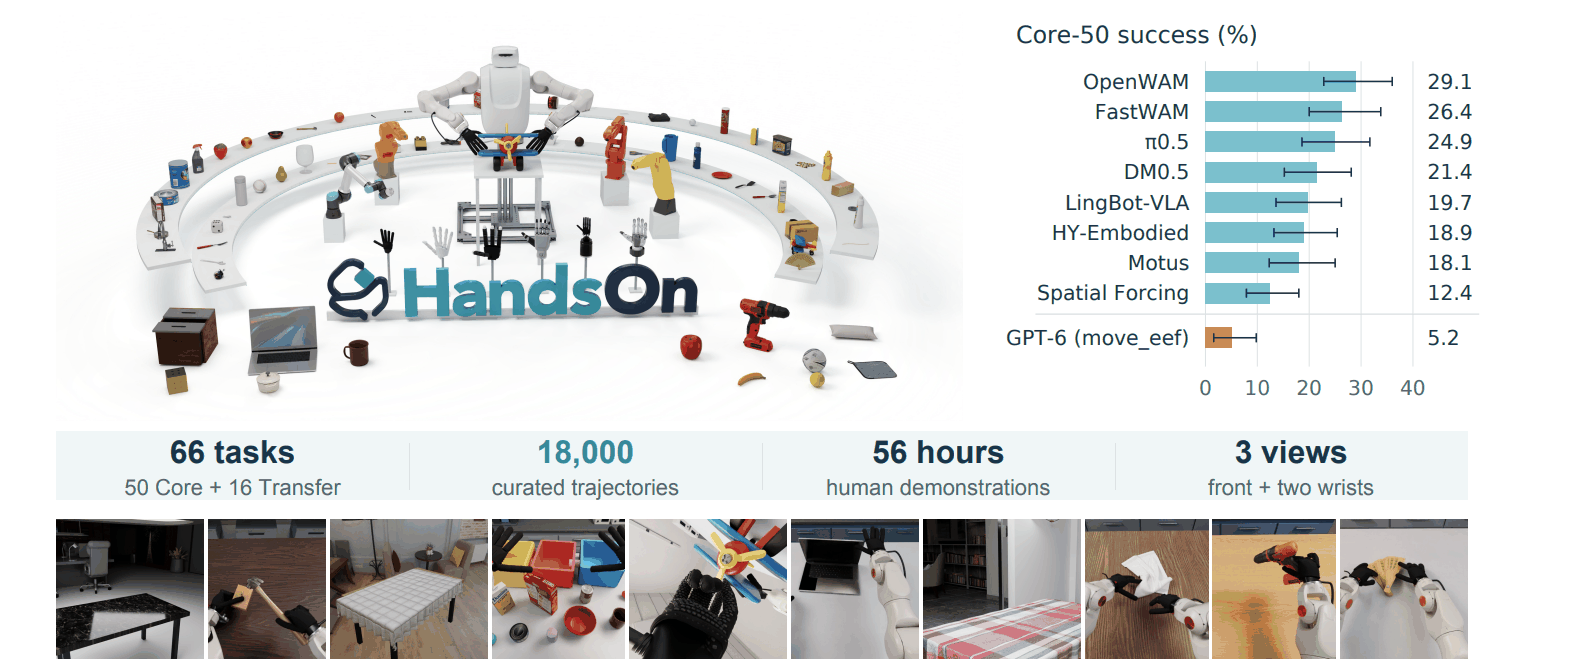
这篇文章作者让Astra用code as policy操纵灵巧手完成任务,结果效果惨不忍睹,成功率只打到了5.2%。
不否认这个测试只提供了eef的接口,harness有点不过关(例如DexJoco被RAX刷到了95%+),但是结合个人的观察来看,确认agent code as policy控制灵巧手所需要花费的时间和token数量都是远远比夹爪任务多的;并且成功率也是远远低于夹爪。
那么在这个问题上,我们能做什么呢?首先我觉得这个问题是可以被GPT7解决的,因为超高自由度,之前认为不可解的高自由度问题,例如直接一遍盲写SVG做鹈鹕骑车动画,这个在人类看来根本不可能的事情,早已被解决,那么一次性输出多个灵巧手关节的action指令,看来也是一个可以被数据解决的问题。
不过,短期和长期内,我们都可以为灵巧手操作的速度来进行优化,例如结合一些System1的模型,来辅助Agent完成快速高动态的灵巧手操作,具体这个System1的模型怎么来,可能是未来工作的核心方向之一。
Agent + VLA/WAM:未来的VLA/WAM应该具备什么能力?
现在的相关系统有很多做法,类似银河通用的那篇,agent审核VLA/WAM输出的动作,然后进行改写,或者类似HarnessVLA,直接选择使用actor动作或者自己code as policy。所以说这个方向不断进化成:VLA/WAM会成为agent调用的一个tool。
那么作为一个tool,我们设计VLA/WAM的时候就不能沿用之前的路子了;而是应该把重点关心在:
- actor如何更好的follow agent指令(language following)?
- follow的是否一定要是language指令(multimodel interface)?
- 如何快速向agent反馈信息(backward infomation flow)?
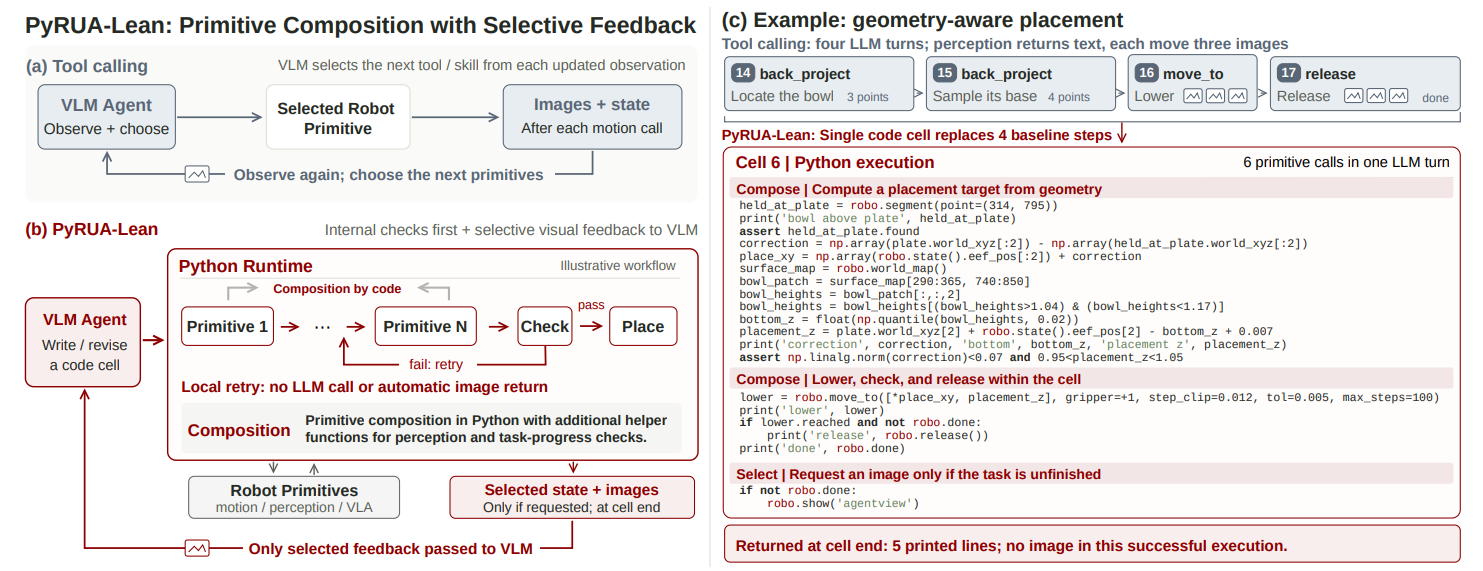
但是不得不说的是,最近不依赖于VLA/WAM的Agent系统越来越多,例如PyRUA-Lean、RAX等,VLA和WAM是否真的未来是一个好用Tool,还等待技术方案收敛。
Make Agentic System Faster
另外一个问题就是:Agent很慢,但是这个时间往往难以节省(因为调的api)。所以我们能做的大概只有两个点:
1、 一次让agent执行更长的action/做更长的规划;例如之前复旦做的YOPO,就是让agent在一开始画任务关键操作点,然后后面的闭环执行、failure covery都由VLA负责,相当于做system之间的trade off
2、 第一次OOD的场景让agent在线慢探索,沉淀skill后复用已有程序进行快速执行,在遇到failure或者意外时可以call agent进入慢系统。这个和RAX说的fast code思想很像。
3、 如何更好的实现异步交互,类似之前的physical intelligence所propose的language coaching,agent是否可以成为一个泛化性不错的VLA的异步language teacher,替代之前的人类?
Perception Layer:Harness的后勤
现在大家用的Perception Tool五花八门,例如多相机特征点标定、RGBD硬出点云然后点云硬用代码分析、SAM3D等等。
其中一个核心点就是:在真机/仿真里面提供3D深度信息,会对agent系统特别有益。同时最近在小红书看到一篇直出object 6D Pose的3D模型,甚至简介里面写了就希望成为一个Robotics Agent系统好用的tool。
种种迹象都能说明,perception layer的重要性。可以说做了一个好的perception layer,整个harness系统是可以无缝提点的。
并且很重要的,就是是否能让perception layer也成为一个RSI过程中能不断进化的part呢?相比于固定的SAM3模型,或者VGGT模型,一个可以不断随着RSI探索过程中残差修复、进化的感知模型会更加符合Sutton的Bitter Lesson。
蒸馏Astra
这个其实很有意思:
- 蒸馏什么数据
- 怎么蒸
- 蒸到什么模型
- 蒸完的模型干什么用
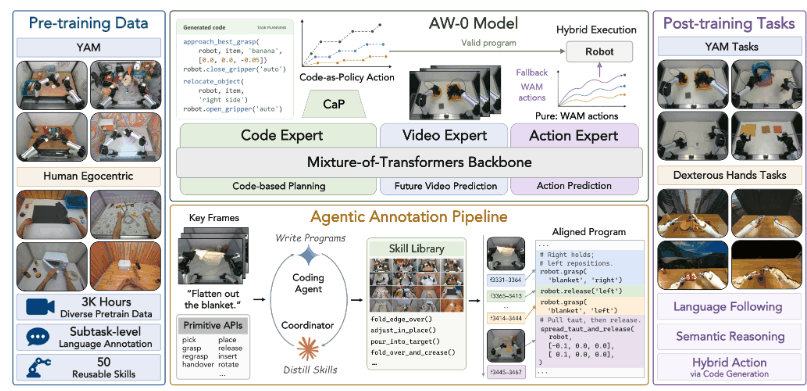
都是很值得探究的问题。举个最简单的例子,像NVIDIA的AW-0就是把Astra的CaP能力蒸馏到一个小的dVLM里面,然后通过MoT的方式给actor传递规划信息。
但是不建议的是个人研究者/早期创业公司去做单纯蒸馏VLM的事情,一是没有意义二是没有必要,说不定蒸完之后Qwen的蒸馏版就release开源了。
Real2Sim
这里其实已经觉得RPG这篇文章做的很好了,发现了一个关键点,就是仿真环境相比于真实环境的一个优势就是能获取到特权信息(例如object state),因而使用privilege teacher来指导student学习policy。
此外就是一些传统的问题了,如何将例如PIN-WM这种文章做的物体物理属性估计做成一个好用的agent skill,让sim2real gap更小,会是一个值得研究的问题。
我们不应该做什么
这里简单总结若干个点吧,仅限个人思考:
1、 过度追求end2end模型:花了大力气去训练VLA/WAM的reason能力和长程规划能力,主要体现在研究基模已经具备的能力
2、 刷仿真benchmark:虽然仿真benchmark很好刷,关注度也很高。但是不要让仿真benchmark成为一个模型/论文的局部最优拟合点。从真机来,到真实世界去。
3、 做单纯手快的事情:如果你看完这篇blog觉得自己的idea和文章中某些观点撞车了,那么你的研究方向大概率是一个low hanging fruit。在coding agent时代,如果做的方向是单纯手快方向的话,大概率会在做到50%~75%的时候被别人抢发撞车。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册