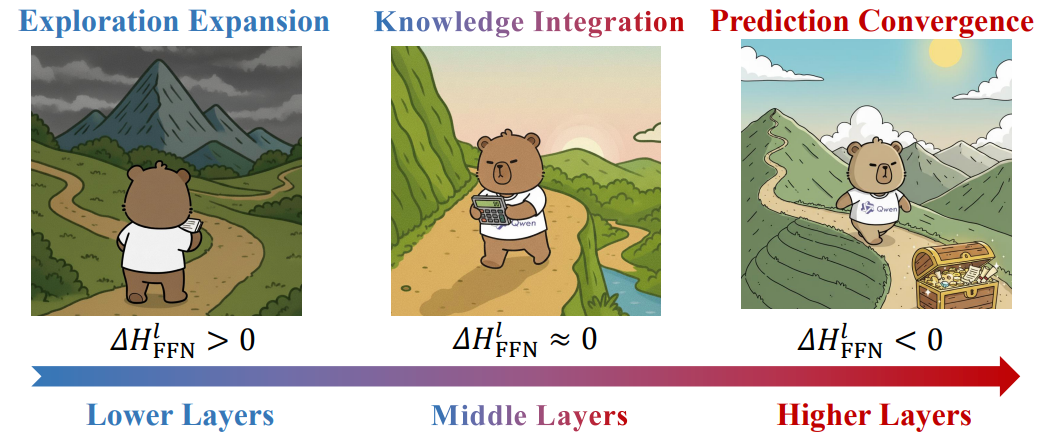
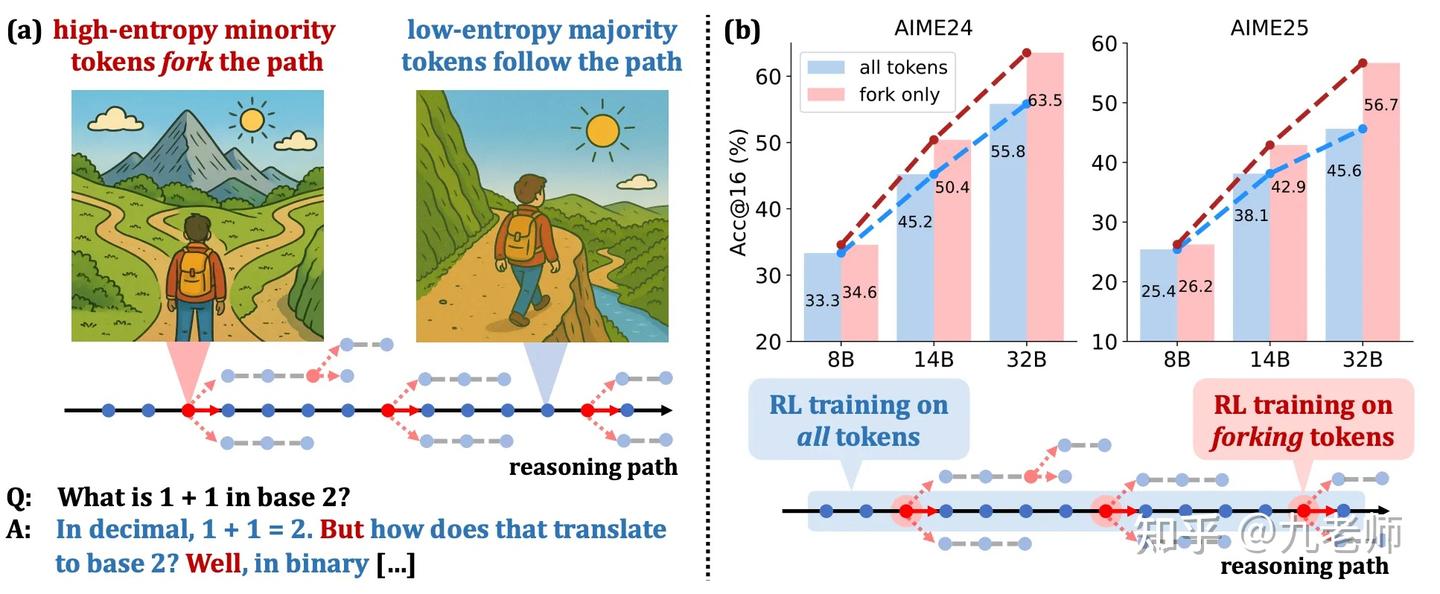
精选文章 LLM内部竟藏着众多策略模型?自动化所&腾讯团队首次揭示大模型RL新机制 当前,大模型+强化学习成为AI领域极为热门的研究。现有的强化学习(RL)方法通常将大语言模型(LLM)视为一个单一的整体策略进行优化,主要的算法优化集中在表层的奖励设计等方面,却忽略了模型内部复杂的层级演化机制。 大模型的黑盒特征通常阻碍了我们进一步了解其内部工作机理,然而理解其如何执行内部推理能为
精选文章 从 Rollout 到 Agentic RL,再到SaaS RL,聊聊 RL一整年的感悟 作者:大润发杀鱼工 https://zhuanlan.zhihu.com/p/1985812420770428370* 前情提要 窝趴在电脑前下棋的我,突然被微信里 junrong 老师Q到了,说知乎上又刷到了我去年的年终总结,还问我今年什么时候写。ahhh,其实本来是有想写的,可惜这个班害人不浅,
精选文章 经验分享!这半年来,用 RL 做 LLM 后训练时踩过的那些坑与心得 作者:天晴 https://zhuanlan.zhihu.com/p/1986921621240447760 用 RL 做后训练 LLM 时,探索效率和训练稳定性是两个最核心的问题。这半年,我积累了不少心得感悟,也踩了很多坑。由于打算金盆洗手不再做这方面的工作了,索性把这些经验分享给大家。 当然,这
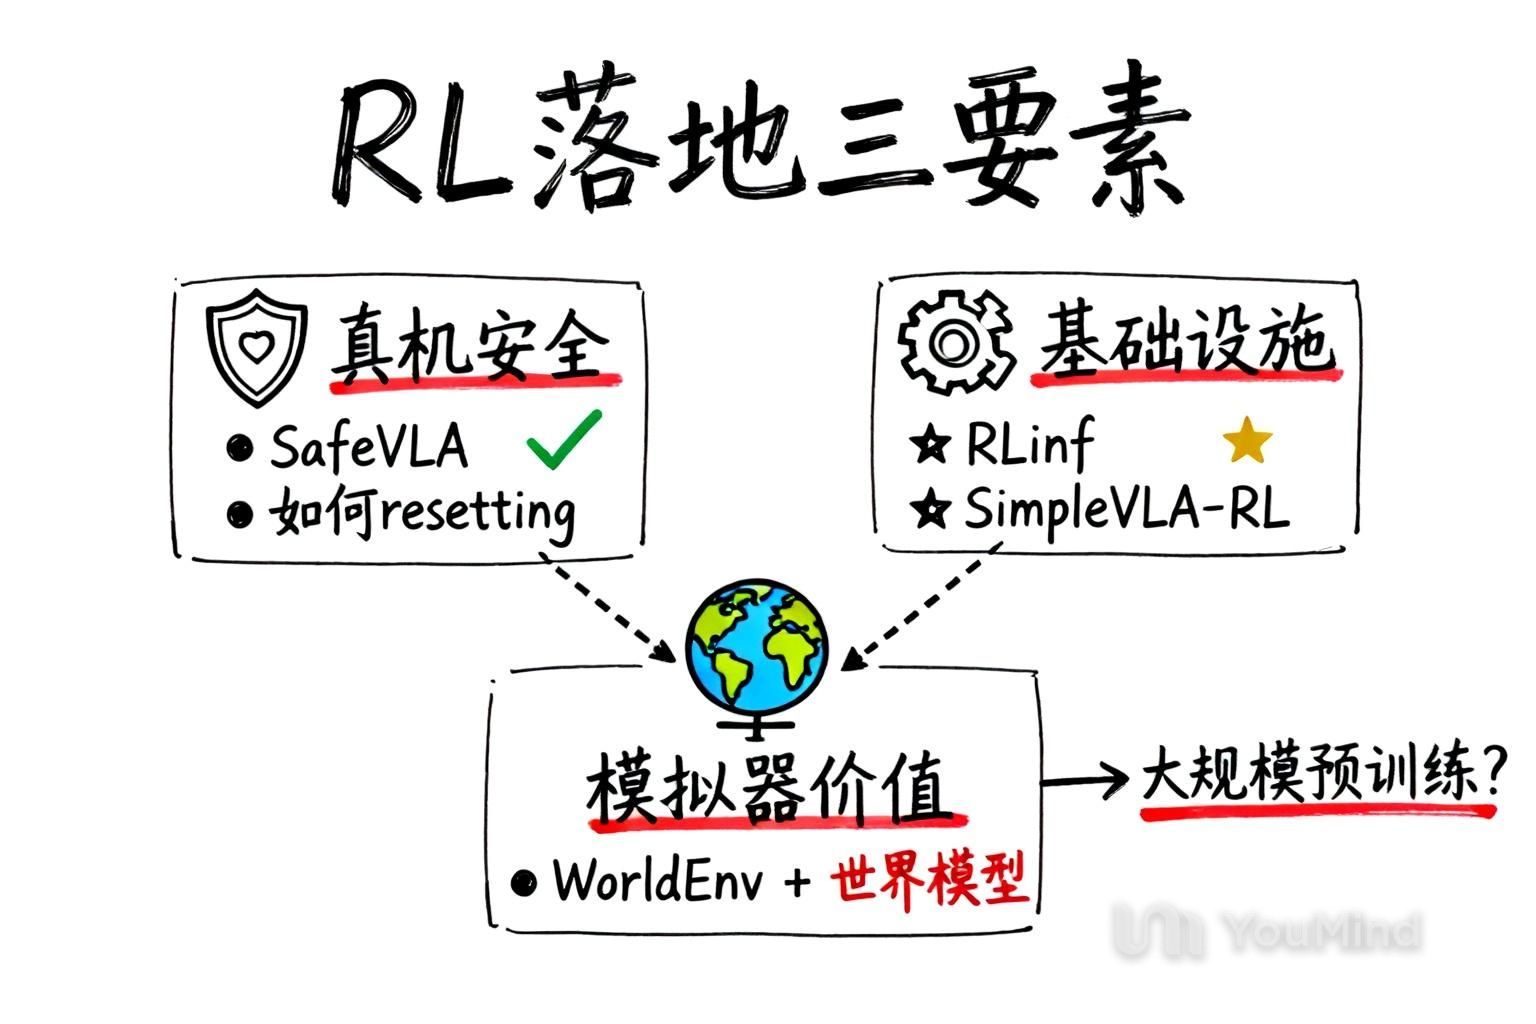
精选文章 在看完近50篇VLA+RL工作之后...... 视觉-语言-动作 + 强化学习:VLA+RL 最新研究全景(含论文、链接与代码) 随着基于大规模模仿学习的视觉-语言-动作 (VLA) 模型取得显著进展,将 VLA 与强化学习 (RL) 相结合已成为一种极具前景的新范式。该范式利用与环境的试错交互或预先采集的次优数据,进一步提升机器人的决策与执行能
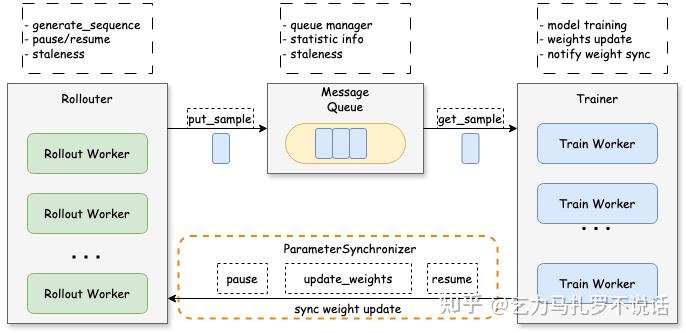
精选文章 工业级 Agentic RL 训练对比选型指南 作者:乞力马扎罗不说话 https://zhuanlan.zhihu.com/p/1978600046514685178 这篇博客想法诞生于上半年基于 trl / verl 魔改 agentic rl 时期,但拖延一直搁置。眼看相关技术栈演进速度惊人,再不发出来就要过气了,于是决定抛砖引玉分享。预计
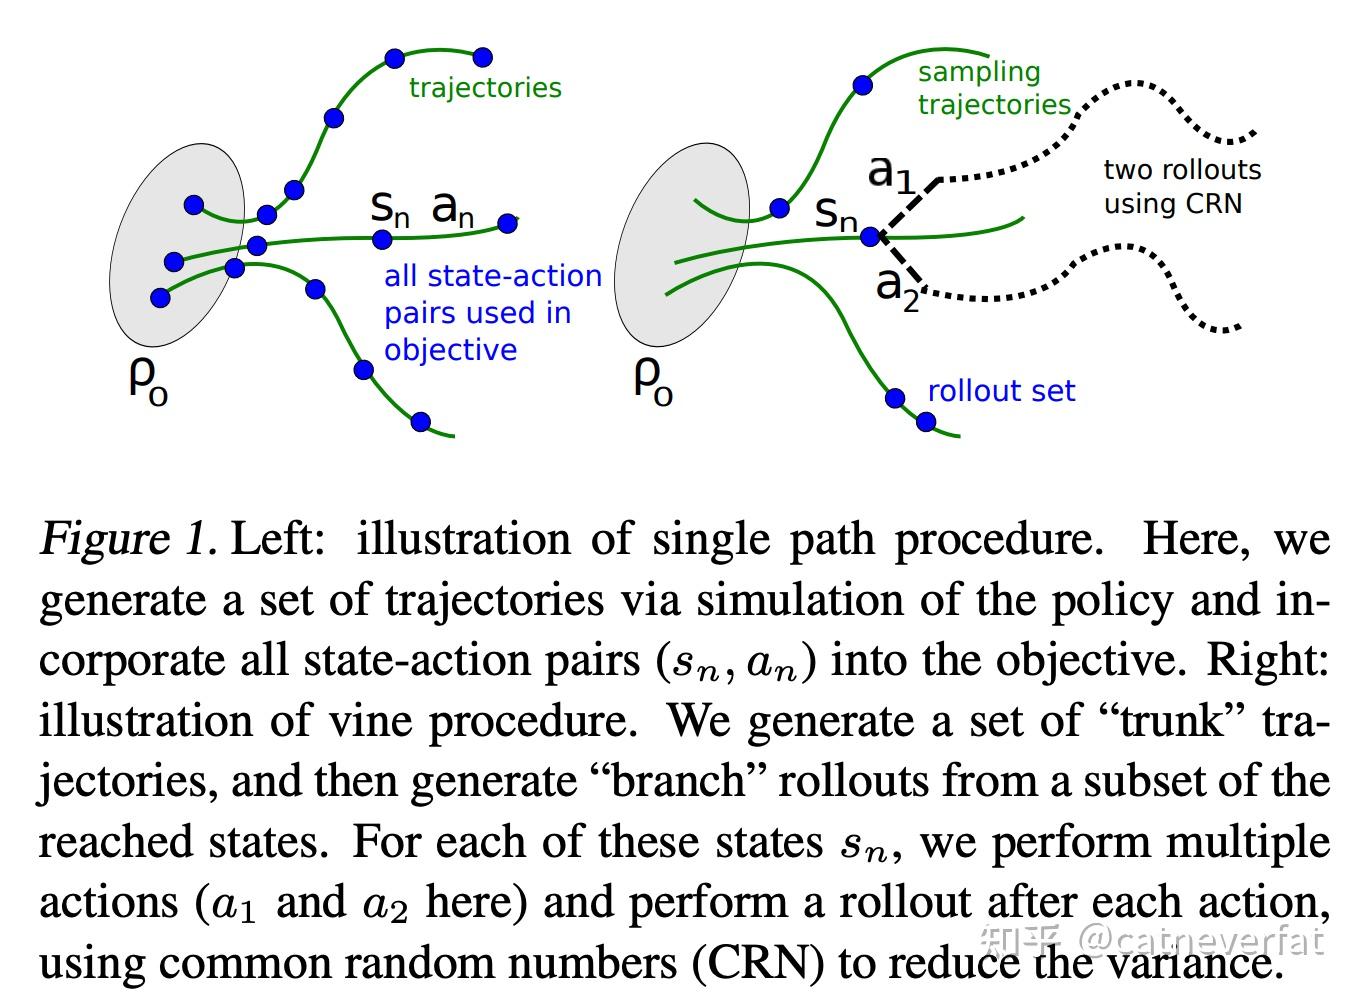
精选文章 深挖强化学习算法PPO,聊聊前身TRPO 作者:catneverfat https://zhuanlan.zhihu.com/p/1908671543476749557 PPO是一种被广泛应用于各个场景下的强化学习算法,笔者之前对它展开过介绍。但是当时主要的理论推导集中在Policy Gradient部分,对PPO主要介绍的是它的目标函数以
青稞Talk TRPO重生:大模型时代的信任域策略优化 在大型语言模型(LLM)的强化学习(RL)阶段,特别是人类反馈强化学习(RLHF)中,我们追求策略 \pi_\theta 的持续优化。 然而,LLM 的复杂性和分布式训练特性,带来了一系列独特挑战,这些挑战在数学上可以统一归结为一个核心问题:策略部署(rollout)与策略更新(\pi_\theta
精选文章 让“思考”本身有价值!为什么模型 RL 后思维链长度持续变短? 作者:Cyril-KI 原文:https://zhuanlan.zhihu.com/p/1982850692340273471 一个有趣的训练现象 在SFT阶段,我们精心设计”Let’s think step by step”提示,成功诱导出丰富的思维链。然而进入RL阶段后,Wandb监控曲线显示R
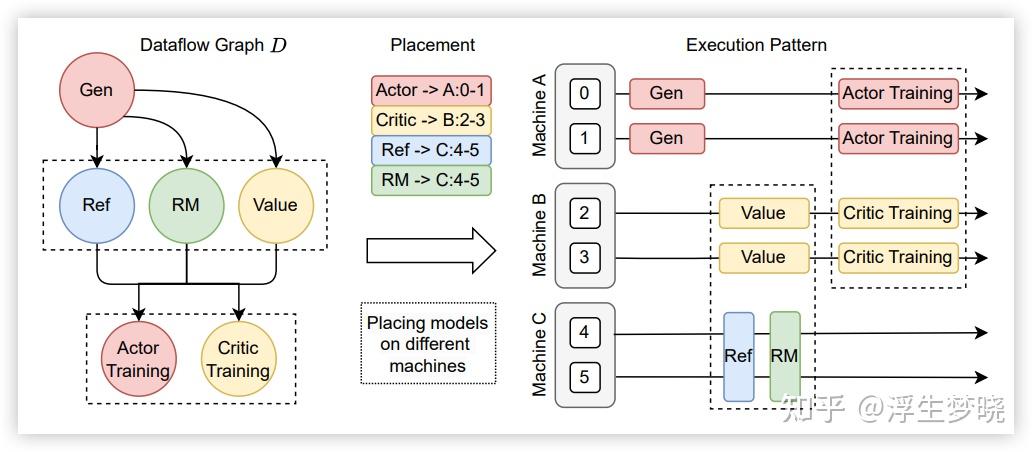
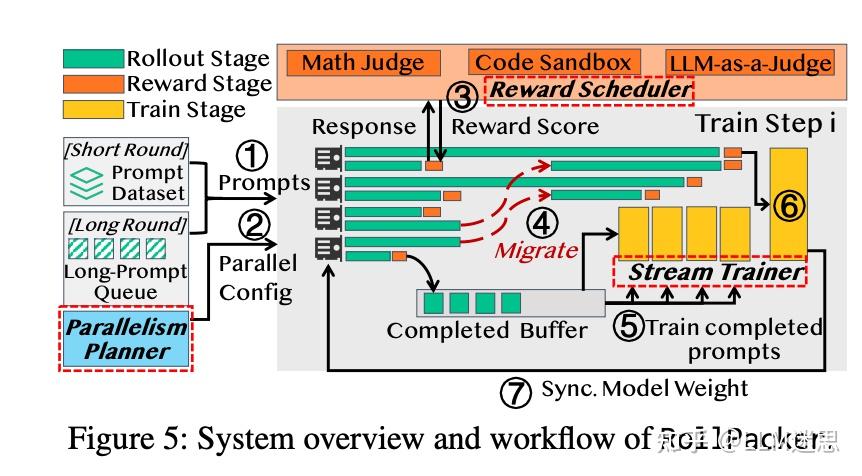
精选文章 对比现有的 RL 训练框架!聊聊关于 Agentic RL 训推框架的一点看法和思考 作者:浮生梦晓 https://zhuanlan.zhihu.com/p/1979237927641949997 前段时间调研了一些 RL 训练框架,目前开源社区的 RL 训练框架可以说百花齐放,老牌的有 openlhf、trl、unsloth、verl。还有今年新开源的 slime、AReaL、R
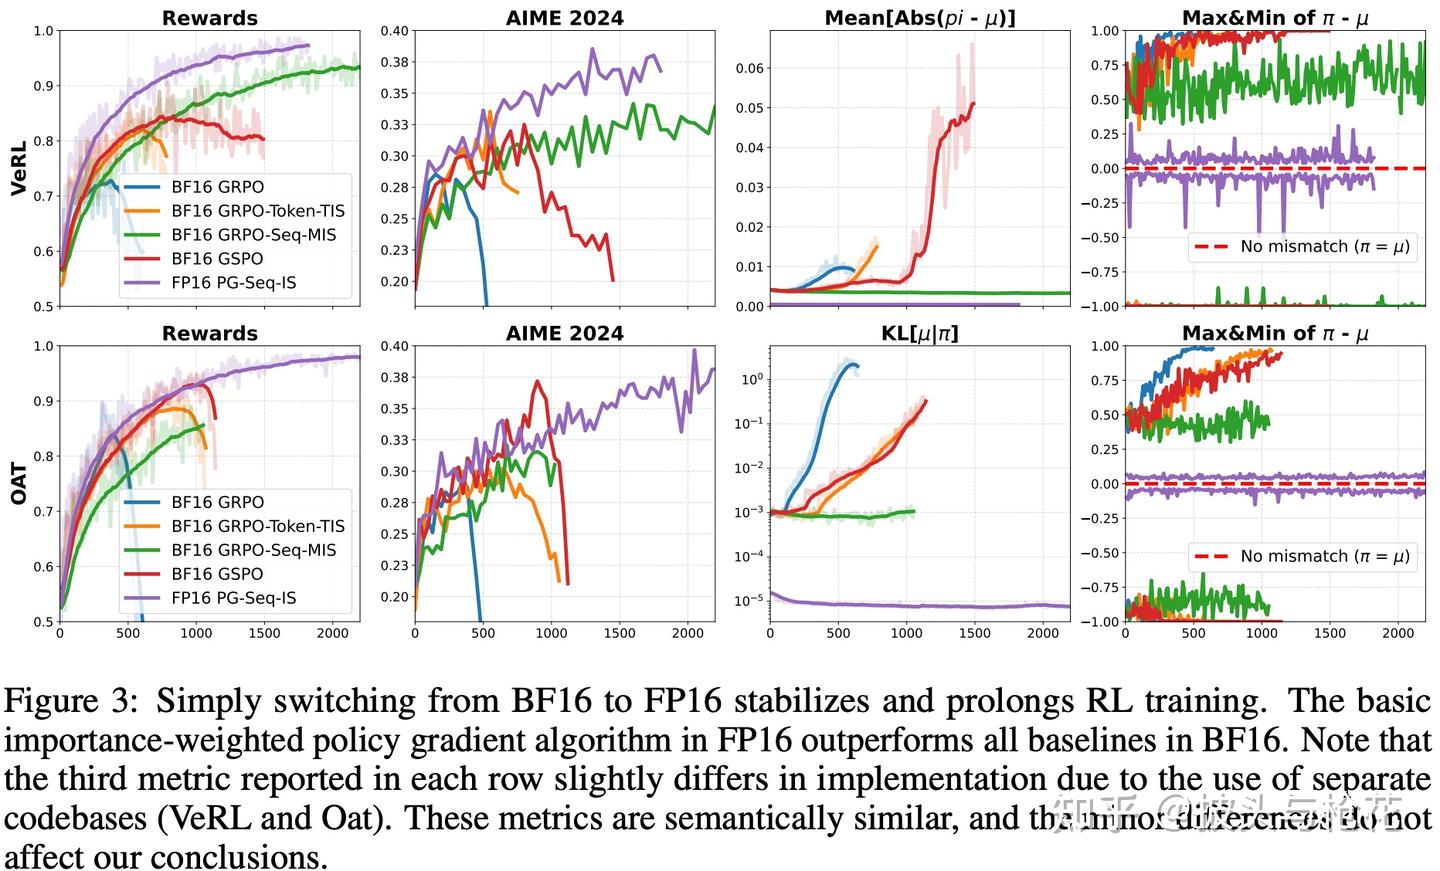
青稞Talk 从 BF16 到 FP16:如何解决RL训练-推理不匹配问题 大语言模型(LLM)的强化学习(RL)微调常因训练与推理策略间的数值不匹配而面临训练不稳定的问题。相比在算法上引入重要性采样来打补丁,我们发现直接从根源上提高浮点数的精度更加有效。 论文:Defeating the Training-Inference Mismatch via FP16 链接:ht
精选文章 纯干货!工业场景下,LLM Agent RL的一些实践感悟 最近几个月在各种场景上做了大量的agent RL训练,例如search agent, 数据分析agent 等等。既有小的dense model,也有大的moe。有单一数据场景,有多源合板数据场景。有失败的经历,也有成功的经历。这里抽空分享下一些感悟,比较乱,随便看看就行: 1、稳定性是工业级场景下R
青稞Talk 从 π_0 到 π_RL:面向流匹配 VLA 的强化学习后训练框架 强化学习可以减少 VLA 模型对大量数据的依赖。我们提出了面向流匹配VLA( π_0, π_{0.5})的强化学习微调框架 π_RL ,提出了 Flow-Noise和 Flow-SDE两种微调技术路线。 Flow-Noise 在单层 MDP 中引入可学习噪声,通过完整的去噪序列计算动作似然;
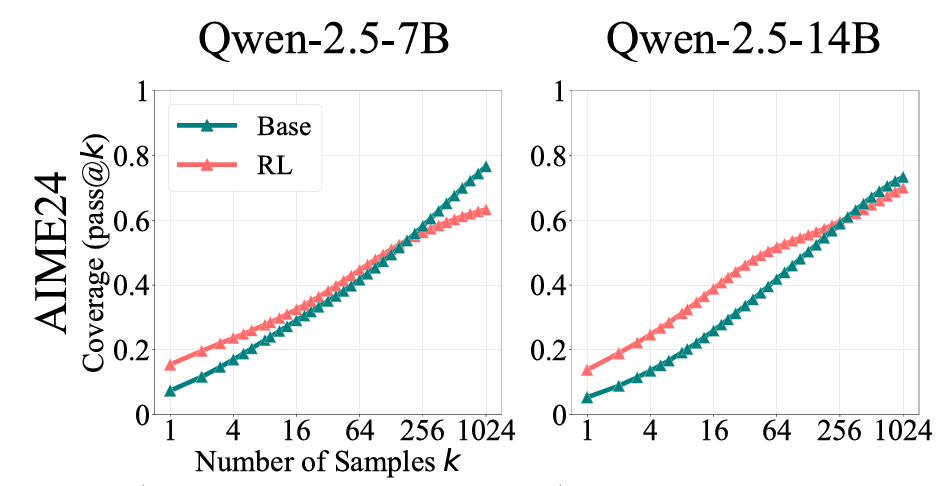
精选文章 什么?RLVR 竟然不是在学习新知识?而是在学习如何使用知识进行推理! 作者:Cheza https://zhuanlan.zhihu.com/p/1972857826515908365 最近看到数不清的论文研究发现: 1.RL有上限 2.SFT本质上是一种特殊的RL 3.通过采用+优化概率分布可以实现RL的效果 今天又刷到一篇论文,从理论的视角区分了RL和SFT对LL
精选文章 VLA 已经不满足于 SFT,也要上 RL 了? 作者:张海抱 https://zhuanlan.zhihu.com/p/1976979860405633293 最近 VLA 的一大研究趋势就是不再满足于 SFT,而是也要上 RL 了。最近读了一波这方面的论文,分享一些心得。 首先,有些文献调研还是按照 online RL / offline RL
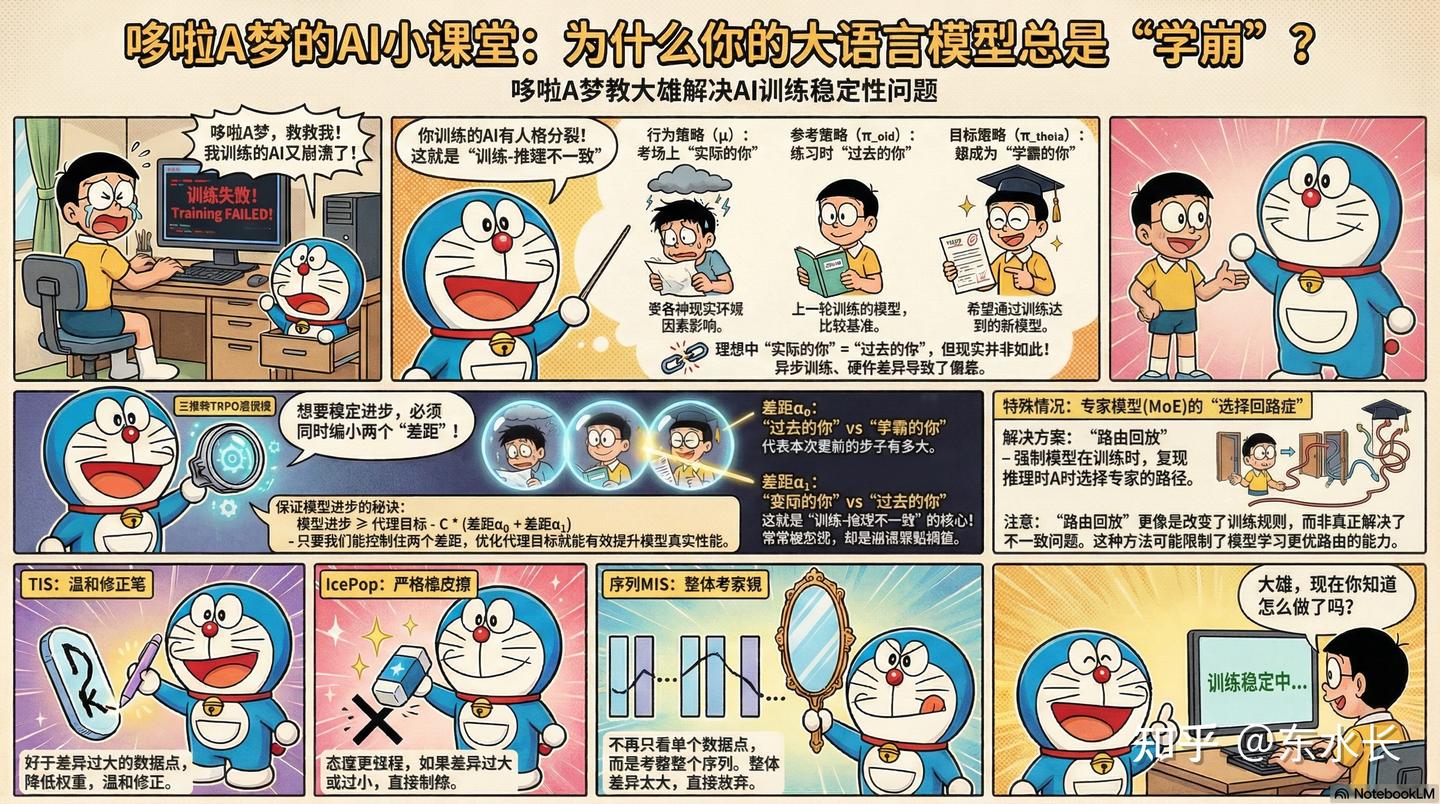
精选文章 深度!从两策略到三策略:行为策略和参考策略不一致下的 TRPO 扩展 作者:东水长(已授权) https://zhuanlan.zhihu.com/p/1973206684907365344 训推不一致和异步框架 最近看到不少关于大模型强化学习中“训推不一致”和“异步训推框架”的讨论,我自己的直觉是:这些看上去复杂多样的问题,很大一部分其实都围绕着一个更基础的矛盾——
精选文章 从“RL比SFT更不容易遗忘”到“反观推荐系统缺陷” 作者:九老师 https://zhuanlan.zhihu.com/p/1976336943878005134 最近陆续有了一些研究LLM中RL相比SFT更不容易造成灾难性遗忘的工作,清晰地指出是RL的On-Policy特性带来了参数的稳定,而SFT将模型参数推向与预训练分布差异很大的方向,导致了遗
精选文章 VLM RL如何涨点 - 实践和思考 作者:Chengru's Blog https://hypercool.cn/ai/ai_algorithms/vision/2025/08/19/dpo-rl.html 前言 过去的一个月在比较高强度做RL,最近终于有了一些阶段性成果,整理了一下整体的迭代思路和最近踩过的坑,分享出来,与各位共勉。
精选文章 RL训练总是崩?Sea AI Lab 最新成果:只需从 BF16 切换到 FP16 就行 作者:披头与枪花 https://zhuanlan.zhihu.com/p/1968757538867647052 《Defeating the Training-Inference Mismatch via FP16》 https://arxiv.org/pdf/2510.26788 这篇论文直
精选文章 入坑必备基础知识!关于推理模型的一些科普 作者:ybq https://zhuanlan.zhihu.com/p/1943048398333780944 这篇文章随便聊一下如今比较火的推理模型,给新入坑的同学做一些简单的科普,都是一些偏基础的知识。 推理模型的训练 推理模型的训练和普通模型的训练并无什么区别,仅仅是 sft 语料多了一些特殊
精选文章 RL 为什么不如 SFT 稳定?以及 RL 各种 Trick 作者:ybq https://zhuanlan.zhihu.com/p/1966609550032475890 这篇文章随便聊聊 LLM RL 的一些想法。文章的灵感来自于,每次和好哥们 @真中合欢 交流 RL 训练的时候,都会被他批评一顿说不要乱加各种技巧。他成功说服了我,我也来试试看能不能说服一
精选文章 28篇最新论文!系统调研 VLA+RL 最近的研究趋势 作者:张海抱 原文:https://zhuanlan.zhihu.com/p/1940702256241575450 写在前面 VLA 时代的强化学习和 Atari 时代的强化学习有什么区别?个人认为有一好两坏两个方面。 好的方面是我们现在有一个非常有用的资源 —— 预训练的大模型,它可以对我们的探