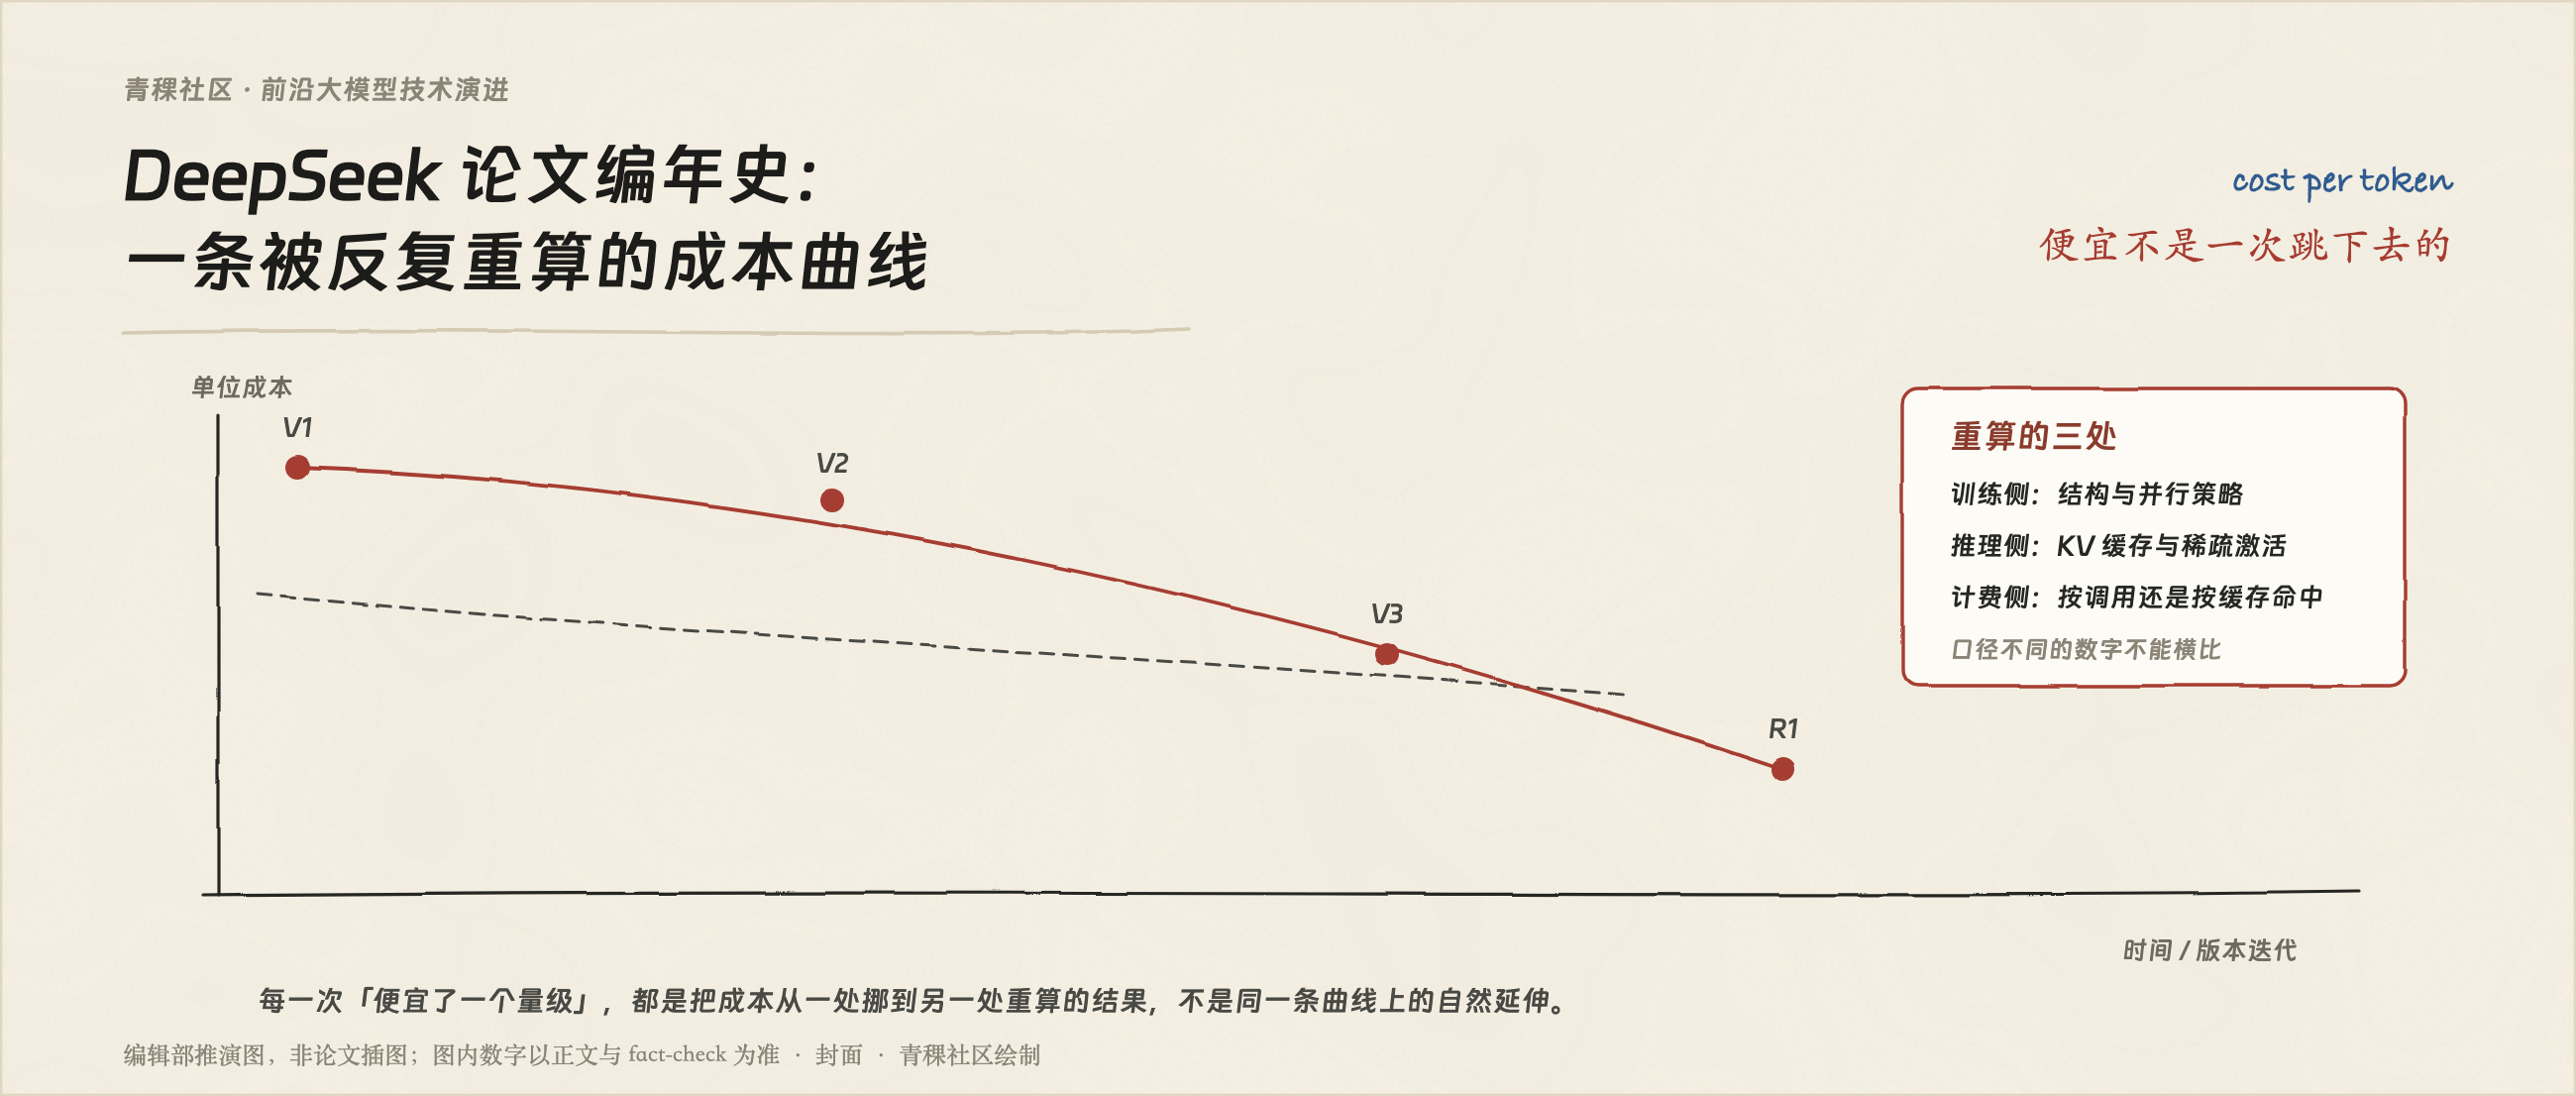
精选文章 DeepSeek 论文编年史:一条被反复重算的成本曲线 开场:同一笔账的两次报价 2024 年 5 月,DeepSeek-V2 的技术报告里出现了一组不太像论文的数字。相对同门的 DeepSeek 67B 稠密模型,它的训练成本省下 42.5%,KV cache 减少 93.3%,最大生成吞吐提升到 5.76 倍。 三个数字指向三笔不同的账。训练成本是卡
青稞Talk DeepSeek V4 模型在 SGLang 中的系统级优化与全栈适配 4月25日,当 DeepSeek-V4 带着 1.6 万亿参数(Pro版)和百万级上下文窗口的震撼配置横空出世时,整个大模型圈的目光都聚焦在了它极具野心的架构革新上:混合稀疏注意力(CSA+HCA)、流形约束超连接(mHC)以及 FP4 专家权重。 然而,对于广大开发者和企业用户而言,面对如此庞大且
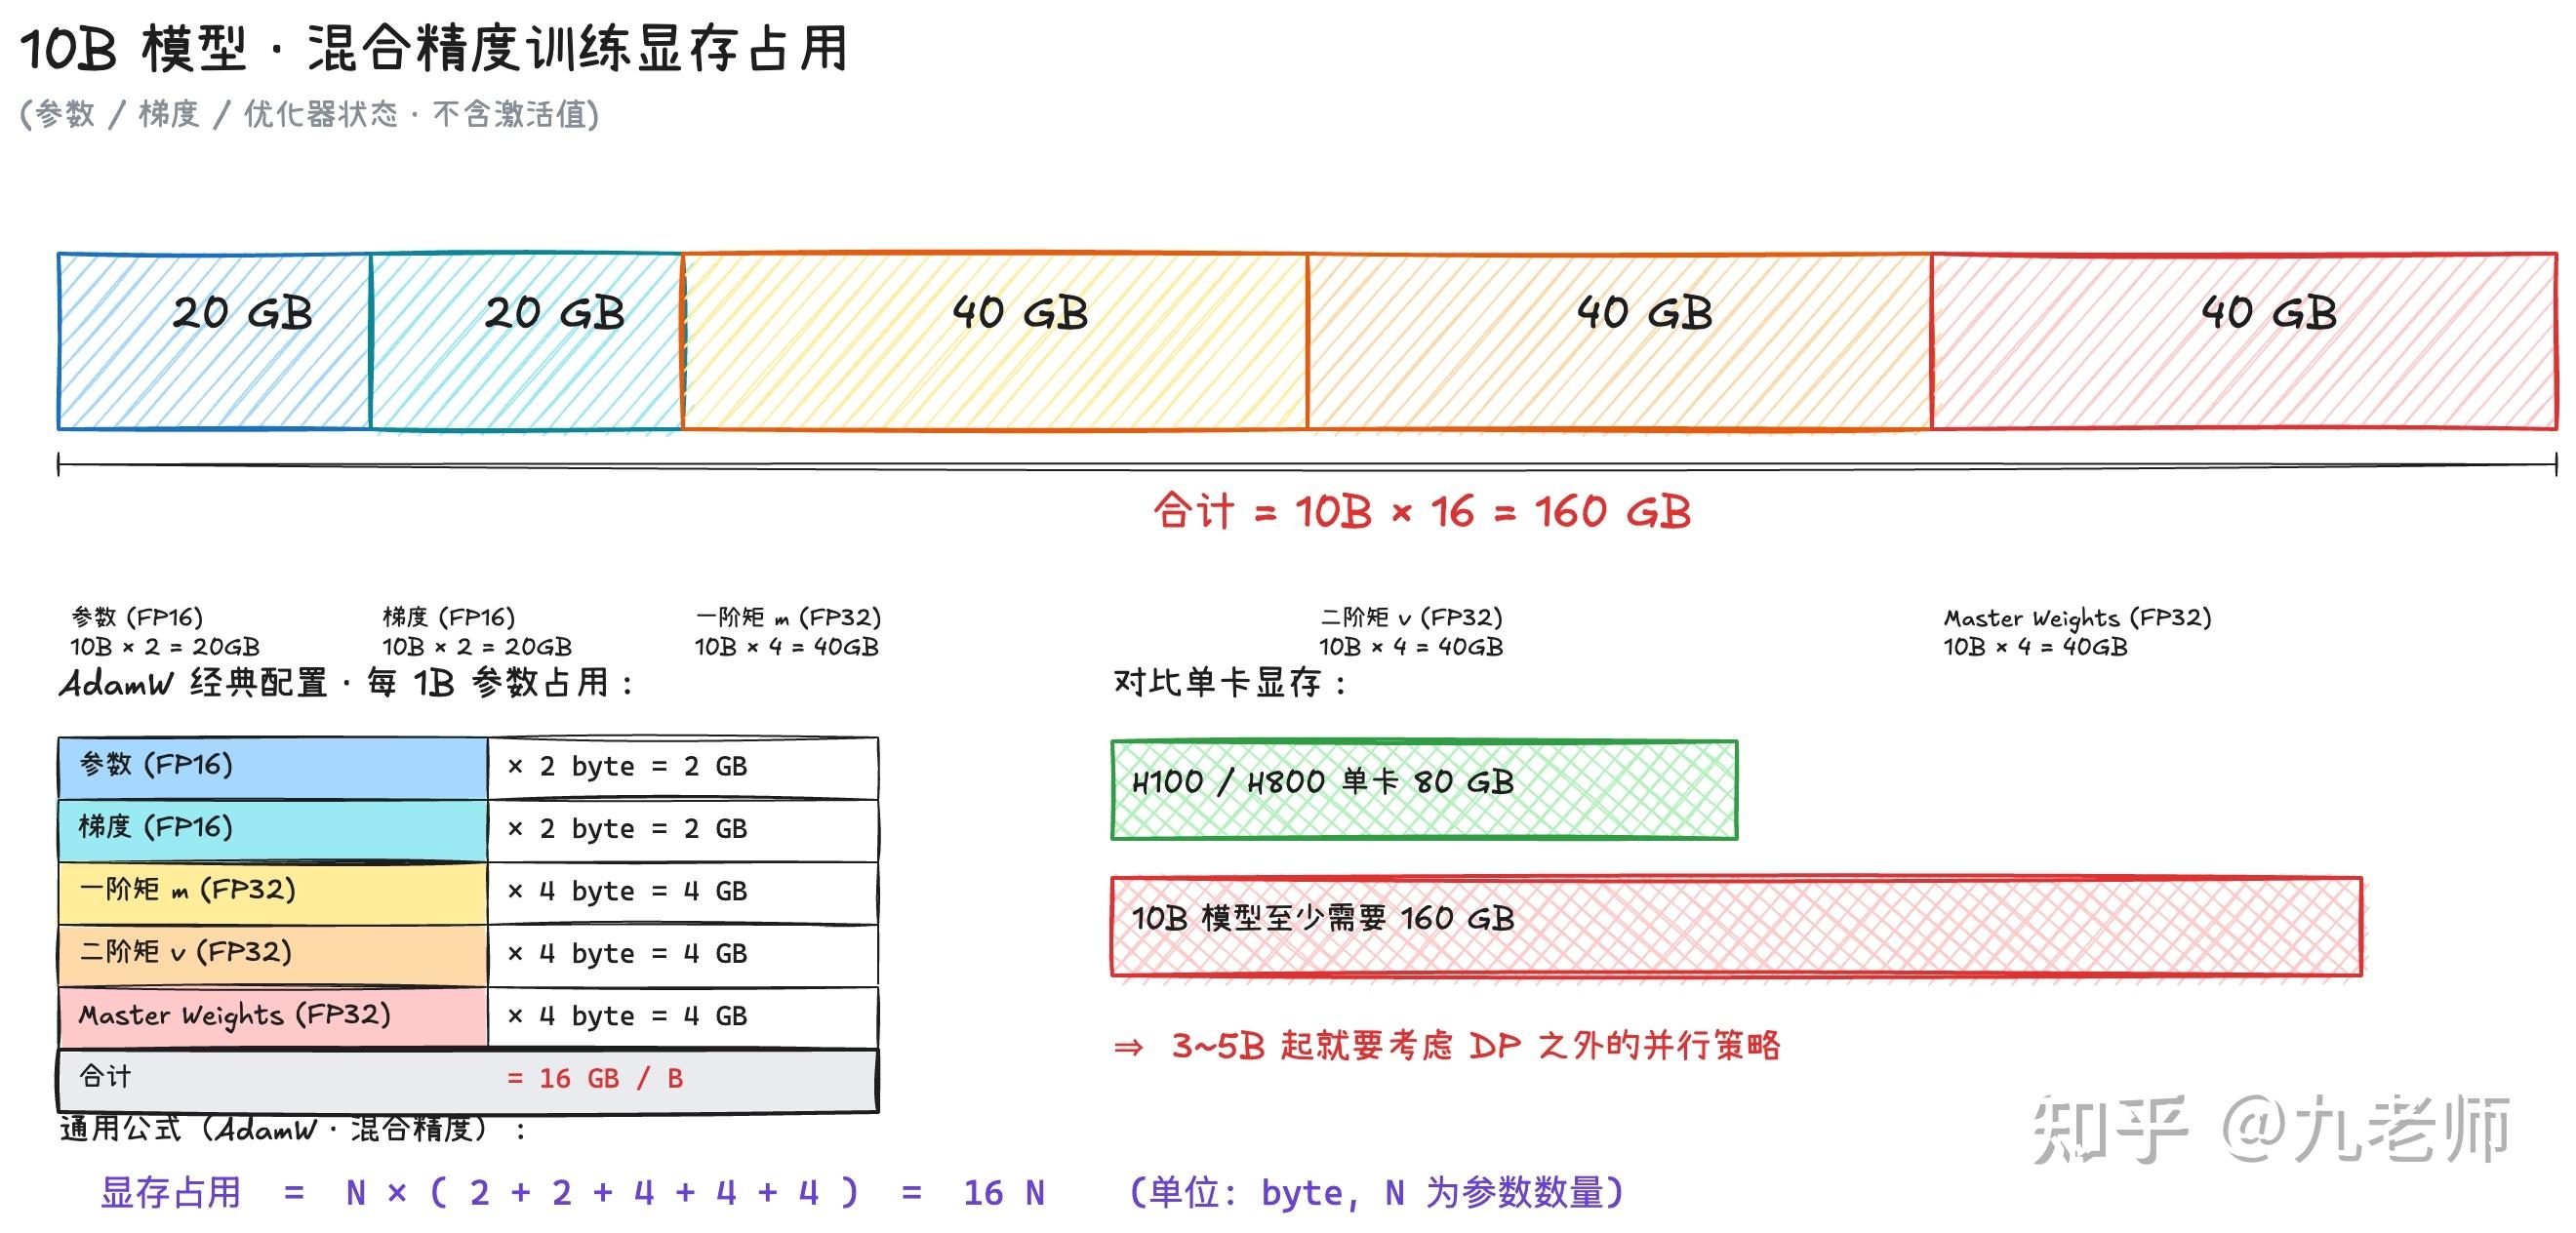
精选文章 DeepSeek-V4 的并行策略和计算通信遮掩 作者:九老师 https://zhuanlan.zhihu.com/p/2034669267807888405 最近模型从Dense切到了MoE,MFU 也相应地暴跌了,大家直觉上觉得Expert被切的很小,所以计算强度上不去,但实际切分完的维度至少也有1024,MFU暴跌的原因一定不来自这里。 深
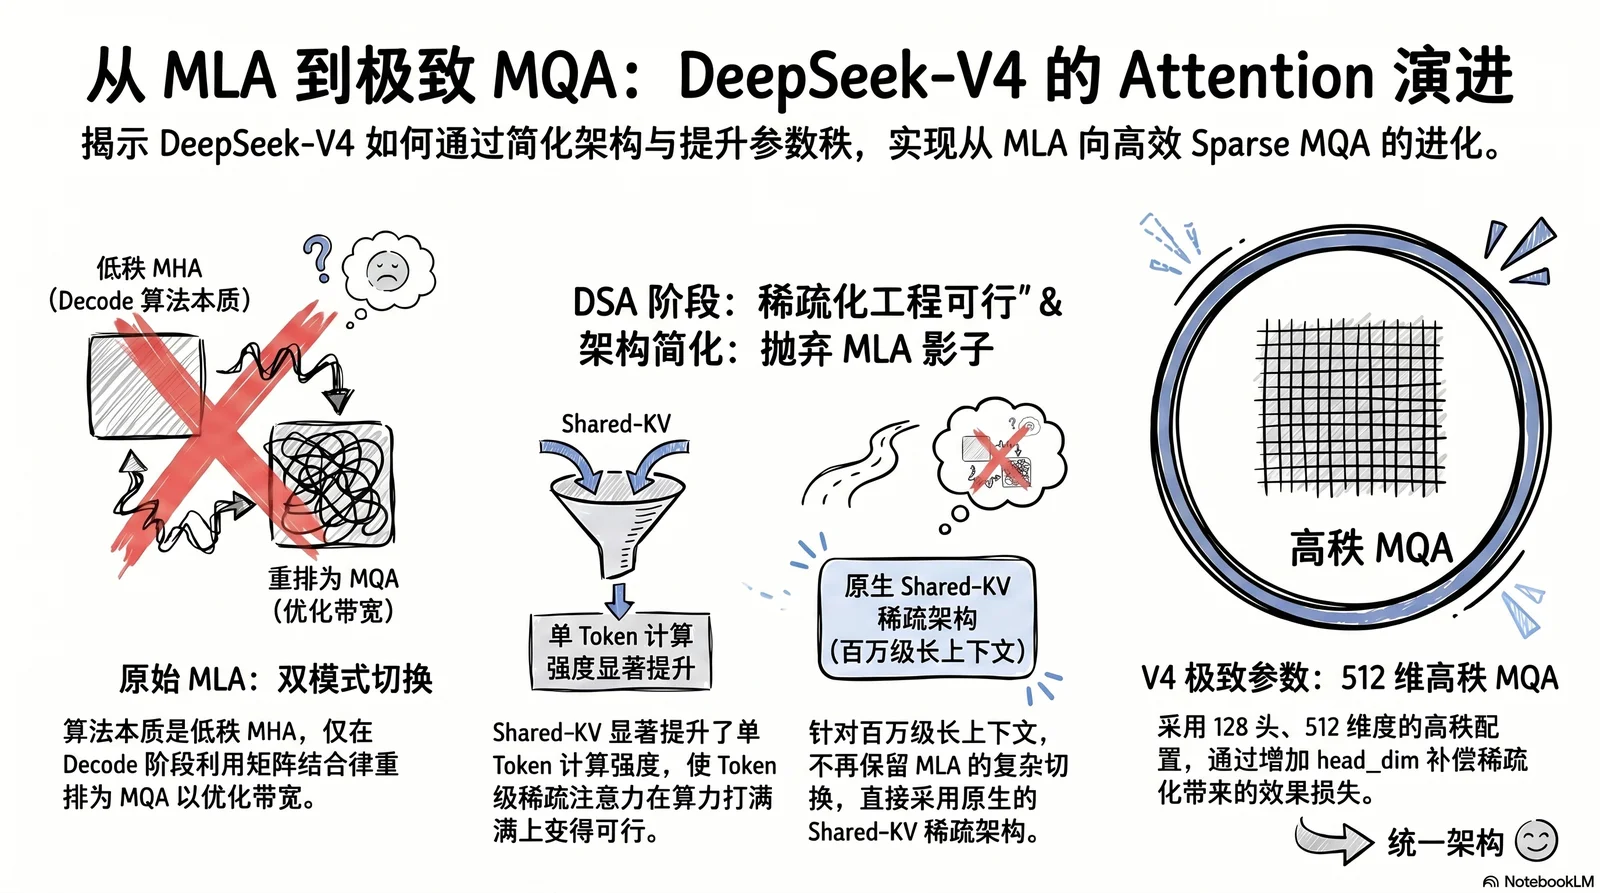
精选文章 从 MLA 到 High-rank MQA:DeepSeek-V4 为什么选择了最“极致”的参数路径? 作者:YyWangCS https://zhuanlan.zhihu.com/p/2031149621397935813 DeepSeek-V4 的论文里已经基本看不到 MLA 形式的表述了,attention 部分是以原生 shared-KV MQA 的形式出现的,而且这个 MQA 还是 head
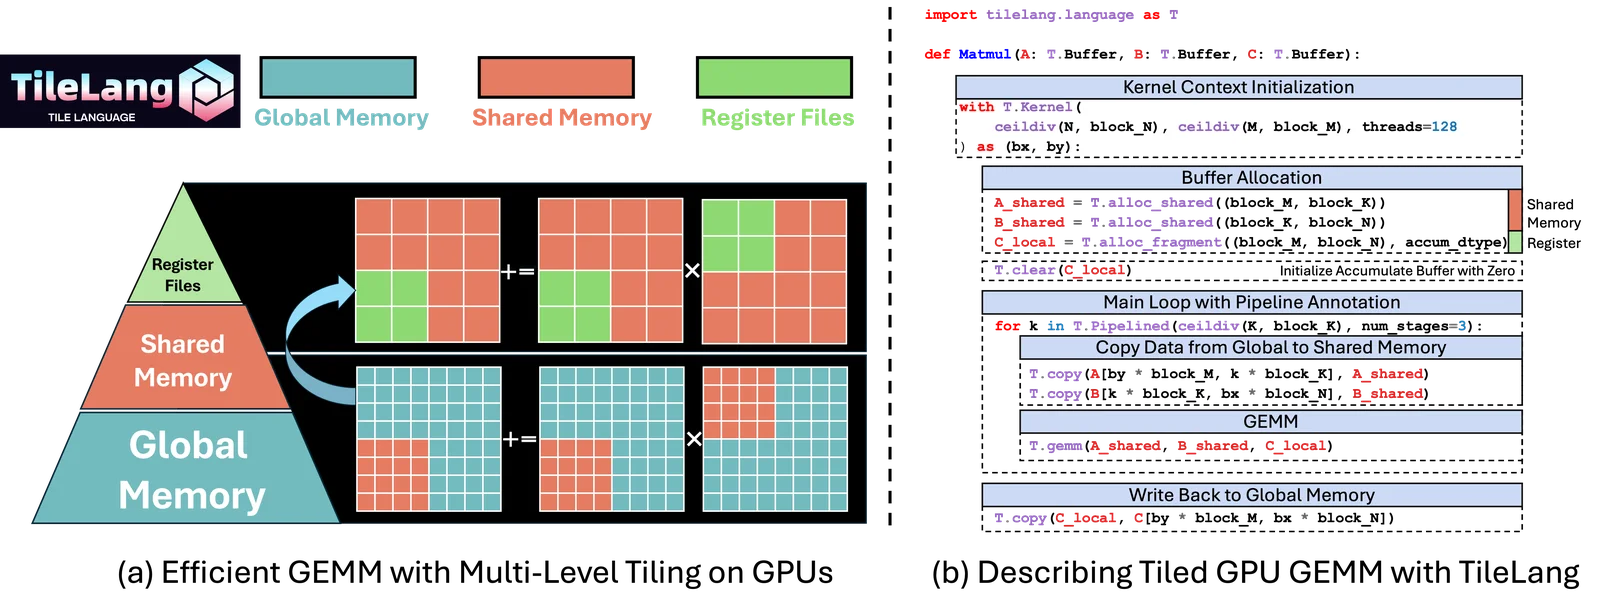
精选文章 DeepSeek-V4 技术报告背后的 TileLang:如何高效实现大模型中的小算子 作者:SiriusNEO https://zhuanlan.zhihu.com/p/2033034202720022871 大家五一快乐!最近 V4 的技术报告讨论度很高,其中 TileLang 在报告中也占了一部分内容,主要是总结了社区最近的一些技术进展、以及其投入实际工业界应用后的一些打磨经验。
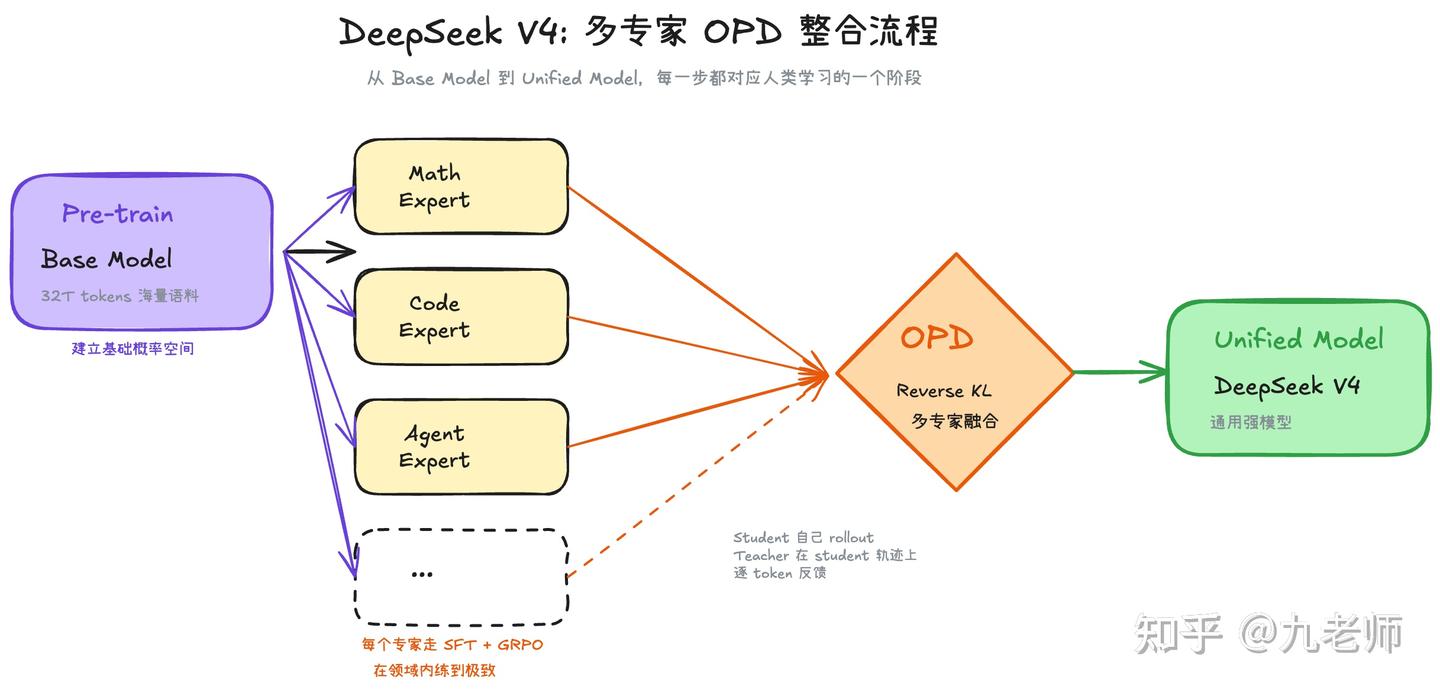
精选文章 从 DeepSeek V4 的多专家 on-policy Distillation 反观人类学习模式 作者:九老师 https://zhuanlan.zhihu.com/p/2031622077107659474 2026 年了,一个 LLM 的训练流程并不陌生——pre-train,SFT,RLHF/RLVR。但实际这是一个领域 LLM 的训练方案,比如 Coder/Match/文本专家,怎么整合