开场:同一笔账的两次报价
2024 年 5 月,DeepSeek-V2 的技术报告里出现了一组不太像论文的数字。相对同门的 DeepSeek 67B 稠密模型,它的训练成本省下 42.5%,KV cache 减少 93.3%,最大生成吞吐提升到 5.76 倍。
三个数字指向三笔不同的账。训练成本是卡时,KV cache 是每个 token 要在显存里占住的字节,生成吞吐是一秒钟能吐多少 token。三笔账的优化方向并不一致:让缓存变小可能拖慢计算,让计算变稀疏可能让通信变贵,把参数摊到更多专家身上又会带来负载不均。
两年四个月后,2026 年 9 月的 DeepSeek-V4.1-Flash 报告给出了另一组报价:常驻 HBM 的全局 KV cache 压到每个 token 890 字节,大约是上一代 V4-Flash 的四分之一;如果算上放在 SSD 或主机内存里的持久化部分,这个比例是八分之一。
两组数字的口径不同、基线也不同,不能放进同一张表。把它们摆在一起,是因为它们回答同一个问题:在固定的算力与带宽预算里,能力上限还能推到哪。 这条线走了将近三年,架构与后训练都换过不止一次做法,而每次发布都在重算这三笔账。
本文按时间把这条论文线读完,看每一代动的是哪一层,以及哪些账至今没有算清。
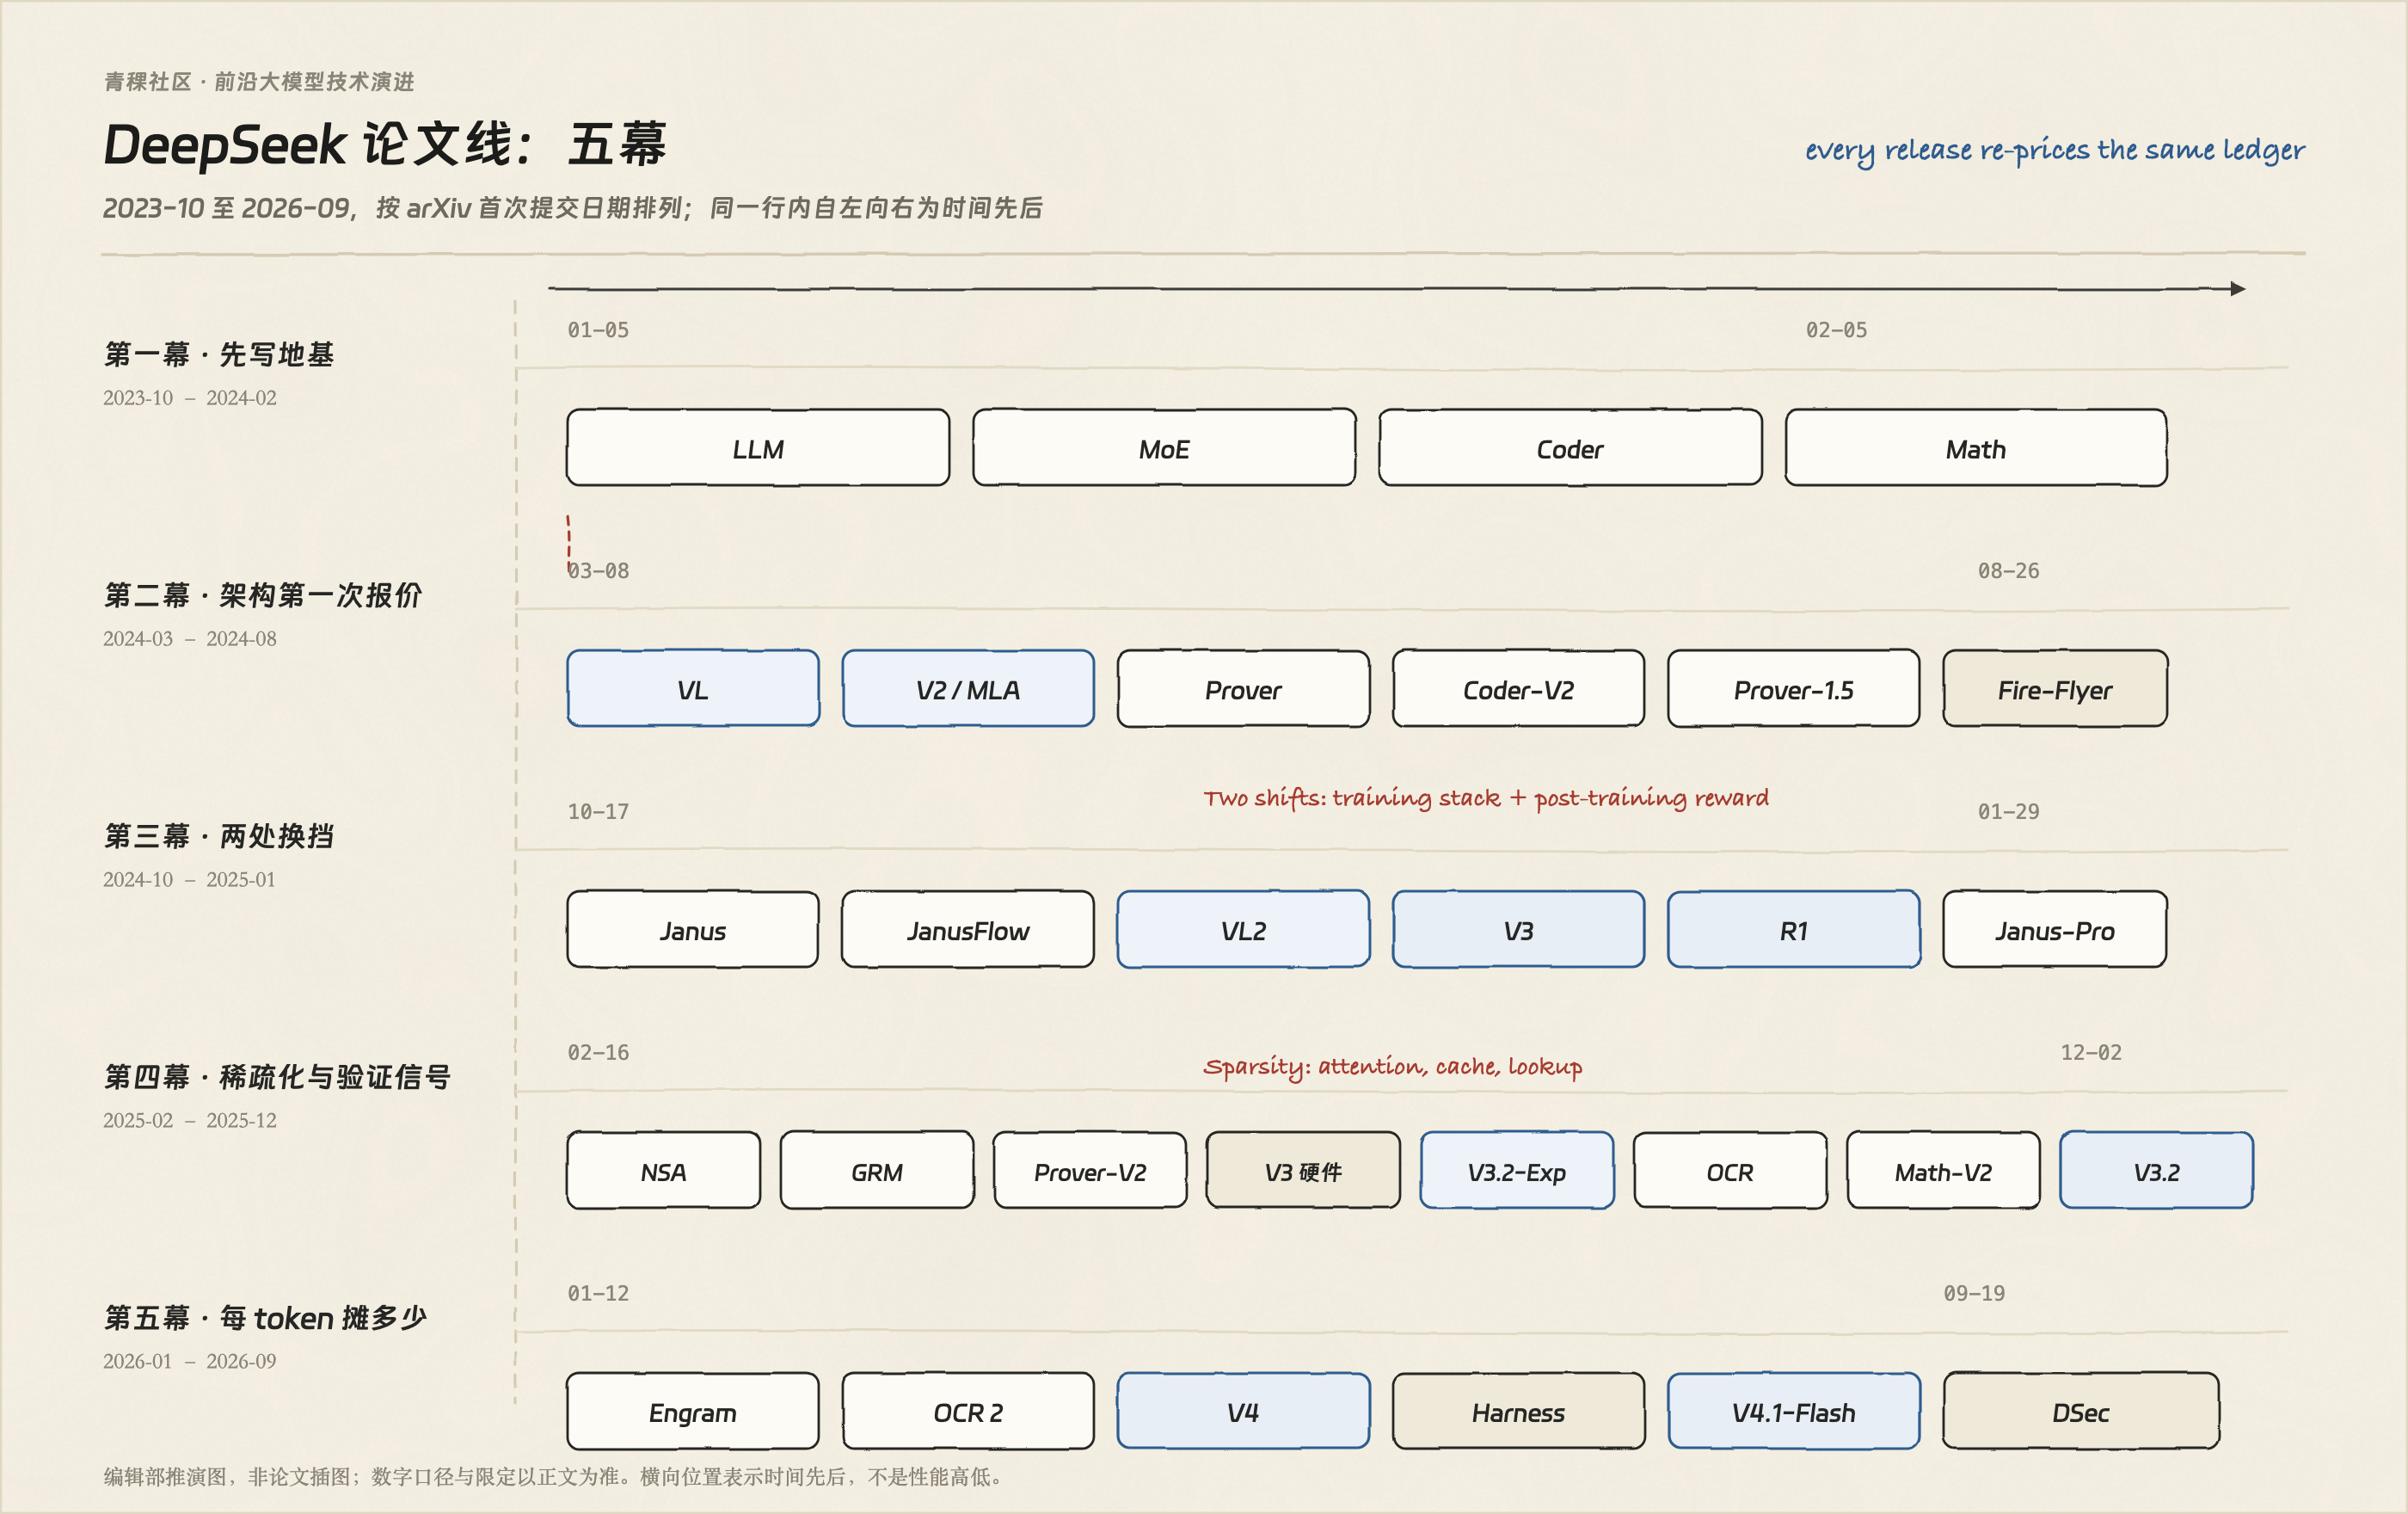
图 1:2023-10 到 2026-09 的论文线,按 arXiv 首次提交日期排列,分成五幕。横向位置表示时间先后,不表示能力高低。图:青稞社区绘制。
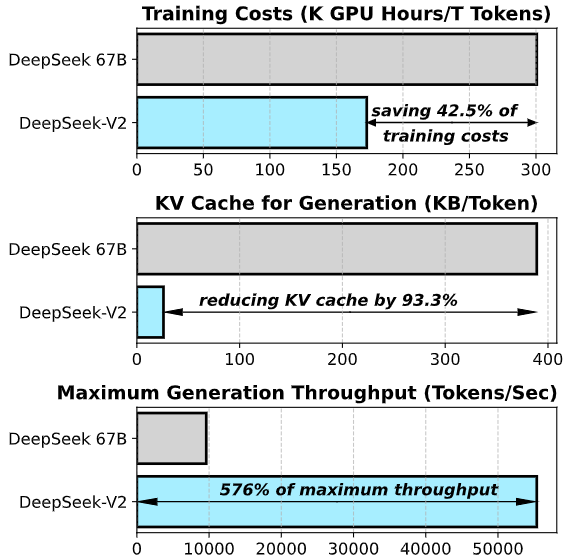
图 2:来源:DeepSeek-AI,DeepSeek-V2(arXiv:2405.04434),官方仓库 figures/trainingcost.png;原图未改动。三张子图依次是训练成本(每 T token 的 K GPU 小时)、生成时的 KV cache(KB/token)与最大生成吞吐(token/s),对比基线都是 DeepSeek 67B。
一、第一幕:先把地基写完(2023-10 至 2024-02)
这条线公开的第一批权重是代码模型 DeepSeek-Coder。官方仓库 2023 年 10 月上线,技术报告到 2024 年 1 月才发出,报告里写的是 1.3B 到 33B 的参数覆盖、2 万亿 token 的从零训练,以及一个 16K 窗口的填空任务——把跨文件补全当成训练目标写进预训练,而不是留到微调阶段处理。
同一个月出现的两个工作更接近地基。DeepSeek LLM 先做缩放定律实验,再据此定下 7B 和 67B 两个配置,预训练数据约 2 万亿 token,后训练由 SFT 加 DPO 两段构成,报告称 67B 模型在代码、数学与推理等多个基准上超过 LLaMA-2 70B。DeepSeekMoE 则处理专家分工的问题:传统 top-K 路由把参数切得不够细,导致每个专家都学到一堆互不相关的知识。它的两条改动是把专家切成 mN 个、每次激活其中 mK 个,再隔离 Ks 个共享专家去承载共性知识。论文用 2B 量级的对照实验说明,这样切出来的 2B 模型与专家参数和计算量达到它 1.5 倍的 GShard 2.9B 表现相当。
这篇 MoE 当时不算热门,但我更愿意把它看作后面所有主线的结构前提:V2 的 236B 总参数、V3 的 671B 总参数、VL2 的语言主干,用的都是这套专家切分方式。
2 月出现的 DeepSeekMath 值得单独记一笔。它公开时最显眼的数字是 MATH 基准上单次 51.7%、64 次自洽采样 60.9%,条件是无外部工具、无投票。但这个数字不是它留下的最长期的东西。它在 DeepSeek-Coder-Base-v1.5 7B 上继续预训练 120B 数学相关 token,同时提出 GRPO:一种去掉价值网络、用组内相对比较估计优势的 PPO 变体。从 2024 年的 Prover-V1.5 到 2025 年的 R1,这条线的 RL 后训练基本都在这族算法上做扩展——至少公开材料里,我没见到换回带价值网络的做法。
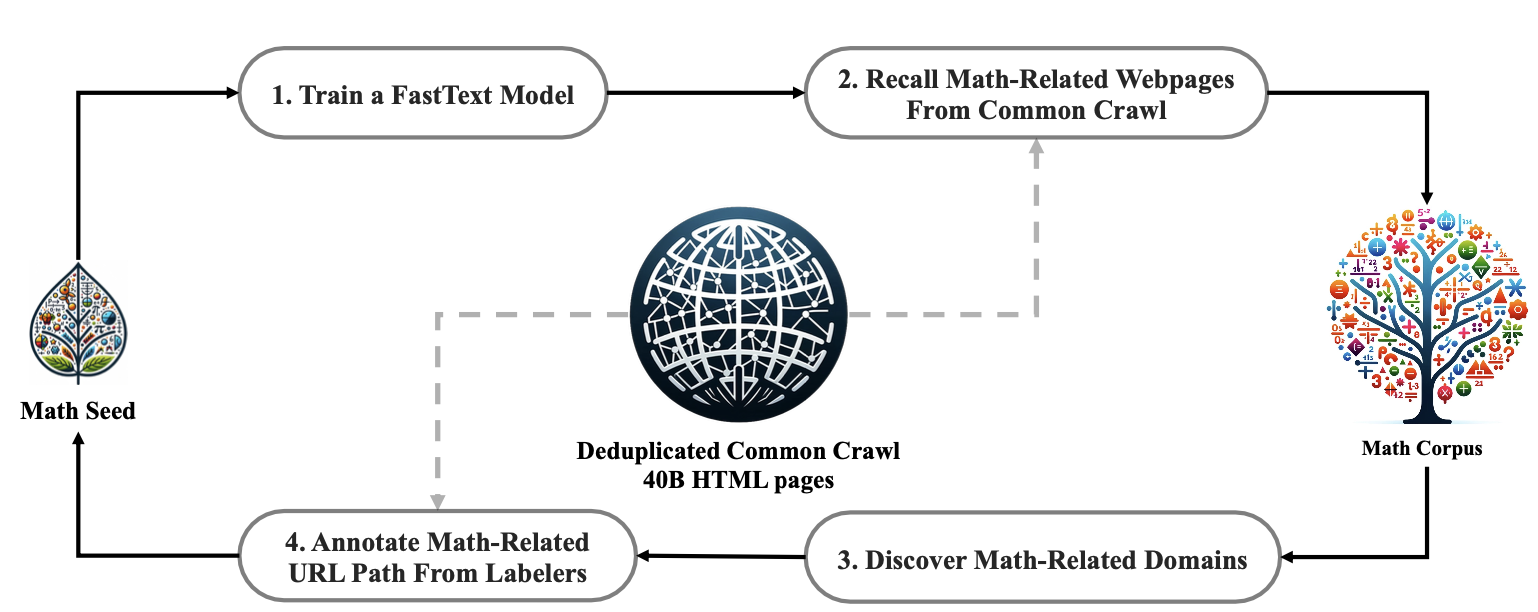
图 3:来源:DeepSeek-AI,DeepSeekMath(arXiv:2402.03300),官方仓库 images/data_pipeline.png;原图未改动。数学语料的生产循环:用种子语料训一个 FastText 模型,从去重后的 Common Crawl 中召回数学网页,再由标注器反向发现新的数学域名。
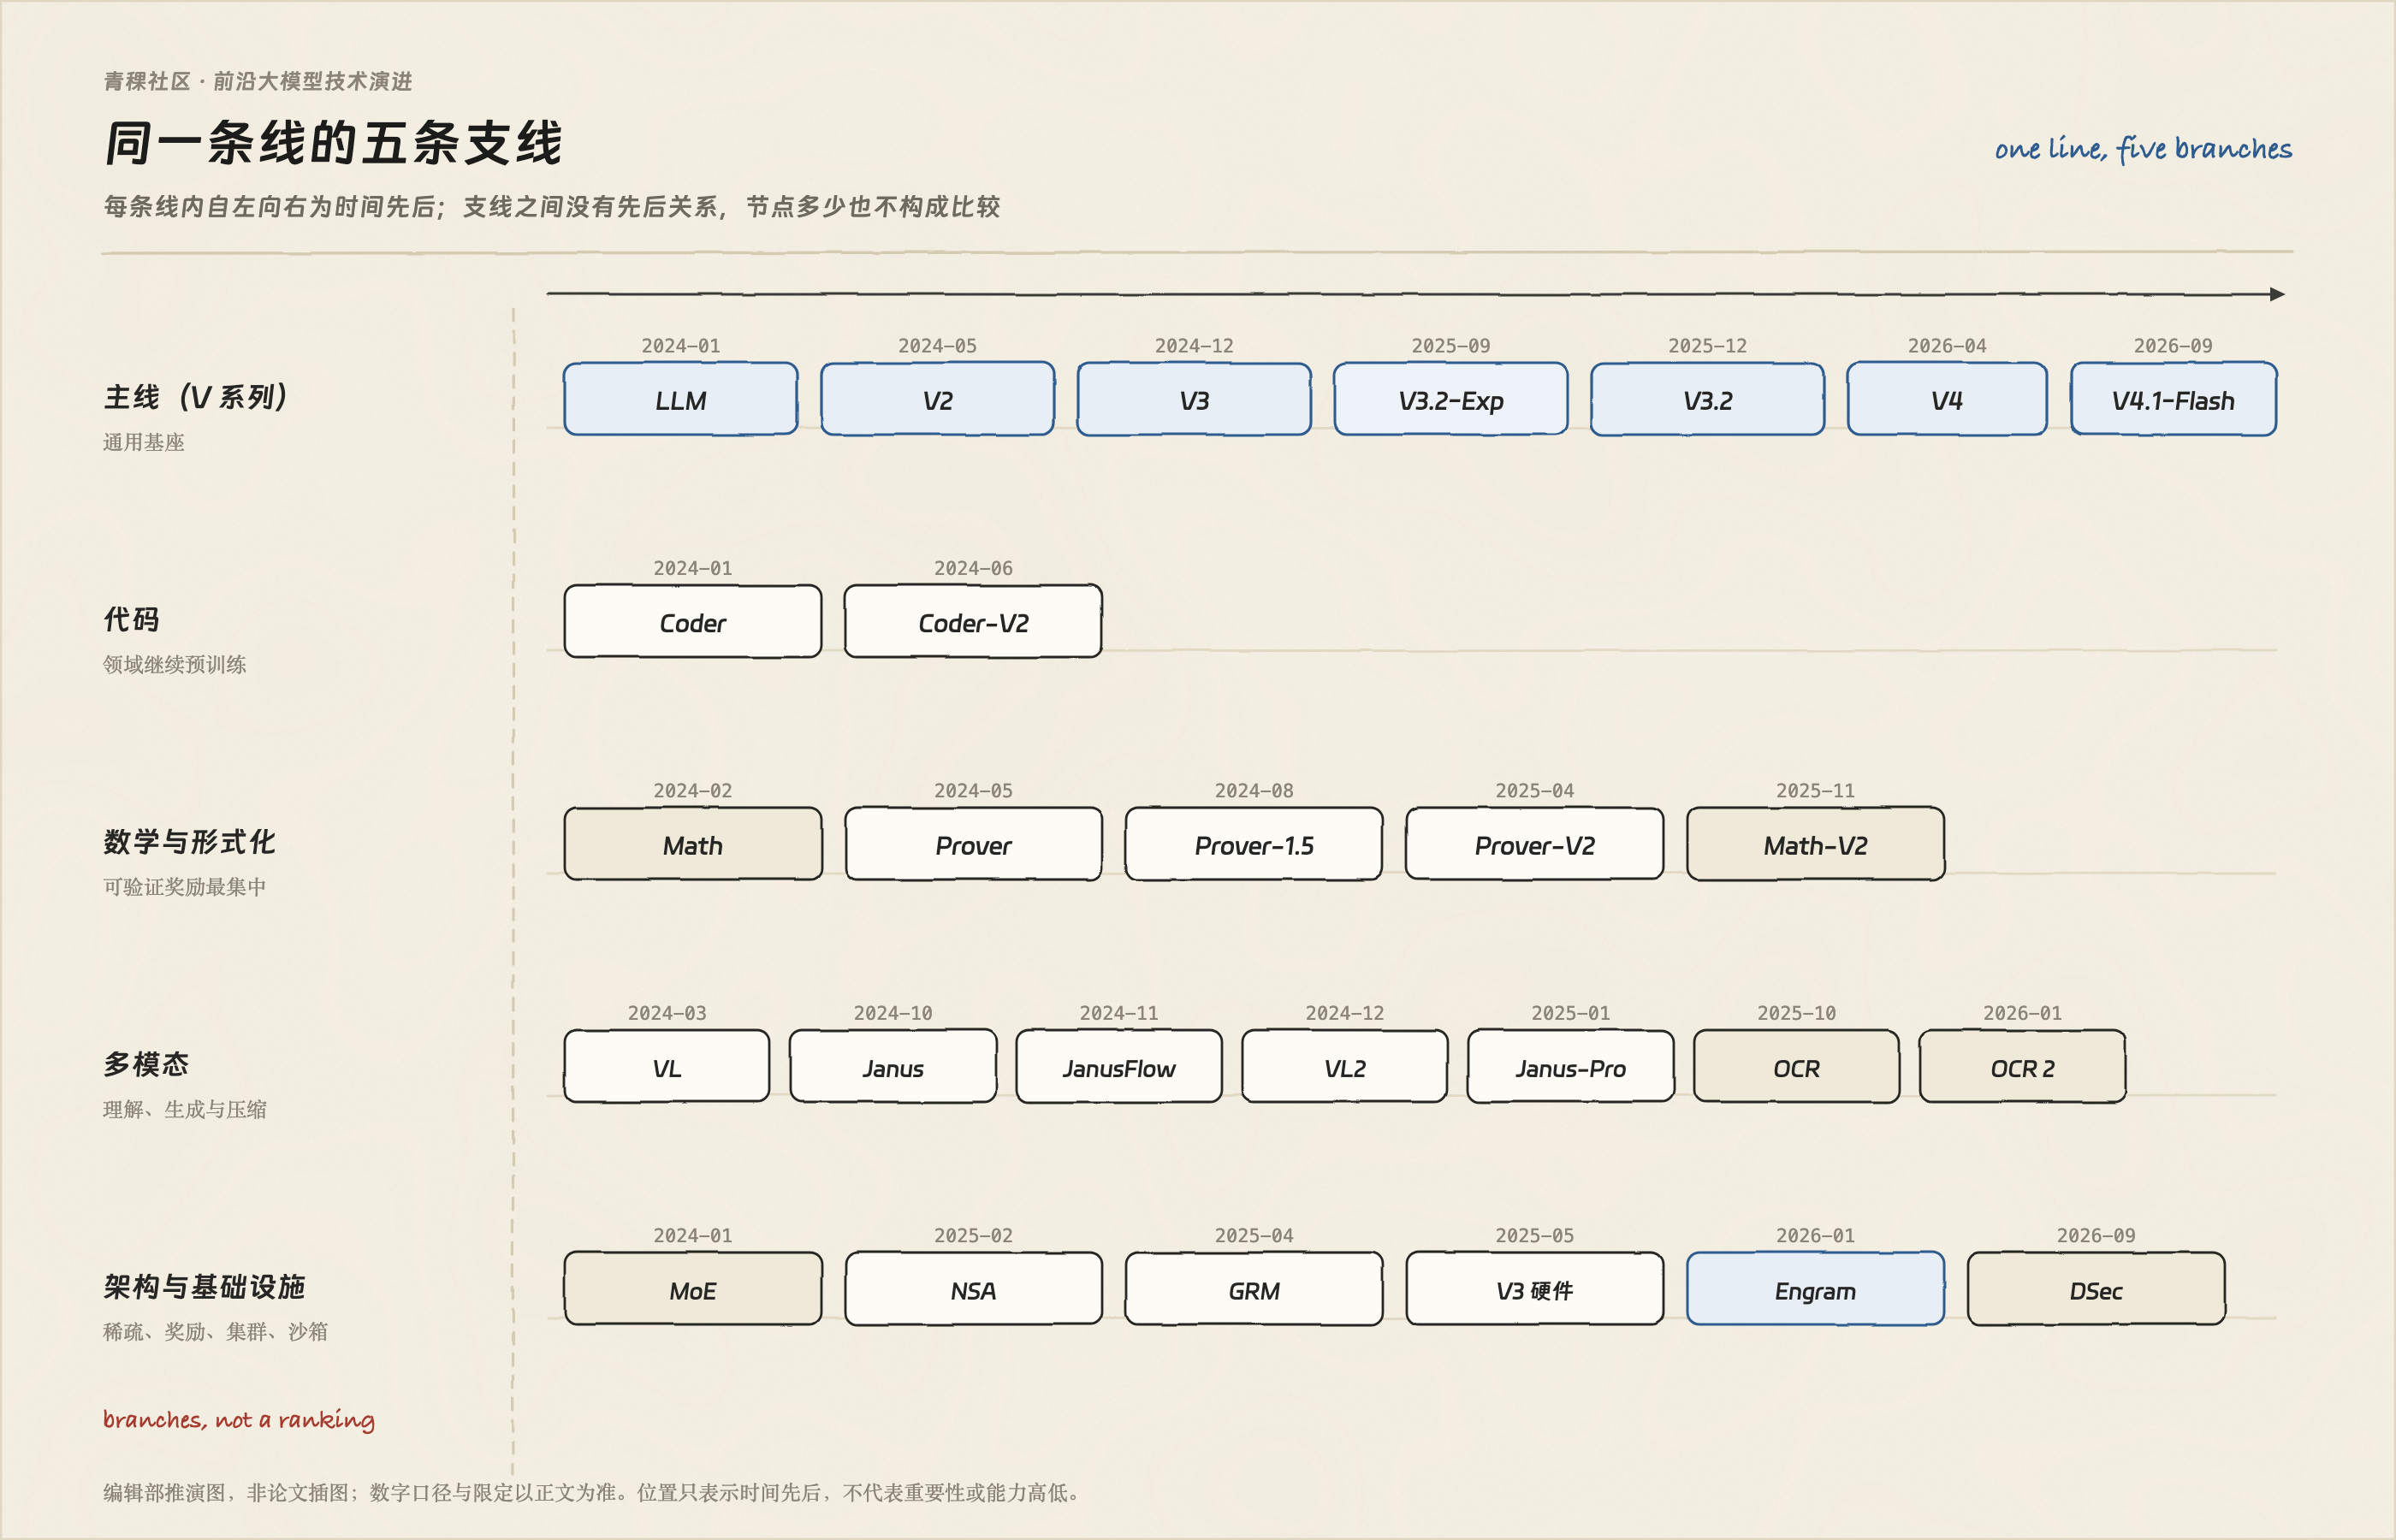
图 4:同一条线的五条支线——主线(V 系列)、代码、数学与形式化、多模态、架构与基础设施。每条线内自左向右为时间先后,支线之间没有先后关系,节点多少也不构成比较。图:青稞社区绘制。
二、第二幕:架构第一次给出报价(2024-03 至 2024-08)
2024 年 5 月的 V2 是这条线第一次把成本写成可比较数字的地方。总参数 236B、每个 token 激活 21B、支持 128K 上下文,预训练语料 8.1T token。两个新结构同时到位:DeepSeekMoE 负责把计算摊薄,Multi-head Latent Attention(MLA)负责把 KV cache 压进潜在向量。同一份报告里给出的三组对照——训练成本 −42.5%、KV cache −93.3%、最大生成吞吐 ×5.76——基线全部是自家的 DeepSeek 67B。
MLA 是我认为这条线上最稳定的架构资产:从 2024 年 5 月到 2026 年的 V4 之前,主线的注意力改动都在它上面做加减,很少推倒重来。
这个阶段还有两条支线。一条是形式化数学:DeepSeek-Prover 把竞赛题翻译成 Lean 4 语句、过滤低质样本、再合成推导过程,凑出 800 万条带推导的训练数据,微调对象是 DeepSeekMath 7B。在 Lean 4 的 miniF2F 上,64 次采样取得 46.3%、累计 52%;同设置下 GPT-4 为 23.0%,此前的树搜索 RL 方法为 41.0%。另一条是训练基础设施:Fire-Flyer AI-HPC 一文交代了训练集群的做法——用 10,000 张 PCIe A100 换来接近 DGX-A100 的性能,成本约为其一半、能耗降低 40%,并把 3FS 这类存储组件写进软件栈。后来 3FS 独立开源,又成了推理与 agentic 训练的基础设施。
值得一提的是 MLA 到底省下了什么。全注意力在生成时需要为每个 token 保存一份键值缓存,缓存大小随上下文线性增长,长上下文推理的显存和带宽很快被它吃满。MLA 的做法是把键值投影到一个低维潜在向量,推理时只缓存这个潜在向量,需要时再还原出键值。它换来的是每 token 的常驻占用下降,代价是多了一次投影计算。这也解释了为什么这条线后来的注意力改动很少直接推倒 MLA:缓存这笔账和计算这笔账可以分开优化,先解决哪一个取决于当时哪一边更紧。
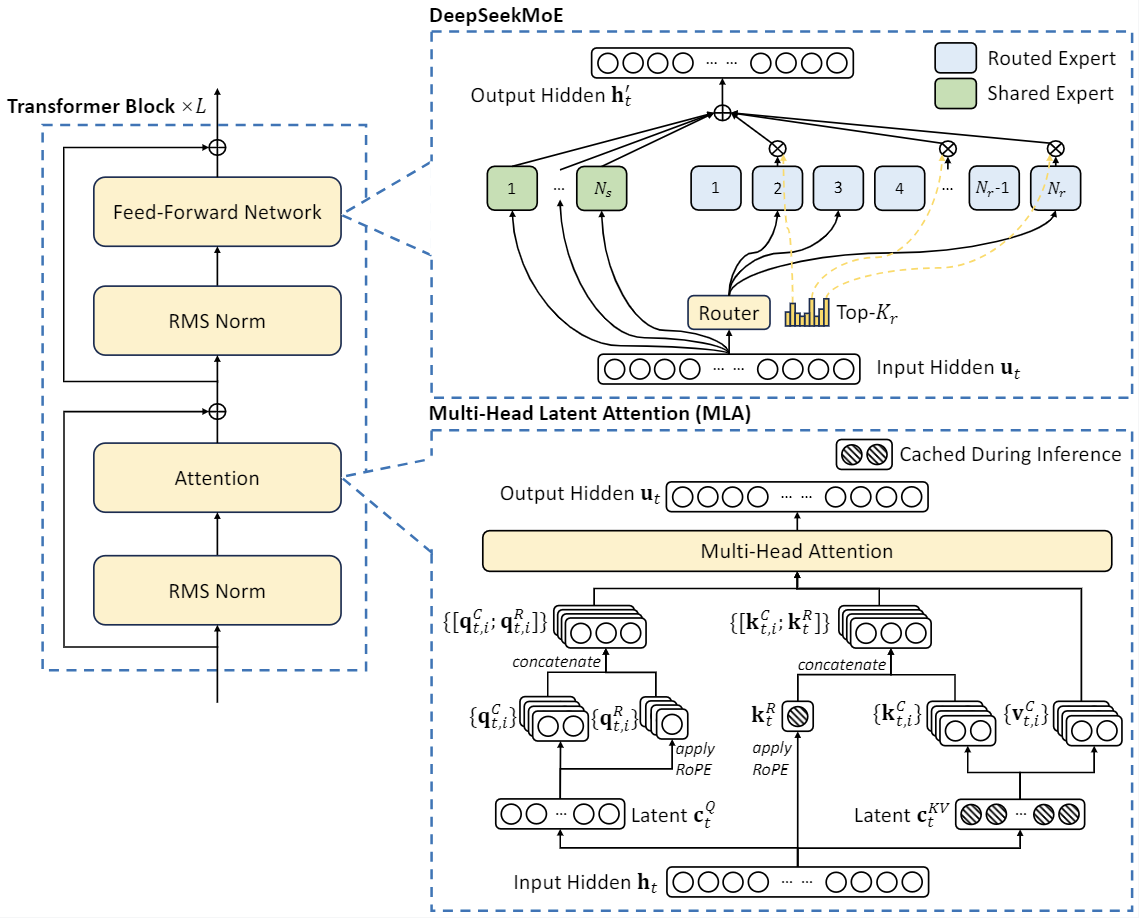
图 5:来源:DeepSeek-AI,DeepSeek-V2(arXiv:2405.04434),官方仓库 figures/architecture.png;原图未改动。左侧是 Transformer 块;右上为 DeepSeekMoE——绿色是共享专家,蓝色是路由专家,Router 按 Top-Kr 选择;右下为 MLA,其中标注 Cached During Inference 的潜在向量就是推理时唯一要缓存的部分。
同一阶段,代码模型从 V2 的中间检查点继续预训练 6 万亿 token,得到 DeepSeek-Coder-V2;编程语言支持从 86 种扩到 338 种,上下文从 16K 扩到 128K。这条支线说明了一件事:在这条线上,领域模型多数是通用基座的下游产物,而不是另起一个从零训练的模型。
三、第三幕:V3 与 R1,两件事同时发生(2024-10 至 2025-01)
2024 年年底到 2025 年年初的四个月,这条线同时换了两次挡。
第一次换挡在训练侧。DeepSeek-V3 把总参数推到 671B、每个 token 激活 37B,预训练 14.8 万亿 token。比起规模,报告里更值得读的是两处工程取舍:负载均衡不再依赖辅助损失,改成调整偏置项;训练目标里加入多 token 预测。报告给出的训练成本是 2.788M H800 GPU 小时,并声明整个训练过程没有出现不可恢复的 loss spike,也没有回滚。
在我看来,把「没有回滚」写进摘要等于把训练稳定性当成一项对外交付的指标;这在此前的大模型技术报告里并不常见。
第二次换挡在后训练侧。DeepSeek-R1 的主张是:推理能力可以由纯强化学习激励,不需要人工标注的推理轨迹;训练过程中出现了自省、验证与策略切换这类行为,其中一部分是训练的结果。同一篇报告里还有一条容易被略过的结论:大模型上涌现的推理模式可以系统地蒸馏给更小的模型。它的实际意义是分工——把昂贵的 RL 训练集中在一两个大模型上,再由它们把行为传给一批小模型,比让每个尺寸各自做一遍 RL 更划算。后续这条线上小尺寸模型的推理能力,多数是这么来的。
同期,多模态支线也在换做法。Janus 把理解与生成两条路径的视觉编码解耦,主干仍然统一,理由是两类任务对视觉信息粒度的要求不同,共用一个编码器会让理解侧吃亏;JanusFlow 进一步把整流流放进语言模型框架,说明生成式建模可以直接在主干内训练,不必为它改架构。到 2024 年 12 月的 DeepSeek-VL2,语言侧的 MoE 与 MLA 被整套搬进视觉语言模型,视觉侧换成动态切图处理不同长宽比的高分辨率输入,三个变体的激活参数分别是 1.0B、2.8B 与 4.5B。
四、第四幕:稀疏化的一年(2025-02 至 2025-12)
2025 年这条线同时在两个方向推进:一边继续做稀疏化,一边扩建验证信号。稀疏这一侧分成三条互不相同的轴,其中两条在这一年落地;验证信号这一侧则换了两种供给方式。
第一条是上下文的稀疏。2 月的 Native Sparse Attention 提出可以在预训练阶段端到端训练的稀疏注意力:把粗粒度的 token 压缩与细粒度的 token 选择叠成层级结构,算法按硬件特性对齐。论文的口径是「在通用基准、长上下文任务与指令推理上不低于全注意力基线」,也就是说它卖的不是涨点,而是省算力而不掉点。
它与 MLA 的区别在于优化的对象。MLA 压的是每个 token 要保存多少缓存,稀疏注意力减的是每个 token 要参与多少计算:注意力矩阵里被跳过的位置不再需要算,省下的是算力与带宽。两者叠起来,才是「长上下文为什么突然变得可负担」的完整答案——一条负责让缓存变小,一条负责让计算变少。稀疏注意力的工程难点也因此落在系统侧:跳过的位置不规整,想要真正省时间,就得有配套的 kernel 把不规则访问变成高效的批量操作,这也是论文强调「按硬件特性对齐」的原因。
这条线在 2025 年 9 月 29 日落到产品上。DeepSeek-V3.2-Exp 的官方发布说明写明,它在 V3.1-Terminus 基础上引入 DeepSeek Sparse Attention(DSA),训练配置刻意与上一代对齐,验收口径是同配置下质量不降——发布说明的对照表里,两代的 MMLU-Pro 都是 85.0。同时宣布 API 价格下降 50% 以上。到 12 月的 DeepSeek-V3.2,DSA 进入主干,报告把这一代的三处变化写成:稀疏注意力、可扩展的强化学习框架、以及大规模 agentic 任务合成管线。
验证信号这一侧的第一个动作是奖励扩展。通用问题没有标准答案,数学题那样的可验证奖励用不上,于是 4 月出现 DeepSeek-GRM:用逐点生成式奖励建模加 SPCT 训练,再把推理算力花在并行采样与元奖励模型投票上。论文给出的判断是这种扩展方式可以优于单纯扩大训练算力,同时也承认部分任务上仍有难度。
第二个动作是把「可验证」本身往上提一层。11 月的 DeepSeekMath-V2 不再奖励最终答案,而是训练一个评判推导质量的验证器,用它作为奖励模型训练出题与推导模型,并用扩展的验证算力持续生产难验证的样本。报告的成绩是:IMO 2025 与 CMO 2024 金牌水平,Putnam 2024 在扩展测试时算力下拿到 118/120。
形式化线的收敛更能说明这个趋势。DeepSeek-Prover-V1.5 用 Lean 的可验证反馈做强化学习,在 miniF2F 上到 63.5%、ProofNet 上到 25.3%;2025 年 4 月的 Prover-V2 换了个方向——先让 V3 把定理拆成子目标并形式化,用递归推导流水线合成冷启动数据,再训练统一的推理模型,结果是 MiniF2F-test 88.9%、PutnamBench 解出 658 题中的 49 题。同一篇论文还发布了 ProverBench:325 道形式化题目,其中 15 道取自 2024 至 2025 年的 AIME,模型解出 6 道。
这一年还有两篇容易被略过的报告。5 月的硬件侧论文《Insights into DeepSeek-V3》把 V3 在 2,048 张 H800 上的经验整理成对硬件的反馈:内存容量、算力效率、互连带宽三类约束各是什么形态,模型侧的 MLA、MoE、FP8 与网络拓扑分别对着哪条约束。10 月的 DeepSeek-OCR 走的是另一个方向——把长文本渲染成图像再用视觉 token 解码,文本与视觉 token 之比低于 10 倍时解码精度约 97%,压缩比 20 倍时仍有约 60%;在 OmniDocBench 上它用 100 个视觉 token 超过 GOT-OCR2.0 的 256 token/页,用少于 800 个视觉 token 超过 MinerU2.0 平均 6000+ token/页的配置。
五、第五幕:从「支持多长」到「每 token 摊多少」(2026-01 至 2026-09)
进入 2026 年,这条线的度量单位发生了变化:以前问的是支持多长上下文,现在问的是每个 token 要摊多少 FLOPs 和多少字节。
1 月的 Engram 把稀疏这件事推到了计算之外。它把 N-gram 查表现代化成一个可扩展的条件记忆模块,与 MoE 并列成为第二条稀疏轴,并给出两者容量分配的 U 型缩放规律。在等参数、等 FLOPs 约束下,扩到 27B 的 Engram 相对 MoE 基线在 MMLU 上 +3.4、CMMLU +4.0、BBH +5.0、ARC-Challenge +3.7、HumanEval +3.0、MATH +2.4;长上下文检索的 Multi-Query NIAH 从 84.2 提升到 97.0。论文的机制分析认为,把局部依赖交给查找之后,注意力容量被释放给全局上下文,浅层也不必再重建静态模式。
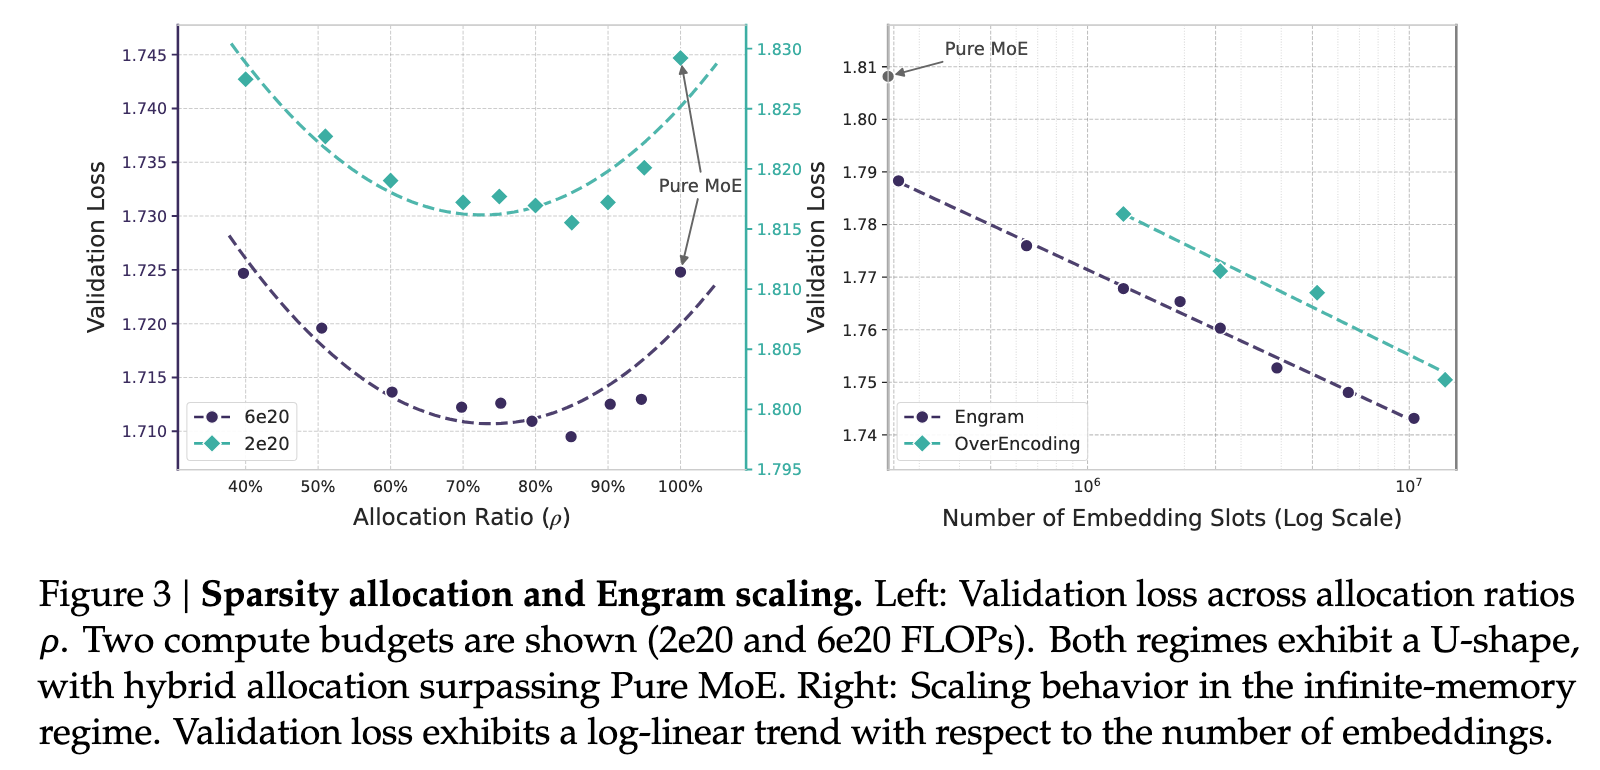
图 6:来源:DeepSeek-AI,Conditional Memory via Scalable Lookup(arXiv:2601.07372),官方仓库 figures/scaling_law.png;原图未改动,图内英文图注为原文。左图是不同算力预算下 MoE 与记忆模块的分配比例(横轴)与验证损失:两端都不如中间,这就是文中所说的 U 型;右图是记忆槽位数与验证损失的对数关系。
4 月的 DeepSeek-V4 预览版把两个模型的规模与上下文同时抬起来:V4-Pro 总参数 1.6T、激活 49B,V4-Flash 总参数 284B、激活 13B,都支持百万 token 上下文,预训练 token 数超过 32T。架构上换了三处:CSA 与 HCA 组成的混合注意力、Manifold-Constrained Hyper-Connections,以及 Muon 优化器。三者分别对应长上下文、残差连接的表达能力和训练稳定性,改动不在同一个位置,说明这一代的收益来自多处叠加而不是单点。效率的对照是自家上一代:在百万 token 设置下,V4-Pro 的单 token 推理 FLOPs 是 V3.2 的 27%,KV cache 是 10%。
9 月的 V4.1-Flash 把账算到了字节一级。主干 552B,解码时每个 token 激活 16B、预填充时只激活 8B——同一模型按负载形态分配算力;KV 侧叠了两层压缩,跨层复用(CSA2)加 FP4 缓存,把常驻 HBM 的部分压到每个 token 890 字节。预训练语料是 45T token 的多模态数据。
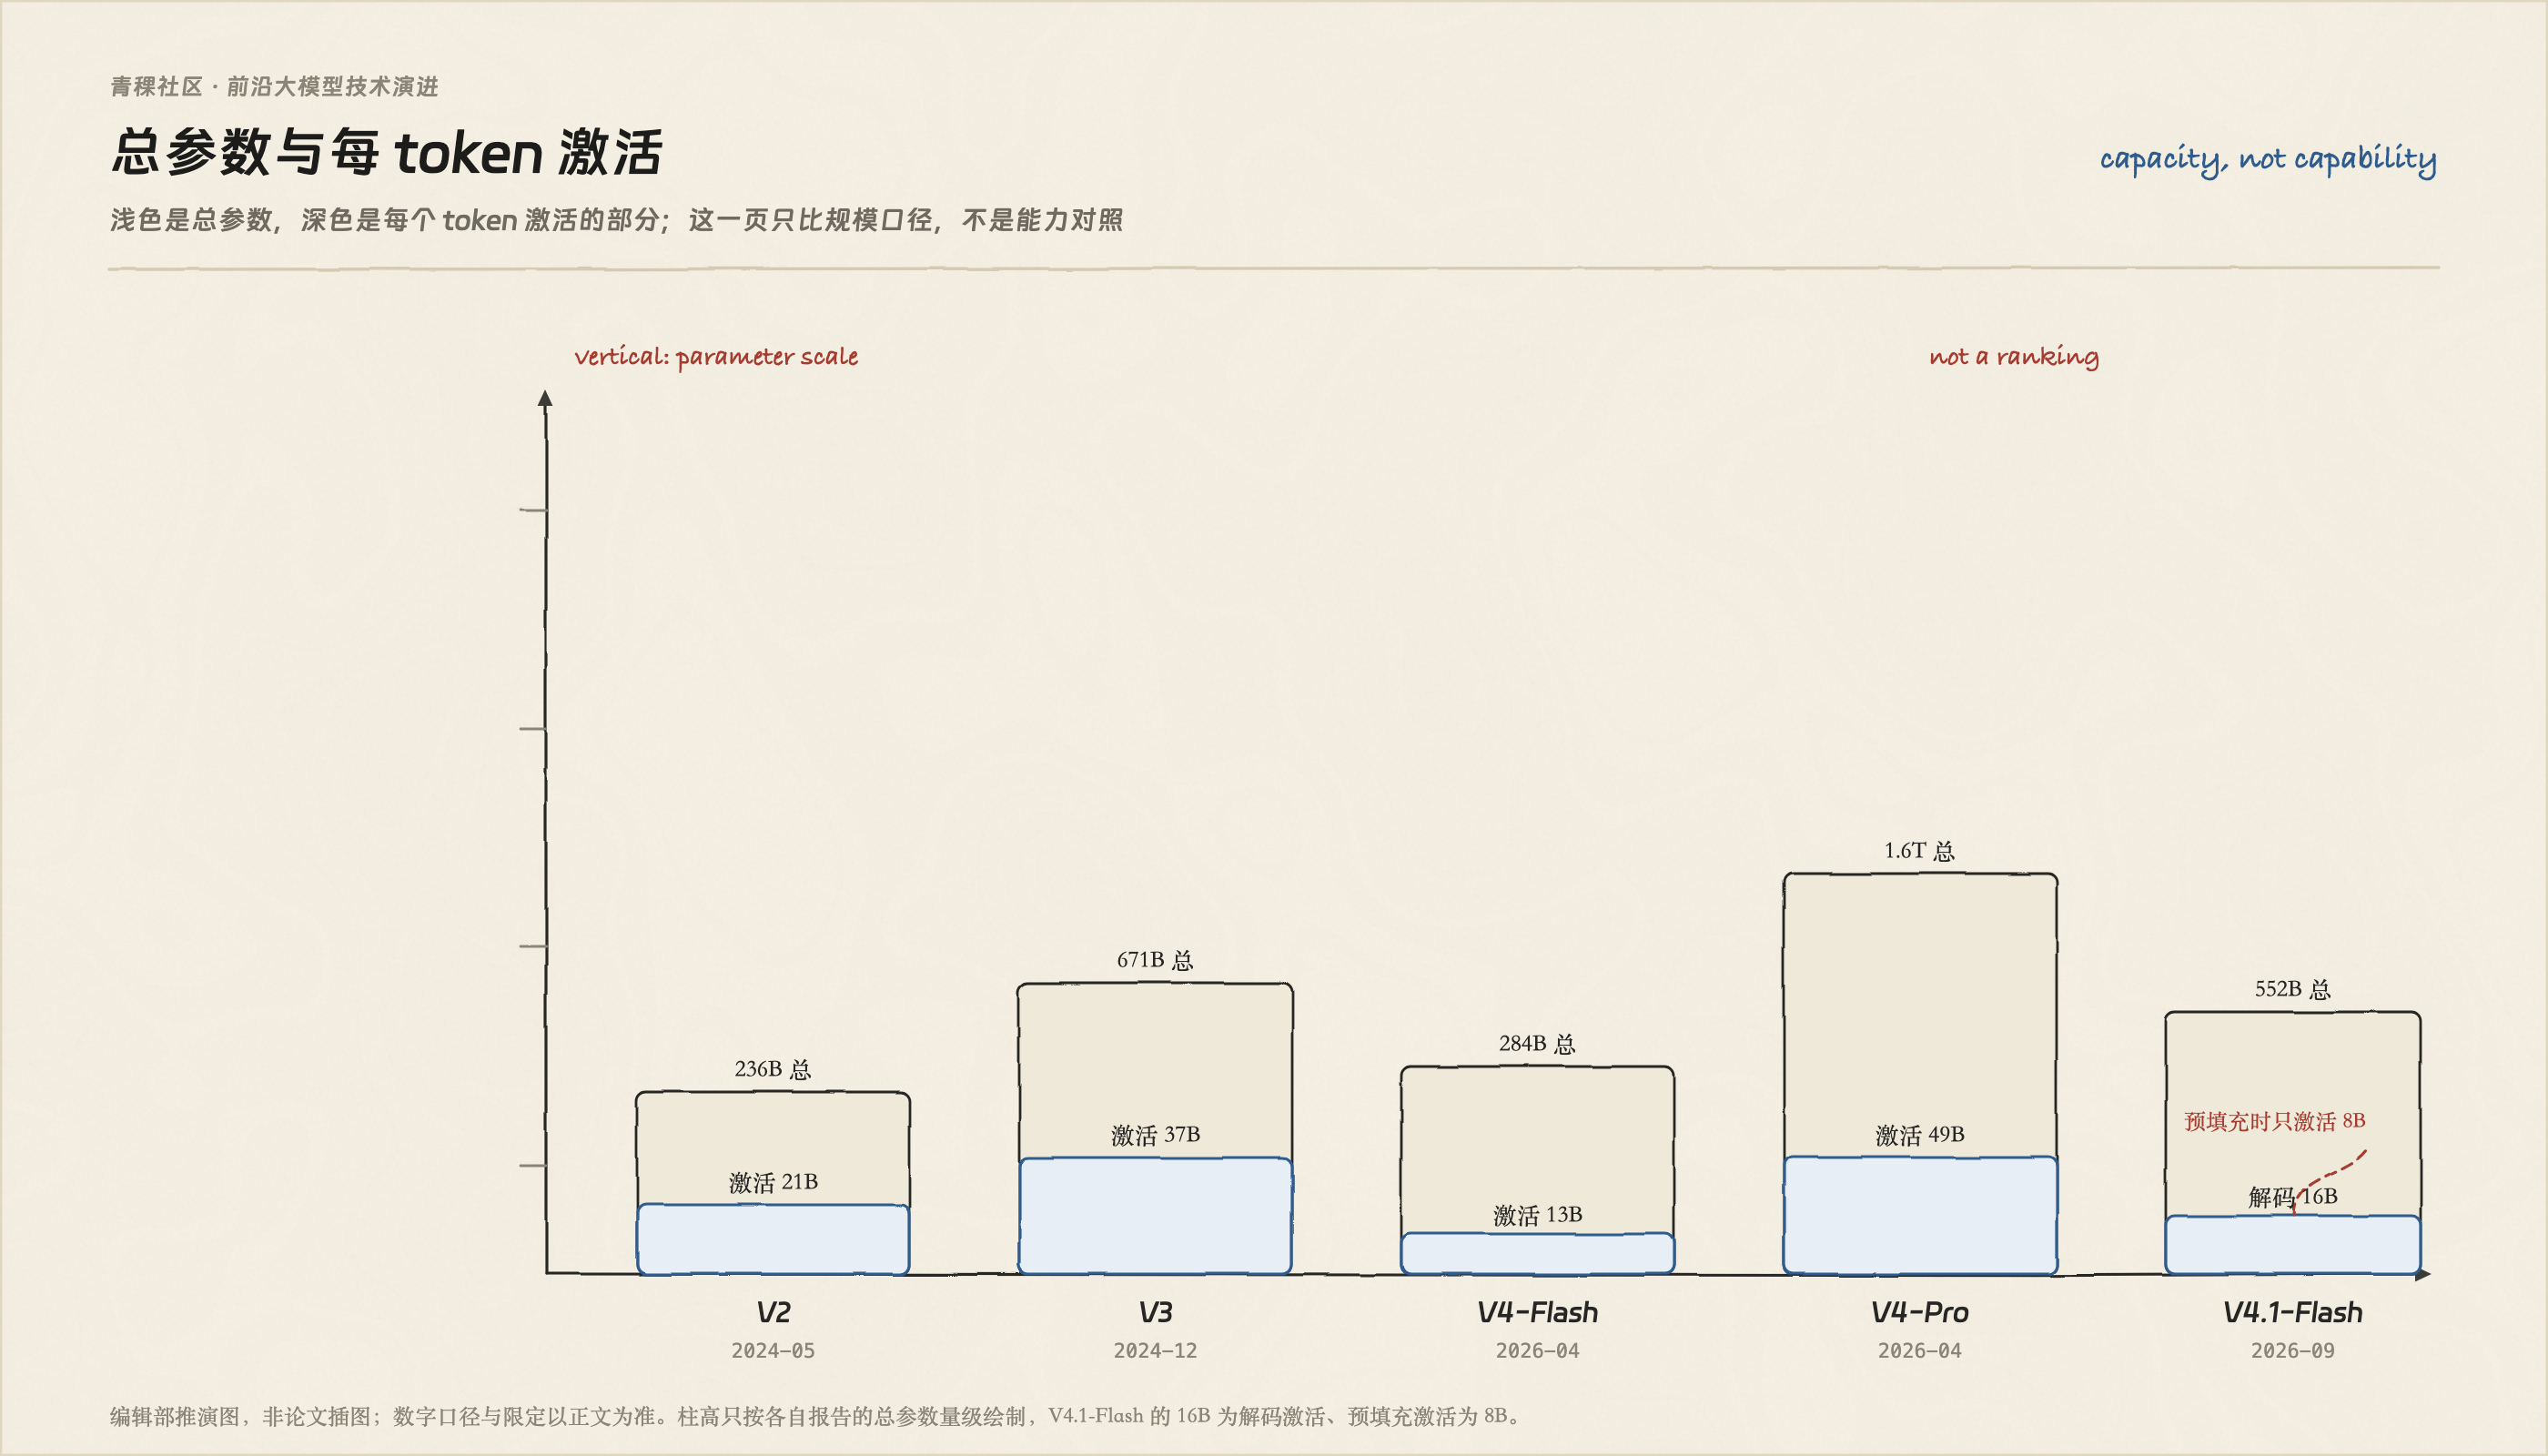
图 7:总参数与每 token 激活的规模口径,按各自报告绘制。这一页只比规模口径,不是能力对照;V4.1-Flash 的 16B 是解码激活,预填充时激活 8B。图:青稞社区绘制。
这两代的差距还有一个不容易注意到的来源:训练和评测的环境本身。9 月的 DSec 报告交代了 agentic 训练的沙箱平台:单个生产单元约 160 个节点,每天服务约 300 万个沙箱,支持超过 38 万个并发沙箱与每秒 5000 次以上的创建;沙箱有状态地跨长交互保留,rollout 执行与可抢占的 GPU 训练解耦,镜像按需从 3FS 加载。报告明确把 reward hacking 一类 agent 越界行为列为要缓解的问题。
同期的 DeepSeek Harness 则是另一条轨道:官方 2026 年 8 月上线的开源 agent harness,架构是「一切皆插件」,处于开发者预览状态。它不进论文线,但它提示了这条线 2026 年的重心——模型的交付形态里多了一层执行框架。
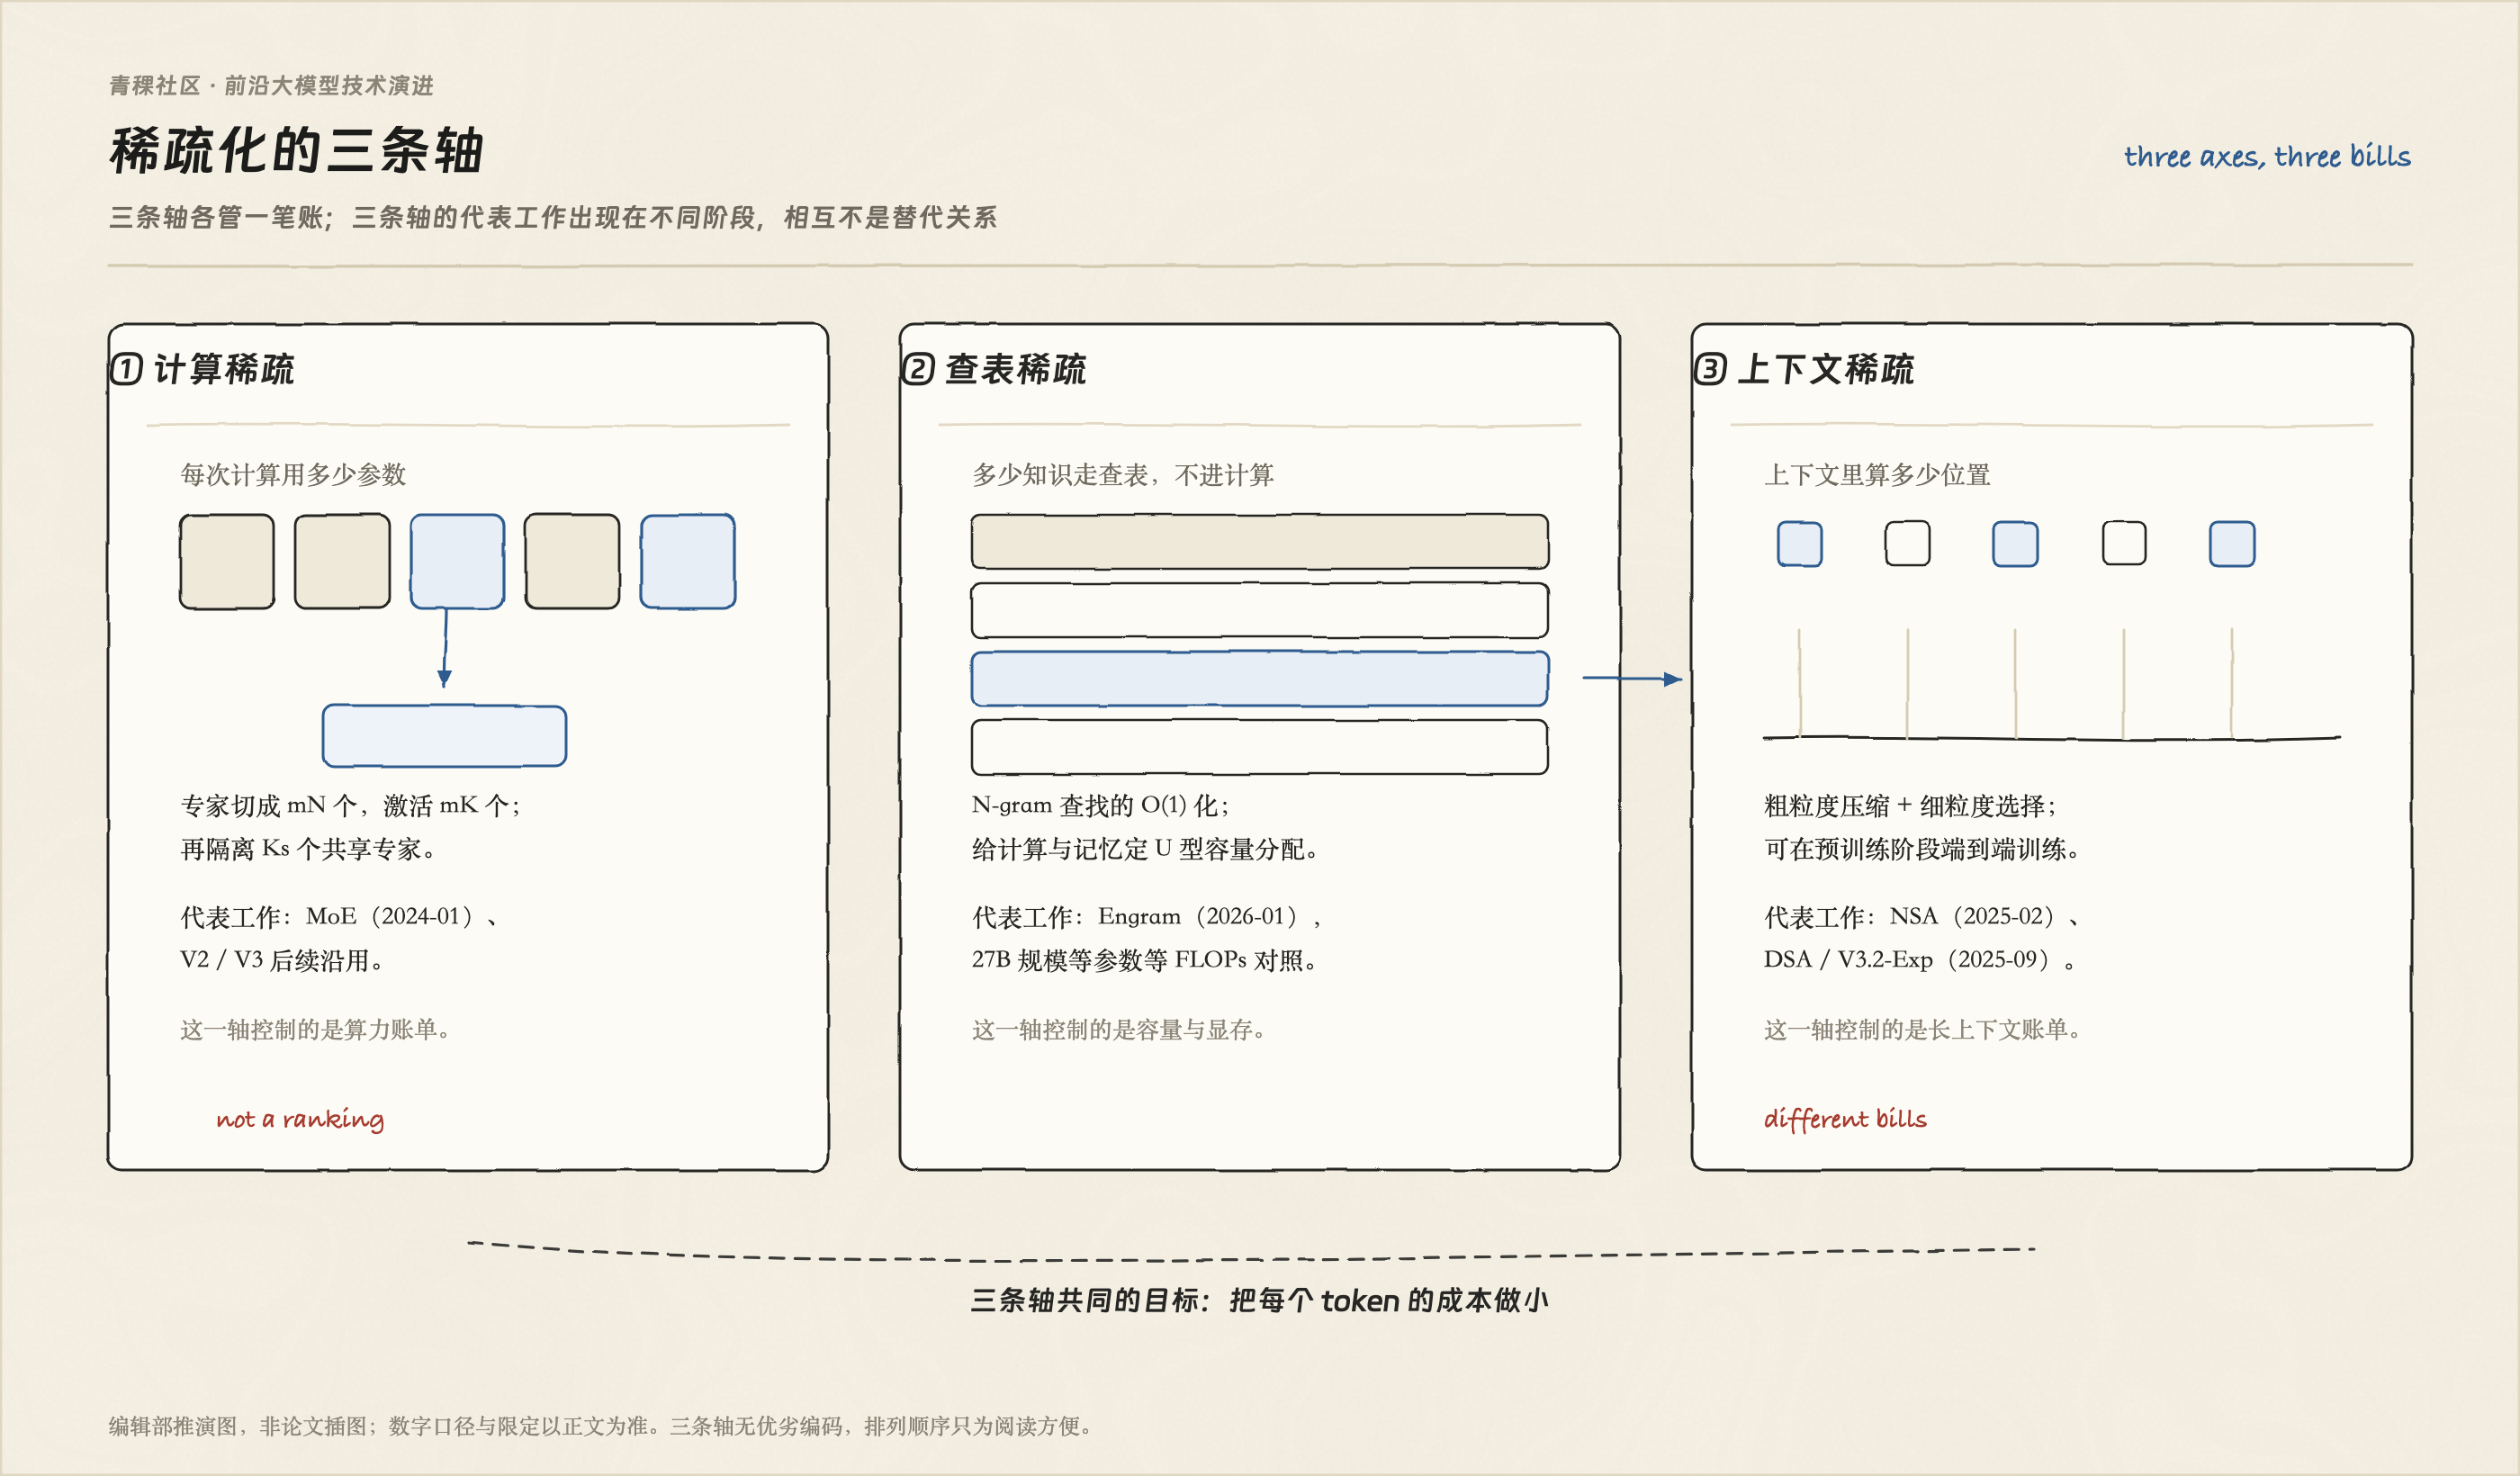
图 8:稀疏化在这条线上分成三条轴——专家稀疏管每次计算用多少参数,条件记忆管多少知识走查表,稀疏注意力管上下文里算多少位置。三条轴各自有代表工作,位置不是性能排序。图:青稞社区绘制。
六、两条支线:多模态的两种做法
除了语言主干,这条线还长期并行着一条多模态支线。它的材料不密集,但几代之间的问题指向很清楚:视觉信息应该以什么粒度进入模型。
理解侧的答案是把输入的粒度做细。DeepSeek-VL 的训练数据覆盖网页截图、PDF、OCR 与图表,用真实场景的用例分类体系构造指令微调数据,视觉编码器用混合结构处理 1024×1024 输入,目的是在分辨率与算力之间找折中。到 2024 年 12 月的 DeepSeek-VL2,语言侧直接换成 MoE 加 MLA,视觉侧改成动态切图:不同长宽比的图片不再被压成同一个比例,而是按内容切成若干块分别编码。三个变体的激活参数是 1.0B、2.8B 与 4.5B,说明这条支线也在沿「按需分配算力」的思路走。
生成侧的答案是把两件事拆开。Janus 认为理解与生成对视觉信息的粒度要求不同,共用一个编码器会让理解侧吃亏,于是把编码路径解耦、主干保持统一;JanusFlow 进一步把整流流放进语言模型框架,用连续生成替代离散 token 自回归,说明生成能力可以在同一个主干里训练,不必为它另建一套结构;2025 年 1 月的 Janus-Pro 没有再改架构,只是把训练策略、数据与模型规模一起放大。
据我整理的公开材料,理解与生成统一这条支线在 2025 年 1 月之后没有新的论文。这不代表工作停止,只是这条线公开的部分暂时停在「解耦编码 + 统一主干」这个形态上。
后半段多出来的第三条做法是光学压缩。DeepSeek-OCR 把长文本渲染成图像,再用视觉 token 解码,压缩比与解码精度之间是一条明确曲线:文本与视觉 token 之比低于 10 倍时精度约 97%,20 倍时约 60%。2026 年 1 月的 DeepSeek-OCR 2 换了编码器的行为方式,让视觉 token 按图像语义重排,而不是固定从左上到右下逐行扫描。把这条线放回主线看,它处理的是同一个成本问题——上下文里的文字究竟要用多少个 token 来表示。
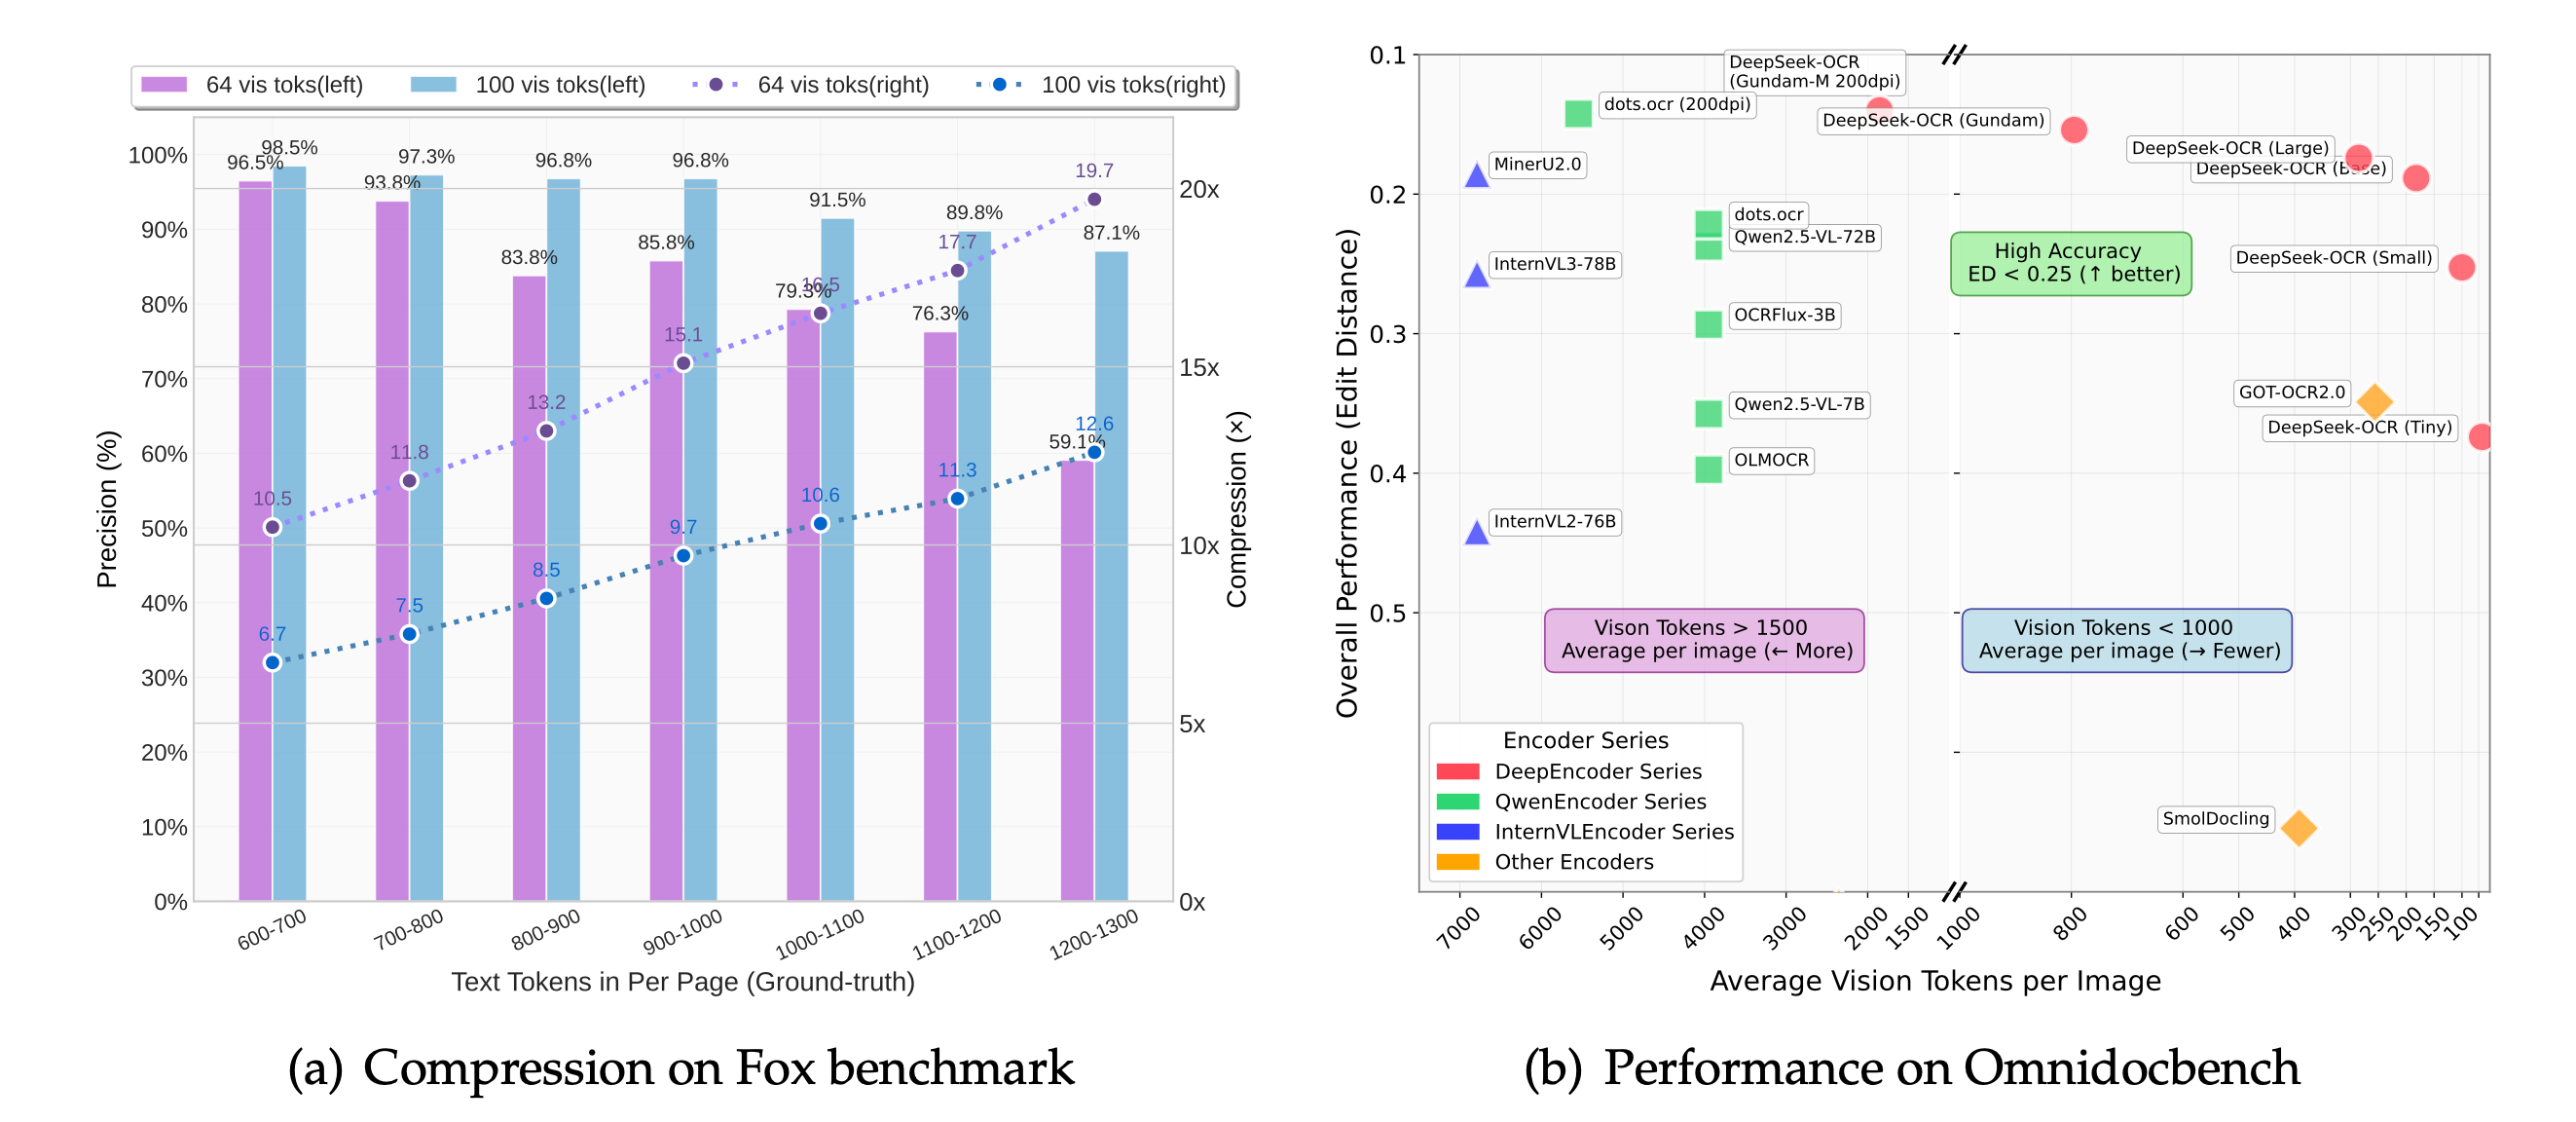
图 9:来源:DeepSeek-AI,DeepSeek-OCR(arXiv:2510.18234),官方仓库 assets/fig1.png;原图未改动,图内英文图注为原文。(a) 是文本 token 与视觉 token 不同比例下的解码精度与压缩倍数;(b) 是不同视觉编码器在 OmniDocBench 上的编辑距离与「每页平均视觉 token 数」——越靠右上角表示用更少视觉 token 取得更好的结果。
七、把三笔账放在一起看
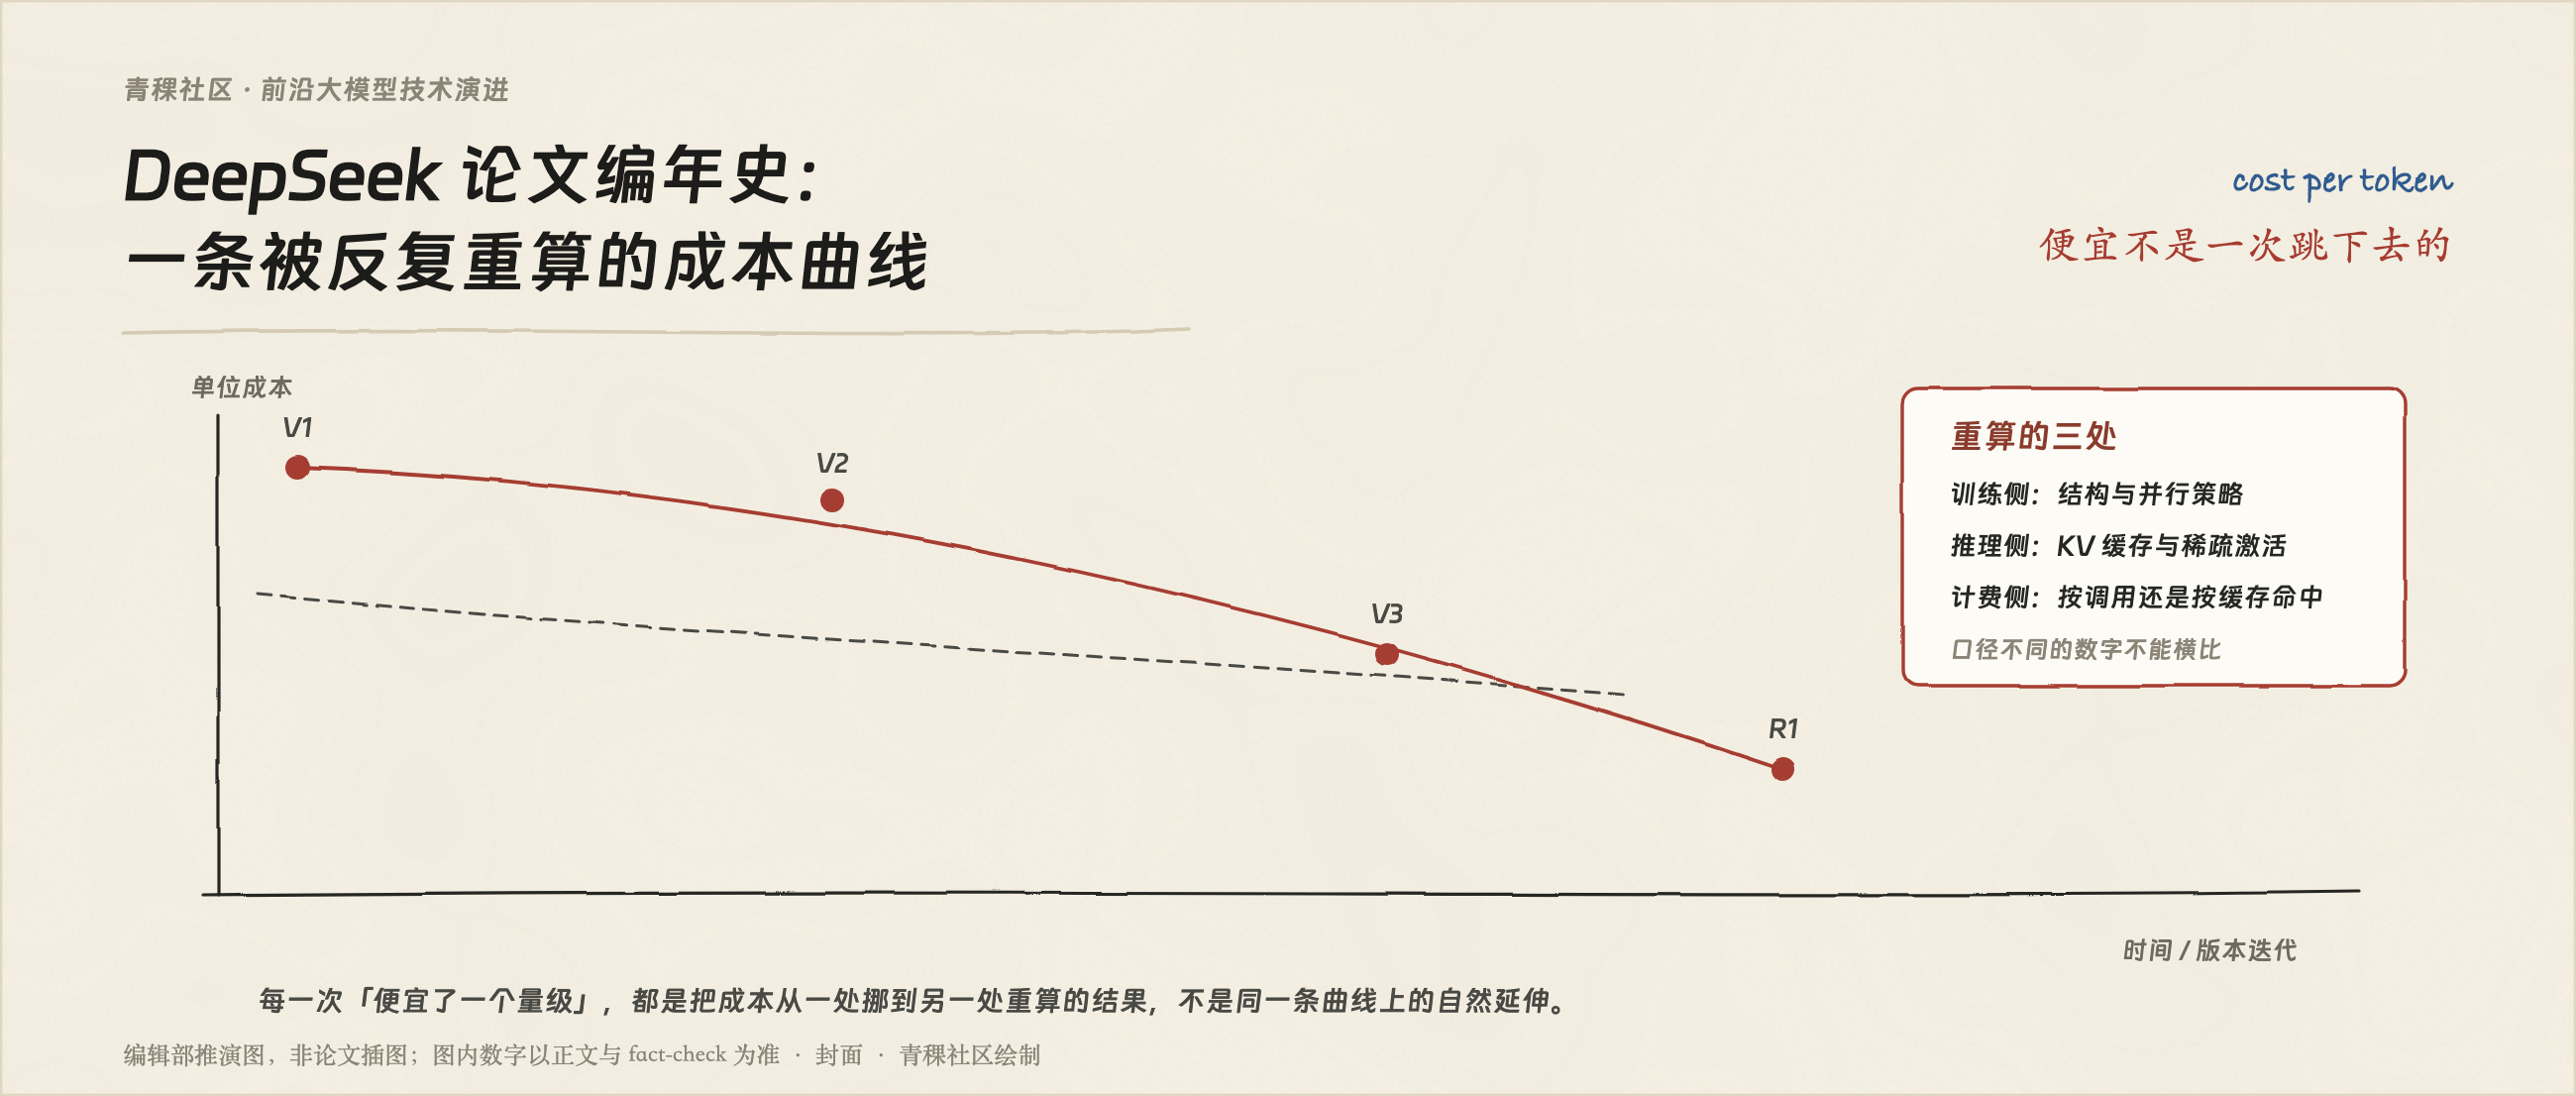
回头把上面五幕的报价排一下,能看到一条并不平滑的曲线。
训练这笔账在 2024 年 5 月第一次被写成数字(相对 DeepSeek 67B 省 42.5%),到 2024 年年底被写成绝对值(2.788M H800 GPU 小时),此后不再单独报价。缓存这笔账的改进幅度最大:V2 相对 67B 减少 93.3%,V4 相对 V3.2 降到 10%,V4.1-Flash 给出 890 字节这个带单位的量。吞吐这笔账只在 V2 出现过一次(5.76 倍),之后被并入长上下文与部署成本的叙述里。
这三笔账的可见度差得很远,我怀疑原因在报告的读法:2024 年的读者需要被说服稀疏架构值得做,所以成本是卖点;2026 年的读者已经默认要做稀疏,卖点回到能力档位,成本被压缩成几个效率数字。
不过把这三笔账直接横比是错的。它们的基线分别是 DeepSeek 67B、V3.2 和 V4-Flash,对应的上下文长度、批次与硬件都不同。它们能说明的是同一条线内部的趋势:每一代都在把「每个 token 的成本」这个分母做小,然后用省下来的预算去换上下文长度、后训练算力或者模型规模。
把 27% 与 10% 这两个数读细一点会更清楚:同一个模型在百万 token 设置下,算力降到上一代的四分之一左右,缓存降到十分之一。两者的下降幅度并不一致,缓存掉得更快,这说明压缩缓存比压缩计算更容易见效——它不需要动模型输出什么,只需要改保存什么。
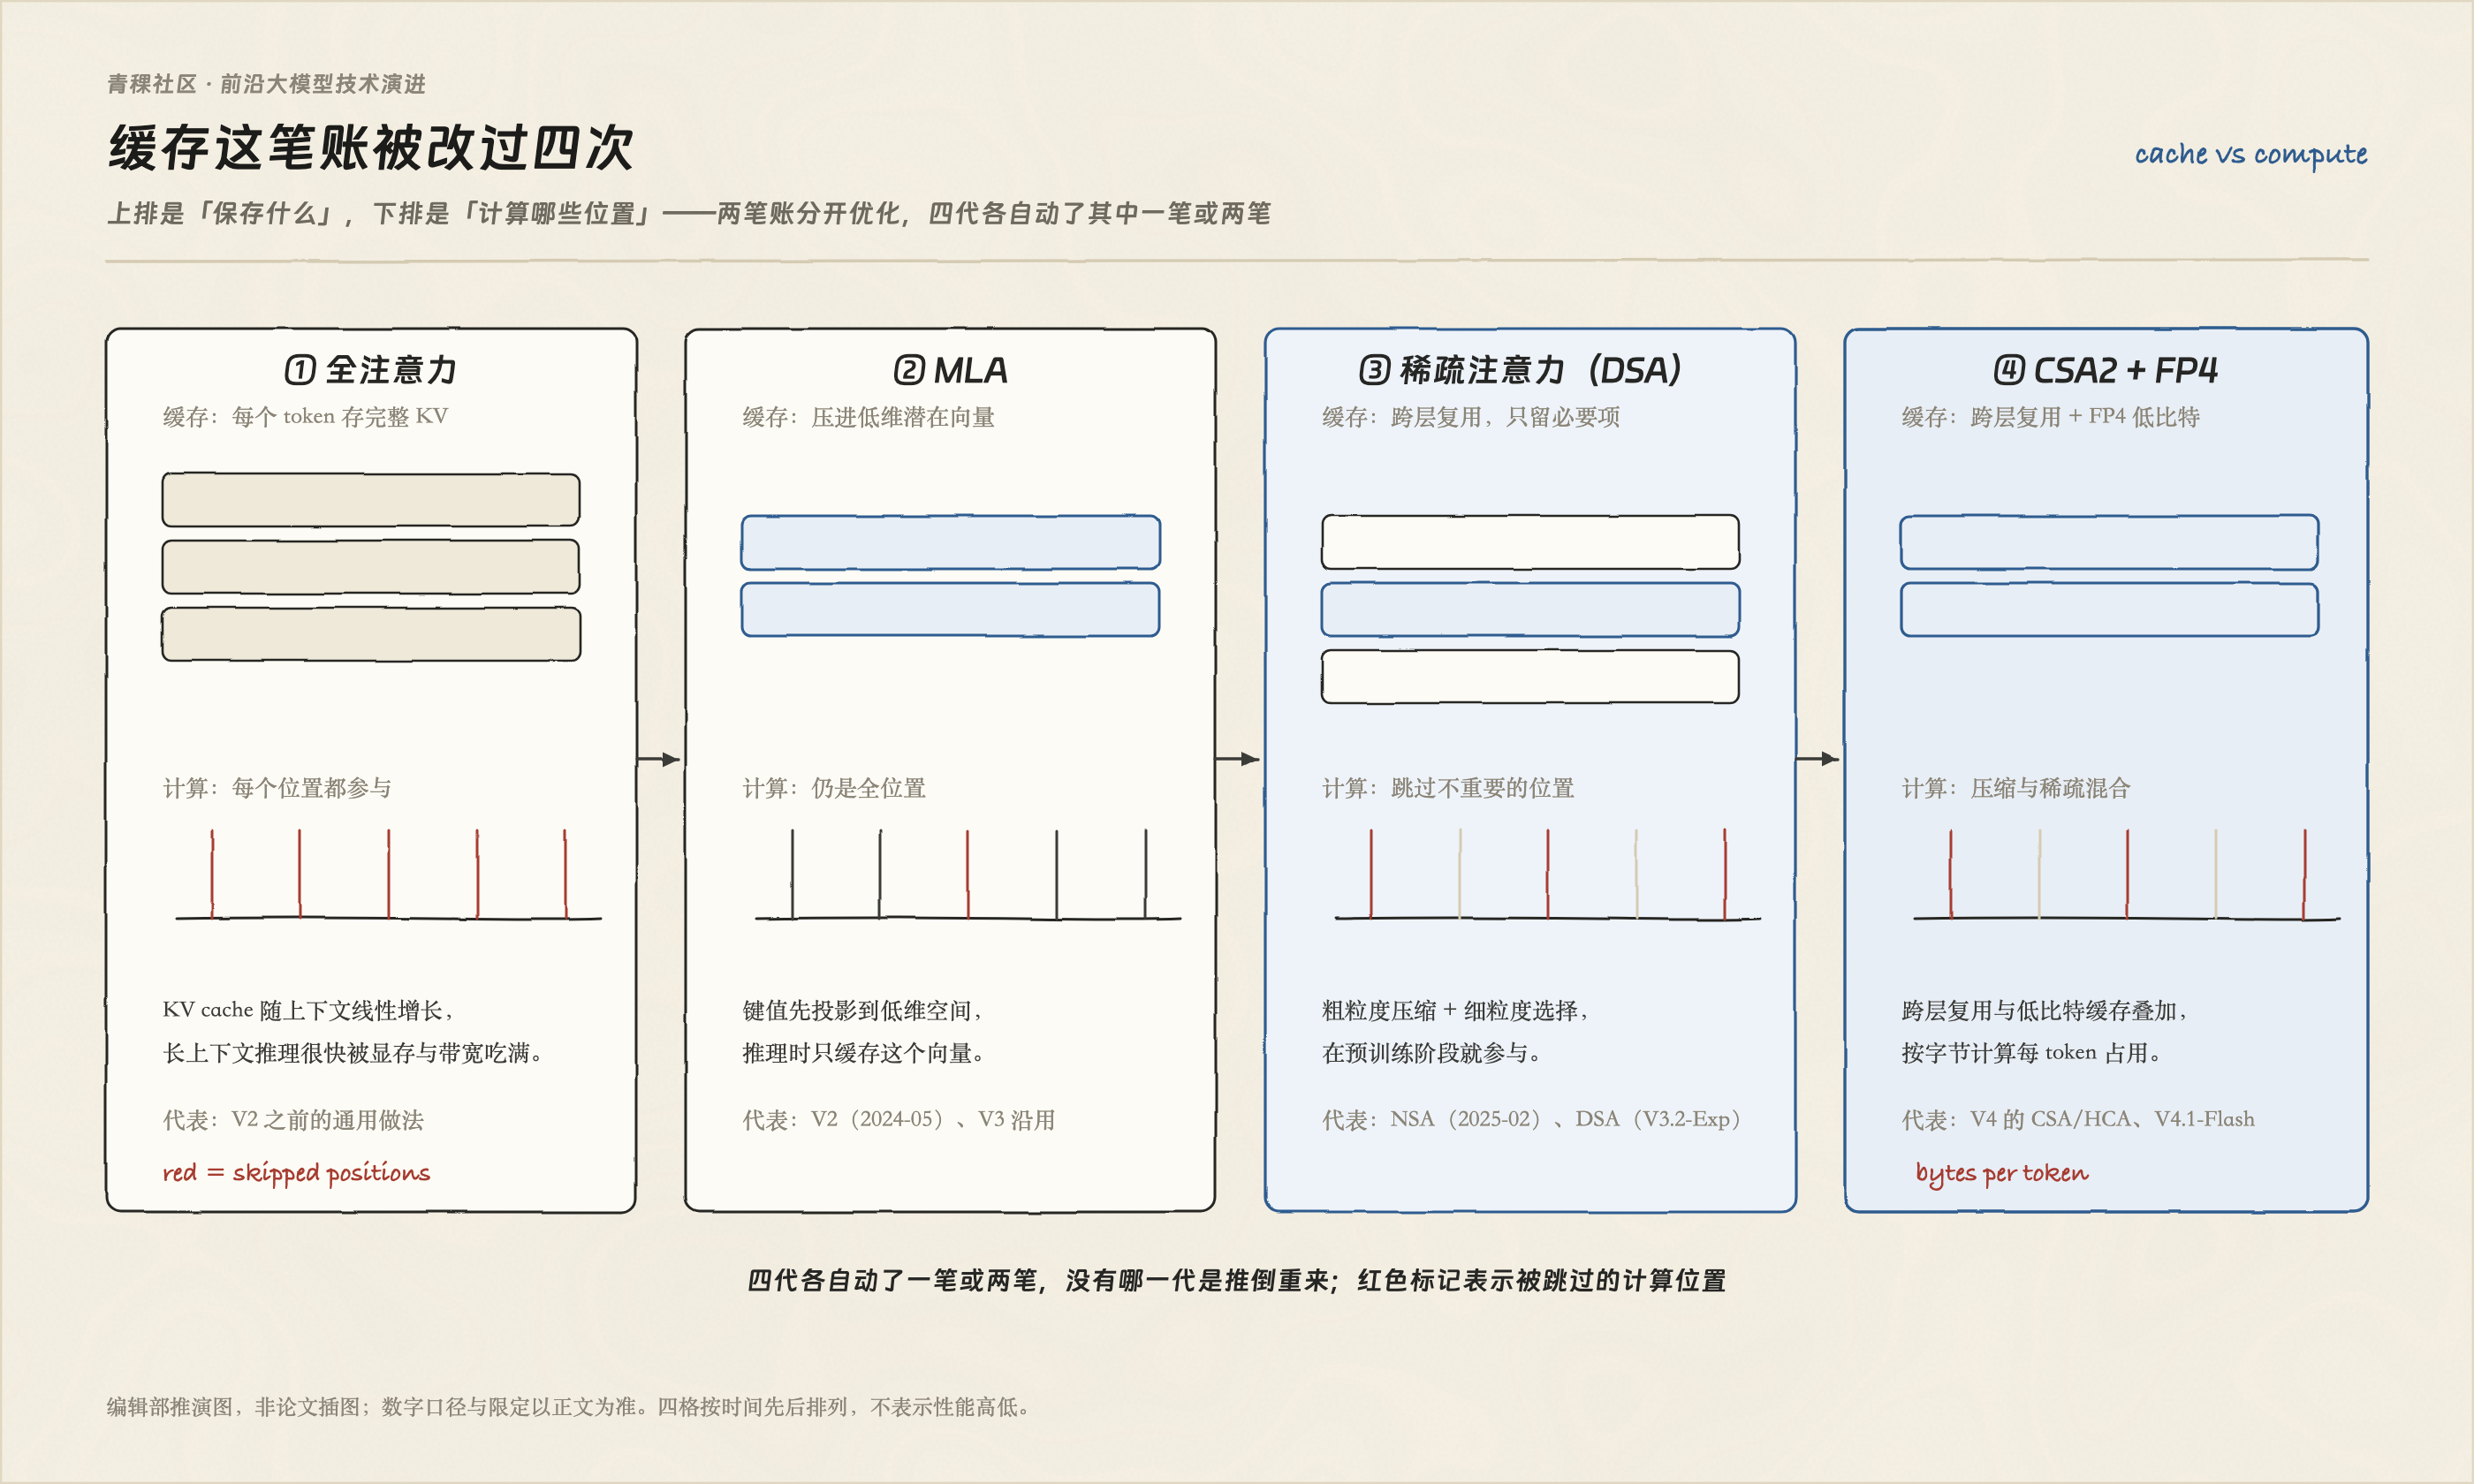
图 10:缓存与计算这两笔账的四次改动——全注意力、MLA、稀疏注意力(DSA)、CSA2 加 FP4。上排是保存什么,下排是计算哪些位置(红色标记表示被跳过的位置)。四格按时间先后排列,不表示性能高低。图:青稞社区绘制。
至于省下来的预算具体换成了什么,两次转换有公开痕迹。一次是 V4 把上下文从 128K 级推到百万级;另一次是 V3.2 把算力投进后训练与 agentic 数据合成。这两次都属于「用效率换能力」的同一种操作,但论文没有把效率增益与能力增益做因果拆分,所以只能说时间上相邻。
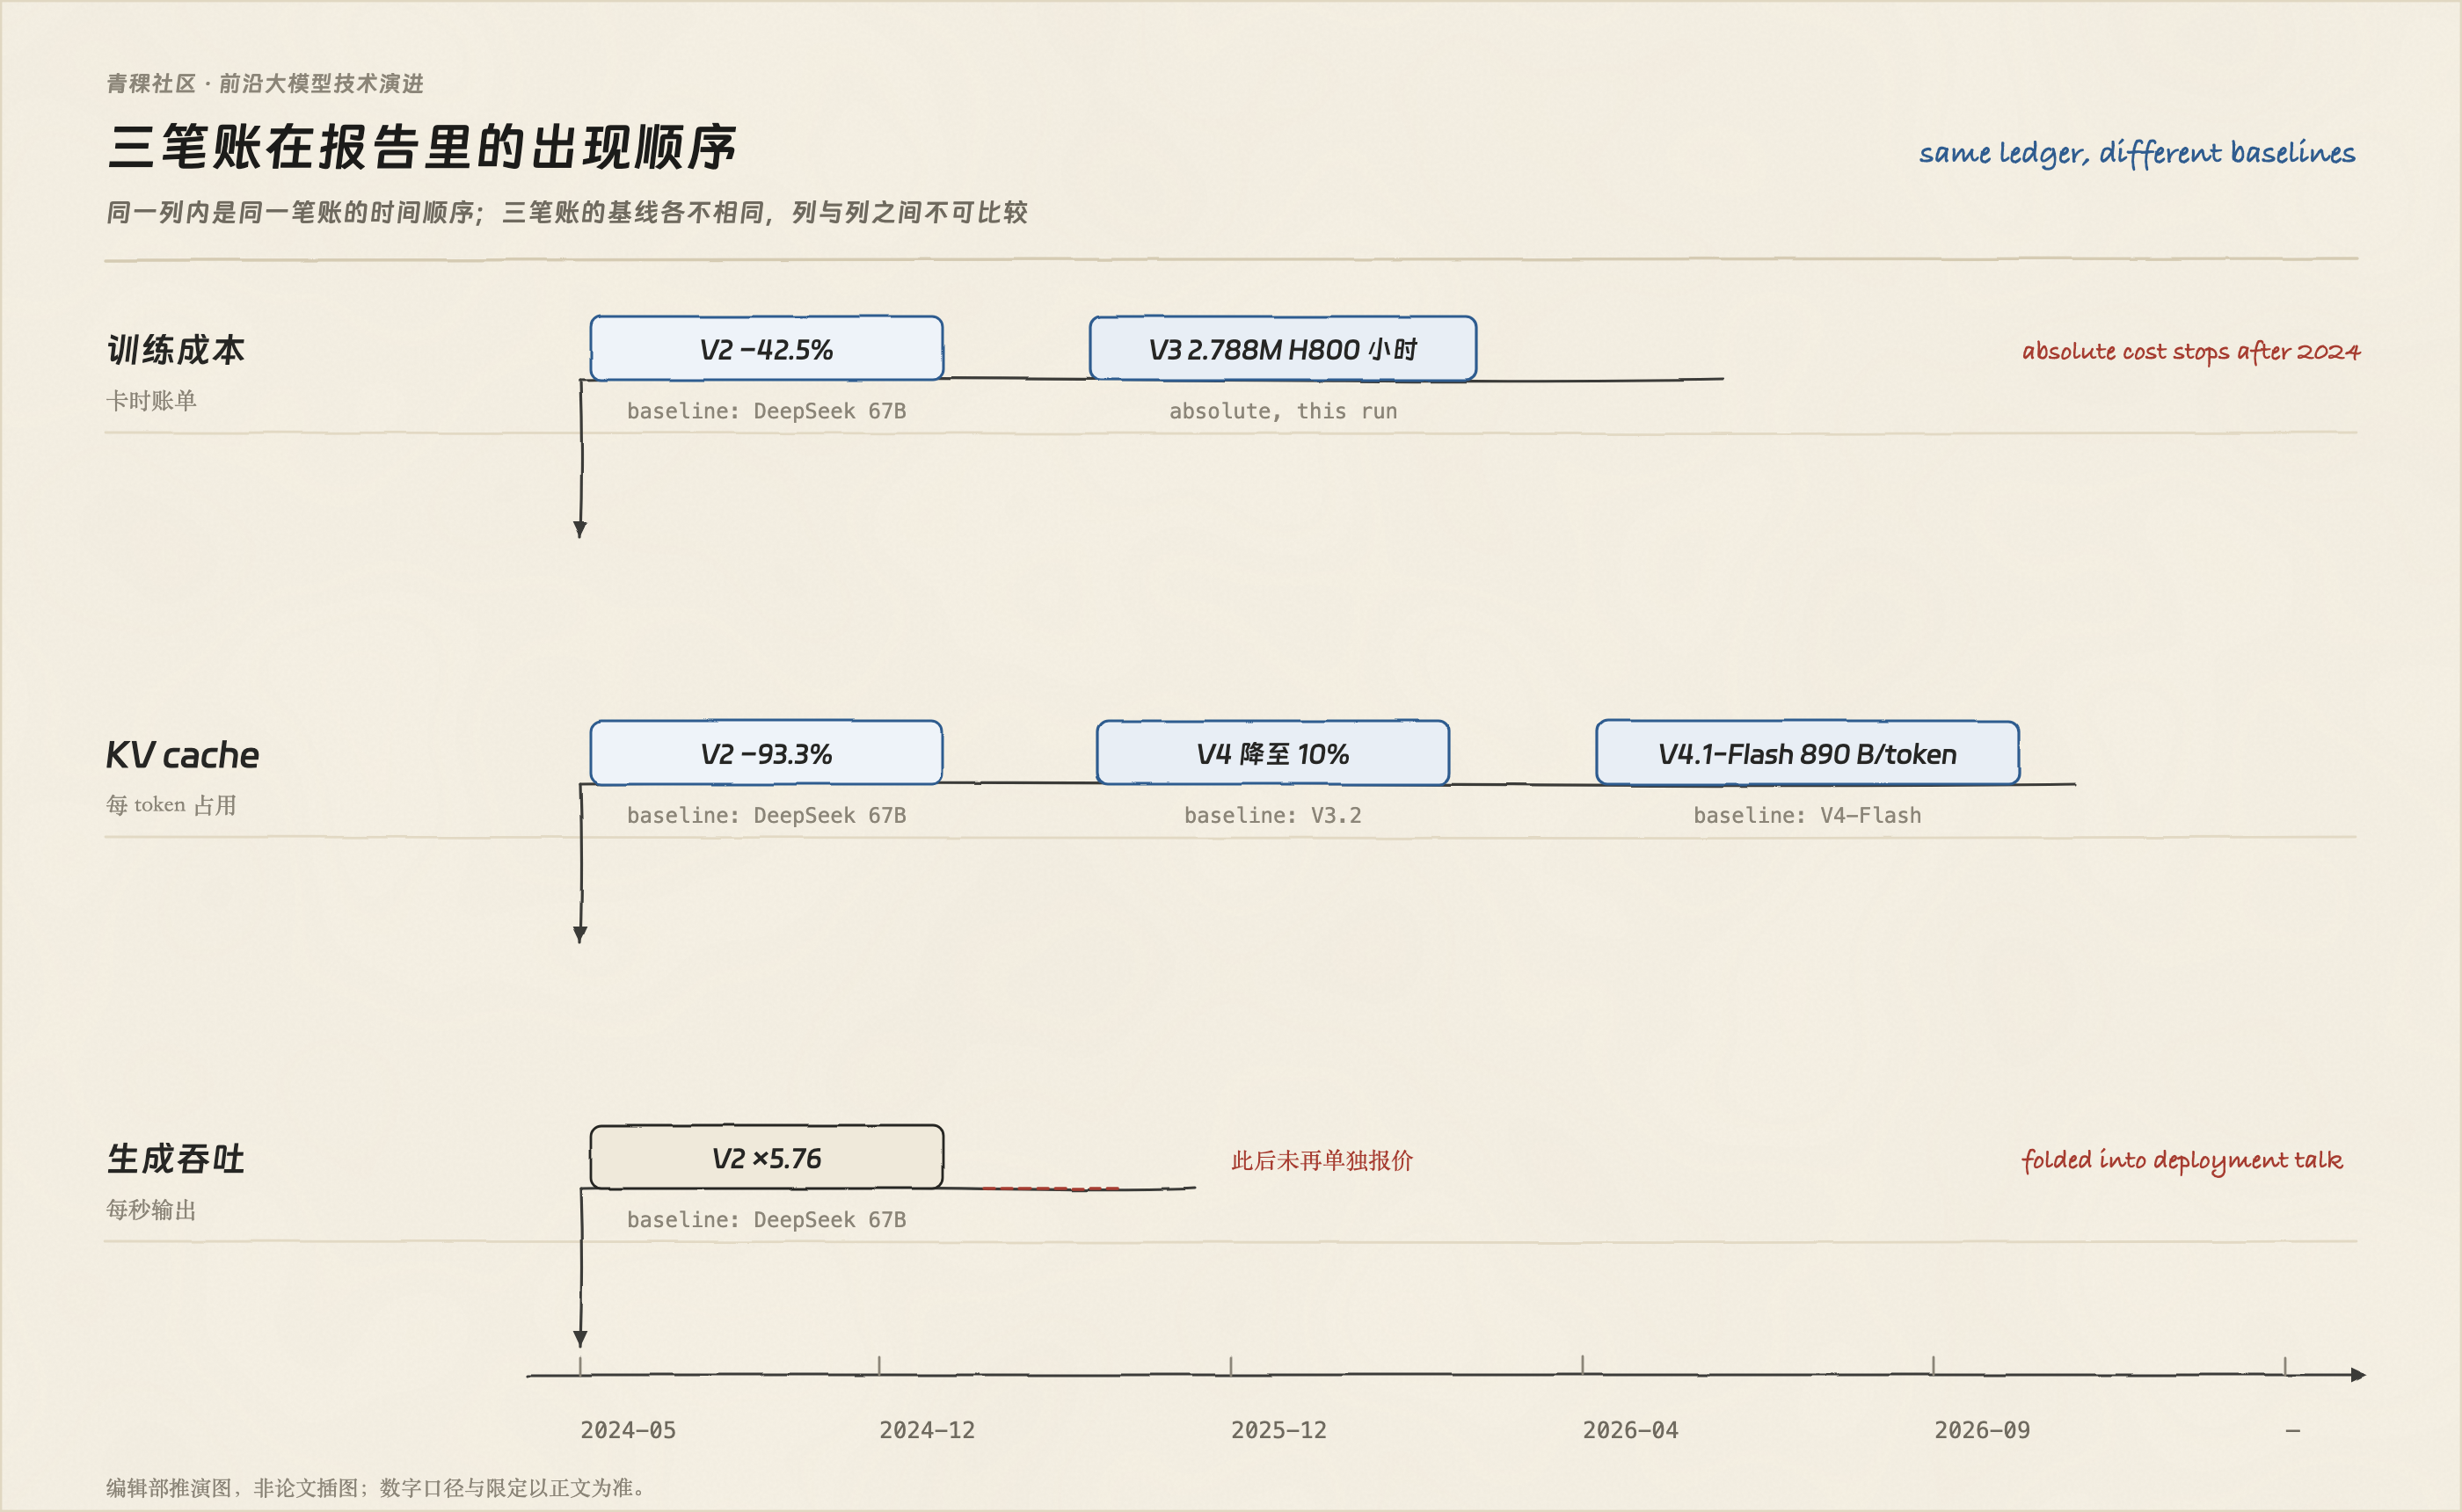
图 11:同一条线上三笔账的可见度变化。三组数字的基线不同(依次为 DeepSeek 67B、V3.2、V4-Flash),纵向不可直接比较;图中只保留各自的出现顺序与口径。图:青稞社区绘制。
八、奖励从哪里来
如果只看模型规模,这条线的 2025 年像是稀疏化的一年;把后训练单独拎出来看,它其实是在解决另一个问题:奖励信号从哪来。
最早的答案是人类的推理轨迹。DeepSeekMath 用 GRPO 在数学题上做强化学习,奖励来自可判定的答案,这条路在数学上成立,因为答案对错可以被自动判定。R1 把同一套逻辑推到通用推理:训练信号来自可验证任务的结果,人写不写思维链不再是前提。这条主张的代价也很直接——只在可验证任务上成立。
接下来两年,这条线一直在扩建「可验证」的边界。奖励建模(DeepSeek-GRM)补的是不可验证的通用问题:先让模型学会生成原则与批评,再用并行采样与投票消耗推理算力。自验证(DeepSeekMath-V2)把判据从答案挪到过程:训练一个能挑出推导毛病的验证器,并随着生成器变强而扩大验证算力。形式化(Prover 系列)更彻底,Lean 4 本身就是验证器,人类只需要提供定理。到 V3.2 与 DSec,扩建的对象变成环境:合成出来的 agentic 任务、可反复回放且不会泄漏状态的沙箱,都属于同一件事——让「对与错」可以被自动判定。
把方法差异放回训练目标上看,这条线的后训练其实只在补同一个短板——验证信号的供给。数学、代码与形式化推理是可验证任务最集中的三个领域,这也是这条线在这些方向上报告得最多的原因。反过来看,代价是这些成绩对通用任务的代表性有限。
把 GRPO 单独看一眼,能看清这个转向的算法形态。PPO 需要一个价值网络来估计基线,价值网络本身要训练、要占显存;GRPO 改成让同一个问题采样一组答案,用组内得分的相对高低当优势信号,价值网络这一项就被省掉了。省下的资源可以换成更多采样、更多题目、更长的训练。这条线的算法改动几乎都朝同一个方向:把人工成本与额外模型换成更多可自动判定的样本。
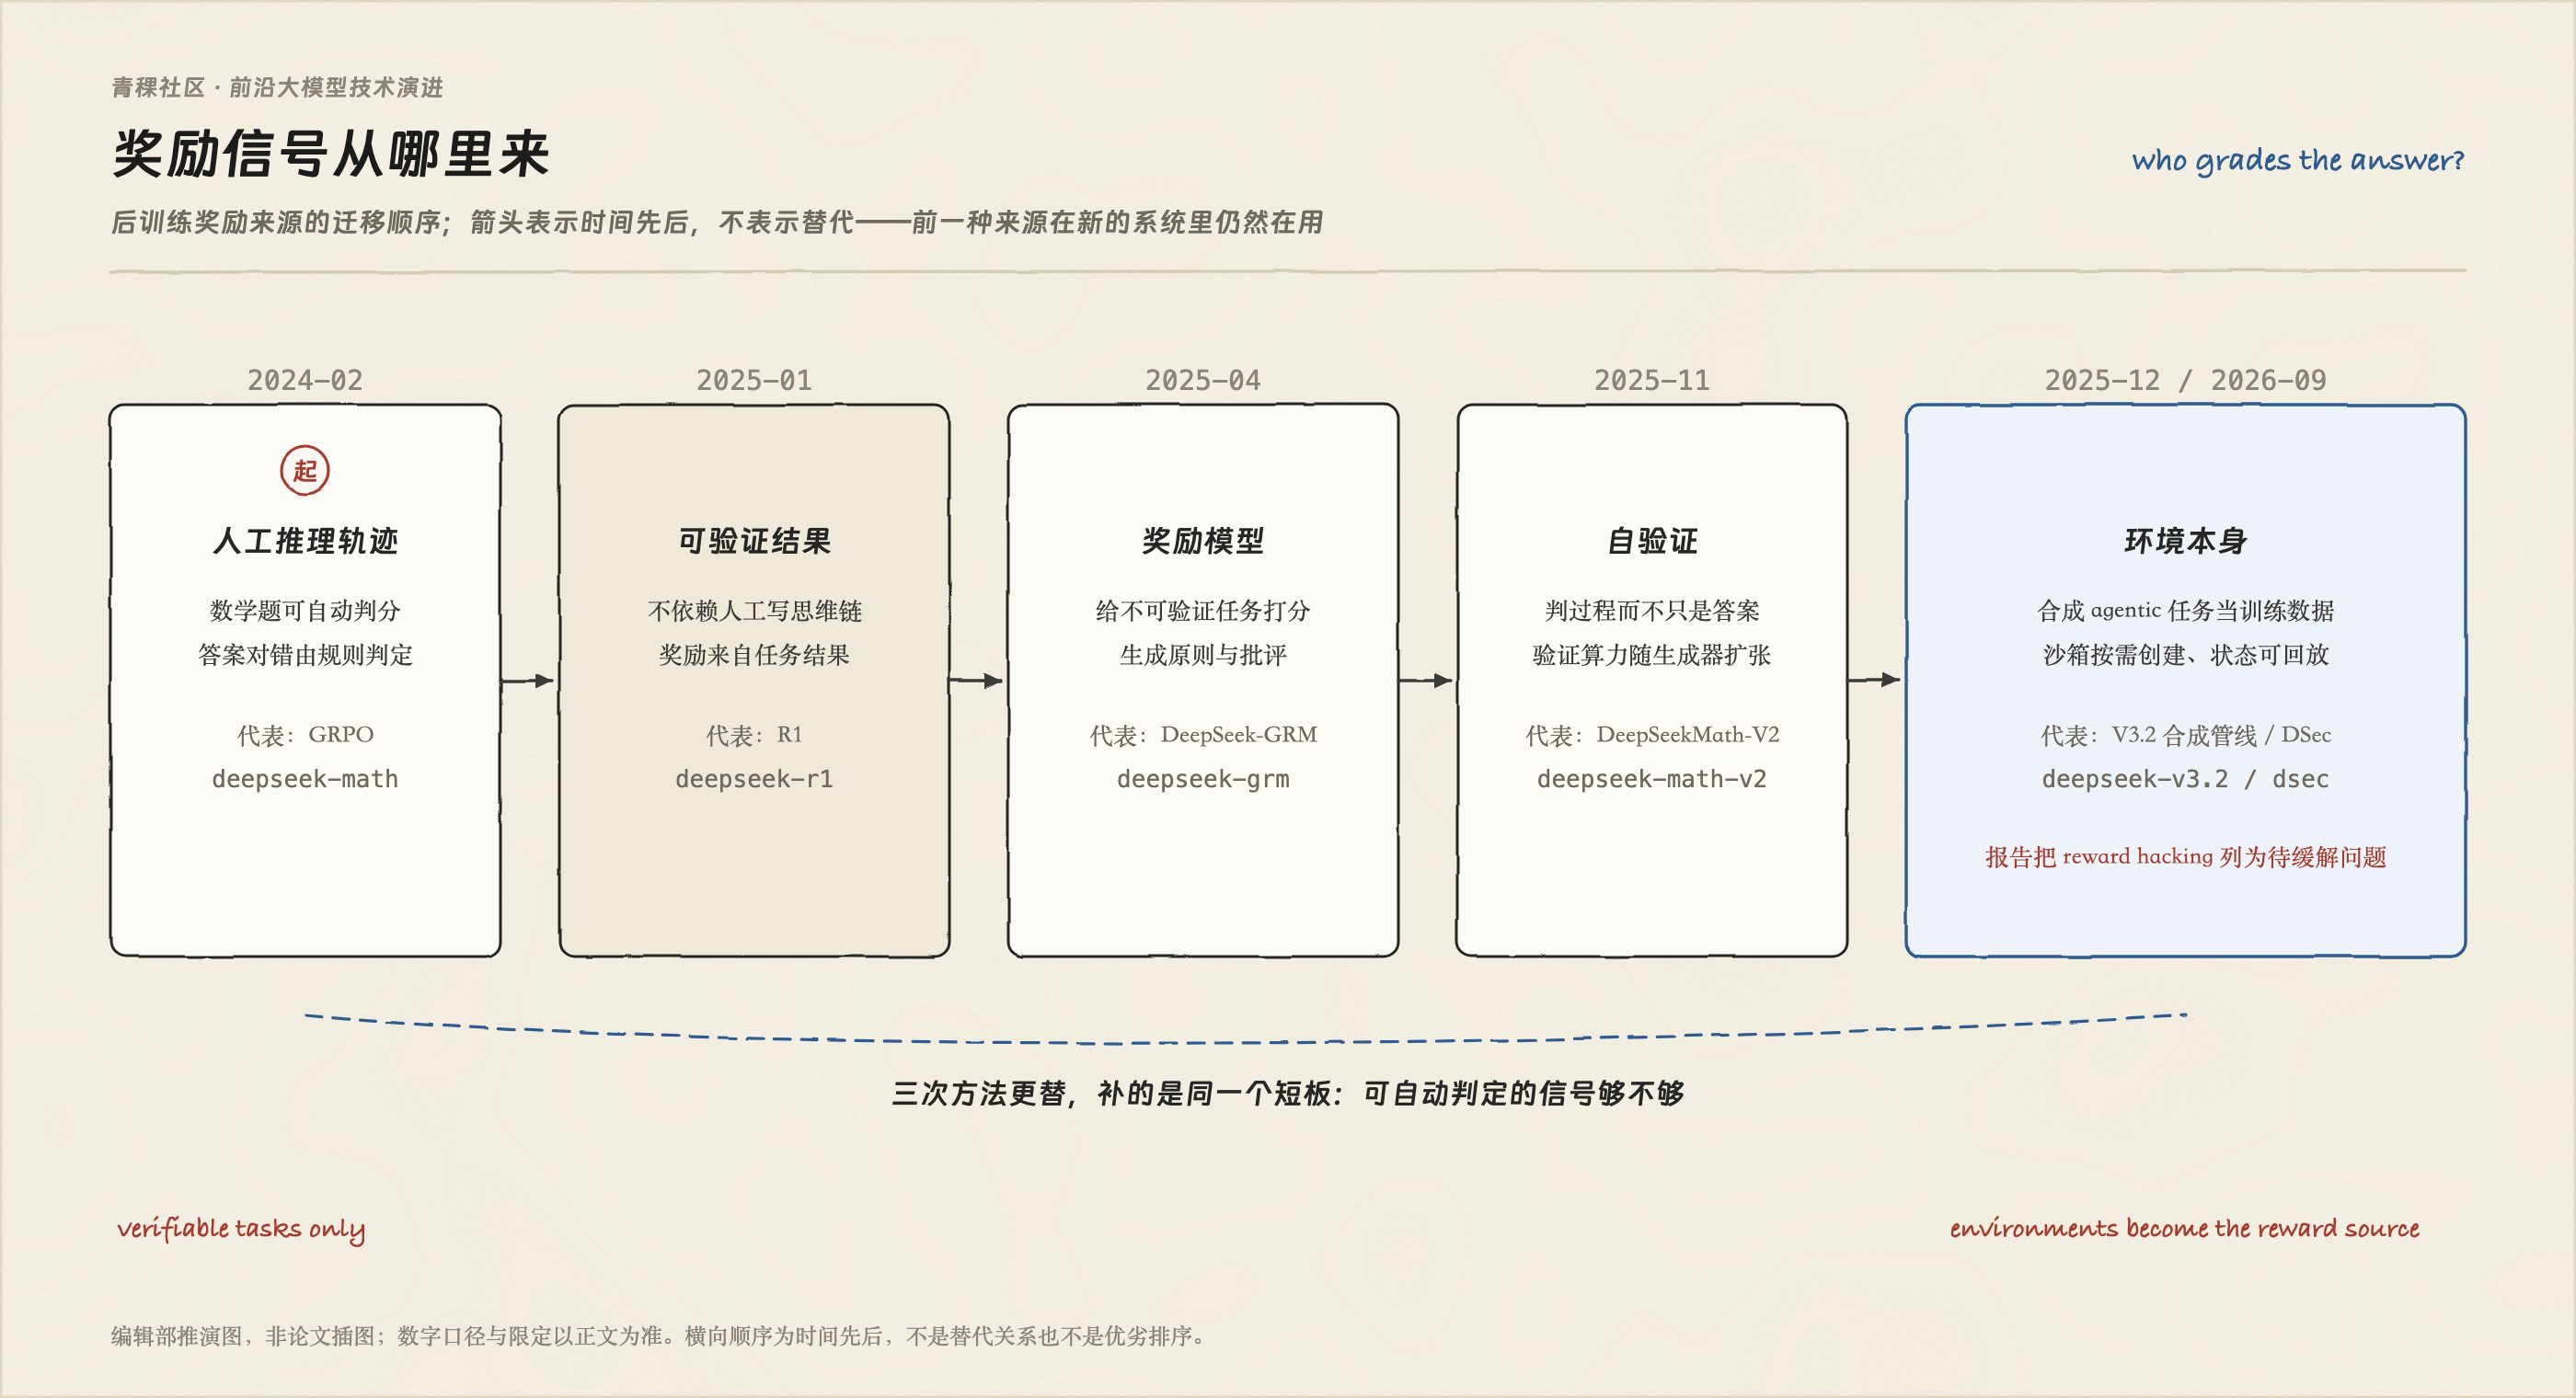
图 12:后训练奖励来源的迁移——从人工推理轨迹到可验证结果、奖励模型、自验证,再到可交互的环境本身。箭头表示时间顺序,不是替代关系,前一种来源在新的系统里仍然在用。图:青稞社区绘制。
九、实验没有证明什么
上面所有数字都来自官方报告与发布说明,这一点决定了它们能回答什么问题。以下几件事,这条线至今没有给出公开证据。
没有跨厂商的同协议对照。 V3.2 报告称自身表现与 GPT-5 相当,高算力变体 V3.2-Speciale 超过 GPT-5,并在 IMO 2025 与 IOI 上达到金牌水平;这些是论文自报结论,评测设置由发布方设定。Math-V2 的 118/120 同样如此,而且它是在扩展测试时算力下取得的,不是单次成绩。把它们写成「超过某模型」会丢掉口径。
没有复现材料。 数据配方、强化学习环境、评测脚本都没有公开。V3 与 V4 公布了参数规模、token 数、GPU 小时,甚至公布了训练过程中没有回滚,但没有公布数据配方的构成。R1 的核心主张需要一整套可验证任务的数据管线才能检验,这套管线在论文之外。因此本文只写「机制可读」,不写「可复现」。
没有失败统计。 所有报告发布的是最终指标,不是失败率与失败模式。DSec 报告是少数公开提到失败侧的地方——它把 reward hacking 列为要缓解的问题,这反过来说明在可交互环境里,被优化的目标与真实目标之间存在缺口。
没有跨规模外推。 Engram 的 U 型容量分配规律验证到 27B,DeepSeekMoE 的专家切分结论来自 2B 量级对照,两者都没有给出更大规模上的验证。
没有把工程技巧与能力提升拆开。 自洽采样、树搜索、测试时扩展这些推理期手段,常与模型本身的能力出现在同一组数字里。DeepSeek-Prover 的 46.3% 与 52% 的区别就是采样次数,Math-V2 的 118/120 需要扩展测试时算力,读这些数字时必须带着条件。
还有一层口径问题值得单独说。这条线的报告习惯把自家上一代当基线,「提升」与「不降」两种结论混在同一张表里的情况并不罕见。V3.2-Exp 的验收口径是同配置质量不降,发布说明给出的 MMLU-Pro 两代都是 85.0——这是一次成功的替换,不是一次能力跃升,把它读成涨点会误判这一代的价值:它换来的东西在价格与效率那一侧。
十、小结
把这条线读成「三年发了十几次模型」会漏掉它的结构。按本次梳理的证据,它更像三个同时推进的工程:
架构侧负责把每个 token 的成本做小。MLA 管缓存,MoE 管计算,DSA 与 CSA2 管上下文,条件记忆把一部分知识挪出计算之外——它们各管一笔账,合起来是把分母做小。
后训练侧负责扩大可验证任务的供给。GRPO、纯 RL、生成式奖励建模、自验证、agentic 环境,都是为了让更多任务能自动判定对错。
基础设施侧负责让前两件事的规模成立。训练集群、FP8 训练栈、分布式文件系统、沙箱平台,都没有直接出现在能力榜单上,但它们是前面两件事的前置条件。
这三条线并不总是同步。2024 年架构侧的报价先出现,后训练侧的方法要等到 2025 年年初才换代;2025 年后训练算力的扩张又回头给基础设施提要求,于是有了沙箱与调度那一层。读这份编年史时把三条线分开看,比按发布时间排队更容易看清每篇论文在回答什么问题。
三者之间的关系是接力,不是替代。稀疏化只有在 kernel 与集群都跟得上时才兑现;后训练的规模只有在 rollout 环境能撑住时才成立。这也解释了为什么这条线的报告里总有一篇看起来「跑题」的系统论文。
至于下一步,这篇梳理能给出的判断只有一条:长上下文的竞争点已经从「支持多长」转成「每个 token 摊多少字节」,V4.1-Flash 的 890 字节与 DSec 的沙箱并发指标都属于这一类工程指标。至于这些指标能不能换来外部可验证的能力提升,要等有独立的评测材料出现才能回答。
把这三条线放在一起,还有一个容易被忽略的推论:这条线的技术选择高度依赖自己那套工程条件。MLA 与稀疏注意力的收益要由专用 kernel 兑现,KV cache 的极致压缩要由自建的推理栈承接,agentic 后训练要由自研沙箱撑住。这些做法在别处能不能照搬,取决于对方有没有同等的系统侧投入,而不只取决于论文写得多清楚。这也是本文在「机制可读」与「可以复现」之间划线的现实理由。