最近的 BPO 与 Score Centering 两个工作热度很高,BPO 的作者也分享对比了两个方法。😉
- Score Centering:解释 training–inference mismatch(TIM)为何制造 drift,并消除它。
- BPO(Bellman Policy Optimization):从 Policy Mirror Descent(PMD)出发,利用 Bellman 方程消去中间价值,推导无 critic 的轨迹目标,再近似成 token loss。
1. 下文统一符号
Prompt 集合为 D,prompt 采样分布为 \mathcal D:x\sim\mathcal D。若均匀分布,\mathcal D(x)=1/|D|。
词表为 \mathcal V,其概率单纯形是:
状态 s_t=(x,y_{<t}) 是 prompt 与生成前缀。策略
为每个状态输出下一 token 分布;所有策略组成 \Pi=\Delta(\mathcal V)^{\mathcal S}。
若 \nu 相对于 \pi 绝对连续,记作 \nu\ll\pi。离散词表中:
即 \operatorname{supp}(\nu)\subseteq\operatorname{supp}(\pi)。它保证概率比、log-ratio 与 KL 不发生正数除以零。
2. PG、PPO 与 PMD
2.1 Policy Gradient
回顾 PG,手推一遍。PG 从最大化期望奖励开始:
利用 \nabla\pi=\pi\nabla\log\pi:
自回归模型满足 \log\pi(y)=\sum_t\log\pi(y_t\mid y_{<t}),所以 surrogate loss:
On-policy 且 advantage 准确时,该采样梯度对 \nabla J 无偏。
2.2 PPO GRPO
PPO、GRPO 是基于 PG estimator 构造的。
它虽然没有显式 \log\pi,但
未裁剪时 \nabla(-Ar)=-Ar\nabla\log\pi。
同一梯度也可由
产生。给它加入 mask M 就是 BPO 文中的 GRPO 公式:
这和常见的 GRPO loss(veRL 默认代码是常见 GRPO ratio/clipping 形式)不一样,但梯度相同。
2.3 PMD
旧策略 \mu 的 advantage:
沿轨迹相加时,中间价值望远镜消去:
性能差异引理给出
更新前不知道 d^\pi,局部地用 d^\mu 近似。为保证旧 advantage 在新策略附近可靠,加入信赖域:
其拉格朗日形式就是 PMD:
唯一解析解:
因此 PMD 是新策略下的期望 advantage 减 KL。
PG 在参数空间求局部梯度;PMD 在策略分布空间求 KL 近端更新。
PMD 的工作比 PG 少一些,比较典型的有 Kimi k1.5。
3. Score Centering
3.1 TIM 与 expected score
在现代 RL 中,Sampler q 生成 rollout,trainer p 重算 log-prob。训推框架不同、量化、kernel、浮点误差、异步同步和 staleness 会导致 p\neq q,这个就是 TIM(training-inference mismatch)。
Token v 的 score:
Sampler 下的 expected score:
On-policy 时,
TIM 下 q 改变 score 的加权,导致 \mathbb E_q[s]\neq0。用一个 TIM 比较大的例子:
则 \mathbb E_p[s]=0,但 \mathbb E_q[s]=-0.3。
3.2 Drift 与 signal
PG 里,有理想 on-policy 梯度:
rollout 实际来自 sampler q。不使用 off-policy 校正时,训练实际采用的期望更新为:
展开协方差的定义,有
Signal 衡量哪些 token 与高奖励相关;drift 只依赖平均奖励。比方说,如果 R\equiv1:
环境没有学习信号,这时 TIM 下仍出现的 \bar s 就是 drift。
3.3 Drift 是向 sampler 蒸馏
而以 q 为教师的交叉熵为
这是一样的,\bar s=-\nabla L_{\rm CE}。
单个 rollout 看似 one-hot SFT,L_y=-\log p_y;在 y\sim q 下取期望后就是 full-distribution 蒸馏:
固定教师最终会收敛;在线 sampler 是 trainer 的量化/陈旧副本:
偏差被反复注入,形成正反馈并可能导致奖励崩溃。
3.4 奖励与 group centering
论文默认主要实验:
+1/0 对照实验直接令 A=R\in\{0,1\};恒 +1 理论实验令 A=R=1。都没有 GAE/critic。
Group centering 只保证一组 rollout 的 advantage 总和为零,不保证具体前缀下 \mathbb E[A\mid y_{<t}]=0。前缀处 drift:
它能缩小和部分抵消 drift,却不能处处消除。
3.5 Score Centering 本体
令
于是
减去常量不改变协方差,因此删除 drift 而保留 signal。
与理想 on-policy 还是有区别的,剩余协方差仍按 q 而非 p 加权。论文的实验里,严重 staleness 时会把 Score Centering 与 TIS/MIS 组合。
3.6 Scalar loss 与 top-k
无需显式生成巨大梯度向量,构造
即可由自动微分得到 -\nabla L=A(s_{y_t}-\bar s)。t 是 rollout 位置;v\in\mathcal V 是当前位置所有候选 token。第一项只看实际 token,第二项计算所有可能 token 的期望。
不过完整 sampler 分布太贵。令 H 为 sampler top-k。
论文有个假设,尾部 q_v\approx\rho p_v,利用 \sum_vp_vs_v=0:
对应 loss:
\operatorname{sg} 是 stop_gradient。不过这是有偏近似。尾部总质量相等不代表 score 加权求和之后相等,因为不同 token 的 s_v 不同。
论文实验中 k=32/128 均接近完整版本。这里 top-k 是保存 log-probs。
import jax.numpy as jnp
from jax.lax import stop_gradient

def score_centering_loss(train_logp, samp_logp, topk_ids,
                         sampled_token, advantage):
    train_head_logp = train_logp[topk_ids]
    tail_mass_ratio = (
        1 - jnp.exp(samp_logp).sum()
    ) / (
        1 - jnp.exp(train_head_logp).sum()
    )
    head_prob_residual = (
        jnp.exp(samp_logp)
        - tail_mass_ratio * jnp.exp(train_head_logp)
    )
    logp_correction = (
        stop_gradient(head_prob_residual) * train_head_logp
    ).sum()
    return -advantage * (
        train_logp[sampled_token] - logp_correction
    )
3.7 IS、裁剪和 staleness
既然 importance sampling 已经能校正 off-policy mismatch,为什么还需要 Score Centering?精确 IS 理论上能消除 drift,但精确 IS 的权重可能极大,方差很高,实践中必须裁剪或丢弃极端权重,裁剪破坏精确分布校正,重新引入 drift。Score Centering 不依赖 importance ratio,也不需要裁剪,因此能够直接、稳定地消除 drift。
再写一遍之前 drift 对应的公式,方便下面对照着看:
理想 on policy 天然没有 drift,token 按 trainer 自己的分布 p 采样:
因此平均奖励产生的 drift 为:
off policy :
精确 IS 权重 w=p/q 满足
精确 IS 也能消除 drift。
权重裁剪后 q_v\widetilde w_v\neq p_v,expected weighted score 再次非零。
令 r_v=q_v\widetilde w_v,归一化 \widehat r_v=r_v/\sum_ur_u;\widehat r 决定被拉向哪个扭曲分布,\sum r 缩放梯度强度。
论文接下来要做实验证明方法的效果,于是他们用三种方式放大 TIM:固定高斯权重偏移;只量化 sampler 的权重/激活/KV cache 而不动 trainer;每 64 步才同步 sampler。后者满足
64-step 窗口内特别 off policy,就像一小段 offline RL;区间之间刷新 sampler,宏观上 online。
更完整地说,RLVR 的 off-policy 来源至少包括:
1、 同一 rollout batch 被切成多个 mini-batch,后续 optimizer update 已在使用较旧策略的数据;
2、 异步训练中 rollout worker 落后于 learner;
3、 partial rollout 的一条回答可能跨越多个策略版本;
4、 即使权重版本相同,训练与推理引擎的数值计算也可能不同。
序列级 IS 与 token 级 IS 的关系
若整条回答由 behavior policy \mu 生成,严格的序列级 IS 权重是
长回答中乘积方差会爆炸。GSPO 使用长度归一化的几何平均
降低长度敏感性,但它已不是严格测度变换所需的 W_\theta。
常见 token-level IS 可看成序列乘积在 r_t\approx1 附近的一阶近似。令 r_t=1+\Delta_t:
当 \pi=\mu 时梯度一致;策略走远或序列很长时,高阶交互不可忽略。例如 T=16384 且所有 r_t=1.001:
极微小的 per-token mismatch 也会沿长回答累积,纯序列 IS 与 token surrogate 都各有困难。KPop 还指出,低概率 token 的训推 log-ratio 波动更大,固定 ratio mask 可能不成比例地丢弃它们。
若 partial rollout 中途切换模型版本,分母不能只用一个统一 \mu;每个 token 都必须使用实际生成它时的 behavior probability \mu_t(y_t\mid s_t)。
相关缩写
- TIS:Truncated Importance Sampling,截断过大的 token ratio;
- MIS / IcePop:Masked Importance Sampling,区间外 token 直接丢弃;
- SC:Score Centering;
- GSPO:Group Sequence Policy Optimization;
- TOPR:Tapered Off-Policy REINFORCE;
- DPPO:Divergence Proximal Policy Optimization,以 binary TV/KL 近似整体策略差异。
4. Bellman Policy Optimization
4.1 Bellman 方程
价值函数定义:
按下一 token 分类并使用全期望公式:
而 action-value 的定义正是:
有
论文的中间奖励为零,转移确定为 s'=(s_t,y_t'),所以 Q^\pi(s_t,y_t')=V^\pi(s');终点 V^\pi(s_{|y|+1})=R(x,y)。
4.2 直接 PMD 是需要 critic
完成 rollout 只知道一次 R,不知道条件期望 V,Q。若从每个前缀采样估计:
长度 T、每个前缀 N 条 continuation 需约 TN 次额外 rollout;评估所有 action 接近 T|\mathcal V|N。
而训练 critic 又增加显存、计算与估计误差。
4.3 从 PMD 到 critic-free 轨迹目标
原始 advantage-based PMD 目标:
它的唯一最优解是:
其中配分函数为:Z^\mu(s_t)=\sum_{y_t'\in\mathcal V}\mu(y_t'\mid s_t)\exp\left(\eta A^\mu(s_t,y_t')\right)。取对数:
在 y_t\sim\mu 下取期望,然后利用
消掉配分函数,首先,
右边的 advantage 期望为零:
左边则等于负的 reverse KL:
因此:
再代回对数最优性条件:
移项得到逐 token 最优性条件:
Bellman 望远镜求和:
定义轨迹残差:
PMD 解使 \delta=0,所以构造最小二乘 critic-free 目标:
\phi(x)>0 是 prompt 权重,只改变优化强度。
这个 L(\pi) 理论式需要真实的 V^\mu(x),需要各位置 t 的反向 KL,需要估计对所有 rollout 的期望。论文对此做了一系列近似,得到用来实际训练的 BPO loss。
作者证明了其与 PMD 有相同唯一最优解,这里 4.4 补充一下证明的前置知识,具体证明就跳过了。
4.4 Token 残差与鞅
定义 d_\pi 为一个 token 的残差
轨迹残差是 token 残差之和:
对任意可行 \pi,\mathbb E_{y_t\sim\mu}[d_\pi]=0:第一部分因为 expected advantage 为零,第二部分因为 log-ratio 均值与 reverse KL 抵消。
令 M_n=\sum_{t=1}^nd_t,则
所以 M_n 是鞅(条件期望无漂移的公平游戏过程)。若最优解使终值 M_T=\delta=0 几乎必然成立,则
继而每个 d_n=M_n-M_{n-1}=0。这排除不同 token 残差正负抵消的伪解。
4.5 从理论式到实际 BPO loss
理论响应级 loss:
每 token 梯度:
作者依次近似:
1、 在 \pi=\mu 处线性化: \delta(\mu)/\eta=R_i-V^\mu(x).
2、 同一 prompt 的 group rollout 估计 V^\mu(x)\approx\operatorname{mean}(R),\qquad \phi(x)\approx1/\operatorname{std}(R),
得到 \hat A^i=(R_i-\operatorname{mean}R)/\operatorname{std}R。
3、 用 Binary KL 代替 full reverse KL。
4、 加平滑、mask、cap 与 stop-gradient。
Binary KL:
它只需当前 token 概率。它这个估计,是完整 KL 的下界。关键恒等式:
为防 \pi_y\to1 时分母过小,定义
最终 BPO loss 构造 token-level surrogate:
5. 两篇论文
5.1 完整形式下两者共享同一个 token 梯度
BPO 的作者进行过对比,认为完整形式下两者共享同一个 token 梯度。
固定 rollout policy \mu,令 trainer 为 \pi_\theta,score 换个符号,不用 s 了,换为
sampler 下均值
Reverse KL 的梯度
因此
BPO 的理论平方残差在 \pi=\mu 处线性化、并采用 group-normalized advantage 后,得到
Score Centering 则直接从 drift 分解出发,构造同一个梯度:
所以在以下条件下,两者 full-vocabulary token 梯度相同:
1、 使用同一个 rollout policy \mu;
2、 使用相同的 \hat A;
3、 精确计算 full-vocabulary reverse-KL / expected score;
4、 暂不加入各自的工程近似和 clipping。
梯度等价,原始理论目标不同:BPO 从 PMD 最优性条件与 Bellman 重构出发;Score Centering 从 off-policy drift 出发。
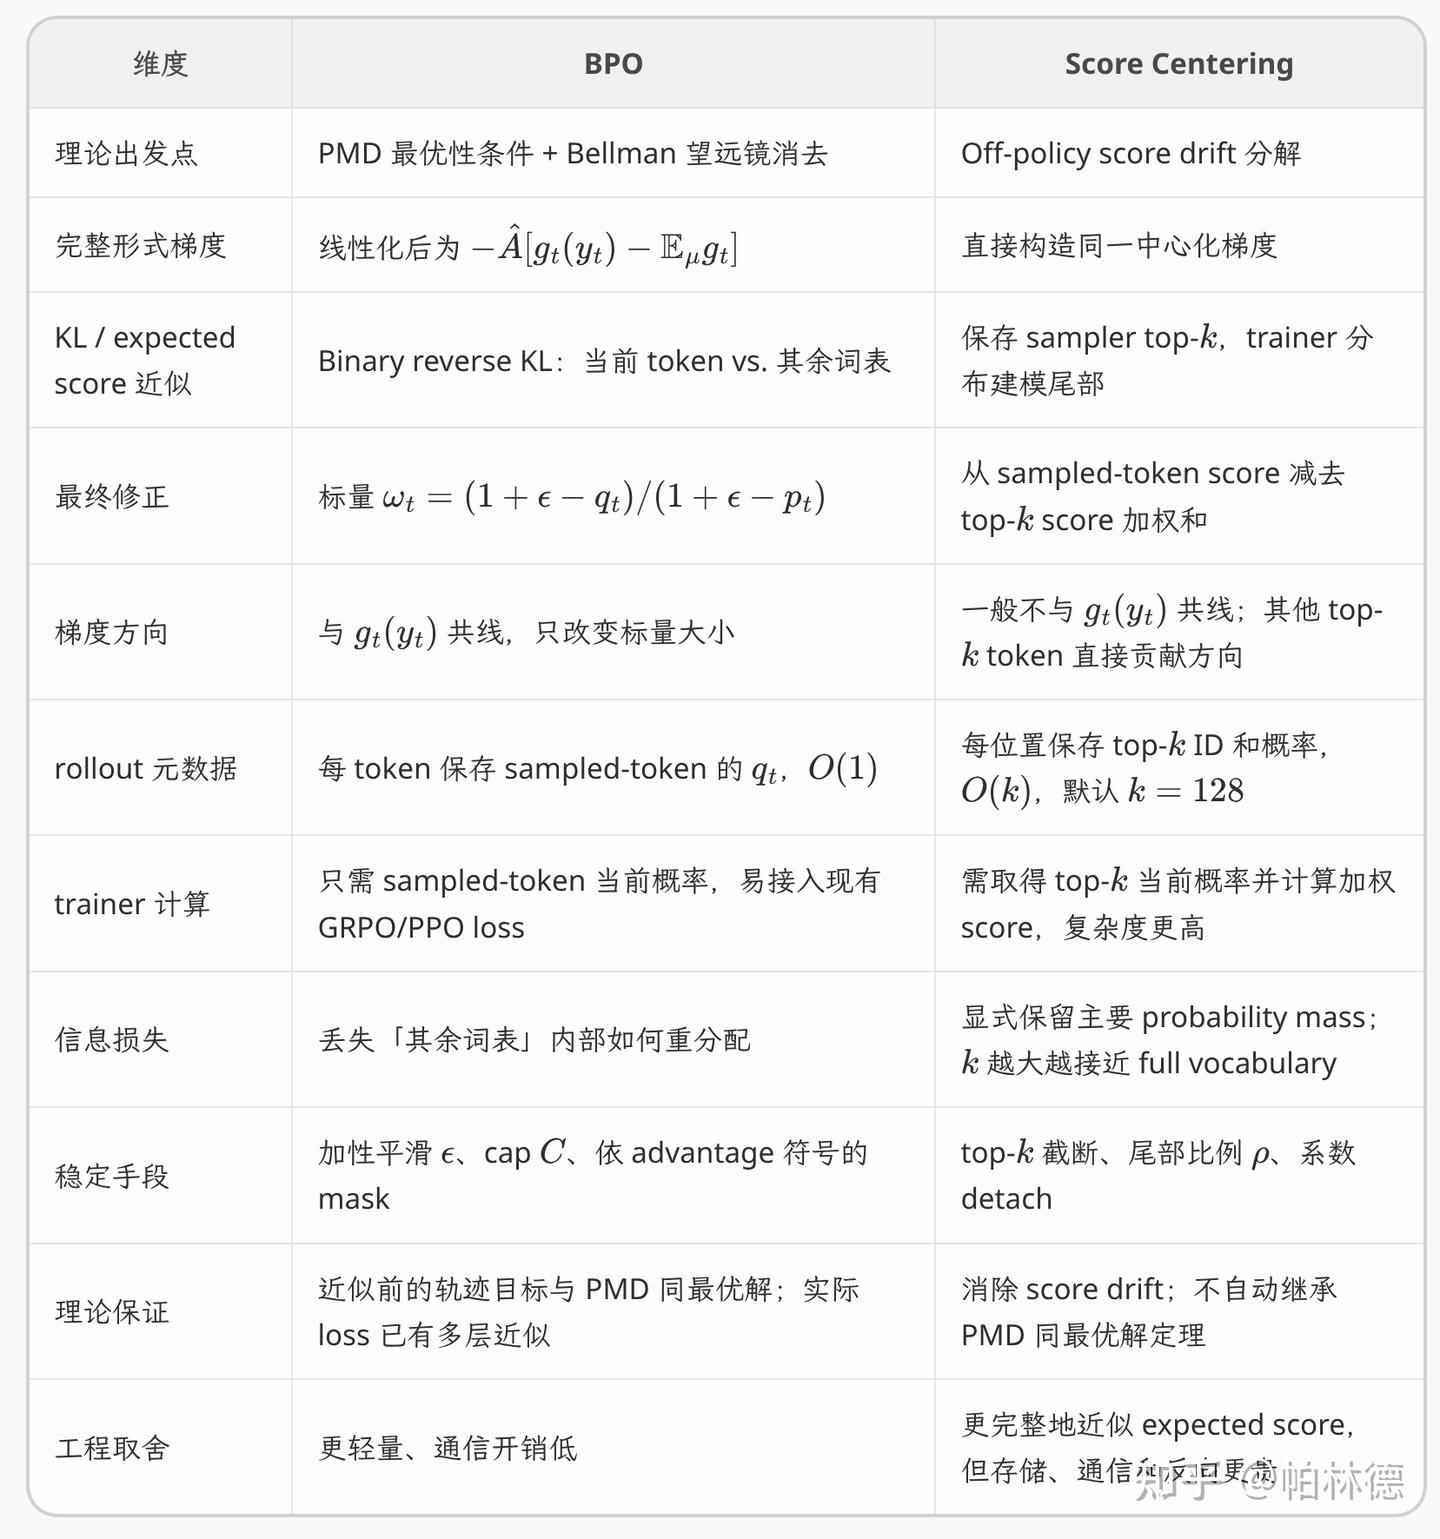
5.2 其他差异
参考 BPO 作者进行的对比
6. 其他
Score Centering 不是 Score-function control variate
经典 score function 为 s(a)=\nabla\log p(a),并满足 \mathbb E_p[s]=0。Reward baseline
利用 \mathbb E_p[bs]=0 降低方差而不改变期望,是 control variate 思想。Score Centering 在 TIM 下减去非零的 \mathbb E_q[s],刻意改变梯度均值以消除 drift,因此是 bias correction,不是经典 variance reduction。
Group centering 只是缩小 drift
它让同一 prompt 的 advantage 总和为零,却不保证每个前缀下的条件均值为零:
故前缀处 \mathbb E[A\mid y_{<t}]\bar s(y_{<t}) 仍然存在。
full Score Centering 与 on-policy 仍不同
它消除了 drift,但 signal 是
而理想 on-policy 是 \operatorname{Cov}_p(R,s)。区别在于 token 按谁的概率加权。
裁剪 IS 是漂移到哪个扭曲分布
裁剪 IS 后令 r_v=q_v\widetilde w_v。它是 token 在梯度中的有效权重,但 \sum_vr_v 未必为 1。归一化
后才是概率分布;\widehat r 决定更新方向,\sum r 决定整体强度。
作者:帕林德
原文:https://zhuanlan.zhihu.com/p/2085051180716237979