
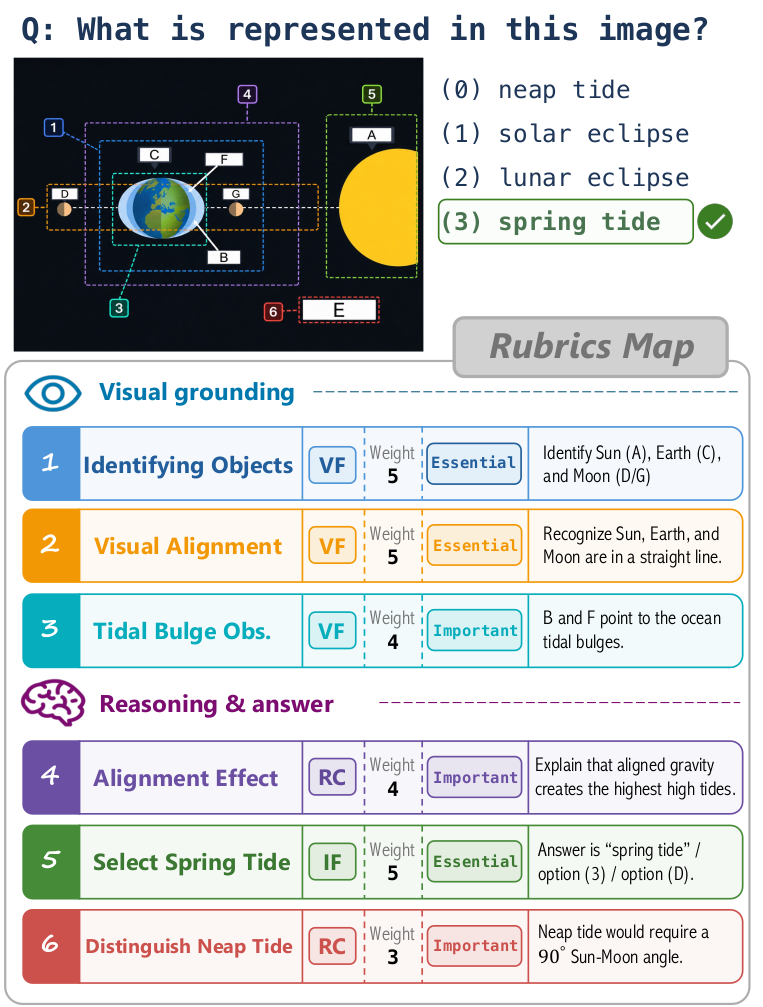
视觉语言模型能生成流畅的回答,却可能看错图表数值,或在推理中引入图像无法支持的结论。
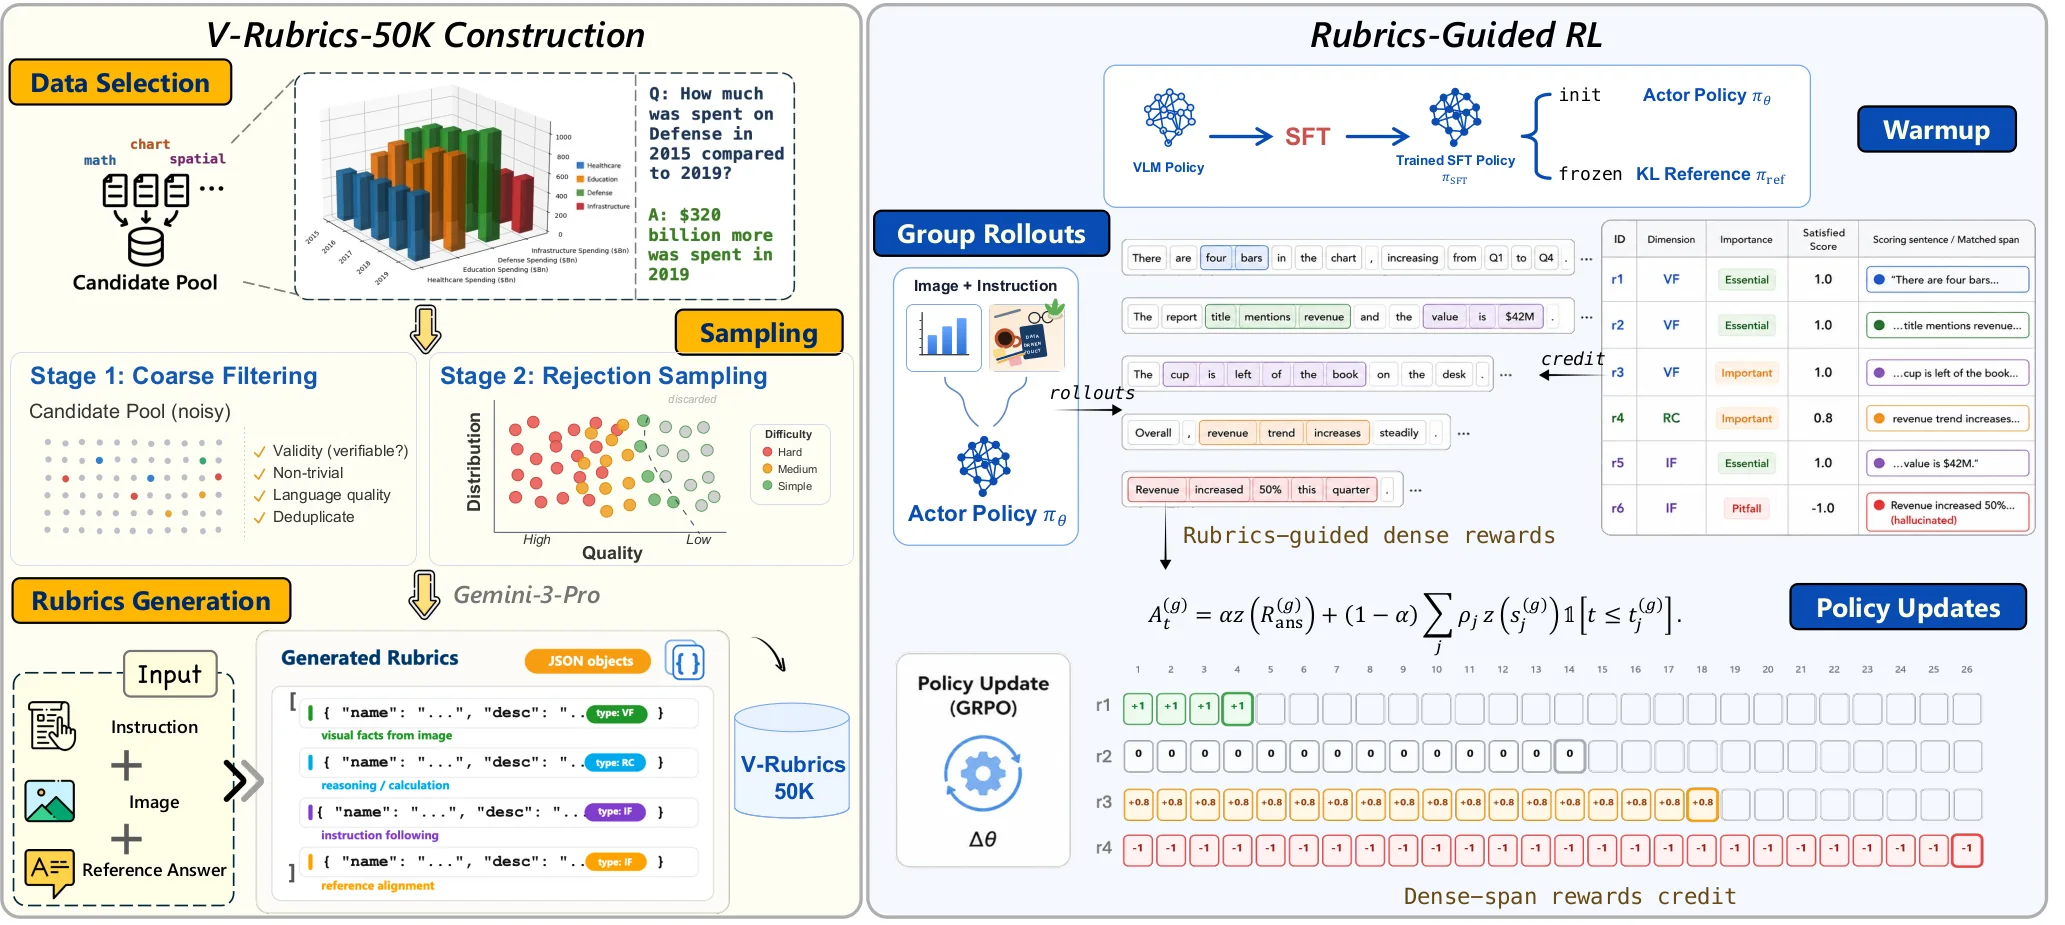
来自南洋理工大学 S-Lab、A*STAR 和 UIUC 的研究团队提出了 V-Rubrics,用逐项评分(rubrics)来处理“信用分配”(credit assignment)问题。
论文:V-Rubrics: Visual Faithfulness via Rubric-Based Reinforcement Learning
链接:https://arxiv.org/abs/2608.25580v1
代码:https://github.com/shulin16/v-rubrics
数据集:https://huggingface.co/datasets/v-rubrics/v-rubrics-50k
视觉事实、推理步骤和任务要求分别列为评判的准则,而这些单项的得分则会被用于后续的 GRPO 强化学习。该论文已被 EMNLP 2026 主会接收,代码与数据现已开源。
完整解读:答案正确,推理就一定可靠吗?V-Rubrics 用 35 万条细粒度准则细化多模态强化学习奖励
10月8日(周四)晚8点,青稞Talk 第157期,青稞社区邀请到南洋理工大学计算机科学博士生田淑琳,分享介绍 V-Rubrics,包括 V-Rubrics 50K 的数据构建、逐项奖励与前缀信用分配设计,并结合知识推理、视觉数学和图表理解的实验与案例,分析其相较答案级奖励的收益与局限,探讨如何让模型的推理更忠于视觉证据。
分享内容
V-Rubrics:如何让模型推理更忠于视觉证据?基于细粒度准则的多模态强化学习奖励
1、答对≠看对:多模态推理的盲区
2、V-Rubrics:用细粒度评分准则提升多模态推理的视觉忠实性
- V-Rubrics 50K 的数据构建
- 逐项奖励与前缀信用分配设计
3、对比答案级奖励的收益与局限
4、探讨多模态推理的未来
5、AMA(Ask Me Anything)环节
青稞介绍
田淑琳,南洋理工大学计算机科学博士生,导师为刘子纬教授和朱宏远博士。她的研究聚焦多模态智能体与视觉推理,尤其关注长时程多模态理解和工具增强推理。她曾获 A*STAR 计算与信息科学奖学金支持,并获评 CVPR 2026 及 ICLR 2025 SCOPE Workshop 杰出审稿人。
直播时间
10月8日(周四)20:00 - 21:00