在这里分享一下兜兜转转了大半年的工作,Diffusion Reward Models,拿 diffusion 来做 reward modeling。
TL;DR
人对同一个回答本来就可能有不同意见,Reward Model 为什么最后一定要压成一个分数?
1、 我们先看了下真实的人类标注,发现这种分歧其实还挺普遍的,而且很多不是简单的“有人打 3 分、有人打 4 分”,而是会出现明显的分组甚至两极化。
也就是说,同一个回答确实可能同时存在几种不同但都合理的评价。所以我们就想,与其把这些意见平均掉,不如直接让 RM 学一个 reward distribution。
2、 方法上我们把传统 RM 最后的 value head 换成了一个 Diffusion Transformer (DiT)。这样给定一个 prompt-response,模型不再只吐一个分数,而是可以采样出一整个 reward distribution。multi-attribute 和 pairwise preference 两种数据都可以统一处理。
比较有意思的是,我们发现:人类分歧越大,DRM 学出来的 reward distribution 也越容易出现多峰。也就是说,它不是单纯给分数加点随机性,而是真的学到了一些和 human disagreement 对应的结构。
3、 这个 distribution 也不只是拿来画图的,我们后面试了几种很直接的用法。
比如用不确定性找出 RM 自己都拿不准的样本,比如Best-of-N 的时候不只看均值,也看这个 reward 稳不稳,甚至还可以做一个新的 test-time scaling:回答不变,多 sample 几次 reward,判断也会继续变准。
最后我们也拿 DRM 去训了 RLHF,下游结果也有提升,所以这个 distributional reward 的收益不只是停留在 RM benchmark 上。
📝 Paper: https://huggingface.co/papers/2609.33803
💻 Code: https://github.com/thunlp/DRM
🤗 Model: https://huggingface.co/Teburile/DRM
来时路
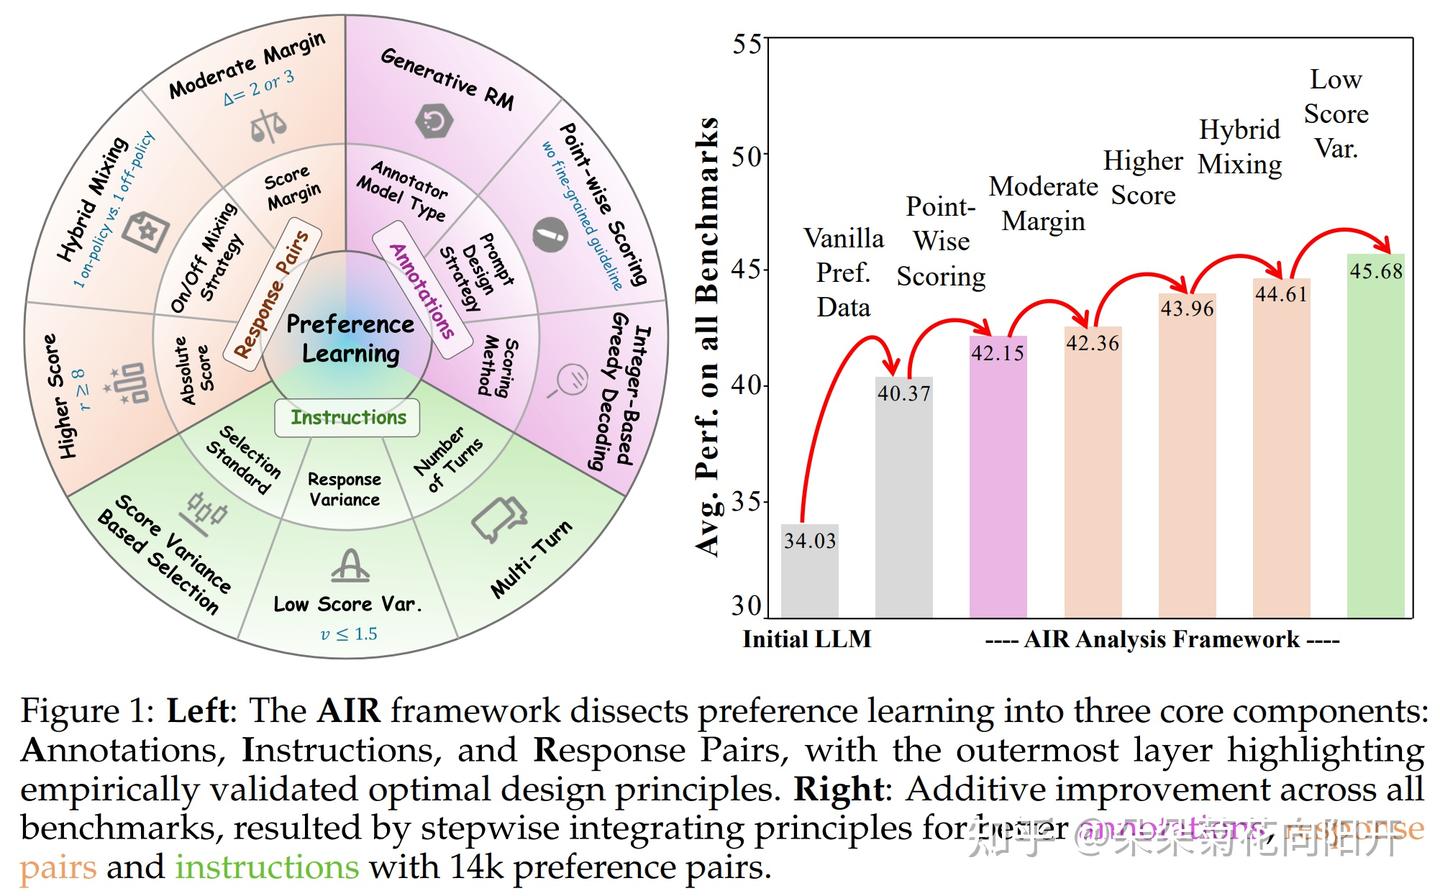
跟 RLHF 打交道其实比较早了,最开始做过一些偏好数据相关的工作,最早受组里 UltraFeedback 工作的启蒙,我们曾尝试研究如何构建高质量的偏好数据,比如从 Instruction, Response Pair 和 Annotation 三个角度分别 empirically 分析偏好对齐数据的质量,具体的结论可以参考 AIR: A Systematic Analysis of Annotations, Instructions, and Response Pairs in Preference Dataset:
后来,在 25 年 4 月份,当时我们想尝试探索更细粒度的 generative reward model 的 RLHF 方法,具体而言去为每一个 prompt,构造一个 fine-grained 的 checklist 来辅助判断 response 回答得好不好。
checklist 在离线的时候由 DeepSeek-R1 生成,然后我们拿过来做 RLHF,让 LLM 自己同时作为 policy model 和 reward model,RM 就是基于这个 checklist 给自己生成的每一条 response 打分,然后 pass rate 作为 reward,这样就是一个比较典型的 self-play RLHF,虽然 checklist 用的还是强模型生成的。
当时这个 setting 有一个很大的问题是 reward hacking,模型倾向于给自己打高分,这个是非常不利的。在这个上面我们希望不断优化这个 checklist 的质量,来希望缓解这个现象,但是没太成功。
对于这个我们甚至想过一个比较理想的情况,有没有可能,一个 LLM 同时作为 policy model, reward model 和 checklist generator 呢?
也就是 checklist 的生成也由自己来造,然后把 "基于 prompt 生成 response"、"基于 prompt 生成 checklist" 和 "基于 prompt 和 checklist,来给 response 打分" 这三个任务混起来训到一个模型里面去。
理想比较好,但是现实情况是我们没成功,效果并不好,这个方向便被暂时搁置了。这个 checklist 在后来有一个大家更广泛用的名字,叫做 rubric,以及基于 rubric 的生成式奖励建模成为了主流 RLHF 方案,怎么迭代更好的 rubric 便是一个比较关键的问题,甚至近期一部分关注 RSI 的工作,把 model 和 rubric 的 co-evolve 也玩到了一起。
早在去年年底,我们其实在考虑,除了基于 MLP as reward head 的 discriminative reward model 以及 generative reward model,还可能怎么做好 reward modeling?我们当时看到了一些比较有意思的工作,
- 比如 Shihan 的 Pre-trained policy discriminators are general reward models,将不同的 policy 直接区分开;
- 比如 ArmoRM,希望用一个输出多个 scalar 的 reward head 来建模 multi-objective rewards;
- 比如 Distributional Preference Learning,假设 reward 的分布可能是正态分布,因此只需要建模 mean 和 variance 即可;
- 再比如 Quantile Regression for Distributional Reward Models in RLHF,同样基于一个输出多个 scalar 的 reward head 来建模 reward distribution 的几个离散采样点,即不同分位数。
这里其实能看出,很早的时候大家就意识到,reward 不应该只是一个坍缩的 scalar,理论上一个 distribution,甚至一个 multi-objective 的 reward vector,会比一个 scalar 蕴含更丰富的信息。
因此这里可能可以分为这样两个问题:
(1)怎么做更好的奖励建模(reward modeling)?
(2)怎么更好地利用 reward?尤其是可能的 multi-objective reward vector 或者 distributional reward。
奖励分布,应该长什么样?
现在 LLM post-training 里,Reward Model 基本已经是一个绕不开的组件。在 RLHF 里,它定义 policy optimization 的方向;在 Best-of-N、rejection sampling 里,它负责告诉我们多个回答哪个更好;很多自动评测本质上也在依赖某种形式的 Reward Model 或 Judge。
但不管模型内部多复杂,大部分方法最后做的事情其实很简单:给定一个 prompt-response pair,输出一个数。 这背后隐含了一个很强的假设:对于一个固定的回答,存在一个相对稳定的“真实 reward”。
可人类偏好真的是这样吗?一个回答可能有人觉得 concise,有人觉得信息不足;有人更重视 correctness,有人更重视 harmlessness;甚至使用同一份 rubric,不同标注者也可能给出相互冲突的评价。如果最后全部求个平均数,那么 disagreement、uncertainty,甚至本来存在的多个评价模式,就一起被压没了。
已有一些 distributional RM 会预测 Gaussian 的 mean / variance,有些方法预测 categorical distribution,还有一些方法预测 fixed quantiles。
但它们又引出了第二个问题:为什么我们在看到数据之前,就要先规定 reward distribution 应该长成 Gaussian,或者应该由固定的一组 quantile 来描述?
特别是当真实的人类偏好可能本身就是多峰分布的时候,本身就可能限制模型能表达的东西。于是我们开始想:能不能干脆不规定 reward distribution 的形状,直接去学它?
在图像生成场景,diffusion 这一加噪去噪的过程比较适合建模一个多峰分布,那对于可能同样多峰的奖励分布,它能不能发挥作用呢?这也是 DRM 的起点。
Diffusion Reward Models 怎么做?
我们的做法其实不复杂。传统 Discriminative Reward Model 通常是:LLM Encoder → Value Head → 一个 scalar reward。
我们保留前面的 LLM Encoder,但是把最后的 value head 换成了一个轻量的 Diffusion Transformer (DiT)。
也就是说,给定 prompt 和 response,encoder 先把它编码成一个 semantic representation,这个 Diffusion Reward Head 再以这个 representation 为 condition,从 Gaussian noise 出发,通过 denoising 生成 reward sample。
多 sample 几次,就得到这个回答对应的一整个 empirical reward distribution。
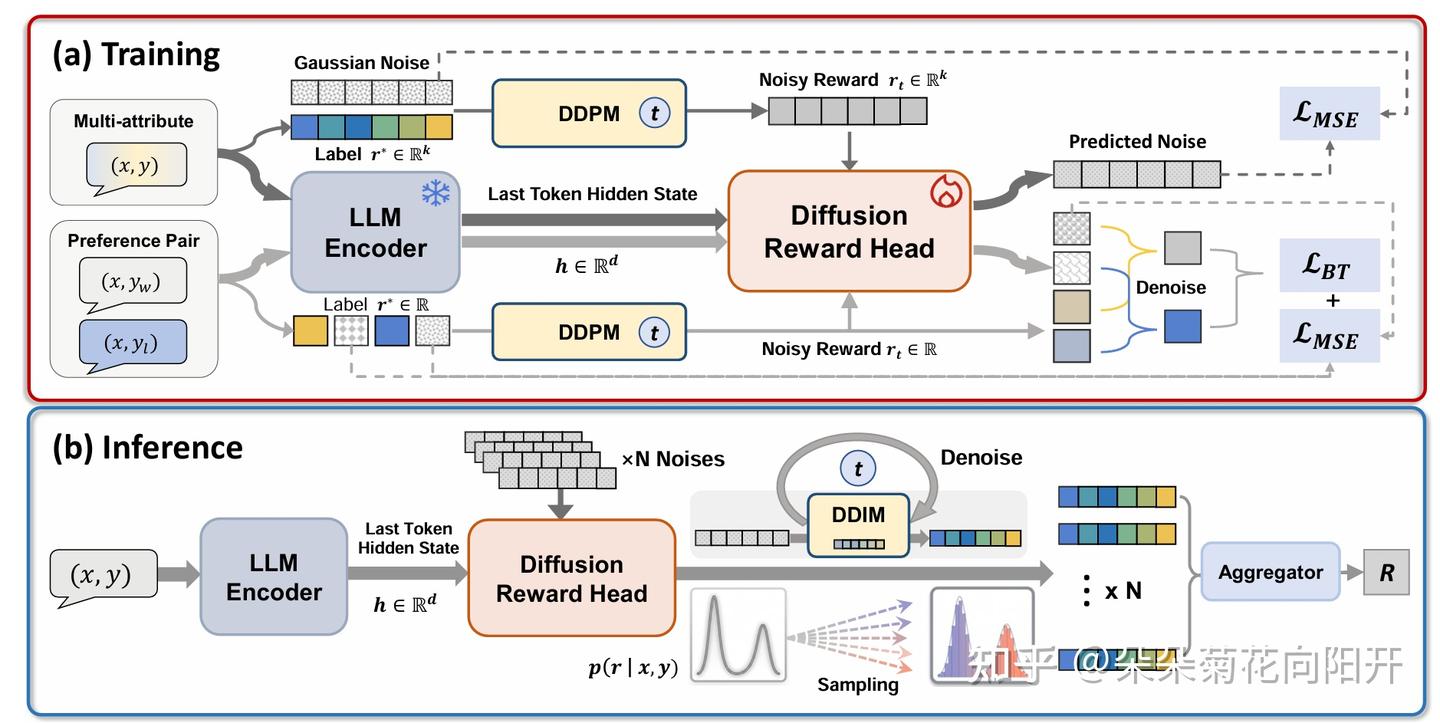
Diffusion Reward Model 训练和推理的流程示意图
我们真正需要的是一个比较灵活的 conditional density estimator:它不应该提前假设输出只能有一个峰,也不应该被限制成某个固定的参数化 family。Diffusion 似乎恰好很适合做这件事。
另一个我们比较在意的问题是:这个框架能不能同时覆盖现在两种常见的 reward supervision?所以我们做了两个版本:
- DRM-Multi-8B 用 multi-attribute reward 数据训练,一共统一到 19 个 reward dimensions
- DRM-Pref-8B 则直接用 chosen / rejected 的 pairwise preference 训练。
两个模型用的都是冻结的 encoder,只替换最后的 Reward Head。前者使用 569K multi-attribute samples,后者使用 273K preference pairs。对于 multi-attribute 数据,没有标注的维度用 mask 排除掉,不提供 supervision。
而对于 preference data,一个更麻烦的问题是:我们只有“谁赢谁输”,没有绝对 reward。 我们的处理方式是构造对称的 pseudo-reward,同时再加一个 Bradley-Terry style 的 ranking objective。
这样既保留 diffusion 的 denoising signal,也强制 preferred response 在 reward 上应该高于 rejected response。
从形式上来看,我们希望把两类 Reward Modeling 都重新表述成同一个问题: 给定 x,y,学习它的 conditional reward distribution。
换成 Diffusion Reward Head,本身有用吗?
主实验里我们做了一个可控对比。 DRM-Multi 使用 ArmoRM 的 training corpus,同时使用同一个 FsfairX-LLaMA3-RM-v0.1 encoder,encoder 直接 freeze。 也就是说,这组比较里我们尽量让数据和 backbone 不动,只换 Reward Head。 结果是:
- ArmoRM:平均 62.3
- QRM:平均 64.1
- DRM-Multi:平均 66.2
DRM-Pref 在完全不同的 pairwise preference supervision 下,也取得了 65.8。
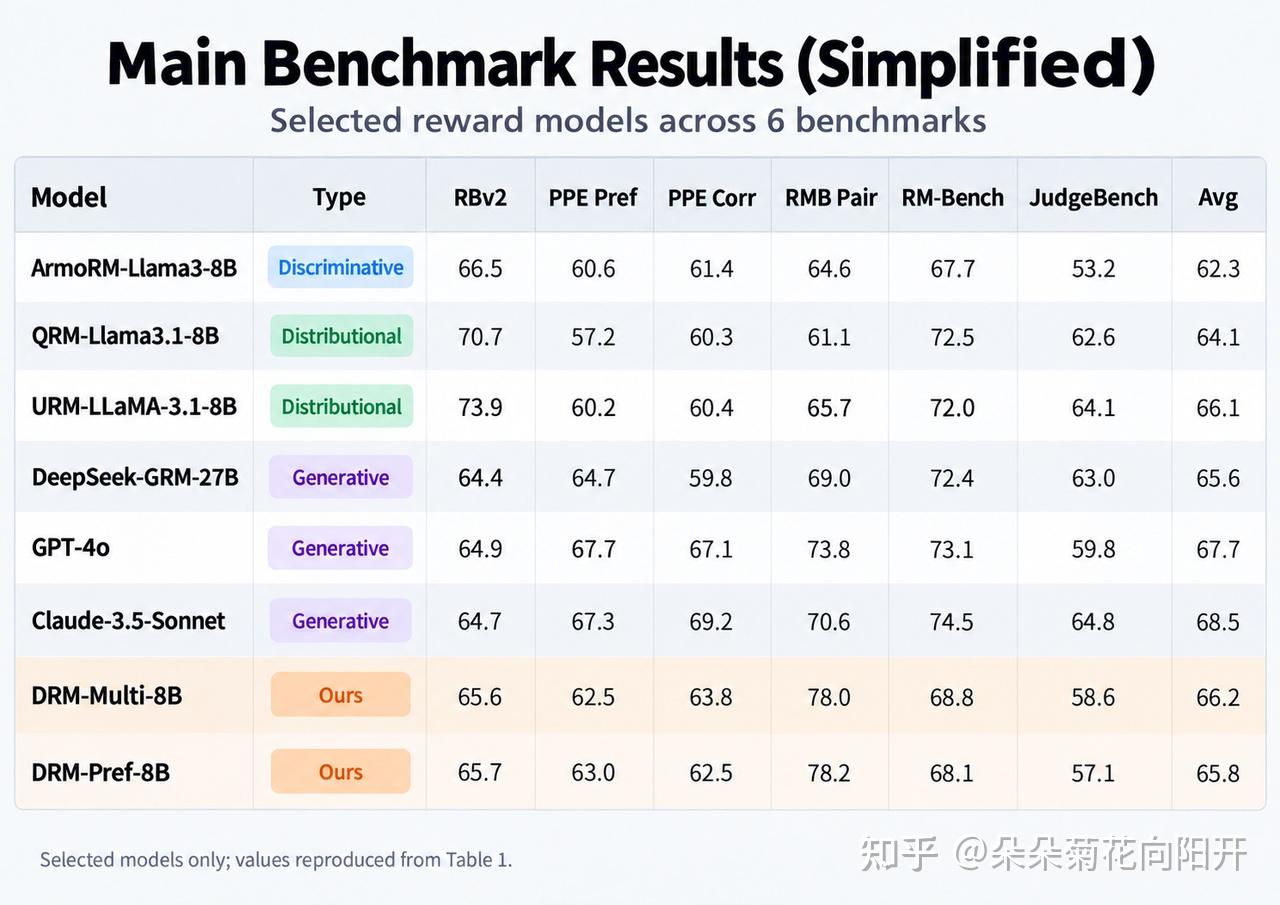
在 matched data + matched backbone 的 setting 下,reward head 本身确实带来了可观的差异。 同时 DRM 不预设 Gaussian 或 quantile family,在平均结果上仍然可以和现有的 parametric distributional RM 保持竞争力。
这个也只能和一些控制数据规模和 backbone 大小的情况能掰手腕,但是仍然打不过一些更前沿的 generative reward model,也只能算是一个初步结果。
到这里,其实只能说明:Diffusion 可以拿来做 Reward Model,而且效果还行。但这并不能证明它真的在学习“人类偏好的分布”,所以后面我们花了相当一部分实验专门验证这件事。
Human Preference 真的是多峰的吗?
如果真实的人类评分其实只是:3.0、3.1、2.9、3.2…… 围着某个“真实平均值”轻微波动,那么 Gaussian mean + variance 可能已经够用了。
所以在分析 DRM 之前,我们先把 DRM 放到一边,直接看数据。我们找了两个有重复人工标注的数据:
- HelpSteer2-Disagreements:同一个 response 有多人独立打分;
- MultiPref:同一个 response pair 有多人进行 preference judgment。
我们不只算 variance,而是专门看三个东西:rating range、separated clusters、polarization。 HelpSteer2 上,helpfulness 有 43.49% 的样本评分跨度至少为 2,28.20% 出现 separated clusters,24.34% 同时包含低分和高分。MultiPref 里,overall preference 有 45.64% 的样本出现方向相反的判断,37.23% 出现 separated clusters。
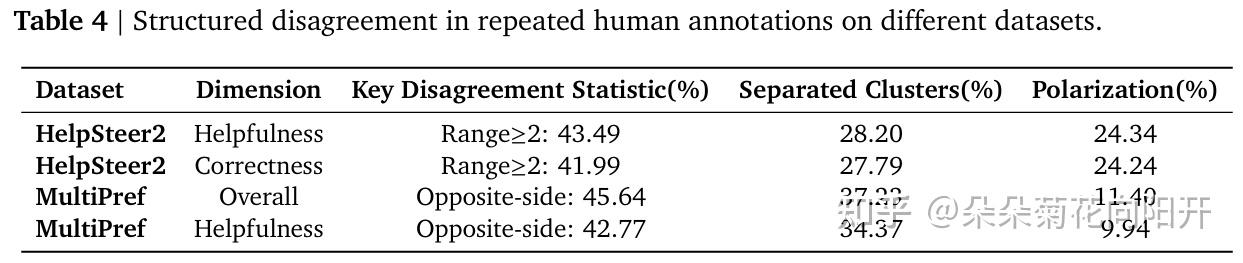
人类分歧似乎不是简单的 annotation noise。 很多时候并不是大家围着同一个答案抖一抖,而是真的能形成两个不同的评价簇,数据里面存在类似的结构。
DRM 学到的是 Human Disagreement,还是单纯学会了“随机”?
首先和真实的人类评分分布直接比,在 HelpSteer2-Disagreements 上,我们把 repeated human ratings 当成 empirical distribution,然后从 DRM 里 sample reward,再比较两边的 distribution distance。
我们用了 Wasserstein、Jensen-Shannon 和 L1 三个 metric,同时准备了几个很简单但重要的 baseline:
- 一个所有样本共享的 empirical prior;
- 一个 global Gaussian;
- 一个普通的 pointwise prediction。
如果 DRM 只是学到了“人一般有这么大方差”,那么它和 global prior / Gaussian 不应该有太大区别。
结果在 helpfulness 上,DRM 的 Wasserstein distance 是 0.804,而 empirical prior、global Gaussian、pointwise baseline 分别是 1.030、1.032、1.032;JS 和 L1 上 DRM 也取得最低距离。
换句话说,它学到的并不是一个全局统一的“噪声”,而是在根据当前这个 prompt-response 去改变 distribution。但我们觉得光做到这里还不够,于是有了后面一个我个人觉得更直观的实验。
如果我们的 hypothesis 是对的,那么应该有一个非常自然的 prediction:Human disagreement 越强,DRM 的 reward distribution 应该越容易出现多峰性。
这件事是可以直接测的。我们按照 repeated human ratings 的 disagreement 强度,把样本分成几组,然后统计 DRM 输出里有多少是多峰的。结果:
对于 helpfulness:37.6% → 55.5% → 63.2%, 分别对应低 disagreement、较强 disagreement 和 polarized samples。Correctness 上几乎是一样的趋势:37.6% → 54.7% → 62.0%。
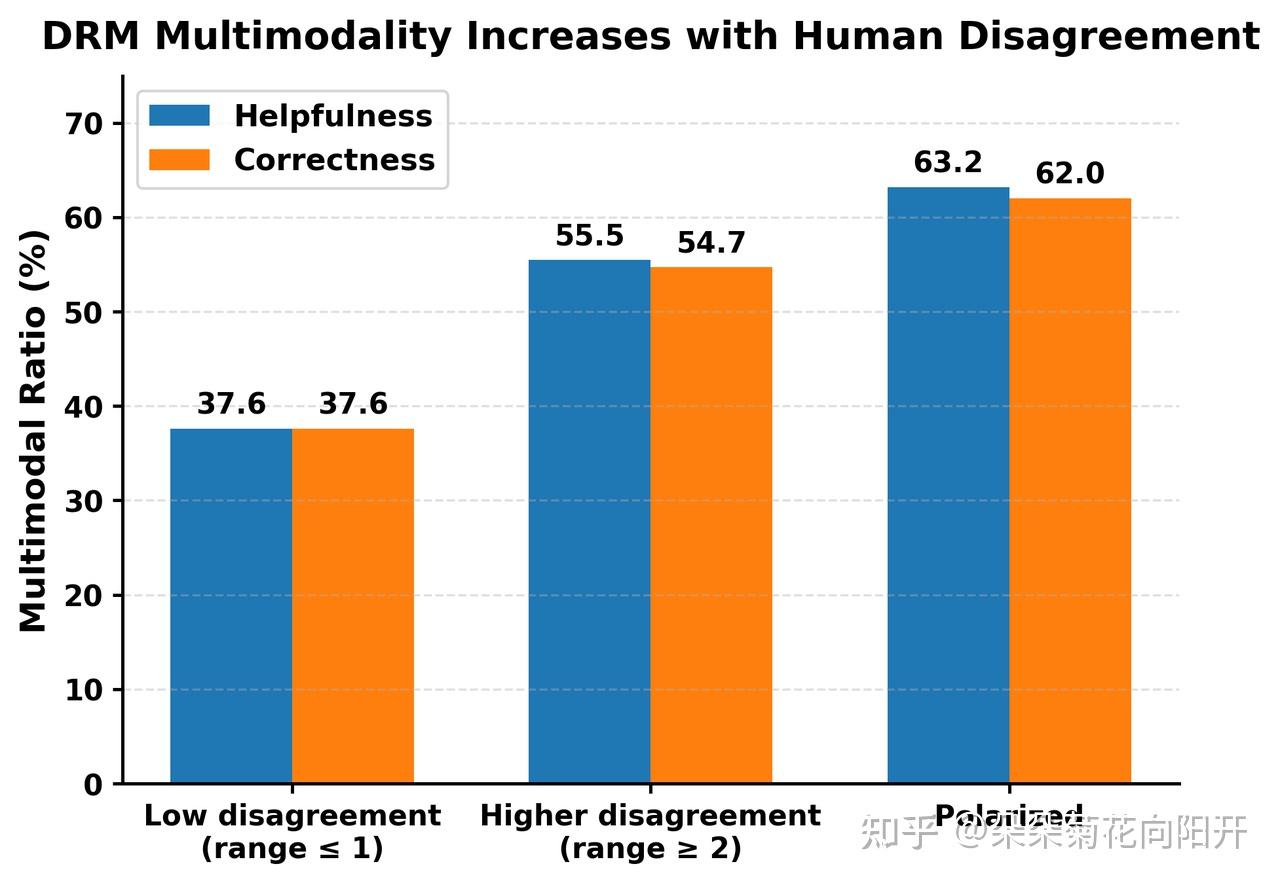
我觉得这张图其实比主 benchmark 更能代表这篇工作的核心。因为它回答的不是“Diffusion Reward Model 能不能再涨几个点”,而是:DRM 输出 distribution 的形状,会跟着人类 disagreement 的结构一起变化。
这也是我们认为 DRM 和“给 scalar reward 人为加一个 variance”最本质的区别之一。到这里,整个逻辑大概变成:人类标注中存在真实的 structured disagreement → DRM 学出来的 distribution 更接近这些 empirical distributions → 人类越 disagreement,DRM 越容易 multimodal。
但还有一个更现实的问题,如果最后拿去做 RLHF 的时候,还是把几十个 samples 一平均,变回一个 scalar,那前面这些 distributional information 不还是白学了吗?这个问题其实触及到我们最开始提到的第二个问题,怎么更好地利用 reward?
所以接下来我们想验证的是:mean 以外的信息,到底能不能真的被用起来。
Distribution 不只是画出来好看:它能告诉我们 RM 自己靠不靠谱
先考虑一个很常见的问题: Reward Model 说 A 比 B 好。 但这个判断到底有多稳? Scalar RM 没什么好办法回答,因为它只有: A = 0.73,B = 0.69,0.04 的差距到底意味着模型很确定,还是其实两个结果几乎不可区分,很难知道。
但如果手里是两个完整 distribution,情况就不同了。 我们可以直接看:“B 的 reward sample 超过 A 的概率是多少?”
如果两个分布严重 overlap,那么哪怕 A 的 mean 高一点,也说明这个 winner 并没有想象中那么稳。 于是我们做了一个很直接的 selective prediction 实验:把 RM 自己最没把握的 decision 一个个删掉。
如果这个 uncertainty 真有意义,那么删得越多,剩下样本的 accuracy 应该越高。结果确实如此,Coverage 从 100% 降到 70% 后:
- PPE Correctness 五个任务平均提高 2.81 个点;
- RMB 上四种 setting 提升 4.56 到 7.31 个点
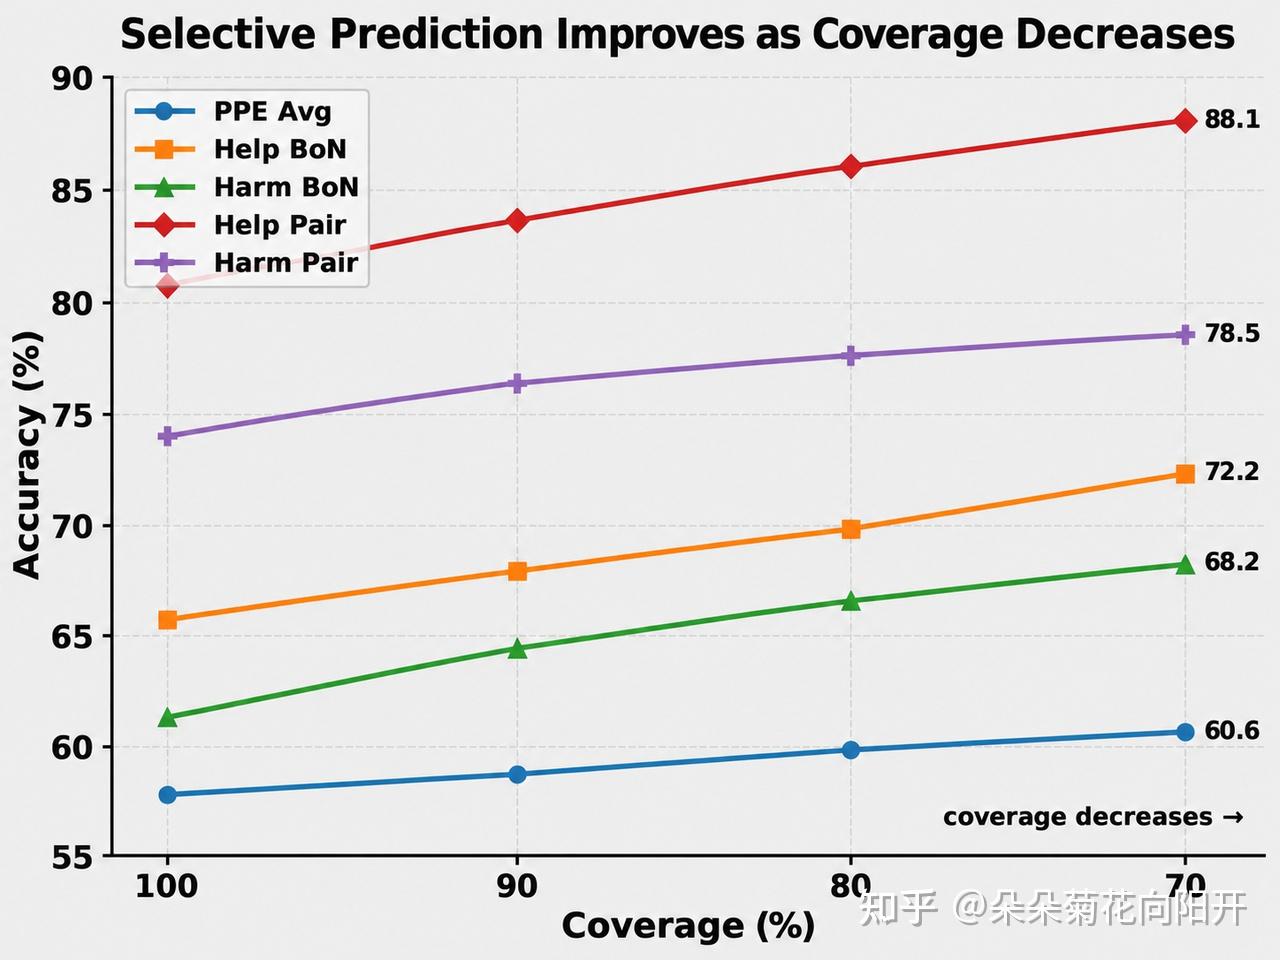
这其实说明了一件很简单但很重要的事:Diffusion Reward Model 所建模的奖励分布 里的 uncertainty,真的在告诉我们“这次判断可信不可信”。
不能拒答怎么办?那就别只看平均分
当然,selective prediction 有一个很明显的条件:你得允许模型说“这题我先不判”。但 Best-of-N 里很多时候是不行的。你生成了 N 个回答,最后无论如何都得挑一个。
于是我们设计了第二种 setting:100% coverage,但 ranking 时把 uncertainty 考虑进去。
这里用了一个非常简单的 Lower Confidence Bound:平均 reward 高当然是好事,但如果 reward distribution 本身特别散,就稍微扣一点分。没有什么复杂算法,本质上就是:既看它有多高,也看它有多稳。
结果在我们测试的 PPE 和 RMB Best-of-N setting 上,LCB 都稳定优于单纯使用 mean。例如 PPE 的候选数从 2、4、8、16 到 32,全部是 positive gain;RMB 的 Helpfulness 和 Harmlessness 也呈现一致趋势。
但我觉得这个实验重要的地方也不在“分数又涨了”。它真正证明的是:完整 distribution 里确实存在 mean 没有表达出来、但可以用于决策的信息。
Reward Model 也有自己的 Test-Time Scaling
这个工作里里还有一个我们觉得挺有意思的副产品。大家现在谈 test-time scaling,一般想到的是:给一个问题多生成几个 response,然后通过 Best-of-N / verifier 从里面选。
也就是说,计算量是花在 response axis 上的。但 DRM 其实天然给出了另一条轴,我们可以:response 一个都不多生成,固定 x 和 y,只从它的 reward distribution 多 sample 几次。
随着 sample 增加,我们对这个 reward distribution 的 estimate 会越来越稳定。在 RewardBench v2 上,DRM-Multi 从 N=1 的 56.5 → N=32 的 65.6,DRM-Pref 从 64.4 → 65.7。
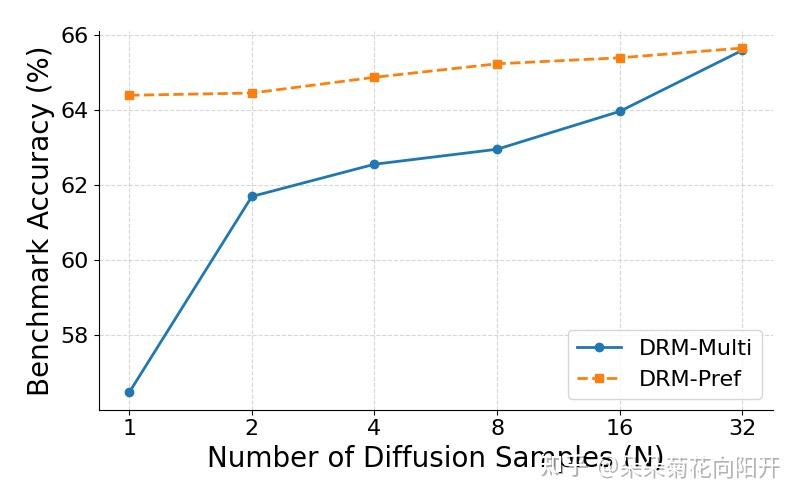
所以这里其实出现了两个正交的 scaling axes:**一个是多想几个答案;另一个是对同一个答案,多想一会儿“它到底值多少分”。**后者对于普通 deterministic scalar RM 是不存在的:forward 多少遍还是同一个 score。某种意义上,这是我们做这个工作之前也没有特别预期到的一个现象。
但是 Diffusion 不会很慢吗?
毕竟普通 Discriminative Reward Head 一次 forward 就结束了,Diffusion 要 iterative denoising。所以我们也专门测了 inference cost。默认设置是 10 个 DDIM steps、32 个 reward samples。
在 batch size=1 的 RewardBench v2 测试里,DRM 的 end-to-end latency 是 63.559 ms,大约是 FsfairX 的 1.63×;peak memory 只多了 0.048 GB。
有意思的是,真正影响 latency 的主要不是 sample 数,而是 DDIM steps。因为 reward samples 可以并行算,N 从 1 增加到 32,RewardDiT latency 只是从 21.197 ms 到 22.461 ms。
反过来,把 DDIM steps 从 10 降到 5,end-to-end latency 可以降到 53.755 ms,也就是 1.38× FsfairX;同时 DRM-Multi 的平均分只从 66.2 降到 65.9。
但是如果和 Generative Reward Model 的耗时相比,已经完全可以忽略了,毕竟生成式奖励模型才是真正的 Test Time Scaling,更何况最近还有大火的 Jev-as-a-Judge(狗头)
放在 RLHF 上遛一遛看看
RM benchmark 上的提升,到底能不能转化成 policy 的提升?所以最后我们直接跑了一组 RLHF。 这里把 setting 固定:
- 同一个 Tulu3-8B-SFT actor;
- 同一套 UltraFeedback prompts;
- 同一个 RLHF training setup; 然后只换 Reward Model。
结果从 FsfairX-RLHF 到 DRM-Multi-RLHF: Arena-Hard v2:1.3 → 2.0,MT-Bench:73.6 → 74.8。
这组实验对我们来说相当于整个故事的最后一块拼图。因为它说明 distributional reward 的作用,并没有停在:“这个模型更会做 RM benchmark。”而是能继续传递进 policy optimization。
当然目前这个结果还比较初步,没有在更 diverse 的 RLHF setting 上去验证,我们后面也会补充更多的实验。
最后
我们其实在探索的,是一种奖励建模的新范式。出发点是 scalar reward 天然信息量不够,但怎么更好地建模 reward distribution,怎么更好地利用 reward distribution 去做 policy optimization,都是尚未解决的问题,我们所做的就是在这上面提出一个想法:diffusion 加噪去噪的过程,是不是有可能能做这件事?
目前整体实验结果上,DRM 还打不过 Generative RM,但也许这个是值得思考探索的一条路。我们想让 reward modeling 少丢掉一点人类反馈里原本就存在的信息。 从这个角度看,Diffusion 只是一个实现手段。
真正想做的变化,是把 Reward Modeling 从:“这个回答值多少分?”往前推一步,变成:“对于这个回答,人们可能形成怎样的评价分布?”然后再进一步问:“这个分布能不能帮助我们做更好的选择?”
目前我们的答案是:至少从 repeated human annotation、uncertainty-aware decision making、test-time scaling 和最终的 RLHF 实验来看,这条路线是值得继续往下走的。
作者:朵朵菊花向阳开
https://zhuanlan.zhihu.com/p/2088694902305640688