世界动作模型(World Action Model)的想象很直接:视频模型已经学过物理世界的动态,那就让它先“想象”未来,再从想象里反推出动作。
问题在于,这个链条的第一环经常断。
在开放环境里,很多 WAM 的视频预测会跑偏:该抓的没抓,该放的放错位置。预测一旦错了,动作就跟着错。标准测试集上接近满分的策略,换一套扰动过的任务配置,或者把技能重新组合一下,成功率就掉下来。
来自星动纪元、清华大学、香港科技大学(广州)等机构的团队提出 VPP2:先把视频模型放到操作数据上继续预训练,再做固定时长预测与蒸馏,最后用 MoT 接上动作专家。14B 的模型在开放任务的指令遵循成功率上比 Cosmos3-64B 高 11 个点;真机 ALOHA 上零样本平均成功率 58.5%,对比 π0.5 的 40.0%、Fast-WAM 的 20.5%;LIBERO-Pro 45.0%(最强基线 11.0%)、LIBERO-OOD 63.9%、RoboDojo 32.26%。代码与模型都已开源。
世界动作模型的泛化性困境
WAM 的赌注是:视频预测够准,动作就能靠逆动力学推出来。
但现有 WAM 的泛化不好,原因有两个。
一是基座视频模型不是为操作优化的。它们为创作与美感训练,对精确的物理动态、对“把杯子放到左边还是右边”这类指令的遵循,都不够可靠。
二是动作组件塞进视频模型的方式有问题。把动作特定的模块或训练目标直接加到预训练好的视频模型上,会明显损伤它原有的泛化能力。
结果就是:在标准评测集上几乎满分的策略,遇到扰动、遇到没见过的技能组合,掉得很厉害。而这类任务,恰恰是真实机器人最常遇到的。

图:左边是人类手部操作,右边是机器人操作;红圈标出基线预测跑偏的位置,绿圈是 VPP2 的结果。来源:arXiv:2610.10270
从事件级视觉预测到指令遵循能力
VPP2 的第一步,是让视频模型学会“按指令想象”。
数据来自三类:机器人操作数据(单臂、双臂、移动与人类机器人,覆盖 20 多个本体)、人类手部活动数据、以及经过筛选的通用视频。每段视频切成 1–12 秒的语义片段,也就是一个完整的操作事件,然后配上细粒度描述:做什么、用哪个执行末端、目标物体是哪个、相机视角是什么。
训练也按“事件”来:每个样本覆盖一个完整子任务,让模型从初始观测一路预测到子任务完成。这比固定时长、只预测下一小段的训练更贴近“指令—轨迹”的对应关系,未来预测的不确定性也更小。

图:数据管线的几个关键动作:末端不可见的片段删掉、多视角拼成一张图、按模板生成带目标物体的描述。来源:arXiv:2610.10270
效果体现在指令遵循上。人类视频和机器人视频两组评测里,VPP2 的成功率是 0.80 和 0.90,Cosmos3-64B 是 0.70 和 0.78,平均高 11 个点。

图:八个需要空间理解的操作任务,同一句指令下三家模型的预测对比。来源:arXiv:2610.10270
迈向实时控制:固定时长预测与蒸馏
事件级预测解决了“想象得对不对”,但没解决“想得够不够快”。
机器人控制要的是固定时长的动作块,而且要快。VPP2 的后训练把视频模型改成预测固定时长的未来块,再用一致性蒸馏把它压成单步生成。
延迟账:bf16 + torch.compile 下,视频模型约 0.12 秒;动作专家以视频 latent 为条件,5 步去噪约 0.1 秒;一个动作块合计约 0.22 秒。

图:三个阶段的结构与注意力掩码。来源:arXiv:2610.10270
如何将动作模态引入视频生成基座模型?
很多 WAM 的做法是:把动作当成一种新模态,塞进视频模型一起训练。VPP2 没走这条路。
它用 mixture-of-transformers(MoT):视频 DiT 和动作 DiT 并列,共享一套注意力结构;动作专家以视频模型的 KV cache 为条件,学一个隐式的逆动力学模型。
好处是两件事分开了:视频模型保留原来的泛化性,动作专家只负责“从预测的未来里反推动作”。预测和动作各有各的参数,不用为了动作去动视频模型的预训练知识。
Steering Policy:System 1 / System 2 协同与性能提升
有了会预测、会出动作的 VPP2,还剩一层:长时程任务和模糊指令怎么办?
分工是:VLM 当 System 2,负责把开放指令拆成明确的子任务、增强 prompt、维护记忆;VPP2 当 System 1,把明确指令映射成轨迹。
在 RoboDojo 的五个任务组上,加了 VLM 子任务规划后,平均成功率 57.6%,不加是 27.6%;其中语言条件更强的积木堆叠从 10% 提到 52%,井字棋从 0% 提到 38%。
落到真机,ALOHA 平台十类零样本任务的平均成功率是 58.5%,π0.5 是 40.0%,Fast-WAM 是 20.5%。

图:十类零样本任务上,VPP2 与 π0.5、Fast-WAM-14B 的成功率对比。来源:arXiv:2610.10270
把这几段连起来看:事件级预测解决“想象得准”,蒸馏解决“想得快”,MoT 解决“从想象到动作”,VLM 规划解决“想得远”。这条链上的每一段,都是为了让机器人少在自己的想象里出错。
工作:Video Prediction Policy 2: Predict Better, Act Better
链接:https://arxiv.org/abs/2610.10270
项目页:https://robert-gyj.github.io/video-prediction-policy-2/
代码:https://github.com/roboterax/video-prediction-policy-2
模型:https://huggingface.co/Haodong082399/VPP2
团队:Yanjiang Guo、Haodong Yan、Zhide Zhong、Zhongru Zhang、Qingyuan Yang、Qingzhou Lu、Xiaoyu Chen、Yen-Jen Wang、Shuying Deng、Chenghan Yang、Puzhen Yuan、Chenxin Liu、Tun Ban、Xiang Zhu、Yichen Liu、Kun Feng、Haoang Li、Jianyu Chen
机构:星动纪元(Robotera)、清华大学、香港科技大学(广州)、加州大学伯克利分校、上海交通大学
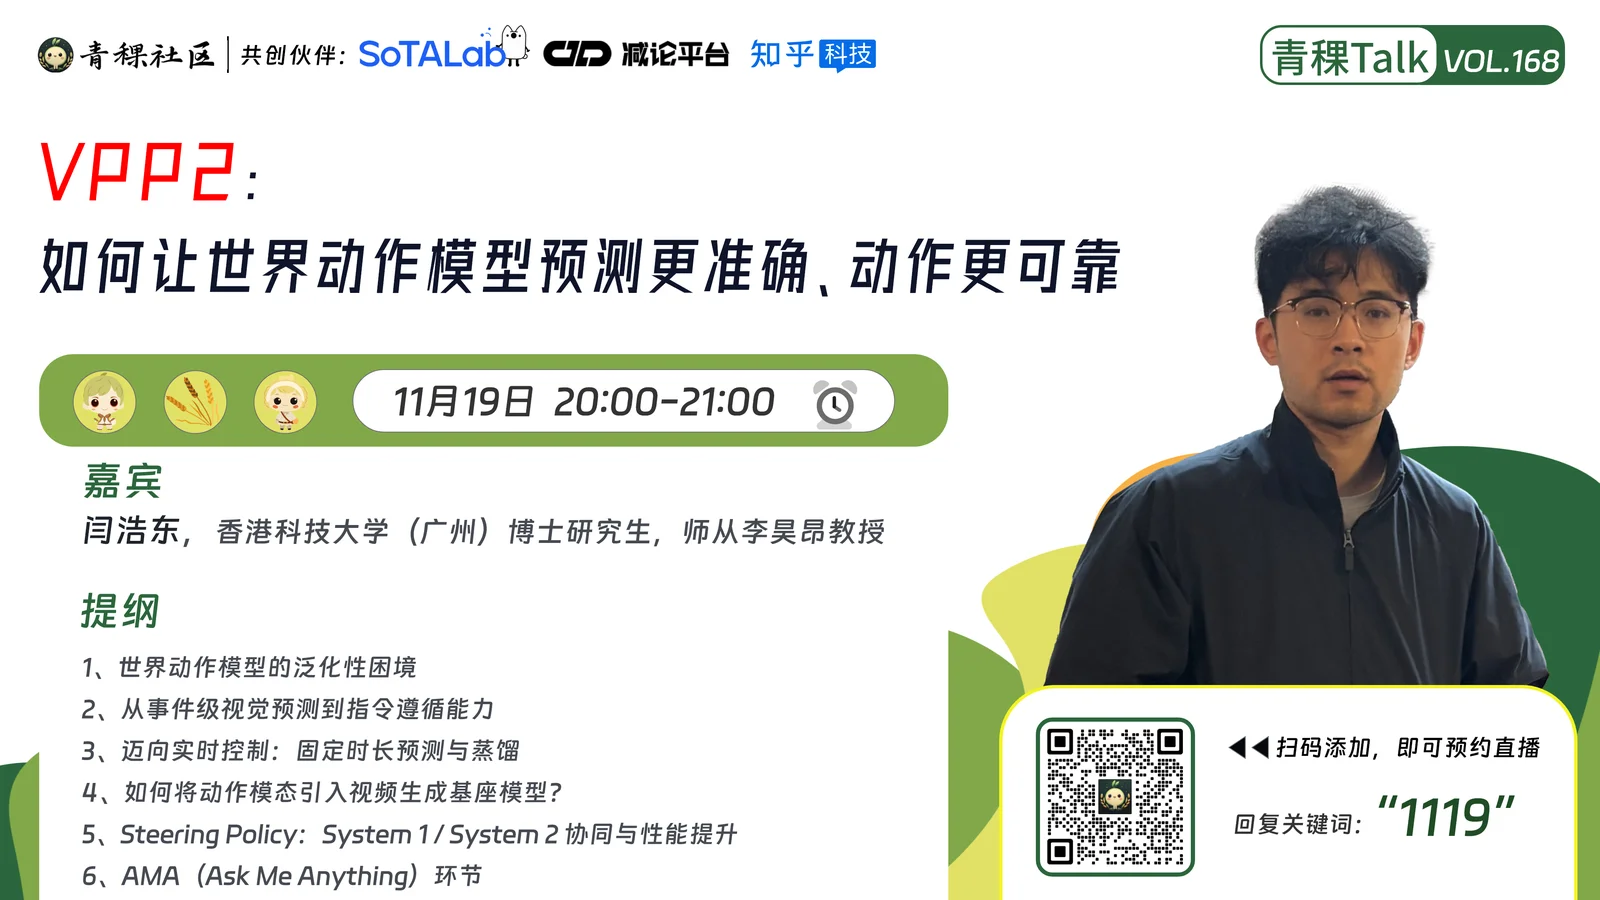
11月19日(周四)晚8点,青稞Talk 第168期,青稞社区邀请到 VPP2 共同一作、香港科技大学(广州)博士生闫浩东,直播分享 VPP2。
分享内容
VPP2:如何让世界动作模型预测更准确、动作更可靠
1、世界动作模型的泛化性困境
2、从事件级视觉预测到指令遵循能力
3、迈向实时控制:固定时长预测与蒸馏
4、如何将动作模态引入视频生成基座模型?
5、Steering Policy:System 1 / System 2 协同与性能提升
6、AMA(Ask Me Anything)环节
嘉宾介绍
闫浩东,香港科技大学(广州)博士研究生,师从李昊昂教授(IRPN Lab),由陈映聪教授共同指导;星动纪元世界模型团队核心成员。研究方向为具身智能基础模型,关注 World-Action Model、World Model 与视频生成方向。相关研究成果发表于 CVPR、ECCV 等国际计算机视觉领域顶级学术会议,代表工作有 VPP2、S-VAM、PSG-JEPA、FlowVLA 等。个人主页:https://haodong-yan.github.io/
直播时间
11月19日(周四)20:00 - 21:00
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册