引言
“从抽屉里取出杯子,放到桌上”,人一听就懂,机器人却要拆成好几步:打开抽屉、拿起杯子、把杯子放到桌上。每一步做什么、操作哪个物体、从第几帧开始、到第几帧结束,这些信息才是机器人真正需要学的“分步教程”。
现实是,机器人数据越攒越多,这份教程却几乎没人写。绝大多数数据只有一句任务级指令;少数带子任务标注的数据集,又各用各的技能词表、描述格式和切分规则,有的甚至把好几轮抓取、放置积木合成一个片段。数据凑不到一起,模型也就没法联合训练、统一评测。
自己补标注?难度不小。人工逐条精修,每小时视频约 100 美元;交给通用视频大模型,GPT-5.6-sol 在原子动作标注上的 Skill 只有 21.4,抓取、释放这类转瞬即逝的物理事件,它基本抓不准。
为此,上海人工智能实验室联合清华大学、浙江大学、复旦大学、上海交通大学推出 RoboAtom,为多来源机器人轨迹补上了统一、时间对齐的原子动作标注
项目:https://internrobotics.github.io/RoboAtom/
代码:https://github.com/InternRobotics/RoboAtom
数据:https://huggingface.co/datasets/InternRobotics/RoboAtom
模型:(https://huggingface.co/InternRobotics/RoboAtom
145 万条轨迹:规模是此前最大同类数据集的 6 倍
先定规矩,再上规模。
RoboAtom 给每个动作片段定了三个字段:技能类别、动作描述、起止帧。比如“拿起杯子”,技能类别是 Pick,描述里保留操作对象,起止帧标出这次抓取在轨迹中的位置。全部数据共用 29 类技能,不同来源的轨迹终于可以放在一起训练。
切分也有统一规则:只有主导技能变了,才开一个新片段;伸手、调整手臂姿态这类准备和过渡动作,并入相邻片段,不把一次操作切得七零八碎。
规矩定好,接下来是规模。逐条人工精修太贵,团队的做法是:先由模型生成候选标注,标注员对照原始视频修正技能、描述和边界,得到高质量的参考轨迹;再用 规则扩展把这些参考标注传播到同一任务的大量重复执行上。
难点在于,同一任务每次执行的速度、停顿、重试都不一样,参考轨迹的时间戳不能直接照搬。规则扩展的思路是“让机器人自己说话”:夹爪一开一合,对应抓取和放置的切换;底盘一动一停,对应移动阶段的起止。它把这些物理线索和参考轨迹的运动进度结合起来,在保持动作顺序的前提下,用动态规划一次性求出所有片段的边界。
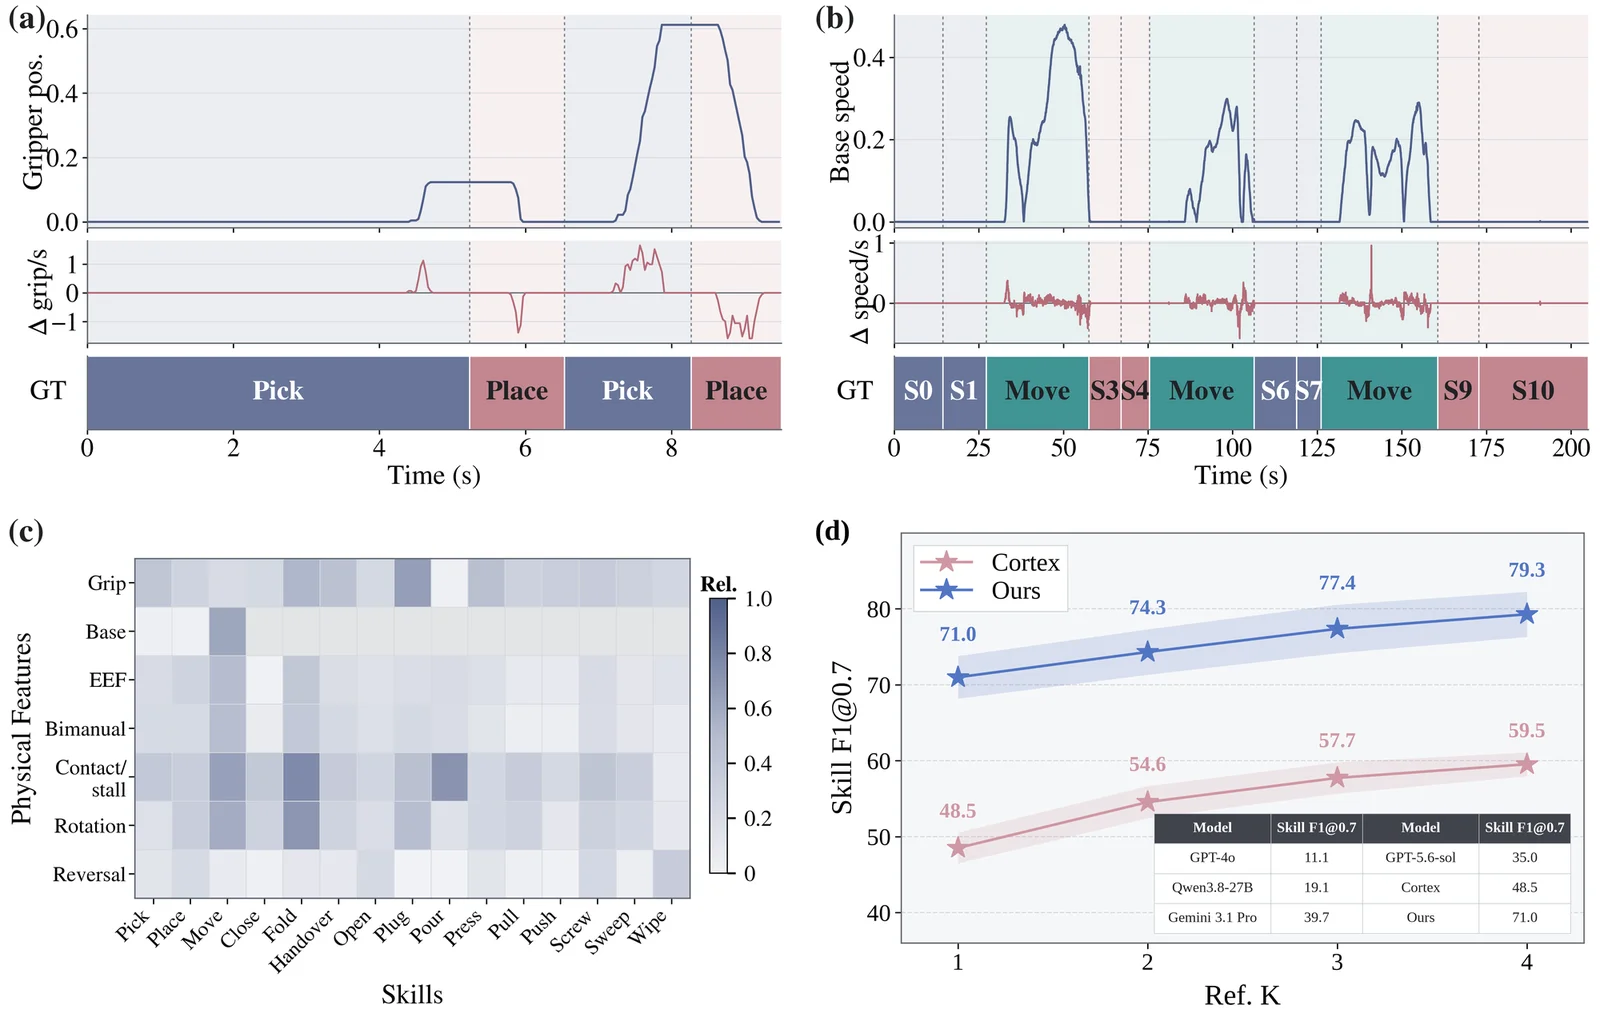
在 100 个任务、每任务 5 条人工标注轨迹的传播实验中:
- 精度翻倍:只给 1 条参考轨迹,PhysExtend 的 Skill 就达到 71.0,同类方法 Cortex 为 48.5,GPT-5.6-sol 为 35.0;给到 4 条参考,进一步升到 79.3。
- 整条轨迹也靠谱:按最严格的人工评判,一条轨迹里所有动作的语义和边界都对才算对。PhysExtend 的整条正确率为 69%,GPT-5.6-sol 为 46%,Cortex 为 37%。
- 几乎零成本:不调用任何大模型,单个 CPU 每小时处理 15,952 条轨迹,吞吐是 Cortex 的 17.1 倍。每小时视频的计算成本约 0.000028 美元,约为 GPT-5.6-sol 的十二万分之一,不到人工精修的百万分之一。
传播之后还有多轮质检:按数据源和本体抽样复查,排除执行步骤不一致的任务,并由模型与人工逐级复核动作描述,确保换了物体、换了颜色的轨迹,描述也跟着对上。
最终,RoboAtom-Data 收录 1,446,974 条轨迹、6,876,282 个动作片段、16,882.1 小时,其中真机约 9,375 小时、仿真约 7,508 小时,覆盖 16 个数据源、3,334 个任务和 32 种机器人本体。与此前最大的同类数据集相比,轨迹数约为 6 倍,片段数约为 6.9 倍,时长约为 5.7 倍,任务数约为 14 倍。
RoboAtom-Bench:GPT 能说对动作,却找不准边界
训练用的标注,不光要说对“做了什么”,还要卡准“什么时候做”。
一段拿取、放置的视频,模型可能动作名称全说对了,却把连续几步合成一段,或者把一次抓取拆成好几个动作。只检查“有没有提到正确的动作”,这些错误根本看不出来。
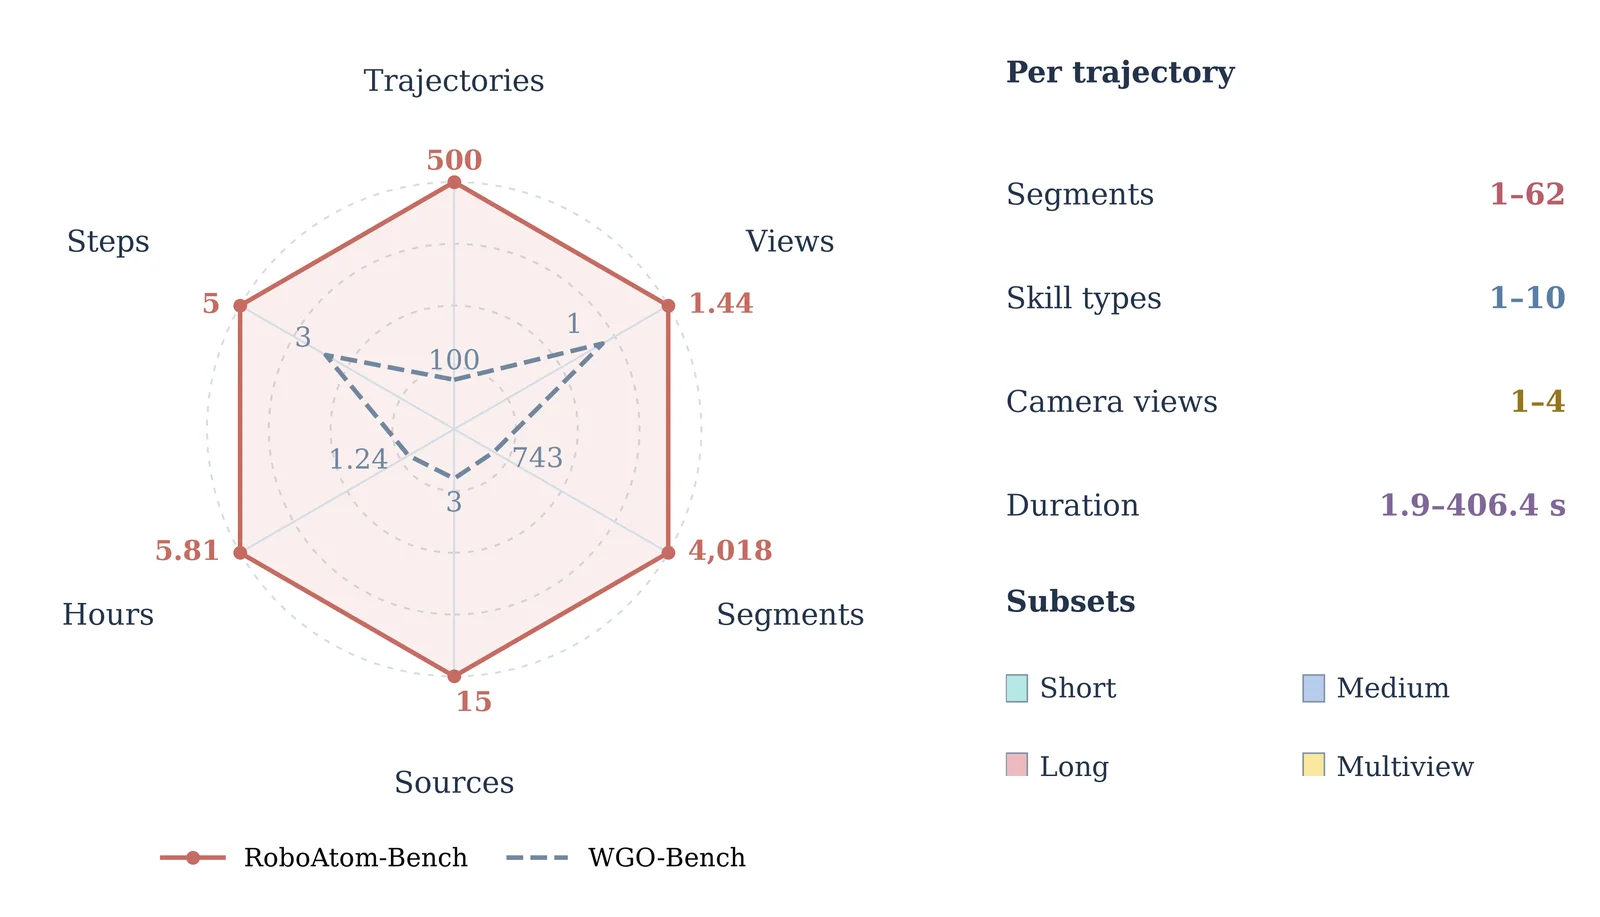
RoboAtom-Bench 就是为揪出这些错误而设计的。它包含 500 条专家复核轨迹、4,018 个动作片段,采用 15 类统一技能,按短、中、长序列和多视角分成四个子集。长序列每条包含 9 到 62 个动作,平均时长 99 秒。相比之下,WGO-Bench Robot 每条轨迹的动作数中位数为 2,RoboAtom-Bench 为 5。
指标同样多维:时间 mIoU 和时间 F1 看边界对不对齐,Skill F1 要求技能类别和时间区间同时正确,Edit 看动作序列有没有漏步、多步或乱序。
一测就暴露了通用大模型的短板。最强的 GPT-5.6-sol,Edit 能拿到 63.4,动作顺序大体能认出来;但时间只有 28.0,边界基本卡不准。切分粒度也很不稳定:四个参考模型在短序列上预测的片段数是真值的 1.48 到 1.70 倍,明显切多了;到了长序列,又只有真值的 0.51 到 0.65 倍,把好几步合成了一步。
9B 小模型全面超越 GPT-5.6-sol,成本只有 1/700
有了大规模高质量标注,团队训练了专用标注模型 RoboAtom-Anno-9B。它以 Qwen3.5-9B 为基座,分三步训练:先用夹爪状态问答、物体定位、空间推理和动作规划等约 284 万条样本做机器人领域中训练;再用 RoboAtom-Data 的原子动作标注做监督微调;最后用 GRPO 强化学习,同时优化时间边界、技能序列和输出格式。
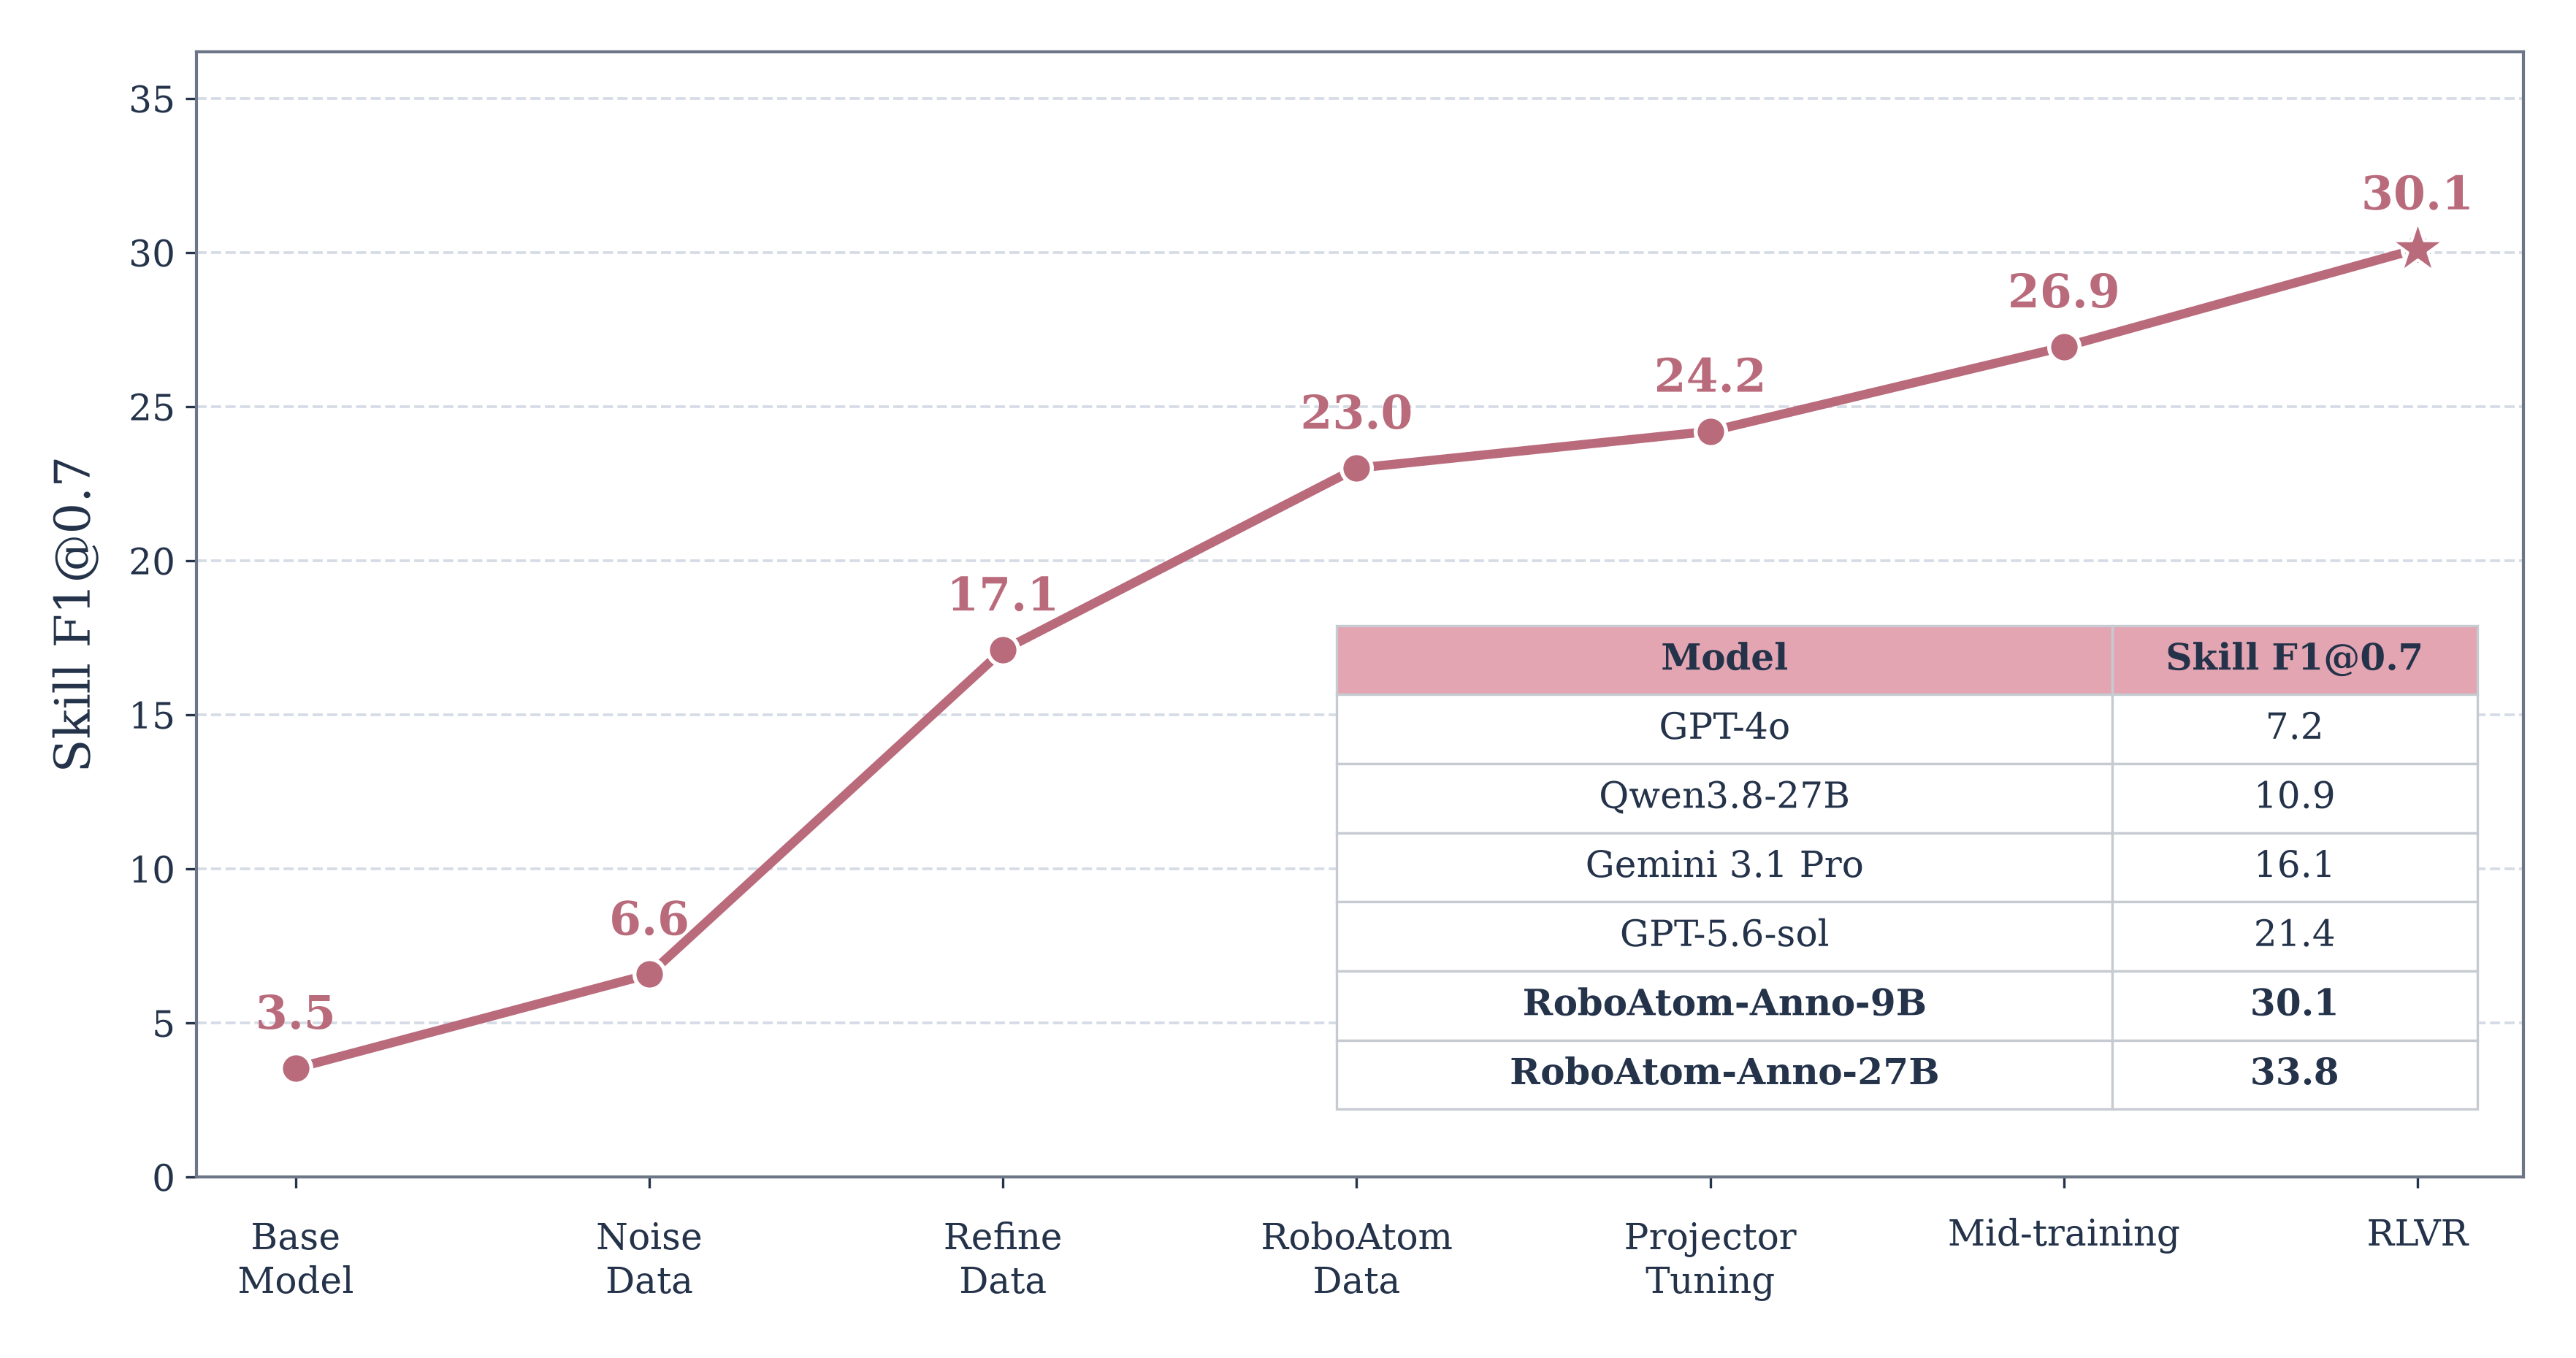
- 数据就是战斗力:基座模型的 Skill 只有 3.5,用开源数据原有的杂乱标注微调后也才 6.6;换成 RoboAtom 标注并完成全部训练后达到 30.1,约为基座的 9 倍。
- 全面超越 GPT:在 RoboAtom-Bench 上,9B 模型的 Skill 比 GPT-5.6-sol 高 8.7 分;mIoU、时间 F1、Edit 等所有质量指标都超过 GPT-5.6-sol、Gemini 3.1 Pro、GPT-4o 和 Qwen3.8-27B。
- 成本低到离谱:每小时视频推理成本仅 0.006 美元,GPT-5.6-sol 要 4.33 美元,相差约 700 倍。精度最高的同时,成本也是所有模型里最低的。
- 切得刚刚好:经过强化学习,预测片段数与真值之比从 1.20 降到 0.99,几乎不多切、也不漏切。
- 换个考场照样领先:在外部基准 WGO-Bench Robot 上,时间达到 48.3,比最强参考模型的 31.3 高 17.0 分。
团队还用同样的方案,以 Qwen3.8-27B 为基座训练了 RoboAtom-Anno-27B,在 RoboAtom-Bench 上把 Skill 推到 33.8,比 GPT-5.6-sol 的 21.4 高 12.4 分,相对提升接近 60%;成本为每小时 0.078 美元,约为 GPT-5.6-sol 的 1/55。在 WGO-Bench Robot 上,时间达到 49.2。
更惊喜的是,这套用机器人数据训练的模型还能迁移到人类第一视角操作视频:在 WGO-Bench Ego 上,27B 模型的时间 达到 28.3,是最强参考模型 14.1 的 2 倍。
原子动作监督,让机器人更会干活
分步标注不只能拿来“看懂”视频,还能直接教机器人“动手”。
团队用 RoboAtom-Data 中时间对齐的原子动作标注,给每个观测和动作附上所在片段的技能类别与描述,和任务指令一起输入 π0.5 微调,得到双系统中的 System 1 执行策略。策略不再只知道最终目标,还清楚当前这一步该干什么。
部署时,System 2 结合任务计划、当前画面和执行历史,选出下一步指令;System 1 执行后把新画面反馈给 System 2,由它判断继续当前步骤还是切换到下一个动作。
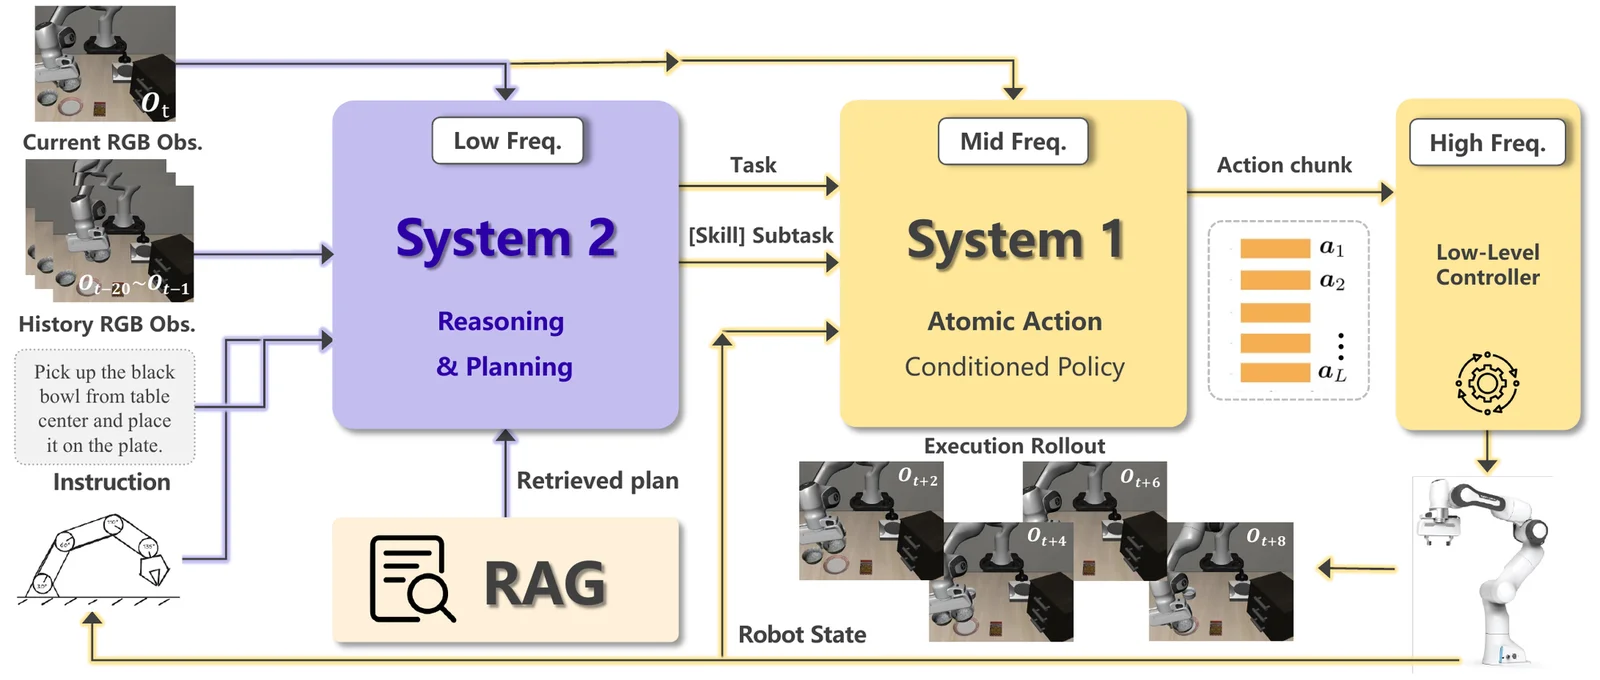
在相同后训练预算、观测空间和动作空间下,与只用任务级指令训练的 π0.5 相比:
- LIBERO-Long:长程任务成功率从 95.00% 提升到 98.20%,接近满分。
- LIBERO-Plus:覆盖 10,030 个扰动任务,整体成功率提升 4.13 个百分点;其中物体变化(Object)提升 6.63 个点,目标变化(Goal)提升 6.41 个点,面对变化的物体和目标更稳。
- RoboTwin:双臂操作在 Clean 和 Random 条件下都有提升,随机场景提升 2.28 个点,平均成功率达到 66.17%。
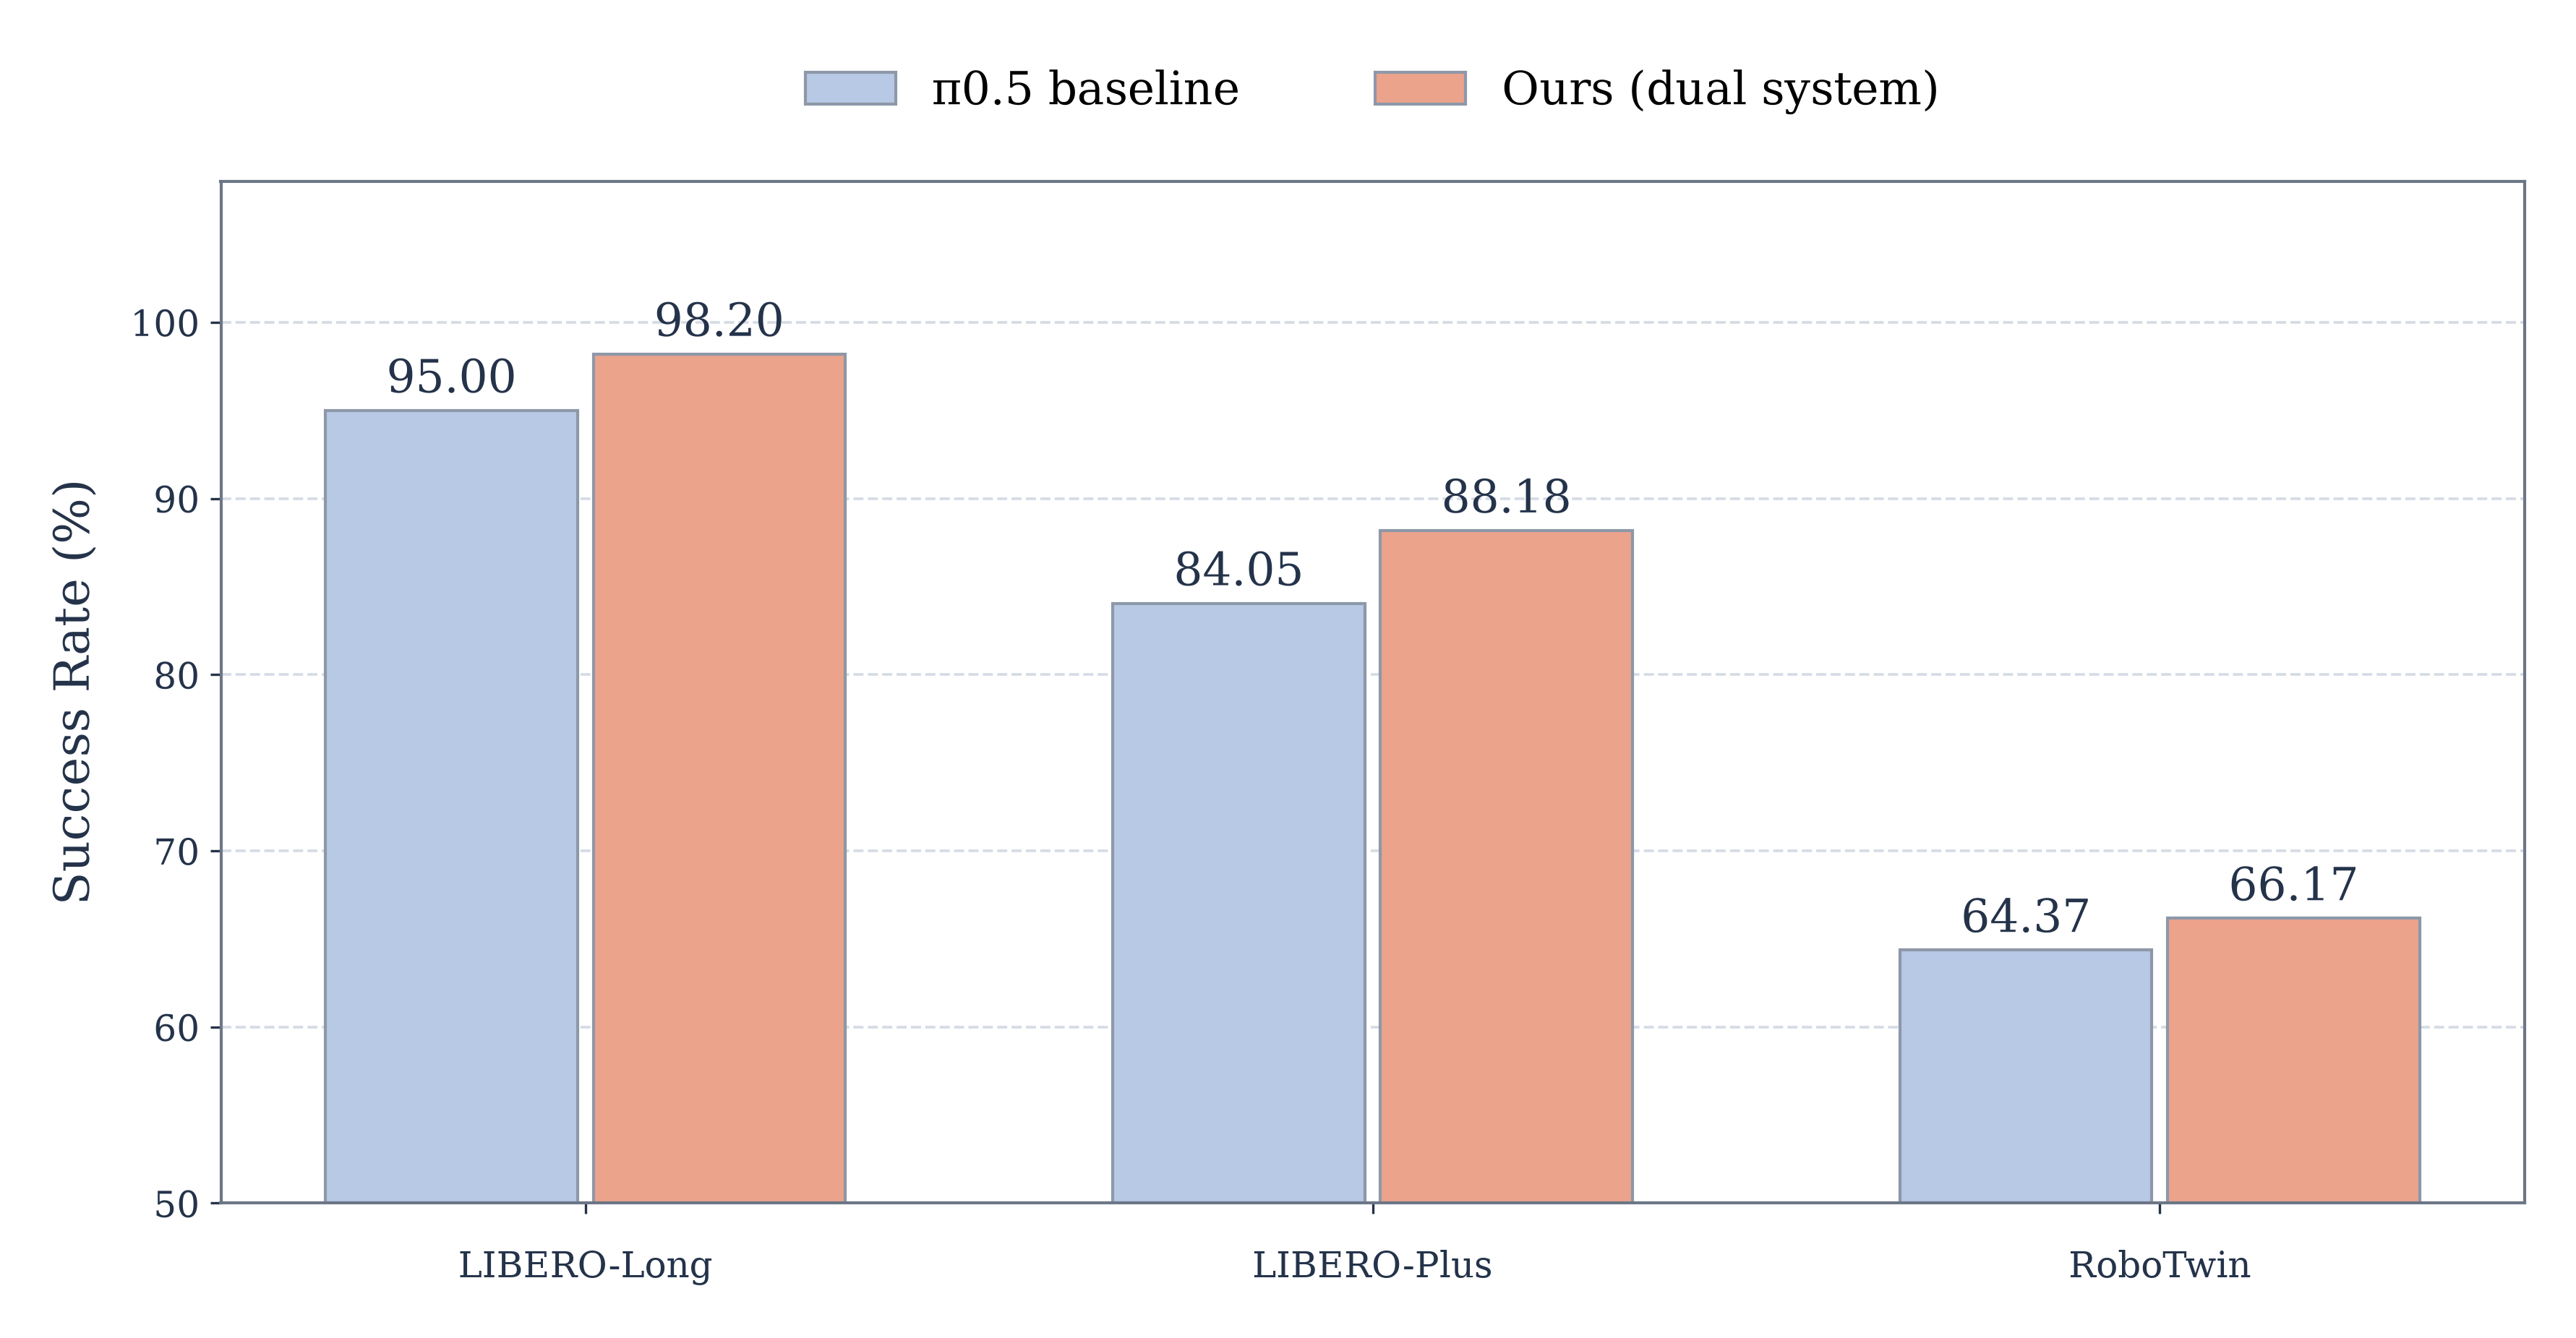
从长程任务到扰动环境再到双臂协作,原子动作监督都带来了稳定收益。
写在最后
RoboAtom 的数据集 RoboAtom-Data、评测基准 RoboAtom-Bench、9B 与 27B 原子动作标注模型及数据构建流程均已开源。
史上最大规模的统一原子动作标注、比 GPT 更准且便宜几百倍的标注模型、能直接提升机器人成功率的动作监督,RoboAtom 为 Agentic Robot 的动作理解、分步规划与闭环执行打下了一块可复用的数据底座。欢迎大家下载使用,一起把机器人的“分步教程”写得更全、更准。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册