大语言模型会修漏洞,但它真的修对了吗?
大语言模型已经能够阅读代码、定位问题、生成补丁,还可以在修改后运行测试。看起来,自动漏洞修复似乎已经进入了“让智能体自己完成任务”的阶段。
但漏洞修复有一个容易被忽略的问题:补丁通过测试,并不一定意味着安全问题已经真正解决。
一个智能体可能只针对某个示例输入打补丁,绕过了测试,却没有修复漏洞的根本原因;多个智能体也可能分别给出看似合理、实际互相矛盾的分析。如果这些未经核验的结论直接进入补丁生成阶段,错误的漏洞理解就会一路传递到最终代码中。
这正是论文 EviRepair 试图解决的问题:在生成补丁之前,先确认“漏洞到底是什么”,并且要求这个判断有代码和运行时证据支持。
论文题目:EviRepair: Evidence-Driven Agents for Reliable Vulnerability Repair
论文链接:https://arxiv.org/abs/2610.13491
代码仓库:https://github.com/lly-s/EviRepair
作者:Yilian Shi、Qingyu Liu、Tianyi Zhou、Wende Tan、Chenyang Si、Yueming Lyu、Xia Hu、Dongrui Liu
单位:南京大学、上海人工智能实验室、帝国理工学院
传统智能体方案,问题出在哪里?
单智能体方案通常把仓库探索、漏洞分析、补丁生成和测试验证都交给同一个智能体。任务集中在一个上下文中,智能体很容易面临“上下文过载”:需要记住的信息越多,分析过程就越容易混乱。
多智能体方案可以把任务拆开,让不同智能体分别承担不同角色。问题在于,多个智能体各自输出结果之后,系统往往只是把这些结果汇总起来,并没有专门检查它们是否真正一致。
换句话说,多个智能体同时得出相同结论,并不能自动证明这个结论是正确的。它们可能共享同一个错误前提,也可能分别遗漏了同一个关键条件。
EviRepair的核心想法很简单:让智能体负责寻找证据,再让另一个智能体专门审查证据。
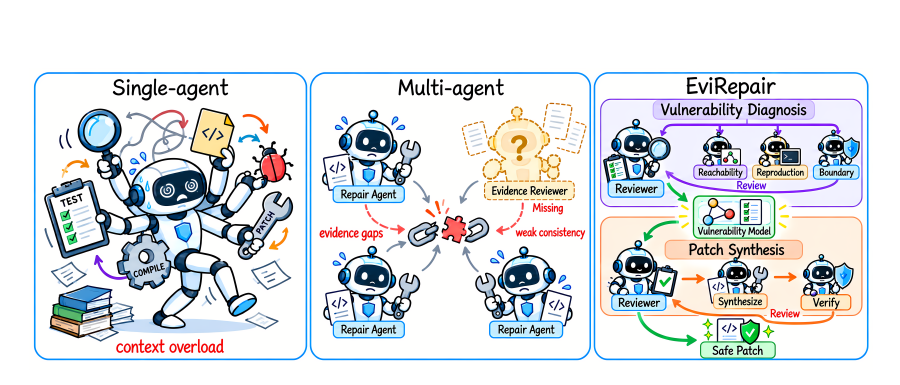
图1:左侧是单智能体的上下文过载问题,中间是传统多智能体缺少证据一致性检查,右侧是EviRepair的整体思路。
先诊断漏洞,再生成补丁
EviRepair将整个流程分成“漏洞诊断”和“补丁合成”两个阶段。
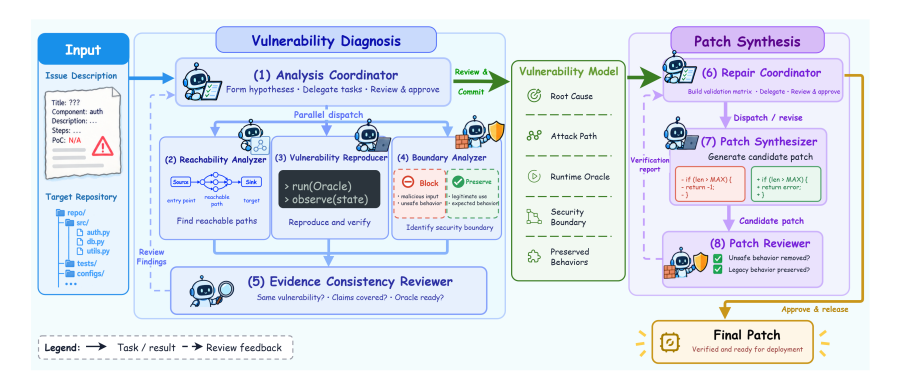
图2:EviRepair先通过多个专门化智能体收集并审查漏洞证据,构建漏洞模型,再据此生成、验证和迭代补丁。
漏洞诊断:先把漏洞查清楚
在漏洞诊断阶段,分析协调器会根据漏洞报告提出若干待验证的安全假设,然后安排不同的专门化智能体并行工作:
- 可达性分析智能体:检查攻击者可控的输入能否从入口一路传播到敏感操作;
- 漏洞复现智能体:构造可执行的复现程序,观察漏洞在原始代码中的实际行为;
- 边界分析智能体:判断哪些输入必须被阻止,以及哪些正常行为必须继续保留。
每个智能体提交结论时,都需要同时提供代码位置、分析结果或运行日志等证据。系统不会仅仅因为某个判断“听起来合理”就接受它。
随后,证据一致性审查智能体会检查几个关键问题:这些发现是否指向同一个漏洞?是否覆盖了漏洞报告中的主要描述?复现程序是否真的执行了目标代码?安全边界是否有充分依据?
如果审查发现证据不足,系统会要求相关智能体补充分析,而不是直接进入补丁生成阶段。最终,经过审查的证据会被整理成一个漏洞模型,成为后续修复工作的依据。
补丁生成:修复之后再验证
有了漏洞模型之后,修复协调器会把其中的安全边界和兼容性要求转化成验证矩阵。矩阵中的每一行都对应一个需要验证的行为:危险输入必须被阻止,合法输入必须保持原有功能,代码还需要能够正常应用和构建。
补丁合成智能体根据根因生成修复方案,并运行完整的验证矩阵。之后,补丁审查智能体在独立上下文中检查补丁是否真的解决了根因、是否关闭了攻击路径,以及是否误伤了正常功能。
这一设计特别关注一种常见失败模式:补丁只是把论文中展示的那个输入样例挡住了,却没有修复同一攻击路径上的其他变体。EviRepair要求修复方案同时满足“消除不安全行为”和“保留合法行为”两个条件。
实验结果
论文在PatchEval和SecBench两个漏洞修复基准上进行了实验,并与Codex、OpenCode等智能体编程系统进行比较,同时测试了多种大语言模型。
这组实验关注的不只是最终分数,还进一步追问:EviRepair在哪些漏洞上更有优势?任务变难之后还能不能保持效果?两个阶段分别贡献了什么?结构化证据能否弥补底层模型能力的不足?
总体结果:两个基准上全面领先
结果显示,EviRepair在两个基准上都取得了最高的整体修复成功率:
- 在PatchEval上,EviRepair的平均修复成功率为 79.13%,高于Codex的70.00%和OpenCode的71.89%;
- 在SecBench上,EviRepair的平均修复成功率为 93.11%,高于Codex的62.56%和OpenCode的83.33%;
- 相比更强的基线系统OpenCode,EviRepair在PatchEval和SecBench上分别将未解决任务比例降低约 26% 和 59%。
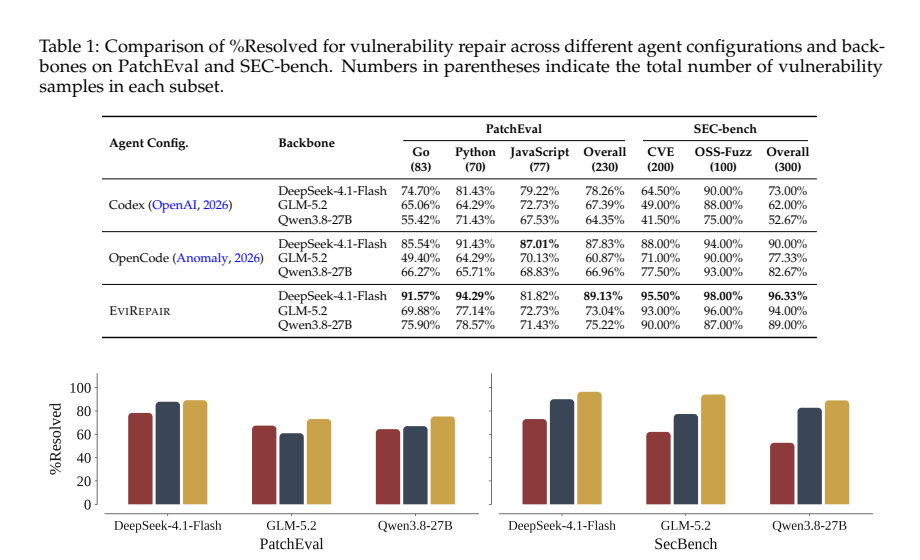
图3:EviRepair在不同模型配置和两个基准数据集上的修复成功率整体更高。
越需要理解漏洞,优势越明显
两个基准的结果并不是简单地说明“多用了几个智能体,所以分数更高”。进一步按漏洞类型拆分后可以看到,EviRepair最擅长的是那些需要判断攻击路径和安全边界的任务。
在PatchEval上,EviRepair在错误授权、权限控制、路径操纵和开放重定向等漏洞类型上提升最明显。这些漏洞的关键并不只是找到某一行代码,而是判断哪些请求应该被允许、哪些请求必须被拒绝。也就是说,系统需要先建立清晰的安全边界,再决定补丁应该在哪里介入。
相较之下,对于代码注入和SQL注入这类修复模式较为成熟的漏洞,各个系统的表现更加接近。对于服务器端请求伪造,EviRepair没有表现出明显优势,论文认为一个重要原因是实验环境禁止外部网络访问,使得这类漏洞的运行时复现和验证更加困难。
在SecBench上,EviRepair在所有漏洞类别中都处于领先位置,其中在释放后使用和空指针解引用任务上的优势最大,而在堆缓冲区溢出任务上的优势相对较小。原因在于,缓冲区溢出任务的崩溃位置通常已经接近需要修改的位置,安全工具提供的崩溃信息本身就包含了较多线索;释放后使用和空指针问题则往往需要从运行时症状反向追踪到更早的根因。
这说明,EviRepair的优势主要来自“补丁位置”和“漏洞表现位置”并不重合的场景,也来自那些必须明确区分“允许行为”和“禁止行为”的场景。
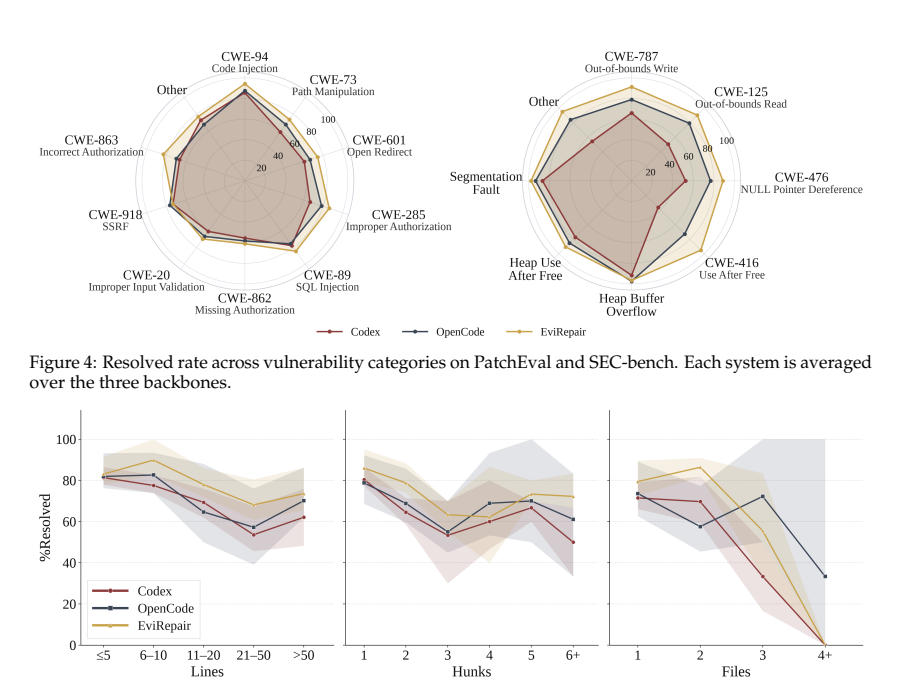
图4:上方展示PatchEval和SecBench不同漏洞类别的修复成功率,下方展示PatchEval中不同修改行数、修改块数量和涉及文件数量下的修复表现。
任务越复杂,优势越能体现
论文还按照真实补丁的修改行数、修改块数量和涉及文件数量来衡量修复难度。随着补丁规模增大,所有系统的成功率都会下降,但EviRepair下降得更慢。
在修改行数为21到50行的任务中,EviRepair的成功率约为72%,基线系统约为56%;在修改块数量较多、难度最高的任务中,EviRepair同样保持领先。补丁越大,通常意味着攻击路径更长、代码中间转换更多,这正是漏洞模型和安全边界能够发挥作用的地方。
不过,涉及多个文件的任务也暴露出当前方法的边界。对于只涉及一个或两个文件的任务,EviRepair明显优于两个基线;涉及三个及以上文件的任务只有7个,样本较少,结果不够稳定,而且EviRepair在涉及四个及以上文件的任务中没有修复成功。论文认为,当前漏洞模型主要围绕单一根因和单条攻击路径组织证据,对于需要协调多个文件、多个相互作用根因的修复任务,表达能力仍然有限。
消融实验:两个阶段缺一不可
为了判断提升究竟来自哪里,论文在GLM-5.2上进行了消融实验。所谓消融实验,就是暂时去掉或替换系统中的某个模块,再观察性能下降多少。
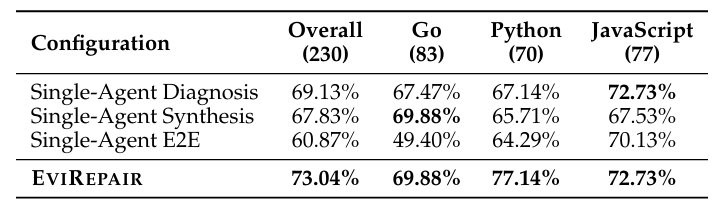
表1:将漏洞诊断阶段、补丁合成阶段或两个阶段都替换为单智能体后,PatchEval上的整体修复成功率均出现下降。
在PatchEval上,完整的EviRepair达到73.04%的修复成功率:
- 将漏洞诊断阶段替换成单智能体后,成功率降至69.13%,下降3.91个百分点;
- 将补丁合成阶段替换成单智能体后,成功率降至67.83%,下降5.21个百分点;
- 两个阶段都改成单智能体后,成功率进一步降至60.87%,下降12.17个百分点。
这个结果很有意思:两个阶段同时被削弱造成的损失,大于分别削弱两个阶段后损失的简单相加。它说明漏洞诊断和补丁合成之间存在相互强化关系。前一个阶段通过证据审查减少错误的漏洞理解,后一个阶段通过补丁审查减少错误的修复决策;即使一个阶段漏掉了问题,另一个阶段仍有机会把它拦截下来。
结构化证据能够弥补部分模型能力差距
论文最后考察了一个很实际的问题:如果底层大语言模型没有那么强,结构化的证据流程还能不能发挥作用?
答案是可以。在实验中,Qwen3.8-27B是规模较小、基线表现较弱的模型。使用这个模型时,EviRepair在PatchEval上的修复成功率仍达到75.22%,不仅高于同一模型下的两个基线,也高于更大的GLM-5.2在Codex和OpenCode中的结果。在SecBench上,EviRepair使用Qwen3.8-27B达到89.00%,超过了GLM-5.2下的所有基线,并接近OpenCode使用DeepSeek-4.1-Flash时的90.00%。
更重要的是,随着底层模型能力下降,EviRepair相对于同模型最强基线的优势扩大:在PatchEval上,使用DeepSeek-4.1-Flash时领先1.30个百分点,使用GLM-5.2时领先5.65个百分点,使用Qwen3.8-27B时领先8.26个百分点。
这意味着,结构化证据并不能完全替代更强的模型,但可以在一定程度上弥补模型推理能力的不足。模型越难以独立完成复杂的漏洞理解,越需要依靠任务拆分、独立审查和明确的验证标准来降低出错概率。
如何理解这些实验结果?
综合来看,EviRepair的提升主要集中在三类任务上:漏洞根因与崩溃位置不一致的任务、需要精确划定安全边界的任务,以及需要较长攻击路径和多步代码理解的任务。对于修复模式非常固定、工具已经直接给出关键位置的漏洞,证据审查带来的额外收益相对有限。
同时,论文也提醒,当前结论仍然建立在PatchEval和SecBench两个基准之上,不能直接等同于真实生产环境中的漏洞已经被彻底消除。多智能体流程还会带来更多模型调用、运行时间和成本。EviRepair的实验结果更准确的含义是:在安全漏洞修复这类高风险任务中,把证据收集和独立审查显式加入流程,能够稳定提高补丁通过基准验证的概率。
这项工作的启发是什么?
EviRepair的价值不只在于增加了几个智能体角色,更在于改变了自动漏洞修复的工作方式:系统需要先建立一个经过证据支持的漏洞模型,再让补丁围绕这个模型进行生成和验证。
对于普通代码生成任务,生成一个“看起来能运行”的方案可能已经有一定价值;对于软件安全任务,系统还必须回答几个更严格的问题:漏洞的根因是什么?攻击路径是否被真正关闭?合法功能是否仍然保留?测试是否执行了当前补丁后的代码?
EviRepair给出的答案是:把这些问题显式写入智能体流程,并让不同角色相互检查。
当然,证据驱动的方法也会带来额外的分析和运行成本。但从实验结果来看,在安全漏洞修复这类高风险任务中,这些审查环节似乎是值得的。未来的编程智能体,可能不只是“会写代码”,还需要学会说明自己为什么这样修改,以及如何证明修改确实有效。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册