作者:Shengyu Feng
原文:https://shengyu-feng.github.io/blog/2026/10/13/beyond-RL
青稞社区为科研人员提供成果宣传支持,投稿联系:aiFreeCode
在上一篇博客中,我们讨论了如何将强化学习理解为从基于能量的分布中采样:
其中 g(x) 是待最小化的目标(例如代价或负奖励),p_{\mathrm{ref}}(x) 是参考分布,\beta 控制向该参考分布正则化的强度。
本文探讨的是扩散模型的无监督训练。与一步生成样本的模型不同,扩散模型引入了一串中间隐状态,逐步把噪声变换为数据。我们将从三个互补的视角考察这一过程,每个视角都提供了一种不依赖目标分布训练样本、就能理解和优化扩散模型的方式。
在继续之前,我们先澄清一下记号。离散时间的扩散模型与连续时间的形式,往往采用相反的时间约定,如下图所示。
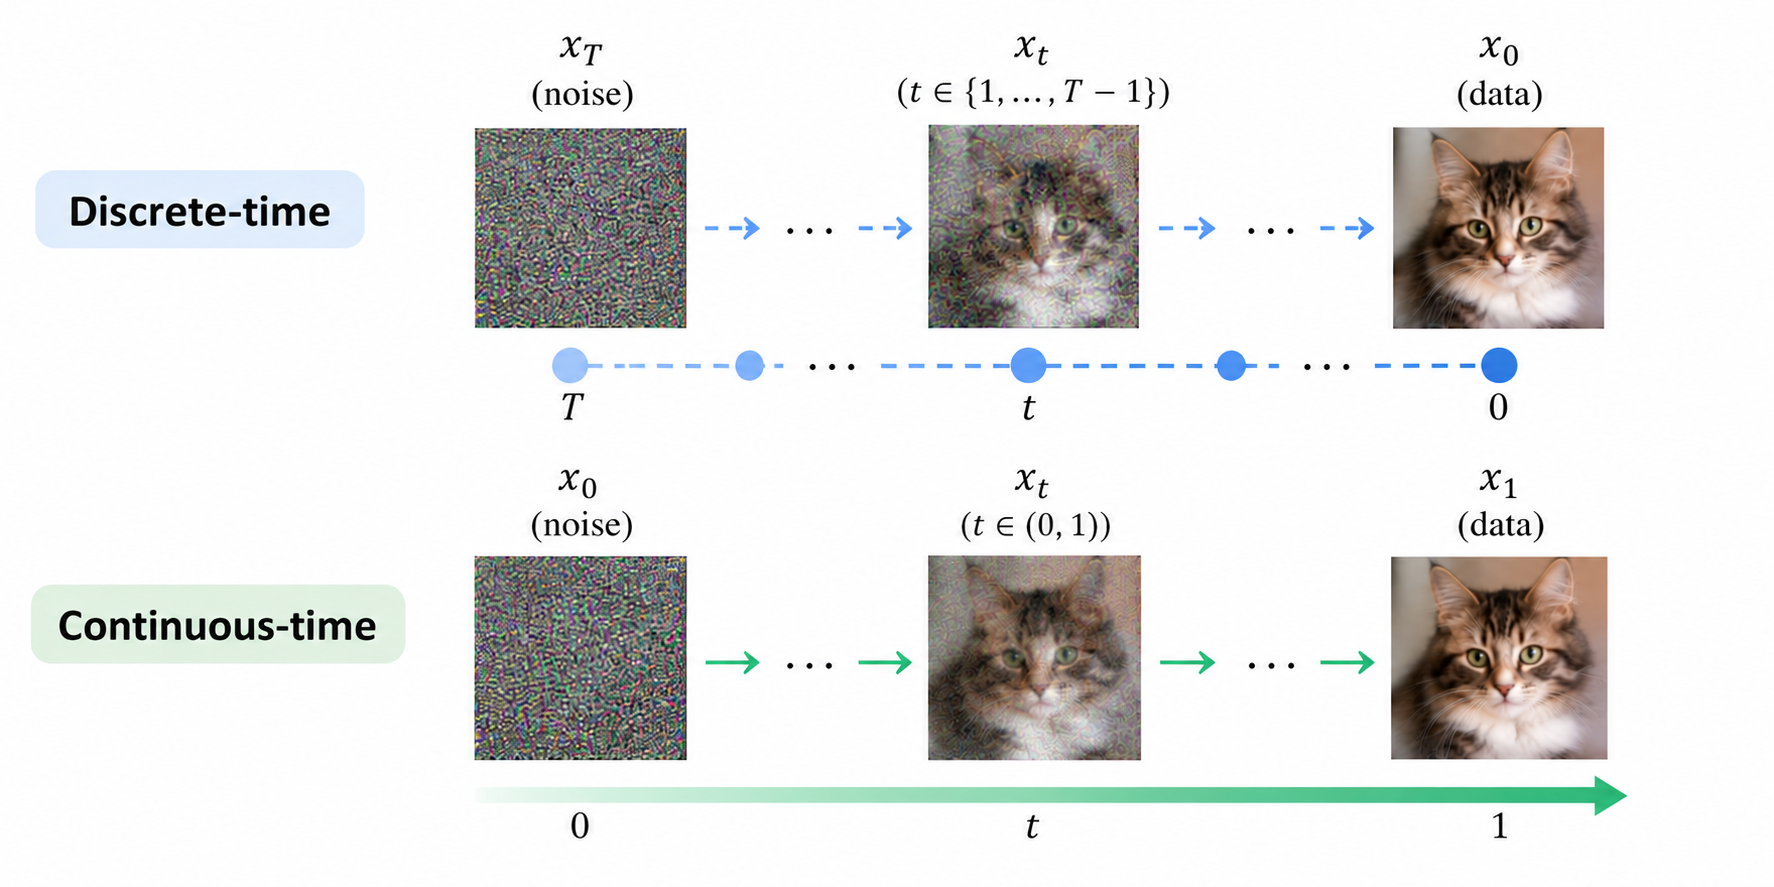
前两节我们将采用离散时间的约定,最后一节采用连续时间的约定。
这里有一个微妙之处:对扩散模型而言,参考分布 p_{\mathrm{ref}}(x) 通常是难以处理的,因此我们改为在整个生成轨迹上定义参考分布。对于离散时间过程,这给出
视角一:Langevin 动力学
我个人认为,这是理解扩散模型最直观的视角。
扩散模型的一个标志性特征是它的迭代生成过程,这一点与 VAE、GAN 等模型形成对比。不过,迭代采样并非扩散模型独有。正如我们在上一篇中所讨论的,**马尔可夫链蒙特卡洛(MCMC)**同样是通过一系列状态转移来生成样本的。
关键区别在于:
- MCMC 在整个采样过程中通常瞄准同一个分布。
- 扩散模型则会逐步穿过不同的分布,从噪声一路走向目标分布。
从这个意义上说,扩散模型可以从退火 MCMC 的视角来理解,这也正是 Noise Conditional Score Networks (NCSN) 的动机所在。
回想一下,MCMC 可以直观地看作一个随机爬山过程:我们倾向于朝概率更高的区域移动,同时偶尔也接受朝低概率区域移动,以保持探索。
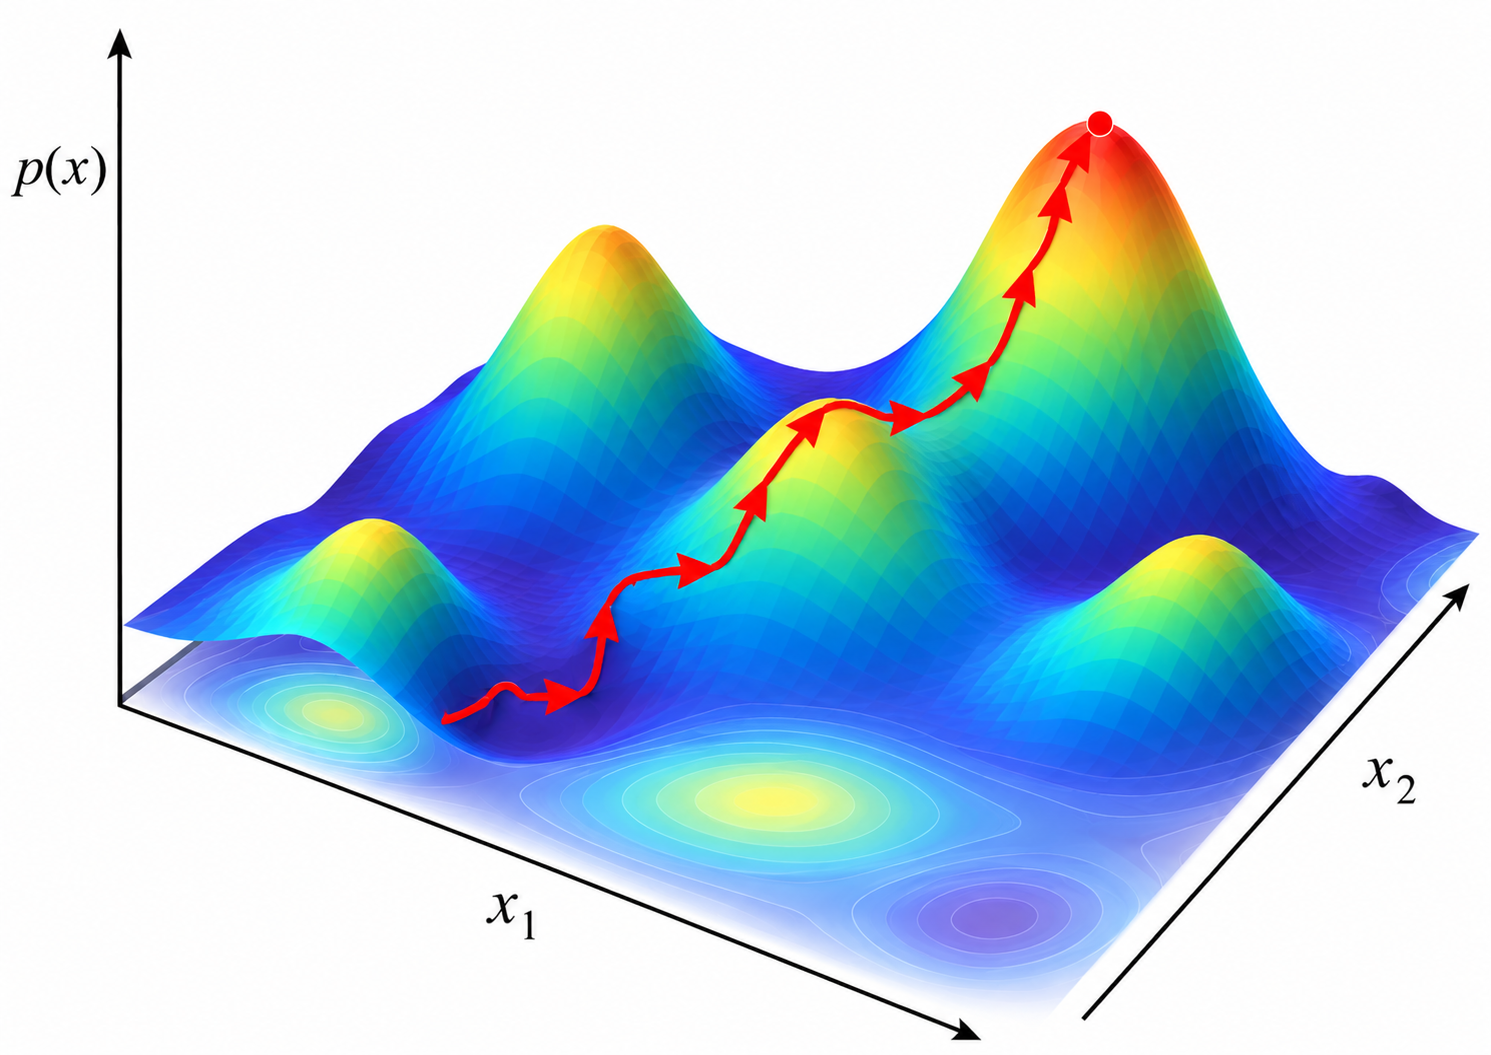
以 Metropolis–Hastings 算法为例,我们首先提议一个新状态:
随后根据下式决定是否接受该提议:
当提议分布对称时,这条规则会简化为一个特别直观的形式:
- 若 p(x')\geq p(x),我们总是接受新状态。
- 否则,以概率 p(x')/p(x) 接受它,从而允许偶尔朝概率较低的状态移动。
MCMC 的效率在很大程度上取决于提议分布。好的提议能高效地探索高概率区域,而糟糕的提议则可能把大量步数浪费在被拒绝的移动上。于是自然产生一个问题:
我们能否直接提议朝概率更高的区域移动?
在局部,\log p(x) 上升最陡的方向由它的梯度 \nabla_x\log p(x) 给出,这个量被称为 score。
利用 score,我们可以构造一个由梯度引导的随机采样过程,即 Langevin 动力学:
该更新包含两个部分:
- 梯度上升:\frac{\sigma^2}{2}\nabla_x\log p(x) 把样本推向概率更高的区域。
- 随机探索:\sigma\,\xi 引入随机性,使过程能够探索整个分布,而不是仅仅收敛到某个局部众数。
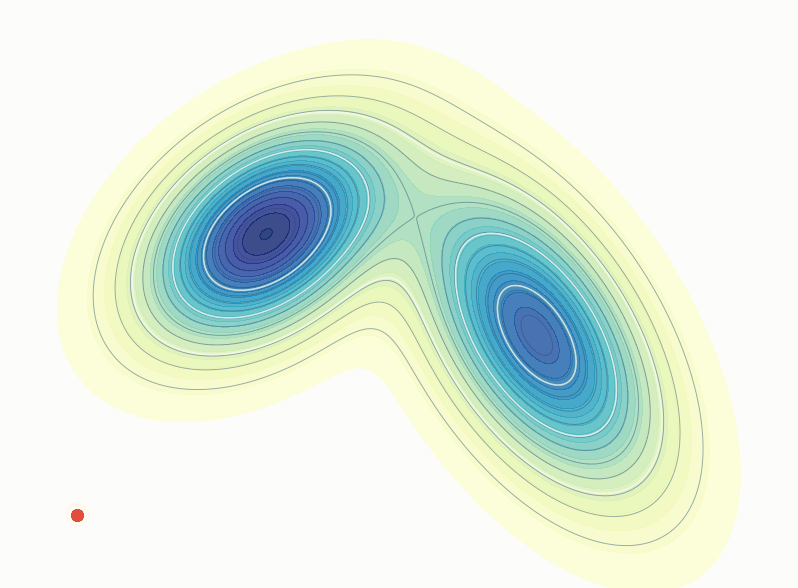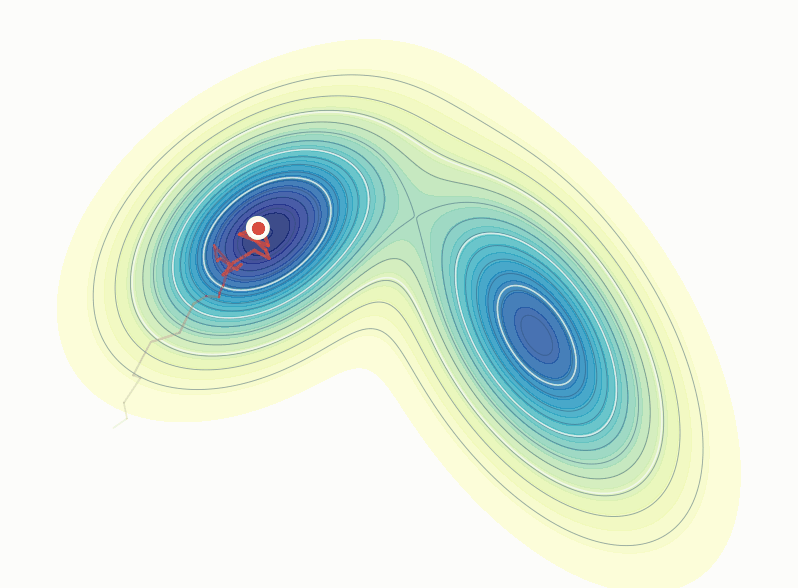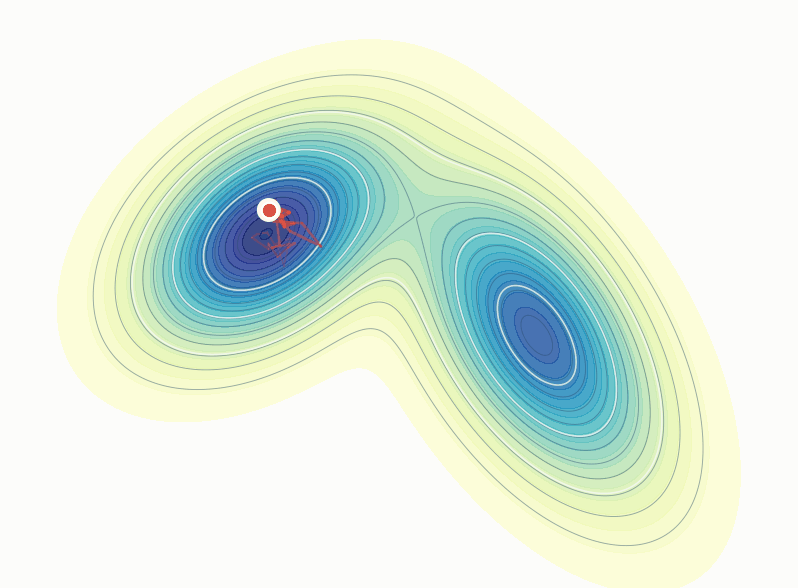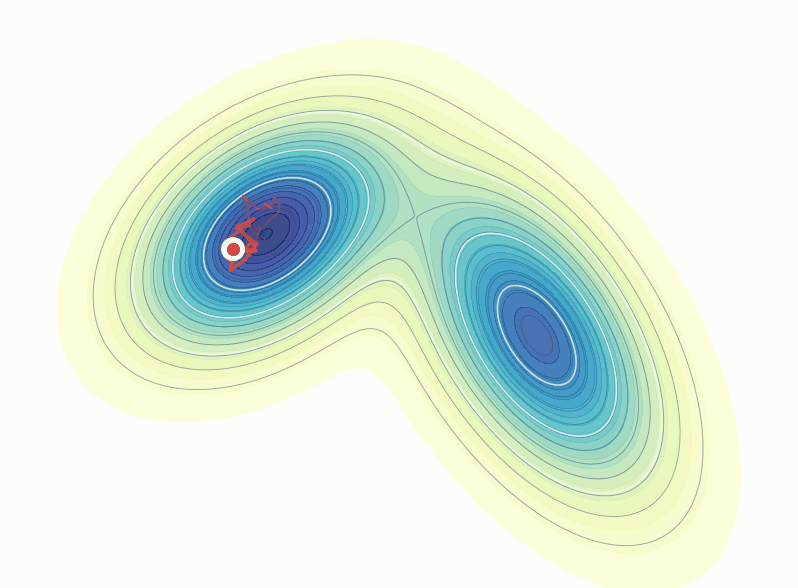
与普通梯度上升(旨在找到分布的众数)不同,Langevin 动力学把梯度信息与噪声结合起来,从目标分布中采样(在步长有限时,相差一个离散化误差)。
剩下的问题就是:在目标密度未知的情况下,如何得到 score \nabla_x\log p(x)。这引出了一类成熟的方法,即 score matching。
由于传统的 score matching 与本文关注的无监督训练方法并无直接关系,我把相关解释放在下面的可选部分,从密度估计的直觉讲起,最后落到现代扩散模型的目标函数。
可选:score 究竟是如何估计的?(KDE、多噪声水平训练与退火 Langevin 动力学)
score matching 的目标是学到一个函数 s_{\theta}(x),用来逼近数据分布的 score:
难点在于,我们只能观测到样本 x\sim p(x),既不知道密度 p(x) 本身,更不知道它的梯度 \nabla\log p(x)。我们如何学习一个无法直接求值的量?
不妨先抛开数学形式,看一个简单的例子。想象一个单位正方形,里面散布着若干观测样本。你会怎样估计任意一点处的概率密度 p(x)?
一种简单的做法是:在该点周围画一个小方框,数一数有多少样本落在里面。把这个计数除以样本总数和方框面积,就得到密度的一个估计。这就是 Parzen 窗方法。
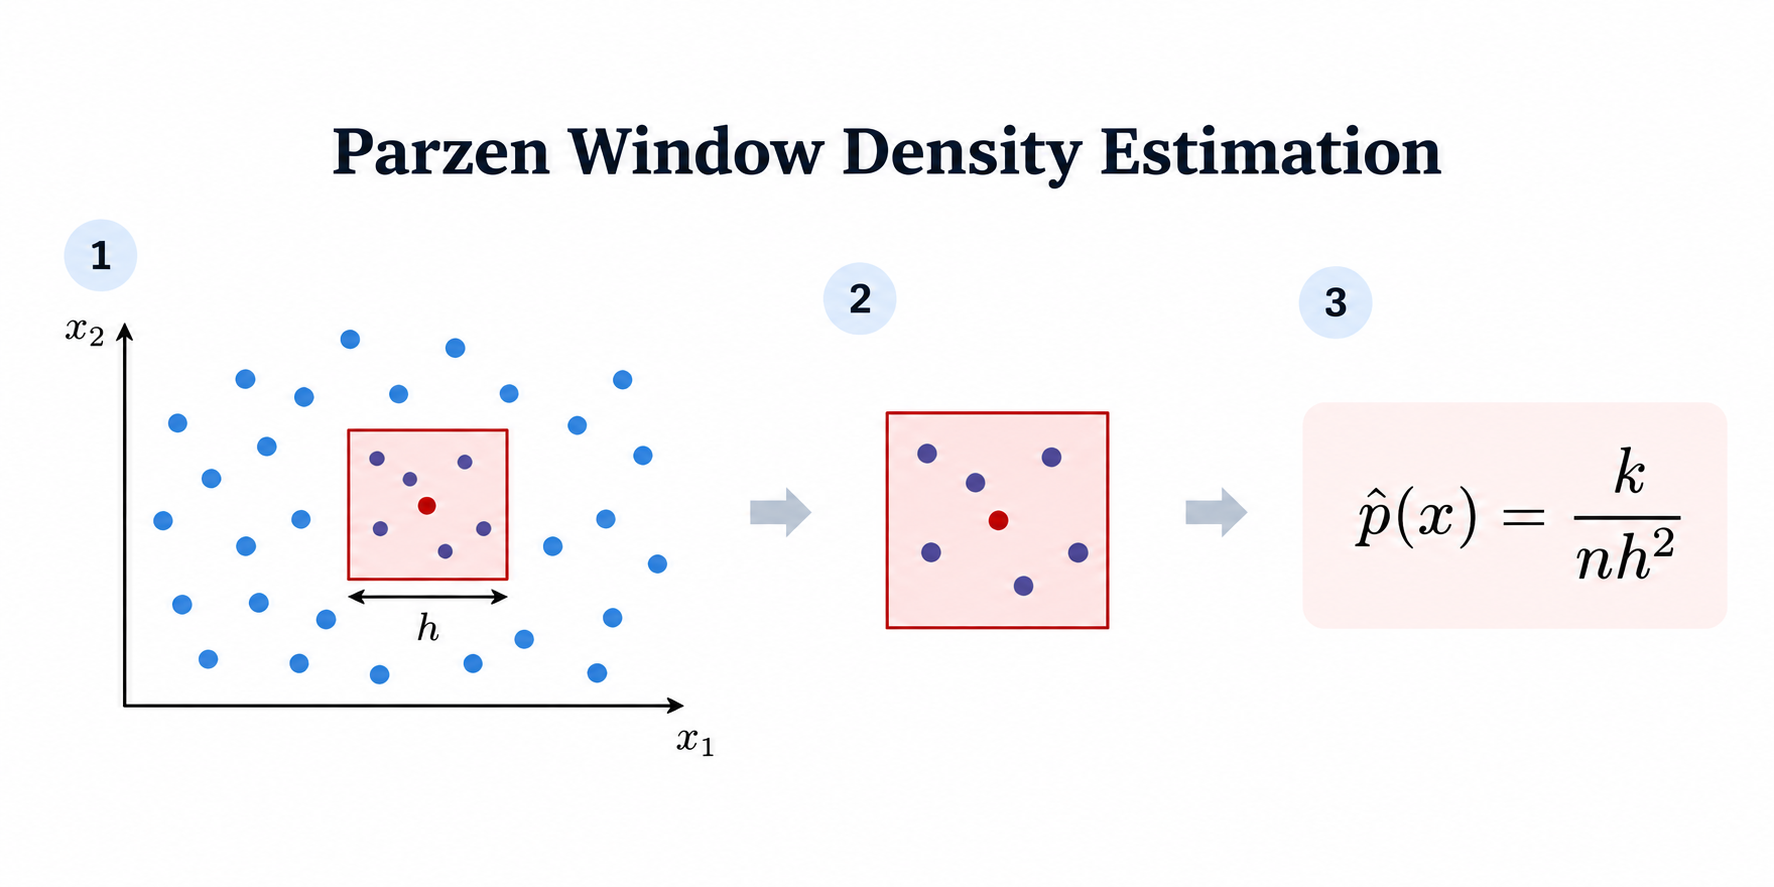
Parzen 窗方法使用的是硬边界:窗内的样本贡献相同,窗外的样本则完全没有贡献。
更平滑的替代做法是:用核函数,依据每个样本与目标点的距离为它分配一个权重。这就是核密度估计(KDE)。
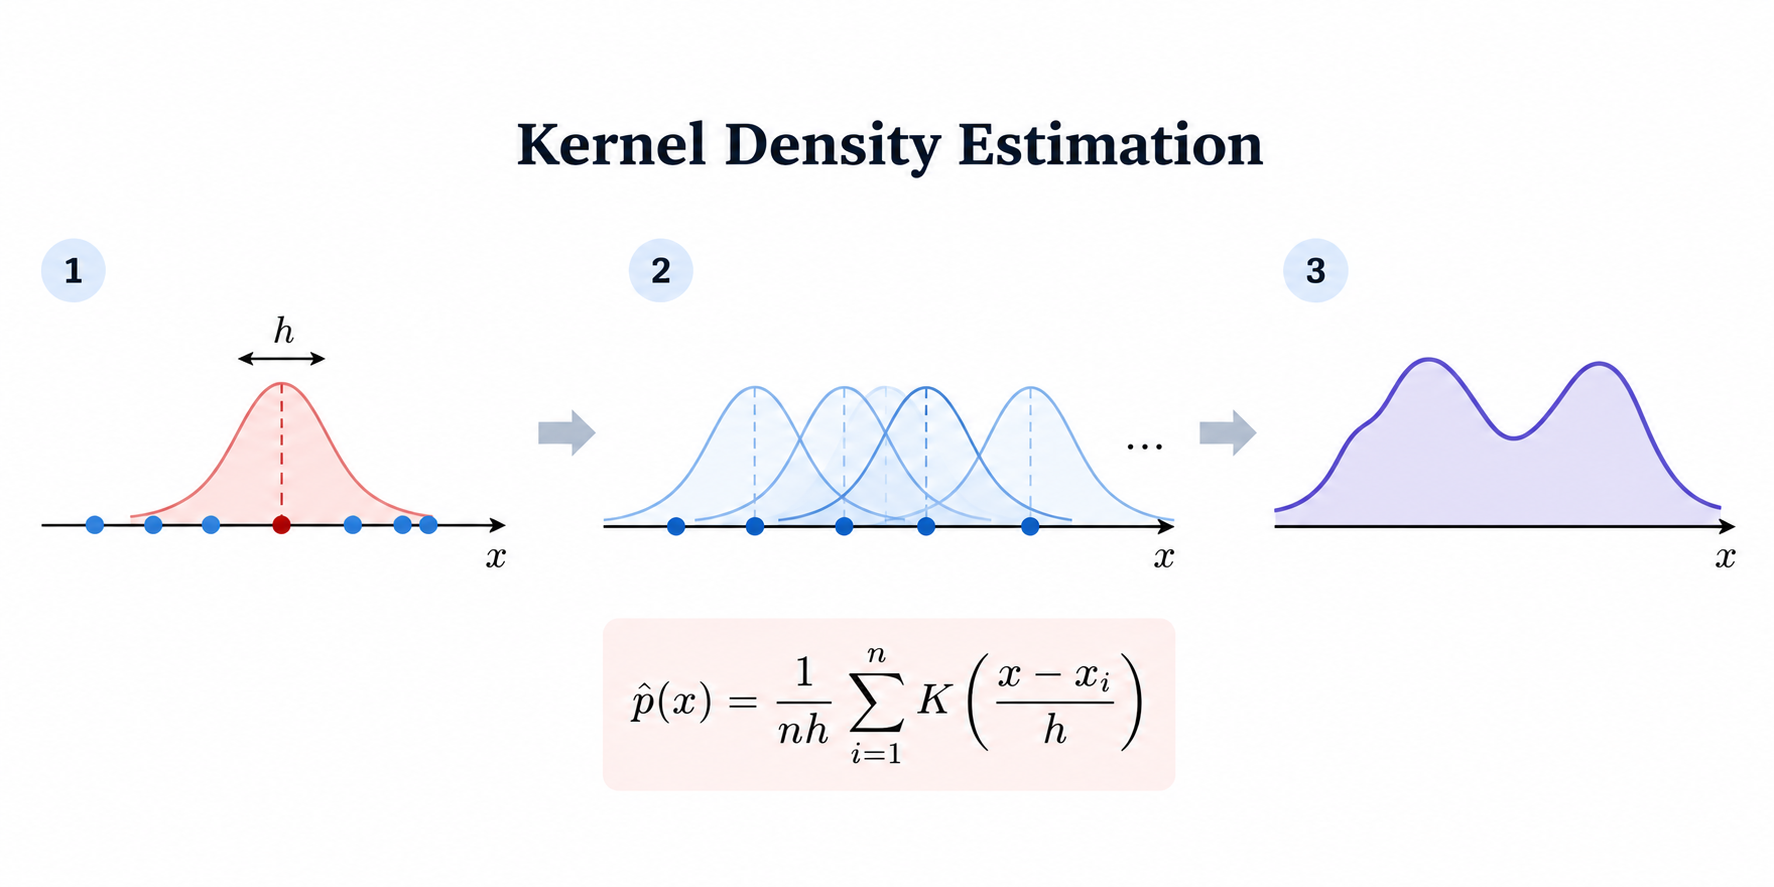
有趣的是,核函数也可以被解释为一个概率分布:
在这一解释下,平滑后的数据分布为
一个常见的选择是高斯核。在一维情形下,
或等价地,
其中 \mathcal{N}(x;x',\sigma^2) 表示在 x 处取值、均值为 x'、方差为 \sigma^2 的高斯密度。
当 \sigma\to0 时,平滑后的分布趋近于原始数据分布:
因此,我们可以通过学习平滑分布的 score 来逼近原始 score。
下面来计算 p_{\sigma}(x) 的 score:
注意,最终表达式中的分式恰好就是后验分布 p_{\sigma}(x'\mid x)。也就是说,平滑分布的 score 等于条件 score 的后验期望:
对于高斯核,条件 score 有简洁的闭式解:
由此得到一个可实际使用的训练目标:
关键洞见是:我们不再需要知道原始密度或其 score。我们只需采一个干净的数据点 x',用高斯噪声扰动得到 x,然后训练网络去预测指回干净样本的方向。
尽管每个单独的目标都指向某一个具体的数据点,但最小化期望 MSE 会恢复出平滑分布的 score。这就是去噪 score matching。
最后,\sigma 的选取至关重要。较小的 \sigma 能更准确地逼近原始分布,但也会让低密度区域的 score 估计变得困难——在这些区域,只有极少数样本对估计有实质贡献。
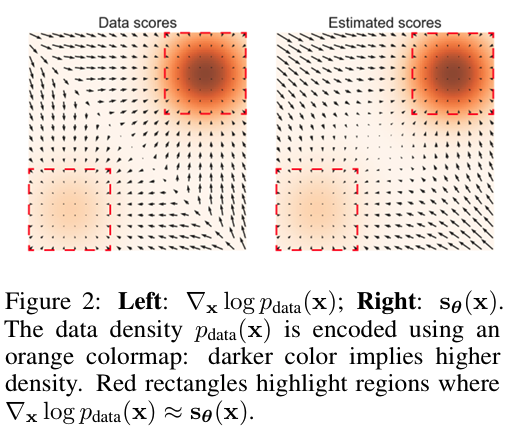
图源:Song & Ermon, 2019。
为解决这个问题,Song & Ermon 提出在多个噪声水平上学习 score:
在每个噪声水平上,我们学习对应扰动数据分布 p_{\sigma_t}(x) 的 score。
当 \sigma 较大时,扰动后的分布可能与原始数据分布相差很大。与其直接用最小噪声水平上的 score 采样,不如逐步地穿过一系列噪声递减的分布。
具体来说,我们从一个高噪声分布出发,在当前噪声水平上执行若干步 Langevin 更新,再用得到的样本去初始化下一个更小的噪声水平。这一过程被称为退火 Langevin 动力学:
这里,我们在每个噪声水平上执行若干步 Langevin 更新 k=0,\cdots,K-1,然后用最终样本初始化下一个水平:
于是采样过程会逐步穿过
并最终在 \sigma_1\to0 时逼近原始数据分布——前提是采样过程能足够好地跟上这些中间分布。
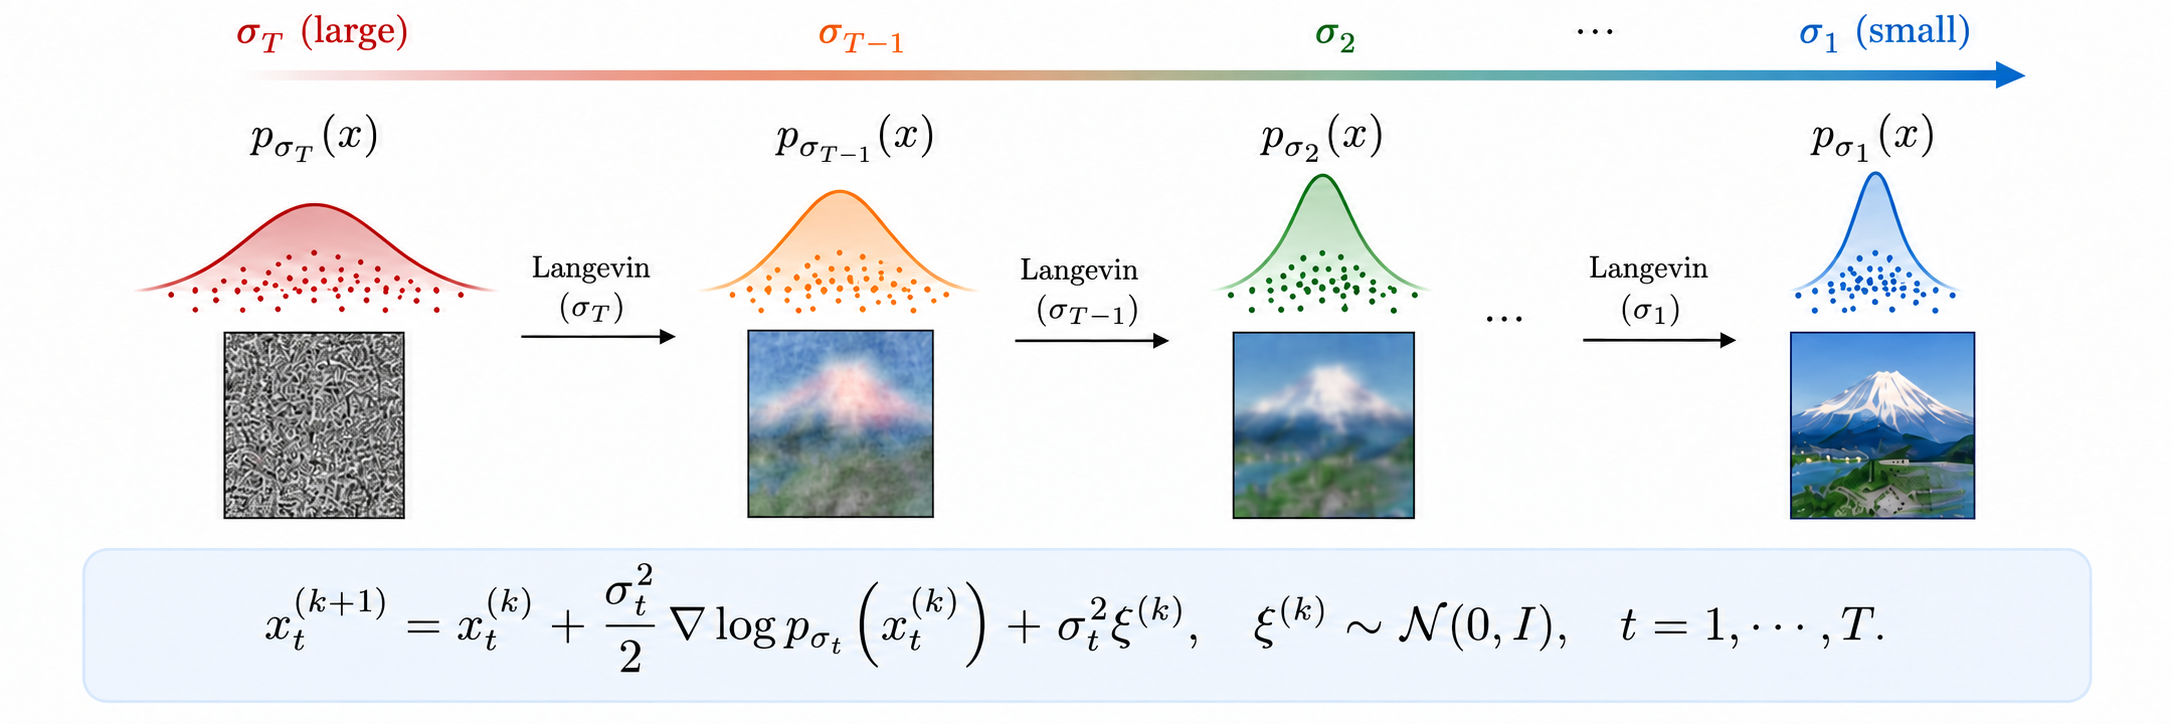
这就揭示了它与扩散模型的联系:两者都构造了一个生成过程,通过一系列中间分布逐步把噪声变换为数据。
在概念上,扩散模型把这种退火采样的思想推得更远:它学习的是逐步去除噪声的转移。不过,标准的反向扩散更新并不严格等同于取 K=1 的退火 Langevin 动力学。
神经 Langevin 动力学
现在回到我们的主线——扩散模型的无监督训练。如果只给定一个基于能量的目标分布,我们能否在不显式学习其 score 的情况下,执行类似 Langevin 的采样?
关键在于对 Langevin 动力学做基于优化的重新诠释。回想标准更新:
我们可以不把它仅仅看作一次随机梯度更新,而是把它的转移分布 p(x'\mid x) 刻画为一个局部优化问题的解:
要理解为什么,回想一下:最小化期望代价加上一个 KL 散度,得到的分布正比于参考分布乘以负代价的指数。这里得到的分布是
它恰好就是
因此,Langevin 更新可以通过求解一个局部 KL 正则化的优化问题来还原。这与单步梯度下降的优化视角密切相关:我们要找一个既能改进目标、又能约束自身移动幅度的更新。
我们还可以把这个解释再推进一步。做一阶泰勒近似,
由于 \log p(x) 相对于 x' 是常数,局部 Langevin 目标可以近似为
这给了一步 Langevin 更新一个格外直观的解释:
- **移向概率更高的状态:**最小化 -\log p(x') 会鼓励下一状态在目标分布下具有更高概率。
- **保持更新局部化:**KL 正则把更新分布约束在高斯扰动附近,使局部近似依然有意义。
需要强调的是,第二个目标/分布是原始 Langevin 更新的更一般化版本,它被称为 locally-balanced proposal。
这个视角之所以有用,是因为它让我们不再显式估计 score \nabla_x\log p(x),而是直接优化一个参数化的转移分布:
对于我们的基于能量的目标,有
因此,期望的目标代价变为
如果这个期望无法对 x' 求导,那么它的梯度仍可以用 REINFORCE 来估计。
重要的是,这个目标只作用于单次转移。我们不必把终端奖励反向传播穿过整条生成轨迹,而是可以直接用下一状态的能量来优化每一次转移。
更一般地说,这种局部优化的视角并不限于各向同性高斯转移。我们可以引入不同的参考分布 p_{\mathrm{ref}}(x'\mid x) 和约束,来控制每一步如何探索状态空间。例如,在我关于 Regularized Langevin Dynamics 的工作中,我在组合空间里约束更新的幅度以促进探索,这部分我会在后续博客中讨论。
用简单的话说,Langevin 动力学把长时程生成与局部转移优化解耦了。我们不必直接优化整条生成轨迹,而是可以反复求解或学习一个更简单的逐步目标。这个视角不仅让优化更易处理,也给了我们相当大的自由,可以为不同的状态空间和生成问题设计不同的局部更新规则、正则项和探索机制。
视角二:隐变量链
现在,让我们换一个视角重新审视扩散模型:隐变量链(a chain of latent variables),这一视角由最初的 DDPM 论文提出。
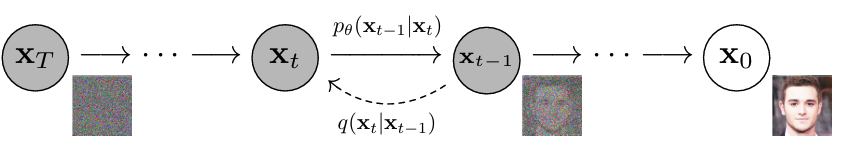
图源:Jonathan Ho,2020。
假设我们有一个数据分布 p_{\mathrm{data}}(x)。我们定义一个前向过程,逐步向数据中加入噪声:
其中每一步转移都服从高斯分布:
反向过程(也就是生成过程)旨在逆转这条链:从噪声 x_T 出发,最终生成干净的样本 x_0。
我们的最终目标是让生成分布与数据分布相匹配:
然而,直接计算边缘分布
通常是不可行的。
关键思路是把目标从边缘分布提升到整条轨迹上的联合分布。根据数据处理不等式,
其中
以及
直观地说,匹配整条轨迹比只匹配它的最终输出是更强的要求。因此,最小化联合 KL 同时也就最小化了边缘 KL 的一个上界。
更重要的是,联合 KL 可以分解为若干可计算的项:
因此,忽略与 \theta 无关的项,DDPM 的训练目标为
这里的推导与原始 DDPM 论文中的 ELBO 推导略有不同,但最终得到的目标是等价的。这个数据处理视角的好处在于:当我们把 KL 散度的方向反过来时,它同样适用——稍后我们就会看到这一点。
现在,让我们回到主要问题:
如果我们没有来自目标分布的样本,而只有一个能量函数,该怎么办?
前向 KL
前向 KL 需要来自目标分布的样本。在拿不到这类样本的情况下,我们还能使用这个目标吗?
可以,借助上一篇博客介绍的采样方法。
思路是:先用重要性采样(IS)、序贯蒙特卡洛(SMC)、MCMC 或相关方法,近似地从基于能量的目标分布中采样,再用标准 DDPM 目标的加权版本来训练扩散模型。
我们以重要性采样版本为例。
回顾一下,我们的目标分布是
接着,我们把当前的扩散模型作为提议分布。具体来说:
- 生成样本: 从当前模型 p_\theta(x_{0:T}) 中采样 N 条轨迹 \lbrace x^i_{0:T}\rbrace_{i=1}^N。
- 计算重要性权重: 对每条轨迹,计算其未归一化的重要性权重:
- 归一化权重:
- 训练模型: 用加权后的样本近似目标轨迹分布下的期望。由此得到的训练目标为
其中 L_{\mathrm{DDPM}}(x_0^i) 表示在给定 x_0^i 的条件下,使用前向加噪过程计算的标准 DDPM 损失。
在每一步优化中,我们对加权训练目标求导时,都把重要性权重和采样得到的轨迹视为固定值。
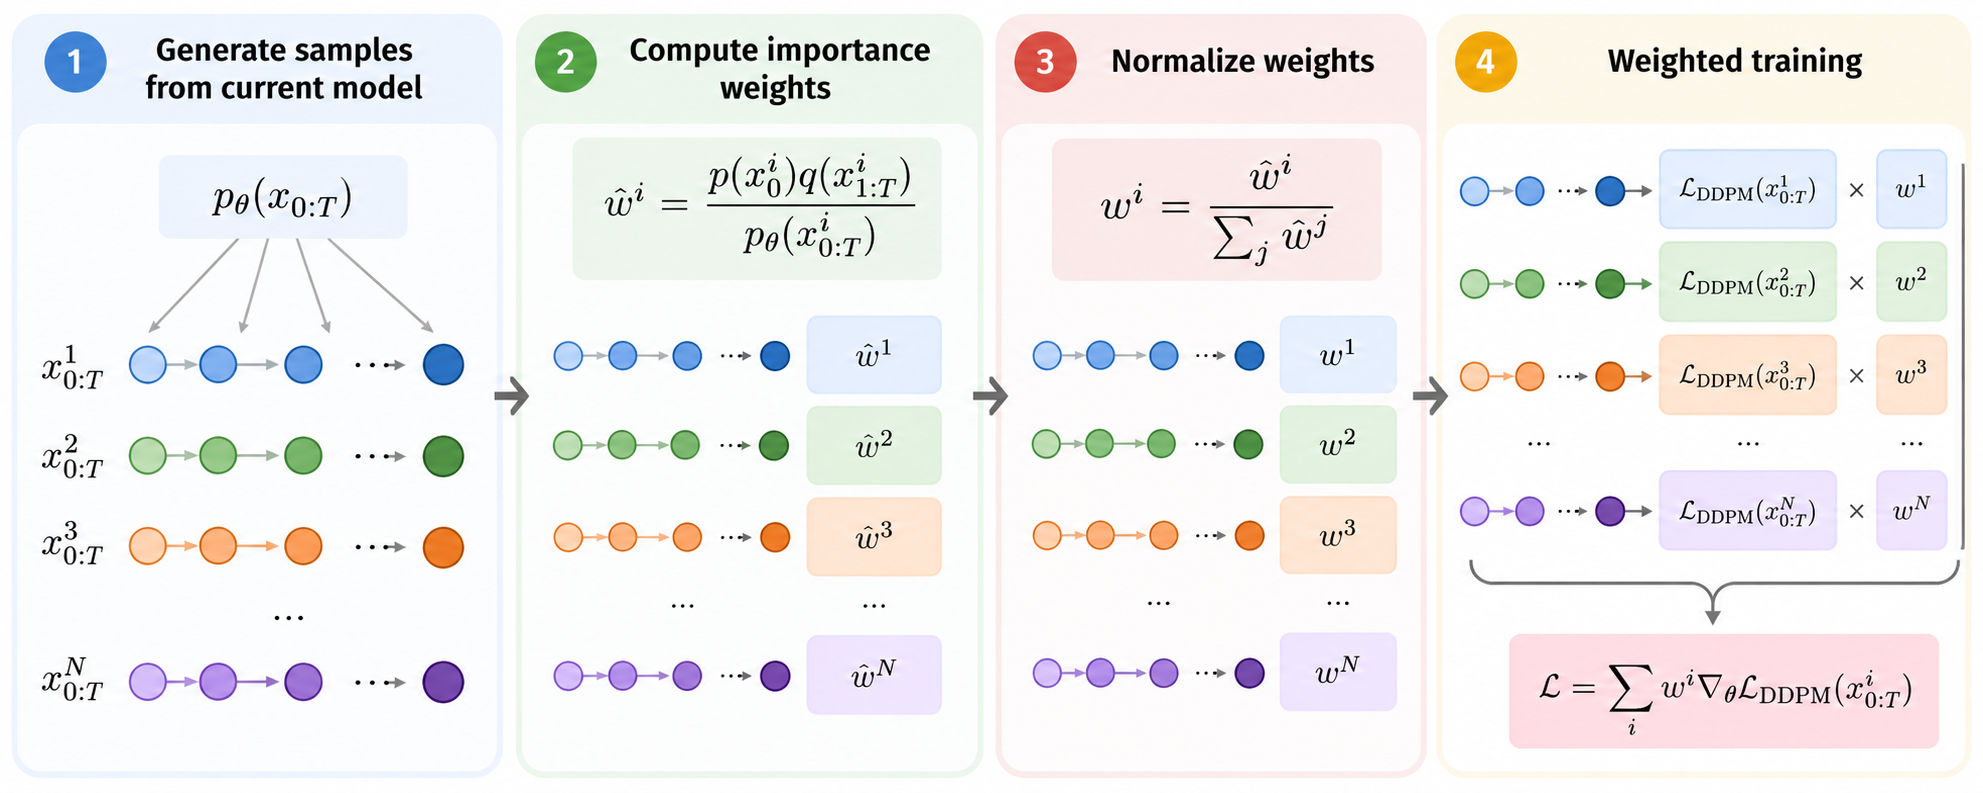
直觉很简单:我们从当前模型中生成样本,给更能代表目标分布的轨迹分配更高的权重,再用它们来训练扩散模型。
原则上,这让我们无需直接拿到目标分布的样本,也能优化前向 KL。
然而,重要性采样在高维空间中会变得越来越困难。大多数轨迹的权重可能小到可以忽略,最终只剩少数几个有效的训练样本。
这促使我们转向另一种做法:反向 KL。
反向 KL
与前者不同,反向 KL 的期望是在模型分布下取的:
这对无监督的扩散训练尤其有吸引力,因为即使无法直接从目标分布中采样,我们也可以从自己的模型中采样。
和之前一样,我们可以把 KL 提升到轨迹空间,利用数据处理不等式得到一个上界:
展开联合 KL,得到
这里,我们假设反向过程的初始噪声分布是固定的,从而把涉及 p(x_T) 的固定先验项吸收进了常数项。
回顾一下,
得到的目标包含三个直观的组成部分:
- L_{\mathrm{entropy}} —— 鼓励探索。 最大化每个反向转移的熵,可以防止模型变得过于确定,这与 soft RL 中的熵正则化类似。
- L_{\mathrm{forward}} —— 约束转移。 最大化前向加噪过程下的似然,会促使相邻状态与预设的噪声调度保持相容。对于高斯转移,在计入前向过程的均值和方差之后,这相当于对相邻状态之差施加二次惩罚。
- L_{\mathrm{target}} —— 优化最终样本。 最小化 -\log p(x_0) 等价于最小化能量 g(x_0),促使生成的样本集中在目标分布的高概率区域。
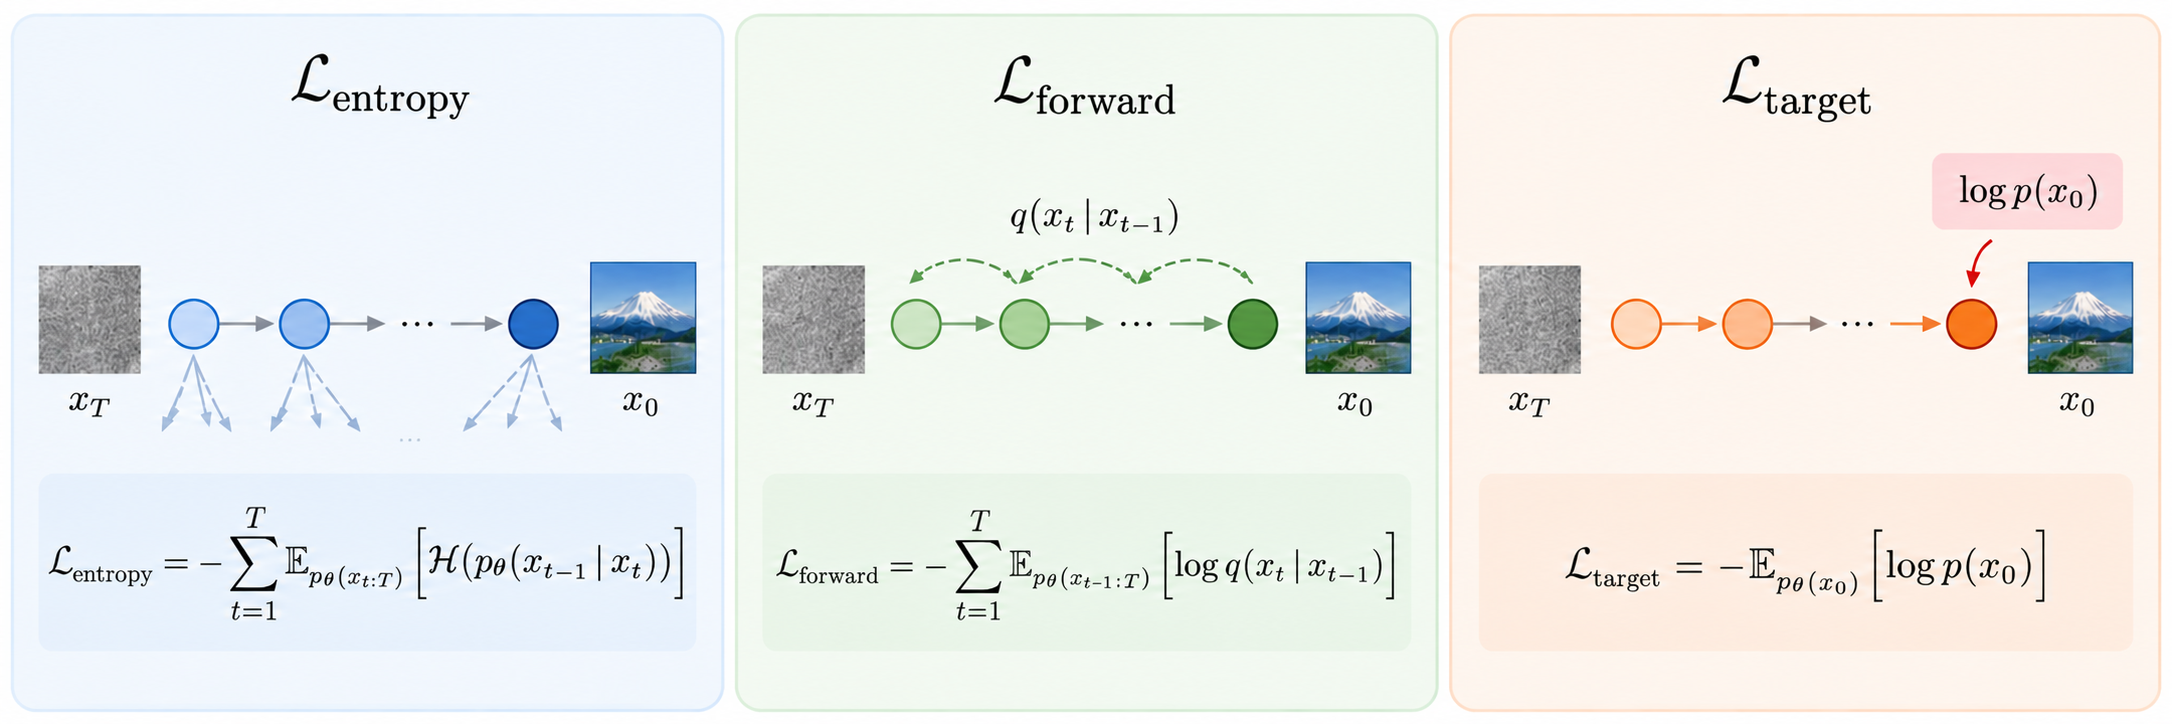
换句话说,反向 KL 把探索、转移正则化和最终样本优化结合在同一个目标中。
然而,优化这个目标并不简单——我们需要对 g(x_0) 这类项关于先前的状态求导。
一种通用的解决办法是使用 REINFORCE 之类的策略梯度方法,Sanokowski et al., 2024 对此做了探索。但这又把我们带回了强化学习中那些熟悉的问题:梯度估计方差高,以及在漫长的生成轨迹上做信用分配。
我们能否转而利用连续时间扩散过程的结构,更直接地优化生成轨迹?
这就引出了我们的最后一个视角。
视角三:随机微分方程(SDEs)
我们的最后一个视角或许也是最有力的一个:把扩散模型视为连续时间的随机过程。
当步长足够小的时候,迭代生成过程可以用随机微分方程(SDE)来描述。正如 Song 等人 所讨论的,前向加噪过程与反向生成过程都可以用 SDE 来表示:
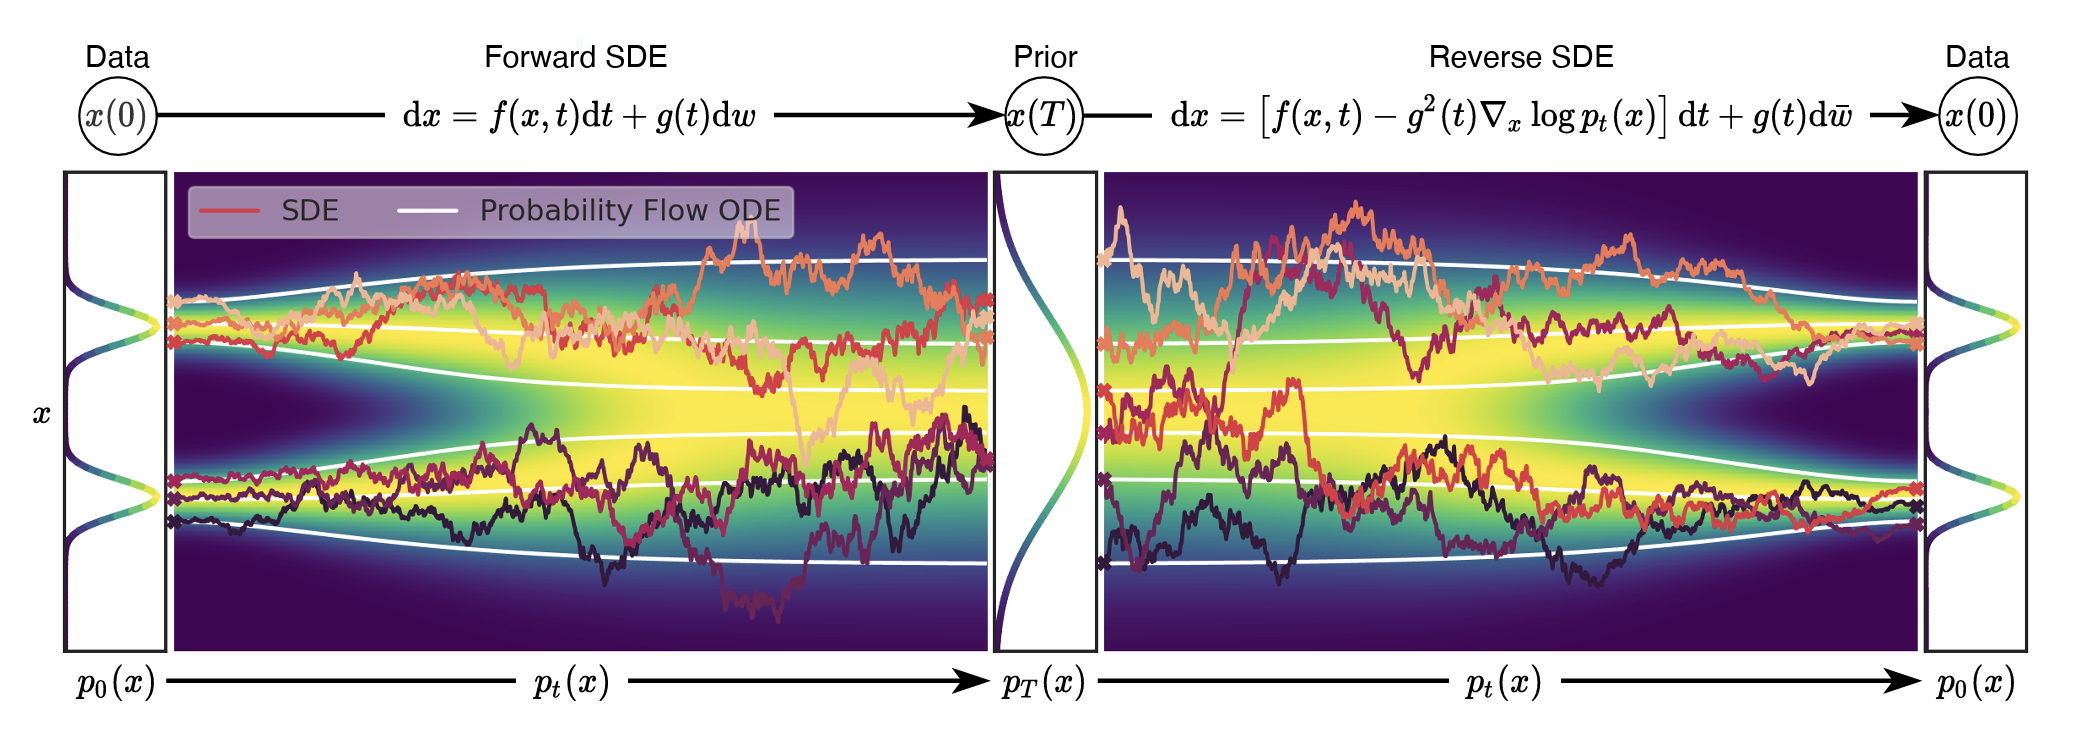
一个密切相关的连续时间视角是流匹配(flow matching),它学习一个确定性的常微分方程(ODE),在两个概率分布之间搬运样本。
本节我们将聚焦 SDE 这一表述,并说明随机最优控制如何提供一个自然的框架,使我们仅凭一个基于能量的目标就能训练扩散模型。
随机最优控制
让我们从最简单的 SDE 开始:
其中 w_t 表示标准布朗运动,\sigma_t 控制注入的高斯噪声的幅度。噪声调度 \sigma_t 通常是事先指定的。
若没有额外的漂移项,粒子就只是在空间中做随机游走,没有任何东西把它引向我们期望的目标分布。
我们把由此得到的轨迹分布记为 p_{\mathrm{ref}}(x_{0:1}),它充当我们的参考过程。
现在假设我们想把粒子引向代价低或奖励高的区域。可以引入一个可学习的控制 u_\theta(x_t,t) 来引导它的运动:
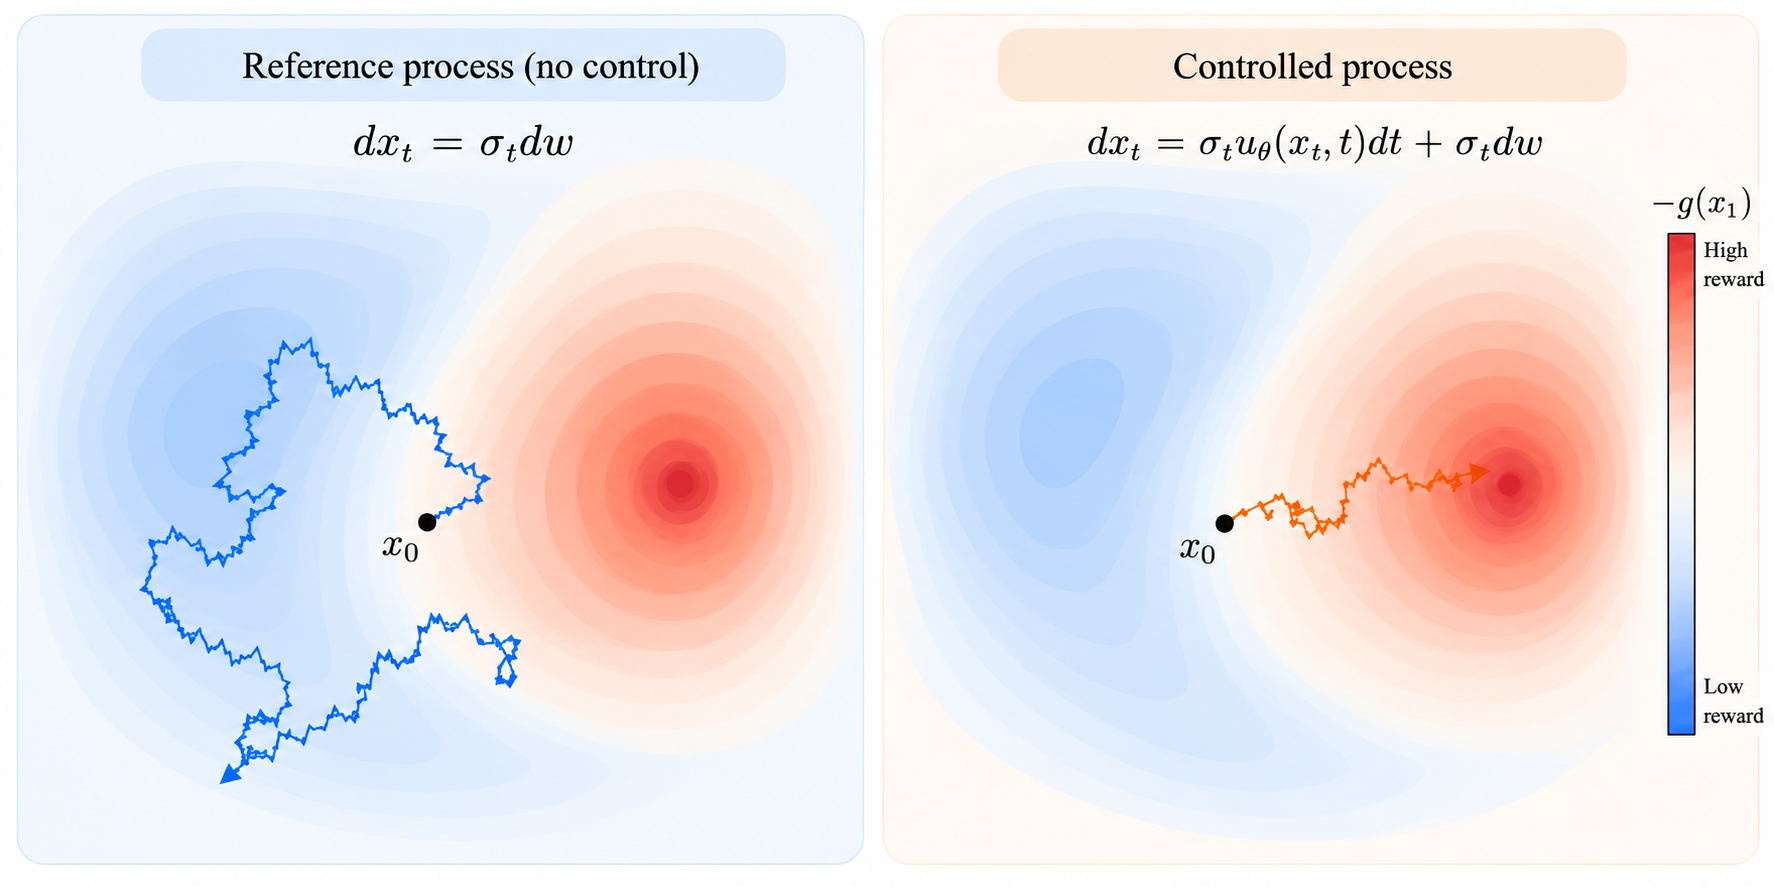
这个控制把轨迹分布从 p_{\mathrm{ref}}(x_{0:1}) 变为 p_{u_\theta}(x_{0:1})。
自然地,我们希望最小化期望终端代价,同时又不想让受控过程偏离参考过程太远。这就引出了**随机最优控制(SOC)**的目标:
这里我们假定受控过程与参考过程具有相同的初始分布和扩散系数。
由 Girsanov 定理,轨迹层面的 KL 散度可以写成控制量平方的期望:
于是 SOC 目标变为
积分项通常被解释为该过程的动能,也就是控制代价(control effort)。它有两层直观含义:
- 偏好较小的控制: 偏离参考动力学越多,代价就越高。对于简单的布朗参考过程,这会抑制不必要的大幅运动或快速变化的运动。
- 把控制分摊到时间上: 由于代价是二次的,在很短的时间区间内施加较大的控制,通常比把相同的总位移分摊到更长的时间区间上更昂贵。
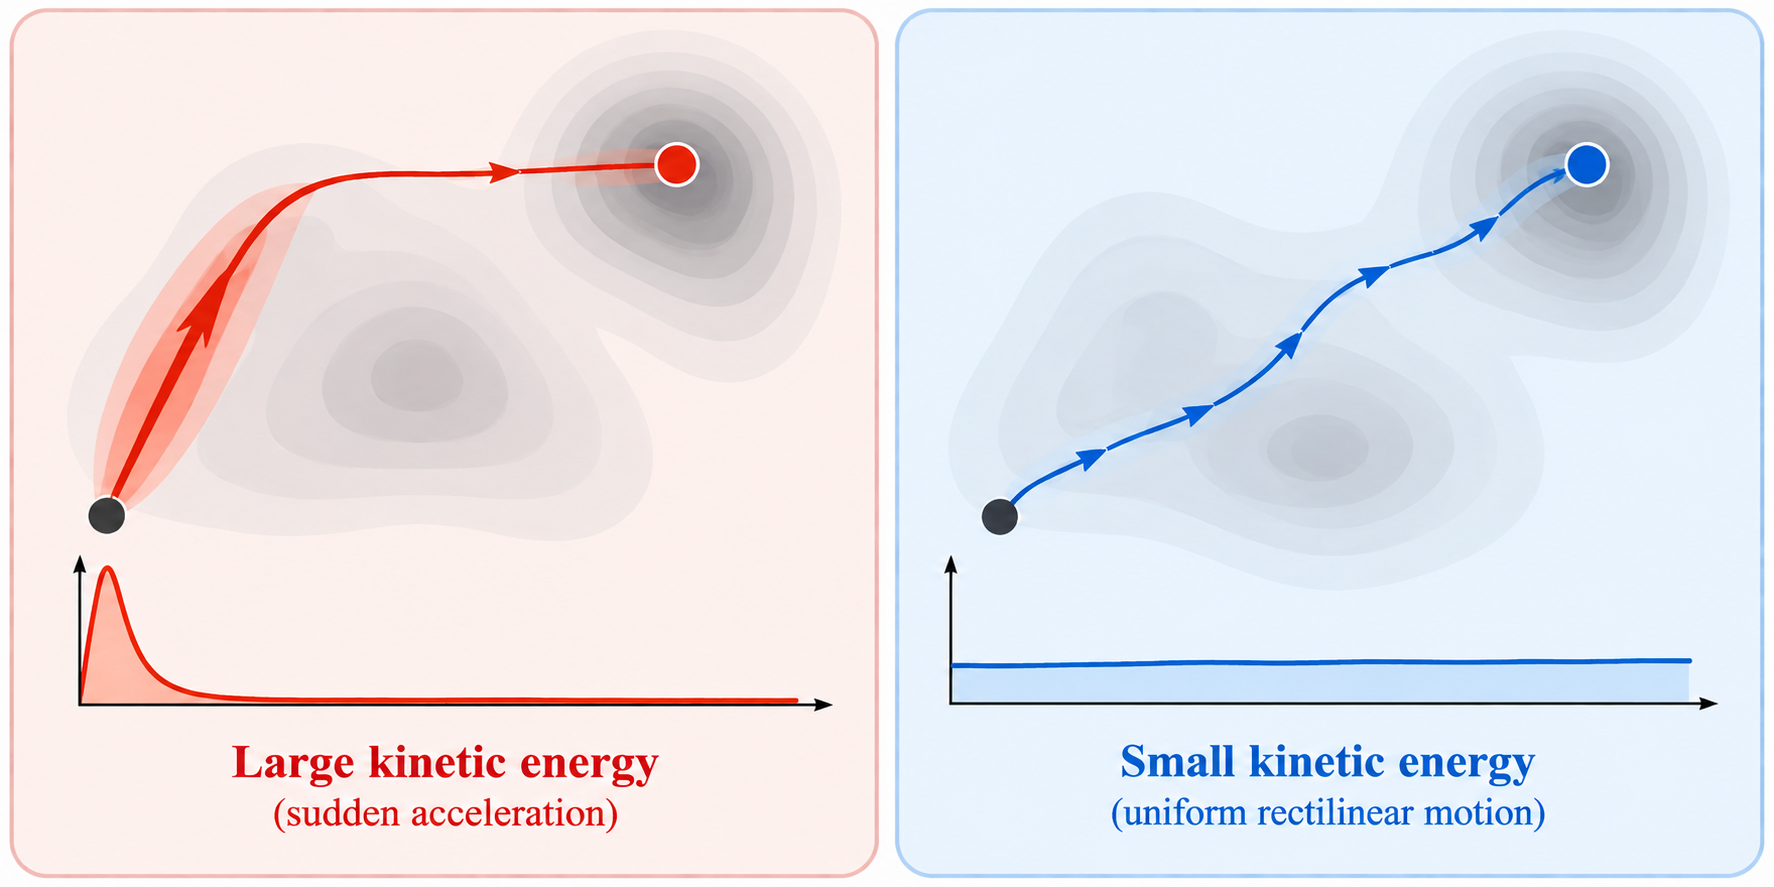
有趣的是,SOC 目标与视角二中推导出的反向 KL 目标十分相似。我们可以建立如下概念上的对应关系:
| 反向 KL(离散时间) | 随机最优控制(连续时间) | 含义 |
|---|---|---|
| L_{\mathrm{entropy}} | 包含在路径空间 KL 中 | 鼓励随机探索 |
| L_{\mathrm{forward}} | 包含在 \frac12\mathbb{E}_{u_\theta}[\int_0^1\Vert u_\theta(x_t,t)\Vert^2dt] 中 | 约束对参考过程的偏离 |
| L_{\mathrm{target}} | \mathbb{E}_{u_\theta}[g(x_1)/\beta] | 鼓励高质量的最终样本 |
在参考动力学与离散化的假设相容的情况下,离散时间的路径空间 KL 会收敛到相应的连续时间控制代价。
我们也可以引入一个预训练的漂移项 u_{\mathrm{ref}}(x_t,t) 来推广参考过程:
若受控过程以 u_\theta(x_t,t) 作为其总的漂移系数,则 KL 正则项变为
解释很直接:我们惩罚的是偏离预训练动力学所需的额外控制,而不是整个漂移项。
伴随方法
建立 SOC 表述,并不能直接解决我们在反向 KL 目标上遇到的优化难题:如何才能高效地让终端代价穿过一条很长的随机生成轨迹传播出去?
这正是伴随方法(adjoint method)的用武之地。
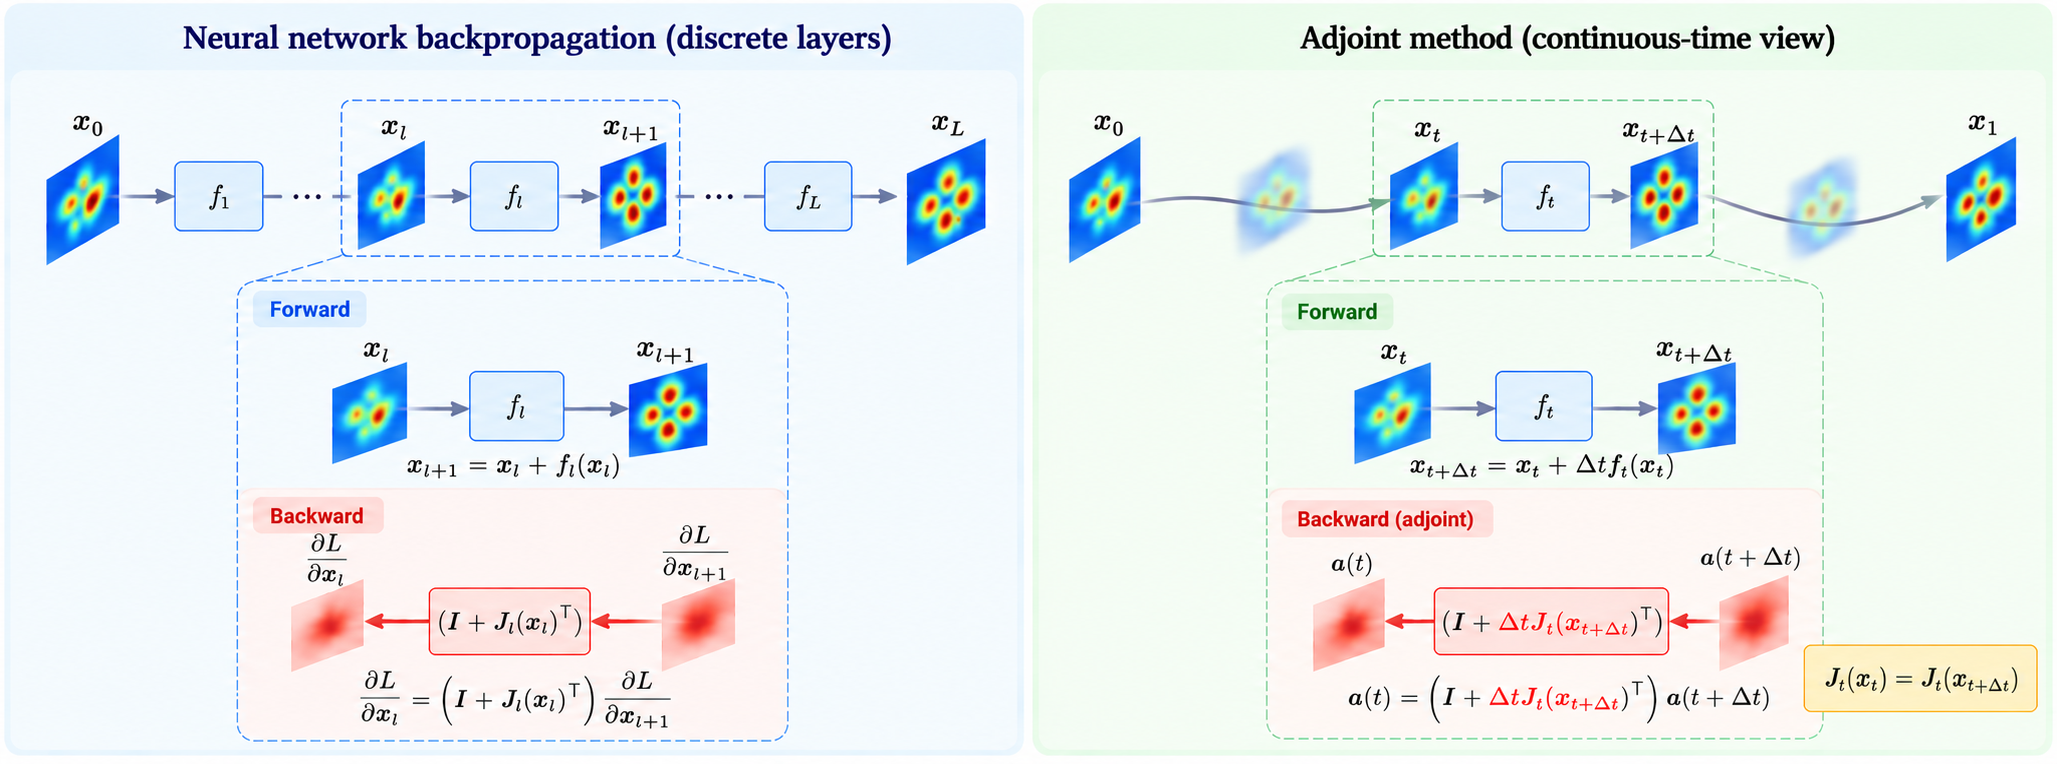
从高层看,伴随方法可以理解为推广到连续时间动力学上的反向传播,额外的好处是:中间状态有时可以通过反向积分重建,而不必把每一个状态都存下来。
为了建立一些直觉,先考虑一个残差网络层:
其反向递推为
标准反向传播通常会存储中间激活 x_l,用来计算雅可比矩阵 \nabla_x f_l(x_l)。
现在考虑一个连续时间的 ODE:
它离散化后的前向更新为
相应的反向递推近似为
当 \Delta t\to0 时,它就变成连续时间的反向微分方程。
计算上的关键差别在于:对于一个足够良态、可逆的 ODE 流,我们可以通过沿时间反向求解动力学来重建中间状态,而不必存储每一次前向的激活。
这正是伴随方法在内存上的潜在优势,不过数值重建会引入误差,而随机轨迹还需要额外的处理。
现在回到我们的 SOC 目标:
为简洁起见,讨论控制函数时我们用 u 代替 u_\theta。
给定在控制 u 下生成的一条轨迹 x_{0:1},我们定义伴随状态 a(t) 为剩余轨迹代价对当前状态的敏感度:
其中梯度是沿未来轨迹求得的,并保持未来的布朗增量固定不变。
对于我们受控的动力学
伴随状态满足反向 ODE
终端条件为
伴随状态告诉我们:如果对当前状态做轻微扰动,剩余代价会变化多少。
但这如何给出关于控制的梯度?
回顾一下,控制是通过 \sigma_t u(x_t,t) 影响状态动力学的。在一个很小的时间区间 \Delta t 内,扰动 \delta u 使下一个状态产生的变化约为
因此由链式法则,未来代价对控制梯度的贡献是每单位时间 \sigma_t a(t)。
把它与即时的控制代价合并,我们得到
其中这个表达式表示逐条轨迹的泛函梯度贡献,尚未对轨迹取相应的期望。
这引出如下目标:
这里,在对 \theta 求回归损失的导数时,采样得到的轨迹与伴随目标都被视为固定量。
换句话说,伴随方法让我们可以沿轨迹反向传播敏感度,从而计算未来代价对控制的梯度。
然而,计算伴随状态仍然需要在每个时间步上计算雅可比矩阵 \nabla_x u(x_t,t),这对大型神经网络来说可能昂贵到难以承受。
这促使我们做进一步的简化。
伴随匹配
Adjoint Matching(伴随匹配)背后的关键观察是:最优控制满足一个特殊的一致性条件。
回顾一下:最优控制必须在即时的控制代价与它对期望未来代价的影响之间取得平衡:
这是关于控制的一阶最优性条件。
可选:最优性条件的直观推导
我们先定义最优未来代价:
时刻 t 的控制会影响目标函数中的两项:
- 即时代价: \frac12\Vert u(x_t,t)\Vert^2\Delta t。
- 未来代价: \mathbb{E}_{x'}[V_{t+\Delta t}(x')]。
将这两项合并,得到
在最优处,\nabla_u J_t(u)=0。
为计算该梯度,回顾状态转移服从
由链式法则,
当 \Delta t\to0 时,假设足够光滑,
将其代入 \nabla_u J_t(u)=0,可得
这就是最优控制条件。
由于在最优处,值函数的梯度等于轨迹伴随状态的条件期望,
我们便重新得到
现在看看这个条件对反向伴随方程意味着什么。
将最优性条件乘以 Jacobian \nabla_x u^*(x_t,t),得到
注意,期望内部的表达式正是完整伴随状态的反向 ODE 中出现的那一项。
因此,在最优处,完整伴随状态的漂移项的条件期望为零。
这并不意味着 a(t) 在每条随机轨迹上都保持不变。它实际说明的是:在构造更简单的回归目标时,可以把这些项去掉,而不会改变我们想要的最优控制。
由此引出精简伴随(lean adjoint) \tilde a(t),其反向 ODE 只包含无控制参考漂移项的导数,以及可能存在的额外运行状态代价。
在我们这个简单的布朗参考设定中,两者均为零,因此
终端条件为
因此,
由此得到的**伴随匹配(Adjoint Matching)**目标函数非常简洁:
同样,在对此回归目标求导时,采样得到的轨迹与终端梯度目标都被视为固定量。
该如何理解这个目标函数?
形式上看,这是最优控制的一种基于回归的不动点表述。在伴随匹配分析所依赖的假设下,当采样分布与目标随当前控制一致地更新时,最优控制是期望回归目标的唯一临界点。
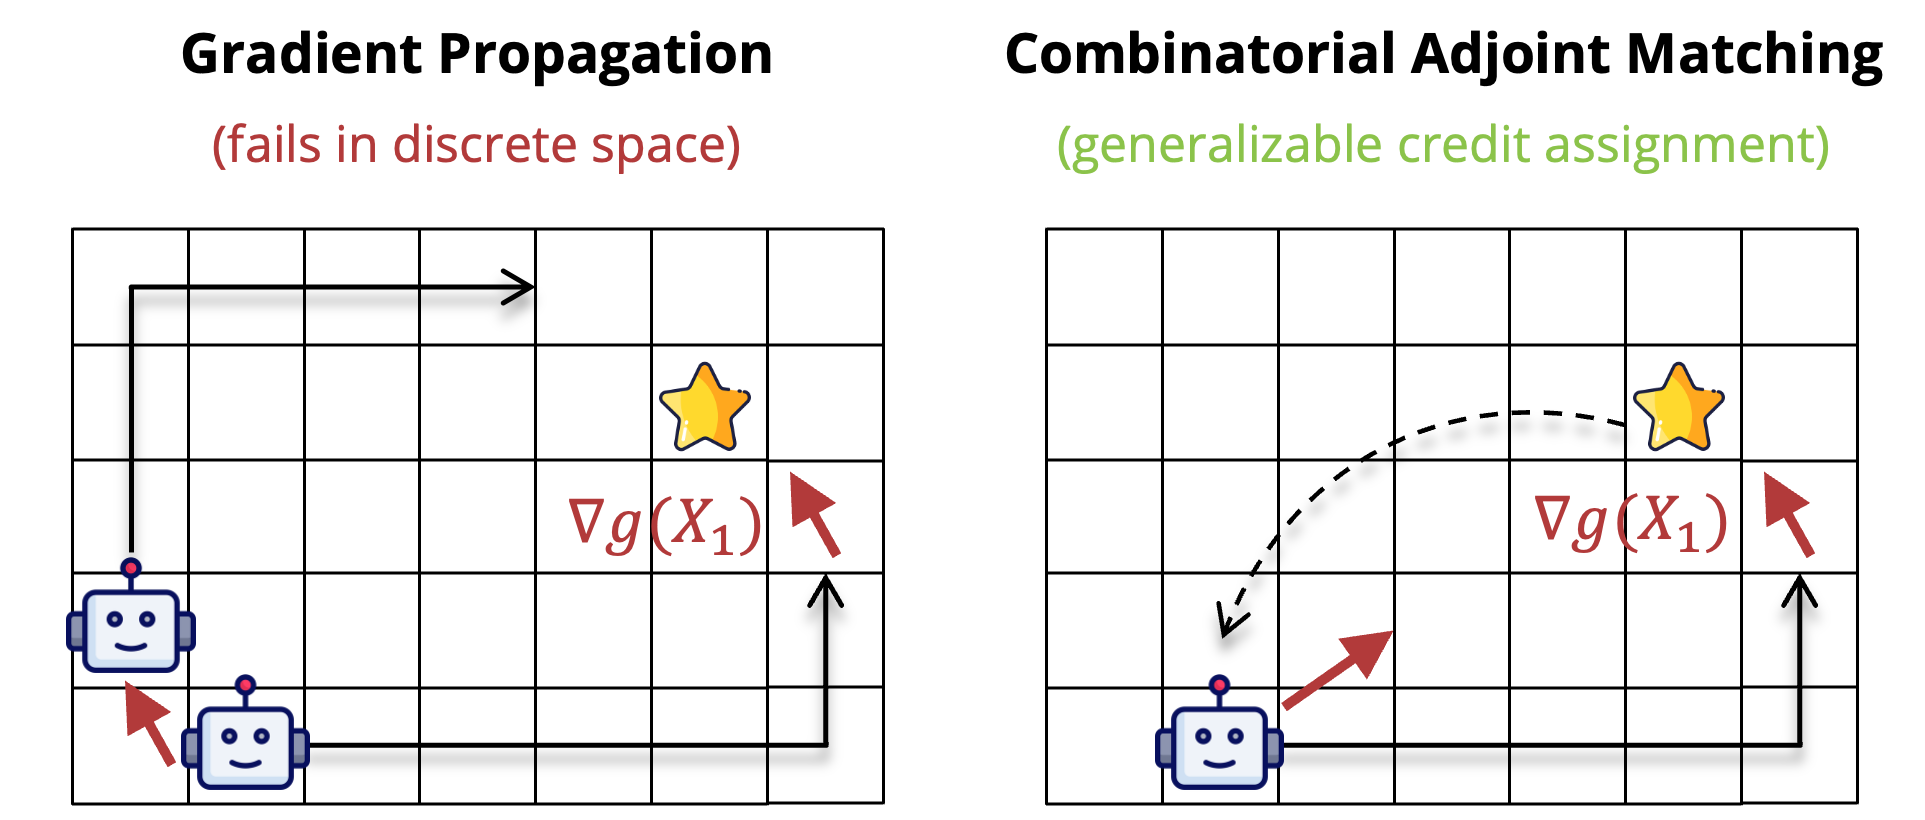
我个人的理解更直观一些:我们用终端状态上期望的更新,去引导每一个中间状态上的控制。
我们不必在每一个扩散步上把终端代价显式地通过整个神经网络反向传播,而是让每一处局部控制去匹配一个由终端梯度构造出的目标。
在把伴随匹配推广到其他设定(包括离散状态空间)时,这种理解尤其有用。
在我早先的工作中,我提出了 Combinatorial Adjoint Matching (CAM),它把这一想法推广到组合优化,同时处理离散转移带来的不可微问题。整体思路如下图所示:
最后的问题是:
如何得到 \nabla g(x_1)?
我列举几种做法:
- 最简单的情形是 g(\cdot) 本身可微,例如一个神经网络或一个可微的目标函数;
- 如果存在某种局部搜索启发式,我们可以借助它找到局部改进的解,CAM 即采用了这种做法;
- REINFORCE 是另一种选择,RAM 就引入了这种方法。
- 最后,与正向 KL 类似,我们也可以依靠采样方法来估计最优控制,DAM 做了这样的尝试。
案例研究(最大独立集)
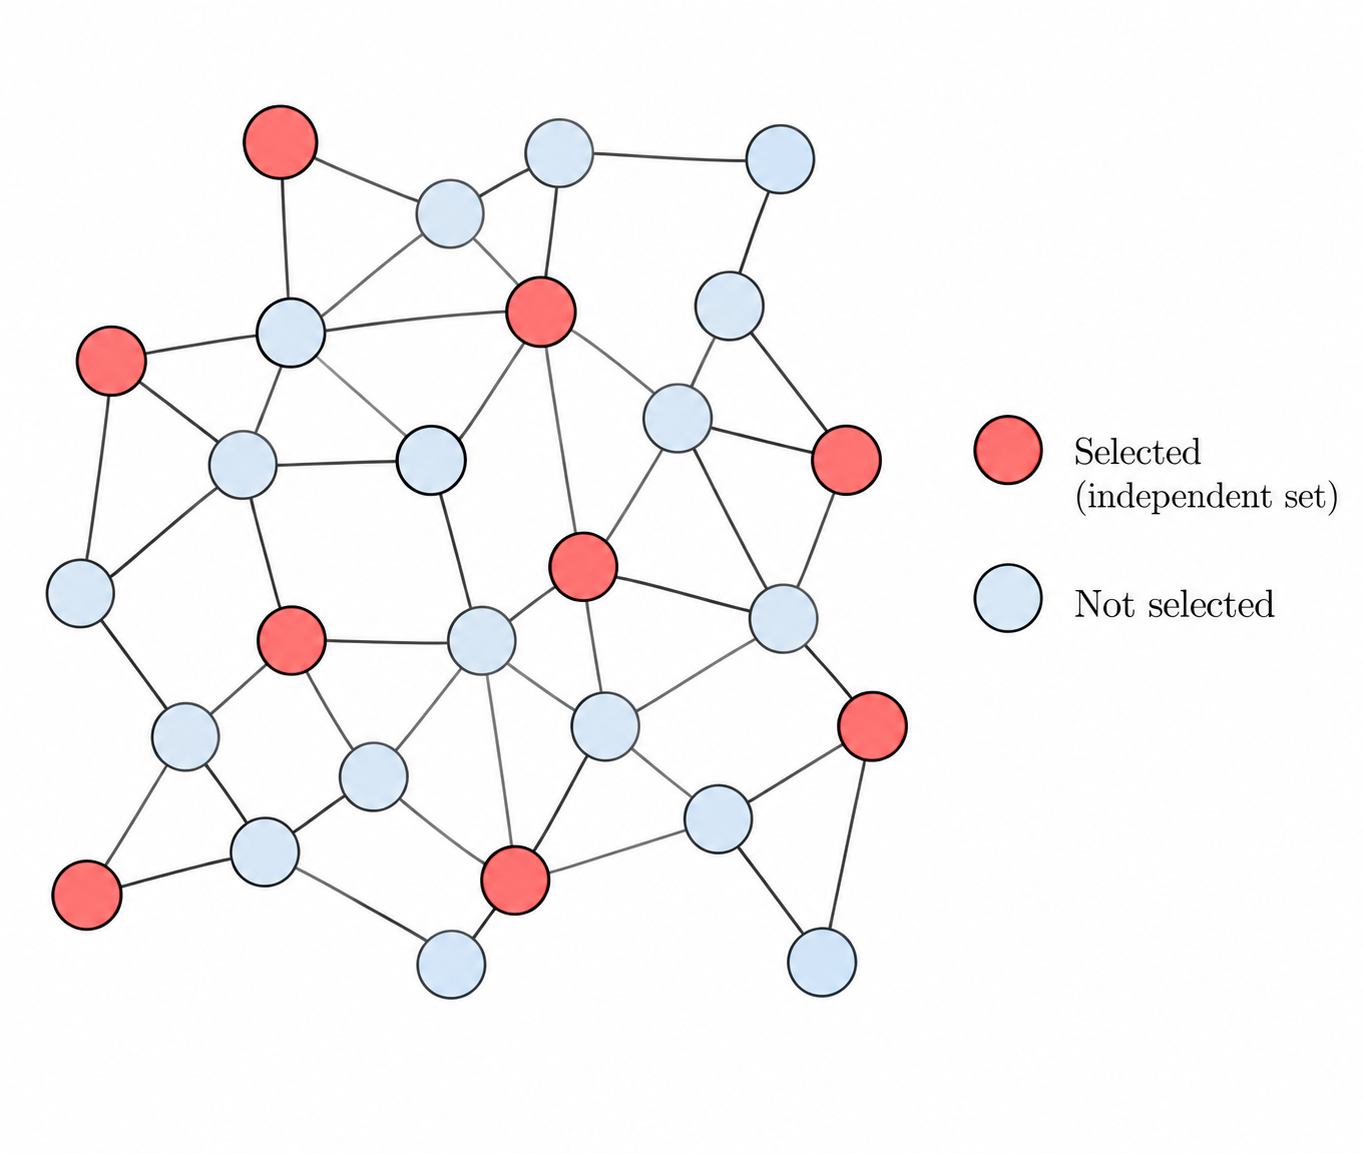
作为具体例子,我们来看最大独立集(MIS),一个经典的组合优化问题。给定图 G=(V,E),目标是在不选择任何两个相连顶点的前提下,选出尽可能多的顶点。
MIS 可以写成关于二值变量 x_i\in\lbrace0,1\rbrace 的简单二次目标,其中 x_i=1 表示顶点 i 被选中:
其中 \lambda>1 用于惩罚同时选中相邻顶点。尽管目标简单、局部结构强,MIS 仍是一个困难的离散优化问题。
下面我们比较本博客中讨论的几种扩散训练方法:
结果表明,对于局部结构较强的问题,由最优解出发的有监督扩散未必优于无监督训练。具体而言,基于 Langevin 的方法可以通过利用目标函数中的局部信息取得有竞争力的表现,而伴随匹配在参与比较的方法中取得了最低的最优性差距。
这也印证了我们的核心结论:扩散过程的结构,为超越通用强化学习方法的、高效的无监督训练提供了机会。
结论
我们考察了看待扩散模型的三种视角,每一种都提供了不同的无监督训练途径:
- Langevin 动力学: 把全局轨迹优化分解为更简单的局部转移优化。
- 隐变量链: 给出一般的概率表述,不过优化时可能仍需借助强化学习的技术,例如 REINFORCE。
- 随机微分方程(SDE): 利用连续时间动力学与伴随方法,把终端目标高效地传播通过整个生成过程。
扩散模型的特殊之处在于:
所有中间状态都位于同一空间,且相邻状态通常彼此相似。
这种结构让我们可以利用局部转移、平滑的动力学以及相邻状态之间的关系,而不是把生成看成任意的一串决策。
我认为,利用这种结构,是开发超越通用 RL 方法的高效无监督扩散训练算法的关键。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册