作者:Kaichen Zhou
青稞社区为科研人员提供成果宣传支持,如有优秀研究成果分享推广,欢迎投稿联系:aiFreeCode
每任务 24 条参考轨迹,只引导一个内部特征,动作模型权重保持冻结。 在三项真实机器人任务上,SteerAct 将平均成功率从 31.1% 提升至 52.2%:增加 21.1 个百分点,相对提升约 68%。 少量执行经验,通过模型内部的一项特征,转化成了可测的操作收益。
斯坦福大学李飞飞与 MIT(麻省理工学院)团队,联合哈佛大学、帝国理工学院、西北大学及普林斯顿大学研究者提出 SteerAct。团队把机器人适配的着力点放在执行过程:从成功和失败轨迹中找到可用的内部方向,再让干预跟随当前操作动态变化。
论文:SteerAct: Unlocking Action Models through Few-Shot Temporal Steering
链接:https://arxiv.org/abs/2610.25632
项目主页:https://steeract.github.io
代码仓库:https://github.com/kaichen-z/SteerAct
作者:Kaichen Zhou、Zhiyan Li、Chongkai Gao、Yuhan Wang、Wenlong Huang、Maggie Wang、Fangneng Zhan、Manling Li、Qianqian Wang、Mac Schwager、Zhuang Liu、Li Fei-Fei(李飞飞)、Mengyu Wang、Paul Pu Liang。Kaichen Zhou 与 Zhiyan Li 为共同第一作者,Mengyu Wang 与 Paul Pu Liang 为共同指导作者。
推方块、叠布、杯间转移乒乓球,每一次操作都可能因过程中的偏差而失手。SteerAct 为预训练动作模型接入一个会看时机的“内部方向盘”:借助预训练稀疏自编码器(SAE)选出任务相关特征,根据其激活变化决定何时增强、何时减弱、何时保持不变。部署时,动作模型与 SAE 均不更新权重,也无需额外训练强化学习控制器。
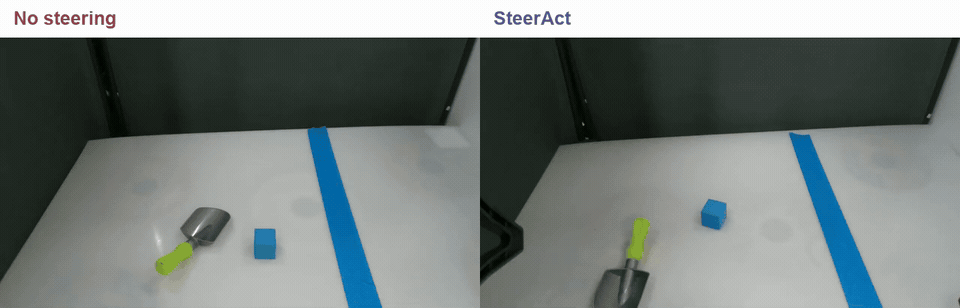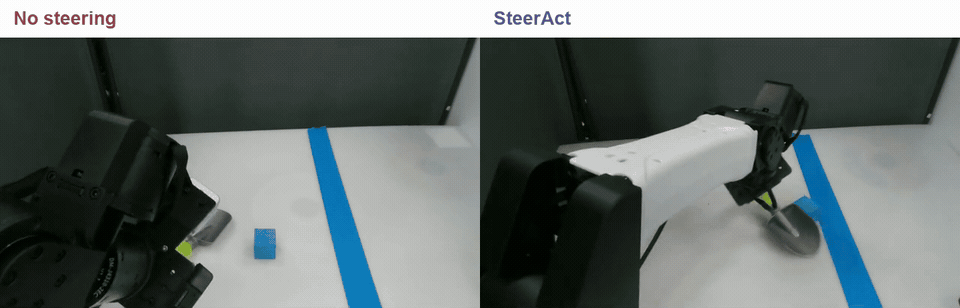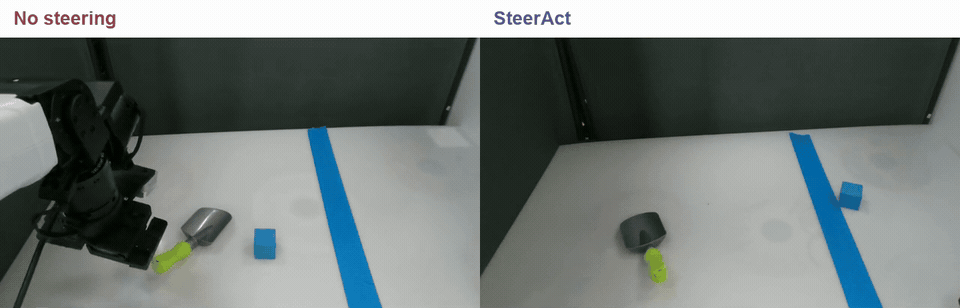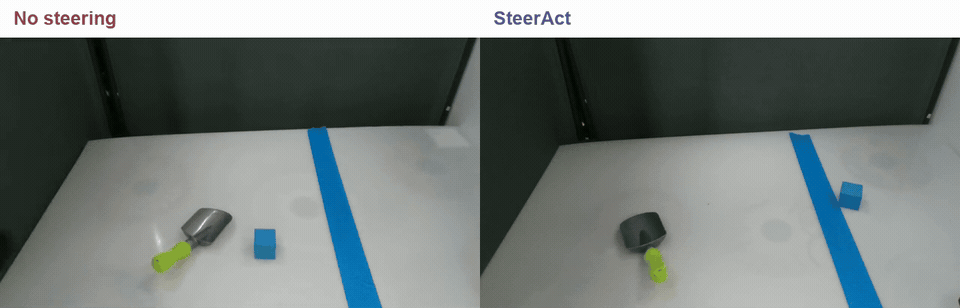
真实机器人推方块:未经引导与 SteerAct 的执行对比。
效果还延伸到仿真中的夹爪与灵巧手操作。覆盖 π0.5 和 Fast-WAM 两种骨干、RoboTwin 2.0 和 DexJoCo 两类基准,SteerAct(Enc)在 36 个任务与骨干组合中的 34 个提高成功率,四组基准与骨干设置的平均成功率均为所比较方法中最高。每个任务各选一个特征,同一套时序引导流程贯穿全部设置。
从模型内部的时间变化中寻找干预入口
预训练动作模型内部包含大量随观察和动作变化的激活。激活引导提供了一个调整入口:沿特定方向修改隐藏状态,可以影响后续动作生成,同时保留原有模型权重。但真正困难的部分,是从众多内部特征中选出有用的一项,并在恰当时刻施加恰当幅度的修正。
只比较激活的平均强度,可能会漏掉关键差别。同一个特征在成功和失败轨迹里,平均值可以很接近,变化顺序却不同:一段时间内是持续上升,还是先升后降,可能提供额外的结果线索。SteerAct 因此把注意力放在特征的局部时序模式上。
它使用一个跨任务共享的预训练稀疏自编码器(SAE),将模型隐藏激活分解成稀疏特征。每项特征都有一条随执行变化的激活轨迹,以及一个可用于干预的解码方向。SAE 提供候选方向,参考轨迹则帮助确定当前任务应该关注哪一项。
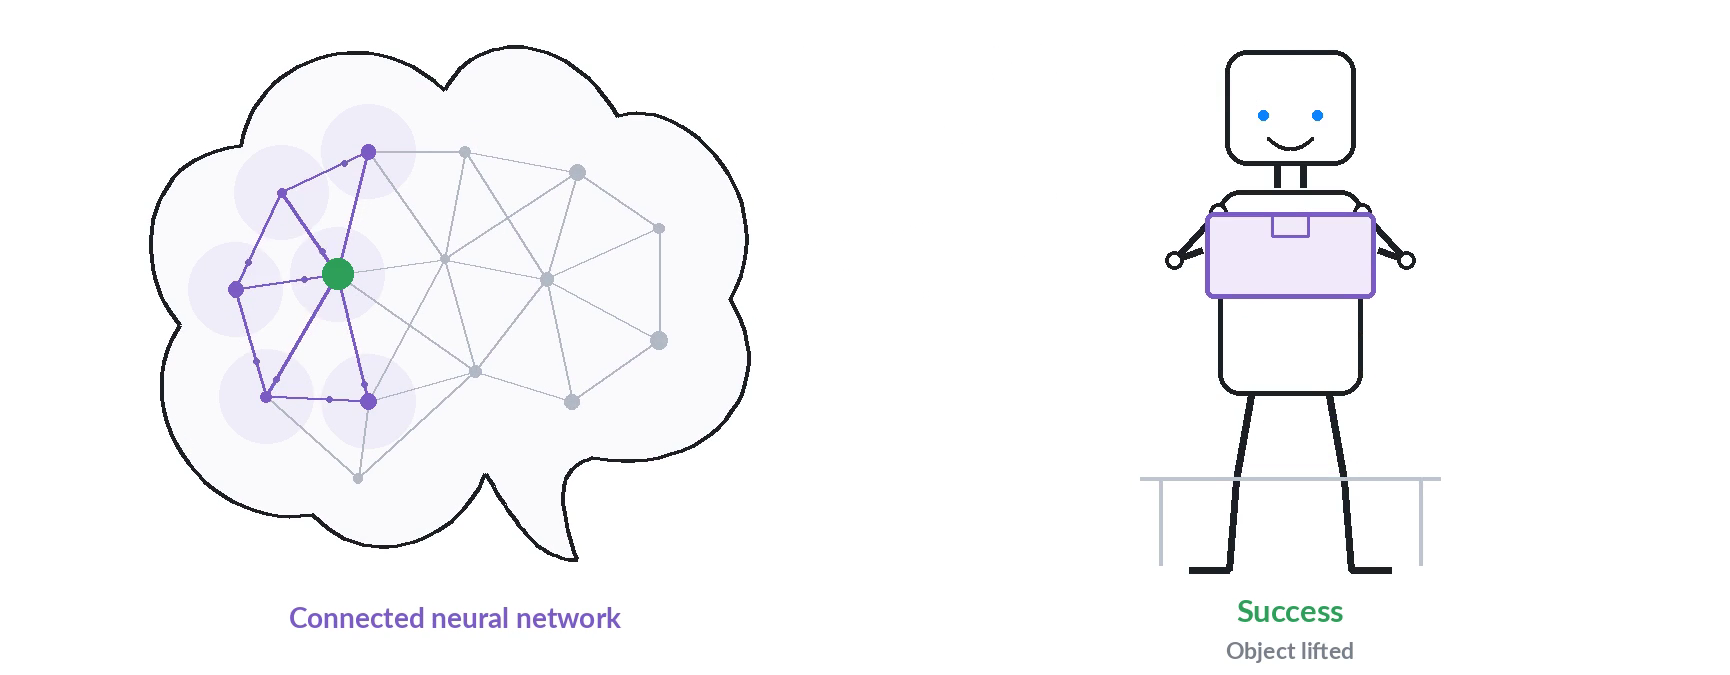
成功:物体被提起,任务完成(机制示意)。
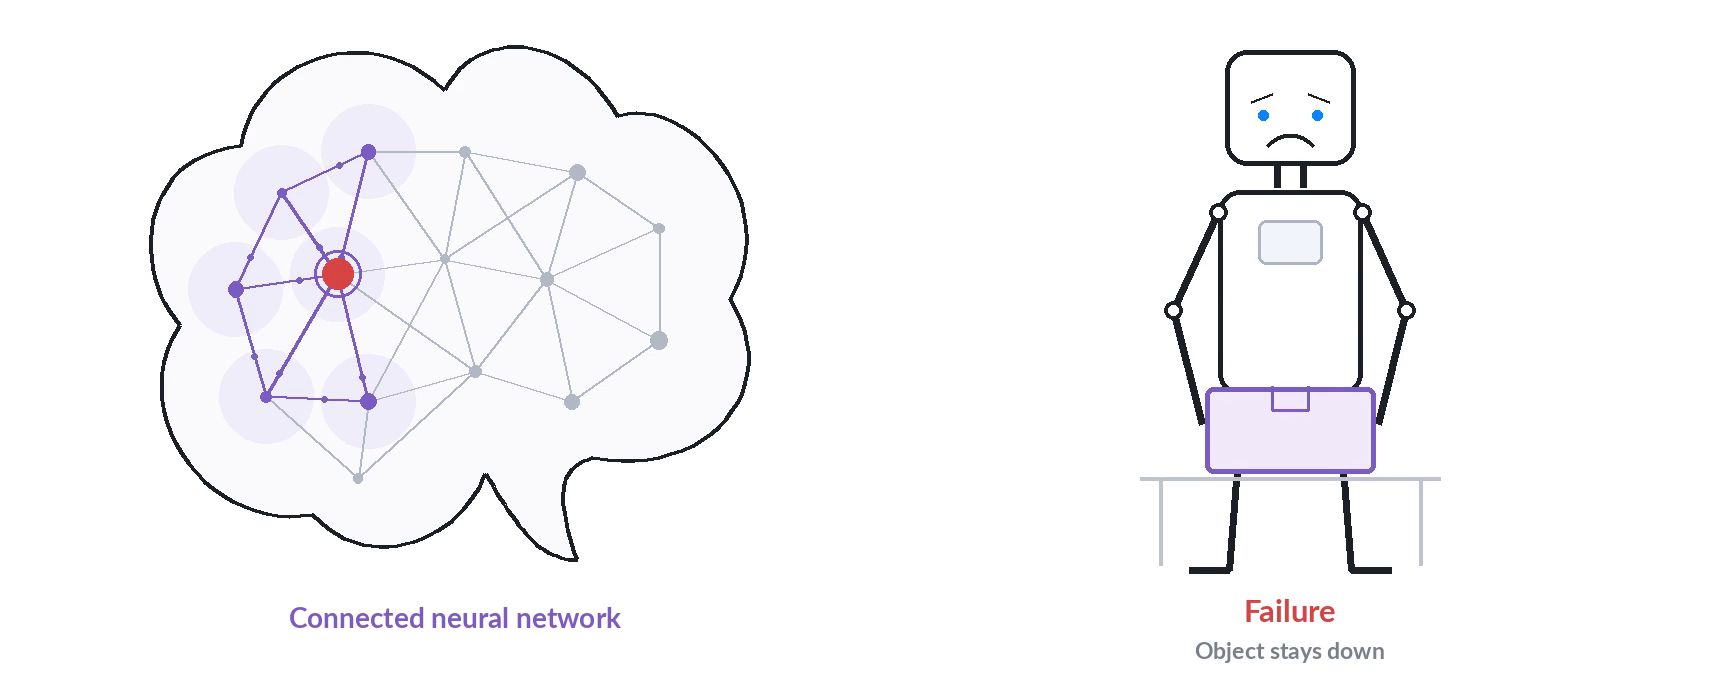
失败:物体未被提起,任务未完成(机制示意)。
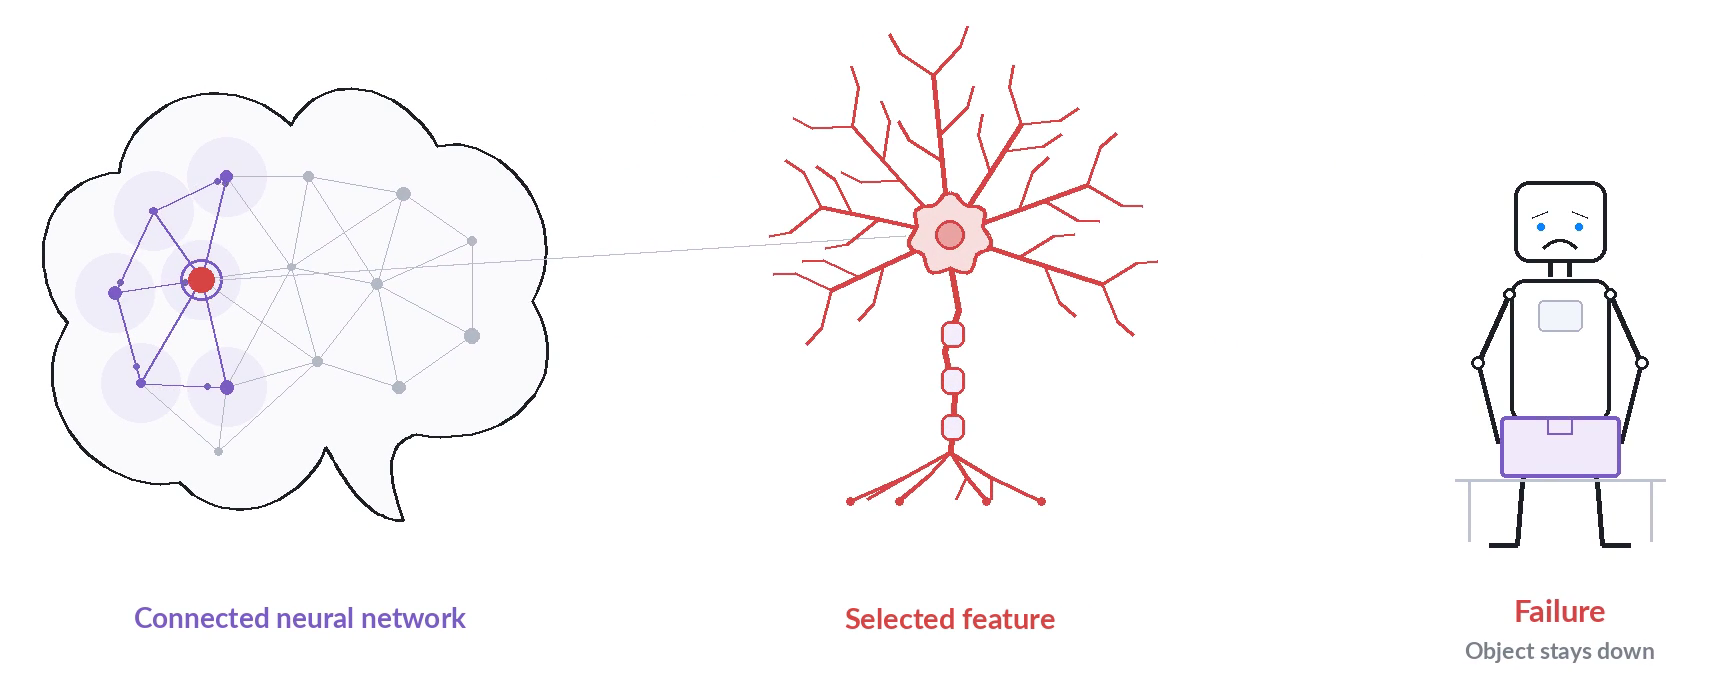
Identify neuron:从模型内部定位待引导特征(机制示意)。
18 维时序描述连接特征选择与执行干预
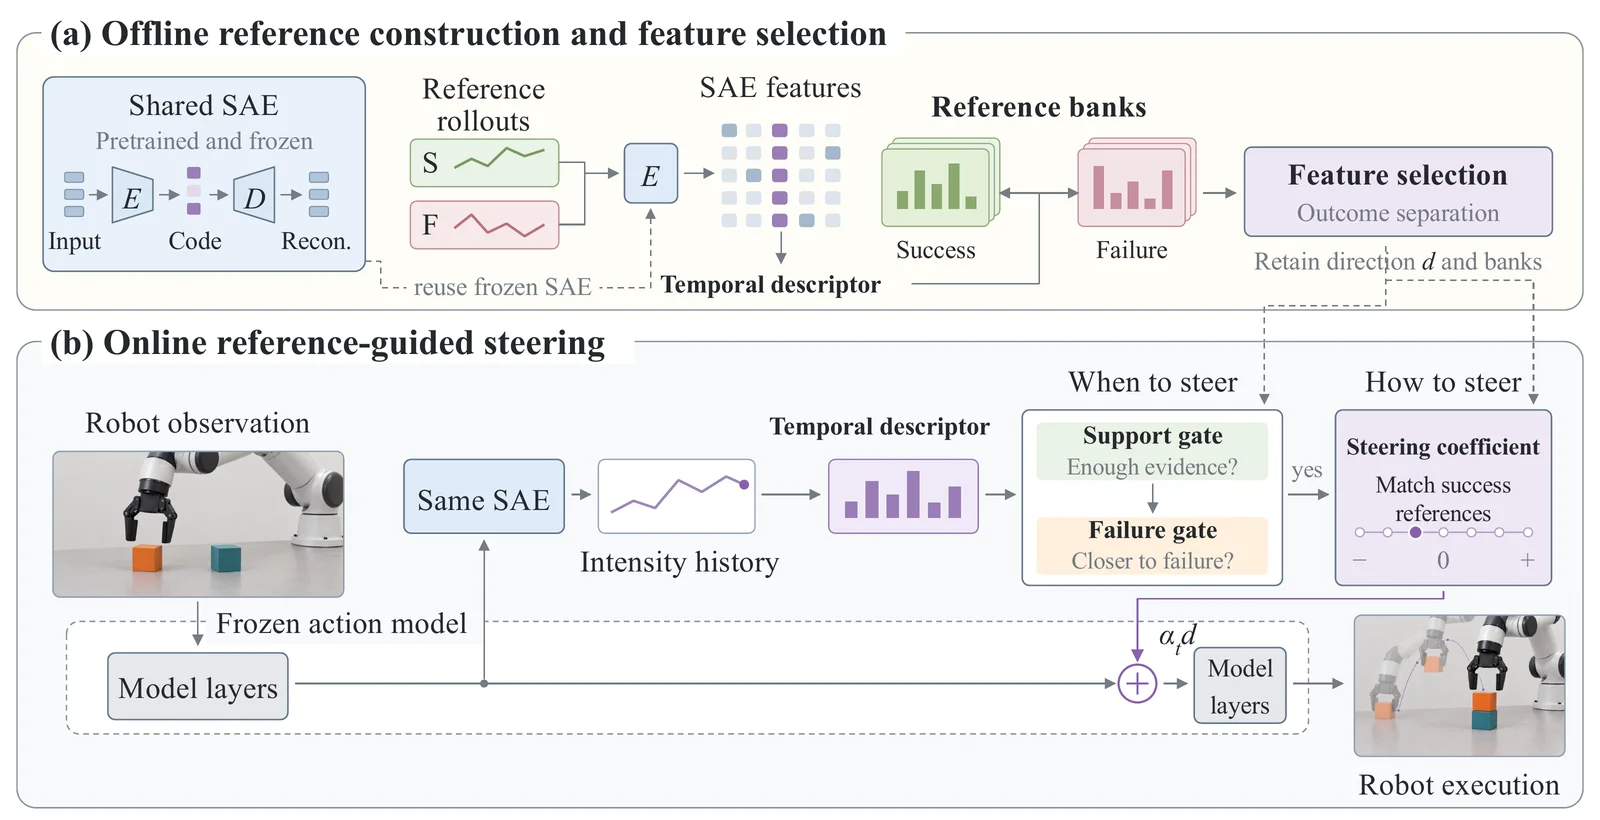
SteerAct 方法总览:离线选择任务特征并构建成败参考库,在线根据时序证据决定干预时机与强度(论文 Figure 3)。
先把激活变化转成可以比较的模式
SteerAct 从特征激活历史中取出连续或间隔采样的三个值,记录它们的相对大小顺序。三个值共有六种排序模式。系统统计各模式出现的频率,再加入熵、并列值比例和可用性标记,在两种采样间隔下形成一个 18 维时序描述符。
这样,长度不同、执行进度不同的历史可以用同一种表示比较,无需把两次操作的每个时间步一一对齐。完整参考轨迹、当前已经观察到的执行前缀,以及候选修正后的历史,都进入同一个描述空间。
离线挑出最能区分成败的一个特征
对每个候选特征,系统把参考轨迹的描述符分为成功库和失败库。选择标准同时考虑两类之间的距离,以及各类内部的变化程度:成功与失败越能分开、同类轨迹越集中,特征得分就越高。最终只保留得分最高特征的解码方向及两组参考库,供部署时使用。
这里的“一个特征”是每个任务各自选择一个。不同任务可以选到不同特征;跨任务共享的是预训练 SAE 和这套选择、比较、干预流程。
两道门控让干预跟上执行节奏
机器人开始执行后,SteerAct 只用截至当前已经观察到的激活历史做判断。系统先经过两道门控,避免仅凭一次波动就修改动作模型。
Support Gate 先检查当前历史是否支持可靠比较。 如果轨迹太短,模式频率还不稳定,或者当前模式缺少参考样本支持,就暂不启用干预。系统通过对模式分布采样,估计有多少可能的描述符能得到参考库支持。
Failure Gate 再检查当前模式是否更接近失败。 通过支持检查后,系统分别计算当前描述符与成功库、失败库的距离。只有更靠近失败库时,才满足这道门的开启条件。两道门都要求连续检查通过或不通过后才切换状态,减少频繁开关。
当两道门同时打开,SteerAct 在有界候选集合中搜索引导系数。候选值包括正数、负数和零;系统用局部响应近似,选择预测描述符最接近成功库的系数,再沿固定解码方向修改隐藏状态。没有同时满足两道门控条件时,系数为零。
这一设计把引导落实为逐次决策:特征方向固定,引导系数随执行历史变化。增强、减弱和保持不变都进入候选范围,让一次离线选择能够支持执行过程中的不同调整。
36 个评估组合中 34 个提升
四组平均成功率领先
研究在 RoboTwin 2.0 的九项夹爪任务和 DexJoCo 的九项灵巧手任务上,分别评估 π0.5 与 Fast-WAM,共形成 36 个任务与骨干组合。默认使用每任务 24 条带成败标签的参考轨迹,每种方法在每项任务上使用 200 条留出轨迹评估。
| 仿真基准 | 冻结骨干 | 未经引导 | SteerAct Enc | 增益 |
|---|---|---|---|---|
| RoboTwin 2.0 | π0.5 | 69.0% | 77.7% | +8.7 个百分点 |
| RoboTwin 2.0 | Fast-WAM | 69.3% | 78.6% | +9.2 个百分点 |
| DexJoCo | π0.5 | 62.3% | 71.9% | +9.6 个百分点 |
| DexJoCo | Fast-WAM | 23.3% | 26.8% | +3.4 个百分点 |
表 1 四组设置的任务平均成功率。Enc 表示在编码器分支施加引导。每组均平均九项任务,增益按舍入前数值计算。来源:论文 Table 1。
SteerAct(Enc)在四组设置中均获得所比较方法里的最高平均成功率。任务层面,RoboTwin 2.0 的 18 个任务与骨干组合全部提升,两类基准合计 34 个组合提升。仍有两个例外:Fast-WAM 在 Click Mouse 上从 7% 降至 5%,在 Hanoi Bi 上仍为 0%。
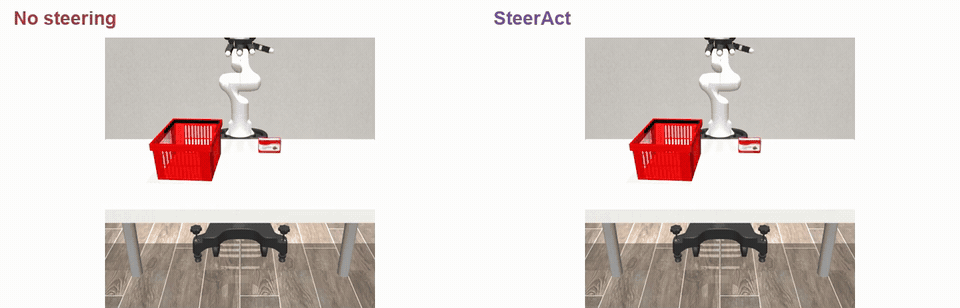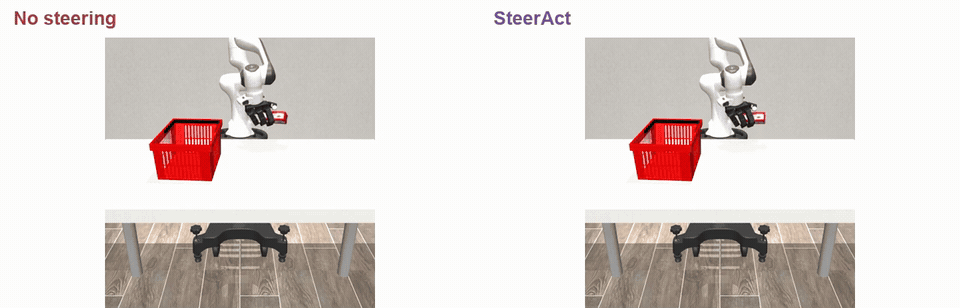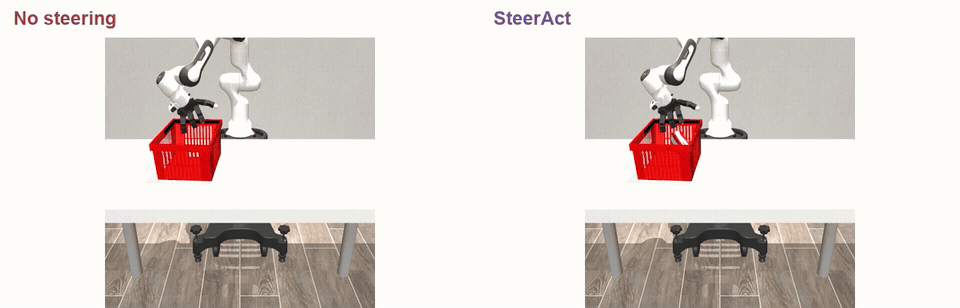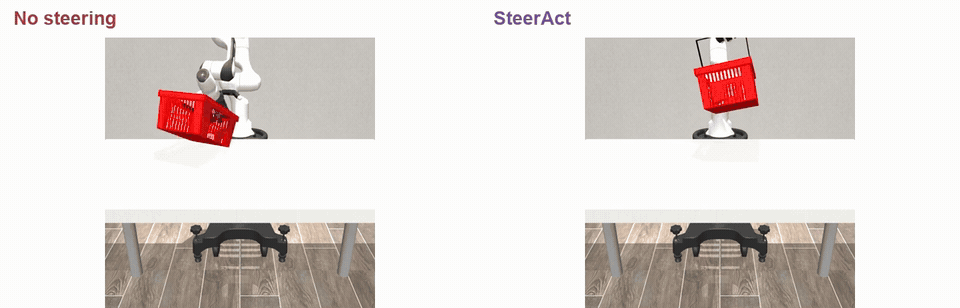
从夹爪到灵巧手:DexJoCo 提桶任务中的执行对比。
真实机器人平均成功率相对提升约 68%
在 I2RT YAM 真实机器人上,研究团队保持 π0.5 权重冻结,测试叠布、杯间转移乒乓球和推方块。每种方法在每项任务上进行 30 次试验,SteerAct(Enc)三项成功率均为所比较方法中最高。平均成功率由 31.1% 升至 52.2%,21.1 个百分点的绝对增益,对应约 68% 的相对提升。
| 真实机器人任务 | 未经引导 | SteerAct Enc | 增益 |
|---|---|---|---|
| 叠布 | 33.3% | 53.3% | +20.0 个百分点 |
| 杯间转移乒乓球 | 40.0% | 63.3% | +23.3 个百分点 |
| 推方块 | 20.0% | 40.0% | +20.0 个百分点 |
| 三项任务平均 | 31.1% | 52.2% | +21.1 个百分点 |
表 2 真实机器人成功率。平均值对三项任务等权计算。来源:论文 Table 2;试验次数见项目主页。
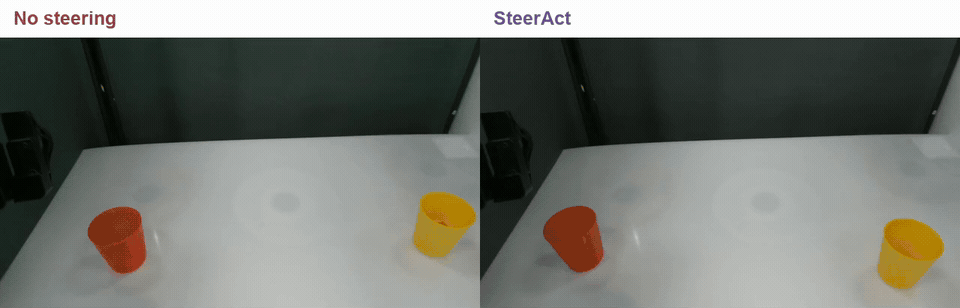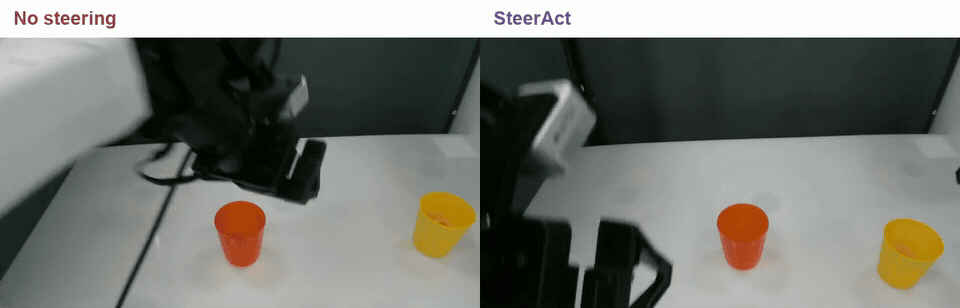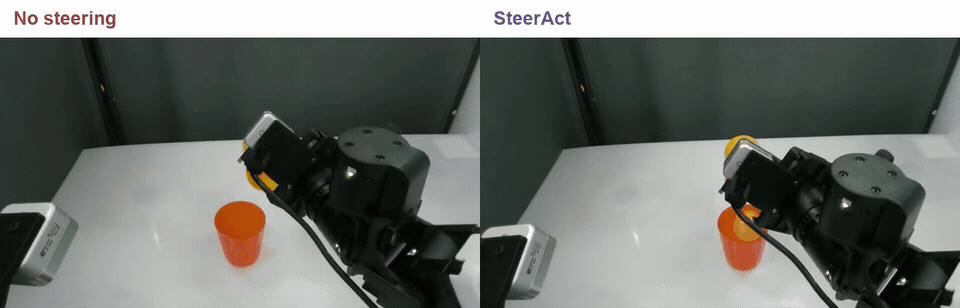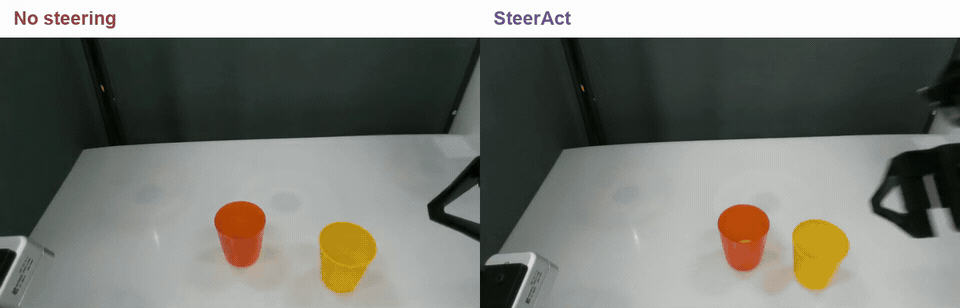
真实机器人杯间转移乒乓球:任务成功率从 40.0% 升至 63.3%。
干预位置同样关键。把同一套方法施加在动作专家分支的 Dec 版本,真实任务平均成功率为 33.3%;编码器分支的 Enc 版本达到 52.2%。这说明模型内部并非每个位置都同样适合引导。
成功率提升的同时
保持较小的决策延迟增量
在 RoboTwin 2.0 的 π0.5 消融实验中,默认单特征方案的平均成功率为 77.7%,高于使用自相关描述的 73.9% 和直接采用动态时间规整匹配的 71.7%。保留门控、改用固定系数 1 或 2 时,成功率分别为 75.8% 和 75.7%。这些结果支持结合执行历史自适应选择修正。
门控也有可测的作用。在八项 VLABench 任务上,完整方案的平均成功率为 36.13%;移除两道门控后降至 22.38%,低于未经引导模型的 23.63%。至少在这组评估里,持续干预会抵消收益,判断何时启用同样重要。
π0.5 在 RoboTwin 2.0 上每次决策仅增加 15.9 毫秒,平均成功率由 69.0% 升至 77.7%。 其决策时间从 207.9 毫秒增至 223.8 毫秒,增幅约 7.6%;Fast-WAM 从 372.6 毫秒增至 415.7 毫秒,增幅约 11.6%。这些数字衡量测试时决策延迟,不包含模型或 SAE 的预训练成本。
一个特征已能带来收益
多特征仍有提升空间
单特征方案已经带来明显收益,但“一个”并不意味着性能上限。在 RoboTwin 2.0 与 π0.5 的消融中,引导前两项和前四项特征分别达到 79.6% 和 80.0%,高于单特征的 77.7%。其吸引力在于用一个简单接口就能取得有效改进。
SteerAct 也仍依赖基础模型的能力、隐藏状态访问权限和预训练 SAE 的质量。Fast-WAM 在部分灵巧手任务上的困难并未被消除;能区分成败的时序关联,也不能直接等同于完整的因果解释。无需逐步对齐同样不代表对任意执行速度变化都保持不变。
SteerAct 为机器人基础模型提供了一个具体的适配接口:用少量成败经验定位内部特征,再根据执行中的时序证据施加修正。在已评估任务上,每任务 24 条参考轨迹与一个特征,就足以提高冻结模型的任务成功率。这让利用已有经验改善实际执行,有了一条可检验、可分析的技术路径。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册