昨天,EAGLE-4 发布了,作为前 EAGLE Team 成员,想结合技术报告,聊聊它的设计,以及我参与研发时的一些实验和取舍。
作者:给你你的
https://zhuanlan.zhihu.com/p/2096797064151701313
先简单介绍一下背景:我在 2025 年 8 月至 2026 年 6 月期间是 EAGLE Team 的成员,后来去了 LongCat,目前在 Kimi 继续做 MTP/投机解码相关的优化。其中,EAGLE Efficient LM Head 的两阶段方案和 training-free 版本,是我在团队期间设计并验证的工作,也是这篇文章想重点回顾的部分。
技术报告重点介绍了 EAGLE-Harness 和 EAGLE Efficient LM Head。下面先简单聊聊 Harness,再展开介绍我更熟悉的 LM Head 部分。
EAGLE-Harness
EAGLE-Harness 其实就是一套用来接入 SGLang/vLLM 的关于动态 SD 的代码,类似于 DSpark 的动态验证逻辑。它根据 draft 和 target 的成本、draft 的 confidence 等因素,来动态地构建一棵 draft tree,并送给 target model 验证。它和 DSpark 的动态验证的区别主要是:
- DSpark 主要是在已经生成的 draft block 里,选择送去 verify 的前缀。而由于 EAGLE 是 auto-regressive 的,因此 EAGLE-Harness 还考虑了 draft 过程的早停。如果预计继续 draft 带来的收益不值得额外的计算开销,就可以直接停止,而不需要生成到预设的最大深度。
- EAGLE-Harness 支持 draft tree。不管是前面说的早停,还是在送 verify 之前做剪枝,都可以在 draft tree 的场景下做。而 DSpark 的这套动态验证是针对 chain 的。
- 期望接受的 token 数的估计方法也不同。EAGLE-Harness 这里不需要额外训练一个 confidence head,而是复用 draft 的概率,并加上一些启发式规则,这里就不展开了。DSpark 则依赖专门训练的 confidence head。
关于 EAGLE-Harness,大家可能会默认地把它当作是一个 “DSpark-Harness” 的 follow-up 工作。不过,按我在团队期间的了解,EAGLE-Harness 的原型来自前同事 Yinrong Hong 等人的 CAST。这个 paper 其实在 25 年 10 月就被挂到 arXiv 了。即使算上后来的优化,在今年年初的时候,这一套方案已经很成熟了。
EAGLE Efficient LM Head
接下来聊聊 EAGLE Efficient LM Head。这部分的方案是我在团队期间设计并验证的,下面简单讲讲当时的 CoT。
在 25 年年底,大家已经意识到了 draft 的 LM Head 很贵。对于 EAGLE 这种只有一层的 draft model,在一些配置下,光 LM Head 就能占到 draft model forward 的一半左右。
当时主流的解决方案(例如 FR-Spec)是对词表做裁剪,即按照 token 出现的频率,裁掉低频 token,保留一个比较小的固定词表。EAGLE-3 也采用了这种方案,通常把词表的大小裁剪到 32000。
但后来我们的实验发现,把词表从 32000 恢复到全词表,接受长度可以提升 1 左右。这在当时的测试里是一个非常明显的提升。也就是说,裁词表虽然省了 LM Head 的开销,但确实也损失了不少 draft 的预测能力。
所以我们就想,能不能既保留全词表带来的接受长度,又把 LM Head 的成本降下来?我当时主要尝试了三条路线:
1、 直接让 LM Head 的计算变便宜,例如做 low-rank、量化等,然后直接用近似后的 logits。
2、 token 级的两阶段法:第一阶段用一个便宜的方法选出 candidates,第二阶段用完整 LM Head 计算这些 candidates 对应的 logits。
3、 cluster 级的两阶段法:先把 tokens 分成若干组,例如每组 128 个 token,先选择若干个组,再计算这些组内所有 token 的 logits,并从中采样。后来 Google Gemma 4 也采用了这种思路。
我们后来选择了第二个方案。原因也很直接:在我们当时试过的配置里,只有第二个方案可以做到相比完整 LM Head 几乎不损失接受长度。第一种方案的接受长度损失很大,第三种也有比较明显的损失。
至于第一阶段怎么做,我们也试过 low-rank、量化,以及两者混合。最后综合考虑,选择了纯 low-rank、不加量化的方案。
于是,这个方法就变成了现在 EAGLE Efficient LM Head 的基本样子:
- 第一阶段,用 low-rank head 对全词表做一次低成本打分,通过 Top-k 选出 candidates。
- 第二阶段,索引出完整 LM Head 中这些 candidates 对应的行,用原来的 hidden states 重新计算 logits。
从计算流程上看,有点神似 DSA:先用一个便宜的模块筛选,再对选中的部分做完整计算。
我这里还有当时画的图,结合起来看应该更清楚一点:
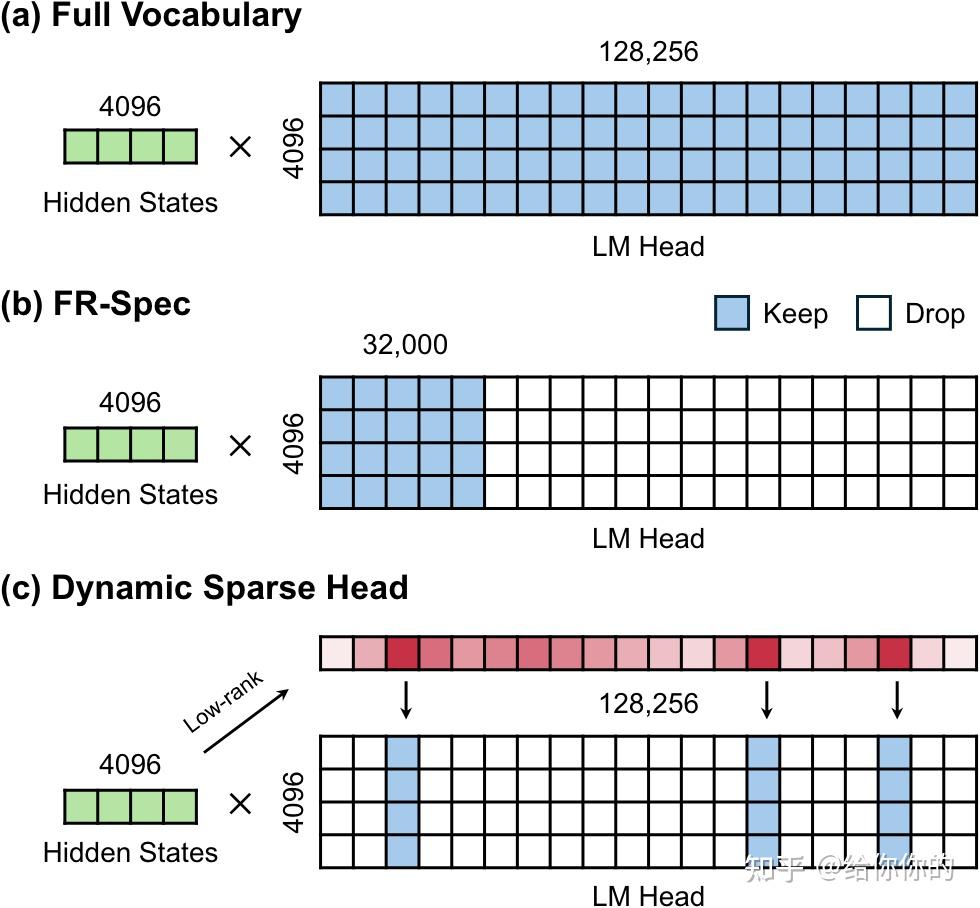
不过说实话,在当下这个时间点,这个思路其实并不稀奇。例如,26 年 2 月的 SpecVocab 就提出了一个计算流程几乎一样的方法。但还是得说一句,我们这套两阶段方案在 25 年 12 月就已经基本成形了。
一个 training-free 的版本:Freq-aware SVD
和现在技术报告里的版本有一个区别:我们最早用的是一个不需要额外训练低秩 head 的方案。我把它叫作 Freq-aware SVD,也就是考虑 token 频率的 SVD 截断。
它的直觉很简单。普通的截断 SVD 对 LM Head 做近似时,并不会区分哪些行对应高频 token、哪些对应低频 token。但我们希望在有限的 rank 下,给高频 token 多分配一些近似精度,毕竟它们在实际生成里更常出现。
具体做法就是:先按词频给 LM Head 的每一行加权,再做截断 SVD,最后把行上的缩放还原回去。这样推理时仍然是在近似原来的 LM Head,并不会直接把词频乘到输出 logits 上。
设完整 LM Head 为 W\in\mathbb{R}^{n\times d},词频权重矩阵为 F=\operatorname{diag}(f_1,\dots,f_n),则 W 的近似 low-rank 分解 A, B 被计算为:
其中,U_r,\Sigma_r,V_r 是保留前 r 个奇异值及其对应向量后的结果。词频权重需要做平滑,保证 f_i>0。
这就是我们用来筛选 candidates 的 low-rank head。给定 hidden states h,直接计算 A(Bh),再取 Top-k 就可以了。
除了统计词频和做一次分解,不需要额外训练。虽然 paper 里没提这个版本,但公开代码里还保留了对应实现。
比较有意思的是,直到我离职,我们一直用的还是这个 training-free 方案。一方面,在我们当时测试的模型和配置里,它已经可以做到几乎不掉接受长度;
另一方面,我们也试过一些简单的 training-based 策略,包括用 SVD 初始化之后再训练,但结果要么打平,要么还不如 training-free 的版本,所以当时也没有太强的动力继续折腾。
不过从这次 EAGLE-4 的 paper 来看,后来的版本已经通过训练低秩候选 head 做出了收益。报告里的做法是固定 drafter 的其余部分,单独训练 low-rank head 的两个因子。这部分是后来的进展。
一个基于 Local Top-k 的变体
我们当时还尝试过一个更高效的变体。
前面这个方案虽然减少了矩阵乘法的开销,但第一阶段仍然要把全词表的近似分数写到 HBM,再读出来做一次全局 Top-k。在我们当时的实现里,这部分开销也不小。
原来的流程大概是:
u = B @ h
scores = A @ u                 # 全词表分数写回 HBM
ids = topk(scores, C).indices   # 再读出来,做全局 Top-k
logits = W[ids] @ h
所以我们尝试把 global Top-k 改为了 local Top-k,并直接放进矩阵乘法的 tile 里做:
u = B @ h

# 概念伪代码:每个 GPU program 处理一个词表 tile
parallel_for tile in vocab_tiles:
    scores = A[tile] @ u       # 完成 rank 维累加,分数留在片上
    local_ids = topk(scores, k_tile).indices
    store(candidate_ids[tile], tile.token_ids[local_ids])

ids = concat(candidate_ids)   # 总候选数约为 tile 数 × k_tile
logits = W[ids] @ h
这个思路和 Google 的分桶近似 Top-k 很像,也是把局部筛选和 matmul 融合起来。这样每个 tile 只保留少量候选,把选中的 token 索引写出来,再把各个 tile 的候选合在一起,交给第二阶段的完整 LM Head 重算。这样就可以省掉全量近似分数的 HBM 写回,以及随后对这些分数做的那次全局 Top-k。
这个做法不保证选出和全局 Top-k 一样的候选。例如,重要的 token 如果集中在同一个 tile 里,就可能被这个 tile 的候选名额挤掉。但在我们当时的测试里,接受长度几乎不掉,下降基本在 0.05 以内。
这里还有一个小细节:最好先把词表行的顺序打乱,再做 local Top-k。我们当时观察到,直接按照原来的词表顺序分块,会影响候选召回;打乱之后再分块,召回率会明显改善。Graphcore 的工作也讨论过用随机重排改善召回。
EAGLE-3.1
这里也顺便来聊聊 EAGLE-3.1 吧。EAGLE-4 继承了 EAGLE-3.1 里的两个归一化改动,一个是 FC Norm,另一个是 Post-norm。
先说 FC Norm。它的位置是在取出 target model 的几层 hidden states 之后,分别做 RMSNorm,再 concat 起来过 FC。
这个是我和前同事 Haochen Gu 当时在训练 GPT-OSS 的 draft 时发现的。我们注意到,target 的 hidden states 经过 FC 之后,输出的 hidden 范数非常大,于是尝试在 FC 前加上归一化。在当时的实验里,加了之后训练收敛更快,训练 acc 也能提高约 2 个百分点,所以后来就把它留了下来。
EAGLE-3.1 发布之后,我也听到有人讨论,说这个 FC Norm 其实没什么用。这个我们当时也观察到了:它确实比较挑模型,并不是加到哪个模型上都有明显提升。至少在我们的实验里,它在 GPT-OSS 上有用,换到有些模型上之后,差别就没那么明显了。
不过,我们也没有观察到加上之后效果劣化的情况,所以我个人还是倾向于先留着。有的模型能赚到一点,有的模型基本打平。当然,这只是我们当时测下来的经验,“加上总没坏处”也不能当成一个普遍结论哈哈。
至于另一个 Post-norm,简单说就是把经过输出 RMSNorm 的 hidden states 传给下一个 draft step,避免未经归一化的 hidden 在递推过程中不断累积范数。这部分不是我做的,Attention Drift 这篇 paper 已经讲得很详细了,感兴趣可以直接看原文,这里就不展开了。
再多聊两句
另外,大家可能会好奇,既然前面提到的 EAGLE-Harness 和 Efficient LM Head 很早就已经成形了,为什么现在才公开?
至少按我在团队期间的体感,当时大家没有那么强的 publication 压力,主要精力还是放在继续提升 EAGLE 的效果上,没有那么着急发 paper、做宣传。当然,这里说的是我在团队期间的情况,不能直接拿来解释后来的整个发布过程。
当时我们也试过一些其他有意思的设计,这次技术报告里没有看到。不过涉及未公开的内容,这里就不展开了。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册