从VLA到WAM,主流的模型都在通用的基座模型作为base model去改造,但通用基座模型真的靠谱吗?
所谓的具身基模又真的训对了吗?
当一个基座模型被改造成 VLA、承担 System 1 的执行角色时,最需要的究竟是什么能力或数据?
人类整理拥挤的桌面,需要先找到杯子和把手,再决定怎样抓取——先明确 where to act,再学习 how to act。
今天的 VLA 与WAM大多沿用通用视觉语言或视频生成基座,它们的预训练目标并非为物理交互所需的精确定位而设计。
这个 mismatch,可能让稀缺的动作数据同时承担感知学习与动作学习的负担。
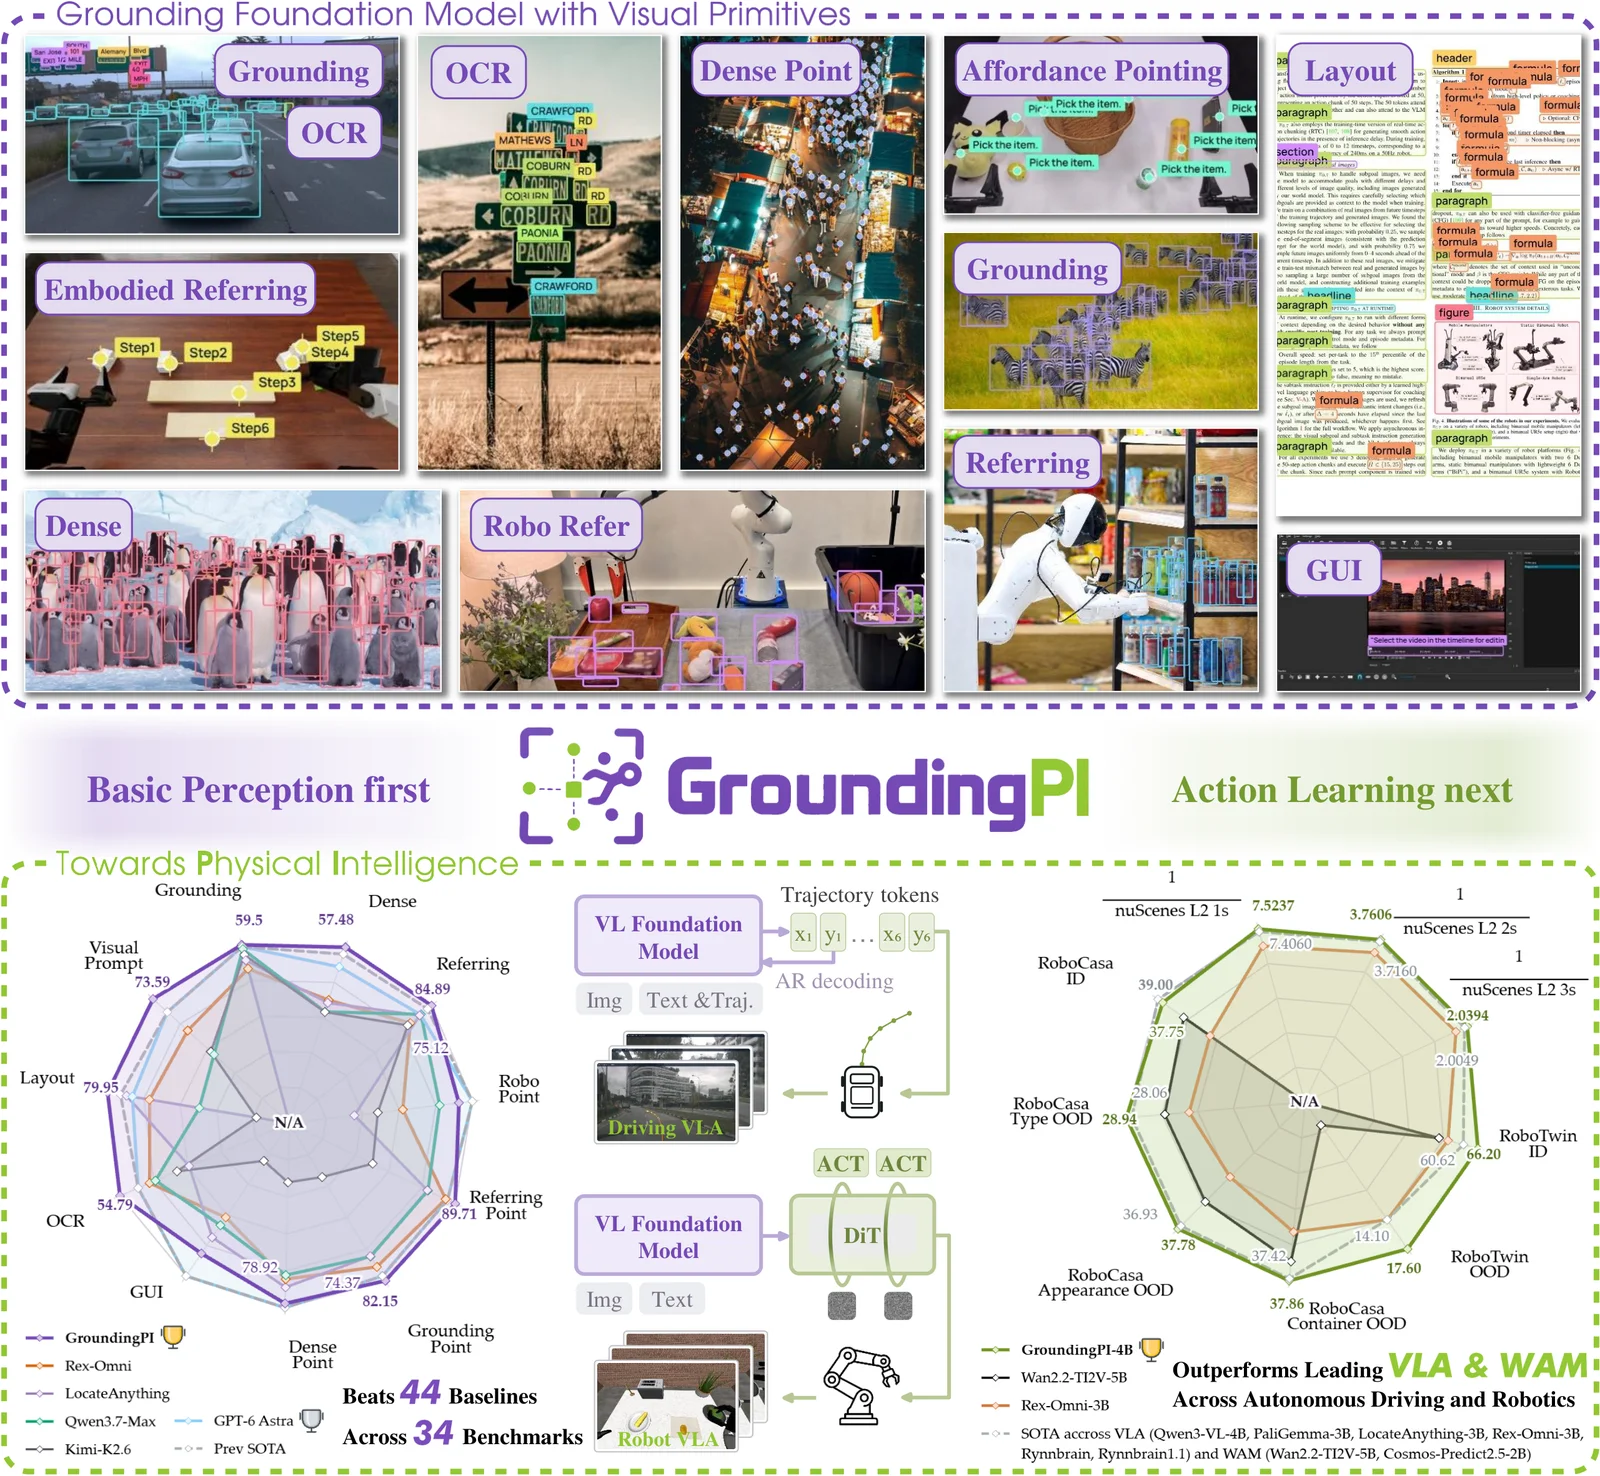
近日,来自小鹏、北京大学、香港大学等海内外高校的研究团队从这一问题出发,通过 Grounding 预训练,涌现基模的原生 perception能力,也作为将VLM空间智能逼出来的训练方式:所谓 Grounding,就是让模型不仅能理解图像中“有什么”,更能根据语言指令,利用point、bbox 等视觉基元(Visual Primitives)精确指出“具体在哪里”。
这种看似基础的视觉定位任务,实际上通过显式的空间监督,倒逼 VLM 建立细粒度的视觉、语义与空间对应关系,将空间感知训练为基模的原生能力。
在此基础上,研究团队进一步检验:这种先训练广泛、精确的感知,再学习行动的路线,究竟能为具身动作学习带来什么,为具身基模设计带来什么?
项目由国内外知名高校合作进行,第一作者兼 Project Lead为Qize Yu,通讯作者为黄世宇与 HKU MMLab 罗平教授,Grounding DINO的作者刘世隆老师也参与研究。
GroundingPI 论文:https://arxiv.org/abs/2609.39601
项目主页:https://groundingpi.github.io/
开源代码:https://github.com/groundingpi/GroundingPI
模型权重:https://huggingface.co/GroundingPI/GroundingPI

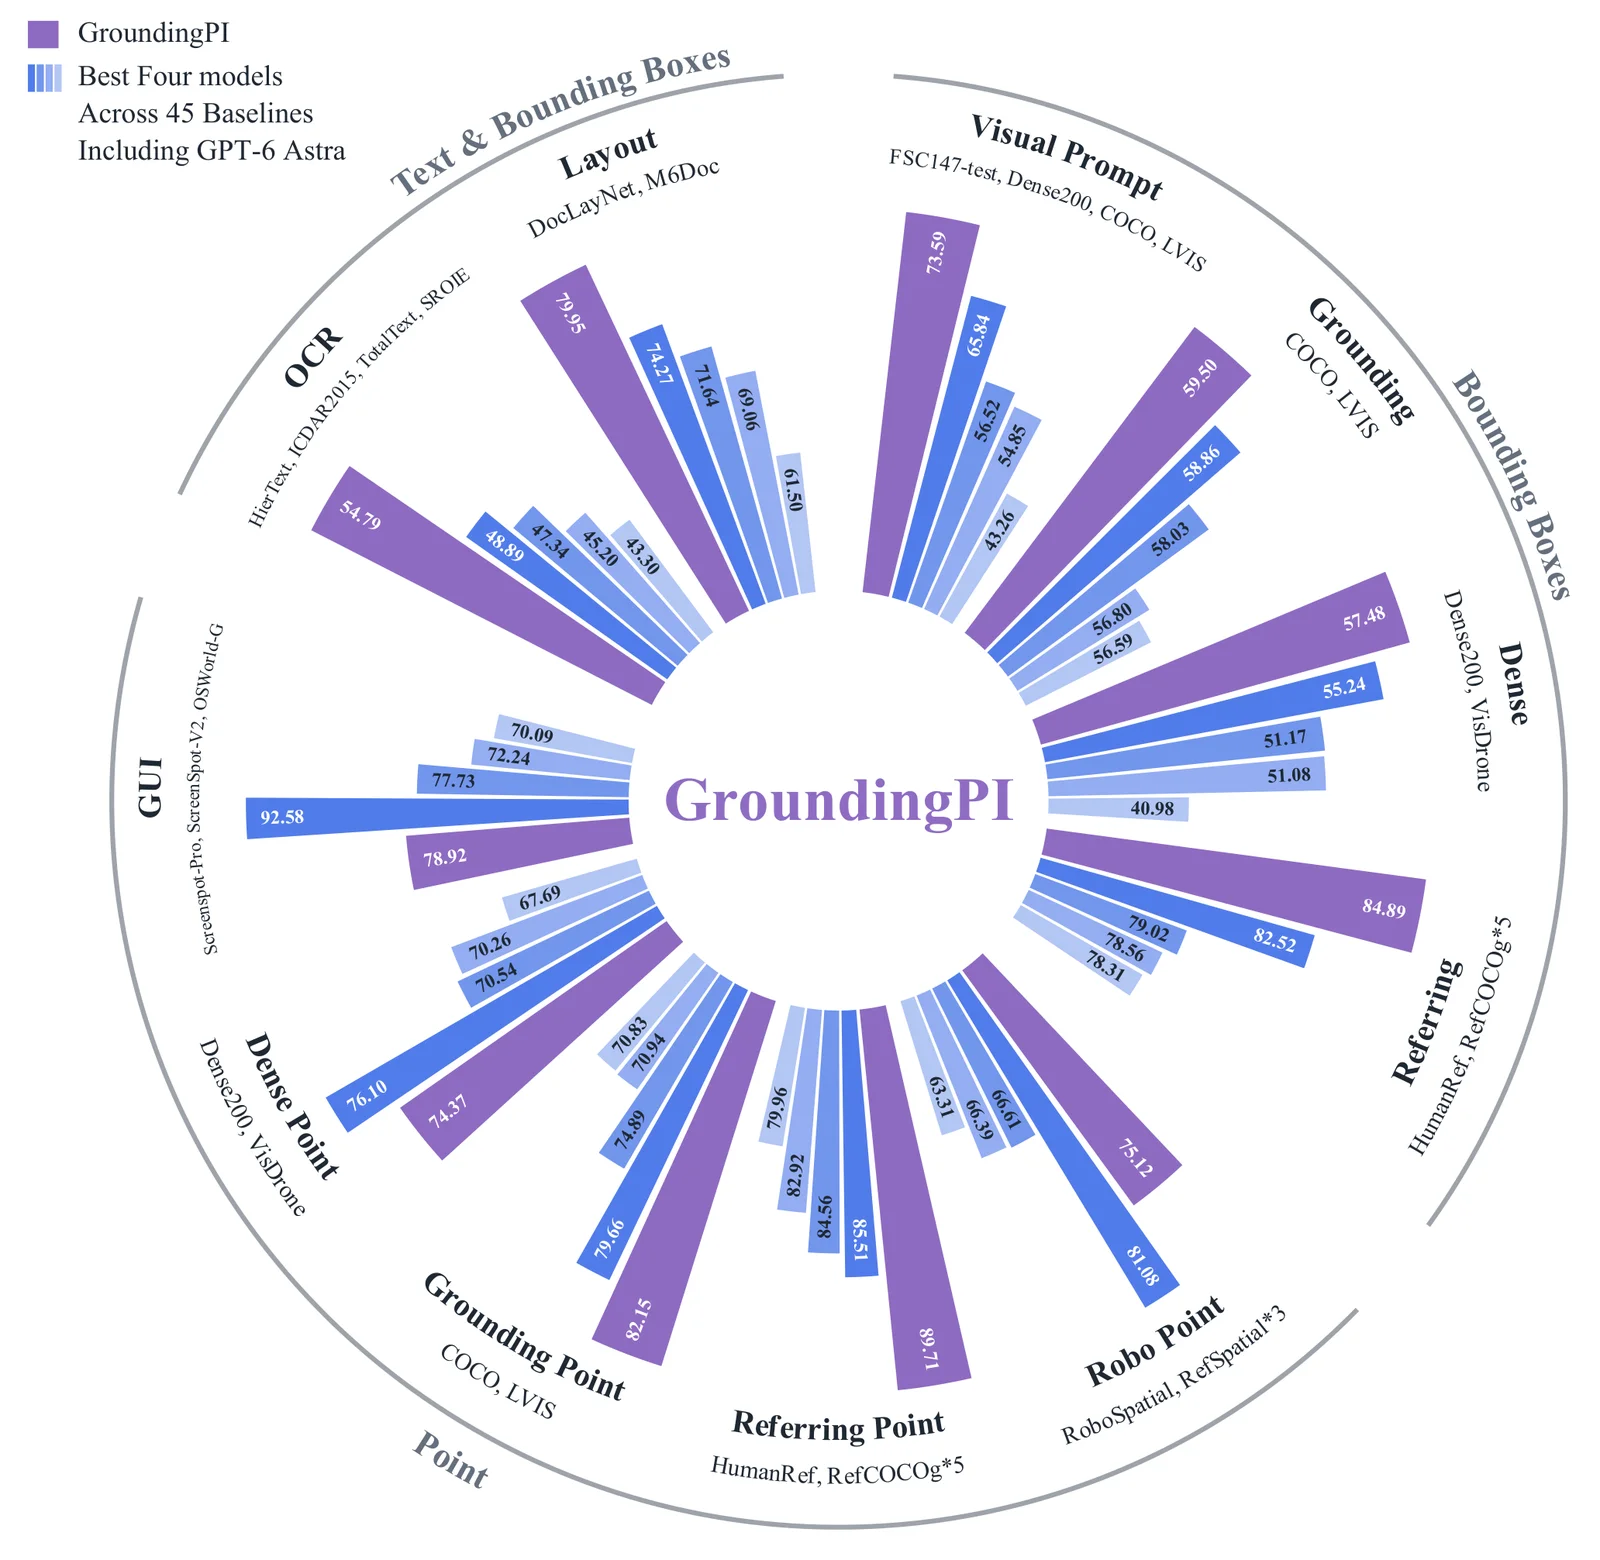
我们看到,GroundingPI 在 34 项横跨 Grounding、Pointing、OCR 等 11 类能力的榜单中,展现 Grounding 预训练带来的强大感知能力:在 34 项基准、44 个对比Baselines 的评测中,4B 体量的 GroundingPI 的综合得分达到 73.68%,甚至超过 GPT-6 Astra(High thinking) 的 71.54%。这个均值按 11 类能力统计,体现的是广泛感知能力的综合优势,可以说当下Grounding模型新SOTA。
从 π0.5 的设计哲学,到原生 Grounding 基座模型
Grounding 在具身学习中的价值,其实已在 π 系列中显现。π0.5 将 bounding-box 预测纳入训练:先定位相关对象,再预测高层子任务,这可以被理解为一种感知锚点(semantic anchor**)**,让语言语义对应到当前画面中的具体对象与位置,这在PI的研究中也有披露,并且在Qwen-RoboManip、G0.5等旗舰模型的设计中也可以看到Grounding的影子。
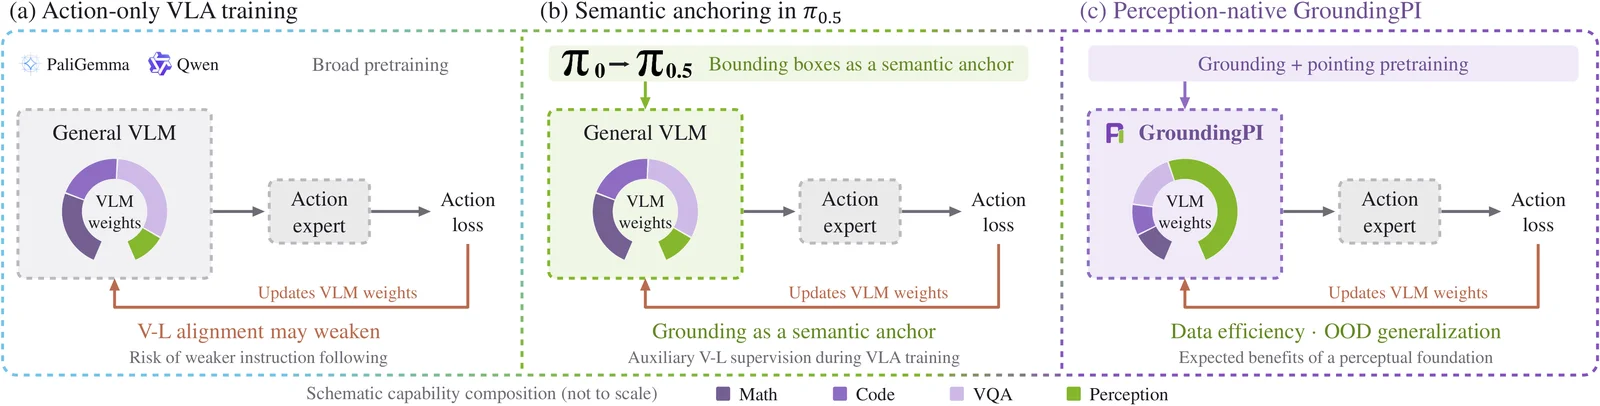
为什么需要锚点?“图里有一个杯子”是正确的语义理解,执行却还需要知道“哪一个杯子、把手在哪里”也作为训练时VL表征的损失来源(避免被破坏)。GroundingPI 研究团队进一步将问题前移到预训练:用统一的量化坐标词表表示点和框,将多种感知任务组织为语言条件下的结构化生成,结合多模态与空间预训练、监督微调和 GRPO 强化学习。
我们在与研究团队的交流中得知,这轮探索投入了千卡级资源,这使得研究得以真正围绕预训练进行系统性消融研究。围绕这一感知基座,论文进一步提出四个与具身训练直接相关的问题。
01|34 个榜单SOTA之外,Grounding 能让机器人更会动手吗?VLA 基座究竟怎么选?
如何判断一个基座是否真的适合具身执行? 只比较不同 VLA 的最终成功率,很难区分提升究竟来自基座能力、动作模型,还是训练数据。他们采用了更直接的验证方式:在各机器人操作基准内固定 Action DiT、动作数据与训练预算,只更换预训练基座,对比通用 VLM、视频生成模型、grounding 模型与具身基模在机器人操作和自动驾驶两个物理AI场景的表现。
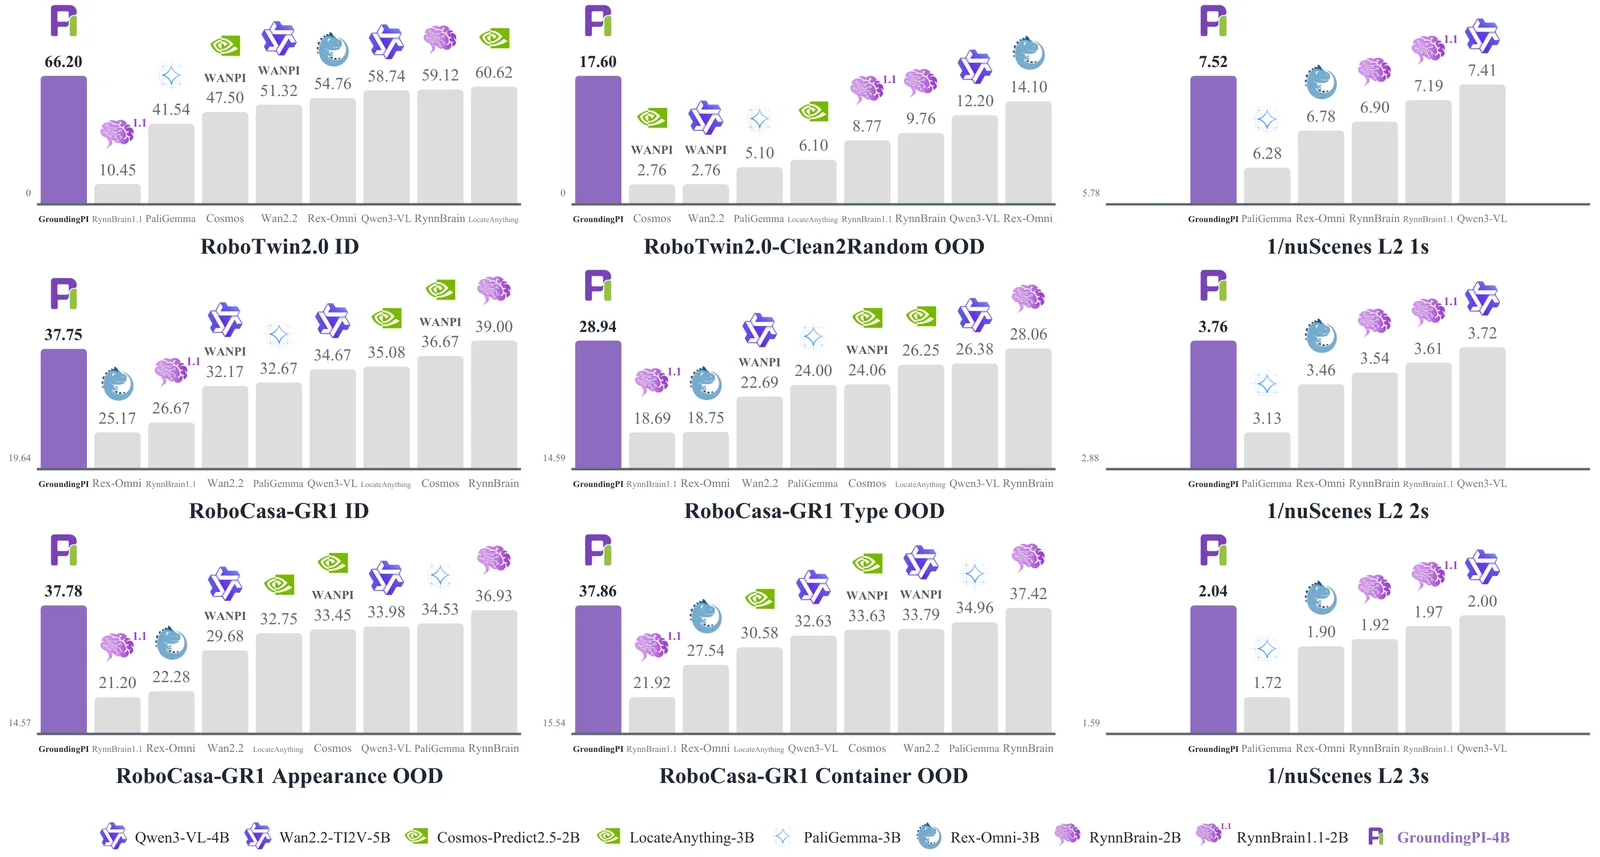
在 RoboTwin 2.0 和 RoboCasa-GR1 的操作评测中,GroundingPI 在全部四种分布外(OOD)设置下领先;其中,RoboTwin Clean2Random 的成功率较次优相对提升 24.8%。驾驶部分则通过 nuScenes 的开环轨迹预测检验迁移表现。研究团队据此指出,选具身基座还要直接看这些 Grounding 感知能力能否帮助机器人应对泛化测试。
在 RoboCasa-GR1 数据效率实验,GroundingPI 仅用 50% 的机器人演示数据,就超过所有使用 75% 数据的对照基座。研究团队由此提出,动作数据不足时,不应只考虑增加示范,也值得检验能否通过补强基座感知,让同样的动作数据发挥更大作用。
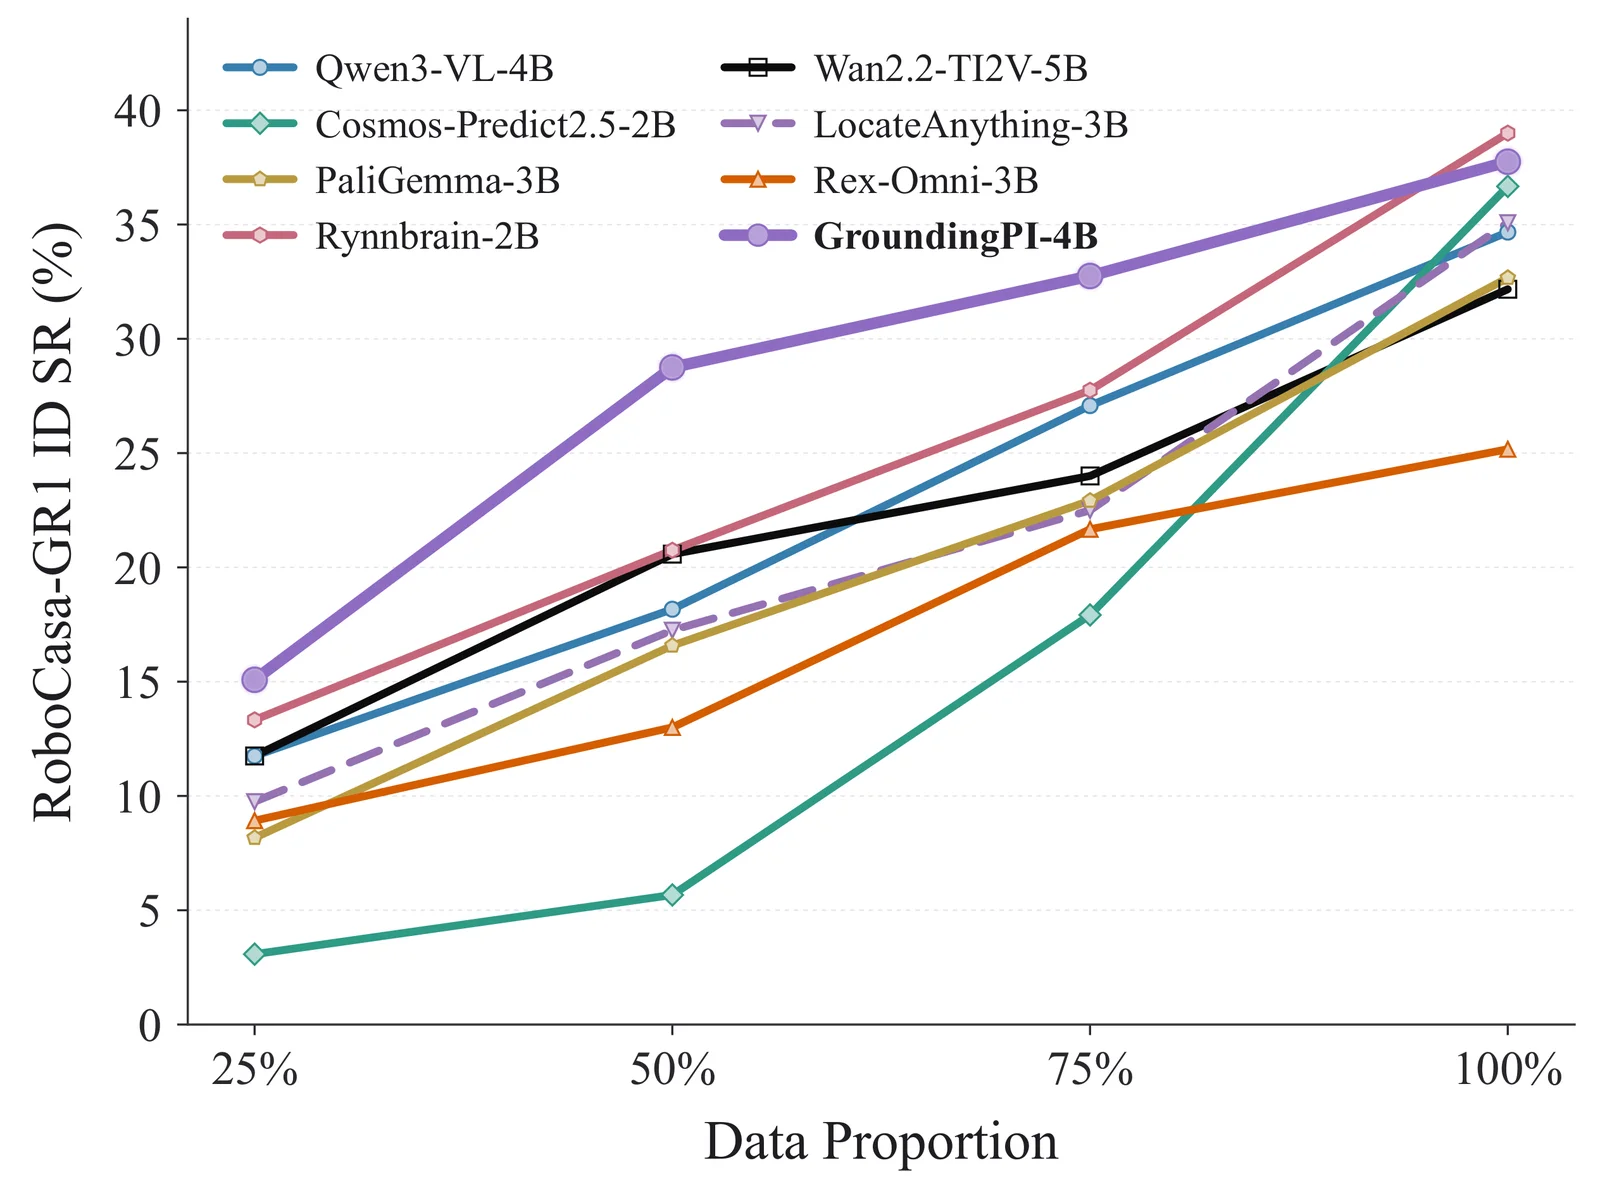
Takeaway 1|把“选基座”变成迁移实验。 在相同动作头、相同数据与预算下,比较任务成功率、OOD 泛化和动作数据效率,才能判断一个具身基模是否适合具身执行!
02|Grounding 预训练的 Scaling 能否迁移到具身训练的 Scaling?
把感知预训练做大,下游动作学习会一起变好吗?
研究团队接着逐步增加 grounding 预训练规模,同时保持下游动作学习配方不变,观察感知与操作表现如何共同变化,Grounding 预训练的 token 数据量逐步扩大,RoboCasa-GR1 的 OOD 平均成功率提高约 6.8 个百分点。研究团队据此强调,泛化收益与感知进步保持了更一致的趋势,这组结果支持感知预训练的规模收益能够迁移到动作学习。
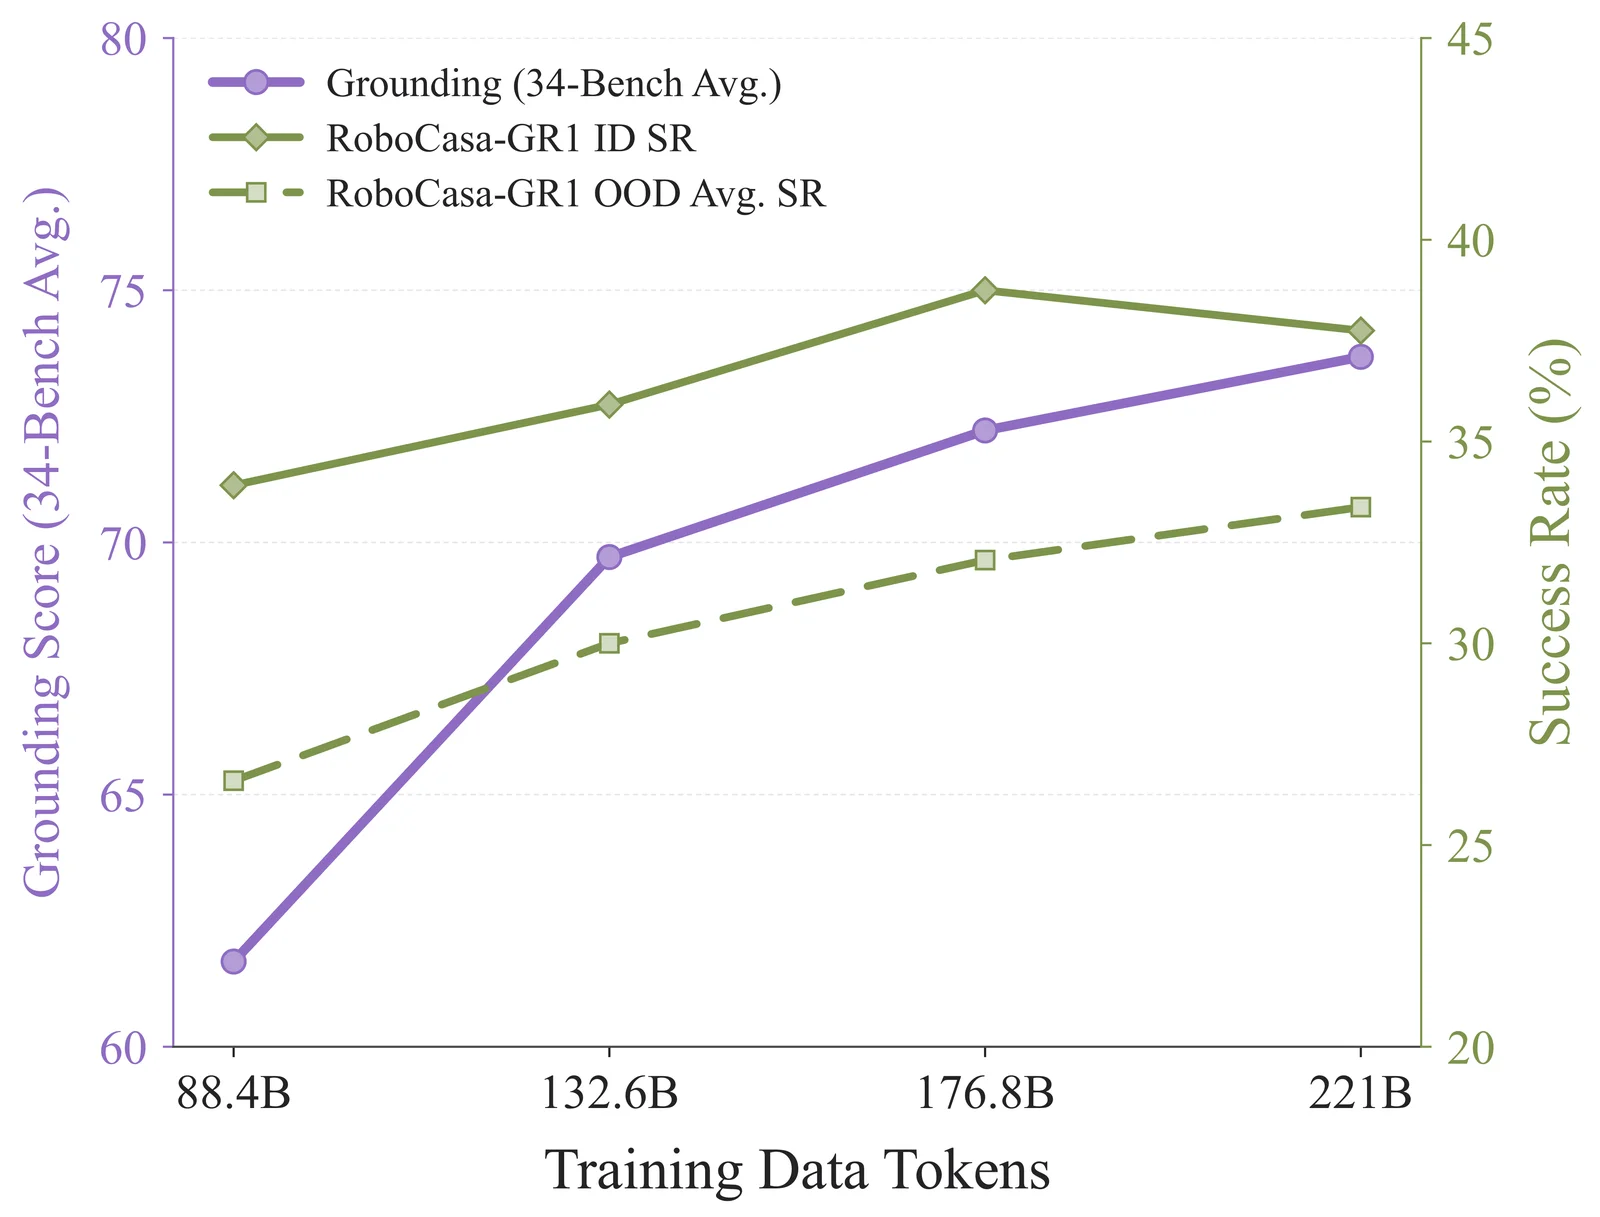
Takeaway 2|用下游泛化衡量感知 Scaling 的价值。 增加感知预训练的投入,可以成为改善具身学习的一条路径,Grounding可能是很好的选择。
03|Grounding 预训练配比具体拆分下,什么数据在具身基模中发力?
除了 basic grounding,哪些数据配比监督最值得加入训练配方?
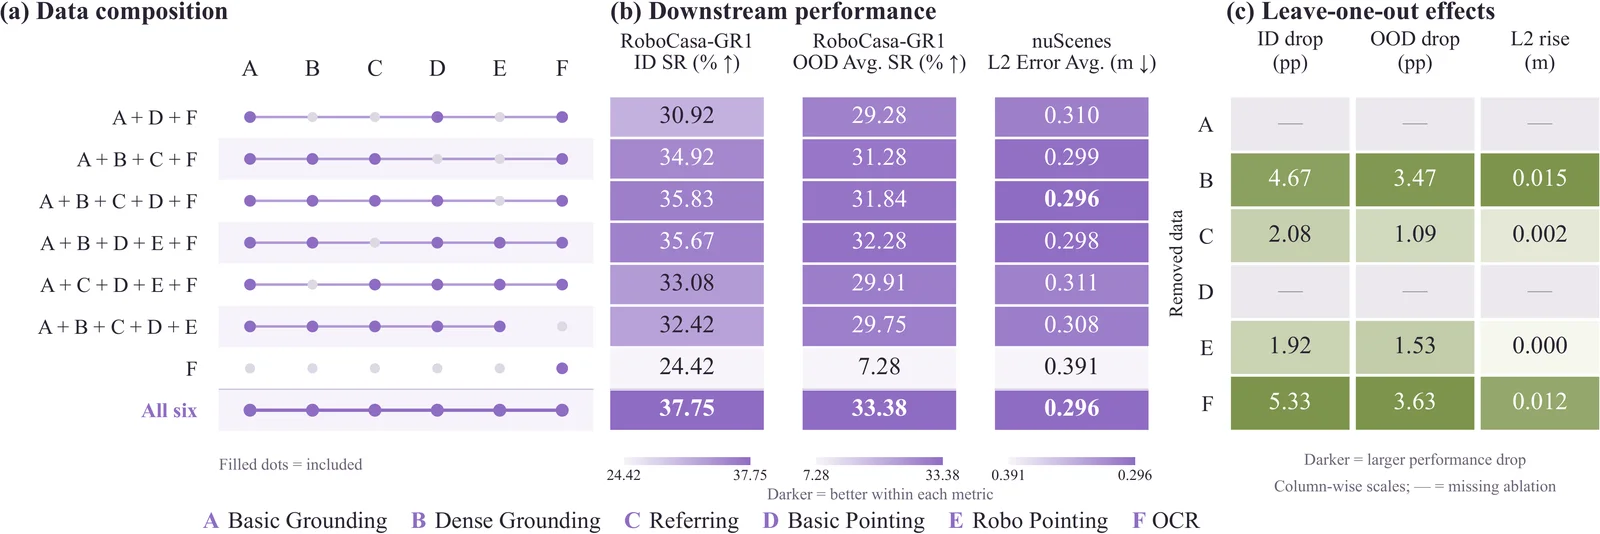
研究团队接着将数据拆成基础与密集 grounding、指代、点选,以及 OCR/布局/GUI 等任务组,考察它们对机器人操作和自动驾驶的影响。
(1)Dense & tiny:交互需要更细的空间分辨力
**在 RoboCasa-GR1 的 OOD 设置下,从完整配方中移除 Dense Grounding,**操作 ID/OOD 成功率分别下降 4.67/3.47 个百分点,驾驶误差也上升。 直观地说,同样偏移几个像素,小物体更容易定位失败;目标越拥挤,越需要把相邻实例分开。Dense 与 tiny 的共同要求,是精细的空间辨别能力,其实看前面的实验,这恰恰是传统通用模型及其欠缺的,哪怕强如 GPT-6 Astra。
(2)OCR:感知学习的潜在催化剂
包含 OCR 的辅助组,单独训练效果有限,加入组合却明显受益。 移除它,操作 ID/OOD 成功率下降 5.33/3.63 个百分点;只用这一组,OOD 成功率仅为 7.28%,几乎崩塌。
OCR 的有趣之处在于 “催化”:字符边界要求局部精度,文字转录又把视觉区域与语义绑定,形成细粒度图文对齐的 proxy task,可能放大空间监督的收益。实验支持这种互补性,但 OCR 的独立催化机制仍是待验证的假说,文章中也做了一些数学的推论证明。
Takeaway 3|按互补能力组织数据,而不只按任务标签堆量。 Basic grounding 打底,dense & tiny 强化空间辨别,OCR 等辅助监督可能催化表征学习;关键是组合后能否让动作学得更好。
04|具身基模的什么架构设计还会影响?
**基模的架构设计会不会也影响具身训练迁移?**一个有趣的发现是,在论文相同下游适配设置中,RynnBrain1.1 在六种操作设置上均低于 RynnBrain,却改善了驾驶表现。新版本不一定带来一致的动作迁移收益。
(1)GDN 与门控:空间细节能否被保留和读出;RynnBrain1.1 的 Qwen3.5 基座引入 Gated DeltaNet 与门控注意力。论文一些数学形式化证明和实验结果分析指出了这一设计在接入VLA改造时可能存在的负影响。
(2)DeepStack:更多视觉特征,是否更容易用于动作;DeepStack 将中间视觉特征注入多个语言层,丰富视觉信息,也可能增加多层特征与动作头之间的对齐需求。
文章同样做了一些数学形式化证明和分析,并且模型特意将 ViT 换位 MoonViT-V2(无 DeepStack)而非 Qwen3 ViT(哪怕可能带来极大成本预训练)。
但这些也只是研究团队的理论验证和假说分析,现有跨模型比较同时改变了数据和基座等因素,支持的是进一步研究这些机制,尚不能把排名差异归因于某个模块。
Takeaway 4|对具身开发的启示:架构要看“动作头能否用好表征”。 除通用能力外,还应检验空间信息的保留、特征读出和有限动作数据下的对齐效率;用控制变量实验判断结构选择,而不是按版本新旧推断迁移能力。
回到 Sys 1 与 Sys 2:具身基模们应该怎样分工?GroundingPI团队的一些设想
研究团队进一步提出,承担不同系统角色的模型,可能需要不同的能力优先级。在他们的设想中,Sys 2 侧重知识密集的推理与长程规划,Sys 1 则更需要“根据眼前场景,及时、准确地执行”。团队将 GroundingPI 定位为后者的感知基础,希望与 Astra 等承担高层推理和规划的模型形成互补,而不是让同一种基座包办所有能力。
研究团队将这些结果概括为一条训练思路:**把有限算力投入执行真正需要的感知能力,让精准 grounding 成为具身基模的原生能力,再用下游动作迁移检验训练是否有效。**通用能力更强,并不自动等于具身执行所需的感知更强;论文没有独立消融数学或代码训练,也不否定它们对 Sys 2 的价值。
GroundingPI 本身仍是感知基座,需要接入动作学习才能形成策略;驾驶结果来自开环评测,真实闭环执行与端到端时延仍需进一步验证。它给出的答案,是一条可以系统检验的路线:先建立精确感知,再学习行动。
同时,文章也提出了两个假说的观点(仅供Discussion):
(1)当下通用基座模型的预训练厂商们更多关注 Agent 等场景的价值,而忽略了模型本身感知的潜力,但是当模型真正被改造为 Sys1 的 VLA 时,快系统并不允许类似 Agent 那样多轮的执行,单次的原生感知反而是最有价值的能力,研究团队认为 Sys1 的 VLA 将成为像 Code Agent 那样的代码执行器,需要快速度和高成功率,需要在有限时间内看准并行动。
而一些具身基模关注机器人下的规划、理解可能对于真正的 VLA 直接动作执行并不本质相关,但或许是可以成为 Sys1 和 Sys2 之间的产物。
(2)Grounding为什么能成为逼出基模空间感知能力的关键预训练,而不是3D bbox、depth等,文章认为Grounding数据量大且易于训练,而3D bbox、depth数据量相对更少,并且绝对数值的 3D bbox、depth 不是很本质,因为人类也拿不准;比如30米外和25米外,对于人类感知不强烈;但是loss惩罚却是5米;并且很难设定一个对场景相关的距离下的阈值来确定loss,depth同理,相对值反而可能是很好的方向。
友情链接:GroundingPI研究团队的同系列 GroundAnything 聚焦 grounding 工具模型的速度瓶颈,在论文的 30 项基准综合评测中超过之前的SOTA模型 LocateAnything,并提供进一步提升吞吐的自推测解码方案。
GroundAnything 论文:https://arxiv.org/abs/2609.39600
GroundAnything 主页:https://groundingpi.github.io/groundanything/
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册