作者:纪牛牛
https://zhuanlan.zhihu.com/p/1924074563257480838
日本顶尖AI实验室Sakana AI发表了一篇论文,就像来自富士山的清新空气一样令人耳目一新。他们提出了对蒸馏方法的全新思考,使用较弱的模型训练出更强的模型,这在过去被认为是不可能的。
今天,我将讨论蒸馏背后的关键直觉,以及为什么这种新方法与我们之前见过的任何方法都不同。
今天的AI领域有一个非常现实的问题,顶尖的团队持续承受着每隔几个月就要交付突破性成果的压力。
在上市速度和真正进展之间的权衡意味着及时的产品发布比交付实际产生收入或真正改善现状的产品更重要。即使最新模型会将现金储备烧光,回报却微乎其微,他们仍然有发布的动力,希望下一轮融资能再存活几个月。
简而言之,相比利润,产品智能(进步的衡量标准)是唯一重要的事情。
但是即使是资金最充足的AI公司OpenAI,在最近的400亿美元融资轮后,也不得不停止其GPT-4.5模型,因为它太昂贵。
事实上,出于开放成服务的商业成本考量,所有前沿AI实验室都对他们最聪明的模型有所保留。
幸运的是,有一种方法可以以廉价方式提供匹配顶级模型大部分性能的服务。这种被称为蒸馏的技术已经成为巨头们的主要策略,作为任何顶级AI实验室商业模式的结构性组成部分,我们今天使用的大多数模型都是蒸馏模型。
蒸馏使得一个较大的模型的能力传授给一个更小的模型。我们不是从零开始训练一个小模型,而是训练一个大型(且运行效率低下)的模型,并将其用作较小模型的老师,这个较小的模型从成本上最终是可以给到用户广泛使用的。
这个想法背后的直觉非常简单,使用人类类比的话:与其给孩子一堆书籍,告诉他们从零开始学习一切,我们人类将其中一些人培训为老师,并用他们来教授孩子们材料,减轻他们必须自己弄清楚一切的负担。
如果我们所有人都天生具有拉马努金的天赋,能够自己学习一切那就太好了。但对我们大多数人来说,情况并非如此。向某人学习比自己弄清楚更容易。
有趣的是,这个想法也完美地适用于AI。如果一个模型被另一个模型教授,它学习得更快更好,而不是必须自己从头学习一切。这正是这些AI实验室使用的策略:
- o4-mini是o4的蒸馏版本
- Gemini 2.5 Flash是Gemini 2.5 Pro的蒸馏版本
- Claude 4 Sonnet是Claude 4 Opus的蒸馏版本
- Mistral Medium 3和Mistral Small 3是Mistral Large 3的蒸馏版本(未发布)
即使是上面担任老师的那些模型,也很可能是AI实验室不公开的更大模型的学生,因为它们太昂贵而无法拿出来作为服务提供。
理解了蒸馏的重要性后,它是如何工作的呢?
通俗的说,普通大模型的训练就是通过模仿来学习。下一个词的预测就是给模型展示大量文本来模仿这些文本数据,比如”牛蛙是一种动物“,训练时候我们给模型看到”牛蛙是一种“,它输出下一个词的概率分布,用交叉熵来计算与真实的文本输出”动物“损失,然后反向传播更新参数。
蒸馏是在模仿真实文本数据基础上引入另一个老师的模仿对象。即把”牛蛙是一种“输入给老师,它输出的下一个词的概率分布和学生模型的输出分布计算相似度来衡量损失。
因此,除了测量他们和真实词的差异,对于学生,还测量老师的输出分布和学生的输出分布之间的差异,从而指导其成为老师的学生。用这种方式我们得到了一个较小的学生,它不一定像老师那样大和"聪明",但它在回答问题的时候表现的像老师。
Sakana认为这整个过程,所有AI实验室都虔诚地遵循的过程,是有缺陷的。
他们提出以下问题:与其训练老师通过只给它们问题让它们弄清楚答案来变得超级聪明,如果我们为老师提供问题和答案,并训练它解释为什么,解决方案是什么,而不是强迫它首先找到答案,会怎么样?
因为已知答案来解释为什么比得到答案更容易,就像物理老师可以解释牛顿定律而不必像牛顿一样聪明或在解释之前必须先发现定律一样。
也就是说,我们不是通过它能多好地独自解决问题来训练老师,而是通过它的学生变得多聪明来指导老师的训练。我们奖励老师模型提供实际提高学生表现的解释,而不是训练有史以来最聪明的老师。
但他们如何做到这一点呢?Sakana完全颠覆了老师的训练。如下面在一个老实说难以理解的图中所见,这种训练方法测量两件事来评估老师的质量:
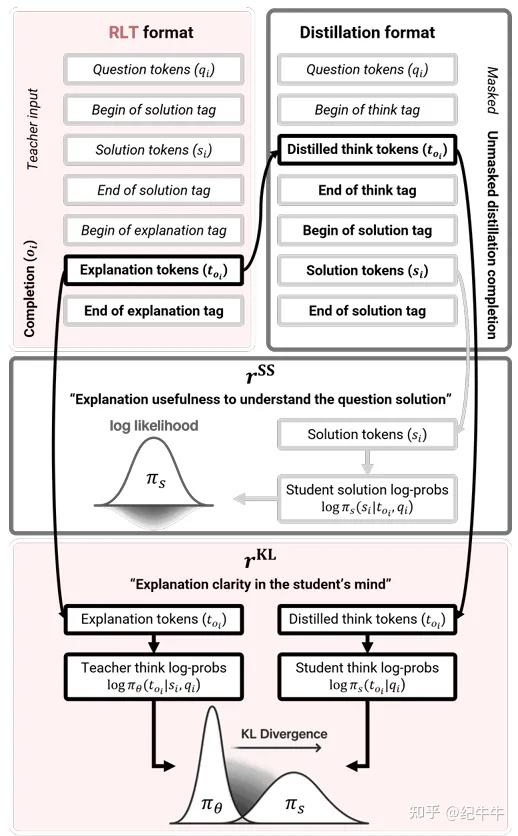
- rSS奖励:给学生一个问题和老师的解释,看看在给定两者的情况下,它是否能产生解决方案。正如研究人员所描述的,这里我们测量"解释对理解问题解决方案的有用性"。
- rKL奖励:这里,我们测量给定问题,学生创建解决方案解释的可能性,以及它与老师的比较。这里,当学生生成类似于老师的思维过程时,我们奖励老师(本质上,学生是否以与老师一致的方式行为)。
举一个例子,比如我们有一个数学题”求解方程 2x + 6 = 14“。传统蒸馏方法,老师模型的训练就是正常的RLVR方式,让它自己找答案并和正确答案对比。学生学习就是模仿训练好的老师的输出。
对比来说Sakana 双重奖励是,首先在训练老师模型的阶段,要求老师提供解释,例如”要解这个方程,我们需要将x项独立出来。首先从两边减去6:2x + 6 - 6 = 14 - 6,得到2x = 8。然后两边同时除以2:2x ÷ 2 = 8 ÷ 2,所以x = 4。“。蒸馏的过程是:
rSS奖励(解决方案奖励)

1. 给学生问题:"2x + 6 = 14"
2. 给学生老师的解释(上面的步骤说明)
3. 看学生能否基于这个解释得出正确答案
- 高分情况:学生看了解释后能正确推导出x = 4
- 低分情况:学生看了解释后仍然答错或无法理解

奖励衡量:老师的解释是否真的有用,是否能帮助学生理解和解决问题

rKL奖励(一致性奖励)

1. 给学生同样的问题:"2x + 6 = 14"
2. 让学生自己生成解题思路
3. 比较学生的思路与老师的思路相似程度

学生可能的回答:
- 高分回答:"先减6,再除以2,所以x = 4"(与老师思路一致)
- 低分回答:"我猜x = 4"(虽然答案对,但思路不一致)

奖励衡量:学生是否真的学会了老师的思维方式,而不只是记住答案
在实际训练场景中,
- 当老师给的解释是” 直接代入试试:当x = 4时,2×4 + 6 = 14,所以答案是4。 “。学生拿到这个解释后,面对新题"3x + 9 = 21"时不知道怎么做,那么rSS就是低分,而rKL会是高分,学生学会了"试数字"的方法,与老师一致。
- 当老师给出的解释是”要解这个方程,我们需要将x项独立出来。首先从两边减去6:2x + 6 - 6 = 14 - 6,得到2x = 8。然后两边同时除以2:2x ÷ 2 = 8 ÷ 2,所以x = 4。“ rSS的结果是学生理解了系统性方法,能解决"3x + 9 = 21"等新问题。rKL也会是高分因为学生也学会了"移项、合并、除法"的系统思路。
传统方法只看老师能否自己解题,但不管老师是否会教。
Sakana的方法直接衡量"教学效果",就像我们评价一个人类老师,我们不只看他自己数学有多好,更要看:
1、 学生听了他的课后能否解决新问题(rSS)
2、 学生是否真的理解了解题思路(rKL)。
我们不是为找到问题解决方案而奖励老师,而是只有当老师生成实际产生帮助到学生的解释时,我们才会奖励老师,而不是训练一个巨大的推理模型并希望它的解决方案作为学生的学习信号。
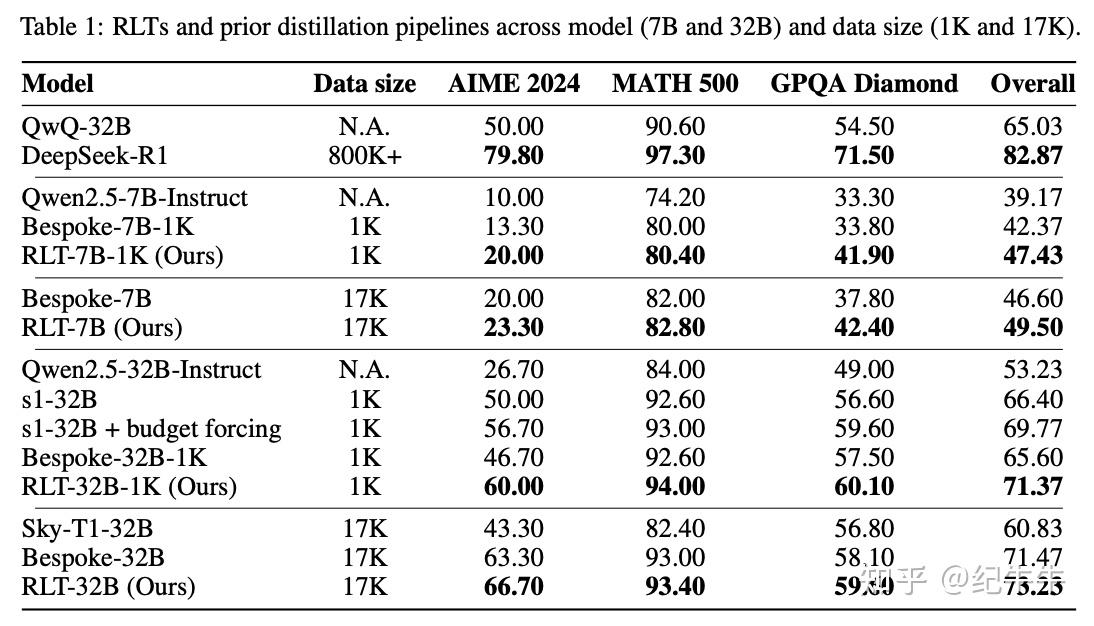
Table 1展示了RLT方法与传统蒸馏方法在三个高难度任务(AIME 2024数学竞赛、MATH 500数学题、GPQA Diamond研究生级科学问答)上的对比结果。
- 未经特殊训练的原始模型Qwen2.5-7B-Instruct只能达到39.17%的综合得分,而32B版本达到53.23%。作为参考标杆,业界顶级模型QwQ-32B达到65.03%,而使用80万+数据训练的DeepSeek-R1更是达到82.87%的高分。
- 在7B学生模型的对比中,我们看到了RLT方法的第一个突破。传统的Bespoke方法使用17K数据,通过大型DeepSeek-R1模型生成并后处理推理轨迹来训练7B学生,最终获得46.60%的综合得分。而RLT方法仅使用7B参数的老师模型,在相同17K数据上训练出的7B学生却达到了49.50%的得分。即使在仅使用1K数据的小规模设置下,RLT方法也能达到47.43%。
- 32B学生模型这个组别中,RLT方法实现了真正的"小老师教大学生"。同样是7B参数的RLT老师,在训练32B学生时达到了73.23%的综合得分,超过了所有传统蒸馏方法。相比之下,使用大型老师模型的Bespoke-32B方法只达到71.47%,而其他方法的得分更低。
就像人类中我们评价一个好老师的标准从来不是比学生更聪明,这里老师的训练是针对教学这个目标进行了优化。从技术角度来看,由于老师使用更直接的任务(解释解决方案而不是找到它)进行训练,老师的训练目标比学生的目标更简单:一个可以访问解决方案并需要生成更好的解释,而学生必须找出解决方案。更容易学习。于是我们确实可以用更小的模型来完成教学工作。
与传统老师不同,他们只有在找到解决方案时才会得到奖励,这是稀疏的,而解释解决方案上奖励是密集的,因为解释的每一部分都通过学生对其内化程度来衡量。简单来说,由于老师只有在从学生那里产生更好的回答时才会改进,反馈是即时和持续的。
成功的AI研究主要由直觉驱动。最好的研究是那种阅读论文后你会说一句"有道理"的研究。是的,AI表现出一些只能通过经验方法发现的高度反直觉行为(比如超参调整,这是现代AI中最接近炼金术的东西)。然而大多数突破来自从常识角度处理问题。
- 模型今天利用的全局注意力机制完全有道理;如果模型关注一切,它就不会忘记任何东西。
- 推理模型来自于更多算力解决问题改善解决方案可能性的想法。
- 蒸馏来自于模型的模仿比数据的模仿更容易的想法,因为老师已经完成了学习的重任,因此学生可以更小。
大多数成功的AI研究只是应用常识。今天的情况也不例外,因为"突破"是训练老师成为好老师。真的就是这么简单。只是训练模型去做它们被训练要去做的事情,就是教学。于是我们有了一种以显著更低成本部署强大AI的方法,并且性能有所改善。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册