千里之堤,溃于蚁穴
——《韩非子·喻老》
✨ AutoRLBench把真实的 RL 训练事故整理成一套智能体基准:考察 agent 能否发现训练失败、定位根因,并真正修复问题。
💻 GitHub:https://github.com/Thinking-Space/AutoRLBench
📖 博客全文:https://thinking-space.github.io/AutoRLBench/page/blog.html
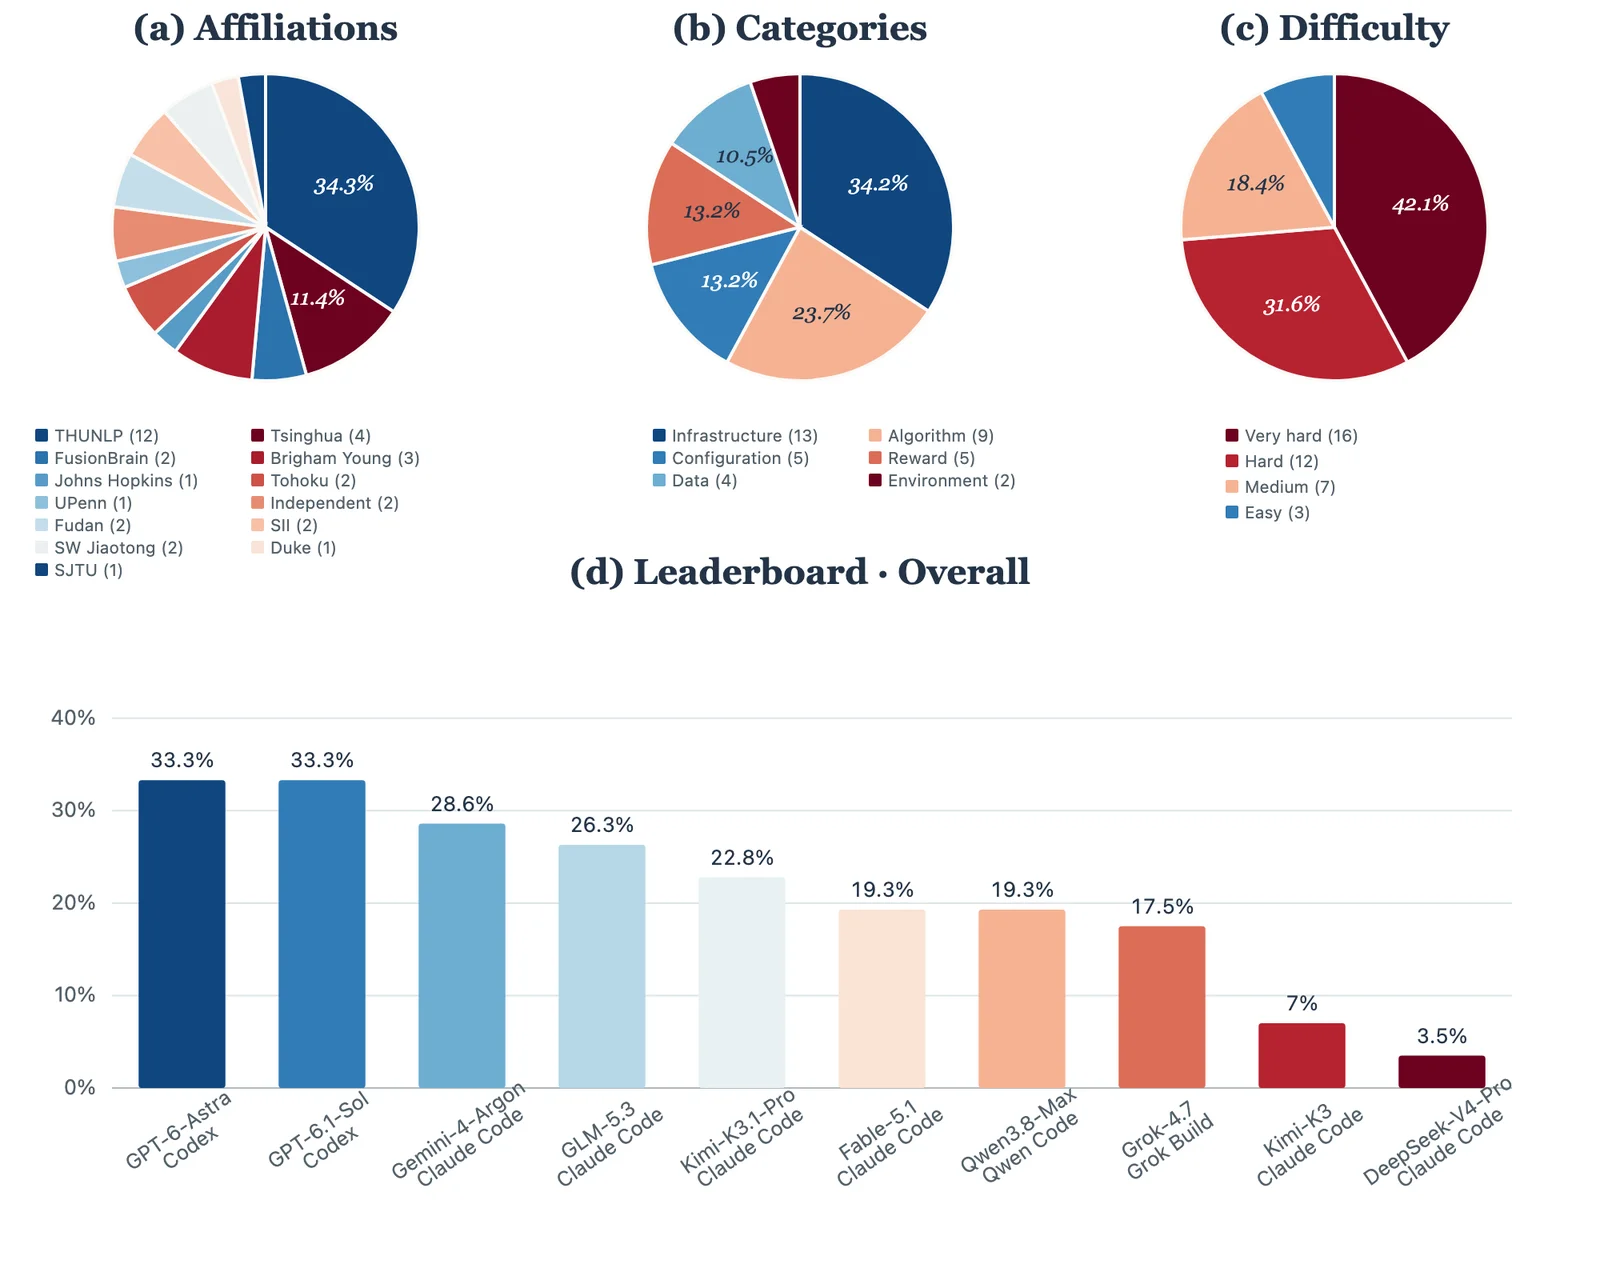
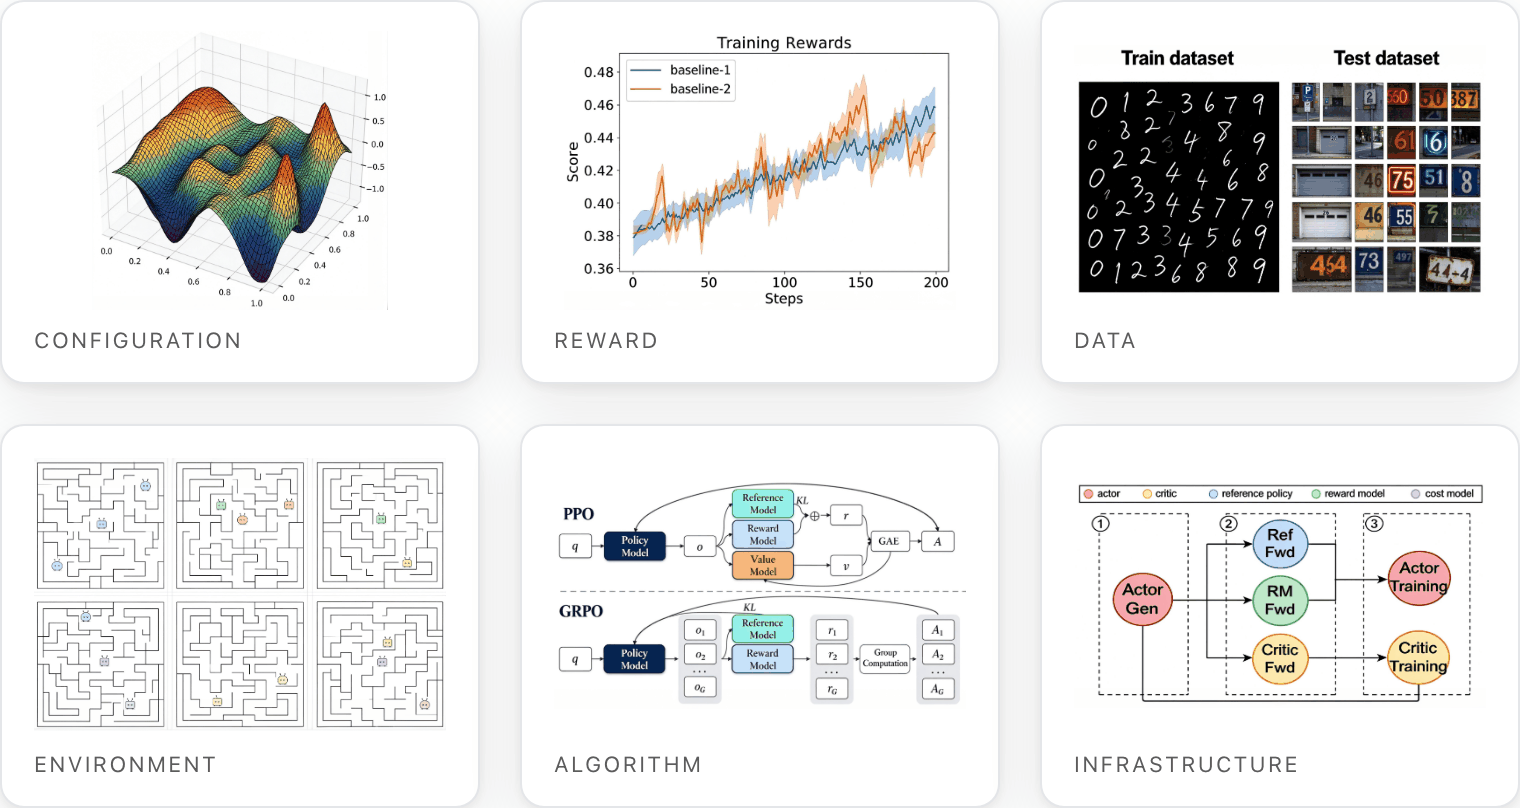
✨ 当前版本包含 34 个诊断任务、17 个修复任务,覆盖 configuration、reward、data、environment、algorithm、infrastructure 六大故障类别。
✨ 首轮结果显示,智能体通常能发现“训练出了问题”,但在解释根因、完成可靠修复方面仍有明显不足。
从 AI for AI 回到 RL 失败现场
AI for AI 不应只看一个端到端总分,还需要回答:智能体能否发现异常、解释原因、采取正确行动,并验证修改是否有效?
RL 训练正是检验这些能力的典型场景。训练可能没有报错,但会因为数据分布、奖励实现、算法逻辑、外部环境或基础设施问题而悄悄失效。
AutoRLBench关注的问题是:
当 RL 训练失败时,AI agent 能否找到根因,并可靠地修复它?
任务格式:从诊断到修复
每个任务都尽量保留真实事故现场,包括源代码、配置、日志、评估记录和运行环境,并配有隐藏的参考答案。
任务分为两个层级:
- Diagnosis:判断训练是否健康,定位具体根因,并提供证据;
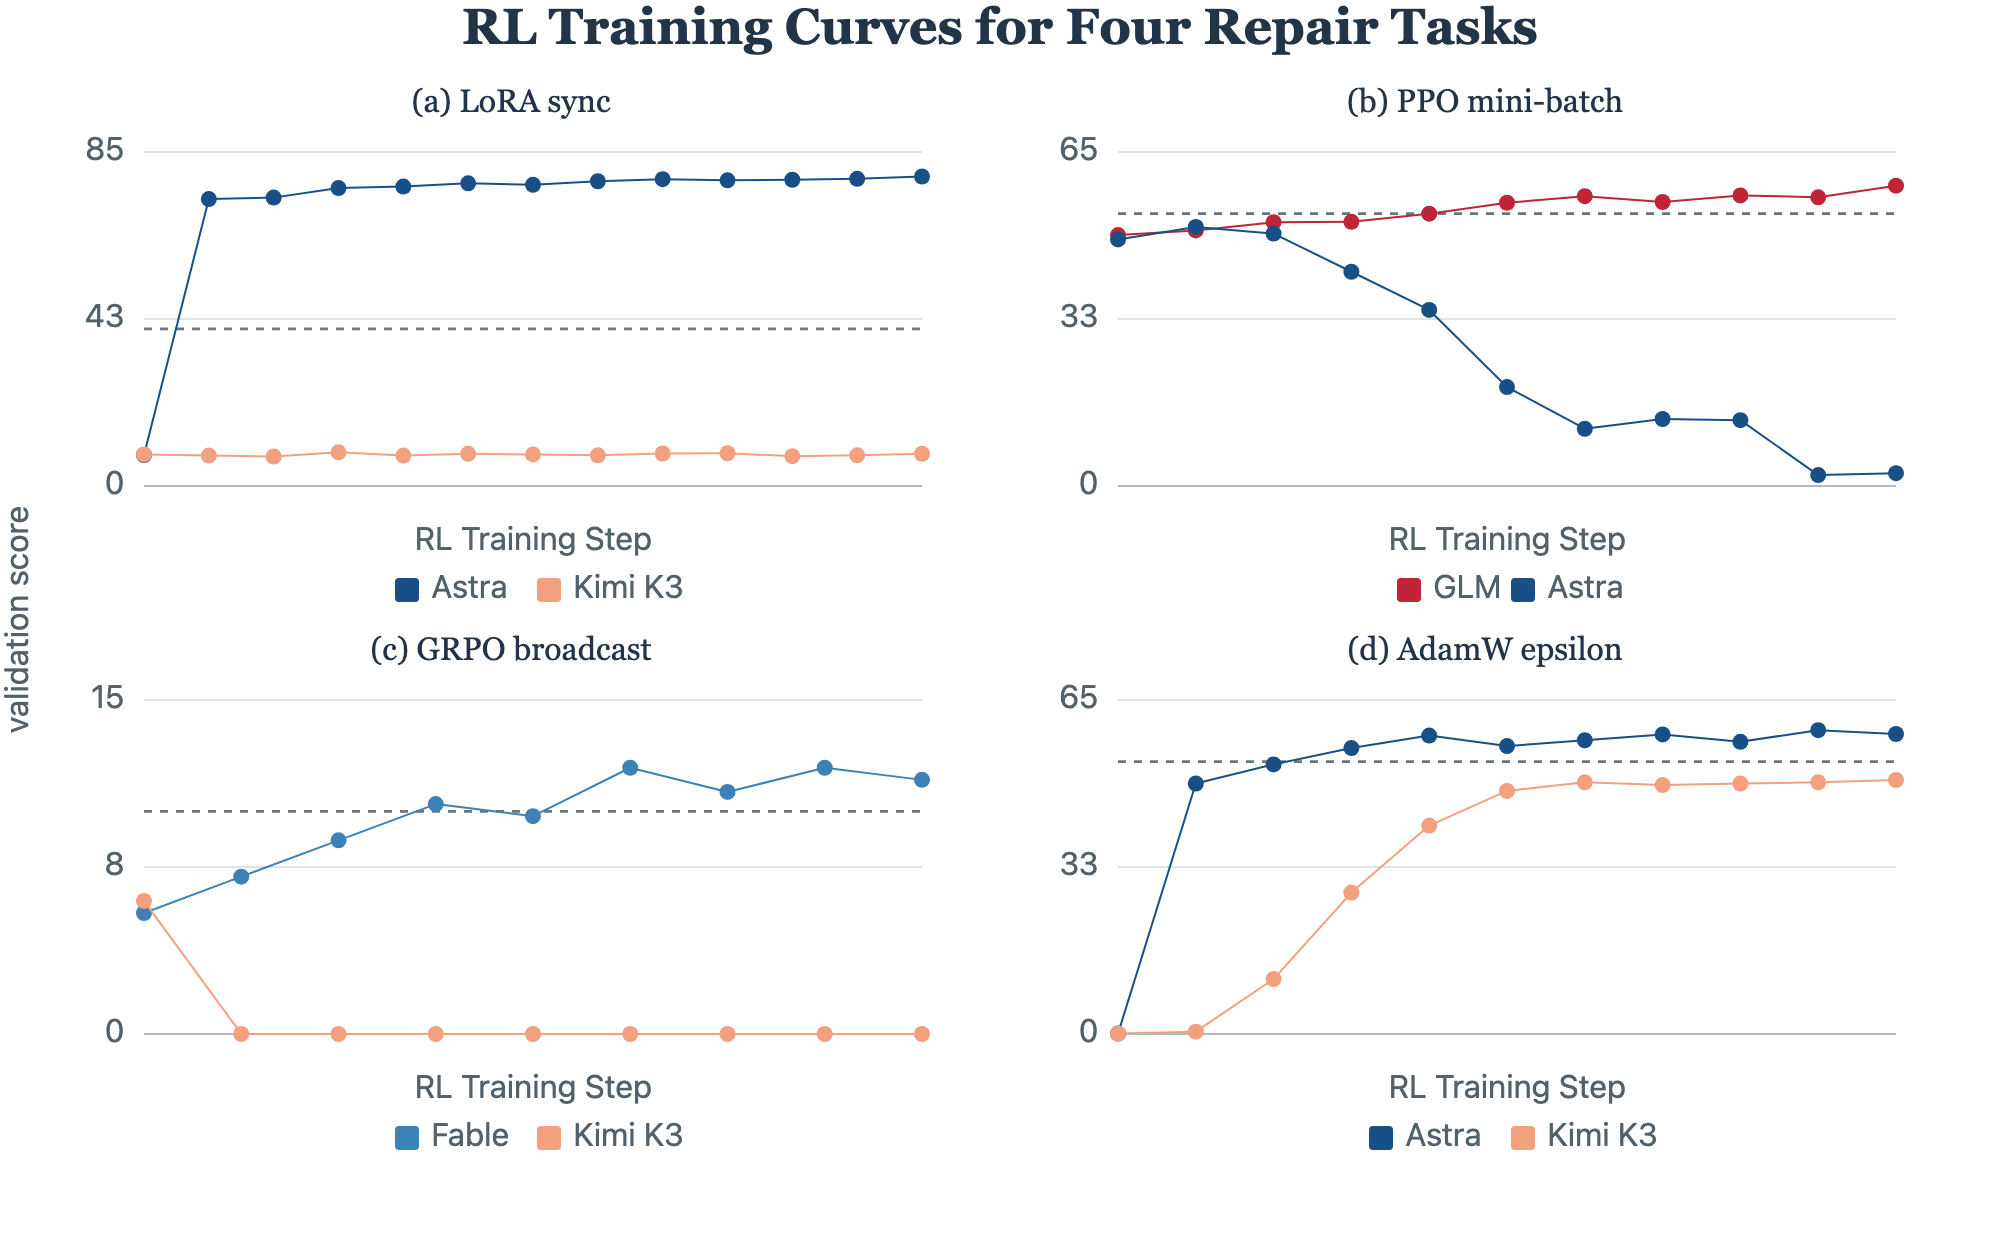
- Repair:修改 workspace,系统在干净环境中重新运行训练,并根据最终指标判定修复是否有效。
更难:故障不会直接报错
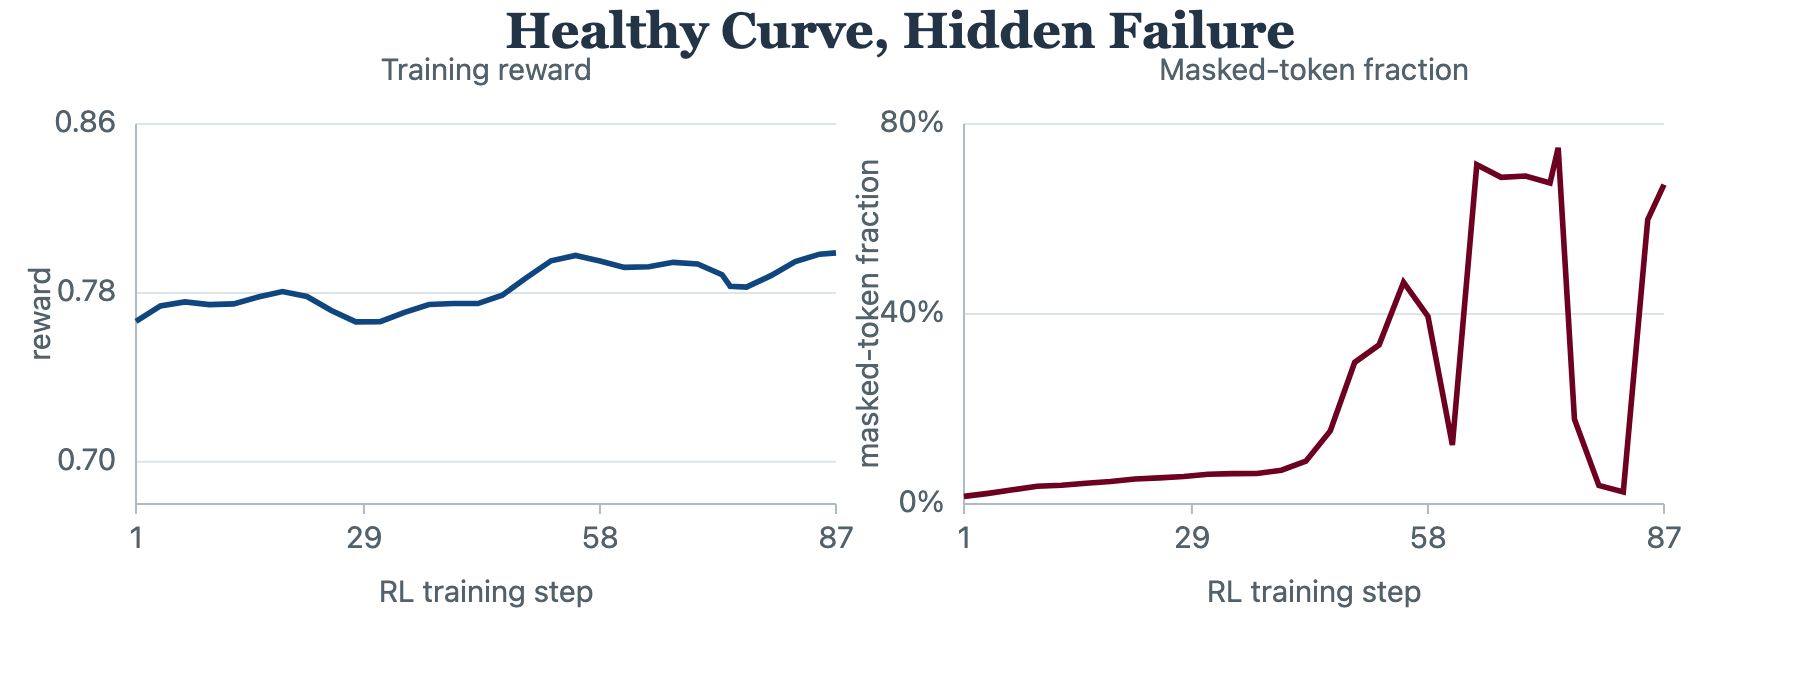
AutoRLBench重点收录隐蔽故障,例如 reward 看似上涨但模型学到了错误目标,训练曲线正常但日志暴露数据异常,或修复早期有效、训练后期再次崩溃。
这些任务要求 agent 联合分析代码、配置、日志和指标,而不能只看一条曲线。
更多样:覆盖完整 RL pipeline
覆盖六类RL故障:
- Configuration:参数或组件协议错配;
- Reward:奖励信号或实现异常;
- Data:训练、验证和数据加载问题;
- Environment:外部环境和工具反馈异常;
- Algorithm:采样与策略更新逻辑缺陷;
- Infrastructure:训练、推理和系统协同故障。
覆盖更多应用场景:
-
数学:考察数学推理、答案验证和奖励设计中的数据与逻辑故障。
-
代码:覆盖代码生成、执行、测试和训练脚本中的实现问题。
-
Agent:
- 工具调用:检查工具选择、参数传递和返回结果处理是否正确;
- 软件工程:覆盖代码修改、依赖管理、测试和完整执行路径;
- GUI:评估智能体在视觉界面中的操作、状态判断和交互反馈。
初步结果:发现失败比解释根因容易
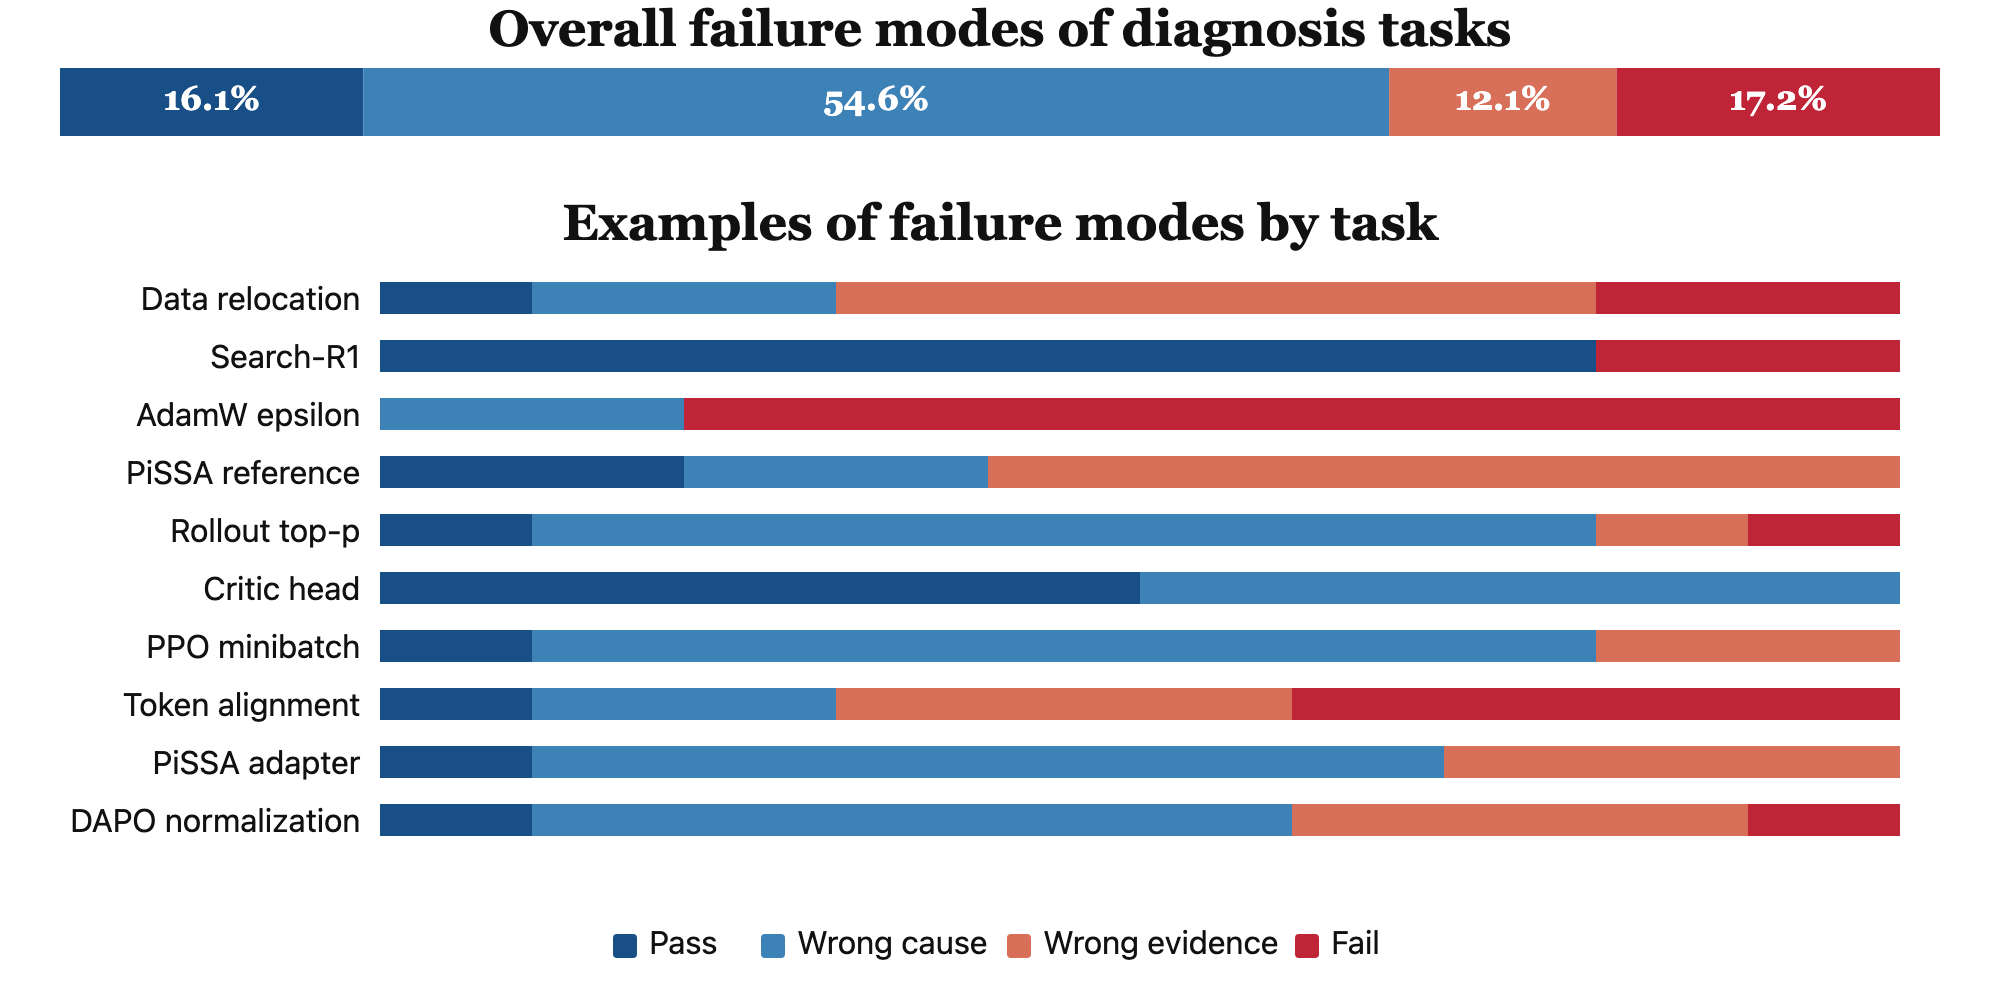
下面的结果来自当前版本的初步评测快照,不是完整评测,也不是最终结论。当前测试包含 10 个前沿模型、340 条诊断轨迹和 170 条修复轨迹,最高整体通过率为 37.3%。
其中,83.6% 的轨迹正确判断训练状态不健康,但只有 27.5% 找到了正确根因。智能体更容易发现“出问题了”,却很难回答“为什么出问题”。
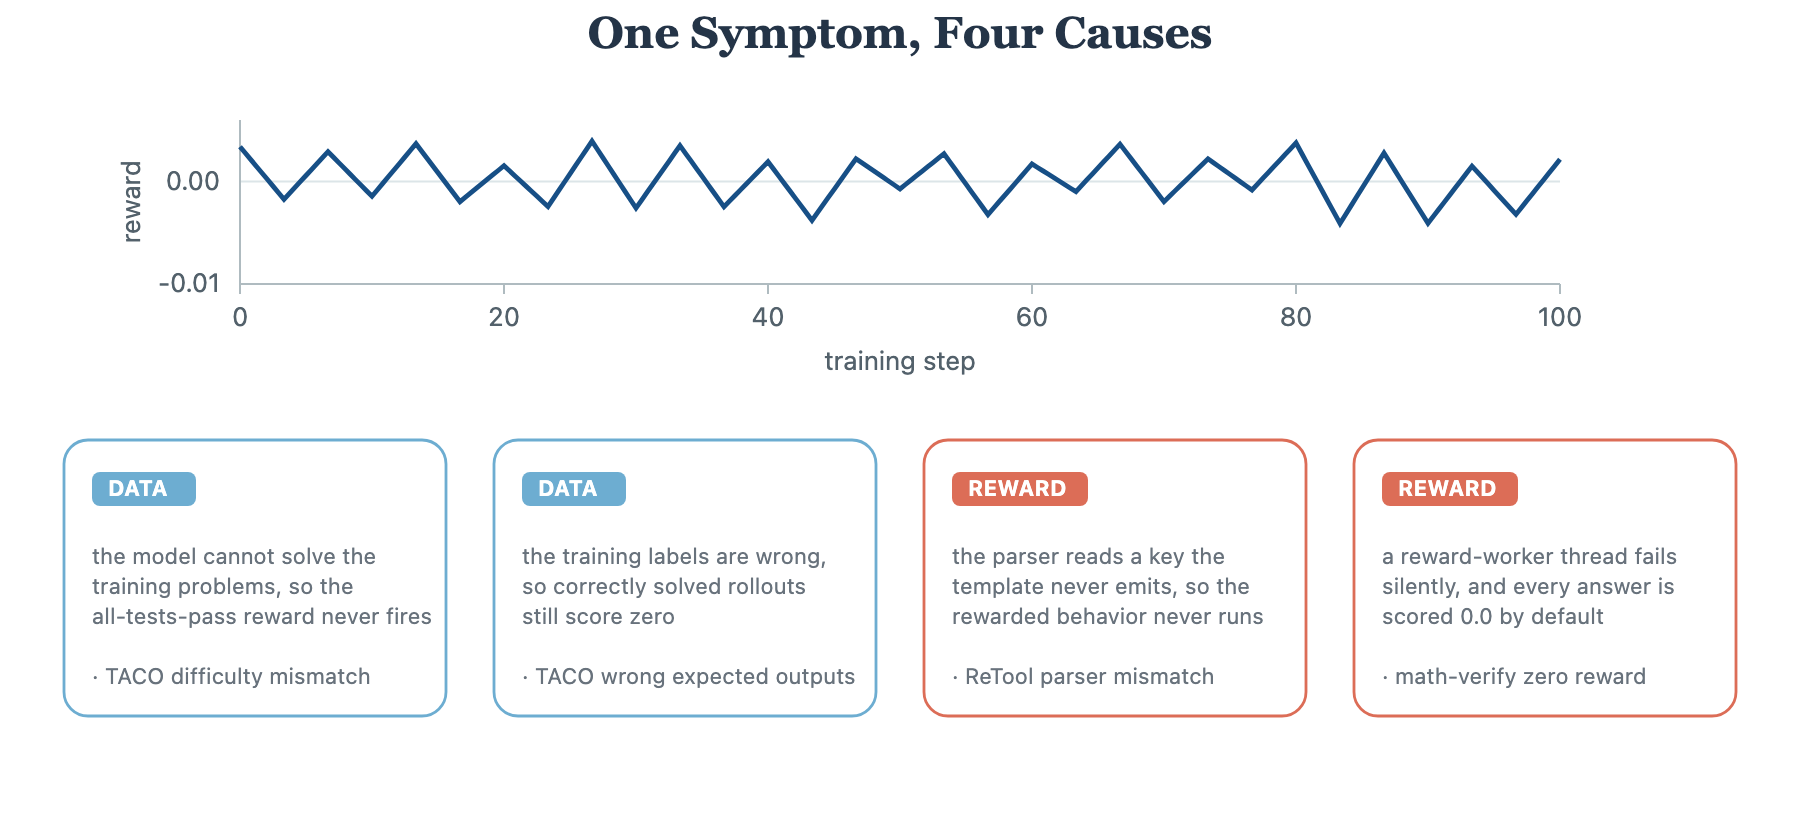
同一条近零 reward 曲线,可能来自数据难度不匹配、标签错误、解析器失效或 reward worker 失败等不同原因。
有些 reward 曲线看起来健康,但 masked-token fraction 已经快速升高。只有结合日志和执行机制,才能发现隐藏故障。
修复也不能只看短期反弹。部分补丁早期改善明显,完整训练结束后却再次下降。
项目仍在进行,欢迎贡献真实案例
AutoRLBench仍在持续更新。我们希望收集更多没有显式报错、涉及多个组件、需要长链条推理,或只有训练后期才暴露的 RL 故障。
如果你手上有一段曾经跑崩、排查困难或修复耗时很长的训练,欢迎提交代码、配置、日志和已有修复。真实、可复现的失败案例,都可能成为帮助社区评估智能体能力的下一道标准题。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册