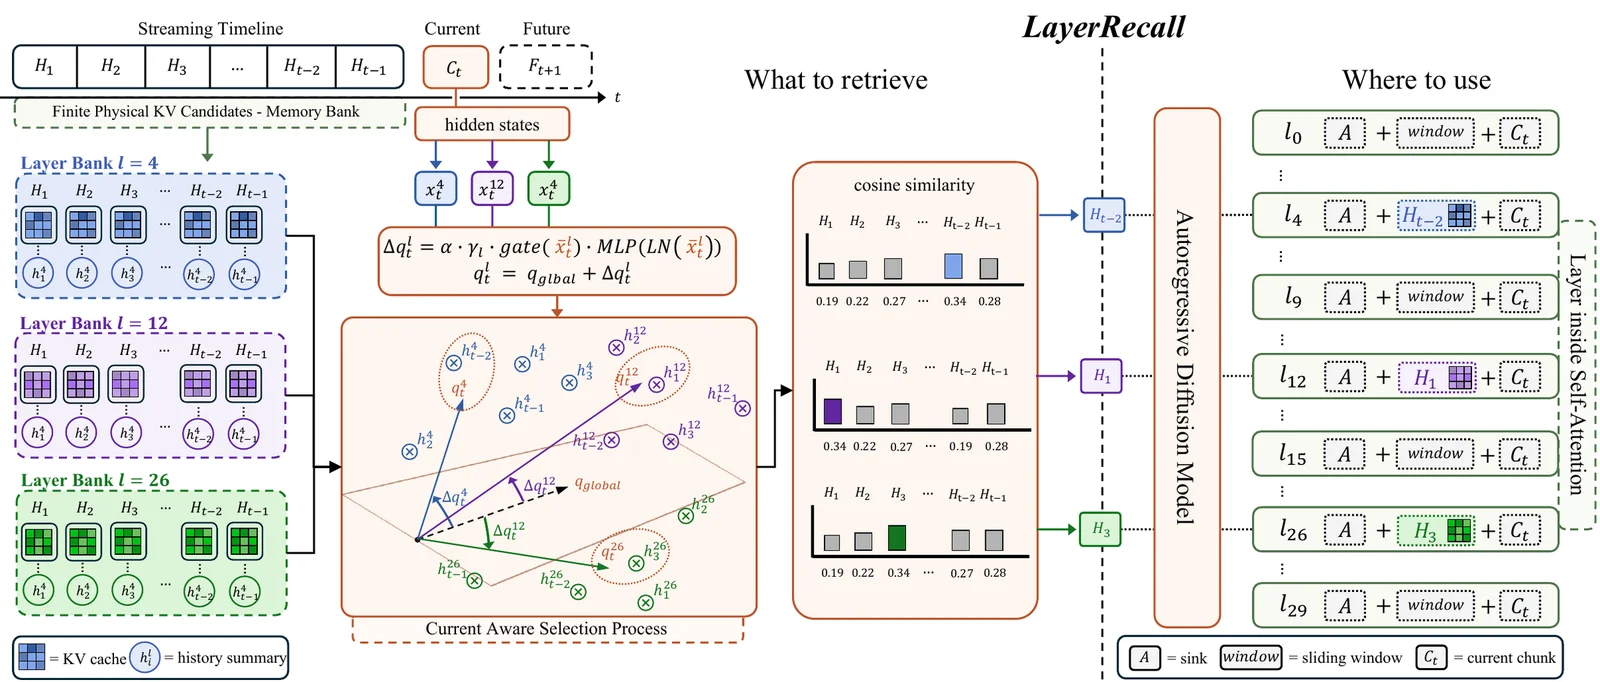
精选文章 不让每一层都“翻旧账”!浙大 & 港大最新开源 LayerRecall,让长视频记忆更准、用得更精 AI能连续生成一分钟视频,就算解决了「长视频」问题吗? 真正的考验,往往发生在主角离开镜头之后。 第一幕,一个穿特定服装的人出现在实验室;第二幕,他离开画面;第三幕再次返回时,模型可能已经给他换了脸、换了衣服,甚至把原本应该回来的物体也一起「忘」了。 原因并不神秘。自回归视频模型通常一段一段生成画面
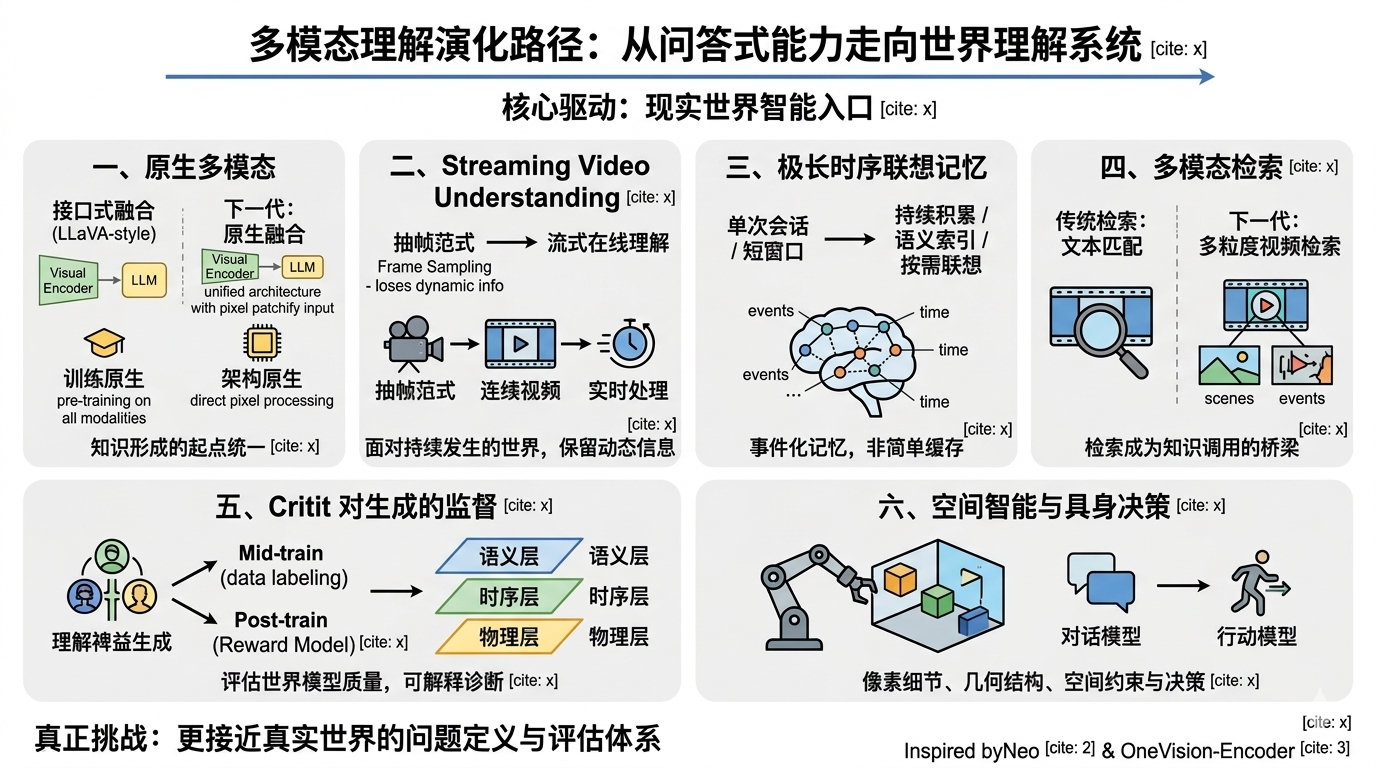
精选文章 多模态理解可能的未来:从描述世界到进入世界 作者:Yuwei Niu 应该是从去年做完WISE 开始,碰到我的朋友都以为我是做生成出身的,但其实我从最开始做科研就是沿着CLIP LLaVA的经典多模态理解路线,并且我心中也一直更喜欢多模态理解多一些。 然而,近一年以来,似乎社区的热度在多模态方面始终更倾向于生成(GPT-Image, Nano
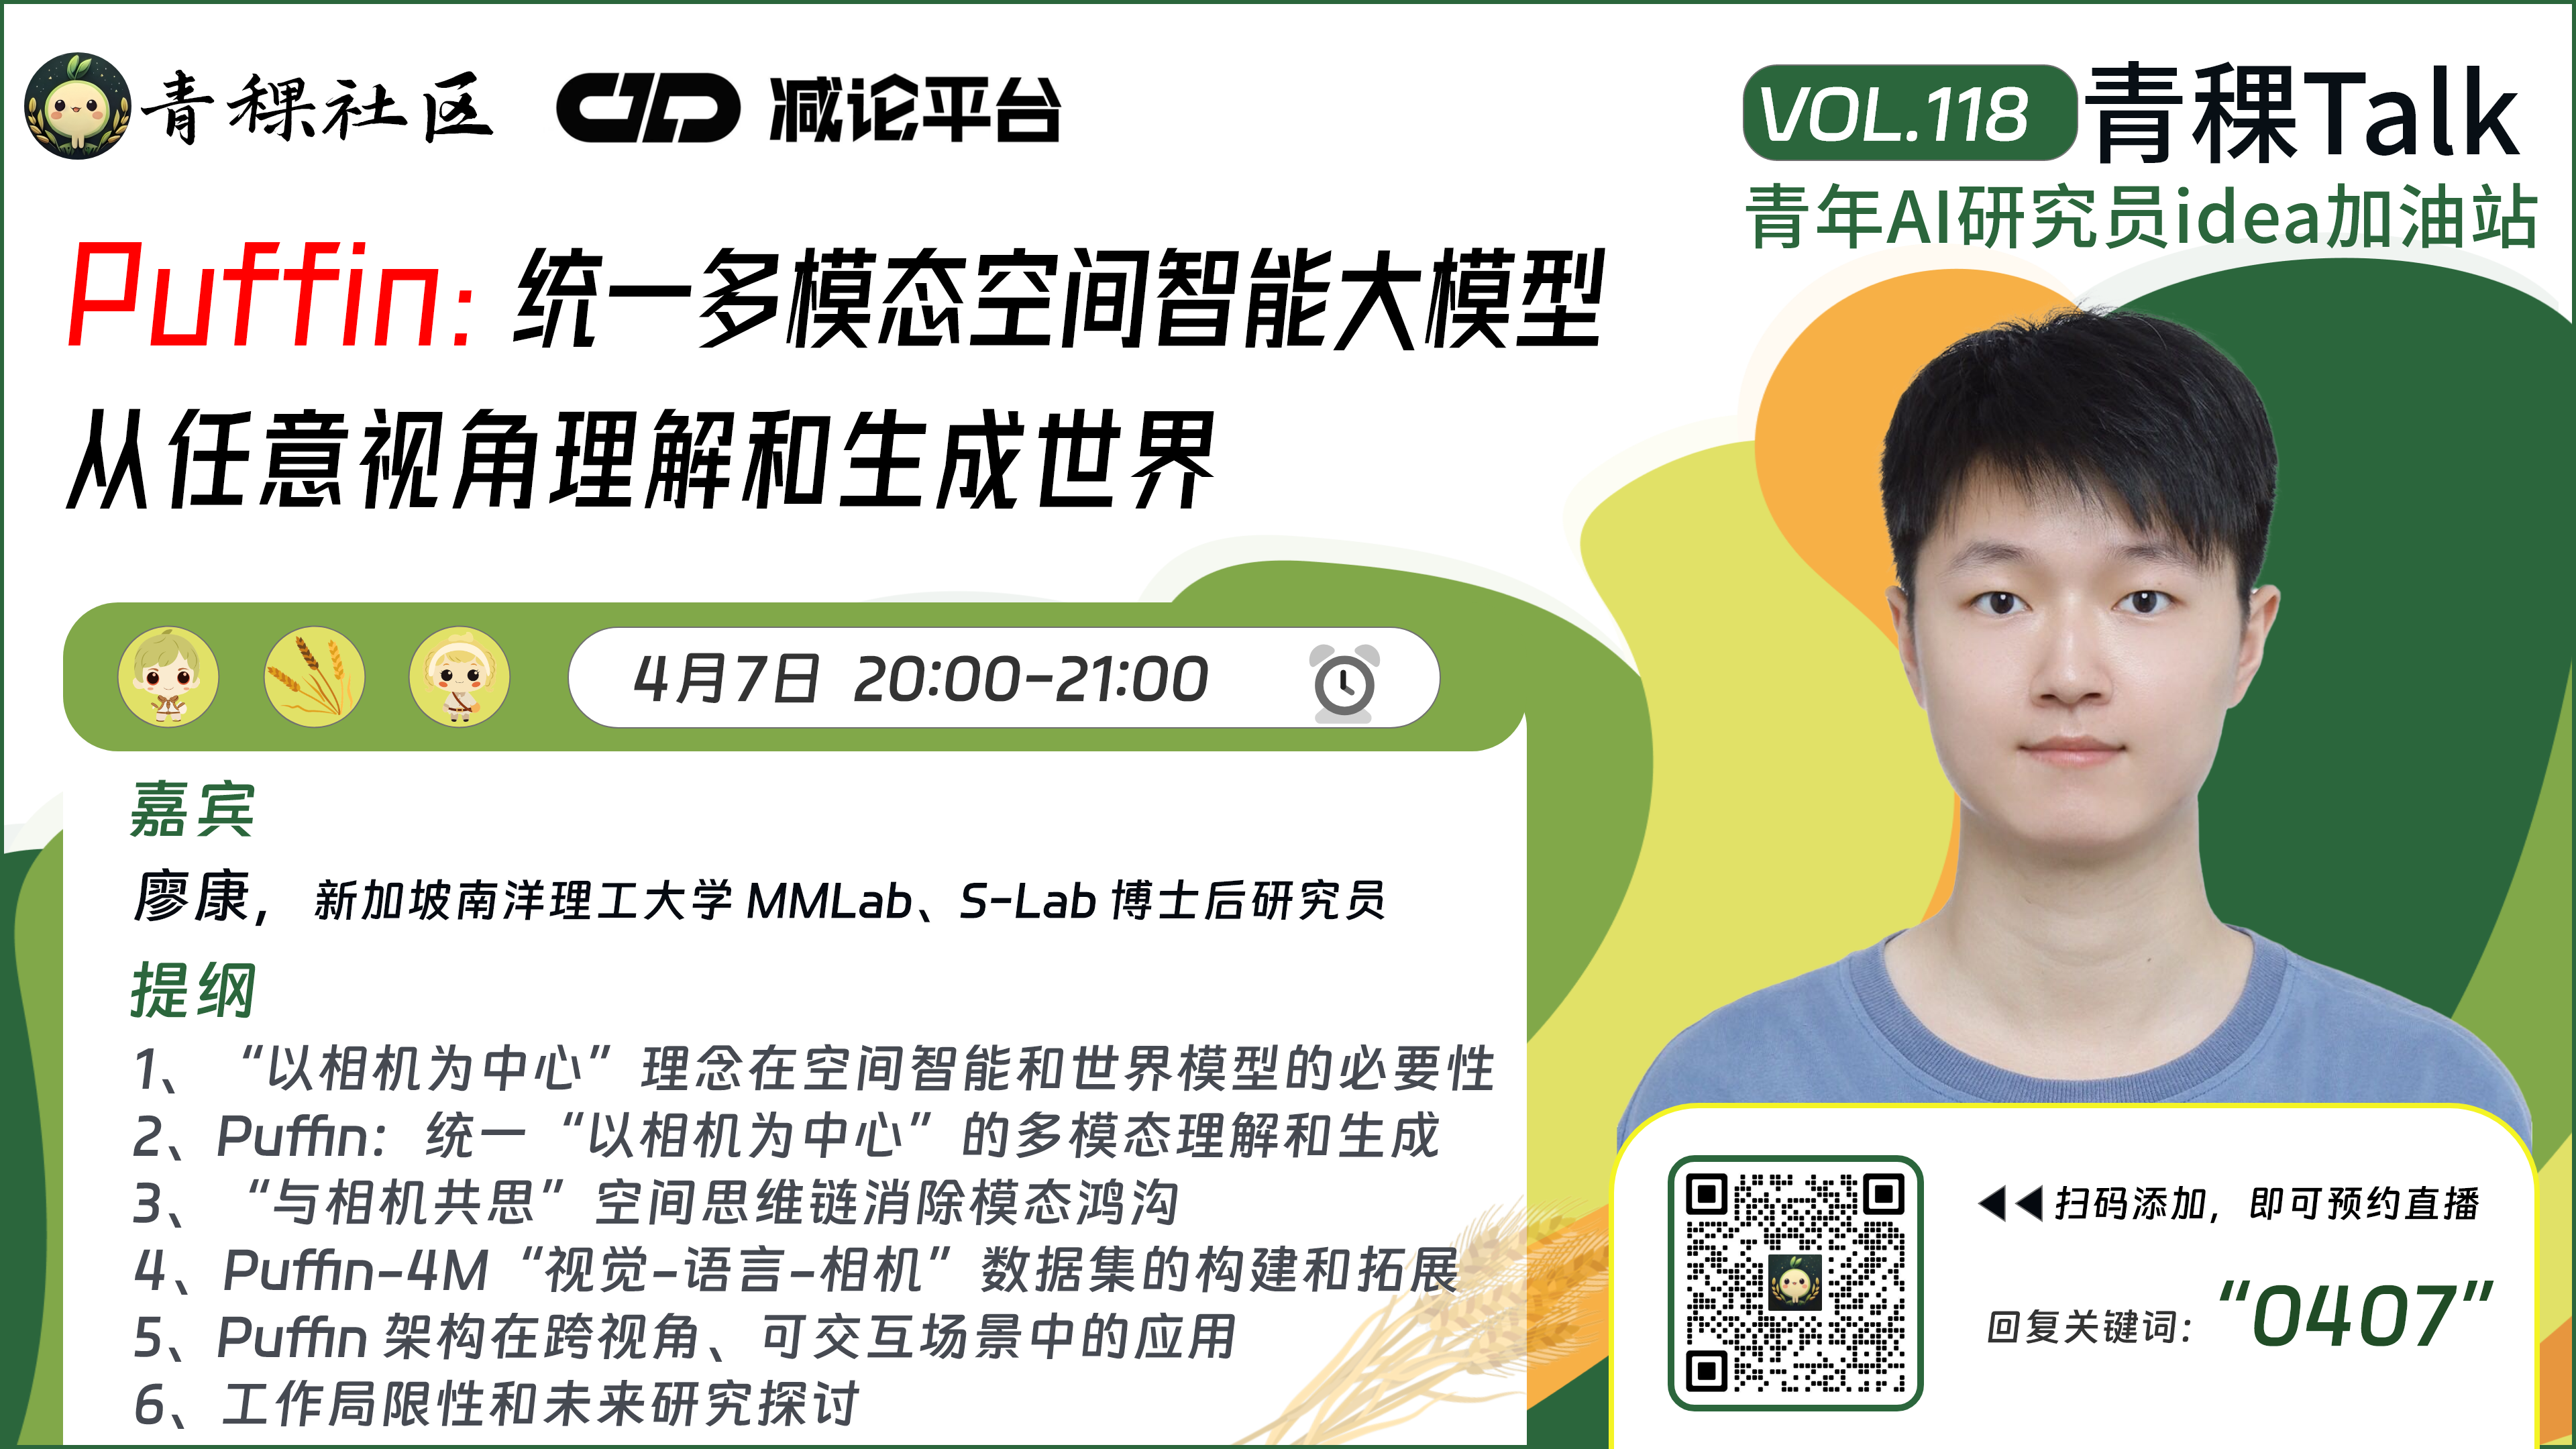
青稞Talk Puffin: 统一多模态空间智能大模型——从任意视角理解和生成世界 多模态空间智能不仅要求机器理解任意相机视角下的现实世界,更要求其具备从任意相机方位创造世界的能力。然而,当前的视觉与生成模型大多仅隐式地感知相机几何,或将理解与生成任务割裂开来。 新加坡南洋理工大学、商汤科技、密西根大学和马普所的研究者们联手提出了一种全新的范式——将“相机几何”破译为一种“语言”,
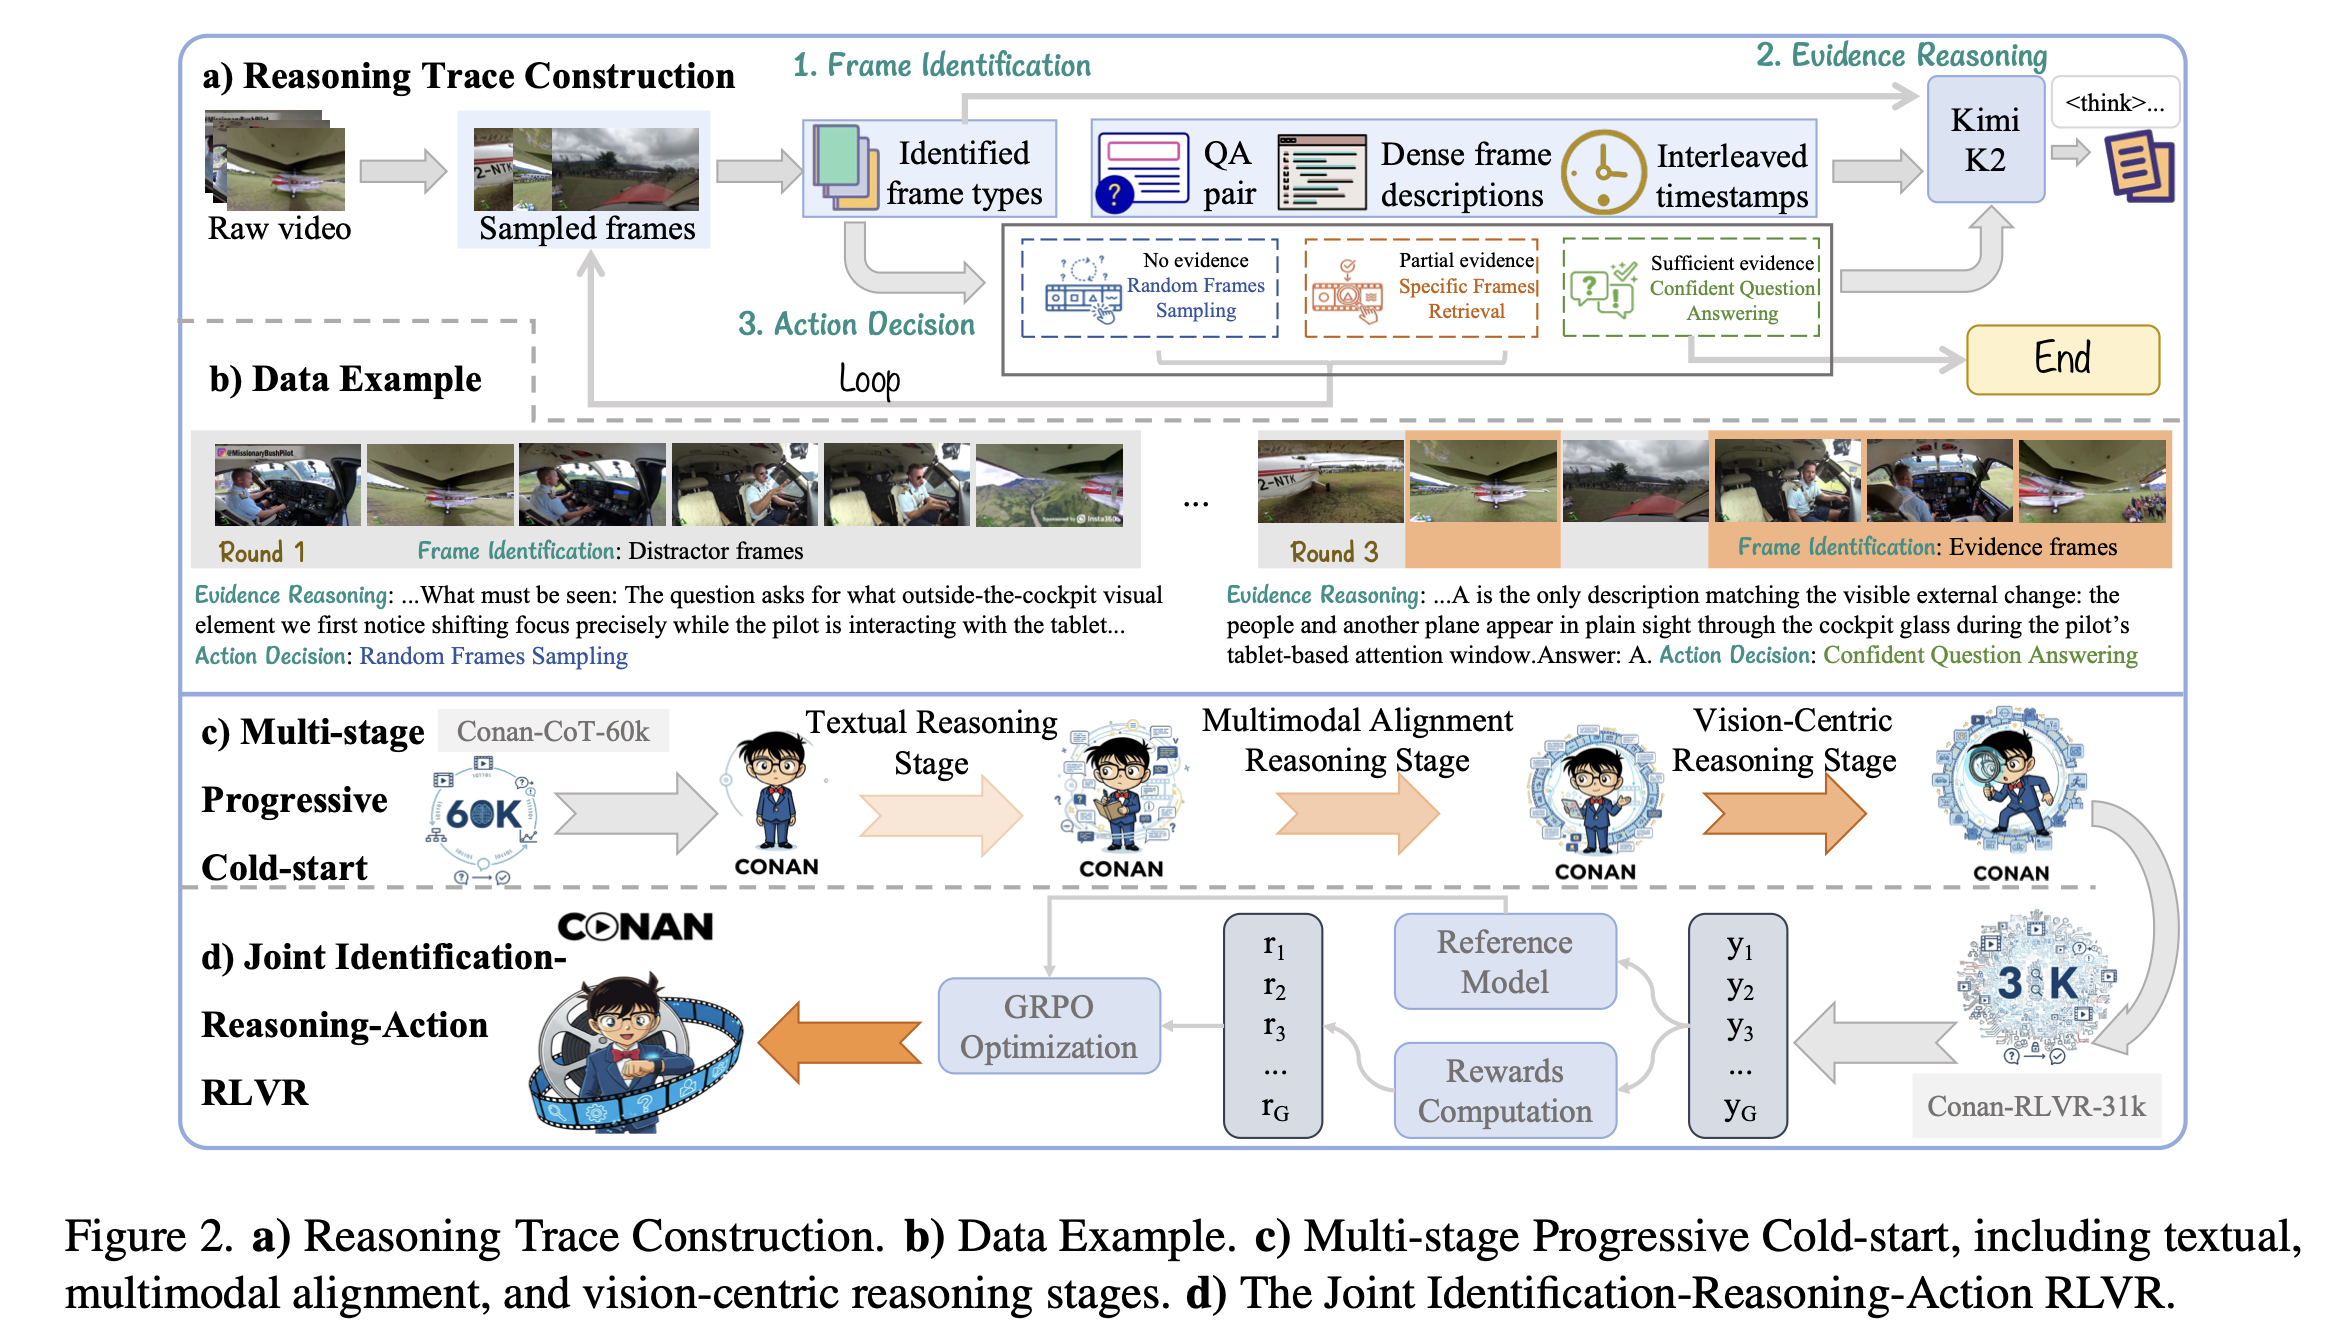
精选文章 北大&腾讯微信AI联合提出Conan:像侦探一样推理,多尺度视觉证据的多步视频推理框架 1.引言 在CVPR 2026接收的论文《Conan: Progressive Learning to Reason Like a Detective over Multi-Scale Visual Evidence》中,我们提出了基于多尺度视觉证据的多步视频推理框架,解决多模态大语言模型(MLLM
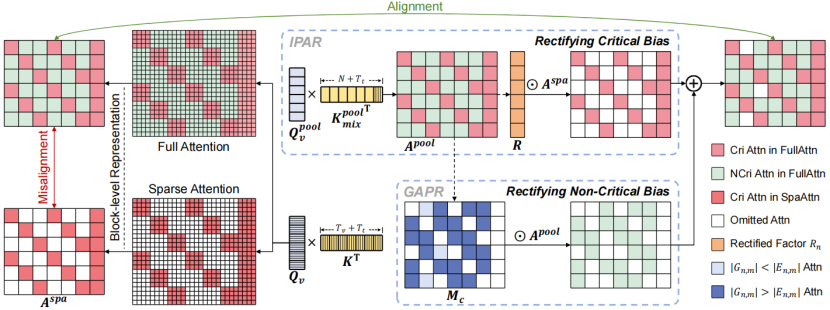
精选文章 为什么视频生成稀疏注意力做不好?中科院自动化所最新提出稀疏注意力纠偏新范式 生成式视频模型正以前所未有的速度进化,从数秒短片拓展至长时段叙事,从模糊低清跃升至逼真4K。然而,随着视频时长和空间分辨率的提升,序列长度急剧增加,二次复杂度的注意力计算量随之飙升,即便采用 FlashAttention 等高效优化,推理延时仍然难以遏制。以生成一段 720p、5 秒的视频为例,单是
青稞Talk SANA-Series:探索图像视频扩散模型的高效设计与加速 随着 GenAI 视觉模型(如 Sora 2、Google Nano Banana)的爆炸式发展,其惊人的效果背后是庞大的计算资源消耗。图像和视频模型的推理 FLOPs 甚至远超 LLM,导致部署成本高昂,难以普及。 SANA系列模型作为高效生成式基础模型的前沿探索,通过引入线性注意力(Linear
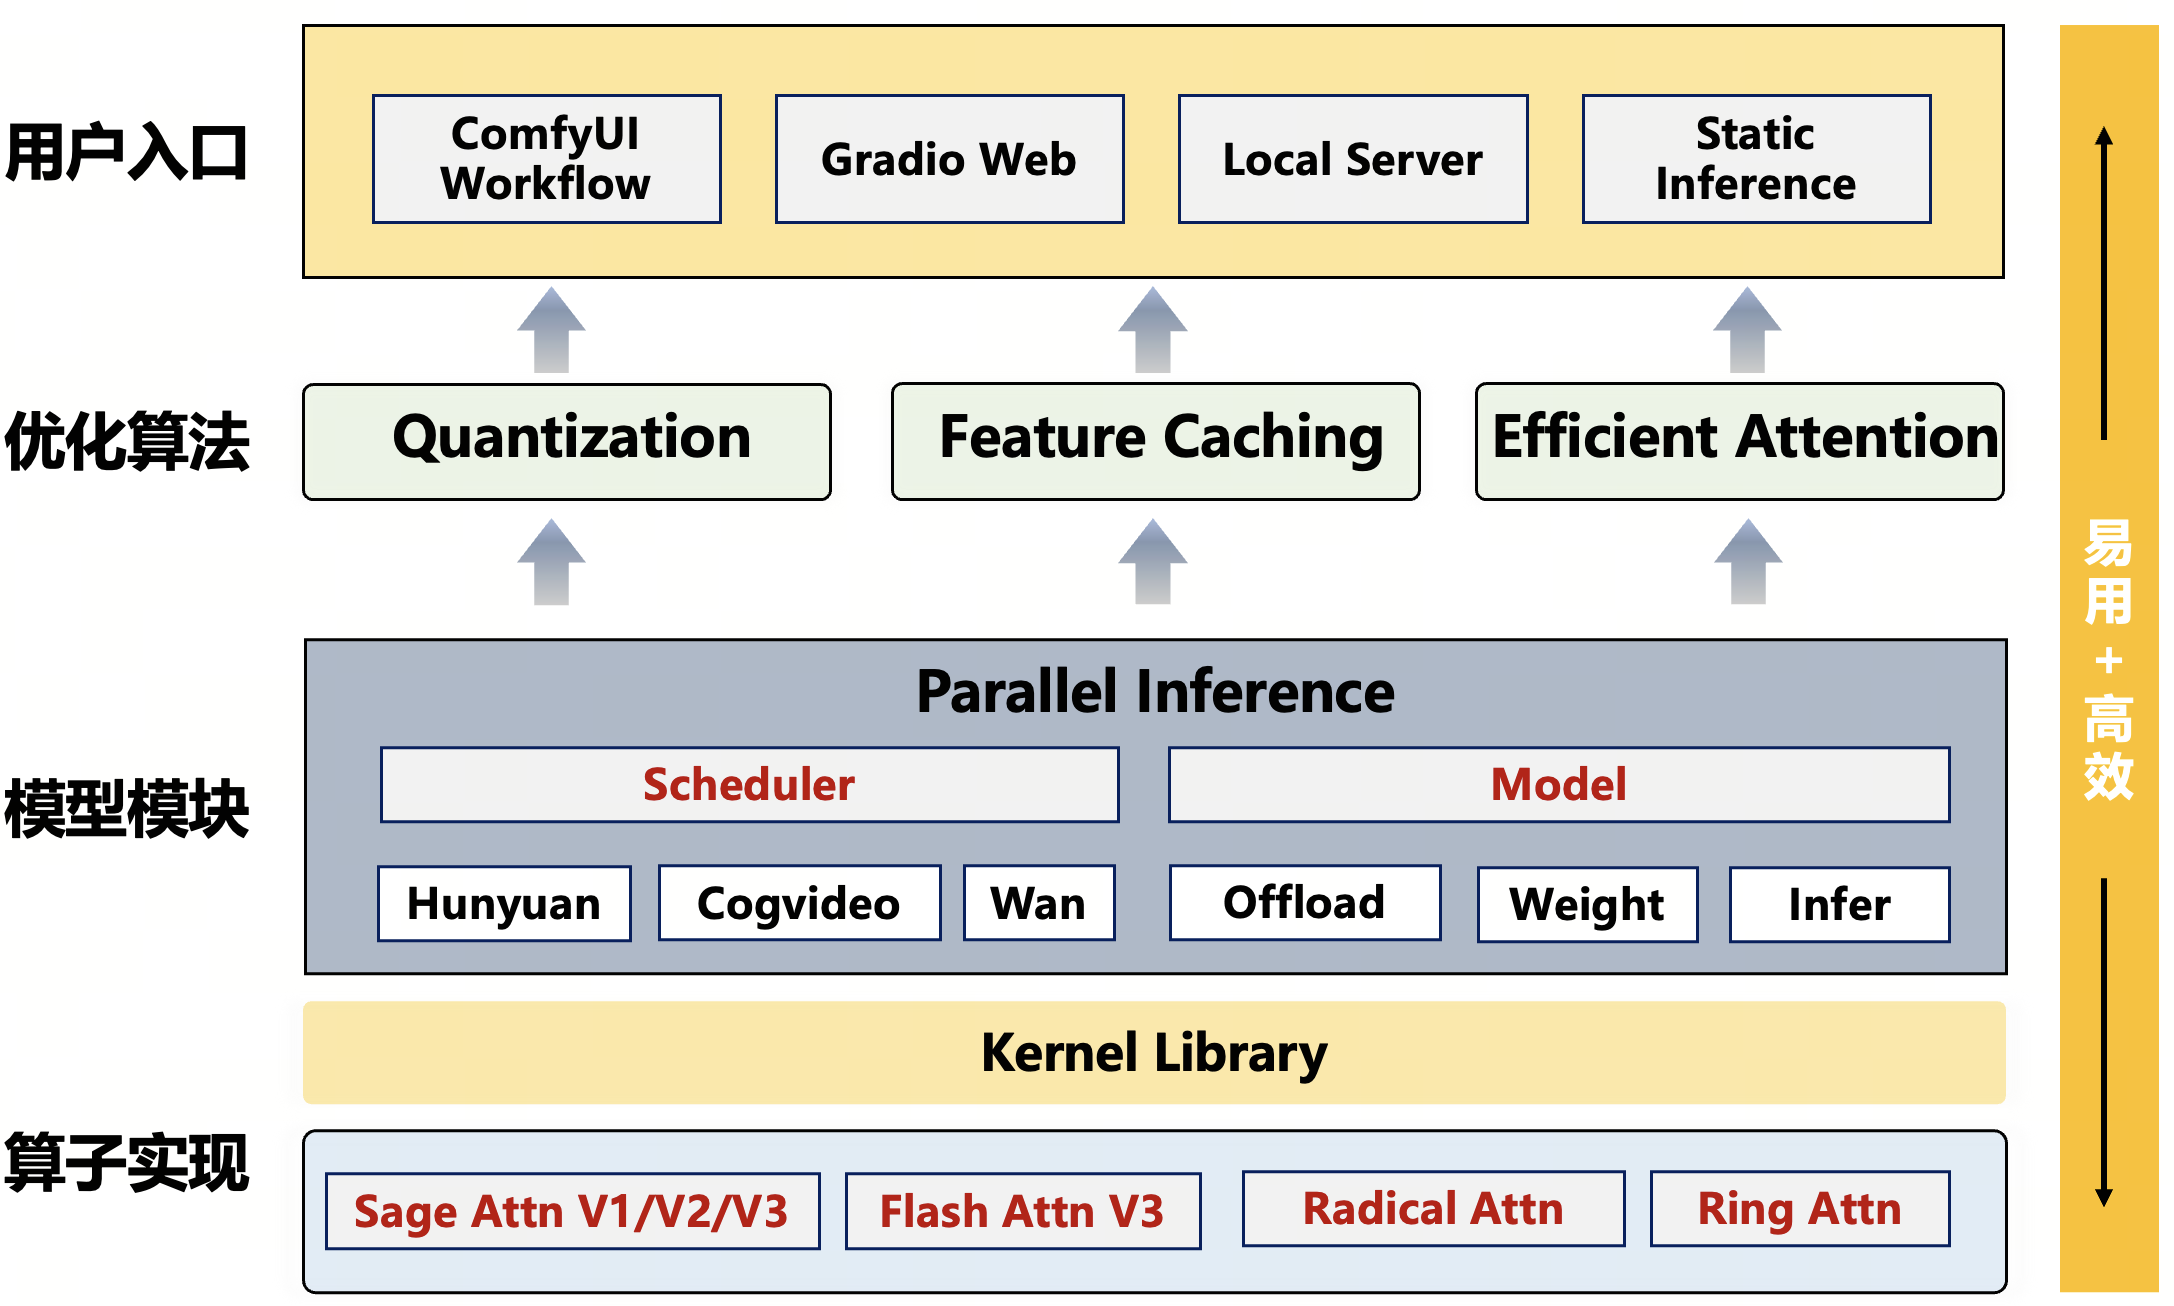
精选文章 Day 0支持HunyuanVideo 1.5!LightX2V让AI视频创作迈入实时生成时代 LightX2V:AI视频创作迈入实时生成时代 就在刚刚,HunyuanVideo 1.5模型正式开源,其官方页面展示了LightX2V视频生成推理框架作为首发支持方案,助力该模型在消费级显卡上实现秒级视频生成。 LightX2V源自ModelTC Github社区,其LightLLM、LightC
青稞Talk ShotBench: 面向增强MLLM摄影语言理解能力的训练与评估体系 11月18日(周二)晚8点,青稞Talk 第90期,同济大学博士生刘洪博,将直播分享《ShotBench: 面向增强MLLM摄影语言理解能力的训练与评估体系》。 论文:ShotBench: Expert-Level Cinematic Understanding in Vision-Language
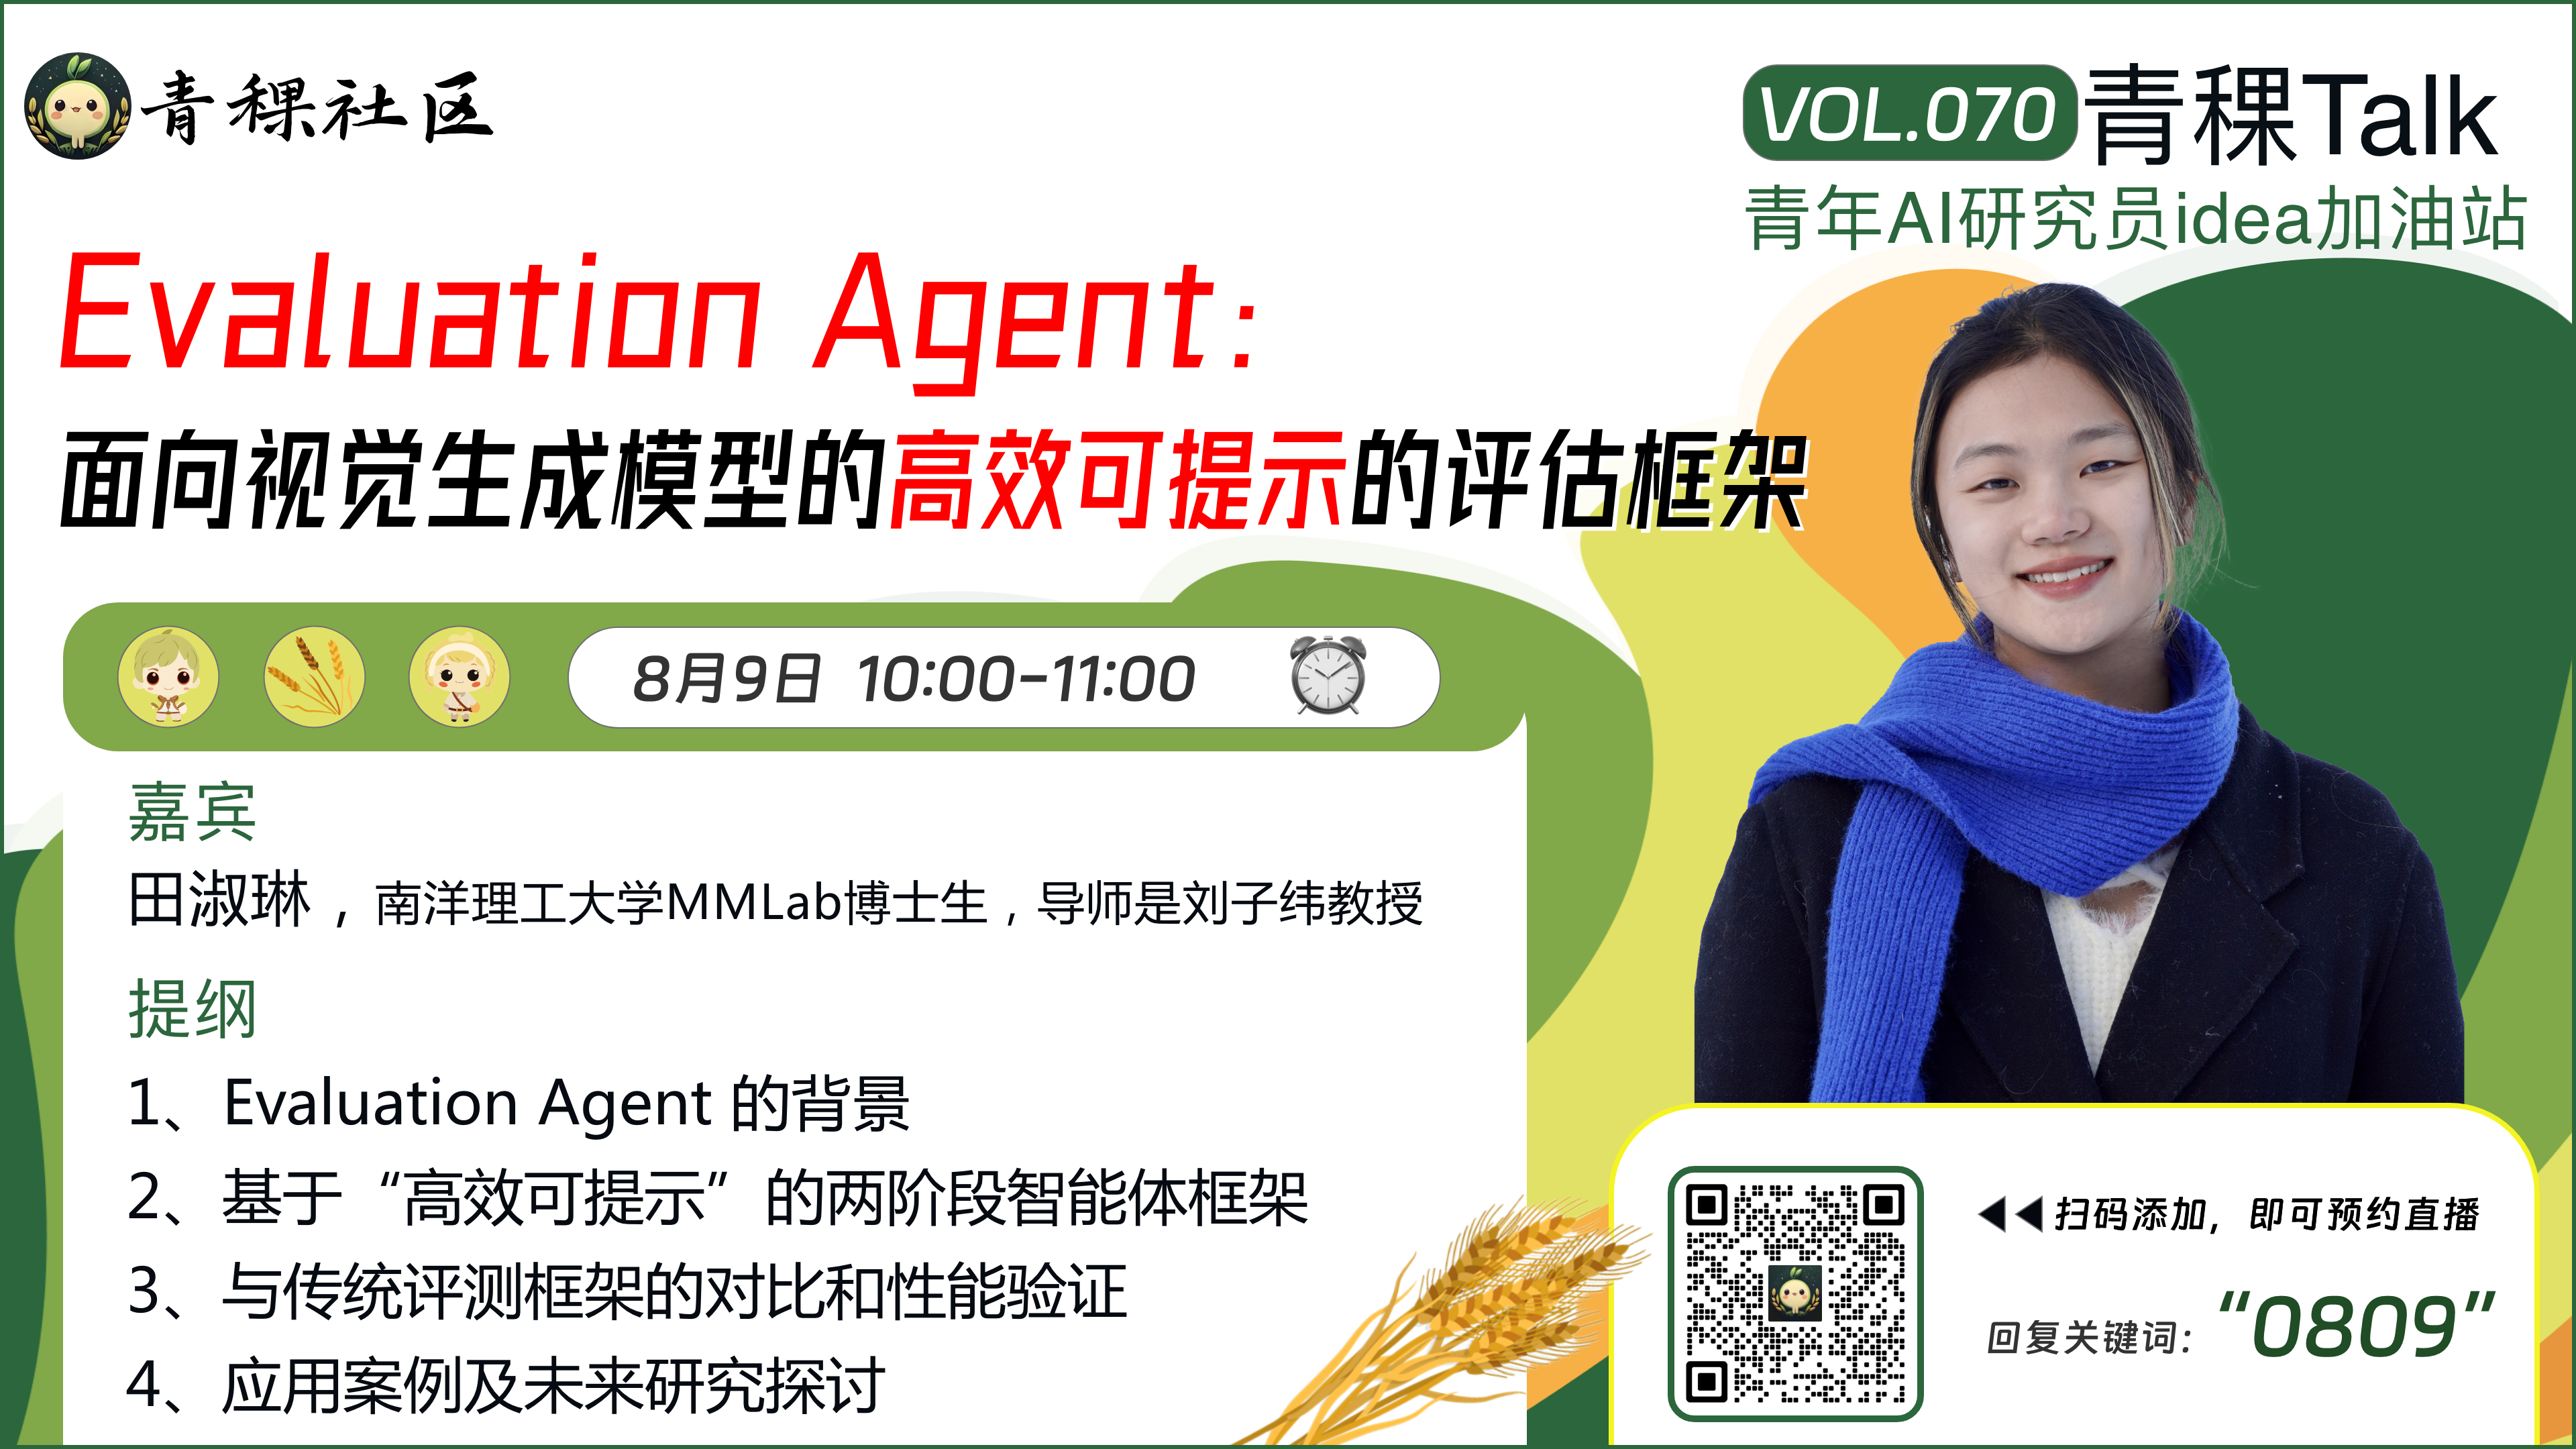
青稞Talk Evaluation Agent:面向视觉生成模型的高效可提示的评估框架 8月9日(周六)上午10点,青稞Talk 第70期,南洋理工大学MMLab博士生田淑琳,将直播分享 ACL 2025 Oral 成果《Evaluation Agent:面向视觉生成模型的高效可提示的评估框架》。 论文:Evaluation Agent: Efficient and Promptabl
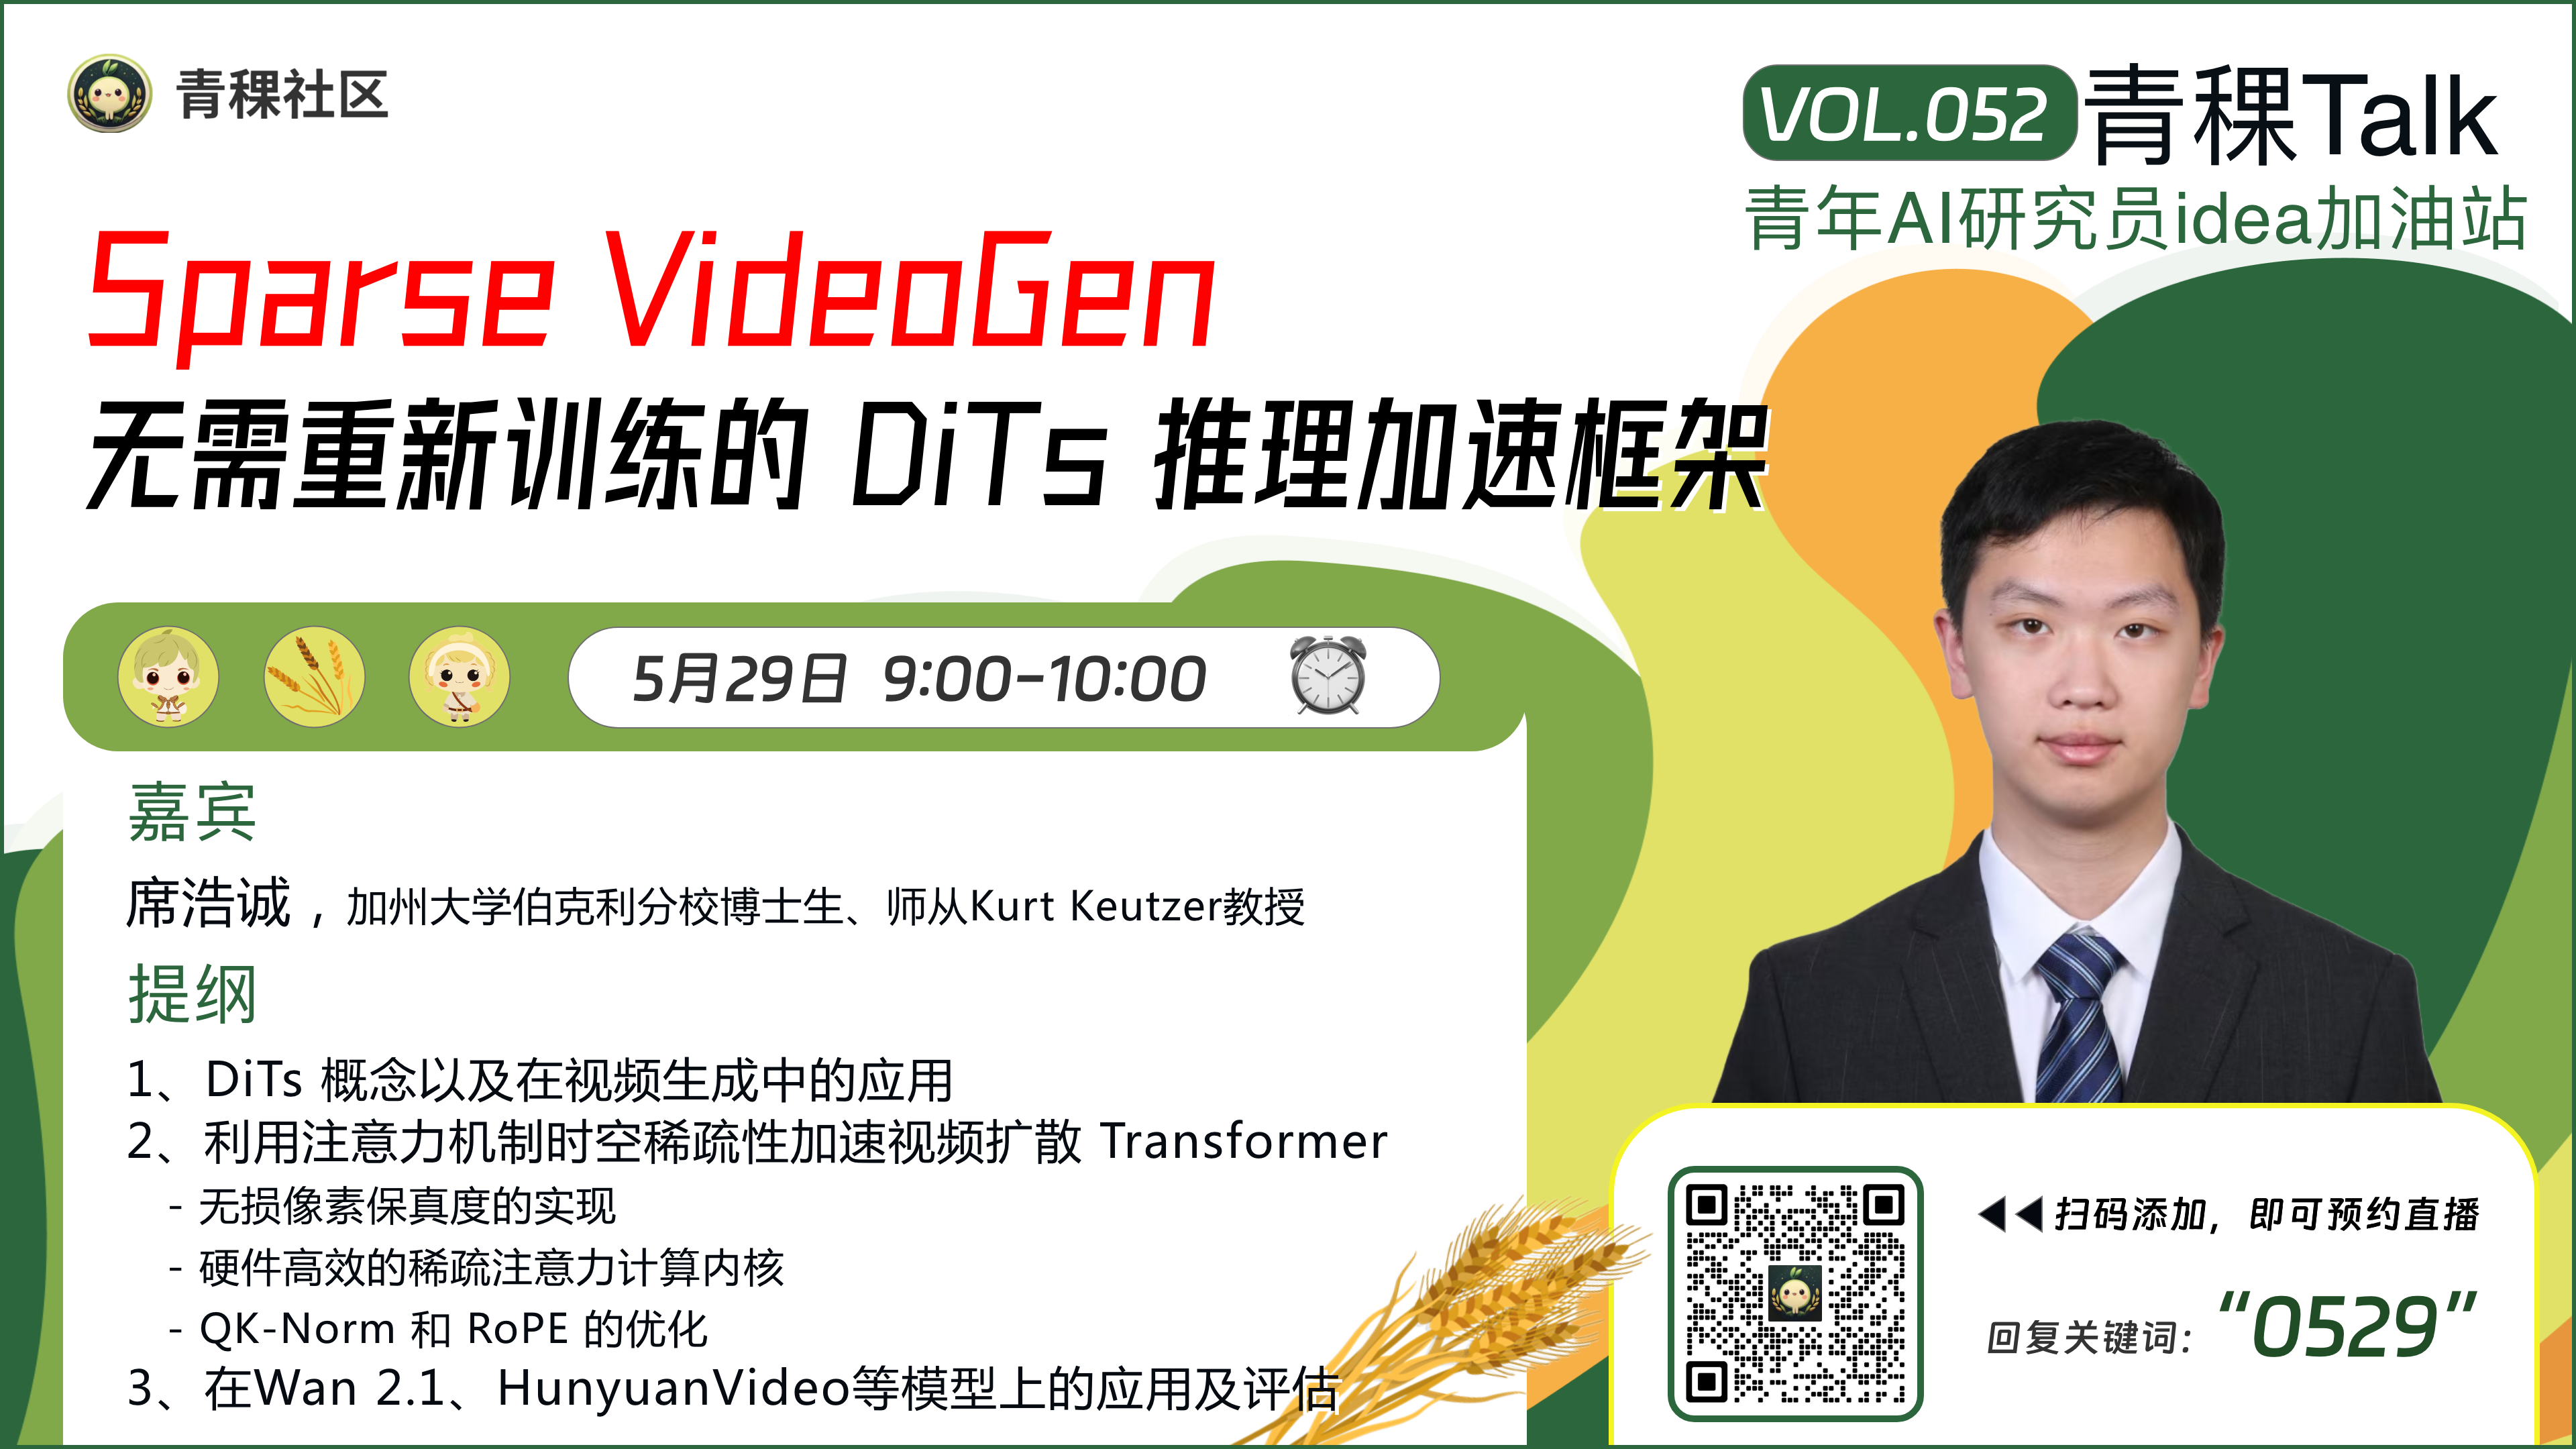
青稞Talk Sparse VideoGen:无需重新训练的 DiTs 推理加速框架 5月29日上午9点,青稞Talk 第52期,加州大学伯克利分校计算机科学博士生席浩诚,将直播分享《Sparse VideoGen:无需重新训练的视频扩散 Transformer 推理加速框架》。 分享嘉宾 席浩诚,加州大学伯克利分校计算机科学博士一年级学生,师从Kurt Keutzer教授,研究方向
青稞Talk Motion Dreamer:面向自动驾驶与物理世界对齐的视频生成模型 1月14日19:00,青稞Talk 第37期,香港科技大学(广州)博士生许添硕,将直播分享《Motion Dreamer:面向自动驾驶与物理世界对齐的视频生成模型》。 主讲嘉宾 许添硕,香港科技大学(广州)博士生,导师为陈颖聪教授,研究兴趣是自动驾驶、视频生成。 主题提纲 Motion Dreame
青稞Talk Follow Family:可控视频生成方法探索与应用 主讲嘉宾 马跃,香港科技大学计算机博士生,清华大学电子信息硕士,主要研究领域是视频生成、图片生成等,曾在百度,腾讯 AI Lab,腾讯混元作为算法研究实习,在NeurIPS,Siggraph,AAAI,CVPR,TMM等发表多篇高水平文章,曾经获得北京市优秀毕业生等荣誉称号。 主题提纲 Follow
青稞Talk K-Sort Arena:视觉生成模型的高效人类偏好竞技场 12月24日20点,青稞Talk 第34期,中国科学院自动化研究所博士生、新加坡国立大学访问博士生李志凯,将直播分享《K-Sort Arena:视觉生成模型的高效人类偏好竞技场》。 主讲嘉宾 李志凯,中国科学院自动化研究所博士生,新加坡国立大学访问博士生。研究方向为高效深度学习和模型压缩,以第一作者
青稞Talk CogVideoX 视频生成开源模型上手实践 9月23日20点,青稞Talk 第23期,智谱AI算法工程师,CogVideoX作者之一张昱轩,将直播分享《CogVideoX 视频生成开源模型上手实践》 主讲嘉宾 张昱轩,智谱AI算法工程师,CogVideoX作者之一;智谱多个开源仓库的核心贡献者。 主题提纲 CogVideoX 视频生成开源模型