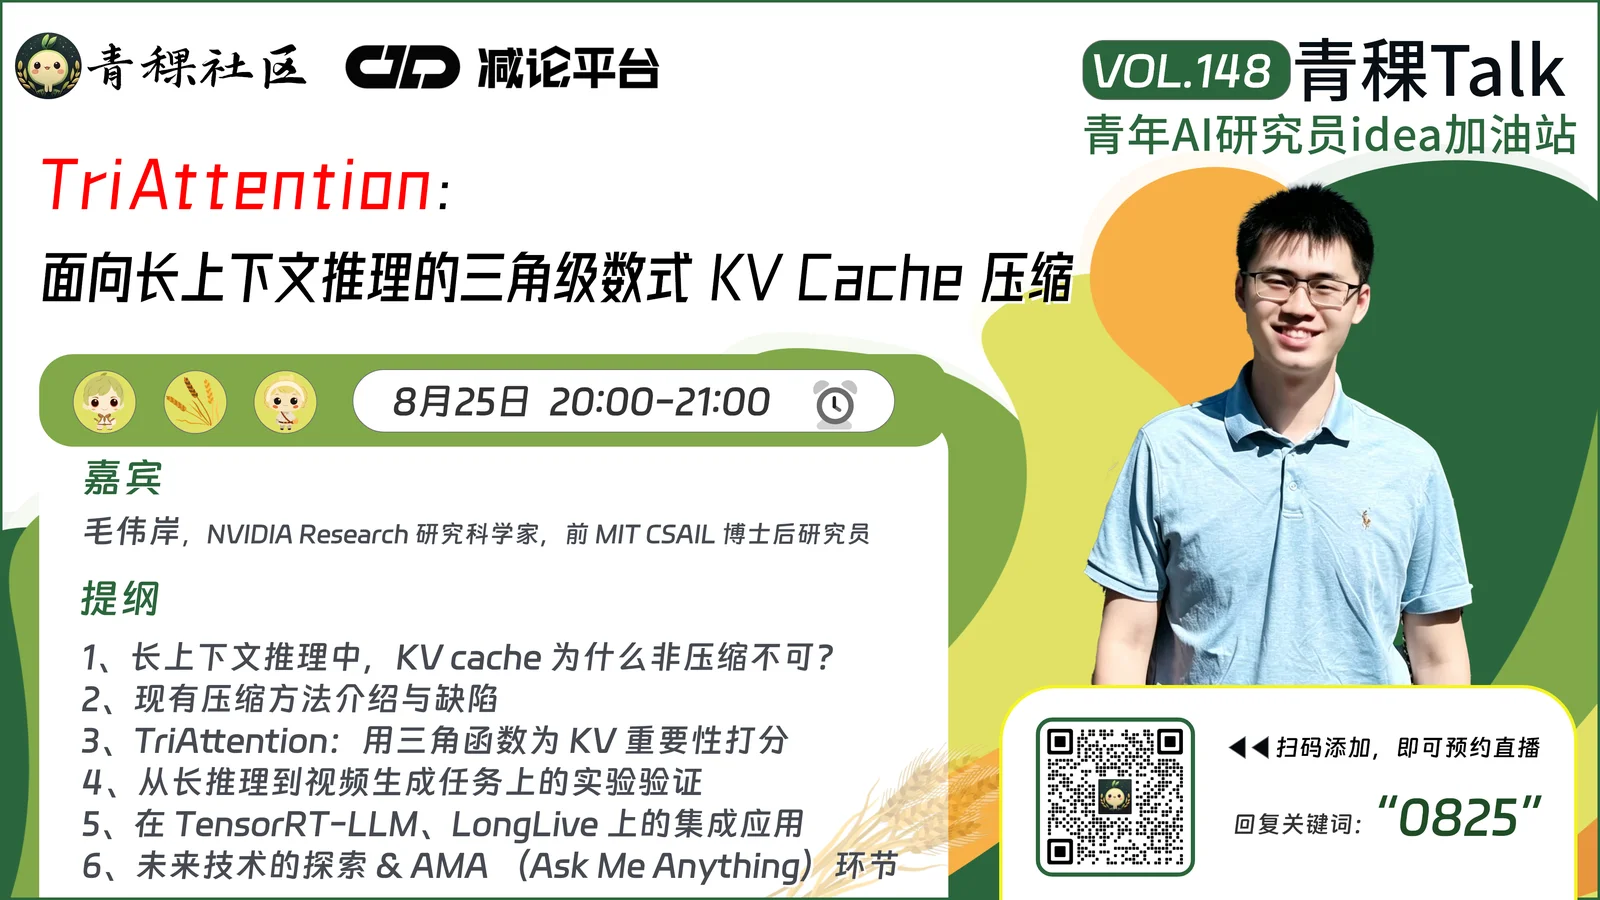
直播预告!和 NVIDIA Research 研究科学家毛伟岸,聊聊 TriAttention:面向长上下文推理的三角级数式 KV Cache 压缩
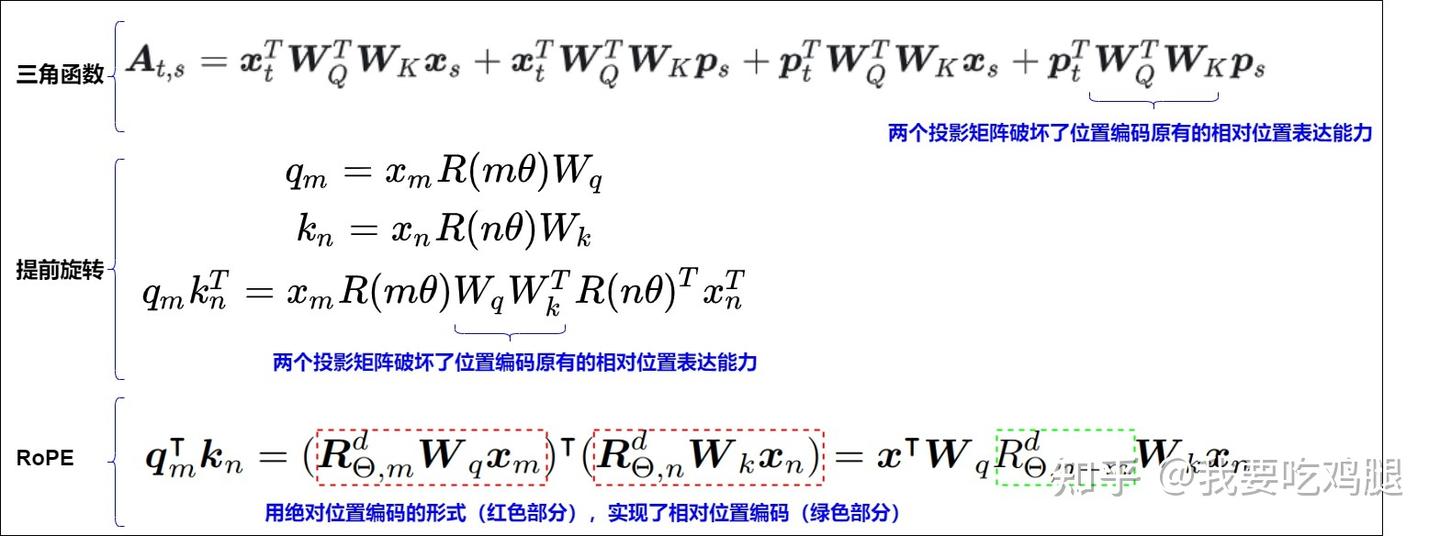
长推理与 long-horizon agent 的上下文越来越长,KV cache 随之成为显存瓶颈。 现有压缩方法多用最近若干 post-RoPE query 的注意力分数估计 key 的重要性;但 query 经 RoPE 后随位置旋转,只有最近一小段仍保持当前朝向,可用样本有限,估计精度受限,
Tag
共 2 篇文章