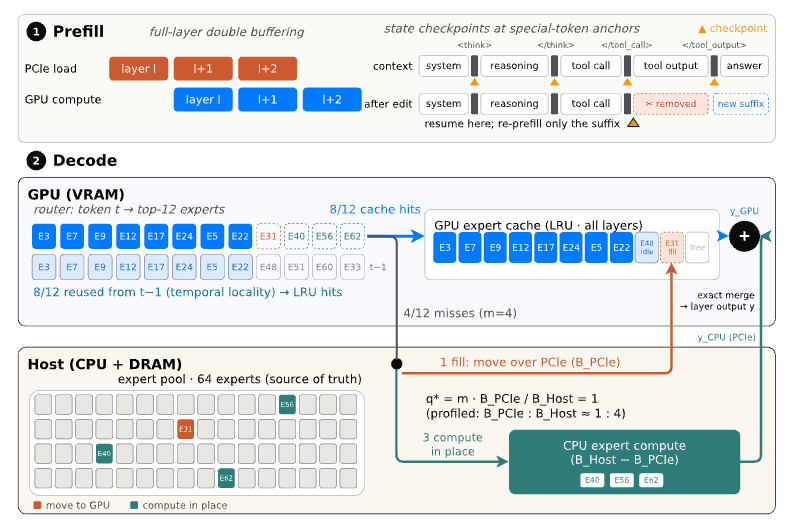
青稞Talk 直播预告!聊聊FreeToken:如何在 8GB 显存上跑起 35B 参数的 MoE 大模型 前沿开源权重模型正日益普及,但其部署服务目前仍主要依赖数据中心级别的基础设施。 来自 UC Berkeley、MIT 等团队推出了一种面向边缘设备原生设计的混合专家(MoE)推理服务系统: FreeToken,它不再将个人计算机简单视为一块小型 GPU,而是将其建模为一个统一、弹性可伸缩的推理平台。
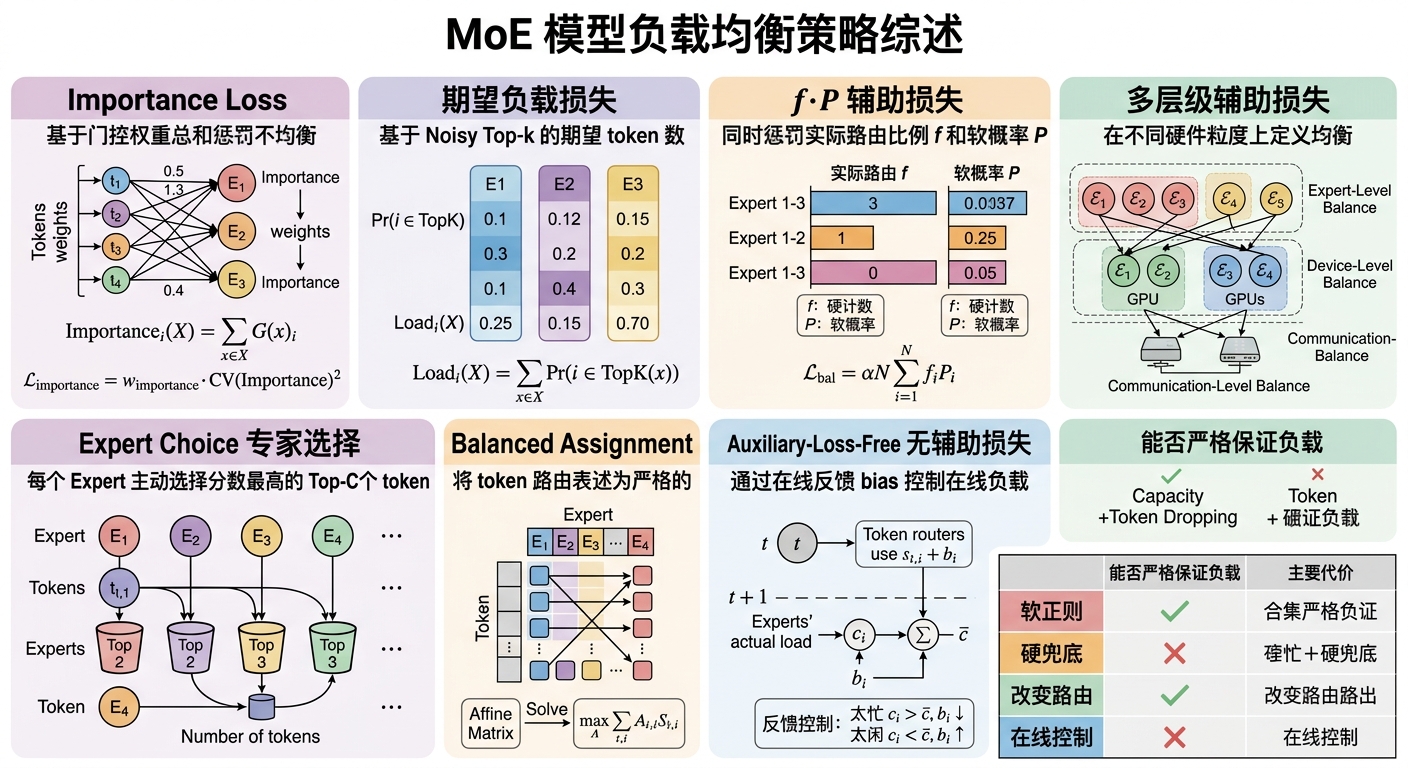
精选文章 大模型 MoE 负载均衡的 N 种方法 作者:觉醒也醉了 https://zhuanlan.zhihu.com/p/2066914125012283729 MoE 中的负载 假设一个 batch(或一个路由 group)中有 T 个 token、N 个 routed experts,每个 token 选择 k 个 Expert。 Rout
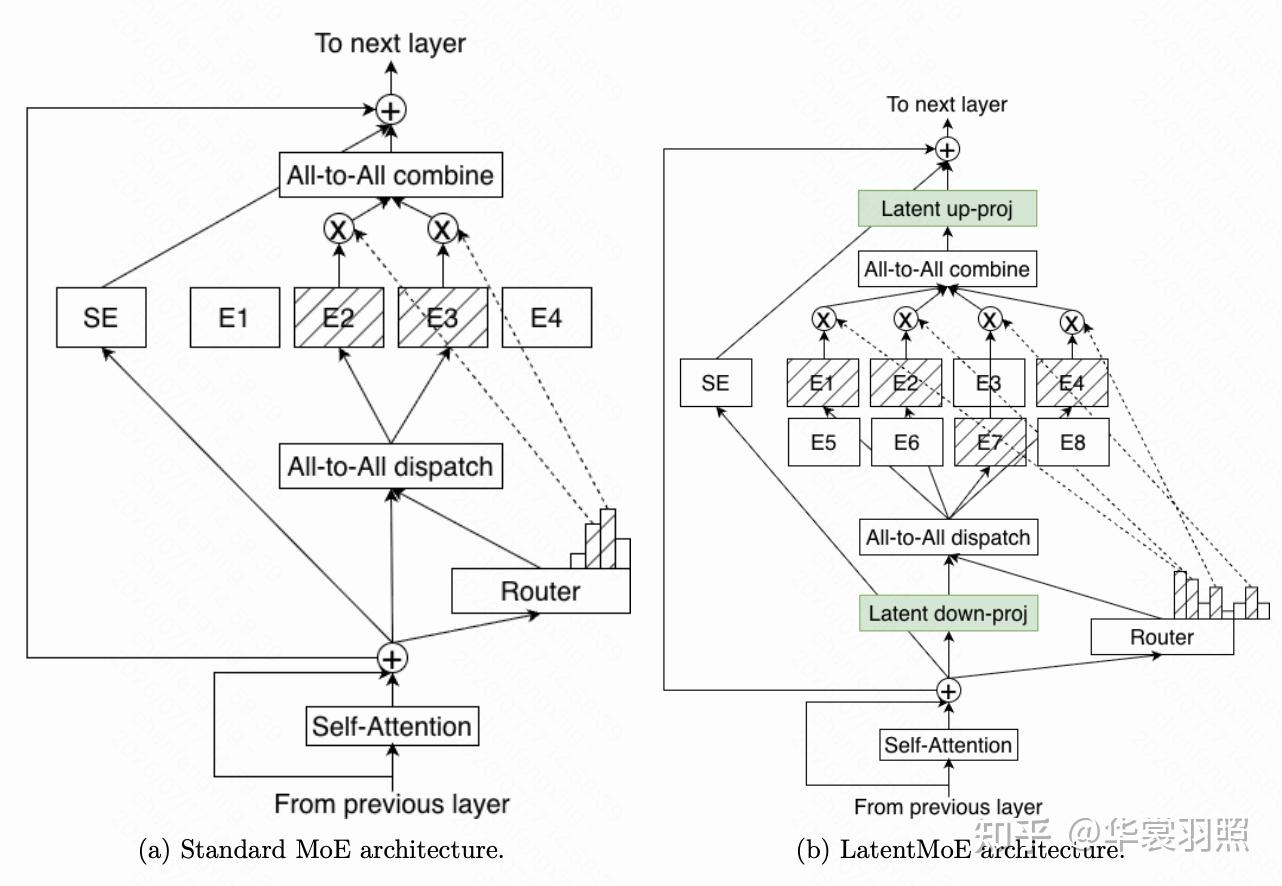
精选文章 从 kimi k3 看下一代 MoE 架构的转折点:LatentMoE 作者:华裳羽照 https://zhuanlan.zhihu.com/p/2061464412574242573 以 Kimi K3 与 Nemotron 3 Super 为例,看 MoE 架构如何在 2026 年完成一次关键的范式跳跃。 2026 年上半年,两件事同时发生:NVIDIA 发布了 1
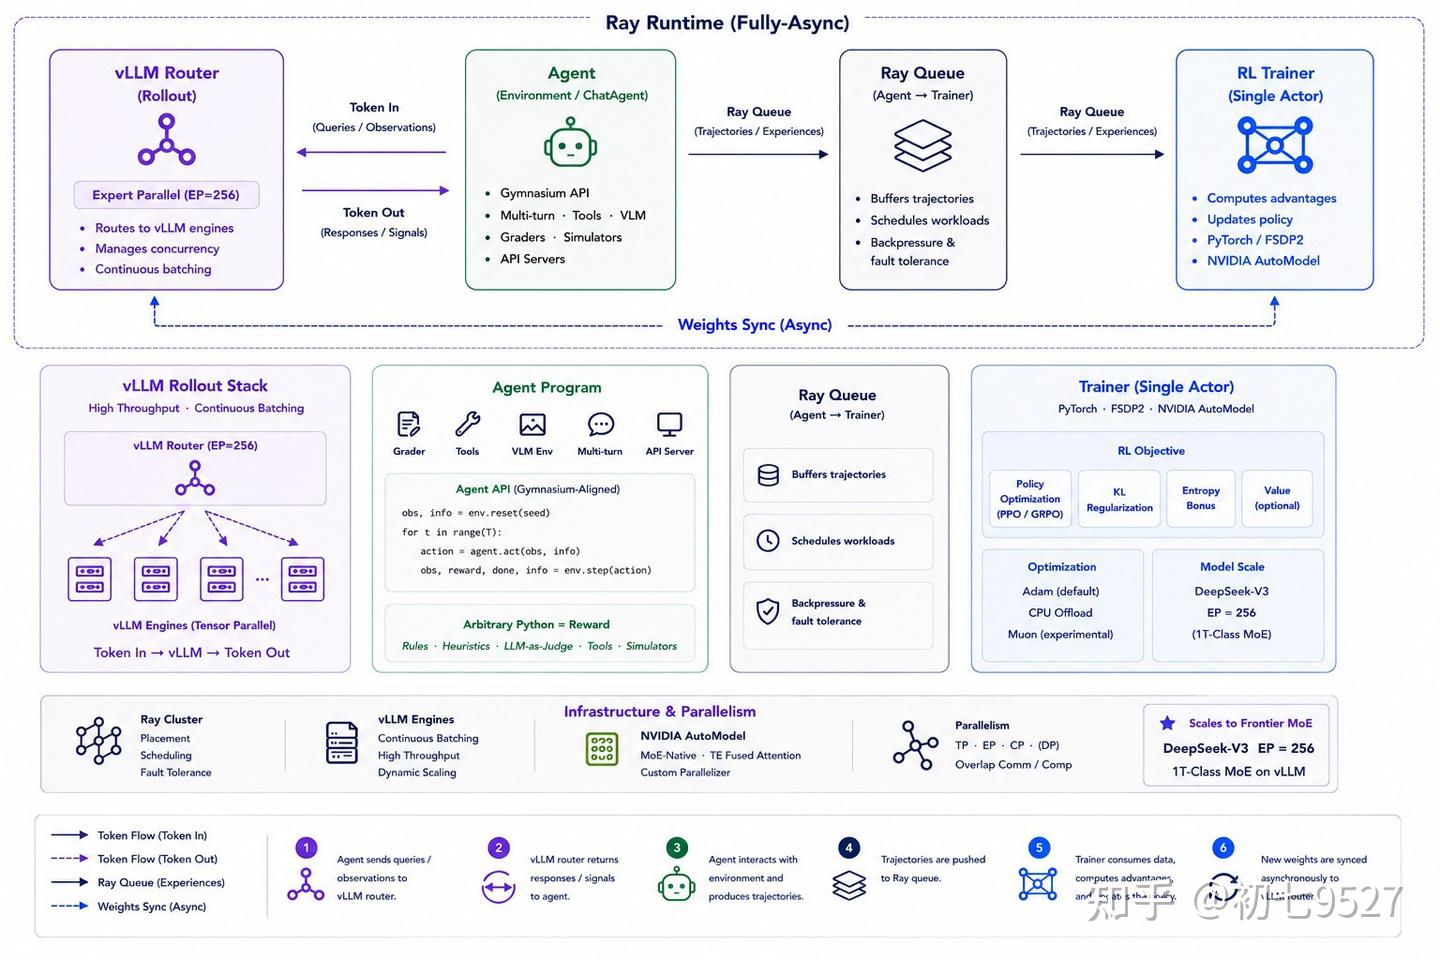
精选文章 又造一个 RL 框架?Agentic RL Research 框架 Molt:9K 行核心 RL 代码、纯 PyTorch! 作者:初七9527 https://zhuanlan.zhihu.com/p/2060313194971846263 TL;DR Molt 是一个 agentic-first、纯 PyTorch-Native 的强化学习框架: 约 9,000 行核心 RL 代码,你能一口气从 CLI 追到执行分支;
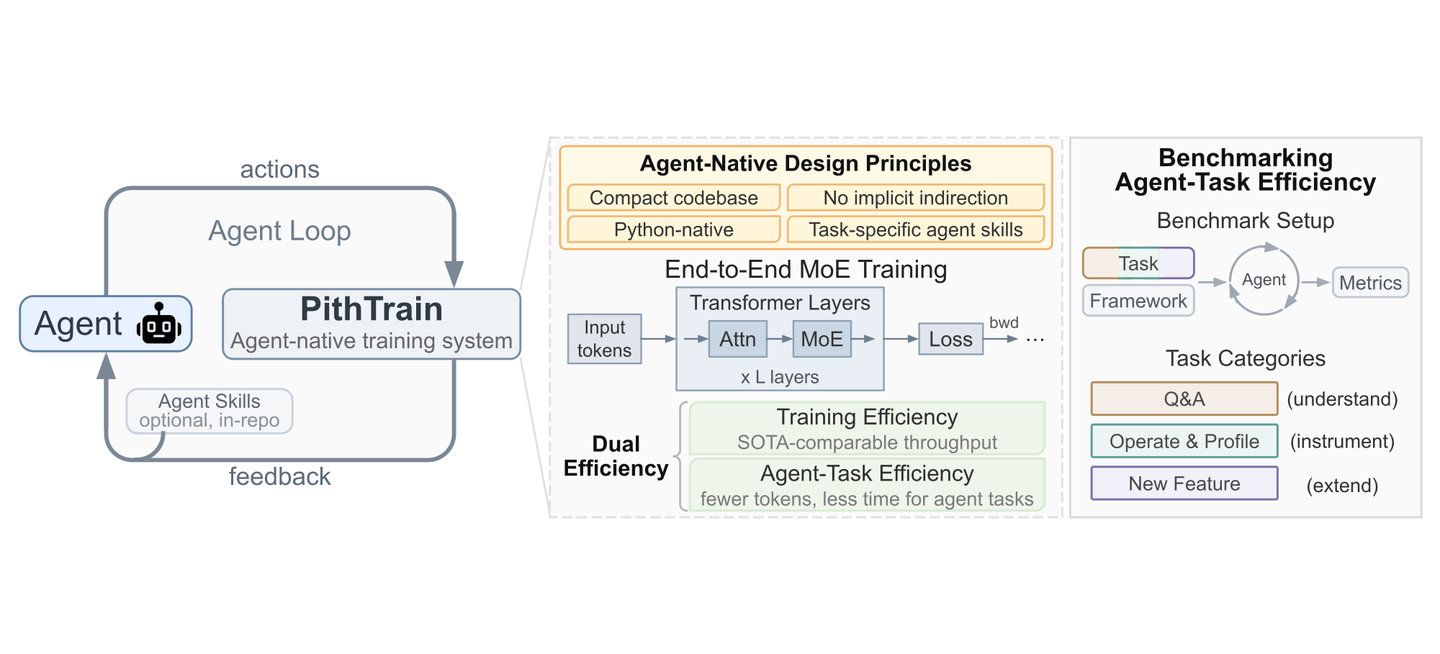
青稞Talk 直播预告!周六上午10点,聊聊 PithTrain:Agent 时代的 MoE 训练框架设计 陈天奇团队最新开源 PithTrain:Agent 时代的 MoE 训练框架设计 专家混合模型(MoE)已经成为当前大语言模型的主流架构,相应的生产级训练框架也经过多年工程积累,具备了优异的训练性能。 然而,随着新的模型架构和系统优化不断涌现,在这些大型框架上进行开发和演进仍然成本高昂。 随着 AI
精选文章 陈天奇团队最新开源 PithTrain:Agent 时代的 MoE 训练框架设计 作者:赖睿航,CMU CS Ph.D. https://zhuanlan.zhihu.com/p/2045509863221064141 TL;DR PithTrain 是一个精简、agent-native 的 MoE(Mixture-of-Experts)训练框架,整套实现约 1.1 万行 Pyt