精选文章 干货!大模型后训练的“剂量”学,什么剂量才能让 Qwen3.8-27B 想得少、不掉能力,还能用 XH 档? 先放最终后训练完成的模型地址: https://modelscope.cn/models/Merkyor/Qwen3.8-27B-EfficientThink-K3-Opus5-Grok4.6-GPT5.6Sol-SFT-SimPO-DFlash2 这件事一开始看起来挺简单。Qwen 3.8 27
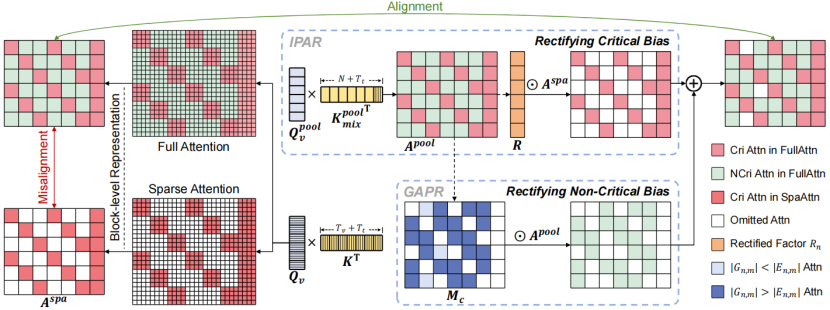
精选文章 为什么视频生成稀疏注意力做不好?中科院自动化所最新提出稀疏注意力纠偏新范式 生成式视频模型正以前所未有的速度进化,从数秒短片拓展至长时段叙事,从模糊低清跃升至逼真4K。然而,随着视频时长和空间分辨率的提升,序列长度急剧增加,二次复杂度的注意力计算量随之飙升,即便采用 FlashAttention 等高效优化,推理延时仍然难以遏制。以生成一段 720p、5 秒的视频为例,单是
青稞Talk 从 BF16 到 FP16:如何解决RL训练-推理不匹配问题 大语言模型(LLM)的强化学习(RL)微调常因训练与推理策略间的数值不匹配而面临训练不稳定的问题。相比在算法上引入重要性采样来打补丁,我们发现直接从根源上提高浮点数的精度更加有效。 论文:Defeating the Training-Inference Mismatch via FP16 链接:ht
青稞Talk Sparse VideoGen:无需重新训练的 DiTs 推理加速框架 5月29日上午9点,青稞Talk 第52期,加州大学伯克利分校计算机科学博士生席浩诚,将直播分享《Sparse VideoGen:无需重新训练的视频扩散 Transformer 推理加速框架》。 分享嘉宾 席浩诚,加州大学伯克利分校计算机科学博士一年级学生,师从Kurt Keutzer教授,研究方向
青稞Talk COAT:显存高效的 FP8 训练,实现高效深度学习 3月22日上午11点 ,青稞Talk 第42期,COAT 第一作者、加州大学伯克利分校计算机科学博士生席浩诚,将直播分享《COAT:显存高效的 FP8 训练,实现高效深度学习》。 分享嘉宾 席浩诚是加州大学伯克利分校计算机科学博士一年级学生,导师是Kurt Keutzer教授,研究方向为大型语言模型
青稞Talk LLMC:大语言模型压缩工具的开发实践 12月16日晚8点,青稞Talk第32期,商汤科技研究院谷石桥和雍洋两位模型压缩研究员,将对LLMC进行直播分享,主题为《LLMC:大语言模型压缩工具的开发实践》。 他们将从工具框架设计,常用算法解读和工具使用方式等角度,为大家详细讲解LLMC及实践,希望大家可以从中获益。 主讲嘉宾 谷石桥,商汤科
青稞Talk DuQuant: 基于正交变换实现大型语言模型的 SOTA级 4 bit 量化 11月5日19点,青稞Talk 第28期,中科院自动化所和香港城市大学联合培养博士生林浩坤,将直播分享《DuQuant: 基于正交变换实现大型语言模型的 SOTA级 4 bit 量化》。DuQuant 的论文在NeurIPS 2024 上获得 88877 的分数并被接收为Oral。 主讲嘉宾 林浩坤
青稞Talk LLMC:大语言模型的量化基准 10月11日晚7点,青稞Talk 第25期,商汤科技算法实习生、香港科技大学准博士生黄雨石,将直播分享《LLMC:大语言模型的量化基准》。 主讲嘉宾 黄雨石,本科毕业于北京航空航天大学,即将进入香港科技大学攻读计算机博士学位。研究方向为高效的AIGC模型,神经网络压缩与加速等,目前已在CVPR, E
青稞Talk S-LoRA:实现多 LoRA 大模型的高效并行化推理 8月26日11点,青稞Talk第20期,UC Berkeley 博士生曹诗怡,将对 S-Lora 进行分享,主题为《S-LoRA:实现多 LoRA 大模型的高效并行化推理》。 主讲嘉宾 曹诗怡,UC Berkeley 博士生;导师是Ion Stoica和Joseph E. Gonzalez教授,主要
青稞Talk AWQ:激活值感知的LLM低位权重量化 8月14日晚7点,青稞Talk第19期,MIT准博士生唐嘉铭,将直播分享《AWQ:激活值感知的LLM低位权重量化》。 主讲嘉宾 唐嘉铭,MIT准博士生;导师是韩松教授;此前,在上海交通大学(ACM班)获得了计算机科学学士学位;大三期间,在上海交通大学高性能计算中心实验室(EPCCLab)进行科研实习