机器人数据不够用,是个老问题。
更麻烦的是换个本体就不好用:同一段“把杯子放进盒子”的视频,夹爪录的换到灵巧手上,手型和接触全变了;机械臂、人形机器人、夹爪、灵巧手,动作空间对不上,一批数据往往只能喂一个本体。另一边,人类的第一人称视频多到用不完,可它和机器人之间隔着一层本体差异。
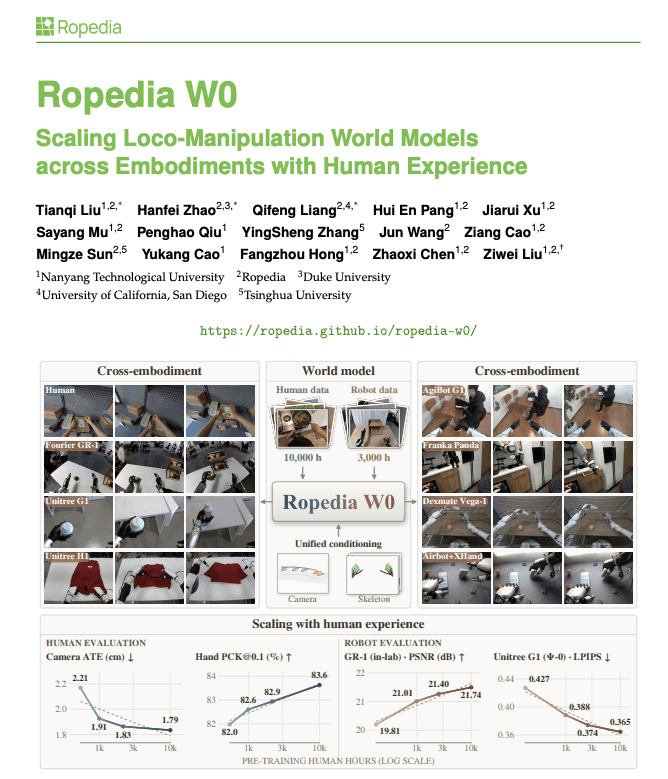
来自南洋理工大学 MMLab@NTU、Ropedia 等机构的团队提出 Ropedia W0:把人类的第一人称经验和机器人数据接到同一条预训练路径上,并开源了代码。
工作:Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience
链接:https://arxiv.org/abs/2610.26855
项目主页:https://ropedia.github.io/ropedia-w0/
代码:https://github.com/Ropedia/ropedia-w0
团队:Tianqi Liu、Hanfei Zhao、Qifeng Liang、Hui En Pang、Jiarui Xu、Sayang Mu、Penghao Qiu、YingSheng Zhang、Jun Wang、Ziang Cao、Mingze Sun、Yukang Cao、Fangzhou Hong、Zhaoxi Chen、Ziwei Liu
机构:南洋理工大学(MMLab@NTU)、Ropedia、杜克大学、加州大学圣地亚哥分校(UCSD)、清华大学
一个接口,让人类和机器人说同一种“动作”
W0 的答案是相机位姿加投影骨架。
移动靠相机位姿:人走路、机器人移动,视角怎么变,由位姿描述。操作靠投影骨架:手在画面里怎么动,就用投影到图像上的骨架表示。
人类的骨架来自 21 个手部关键点;机器人这边,用本体原生的前向运动学投影,再加大量人工关键点标注和修正,把不同本体的末端执行器对齐到同一张图像坐标系。
接口统一之后,移动和操作进了同一套表示,人形、机械臂、夹爪可以共用同一个模型。

图:左右是人和机器人的第一人称预测,中间是统一的相机/骨架条件;底部曲线是随人类数据量增加的变化。来源:arXiv:2610.26855
数据:1 万小时人类视频 + 3 千小时机器人数据
训练数据叫 Xp-Data。
人类部分是 14 个公开第一人称数据集加自采;机器人部分是 13 个公开数据集。所有数据过五阶段清洗管线,最后留下约 1 万小时人类视频和 3 千小时机器人视频。
标注分三层:几何(相机位姿)、运动学(骨架)、语义(描述文本)。有了这三层,人类数据和机器人数据才能进同一个训练集。

图:人类和机器人数据经过五阶段清洗,合成 Xp-Data。来源:arXiv:2610.26855
模型:一个视频扩散模型,两种规模
W0 是一个 latent video diffusion,输入初始观测、文本和运动学条件,预测未来的第一人称视频。
两种规模:dense 5B;A14B MoE,基于 Wan2.2-I2V-A14B,约 27B 总参、14B 激活。训练分两段:先用人类视频预训练,再用人类加机器人的混合数据做 mid-training。
条件注入也分开:空间对齐的条件(相机射线图、骨架渲染图)直接加到视频 token 上,其余上下文走 cross-attention。

图:初始观测、文本与运动学条件怎么进入视频扩散模型。来源:arXiv:2610.26855
评测:5B 对上 14B、64B
评测覆盖五个机器人基准:DreamDojo、Ψ0、ω-HOME、Xp-Teleop、AgiBot,外加人类第一人称的留出集。其中 Xp-Teleop 是新搭的长时程基准,约 1 小时灵巧人形遥操作数据,覆盖六类家务活动。
DreamDojo 上,1% 的后训练预算,5B 的 In-lab PSNR 是 20.85,14B 的 DreamDojo 是 18.98;100% 预算时,A14B 23.22 对 21.41。
Ψ0 上,A14B 零样本 17.36 dB,高过 Cosmos3-Nano(16B)全数据训练的 16.55,也高过 Cosmos3-Super(64B)的 15.73。ω-HOME 上,5B 零样本 17.35,对 Cosmos3-Nano 16.24。
人类视频留出集:相机轨迹误差 1.79 cm,对 1.93 cm;手部关键点 PCKm 88.66,对 84.03。
另外,人类预训练数据越多,人和机器人的预测都越准。
从分钟级生成到实时 VR
世界模型要能用,先得跑得动。
蒸馏之后,4 步学生能匹配甚至超过 50 步教师,速度提升约 7 倍,支持分钟级 rollout。戴上 Quest 3,头部和手部动作映射成相机位姿与骨架,模型实时生成第一人称视频,人可以边动边看。

图:少步学生从教师蒸馏,再接上流式生成。来源:arXiv:2610.26855

图:头显用户的操作实时映射成第一人称视频。来源:arXiv:2610.26855
三类应用:策略评估(用预测的任务进度对真值)、模型基规划、世界-动作模型(用 W0 初始化策略)。LIBERO-Plus 上,全量数据 56.82% 对 FastWAM 50.06%;只给 3 条演示时 23.97% 对 21.44%——数据越少,预训练越值钱。
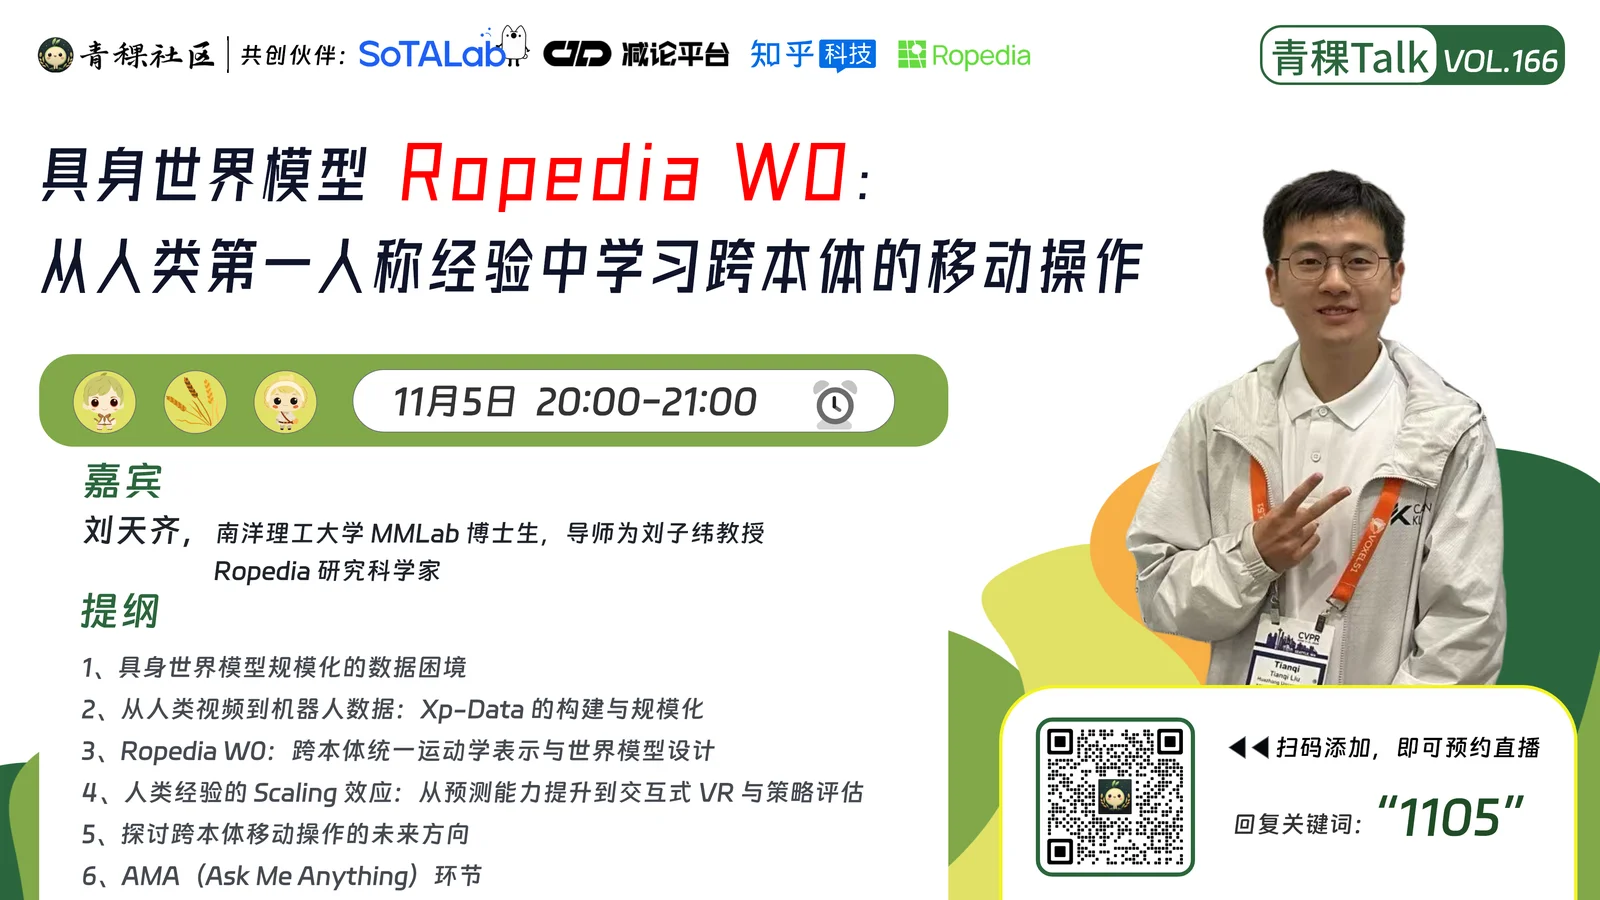
11月5日(周四)晚8点,青稞Talk 第166期,青稞社区邀请到 Ropedia W0 一作、南洋理工大学 MMLab@NTU 博士生、Ropedia 研究科学家刘天齐,分享《具身世界模型 Ropedia W0:从人类第一人称经验中学习跨本体的移动操作》。
分享内容
具身世界模型 Ropedia W0:从人类第一人称经验中学习跨本体的移动操作
1、具身世界模型规模化的数据困境
2、从人类视频到机器人数据:Xp-Data 的构建与规模化
3、Ropedia W0:跨本体统一运动学表示与世界模型设计
4、人类经验的 Scaling 效应:从预测能力提升到交互式 VR 与策略评估
5、探讨跨本体移动操作的未来方向
6、AMA(Ask Me Anything)环节
嘉宾介绍
刘天齐,南洋理工大学 MMLab@NTU 第一年博士生,导师为刘子纬教授,同时担任 Ropedia 研究科学家。本硕毕业于华中科技大学,师从曹治国教授,获得过三次国家奖学金。早期做三维视觉,目前专注于具身智能与世界模型,主要研究如何从大规模人类第一人称经验中学习可跨本体迁移的物理世界模型和机器人基座模型。
在 CVPR、ICCV、ECCV、ICLR、SIGGRAPH、TPAMI 等顶级会议和期刊上发表论文十余篇,以第一作者或共同一作身份完成的工作有 Ropedia W0、Light-X、Free4D、4DNeX、MVSGaussian 等。
直播时间
11月5日(周四)20:00 - 21:00
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册